我手写的 Redis 锁,输给了 10 秒的 TTL
场景很简单:自己比赛的项目里,发布游记接口要给用户加积分。为了防止同一用户刷接口重复加分,我按用户粒度加了一把 Redis 锁。
第一版写完我觉得挺稳:SET key value NX EX 一行同时搞定加锁和过期、UUID 做唯一标识、finally 里释放。三个该做的都做了。
后来发现三个漏洞,它们不在同一层------第一个写代码时能想到,第二个压测时才暴露,第三个要看懂 GET 和 DELETE 之间的缝隙才明白。
而最后一个,是我加了锁之后才想通的一句话:我要的其实不是锁。
第一版:三个设计点都"对"的锁
| 设计点 | 实现 | 解决什么 |
|---|---|---|
| 原子加锁 | setIfAbsent(key, value, ttl, unit) = SET key value NX EX 10 |
NX 保证互斥,EX 防止死锁 |
| 唯一标识 | UUID 作为 value | 防止误删别人持有的锁 |
| 安全解锁 | GET → 比较 UUID → DELETE | 降低"锁过期后误删新锁"的概率(没消除,见漏洞二) |
这里补一句容易被忽略的细节:SETNX 这个命令本身不带过期时间 ,它只解决"不存在才设置",不解决"设置后什么时候消失"。用 SETNX 再补一次 EXPIRE,中间崩溃了就是一把永久锁。所以要的是 SET key value NX EX 这一条原子命令,不是 SETNX。
锁粒度 也值得说一句:我用的是 lock:blog:{userId},用户 A 和用户 B 各自一把锁,互不阻塞。
这组参数我真的压过:同一用户并发 100 次,1 次成功,99 次 429,余额只加了 10,流水只有 1 条。
css
A(不加保护)  100 并发 → 余额 1000,流水 100 条
B(加锁)      100 并发 → 余额   10,流水  1 条
A 组余额 1000 是因为 100 个请求真的同时进了临界区,每个都 experience = experience + 10。B 组余额 10,说明锁确实在拦。
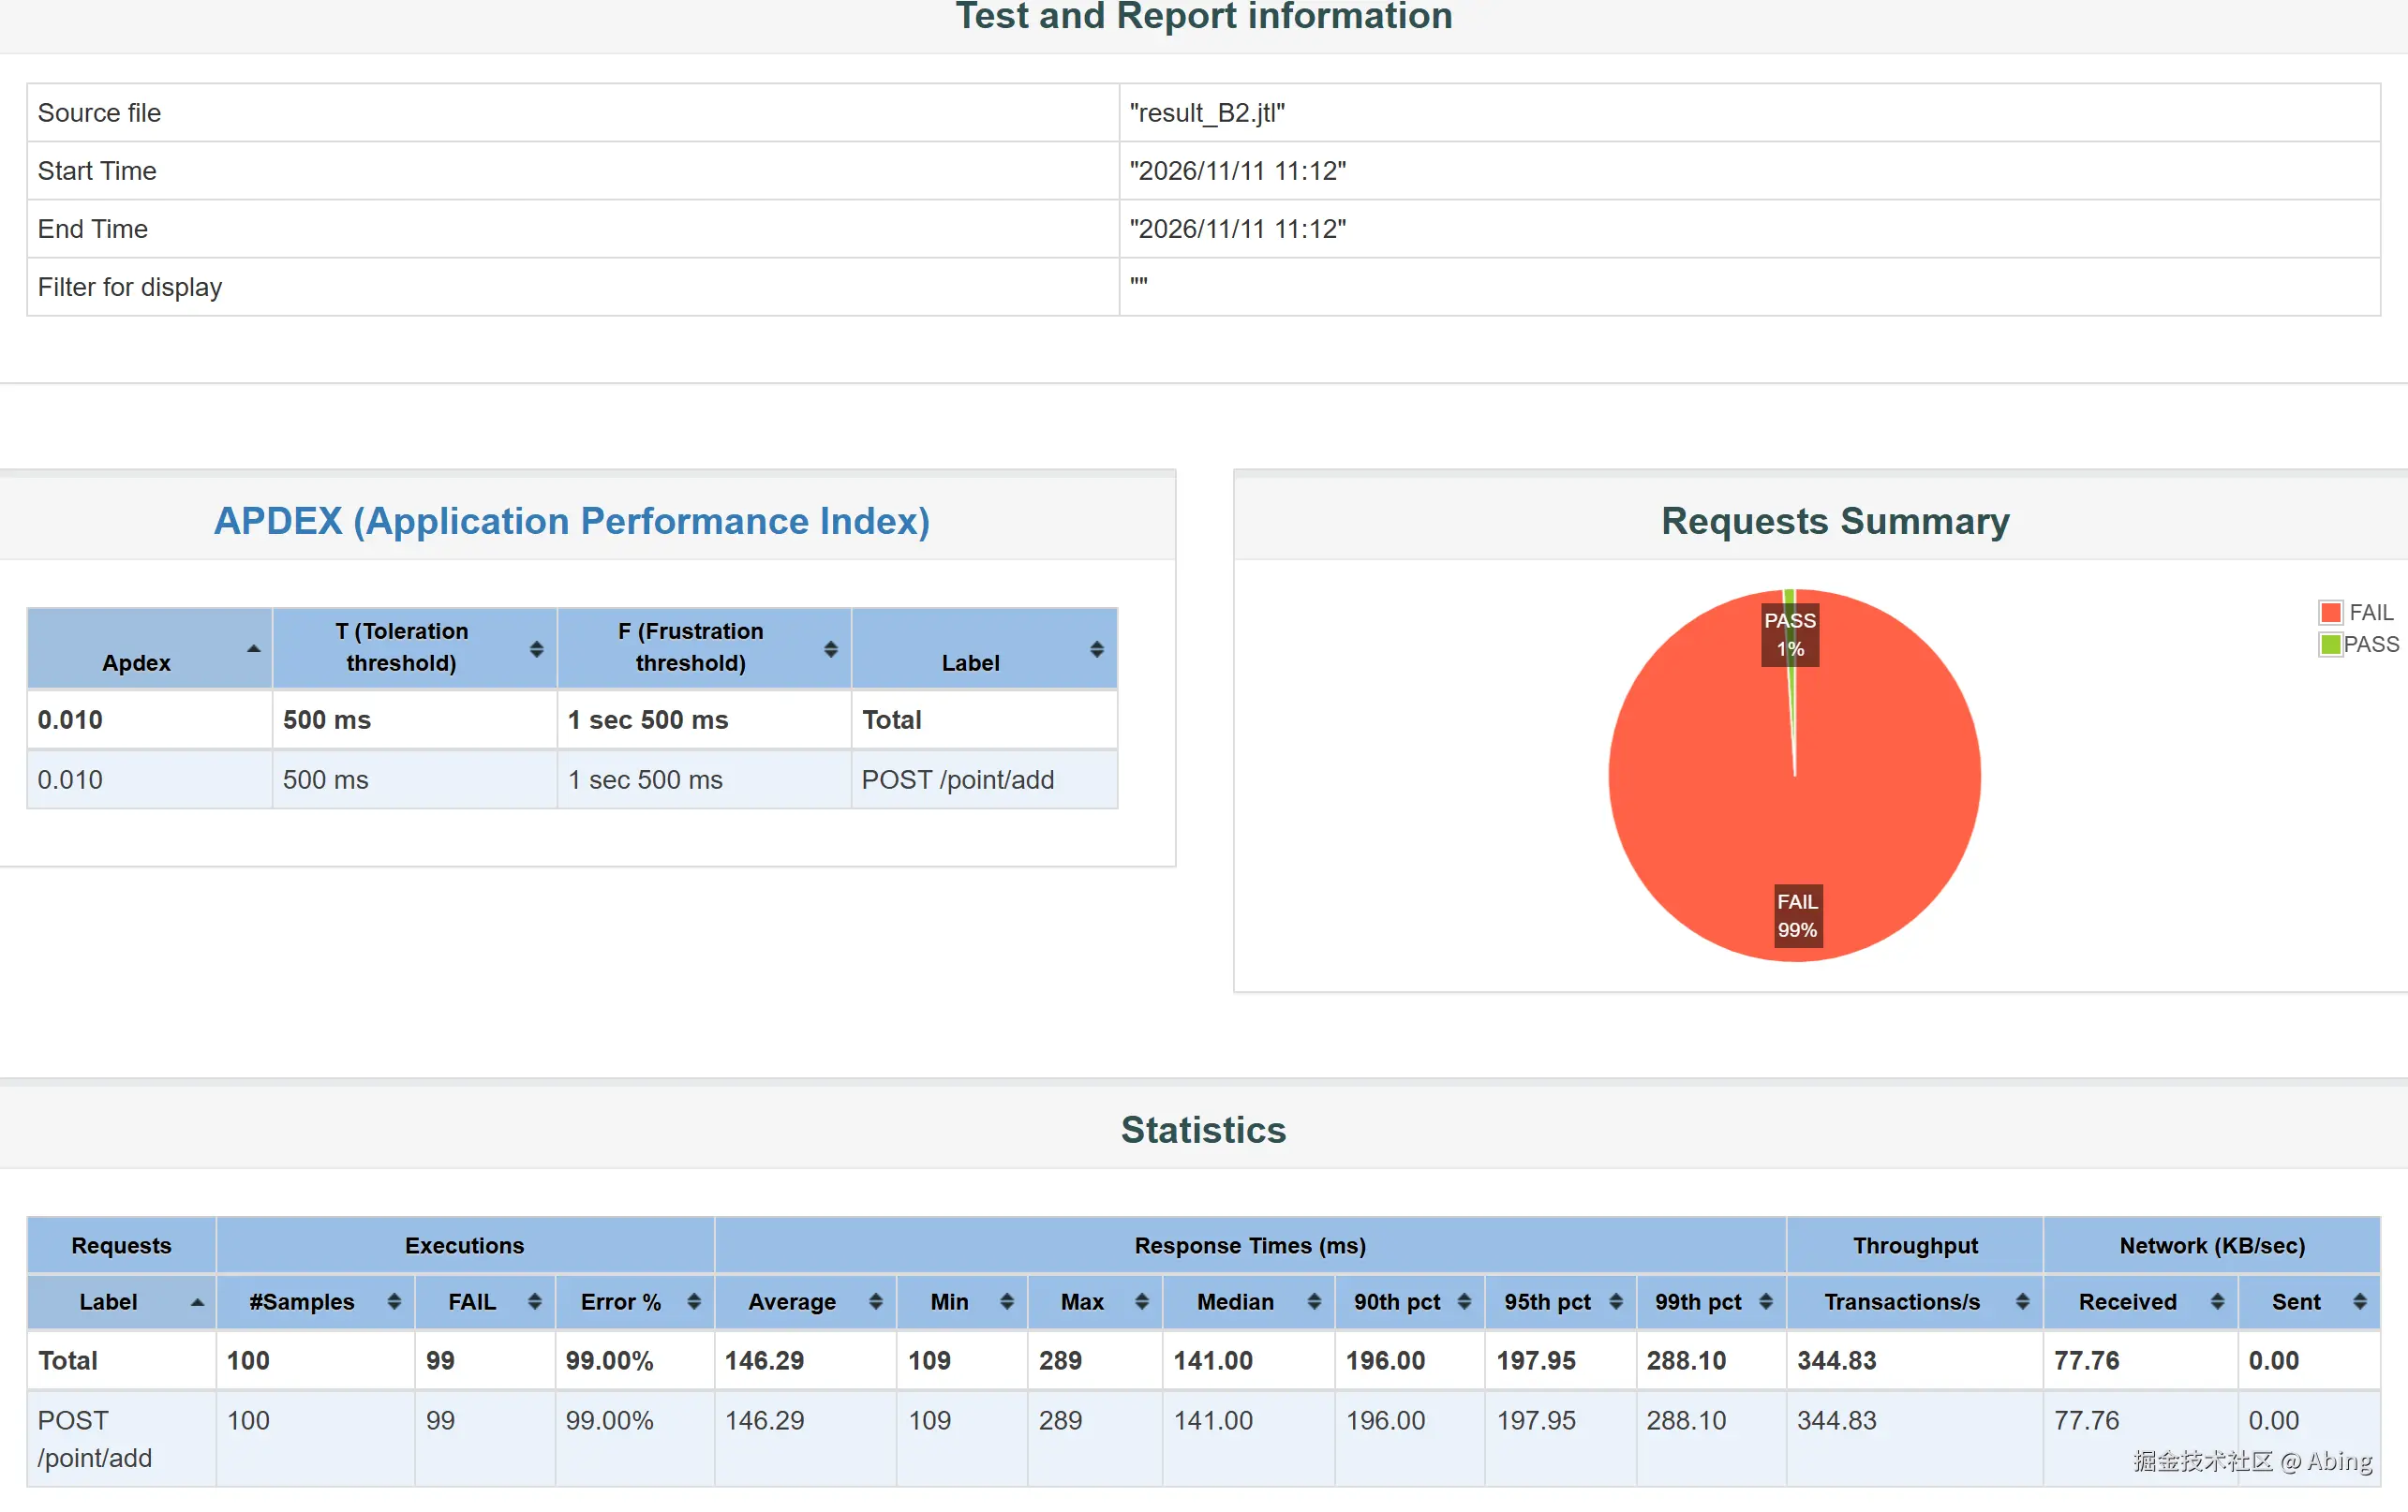
100 个请求,99 个被标红。这里要说明一句:Error % 其实是 429,是锁在正常拒绝,不是服务出错------JMeter 只是如实把 4xx 记成了失败。
单看这一列 99% 的失败率有点刺眼,但它恰恰是锁在工作的证据:

99 个样本全是 429 Too Many Requests,占全部请求的 99%。
这确实是业务要的效果,不是缺陷。也正因为这组数据看起来"完美",我才没往下想一步。
看起来没问题。但三个漏洞都在等着。
漏洞一:TTL 是写死的 10 秒
setIfAbsent(..., 10, TimeUnit.SECONDS) 这行代码里,10 是个魔数。
它默认了一件事:业务一定在 10 秒内跑完。
这句话我当时是当常识接受的。为了验证它到底会不会破,我搭了个最小工程:同一个"加分"动作写四份------不加保护、加锁、加锁但业务拖到 12 秒、不加锁靠唯一索引幂等。临界区四份完全一样,只换保护方式。
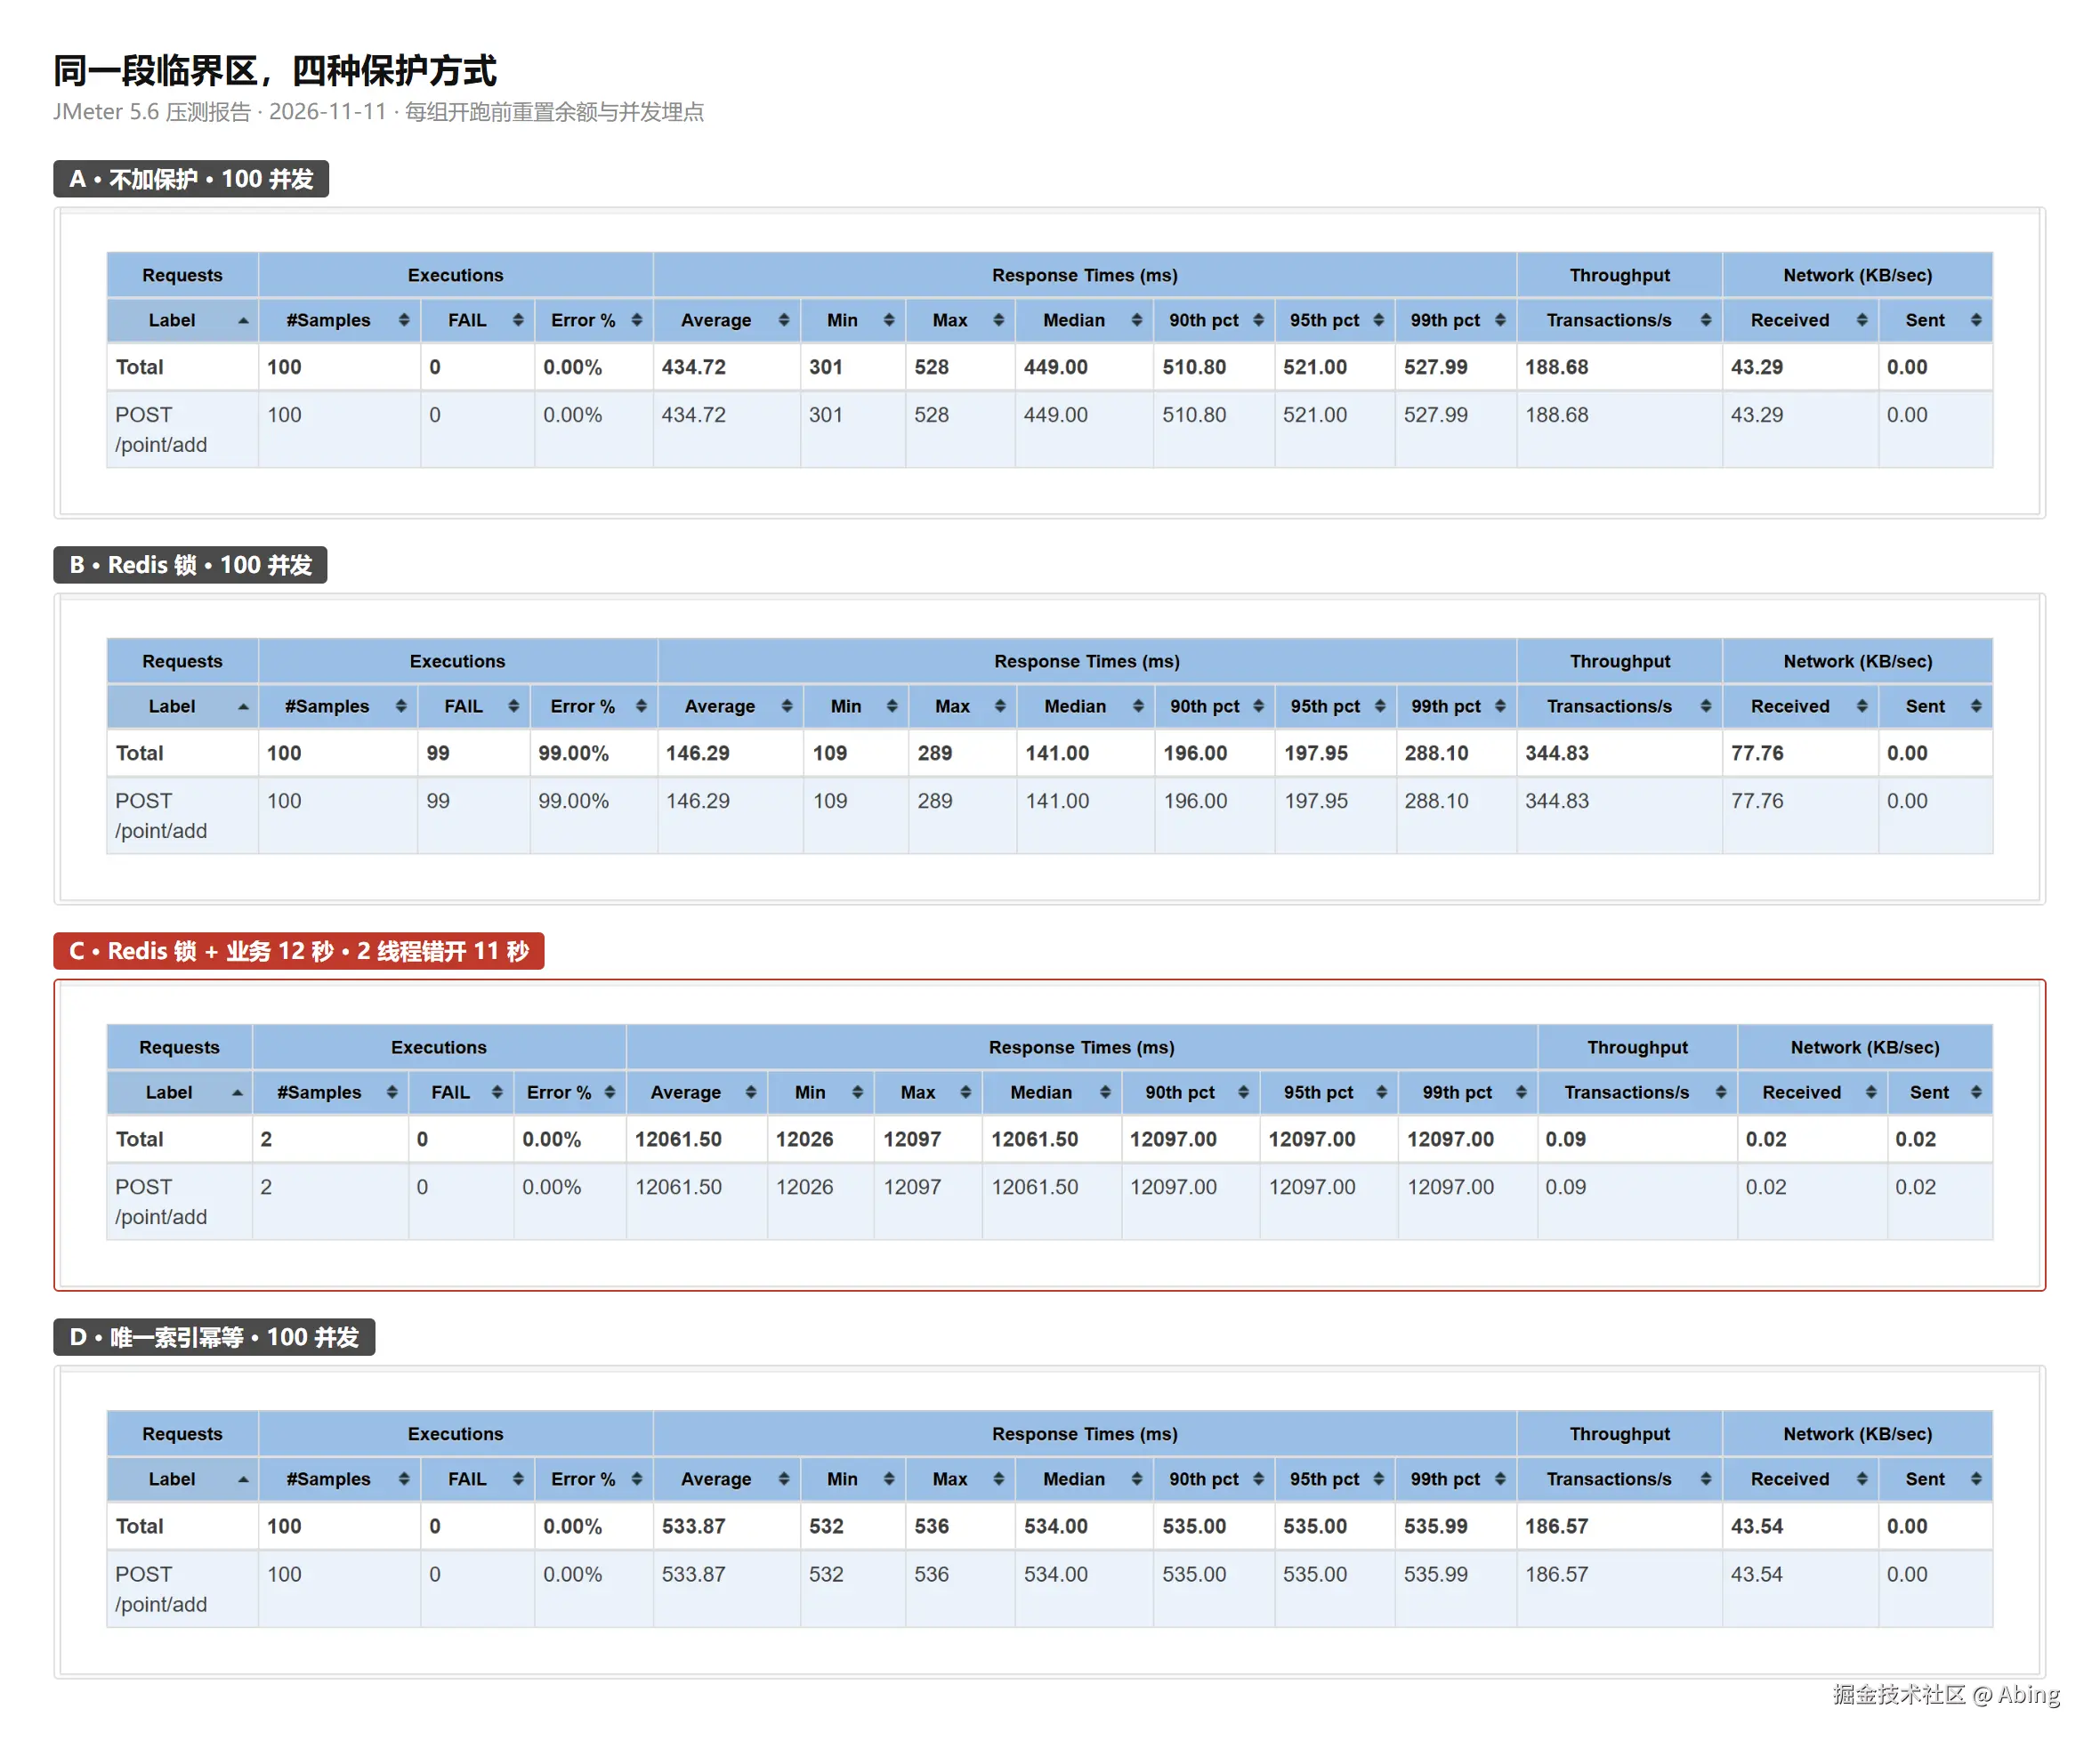
同一段临界区、四种保护方式。B 组 99% 的请求被锁挡掉,C 组只有 2 个样本、平均响应 12 秒。
C 组的设计是"业务比 TTL 慢一点点":TTL 还是 10 秒,业务耗时故意拖到 12 秒,只发 2 个请求,第二个晚 11 秒发。
这两个数字不能随便填:
- 开 100 个线程,第 2~100 个都在第 1 秒内到达,那时锁还在,全被 429 挡掉------漏洞根本出不来;
- 只错开 5 秒,第二个请求到达时离第一个加锁才 5 秒,锁还在,同样被挡;
- 必须让第二个请求的到达时间 > 第一个请求的 TTL,才有机会。
结果:
第 1 个请求:加锁成功 → 进入临界区 → 睡 12 秒
第 2 个请求:在第 10.7 秒到达 → 加锁成功 → 也进入临界区 → 睡 12 秒
日志原文(同一轮跑的,时间戳连续):
ini
10:42:15.187  [LOCK] acquired key=lock:point:3 token=2170...:179 ttl=10s
10:42:25.896  [LOCK] acquired key=lock:point:3 token=b956...:249 ttl=10s   ← 10.7 秒后,第二个也拿到了
10:42:27.208  [LOCK] release-skipped holder=b956... mine=2170...          ← 第一个跑完了,想删锁,发现锁已经换成别人的
10:42:37.910  [LOCK] release-skipped holder=null   mine=b956...            ← 第二个跑完,锁早已被 TTL 删掉
两个请求都是 200,都进了临界区,分加了两次:
ini
C: 2 × 200            ← 两个都成功,这就是漏洞
balance = 20          ← 应该是 10
records = 2           ← 应该是 1
[CS] MODE=lock  MAX_CONCURRENT=2  TOTAL_ENTERED=2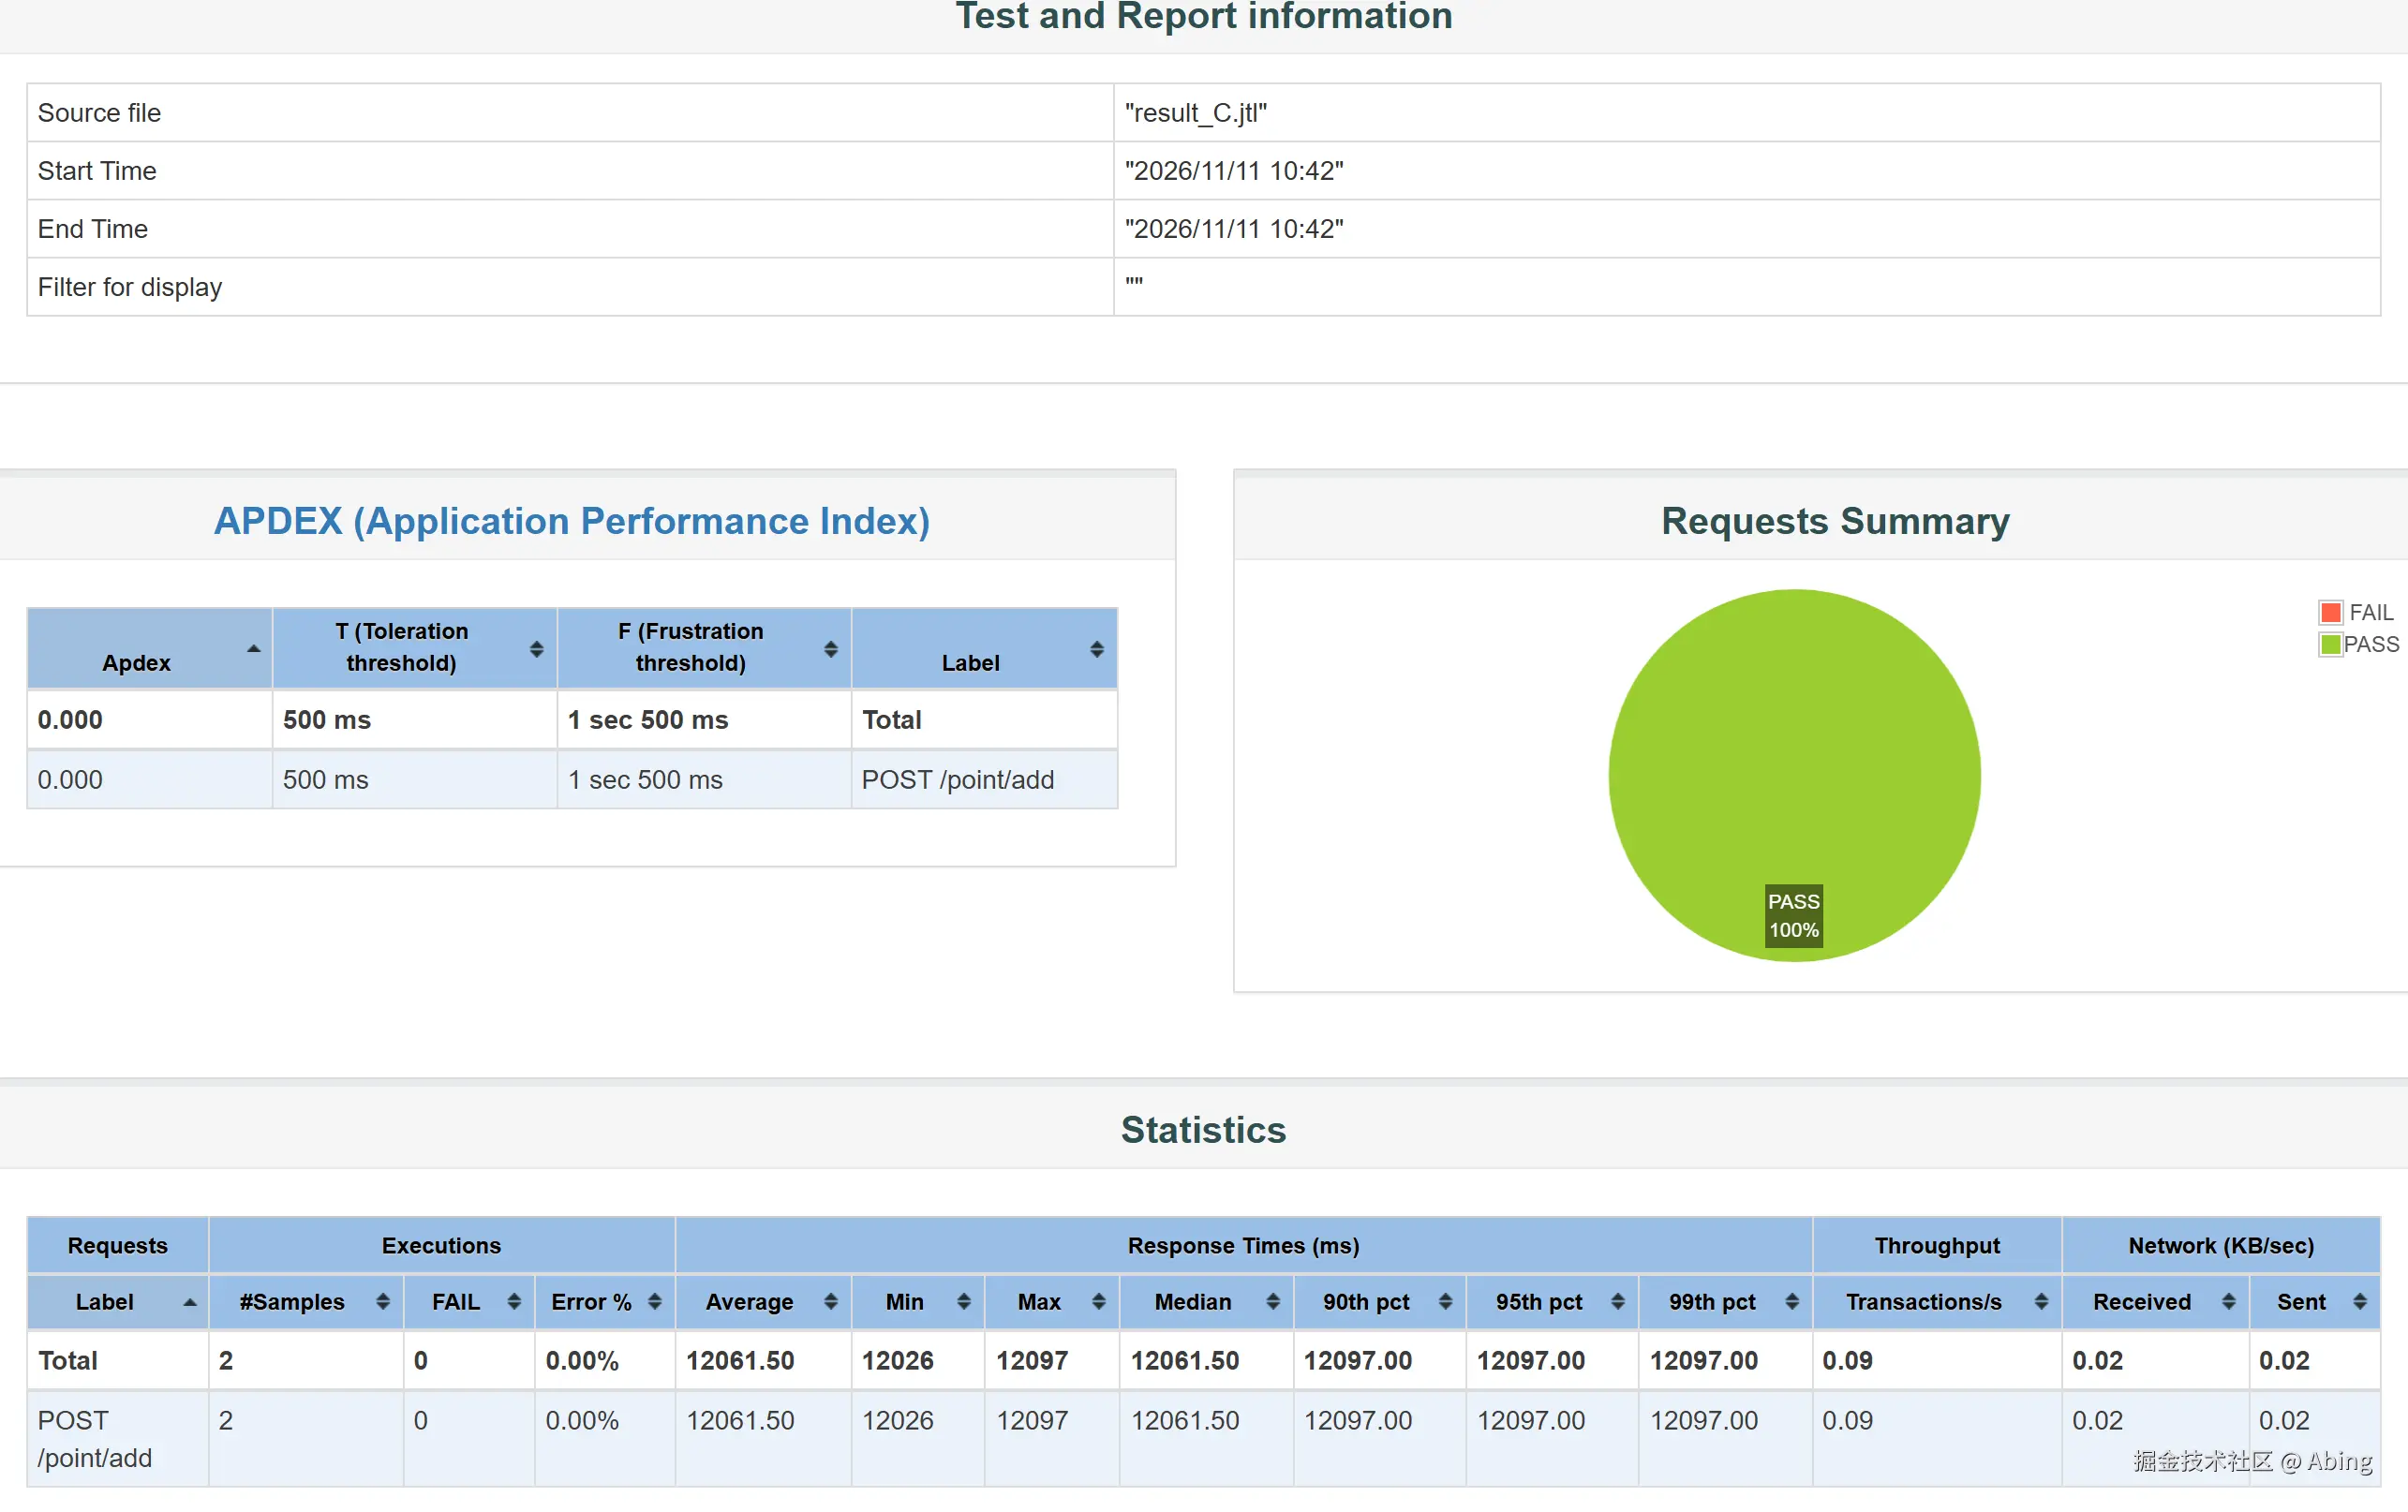
只有 2 个样本、Error % 为 0------这不是"没问题",这是"两个都成功了" 。响应时间 12026~12097 毫秒,两个都撑满了 12 秒的 sleep。
MAX_CONCURRENT=2 是这一节唯一需要看的数字:同一把锁保护的临界区里,同时有两个人。
再加一个佐证:两个请求的响应时间分别是 12097ms 和 12026ms,而它们的发起时间相差 10753 毫秒。后发的那个晚了 10.7 秒才出门,却和先发的几乎同时结束------它们是真的在并行跑,不是一个等另一个。
第二个请求为什么能进
这是整件事里必须写清楚的一句,因为它决定了这个漏洞是"偶发"还是"必然"。
三层原因,缺一层都不会发生:
- 过期是 Redis 服务端的事,跟持锁线程的死活无关。 第 1 个请求还在
sleep(12000)里,它什么都没做错,但 key 的 TTL 到点就被删了。 - 第 2 个请求不是"抢"到的,是"捡"到的。 它到达时锁已经不存在了------它不是赢了竞争,是根本没人跟它竞争。这一点很关键,它意味着这不是概率问题。
setIfAbsent的前置条件是"key 不存在"。 此刻成立,于是它安静地加锁成功,还以为自己是唯一持有者。
所以结论不是"TTL 设小了",而是:只要业务耗时 > TTL,就必然发生,跟并发量、跟代码质量、跟概率都无关。 调大 TTL 只是把这个阈值往后推------今天 10 秒不够改成 60 秒,遇到一次 90 秒的冷启动照样破。
finally 里的释放逻辑在这里完全救不了场:它保证的是"跑完之后释放",而这次是"没跑完就被释放了"。释放动作本身没错,错的是它发生的时机不由代码决定。
漏洞二:解锁不是原子的,中间能塞进一次过期
第二版我加了 UUID 校验,看起来解决了误删:
csharp
GET lock            → 是我的
(这个间隙,锁过期,别人拿到锁)
DEL lock            → 删的是别人的
GET 和 DELETE 是两次网络往返。如果在这两次之间,锁恰好过期、而另一个线程刚好拿到锁:判断的时候锁还是自己的,删除的时候已经不是了。
UUID 校验防住了"过期后误删",没防住"判断完才过期" 。这个窗口极小,但它不由你的代码质量决定------由网络抖动和业务耗时的分布决定。
这个窗口我在 C 组里顺手撞上了。上面日志里那行:
ini
10:42:27.208 [LOCK] release-skipped holder=b956... mine=2170...第 1 个请求在第 12.02 秒去释放锁,此时锁的持有者已经是第 2 个请求。它做对了------比较了 value,发现不是自己的,跳过了删除。
但注意它"做对"的方式:先 GET 出来比一次,再决定要不要 DEL。 这两步之间隔了一次网络往返。这次侥幸没删错,是因为中间没有发生第三次过期;只要那个间隙里 key 又过期、又被别人加上,我比较的和删除的就不是同一把锁了。
所以 release-skipped 证明的不是"我的解锁写得对",而是"这次刚好没撞上"。
漏洞三:没有续期机制,长任务天然无解
前两个漏洞可以靠"缩短业务耗时"绕过去,第三个绕不过去:
只要业务耗时不确定,写死 TTL 就是错的。
而"不确定"才是常态------一个接口今天 200ms,明天遇到冷启动可能就是 3 秒。你没法用一个固定数字覆盖它。
漏洞一是"业务超时了会破",漏洞三是"你没有任何办法让业务不超时"。这是同一个根因的两面:锁的生命周期和业务的生命周期是两条独立的线,代码里没有任何东西把它们同步起来。
需要的是:业务还在跑,锁就自己续上。
补一句实验条件
上面所有数字来自一个独立的最小工程,不是从业务项目里截的。四个容易让结论失效的地方:
- 每组跑之前清空余额、流水和 Redis 锁,并重置并发埋点------埋点是进程级峰值,不清零的话 B 组会读到 A 组留下的 100;
- 100 并发用集合点(Synchronize Timer)对齐,保证是真同时;
- C 组必须去掉集合点。集合点会把两个请求强行对齐到同一刻,那就变成"两个人同时抢锁"(只有一个能成功),而不是"锁过期后第二个人进来"------完全不同的实验;
- 连接池开到 120。默认 10 个连接会把 100 并发排队串行化,并发峰值会莫名其妙停在 30 多,看起来像锁没生效。
方案一:Lua 脚本,先把解锁做成原子操作
我在最小工程里验证的第一版修法是 Lua。
GET 和 DEL 在 Redis 端作为一次执行完成,漏洞二直接被堵死。注意 Lua 里用 KEYS[1] 和 ARGV[1],别把 lockKey 拼进脚本字符串------那会破坏 Redis 的集群分片。
但 Lua 只解决了漏洞二。 漏洞一和漏洞三(TTL 写死、无续期)它管不了。
方案二:Redisson 看门狗,把续期交给框架
看门狗做的事很简单:锁默认 30 秒过期,后台线程每 10 秒检查一次业务是否还在跑,还在就续到 30 秒。 业务结束、unlock 之后不再续期。
三个漏洞一次解决:
| 漏洞 | Redisson 怎么处理 |
|---|---|
| TTL 写死 | 不再依赖业务耗时,续期跟着业务生命周期走 |
| 解锁非原子 | 内部走 Lua 脚本;锁的 value 是 UUID:threadId 复合值,用来做归属校验和可重入计数 |
| 无续期 | 看门狗自动续期 |
但别急着无脑上 Redisson
我在项目里最终是"Lua 先上、Redisson 备用",因为有个判断要说清楚:
Redisson 是为一个 TTL 问题引入一整个客户端。
- 它带进来的不只是锁,还有连接池、序列化配置、可重入计数、红锁等一整套;
- 看门狗续期本身是有代价的:只要 JVM 还活着、持锁线程没结束(哪怕业务线程卡死),续期就不会停,锁也就不会释放;
- 但它的边界也清楚:进程一旦被杀,续期随之消失,30 秒后锁自动释放。 所以它防的是"业务慢",防不了"线程假死";
- 如果你只用一个 Redis 单实例做锁,Redisson 的很多能力(RedLock、多节点)根本用不上。
顺带纠正一个我自己写错的版本:最初我写的是"看门狗会让锁永远不会自动释放"。这话只在"JVM 存活且线程卡死"这一个条件下成立,不是通例。
方案三:也许你根本不需要锁
写完上面这些,我回头看了一眼需求原文: "防止同一用户刷接口刷积分"。
然后我发现,锁从头到尾解决的都是另一个问题。
锁保证的是「同一时刻只有一个人 」。它管的是并发,不是重复。用户在第 1 秒发一次、第 11 秒再发一次,两把锁都拿得到,两次都加分------锁什么也没拦住。这也是为什么 lock:blog:{userId} 不是"1 次 / 10 秒的限流":业务耗时 200ms 时,第 3 秒来的请求照样能进。它是互斥,不是限流。
三种工具,管的其实是三件事:
| 你的真实需求 | 该用什么 | 管的维度 |
|---|---|---|
| 同一时刻只允许一个请求进临界区 | Redis 锁 / Redisson | 并发 |
| 允许重复,但限制频率(如"每分钟最多 30 次") | 令牌桶 / 滑动窗口 | 速率 |
| 同一个业务动作只生效一次(同一篇游记只加一次分) | 唯一索引幂等 | 重复 |
我的需求是第三行,而我一开始用了第一行的工具。
令牌桶听起来更接近,但它在我的场景里也是错的:限流允许"每 10 秒加一次分",一个用户挂个脚本一天能刷 8640 分。限流解决的是"不要太频繁",不是"不要重复"。
最后我改成了幂等:给积分流水表加唯一索引 (user_id, biz_key),biz_key 用业务单据生成(比如 blog:{blogId}),重复请求在插入这步就被数据库挡住,DuplicateKeyException 直接当成功返回。
同样是 100 并发,D 组的结果是这样:
| 组 | 保护方式 | 余额 | 同时进临界区峰值 | 用户看到的结果 |
|---|---|---|---|---|
| B | Redis 锁 | 10 | 1 | 99 个人收到 429 |
| D | 唯一索引 | 10 | 100 | 100 个人都收到成功 |
两组数据都对------都只加了一次分。区别在体验:锁把 99 个人挡在门外让他们重试,幂等让 100 个人都拿到"已完成",只是实际只算了一次。
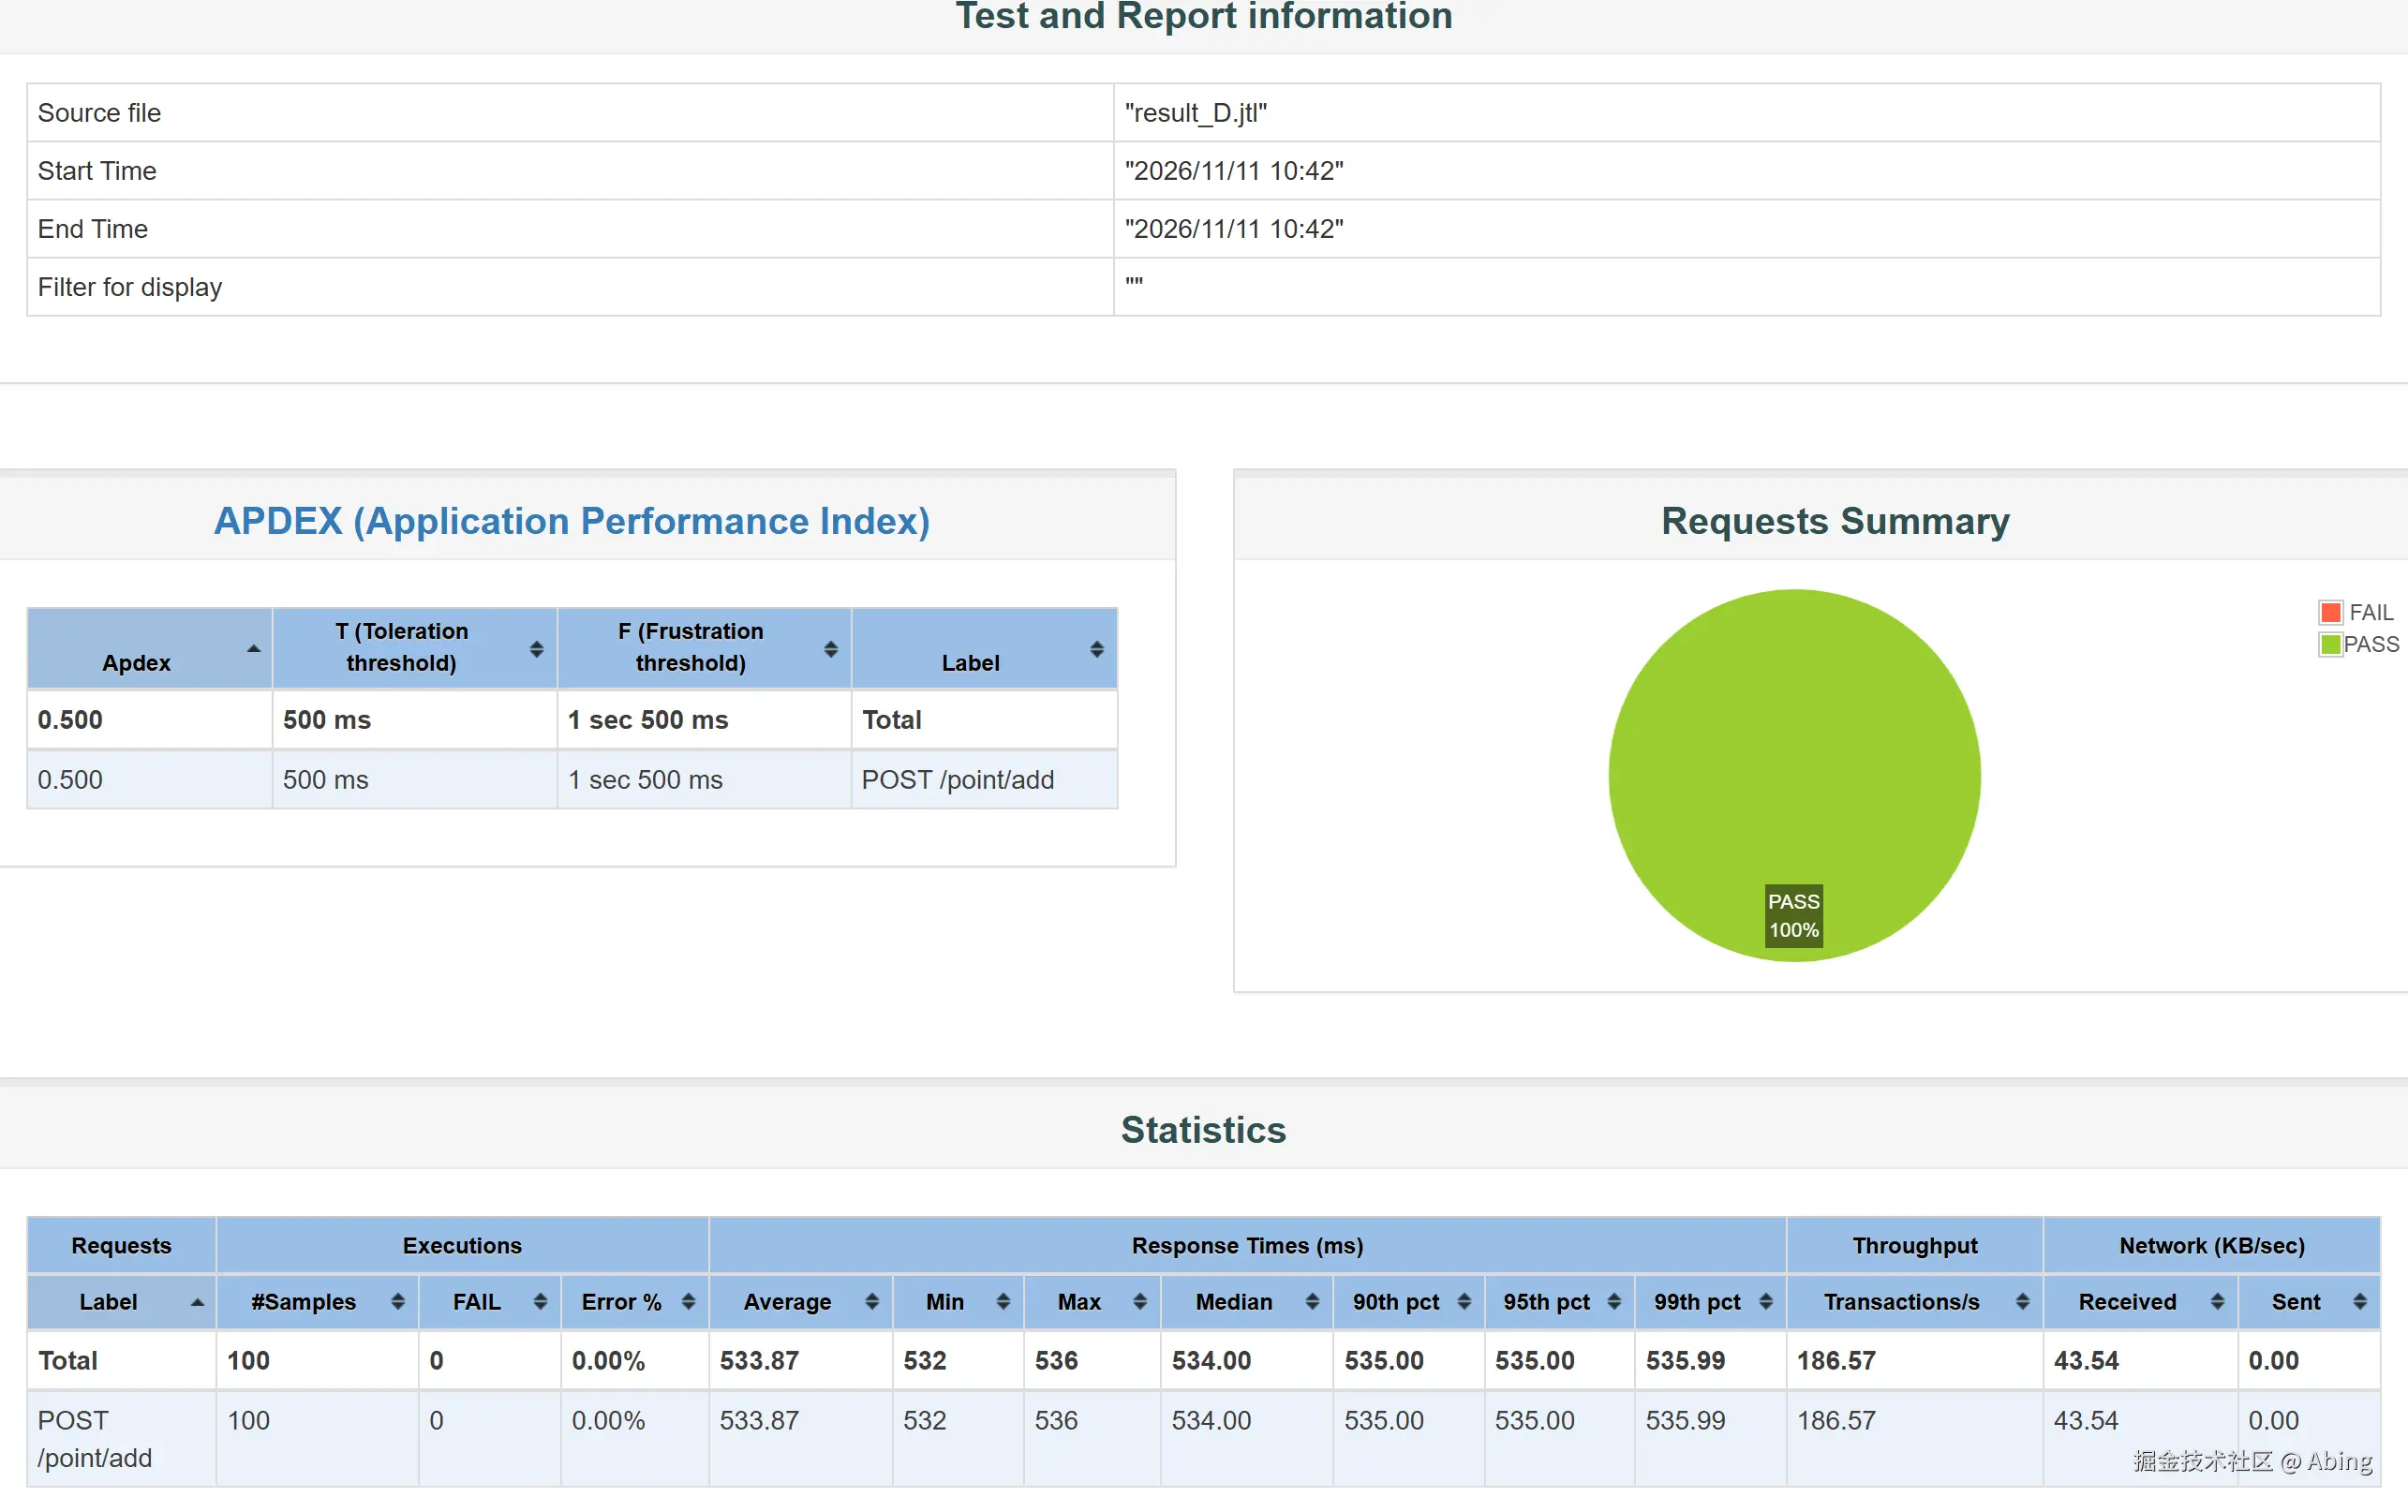
同样的 100 并发,Error % 是 0,100 个请求全部命中 200。对比上面 B 组那张 99% 标红的图------这就是"拒绝用户"和"去重"的差别。
对"防止刷积分"这个需求,第二种才是对的。用户重试不该是一种惩罚。 锁是用来保护临界区的,不是用来拒绝用户的。
还有一个细节值得记下:D 组的顺序必须是先插流水(闸门)再加余额 。反过来写,余额加完、插流水失败,回滚也救不回已经加掉的分数------而且加余额如果用 update ... set experience = #{新值} 这种读改写,高并发下还会丢更新。我用的是 set experience = experience + 10 的原子自增。
边界
- 单机 Redis,没做集群,所以没验证过主从切换时的锁失效问题(Redis 异步复制,主挂了可能丢锁);
- 看门狗在"持锁线程假死"时的行为我没压测过------理论上只要 JVM 活着就会一直续期,实际影响取决于业务超时配置;
- 实验里的"业务耗时"是
sleep模拟的,比真实接口更稳定。真实场景的耗时是长尾分布,TTL 被突破的概率比实验里更高,不是更低; - 幂等方案没覆盖"用户删了游记再重新发布"的情况------那会生成新的
blogId,算一次新的加分,这是业务上要单独确认的边界。
示例代码为重新编写的通用实现,不对应任何具体项目源码。文中所有压测数据来自本地最小复现工程(Spring Boot 3 + JMeter 5.6,2026-11-11 实跑)。