作者:vivo 互联研发效能团队- Wu Qinghua
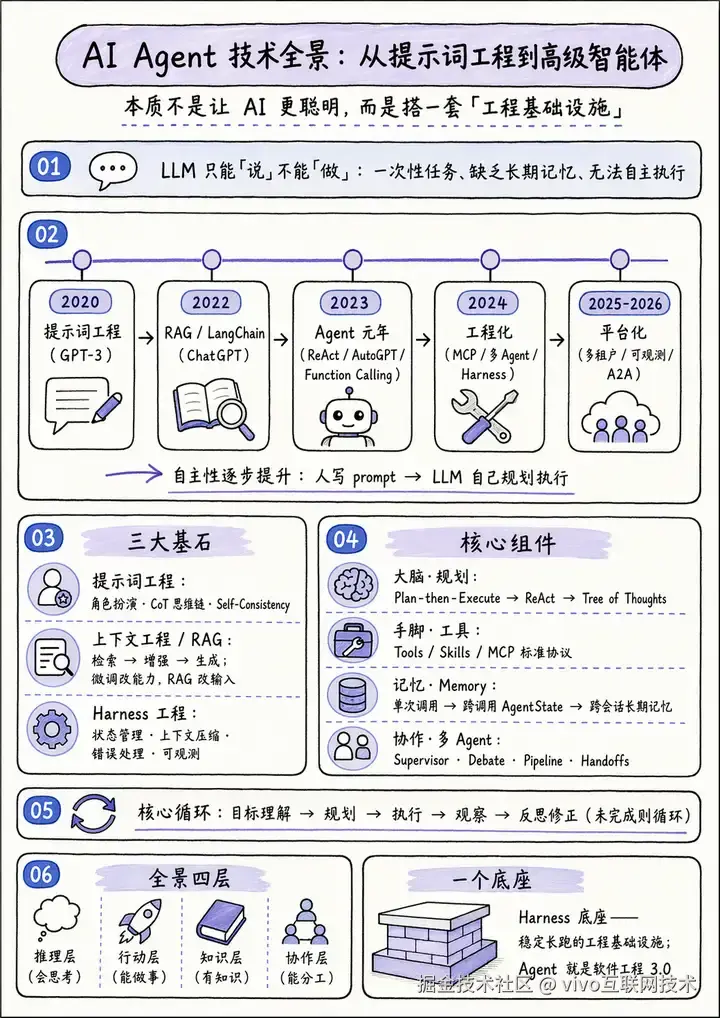
本文系统梳理了 AI Agent 技术演进全景,核心目标是构建能自主规划、调用工具、交付结果的"数字员工"。从提示词工程(如何精准传达意图),到 RAG(如何接入外部知识),再到 Harness 工程(如何让模型持续可靠运行),再到 ReAct 循环(如何赋予自主决策与执行能力),最后到多智能体协作。
1分钟看图掌握核心要点👇
引言:从"问答工具"到"数字员工"
我们熟悉的 AI 交互
大家都用过 ChatGPT 或类似的大语言模型。交互方式很简单:你问一个问题,它给一个回答。这种"对话式"交互已经很强大了,但仔细想想,它有三个明显的局限:
- **一次性任务:**每次对话都是独立的,它不会主动延续上次的话题
- **缺乏长期记忆:**换个窗口,它就把你忘了
- **无法自主执行:**它只能"说",不能"做"------不能帮你查数据库、发邮件、跑测试
打个比方:这就像一个博学但没有手脚、也没有记忆的顾问。你每次都得把背景重新交代一遍,他给你建议,但你得自己动手执行。
核心问题
我们真正想要的是什么?是一个能理解目标、自主规划、并执行复杂任务的"智能代理"------就像一个新员工,你给他一个任务,他会自己拆解步骤、调用工具、遇到问题会调整方案,最终交付结果。
这就是 AI Agent 要解决的核心问题。
一段简短的历史演进
在正式开始之前,让我们快速回顾一下这条技术路线是如何演进过来的------理解历史,能帮我们看清未来:
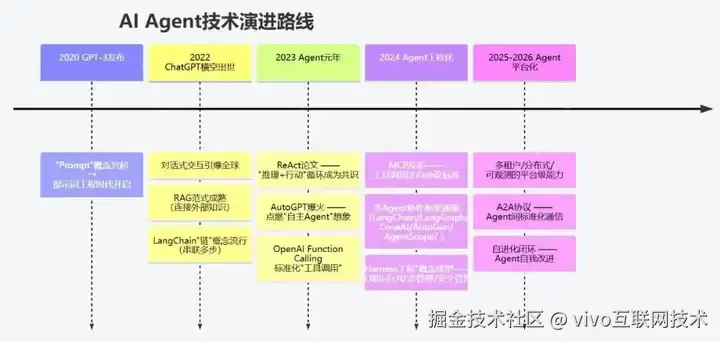
**一条主线贯穿始终:**从"人写好 prompt 让 LLM 执行",到"LLM 自己规划并执行"------自主性一步一步提升,每一步都伴随着新的工程挑战。
今天的路线图
本次分享,我将带大家走完这样一条路:
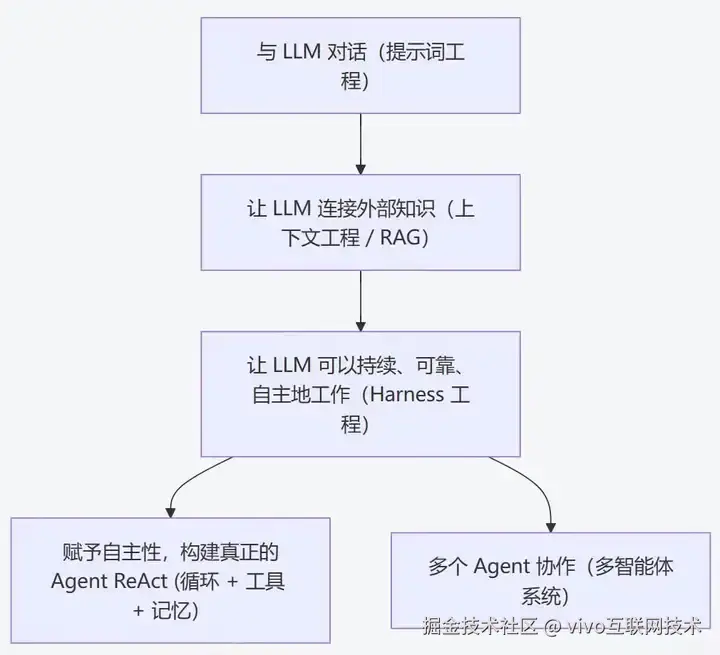
每一步都不是凭空出现的,而是前一步跑不动了,才催生了这一步。理解了这条因果链,你就理解了 Agent 的全貌。
一、基石:与 LLM 高效协作的艺术
在构建 Agent 之前,我们必须先掌握与 LLM 高效沟通的方法。这一部分讲三个层次的"协作艺术"。
1.1 提示词工程(Prompt Engineering)
**解决的问题:**如何精确地向 LLM 传达意图,获得高质量的回答?
这是人机协作的起点。LLM 的输出质量高度依赖输入------同样的问题,不同的"问法"可能得到天差地别的结果。这不是 bug,而是 LLM 概率推理本质的必然结果:prompt 决定了模型在概率空间中往哪个方向走。
底层原理:为什么 prompt 如此重要
要理解提示词工程为什么有效,需要回到 LLM 的工作原理。LLM 本质上是一个自回归语言模型------它做的事情是"给定前面的 token,预测下一个 token 的概率分布":
css
P(token_n | token_1, token_2, ..., token_{n-1})这意味着:
- **每一个 token 都会改变后续所有 token 的概率分布。**prompt 中的每一个词,都在把模型"推向"某个方向。这就是为什么角色设定("你是 Java 工程师")有效------它把后续 token 引向技术领域的概率空间。
- **LLM 没有真正的"理解"。**它不是先理解你的意图再生成回答,而是基于训练数据中的 pattern 统计,逐 token 生成最"像"训练数据中类似上下文的文本。Few-shot 示例有效,正是因为它在 prompt 中构造了"这种输入应该对应这种输出"的 pattern。
- **上下文窗口是注意力机制的作用范围。**Transformer 的自注意力机制让每个 token 都能"看到"窗口内的所有其他 token,但窗口之外的内容完全不可见。所以"放在上下文里"和"不在上下文里",对 LLM 来说是"存在"和"不存在"的区别。
理解了这些,你就会明白为什么 prompt 不是"花言巧语",而是控制 LLM 输出分布的工程手段。
基础技巧
-
**角色扮演:**给 LLM 一个明确的身份。"你是一个资深 Java 后端工程师"比"请回答以下问题"有效得多------它约束了输出范围,影响模型的注意力分布。
-
**清晰指令:**把任务要求说清楚、说具体。"写一个分页查询接口,用 MyBatis-Plus,返回 Result 包装"比"写个接口"好得多。
-
**Few-shot 示例:**给几个输入-输出的例子。LLM 是从例子中 pattern matching 的,给它看三个情感分析的例子,比单纯说"请分析情感"有效得多。
arduino// AgentScope 中的角色设定 + 结构化输出 ReActAgent agent = ReActAgent.builder() .name("weather_assistant") .sysPrompt("你是一个天气助手,可以查询不同的城市的天气情况,可以简洁的按照格式给用户回答。") .model("dashscope:qwen-plus") .build(); // 结构化输出------让 LLM 按 JSON Schema 返回,而非自由文本 public record WeatherResponse(String location, String temperature, String condition){} Msg result = agent.call( List.of(new UserMessage("旧金山天气如何?")), WeatherResponse.class ).block(); WeatherResponse weather = result.getStructuredData(WeatherResponse.class); // weather.location() → "San Francisco"
框架会根据模型能力自动选择路径:支持原生结构化输出的模型走 response_format 参数,不支持的走"合成工具 + 指令"的降级路径------但对调用方完全透明。
高级技巧
**思维链(Chain-of-Thought, CoT):**让 LLM "想一想再回答",把推理过程写出来。本质是把"一步到位的直觉判断"拆成"多步的显式推理",每一步都在缩小概率空间,降低单步出错率。这个思想后来直接演变成了 Agent 的 ReAct 循环。
CoT 之所以有效,有一个信息论视角的解释:直接生成最终答案时,模型需要在一个 step 内完成"从输入到答案"的全部映射,这个映射的熵很高(不确定性大),出错概率高。而 CoT 把这个映射拆成多个 step,每个 step 的熵更低(从"当前推理状态"到"下一步推理状态"的映射更确定),每步出错率更低,整体准确率就上去了。
**自洽性(Self-Consistency):**让 LLM 对同一问题多次推理(设 temperature > 0),取多数票结果。用"多个独立推理的共识"代替"单次推理的直觉",降低随机性。代价是成本翻 N 倍。
横向对比:不同提示策略的取舍
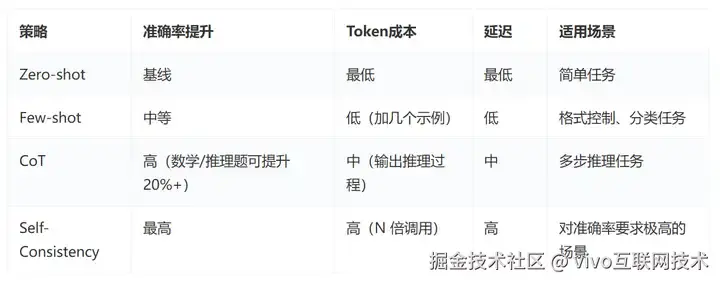
**一个趋势:**目前新一代的模型基本都开始把 CoT 内化到模型训练中------模型自己学会"内部思考",不再需要用户手动加 "think step by step"。但理解 CoT 的原理仍然重要,因为它是 ReAct 循环的思想源头。
类比:提示词工程就像给一个聪明但不了解你业务的新员工写"沟通指南"。指南写得越清楚,他交付的成果越符合预期。
1.2 上下文工程(Context Engineering)
**解决的问题:**LLM 的上下文窗口有限,如何处理需要外部知识或超长内容的任务?
提示词工程管的是"一次推理怎么说清楚",但很快我们会遇到一个问题:有些知识不在 prompt 里,LLM 根本不知道。比如公司内部的报销制度、最新的产品文档、某个客户的历史订单------这些不在 LLM 的训练数据中。
为什么不能直接微调(Fine-tuning)?
一个自然的问题是:既然 LLM 不知道私有知识,为什么不在私有数据上微调它?RAG 相比微调有什么优势?
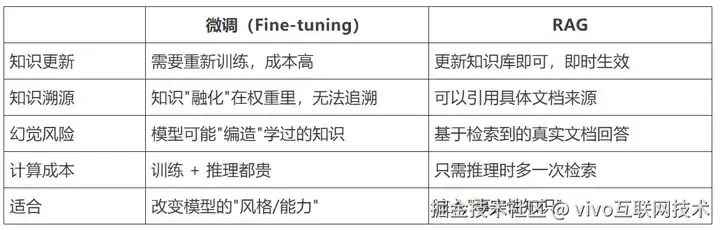
**核心区别:**微调改变的是模型的"能力"(怎么回答),RAG 改变的是模型的"输入"(基于什么回答)。事实性知识适合 RAG(可更新、可溯源),行为模式/领域推理能力适合微调。两者不互斥,实际系统常常组合使用。
RAG 的工作流程
RAG(Retrieval-Augmented Generation,检索增强生成) 的核心流程:
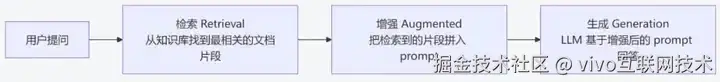
RAG 的精妙之处在于:**不把所有知识塞进 LLM,而是在需要时按需检索。**就像人不需要把百科全书背下来,遇到问题时去查就行。
底层原理:向量检索是怎么工作的
具体怎么"查"?通常用向量检索:
- **文档预处理:**把文档切成片段(通常 200-500 token 一段),每个片段用 embedding 模型转成向量(一个几百到几千维的浮点数数组)
- **查询时:**用户问题也用同一个 embedding 模型转成向量
- 相似度计算:计算问题向量与每个文档向量的余弦相似度,取最相关的 Top-K
为什么 embedding 能捕捉语义相似度? embedding 模型在训练时,学会了把"语义相近"的文本映射到"空间相近"的向量。比如"如何报销差旅费"和"差旅费报销流程"这两个短语,虽然用词不同,但 embedding 向量的余弦相似度会很高。这比关键词匹配强得多------关键词匹配找的是"字面相同",向量检索找的是"意思相近"。
scss
    // AgentScope 中接入知识库的代码示例
    KnowledgeBase kb = new BailianKnowledge(baseConfig);

    ReActAgent agent = ReActAgent.builder()
            .name("assistant")
            .model("dashscope:qwen-max")
            .knowledgeBase(kb)        // 注册知识库
            .build();

    // Agent 在需要领域知识时会自动检索知识库
    Msg result = agent.call(
            List.of(new UserMessage("我们公司的差旅费报销标准是什么?")),
            RuntimeContext.empty()
    ).block();
    // Agent 内部:检索"差旅费报销"相关文档片段 → 拼入 prompt → LLM 基于文档回答
RAG 的进阶:不只是"检索+拼接"
朴素 RAG(检索 Top-K 拼入 prompt)有很多变体来提升效果:
- **混合检索:**向量检索(语义)+ 关键词检索(BM25,精确匹配)+ 重排序,取长补短
- **查询改写:**LLM 先把用户问题改写得更适合检索(如"那个报销的事" → "差旅费报销标准 流程")
- **分块策略:**按语义切分而非固定长度,或用父子文档(检索子块、返回父块获取更多上下文)
- **多跳检索:**第一轮检索结果中发现新线索,再检索一轮(适合"A 公司的 CEO 之前在哪家公司"这种需要推理的问题)
RAG 解决了两个关键问题:知识过时 (知识库可以随时更新)和幻觉(LLM 基于检索到的真实文档回答,而非凭空编造)。它也是后面 Agent 连接外部知识库的基础。
类比:如果提示词工程是给新员工写"沟通指南",那 RAG 就是给他配一个"公司内部文档检索系统"------他不需要背下所有文档,需要时搜一下就行。
1.3 Harness 工程(Agent的运行时基础设施)
**解决的问题:**单一的 Prompt 无法完成复杂任务,如何将多个 LLM 调用串联起来,形成工作流?
从"链"到"Harness"的演进
到目前为止,我们讲的都是"一次 LLM 调用"。但真实任务往往需要多步:
- 先理解用户意图 → 再检索相关知识 → 再生成回答 → 最后格式化输出
- 先写代码 → 再跑测试 → 测试失败则修改 → 再跑测试
2022 年,LangChain 提出了"链(Chains)"的概念------把多个 LLM 调用(以及非 LLM 的处理步骤)用代码串成一条流水线。这是最早的流程编排尝试:
ini
    # LangChain 的早期"链"范式(伪代码)
    chain = LLMChain(
        llm=OpenAI(),
        prompt=PromptTemplate("翻译以下文本为英文:{text}")
    )
result = chain.run(text="你好世界")但"链"有一个根本局限:它是开发者硬编码的固定流程。链走哪条路、在哪分叉、在哪循环,都是写死的。一旦任务需要"根据情况动态决定下一步做什么",链就力不从心了。
这就催生了从"链"到"Agent"的转变------而 Agent 需要长期运行、状态管理、安全管控等工程基础设施,这就是 Harness 工程。
Harness 工程 关心的是**运行时基础设施:**让一个自主 Agent 能长期、可靠地跑起来,需要哪些支撑层。它解决的不是"走哪条路",而是"在路上怎么不翻车"。
在 AgentScope 2.0 中,这套编排能力被系统化为 Harness 工程。它不只是把调用串起来,还解决了:
- **状态管理:**每一步的中间结果如何保存和传递
- **上下文压缩:**多步对话后上下文膨胀怎么办(自动摘要 + 大结果落盘)
- **错误处理:**某一步失败了如何重试或降级
- **可观测性:**整个流程的执行过程如何追踪和调试
底层原理:Middleware 洋葱模型
Harness 的核心扩展机制是 Middleware(中间件)------它借鉴了 Web 框架(如 Express、Koa)的"洋葱模型",在 ReAct 循环的关键时机插入自定义逻辑:
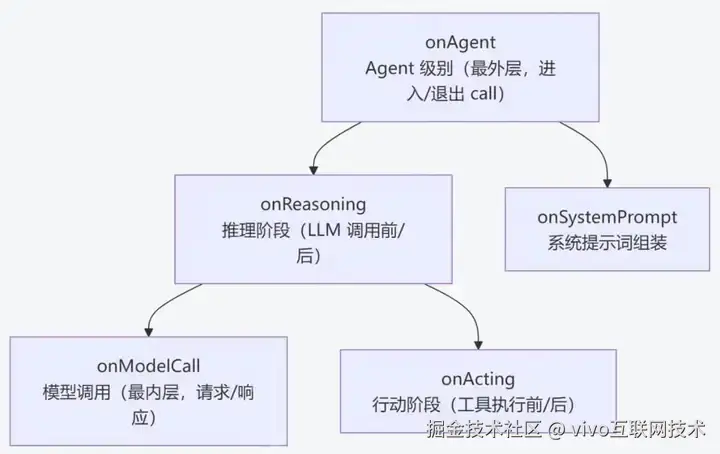
每个 middleware 可以在"前"和"后"两个时机介入。比如你可以写一个审计 middleware,在 onActing 的"前"记录"即将调用什么工具",在"后"记录"工具返回了什么"------而不影响其他逻辑。
scss
    // 自定义 Middleware 示例:记录所有工具调用到审计日志
    publicclassAuditMiddlewareextendsMiddlewareBase {

        @Override
        public Mono<Void> onActing(ActingContext ctx, MiddlewareNext next){
            String toolName = ctx.getToolCall().getName();
            String userInput = ctx.getToolCall().getInput().toString();
            auditLog.info("工具调用开始: tool={}, input={}", toolName, userInput);

            return next.proceed(ctx)
                    .doOnSuccess(v -> {
                        String result = ctx.getToolResult().getTextContent();
                        auditLog.info("工具调用完成: tool={}, resultLen={}",
                                toolName, result.length());
                    });
        }
    }

    ReActAgent agent = ReActAgent.builder()
            .name("audited_agent")
            .model("dashscope:qwen-max")
            .middlewares(List.of(new AuditMiddleware()))
            .build();
**关键设计:**Harness 的内置能力(压缩、记忆、子 Agent、Plan Mode)全部以 middleware 形式实现,钩在 ReAct 循环的关键时机上。核心推理算法本身不变,Harness 只往里加东西。这意味着你可以按需开启------不需要的全关掉,Agent 依然能跑。
横向对比:主流编排框架
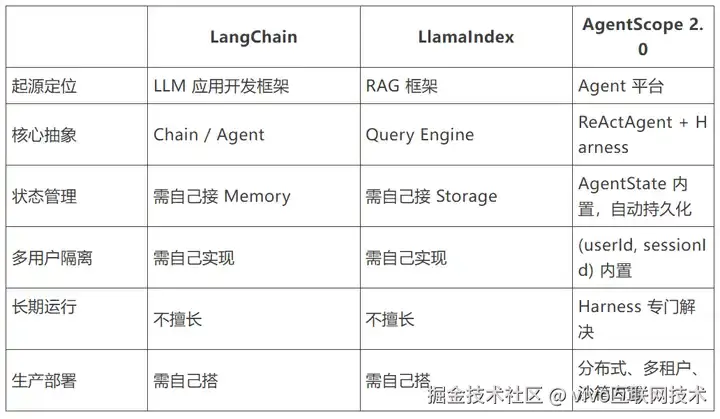
**选型建议:**简单的 LLM 应用用 LangChain 快速搭原型;以 RAG 为核心的应用用 LlamaIndex;需要构建生产级自主 Agent 用 AgentScope。三者不是互斥的------AgentScope 也可以接入 LlamaIndex 的检索能力。
**Harness 工程将 LLM 从一个"单点工具"变成"流水线"中的一个环节,**是通向 Agent 自动化的关键一步。
**类比:**如果提示词工程是"沟通指南",RAG 是"文档检索系统",那 Harness 工程就是"标准作业流程(SOP)"------把多个步骤编排成一条可重复、可监控的流水线。
二、核心:构建自主工作的 AI Agent
前面三块基石,本质上都还是"人驱动、LLM 执行"的模式。现在,我们进入真正的 Agent 领域------赋予 AI 自主性。
2.1 Agent 的"大脑"------规划与决策(Planning & Decision-Making)
**解决的问题:**面对复杂目标,Agent 如何自主决定"先做什么,后做什么"?
规划范式的演进
Agent 的规划能力经历了几代演进,每一代都在解决上一代的局限:
第一代:Plan-then-Execute(先规划后执行)
**思路:**先用 LLM 生成一个完整的计划,然后逐步执行。
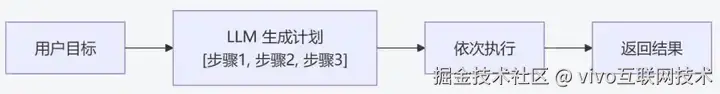
**局限:**计划是静态的。执行中发现某步走不通,整个计划就废了------而真实世界中"执行中发现意外"是常态。
第二代:ReAct(推理+行动交错)------当前主流
ReAct(Reason + Act) 的核心思想是推理和行动交错执行:
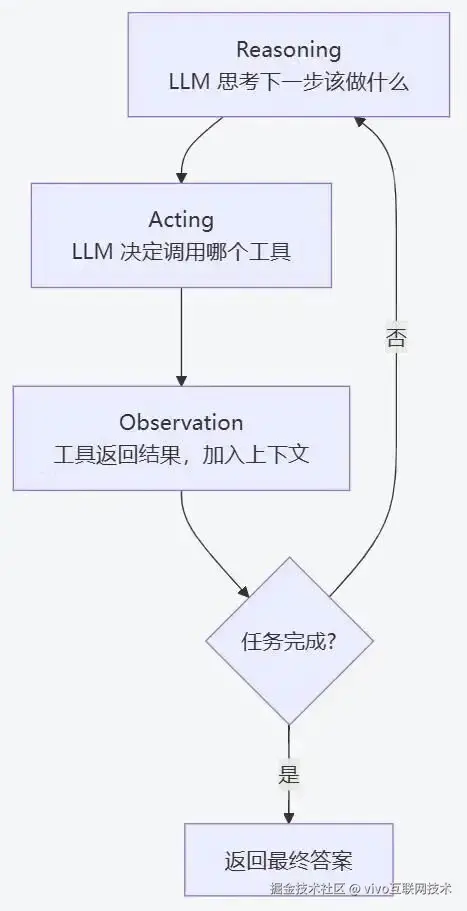
ReAct 的精妙之处:不是"先想好所有步骤再执行"(纯规划),也不是"盲目执行不思考"(纯行动),而是"想一步、做一步、看结果、再想下一步"。这更接近人类解决陌生问题的方式。
ReAct 循环内部实际给 LLM 的 prompt 大致是这样的(简化版):
yaml
    你是一个能使用工具的助手。请按以下格式回答:

    Thought: 我需要先理解用户想要什么...
    Action: search_web
    Action Input: {"query": "Spring Boot 3.2 新特性"}

    (框架执行工具,返回结果)

    Observation: Spring Boot 3.2 主要更新包括...

    Thought: 现在我知道了主要特性,可以总结了
    Action: [无需工具,直接回答]
    Final Answer: Spring Boot 3.2 的主要新特性包括...
**每一轮迭代中,LLM 都能看到:**之前所有的 Thought、Action、Observation。这意味着它可以根据执行结果动态调整后续计划------这是 Plan-then-Execute 做不到的。
第三代:Tree of Thoughts / MCTS(树状搜索)------前沿探索
ReAct 是"单链推理"------一条路走到底。但有些复杂问题需要"探索多条路径,回溯不靠谱的分支"。Tree of Thoughts 把推理组织成一棵树,支持分支探索和回溯,类似下棋 AI 的蒙特卡洛树搜索(MCTS)。
代价是成本高很多(每个节点都是一次 LLM 调用),目前主要在研究阶段,生产中很少用。
横向对比:三种规划范式
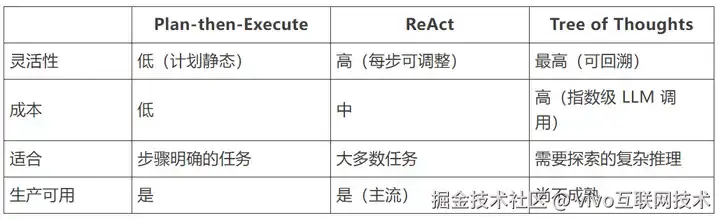
对于特别复杂的任务,ReAct 之上还可以叠加 Plan Mode:Agent 先在只读模式下分析任务、生成一个计划文件,用户审核计划后,Agent 再按计划执行。这实现了意图与动作的解耦------先想清楚要做什么,再动手做。
2.2 Agent 的核心循环与架构
Agent 与普通 LLM 应用的本质区别是什么?是"自主性"。
普通 LLM 应用是"你给一个输入,它给一个输出"。而 Agent 是"你给一个目标 ,它自己决定怎么做,做完告诉你结果"。
传统程序 vs Agent:控制权的转移
理解 Agent,最好从它与传统程序的根本区别入手:
**传统程序:**控制流是开发者写死的。if-else 怎么分叉、for 循环几次、调用哪个函数------都是预先确定的。程序是"开发者控制的执行体"。
**Agent:**控制流由 LLM 在运行时动态决定。下一步做什么、调用什么工具、什么时候停止------都由 LLM 根据当前上下文判断。程序变成了"LLM 驱动的执行体"。
这是一次根本性的转变:控制权从开发者转移到了 LLM。开发者不再编写"执行逻辑",而是编写"执行框架"------框架定义了 LLM 可以在哪些点做什么决策,但具体决策内容由 LLM 自己根据上下文判断。
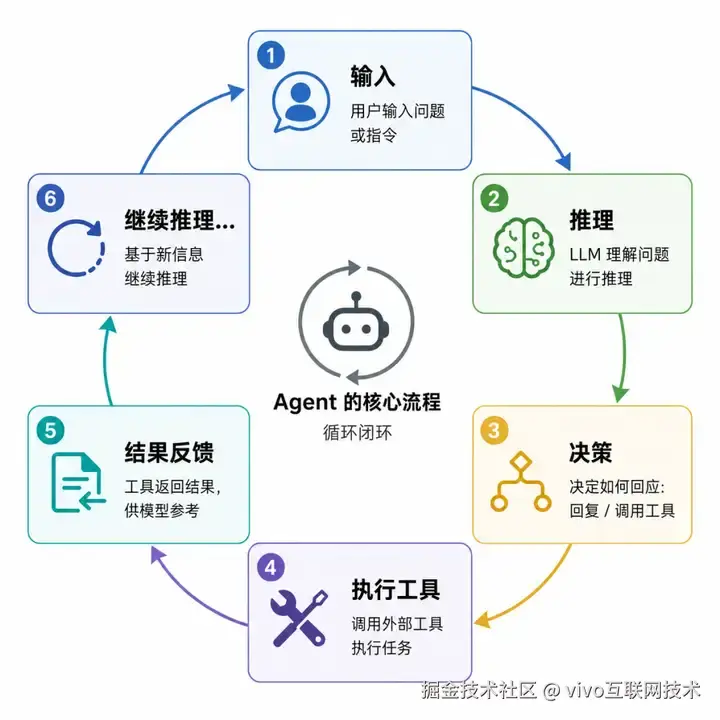
实现这种自主性的,是 Agent 的核心控制循环:
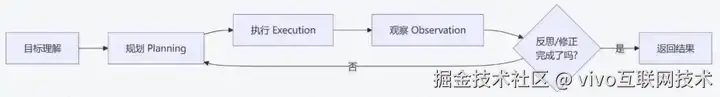
这个循环的每个环节:
- **目标理解:**把用户的自然语言请求,转化为可执行的任务目标
- **规划:**把大目标拆成可执行的子步骤
- **执行:**调用工具完成每个子步骤
- **观察:**获取工具执行的结果
- **反思/修正:**根据结果判断是否完成,没完成则调整计划
AgentScope 中的实际控制流
在 AgentScope 中,这个循环的具体实现是 ReActAgent 的主循环:
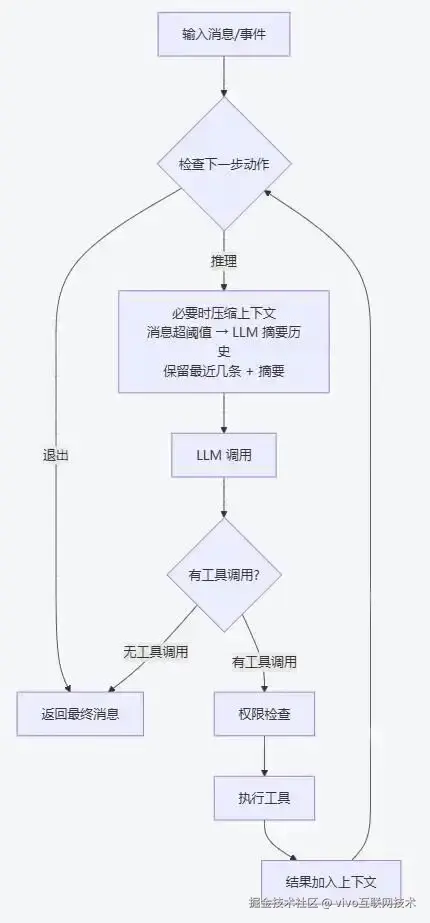
几个值得注意的运行机制:
- **迭代上限:**循环不是无限的。maxIters(默认 10)限制了最大迭代次数,防止 Agent 陷入死循环
- **并发工具调用:**如果 LLM 一次返回多个工具调用,Agent 可以并发执行(标记了 concurrency
-Safe 的工具) - **权限闸门:**每次工具执行前都走权限检查(允许/询问/拒绝),敏感操作会暂停等待人工确认
- **中断恢复:**支持 interrupt(userId, sessionId) 精确中断某个 session,中断后状态自动保存,下次调用从中断点恢复
这个循环是理解后续所有组件的框架------工具是"执行"环节的手脚,记忆是贯穿全循环的状态,知识库是"规划"和"执行"的参考。后面讲的每个组件,都可以对应到循环中的某个位置。
2.3 Agent 的"手"和"脚"------工具(Tools)与技能(Skills)
**解决的问题:**LLM 本身无法与外部世界交互(调用 API、读写文件、执行代码),如何赋予它行动能力?
工具(Tools)
工具就是 Agent 可以调用的外部函数。对 LLM 来说,一个工具需要暴露三件事:名称、描述、参数格式。LLM 根据这些信息决定"什么时候用哪个工具"。
底层原理:Function Calling 是怎么工作的
工具调用的完整流程涉及 LLM 和框架的协作:
swift
    1. 框架把工具的 JSON Schema 注入 LLM 请求
       POST /v1/chat/completions
       {
         "messages": [...],
         "tools": [{
           "type": "function",
           "function": {
             "name": "get_current_time",
             "description": "返回指定时区的当前时间",
             "parameters": {"type": "object", "properties": {"timezone": {"type": "string"}}}
           }
         }]
       }

    2. LLM 决定是否调用工具。如果调用,返回的不是普通文本,而是一个结构化的 tool_call:
       {
         "tool_calls": [{
           "id": "call_abc123",
           "function": {"name": "get_current_time", "arguments": "{\"timezone\": \"Asia/Shanghai\"}"}
         }]
       }

    3. 框架解析 tool_call,执行对应的 Java 方法,拿到结果

    4. 框架把工具结果作为新消息加入上下文,再次调用 LLM
       → LLM 基于工具结果继续推理
**关键点:**LLM 本身不"执行"工具,它只是输出一个"我想调用这个工具"的结构化指令。真正执行工具的是框架代码。LLM 做的是"决策",框架做的是"执行"。
less
    // AgentScope 用注解定义工具,框架自动推导 JSON Schema
    @Tool(name = "get_current_time",
          description = "返回指定时区的当前时间",  // 这个描述决定了 LLM 用不用它
          readOnly = true)
    public String getCurrentTime(
            @ToolParam(name = "timezone", description = "IANA 时区,如 Asia/Shanghai")
            String timezone) {
        return LocalDateTime.now(ZoneId.of(timezone))
                .format(DateTimeFormatter.ISO_LOCAL_DATE_TIME);
}这里有一个关键点:工具的描述必须详细具体。"数据查询工具"远不如"查询指定日期范围内的订单数据,支持按客户ID筛选"有效------因为 LLM 是靠描述来决策的。
当工具数量多了,会带来两个问题:上下文膨胀(每个工具的 schema 都占 token)和决策干扰(工具太多,选错率上升)。解决方案是工具组(Tool Group):把工具分组,运行时只激活当前任务相关的组------这就是"按需披露"。
java
    // 工具组:按需激活
    ToolGroup database = new ToolGroup(
            "database", "数据库操作工具",
            ToolGroupScope.SESSION, /* active = */false);
    database.addTool("db_query");
    database.addTool("db_migrate");

    ReActAgent agent = ReActAgent.builder()
            .name("router")
            .toolkit(toolkit)
            .enableMetaTool(true)   // 启用 reset_tools 元工具,让 Agent 自己切换工具组
            .build();
    // Agent 遇到数据库任务时,自己调用 reset_tools 激活 database 组
MCP(Model Context Protocol)
**解决的问题:**工具提供方和 Agent 框架的解耦。
如果没有 MCP,你用 AgentScope 写的工具,换成 LangChain 就得重写。每换一个框架,工具生态就重建一遍。
MCP 是一个标准化协议:工具提供方按 MCP 协议实现一个 server,任何支持 MCP 的 Agent 框架都能接入。它让工具变成可复用、可独立部署的"微服务"。
MCP 的协议设计
MCP 定义了三种连接方式,对应不同的部署场景:
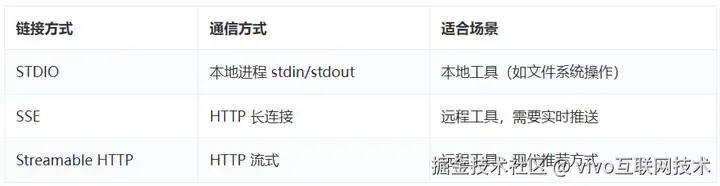
MCP server 启动后会暴露一个工具列表,客户端(Agent 框架)连接后自动发现可用工具。这跟微服务的"服务注册与发现"是同一个思想。
scss
    // 接入一个远程 MCP server 只需几行代码
    McpClientWrapper weather = McpClientBuilder.streamableHttp()
            .name("weather").url("https://api.weather.com/mcp")
            .header("Authorization", "Bearer xxx")
            .build();

    Toolkit toolkit = new Toolkit();
    toolkit.registerMcpClient(weather).block();
    // 框架自动处理协议协商、工具发现、结果转换
    // MCP 工具在 toolkit 中以 mcp__weather__get_forecast 命名,避免冲突
类比:MCP 之于 Agent 工具,就像 HTTP 之于 Web 服务------一个标准协议,让生产者和消费者解耦。就像你不需要关心一个 REST API 是用 Java 还是 Python 写的,MCP 让你不需要关心一个工具是跑在哪个 Agent 框架里。
技能(Skills)
工具是"能做什么"(能力),但 Agent 每次处理同类任务都从零摸索------它不记得"上次怎么做最有效"。
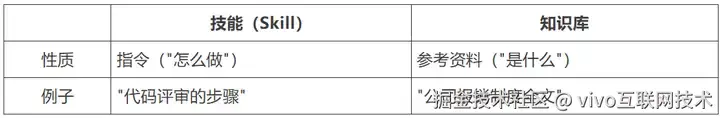
技能(Skill) 解决的就是这个问题:它是 Agent 的 SOP,一份可复用的工作流程文档。本质是 Markdown 指令,告诉 Agent "遇到这类任务该怎么做"。
objectivec
code-reviewer/           ← 一个技能就是一个目录
├── SKILL.md             ← 指令文档:"先搜代码、再读文件、按检查清单评审"
├── references/          ← 参考资料(如代码风格规范)
└── scripts/             ← 可执行脚本(如自动化检查脚本)
**技能 vs 工具的本质区别:**工具是"一个可调用的函数",技能是"一套工作流程的指令"。技能不能直接调用------Agent 先读取技能指令,再用已有工具按指令执行。技能是"知识",不是"动作"。
更进阶的是,Agent 可以自己起草技能------成功经验自动沉淀为技能草稿,经审核后变成正式技能。这就是 Agent 的"自进化"能力:know-how 在每次运行之间累积。
2.4 Agent 的"记忆"------短期与长期(Memory)
**解决的问题:**如何让 Agent 记住对话历史、任务进度和过去经验,避免重复犯错?
LLM 本身是无状态的------两次调用之间,模型不记住任何东西。要让 Agent "有记忆",需要工程手段。
记忆问题的本质
"记忆"听起来是一个概念,但实际包含三个不同层次的问题:
- **单次调用内的记忆:**一次 call() 内多轮 ReAct 循环中,前一步的结果如何传到下一步?→ 靠上下文(AgentState.context)
- **跨调用的记忆:**用户上一次对话说的内容,这次对话还记得吗?→ 靠 AgentState 持久化
- **跨会话的记忆:**上个星期对话中提取的经验,这次新对话能用上吗?→ 靠长期记忆系统
这三层问题的解决方案完全不同,不能混为一谈。
记忆分两层:
短期记忆------会话记忆(Session Memory)
管理单次任务/对话中的上下文。核心载体是 AgentState,它不只存对话历史,还存权限规则、任务清单、工具激活状态等所有影响推理的运行时状态:
css
AgentState
├── context              ← 对话历史(用户输入、assistant 回复、工具调用、工具结果)
├── summary              ← 压缩后的摘要(上下文超阈值时生成)
├── permissionContext    ← 工具权限规则(哪些工具允许/询问/拒绝)
├── planModeContext      ← Plan Mode 状态(当前是否在规划阶段)
├── tasksContext         ← 任务清单(todo_write 维护的子任务列表)
└── toolContext          ← 工具组激活状态(当前激活了哪些工具组)
为什么权限规则和任务清单也放在 AgentState 里? 因为它们都影响 LLM 的推理决策。权限规则决定 LLM 知道"哪些操作可以做",任务清单决定 LLM 知道"当前进度到哪了"------这些和对话历史一样,都是推理时需要看到的上下文。
在 AgentScope 中,Agent 实例本身是无状态的------所有状态按 (userId, sessionId) 外部化存储:
less
    // 配置 Redis 状态存储------生产环境推荐
    ReActAgent agent = ReActAgent.builder()
            .name("assistant")
            .model("dashscope:qwen-plus")
            .stateStore(new RedisAgentStateStore(jedis))  // 分布式状态存储
            .build();

    // 第一次调用------创建会话,Agent 查了航班信息
    agent.call(List.of(new UserMessage("帮我查北京到上海的航班")),
            RuntimeContext.builder().userId("alice").sessionId("s1").build()).block();

    // 第二次调用------自动恢复上次的 AgentState,Agent 知道"最便宜的"指什么
    agent.call(List.of(new UserMessage("最便宜的是哪个")),
            RuntimeContext.builder().userId("alice").sessionId("s1").build()).block();
一个 Agent 实例可以同时服务成千上万个用户,互不干扰。状态存储用 Redis 等分布式后端时,还能实现跨机器的故障转移和滚动发布零中断------不同物理机上的 Agent 实例都能拿到完全一致的状态。
长期记忆(Long-term Memory)
会话记忆是"短期记忆"------会话结束就归档了。但有些信息是跨会话的:用户偏好、项目约定、历史经验。这些不应该靠用户每次重说一遍。
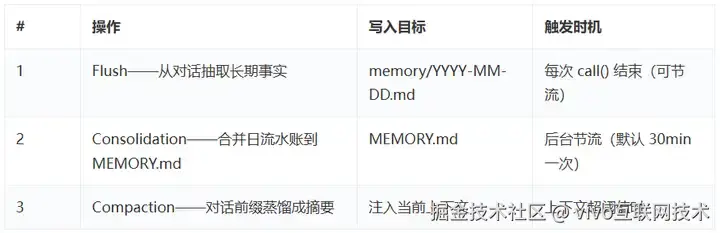
AgentScope 的长期记忆分两层,解决"既要记住长期事实,又不能让上下文无限增长"的矛盾:
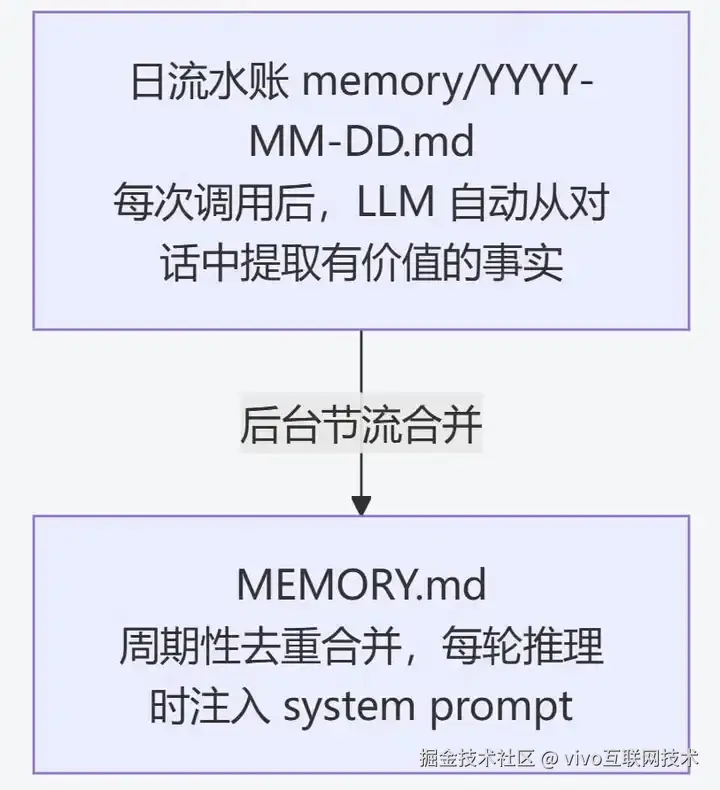
这里有三处独立的 LLM 调用,每一处都有自己的 prompt 和触发时机:
less
    // 记忆系统配置------可以用小模型跑记忆操作,省成本
    HarnessAgent agent = HarnessAgent.builder()
        .model("openai:o3")                      // 主推理模型(强)
        .memory(MemoryConfig.builder()
            .model("openai:gpt-4.1-mini")        // 记忆操作用小模型(便宜)
            .flushTrigger(MemoryConfig.FlushTrigger.throttled(
                    Duration.ofMinutes(10)))      // 最多每 10 分钟 flush 一次
            .build())
        .compaction(CompactionConfig.builder()
            .triggerMessages(30)                  // 30 条消息触发压缩
            .keepMessages(10)                     // 保留最近 10 条
            .model("openai:gpt-4.1-mini")        // 压缩也用小模型
            .build())
        .build();
Agent 还获得 memory_search 工具,可以主动检索历史记忆。这就像人有"日记本"和"经验总结"------日记记原始事实,经验总结是提炼后的智慧。
横向对比:记忆方案的选择
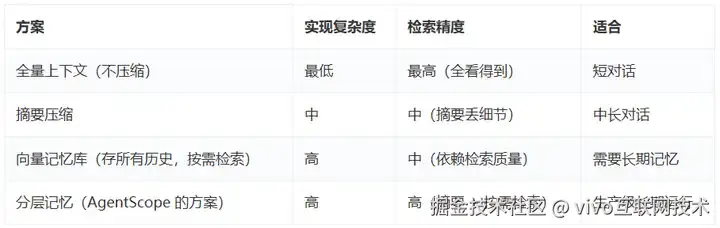
类比:Session 是"工作记忆"(你正在想的事),Memory 是"长期记忆"(你积累的经验)。
2.5 Agent 的"知识库"(Knowledge Base)
**解决的问题:**Agent 如何获取执行任务所需的专业领域知识?
这里我们回到第一部分讲的 RAG。知识库是 Agent 获取静态领域知识的主要来源------公司制度文档、产品技术文档、行业规范等。
知识库 vs 记忆的区别(这是容易混淆的点):
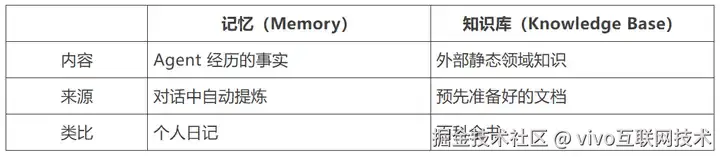
知识库 vs 技能的区别:
2.6 Agent 的"组织"------多智能体协作(Multi-Agent Systems)
**解决的问题:**单个 Agent 的能力有限------上下文污染、工具过多、无法并行。如何通过组织多个 Agent 协同工作来解决更宏大的
单 Agent 的瓶颈
随着任务复杂度增加,单 Agent 会遇到瓶颈。就像一个人要同时做设计、开发、测试、运维------不是做不到,而是效率低、容易出错。具体来说有三个瓶颈:
- 上下文污染:所有子任务的中间结果都堆在一个上下文里,互相干扰,LLM 注意力被稀释
- 工具过载:一个 Agent 要处理所有类型任务,工具列表越来越长,选错率上升
- 串行瓶颈:单 Agent 是串行执行的,无法同时处理多个独立子任务
子 Agent 的核心思想
子 Agent(Sub-Agent) 的核心思想是分工:每个子 Agent 有独立的上下文、工具集、人格和推理循环,可以并行执行,互不污染。
两种委派模式:
-
**同步委派:**主 Agent 调用子 Agent,等结果返回再继续------"我需要你的结果才能往下走"
-
**后台委派:**交给子 Agent 后不等待,完成后通过 system-reminder 自动推送结果------"你先做着,我干别的"
arduino// 声明式子 Agent:在 workspace/subagents/ 目录下放一个 Markdown 文件 // subagents/code-reviewer.md 内容: // --- // name: code-reviewer // sysPrompt: 你是一个代码评审专家,专注于发现潜在bug和代码规范问题。 // tools: [read_file, search_code, run_tests] // --- // 评审步骤: // 1. 读取目标代码 // 2. 检查常见问题模式 // 3. 给出结构化评审报告 // 主 Agent 通过 agent_spawn 创建子 Agent,agent_send 发送任务 // 子 Agent 独立运行,有自己的上下文和工具集
多智能体协作模式
以"软件开发团队"为例:
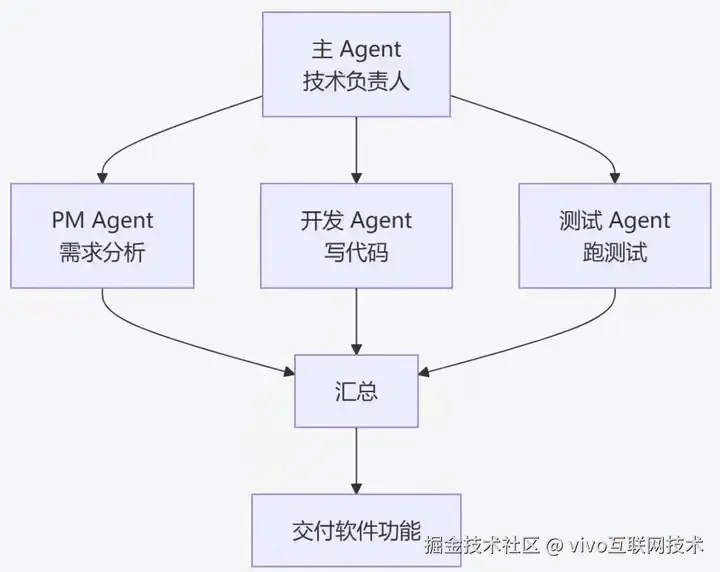
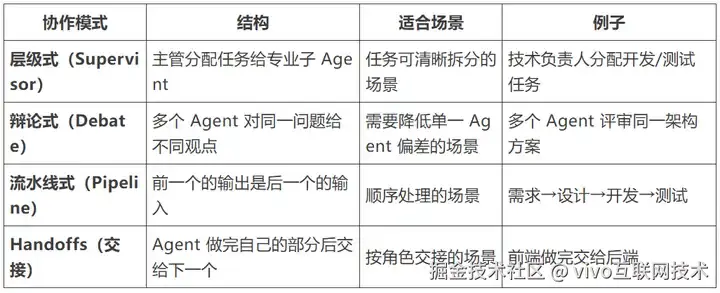
不同的协作模式适合不同场景:
Tool vs Skill vs Subagent 的层次关系:
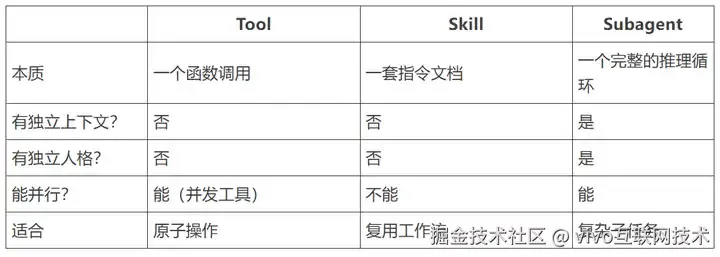
三者不是互斥的:子 Agent 内部会用到工具,也可能加载 Skill。它们是不同层次的抽象------Tool 是"手脚",Skill 是"方法手册",Subagent 是"另一个大脑"。
这就是从"一个全能 Agent"到"一个 Agent 团队"的演进------就像从"个人英雄"到"高效团队"。
三、实战指南:从概念到落地
前面两部分讲的是"Agent 是什么、怎么工作"。但真正落地时,你会发现"知道概念"和"做出好用的系统"之间还有很大的距离。这一部分,我们来看三个实战维度:在什么场景用、常见坑在哪里、最佳实践是什么。
3.1 典型应用场景:Agent 适合解决什么问题
不是所有问题都适合用 Agent。判断的核心标准是:任务是否需要"多步推理 + 动态决策 + 外部工具"。如果只需要一次 LLM 调用就能完成,用 Agent 是杀鸡用牛刀。
场景一:知识问答助手(RAG + 轻量 Agent)
**业务背景:**公司内部有大量文档(制度、产品文档、技术 wiki),员工查找效率低。
**为什么用 Agent:**单纯的 RAG 只能"检索+回答",但员工的真实需求往往需要多步------先查制度,再查配套流程,再结合个人情况给建议。
**架构:**知识库(RAG) + 轻量 Agent(ReAct 循环 + 2-3 个工具:检索、读文件、回答)
scss
    // 知识问答助手------最轻量的 Agent 应用
    ReActAgent agent = ReActAgent.builder()
            .name("kb_assistant")
            .sysPrompt("你是公司内部知识助手。回答时请引用文档来源。"
                    + "如果检索结果不足以回答,请明确告知而非编造。")
            .model("dashscope:qwen-plus")
            .knowledgeBase(kb)            // 知识库
            .maxIters(5)                  // 知识问答不需要太多轮迭代
            .build();
**落地建议:**这是 Agent 的"入门级"应用,ROI 容易量化(节省的查找时间)。先从这个场景切入,验证效果后再扩展。
场景二:代码工程助手(工具密集型 Agent)
**业务背景:**开发团队需要一个能读代码、跑测试、提交 PR 的 AI 助手。
**为什么用 Agent:**代码任务天然需要多步------理解需求→搜索相关代码→读取文件→修改代码→运行测试→根据测试结果修复→提交。每一步的结果都影响下一步怎么做,这是 ReAct 循环的典型场景。
**架构:**HarnessAgent + 工作区(代码仓库) + 工具集(read_file, write_file, execute_shell, search_code) + Plan Mode
scss
    HarnessAgent agent = HarnessAgent.builder()
            .name("code_engineer")
            .sysPrompt("你是一个代码工程师。修改代码前先理解上下文,"
                    + "修改后必须运行测试验证。")
            .model("dashscope:qwen-max")
            .workspace(workspace)               // 代码仓库作为工作区
            .enablePlanMode()                   // 复杂修改先出计划
            .compaction(CompactionConfig.builder()
                    .triggerMessages(20)         // 代码任务上下文增长快,提早压缩
                    .keepMessages(8)
                    .build())
            .build();
**落地建议:**代码场景的 Agent 效果显著,但安全风险也高------必须配权限系统和沙箱。建议先在只读模式(只分析不修改)下验证,再逐步放开写权限。
场景三:数据处理与分析 Agent(多工具协作)
**业务背景:**业务团队需要从多个数据源取数、清洗、分析、生成报表。
**为什么用 Agent:**数据分析的过程高度动态------先看数据结构,决定分析方向,写 SQL 取数,发现异常再深挖,最后出图。这种"边探索边决策"的过程,硬编码的 ETL 管道做不到。
**架构:**Agent + 多工具组(数据库查询、Python 执行、图表生成) + 知识库(业务指标定义)
java
    // 数据分析场景------工具组按需激活
    ToolGroup queryGroup = new ToolGroup("db", "数据库查询工具", ...);
    queryGroup.addTool("sql_query");
    queryGroup.addTool("schema_inspect");

    ToolGroup analysisGroup = new ToolGroup("analysis", "分析工具", ...);
    analysisGroup.addTool("python_execute");
    analysisGroup.addTool("plot_chart");

    ReActAgent agent = ReActAgent.builder()
            .name("data_analyst")
            .toolkit(toolkit)
            .enableMetaTool(true)       // 让 Agent 自己切换工具组
            .knowledgeBase(metricsKb)   // 业务指标定义
            .maxIters(15)               // 数据探索需要更多轮次
            .build();
**落地建议:**SQL 执行工具必须配只读数据库账号,Python 执行必须在沙箱中。数据分析 Agent 的价值在于"替代数据分析师的重复劳动",不是替代数据分析师本人。
场景四:多 Agent 协作------自动化研发流水线
**业务背景:**将需求分析、代码开发、代码评审、测试验证串联成自动化流水线。
**为什么用多 Agent:**每个环节需要不同的专业能力和工具集,放在一个 Agent 里会上下文污染、工具过载。
**架构:**Supervisor Agent + 4 个专业子 Agent(PM / Developer / Reviewer / Tester)
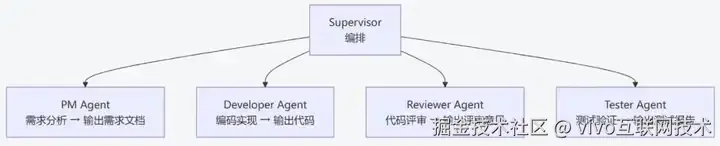
**落地建议:**多 Agent 系统复杂度高,建议在单 Agent 验证效果后再引入。初期可以用"人在回路"(HITL)替代部分子 Agent,逐步自动化。
不适合 Agent 的场景
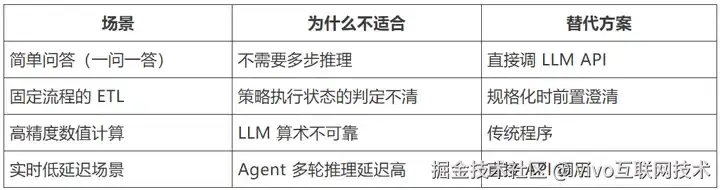
3.2 常见痛点与避坑指南
Agent 落地过程中,以下痛点几乎每个人都会遇到。这里把"踩过的坑"提前列出来。
痛点一:Agent "不按预期行动"------工具调用决策不准
**现象:**Agent 该用工具时不用,不该用时乱用;或者选错了工具。
**根因:**LLM 是根据工具的 description 来决策的。描述模糊、描述之间有重叠,都会导致选错。
避坑指南:
ini
❌ 坏的描述:description = "查询数据"
✅ 好的描述:description = "查询 MySQL 订单表中指定日期范围内的订单记录,
支持按客户ID和订单状态筛选。返回字段:订单号、金额、状态、创建时间。"- 工具描述要写到同事能看懂的程度------不只是"做什么",还要包括"输入是什么格式、输出是什么格式、什么时候该用"
- 工具之间不要有职责重叠------如果有两个工具都能"查数据",LLM 会困惑。合并它们,或者用更清晰的命名区分
- 给工具加 readOnly 标记------只读工具可以放心并发,框架会自动优化
痛点二:上下文爆炸------Token 成本失控
**现象:**长对话中 token 消耗线性增长,成本越来越高,效果反而越来越差("迷失在中间")。
**根因:**每轮 ReAct 循环都会往上下文加消息(推理过程 + 工具调用 + 工具结果),如果不管理,几十轮后上下文就爆了。
避坑指南:
less
    // 生产环境的标准配置
    HarnessAgent agent = HarnessAgent.builder()
            .compaction(CompactionConfig.builder()
                    .triggerMessages(20)          // 20 条就触发,不要等太多
                    .keepMessages(8)              // 只保留最近 8 条 + 摘要
                    .truncateArgs(CompactionConfig.TruncateArgsConfig.builder()
                            .maxArgLength(2000)   // 工具参数超 2000 字符就截断
                            .build())
                    .build())
            .toolResultEviction(ToolResultEvictionConfig.defaults())  // 大结果落盘
            .memory(MemoryConfig.builder()
                    .flushTrigger(MemoryConfig.FlushTrigger.throttled(
                            Duration.ofMinutes(10)))  // flush 节流,不是每次都跑
                    .model("dashscope:qwen-turbo")     // 记忆操作用便宜模型
                    .build())
.build();- **压缩阈值宁低勿高:**20 条消息触发压缩,比 50 条再压缩效果好------上下文越长,LLM 注意力越分散
- **大工具结果必须落盘:**read_file 读了个 100KB 的文件,全文进上下文就是灾难。配 toolResultEviction 让超 80K 的结果自动落盘
- **记忆操作用小模型:**flush 和 consolidation 不需要主模型那么强,用 qwen-turbo 等轻量模型能省 80% 成本
痛点三:Agent 陷入死循环------反复调用同一个工具
**现象:**Agent 反复调用同一个工具,或者在不同步骤间来回跳,无法收敛到最终答案。
**根因:**通常是 prompt 不够清晰,或者工具返回的结果让 LLM 误判了任务状态。
避坑指南:
-
设 maxIters 兜底:生产环境必须设,默认 10,复杂任务最多 20。宁可让 Agent "没做完就返回",也不能让它无限跑
-
工具结果要包含状态信息:不要只返回数据,还要告诉 LLM "这个操作成功了吗""还有多少没做"
// ❌ 坏的工具返回:只有数据,没有状态 return"Order #12345, amount: 100, status: pending";
// ✅ 好的工具返回:包含状态,帮助 LLM 判断下一步 return"查询成功。找到 1 条订单:Order #12345, amount: 100, status: pending。\n"
- "该订单处于待审批状态,你可以使用 approve_order 工具进行审批。";
-
用 TodoTools 让 Agent 跟踪进度:复杂任务开启 enableTaskList(),Agent 维护一个任务清单,每完成一项划掉,避免"忘了做到哪了"
痛点四:安全问题------Agent 执行了危险操作
**现象:**Agent 误删文件、执行了危险命令、把敏感数据发到了外部 API。
**根因:**Agent 有了行动力,也意味着有了破坏力。没有权限管控的 Agent 就像没有刹车的汽车。
避坑指南:
less
    // 生产环境的安全配置------三道防线
    ReActAgent agent = ReActAgent.builder()
            .permissionContext(PermissionContextState.STRICT)  // 严格权限模式
            .toolkit(toolkit)                                   // 工具白名单
            .build();

    // 第一道防线:工具粒度权限
    // 写操作工具必须标记 readOnly = false,框架会走权限检查
    @Tool(name = "delete_file", description = "删除指定文件",
          readOnly = false, dangerousDirectories = {"/etc", "/system"})
    public String deleteFile(@ToolParam(name = "path") String path){ ... }

    // 第二道防线:HITL 人工确认
    // 敏感操作触发 RequireUserConfirmEvent,暂停等待人工确认
    // 确认后规则可持久化------同类操作以后自动放行

    // 第三道防线:沙箱隔离
    // 不可信代码在 Docker 沙箱中执行,宿主不受影响
    HarnessAgent agent = HarnessAgent.builder()
            .filesystem(new DockerFilesystemSpec()...)  // 沙箱文件系统
.build();- 最小权限原则:Agent 初始权限只给只读工具,写操作需要审批。宁可多确认几次,也不要一上来就给全权
- 危险路径黑名单:delete_file、execute_shell 等工具要配 dangerousDirectories / dangerousCommands
- 沙箱是最后一道墙:即使权限系统失效,沙箱也能保证影响范围可控
痛点五:评估困难------不知道 Agent 效果好不好
**现象:**传统软件测试是"输入→断言输出",但 Agent 的多步推理 + 工具调用让输出变得非确定性------同样的输入可能走不同的路径。
避坑指南:
分层评估:
- **工具层:**每个工具单独测(传统单元测试)
- **推理层:**给定上下文,断言 LLM 是否选对了工具(批量用例)
- **端到端:**给定目标,断言最终结果是否正确(允许路径不同,只看结果)
**黄金集回归:**维护一批"标准问题+标准答案",每次模型升级或 prompt 修改后跑一遍
**可观测是前提:**必须能追踪 Agent 的每一步推理和工具调用。AgentScope 的 Studio 可视化工具就是干这个的
csharp
    // 开启可观测------生产环境必备
    ReActAgent agent = ReActAgent.builder()
            .name("observable_agent")
            .model("dashscope:qwen-max")
            .toolkit(toolkit)
            // 每一步推理、工具调用、工具结果都以事件流出
            .build();

    // 用 streamEvents 而非 call,实时追踪执行过程
    agent.streamEvents(userMsg)
            .doOnNext(event -> {
                switch (event.getType()) {
                    case TEXT_BLOCK_DELTA -> System.out.print(((TextBlockDeltaEvent) event).getDelta());
                    case TOOL_CALL_START -> log.info("工具调用: {}", ((ToolCallStartEvent) event).getToolCallName());
                    case TOOL_CALL_END -> log.info("工具完成: {}", ((ToolCallEndEvent) event).getToolCallName());
                }
            })
            .blockLast();
3.3 行业最佳实践
实践一:渐进式引入------从"HITL"到"全自动"
不要一上来就做全自动 Agent。推荐的分阶段路径:
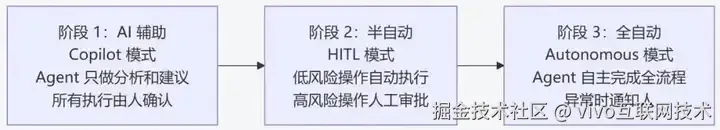
实践二:Model Routing------不同任务用不同模型
不是所有步骤都需要最强的模型。一个常见成本优化策略:
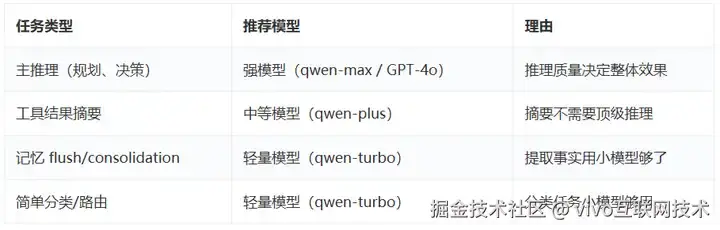
less
    // 主模型用强模型,辅助操作用小模型
    HarnessAgent agent = HarnessAgent.builder()
            .model("dashscope:qwen-max")              // 主推理
            .memory(MemoryConfig.builder()
                    .model("dashscope:qwen-turbo")    // 记忆操作
                    .build())
            .compaction(CompactionConfig.builder()
                    .model("dashscope:qwen-turbo")    // 压缩摘要
                    .build())
            .build();
    // 这样整体成本能降 40-60%,效果几乎无损
实践三:Skill 沉淀------让 Agent 越用越强
团队在使用 Agent 的过程中,会积累大量有效的工作模式。把这些模式沉淀成 Skill,让 Agent 越用越强:
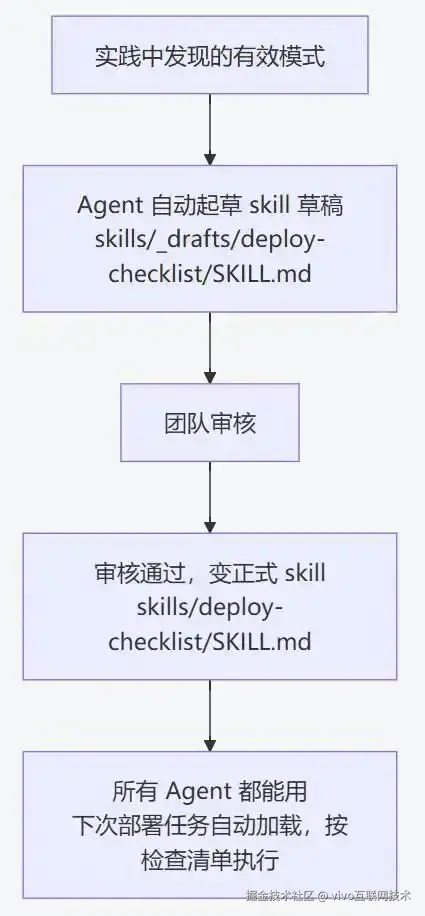
关键原则:
- 通用能力放 Git 技能仓库,团队共享
- 项目特有规范放 workspace/skills/,跟代码版本走
- 个人偏好放 /skills/,用户隔离
实践四:生产部署 Checklist
上线前逐项检查:
-
**状态存储:**用 Redis/MySQL,不要用内存或本地 JSON(多副本会丢状态)
-
**maxIters 上限:**必须设,防止死循环烧 token
-
**权限模式:**生产环境用 STRICT 模式,不要用 DEFAULT
-
**沙箱隔离:**涉及代码执行的工具必须在沙箱中
-
**上下文压缩:**必须配 compaction,否则长对话必爆
-
**大结果卸载:**必须配 toolResultEviction,否则大文件读取必爆
-
**可观测性:**开启事件流日志,接监控告警
-
**降级方案:**模型超时/限流时的 fallback 模型
-
**成本监控:**设置 token 用量告警阈值
-
**隐私脱敏:**工具返回中的敏感信息(手机号、身份证号)要脱敏后再进上下文
scss// 生产级 Agent 配置模板 HarnessAgent agent = HarnessAgent.builder() .name("production_agent") .model("dashscope:qwen-max") .maxRetries(3) // 模型重试 .fallbackModel("dashscope:qwen-plus") // 降级模型 .workspace(workspace) .stateStore(new RedisAgentStateStore(jedis)) // 分布式状态 .compaction(CompactionConfig.builder() .triggerMessages(20).keepMessages(8).build()) .toolResultEviction(ToolResultEvictionConfig.defaults()) .memory(MemoryConfig.builder() .flushTrigger(MemoryConfig.FlushTrigger.throttled(Duration.ofMinutes(10))) .model("dashscope:qwen-turbo") .build()) .permissionContext(PermissionContextState.STRICT) .enablePlanMode() .build();
四、总结与展望
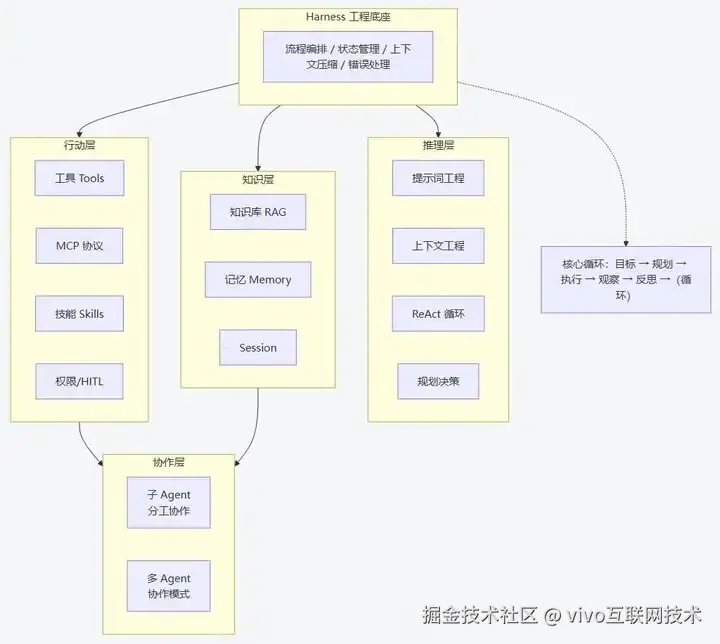
全景架构图
让我们把今天讲的所有概念整合到一张图里:
一句话总结:
- 推理层让 Agent 会思考(提示词 + 上下文 + ReAct)
- 行动层让 Agent 能做事(工具 + MCP + 技能 + 权限管控)
- 知识层让 Agent 有知识(知识库 + 记忆 + Session)
- 协作层让 Agent 能分工(子 Agent + 多 Agent 协作)
- Harness 底座让 Agent 稳定长跑(编排 + 状态 + 压缩 + 容错)
四层叠加在底座上 = 完整的自主智能体。
当前挑战
Agent 技术发展很快,但也面临实实在在的挑战:
- **稳定性:**LLM 的概率推理本质意味着 Agent 不可能 100% 可靠,同样的输入可能得到不同结果
- **成本:**多轮推理 + 工具调用 + 记忆提炼,一个复杂任务的 token 消耗是单次对话的几十倍
- **安全性:**Agent 有了行动力,也意味着有了破坏力------误删文件、执行危险命令的风险真实存在
- **评估困难:**传统软件测试是"输入→断言输出",Agent 的多步推理 + 工具调用让测试变成一个非确定性问题
这些挑战也催生了很多工程实践:权限系统做三态决策(允许/询问/拒绝)、HITL 让敏感操作可暂停等待人工确认、沙箱隔离让不可信代码安全执行。
未来方向
展望未来,几个值得关注的方向:
- **更强的自主规划能力:**从 ReAct 的"走一步看一步"到更全局的规划------树状搜索、蒙特卡洛树搜索(MCTS)等
- **Agent 自进化:**Agent 自动沉淀成功经验为技能、自动清理过时技能------know-how 越用越多
- **多 Agent 生态:**不同团队、不同公司的 Agent 通过标准协议(如 A2A 协议)互相协作,形成"Agent 的互联网"
- **与物理世界结合:**Agent + 机器人,从数字世界走向物理世界------具身智能(Embodied AI)
一个启发
最后,我想留给大家一个思考:
Agent 技术的本质,不是让 AI 变得更"聪明",而是给 AI 搭一套"工程基础设施"------让它从"灵光一闪的问答"变成"可靠运转的系统"。这跟软件工程的发展史如出一辙:从单个脚本,到工程化,到平台化。
Agent 就是软件工程3.0-- 软件工程3.0的开发新范式。
我们正在经历的,是 AI 从"模型"到"系统"的工程化转折点。而这个转折点中的每一个工程问题------可靠性、可观测性、安全性、可维护性------都是我们工程师最擅长的领域。
Agent 的未来,不只是 AI 研究员的未来,更是我们每个工程师的未来。