完成一个需求,常常要同时改好几个仓库:
- 全栈项目:前端、后端服务、接口定义各在一个仓库,有时还有配置仓库;
- 移动端组件化:壳工程、业务组件、基础组件库分在不同仓库,一个功能经常同时改业务组件和基础库;
- 同一个功能要在几个端各实现一遍,每个端一个仓库。
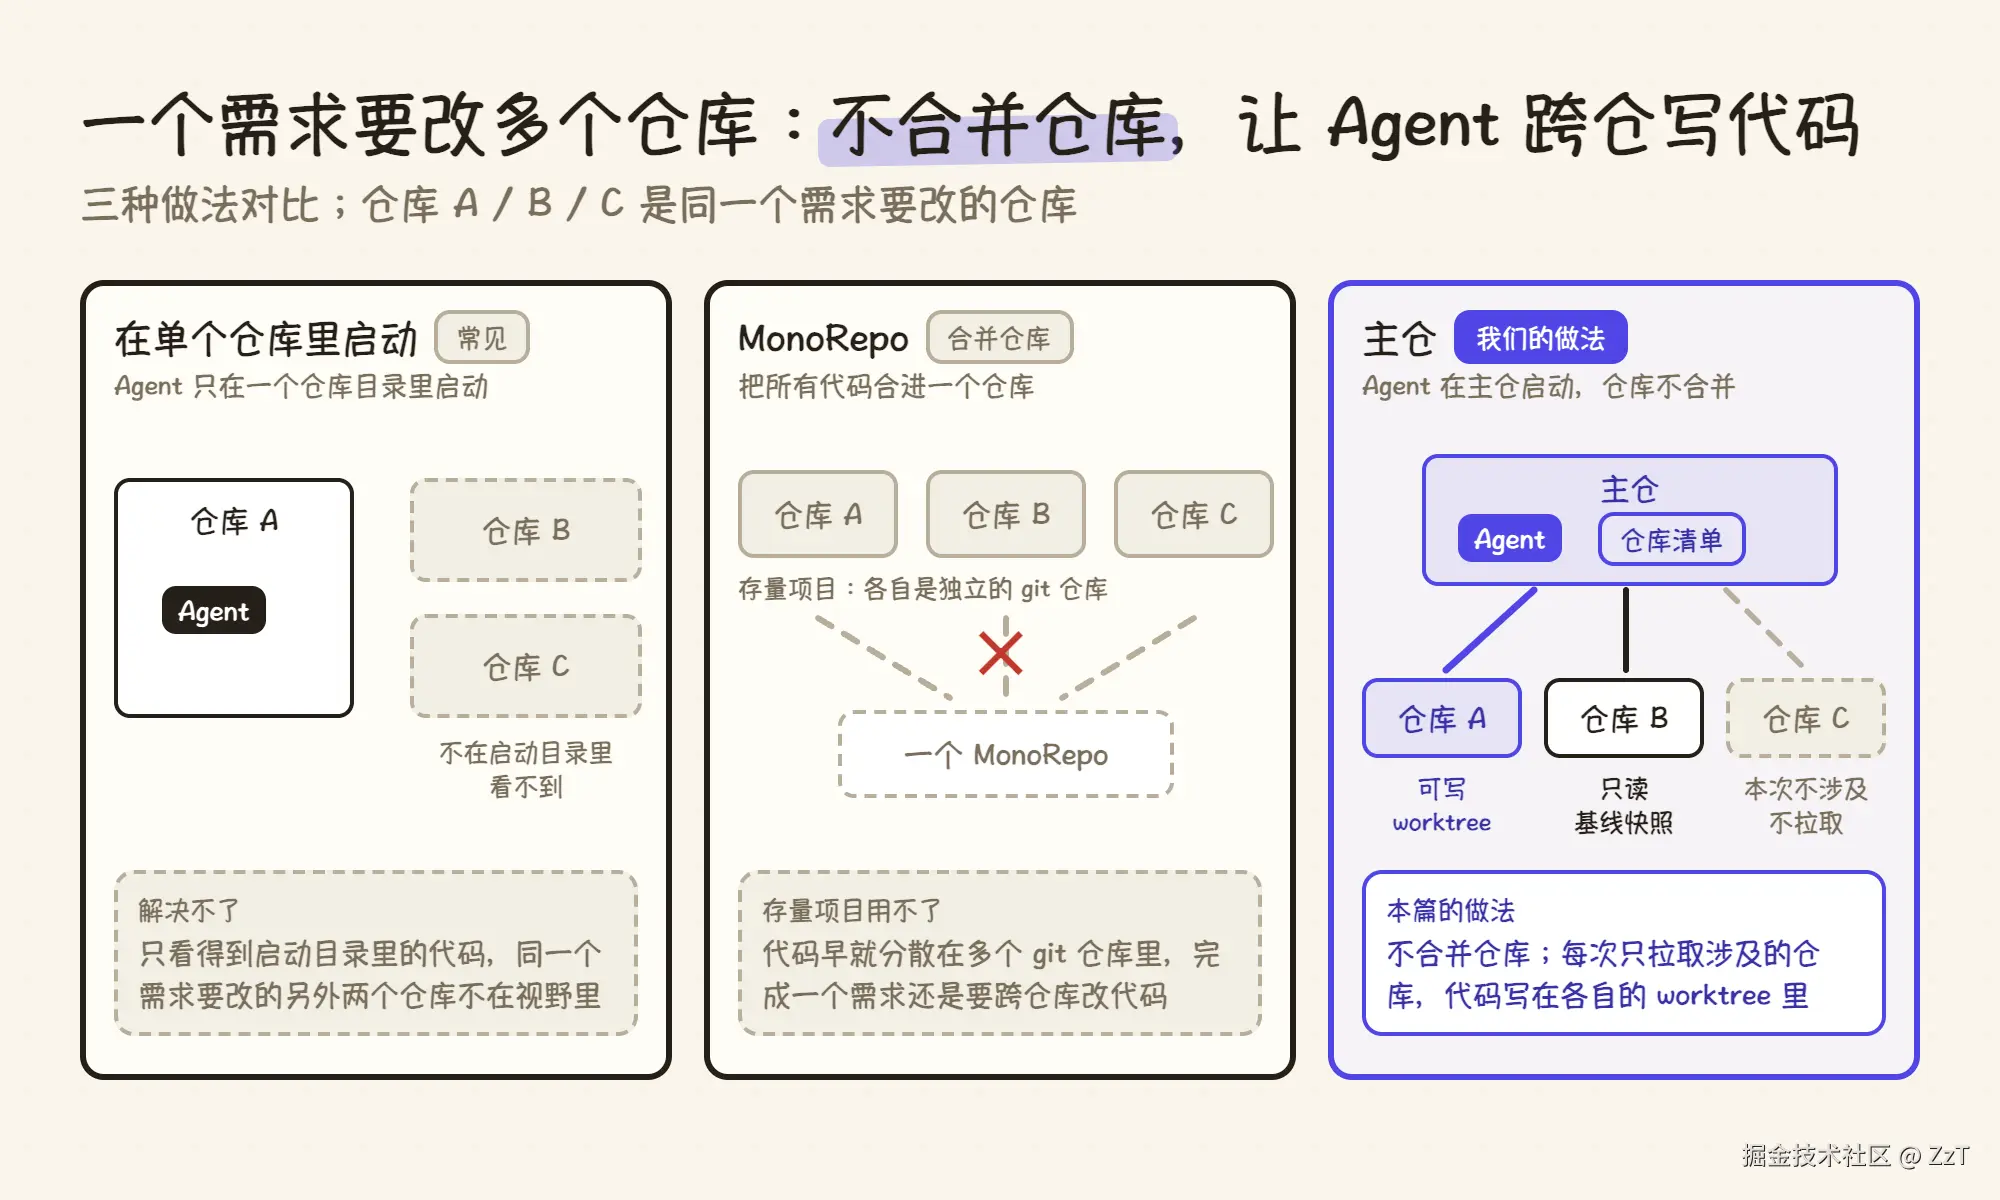
而 Agent 每次只在一个目录里启动,只看得到这个目录里的代码。
常见的做法是用 MonoRepo:把所有代码合进一个仓库,Agent 在一个目录下就能看到全部代码。但这解决不了存量项目的问题。存量项目早就分散在多个 git 仓库里,完成一个需求,还是要跨几个仓库改代码。
所以开发阶段先要解决的是:不合并仓库,怎么让 Agent 跨仓库写代码。具体是三个问题:Agent 在哪里启动,仓库放在哪里,代码写在哪里。
我们的做法是用一个主仓统一管理:
- Agent 在主仓里启动;
- 主仓用一份清单登记所有仓库,每次交付只拉取涉及的那几个;
- 代码写在每个仓库从基线建出来的 worktree 里,原工程目录不动。
11 月 10 日,Matt Pocock 在 X 上分享了他的做法 Home Repo,也是这个方向:一个主仓存放所有 skill、引导文件和文档,Agent 在主仓里运行,主仓的 AGENTS.md 里写明其他仓库在哪。下文会逐项和它对照。
本篇讲这几件事:
- 主仓里放什么;
- 仓库怎么登记,每次交付读哪些仓库、写哪些仓库;
- 代码写在哪里:每个可写仓库一个 worktree,原工程目录不动;
- 构建和测试命令怎么统一;
- 同一个主仓怎么同时支持 Claude Code 和 Codex。
其中有两处是我们踩过的坑:worktree 占满磁盘,以及 worktree 里的改动没合回导致丢代码。
开发阶段分几篇讲。本篇讲工程结构,后面两篇讲知识库和 D2C。
Matt Pocock 的 Home Repo
Matt 在这条推文里说,很多人问他怎么让 Agent 同时在多个仓库里工作,他的办法是 Home Repo:
- 一个单独的仓库作为主仓,所有 skill、引导文件、wiki 都放在这里;
- Agent 在主仓里运行;
- 主仓的 AGENTS.md 里给每个仓库写一句话,比如「要用 skills,就把 mattpocock/skills 克隆到 ~/repos/skills」。
他列了三个好处:引导文件和工具集中在一处,所有 Agent 在同一个地方运行,可以对多个仓库做大范围的改动。推文配图里,一位学员说自己维护 38 个仓库,只是把它们克隆进主仓、加进 gitignore,效果就很好。
回复区里,Matt 又补充了几条:
- 每个仓库自己的东西,比如构建命令,放在各自仓库里,主仓里只写这些仓库在哪;
- 同一个仓库要并行开发几个功能,就在克隆里用 worktree;
- 团队使用时,主仓归团队所有,所有人都在主仓里运行 Agent;
- 跨仓库的事项记录在主仓;
- 用完的 worktree,他的做法是直接清掉。
- 有人问 MonoRepo 怎么样,他说也很好,只是需要大量配套工具,而且不一定能做成。
回复区也有人反过来做:在各个仓库里运行 Agent,每个仓库的 AGENTS.md 写明主仓在哪、该读主仓里的哪些文件。理由是在主仓里运行时,Agent 总想去翻其他仓库。本篇不讨论这两个方向的取舍,我们选的是在主仓里运行。
下面按我们的工程结构逐项讲,每一项都和 Matt 的做法对照。
主仓里放什么
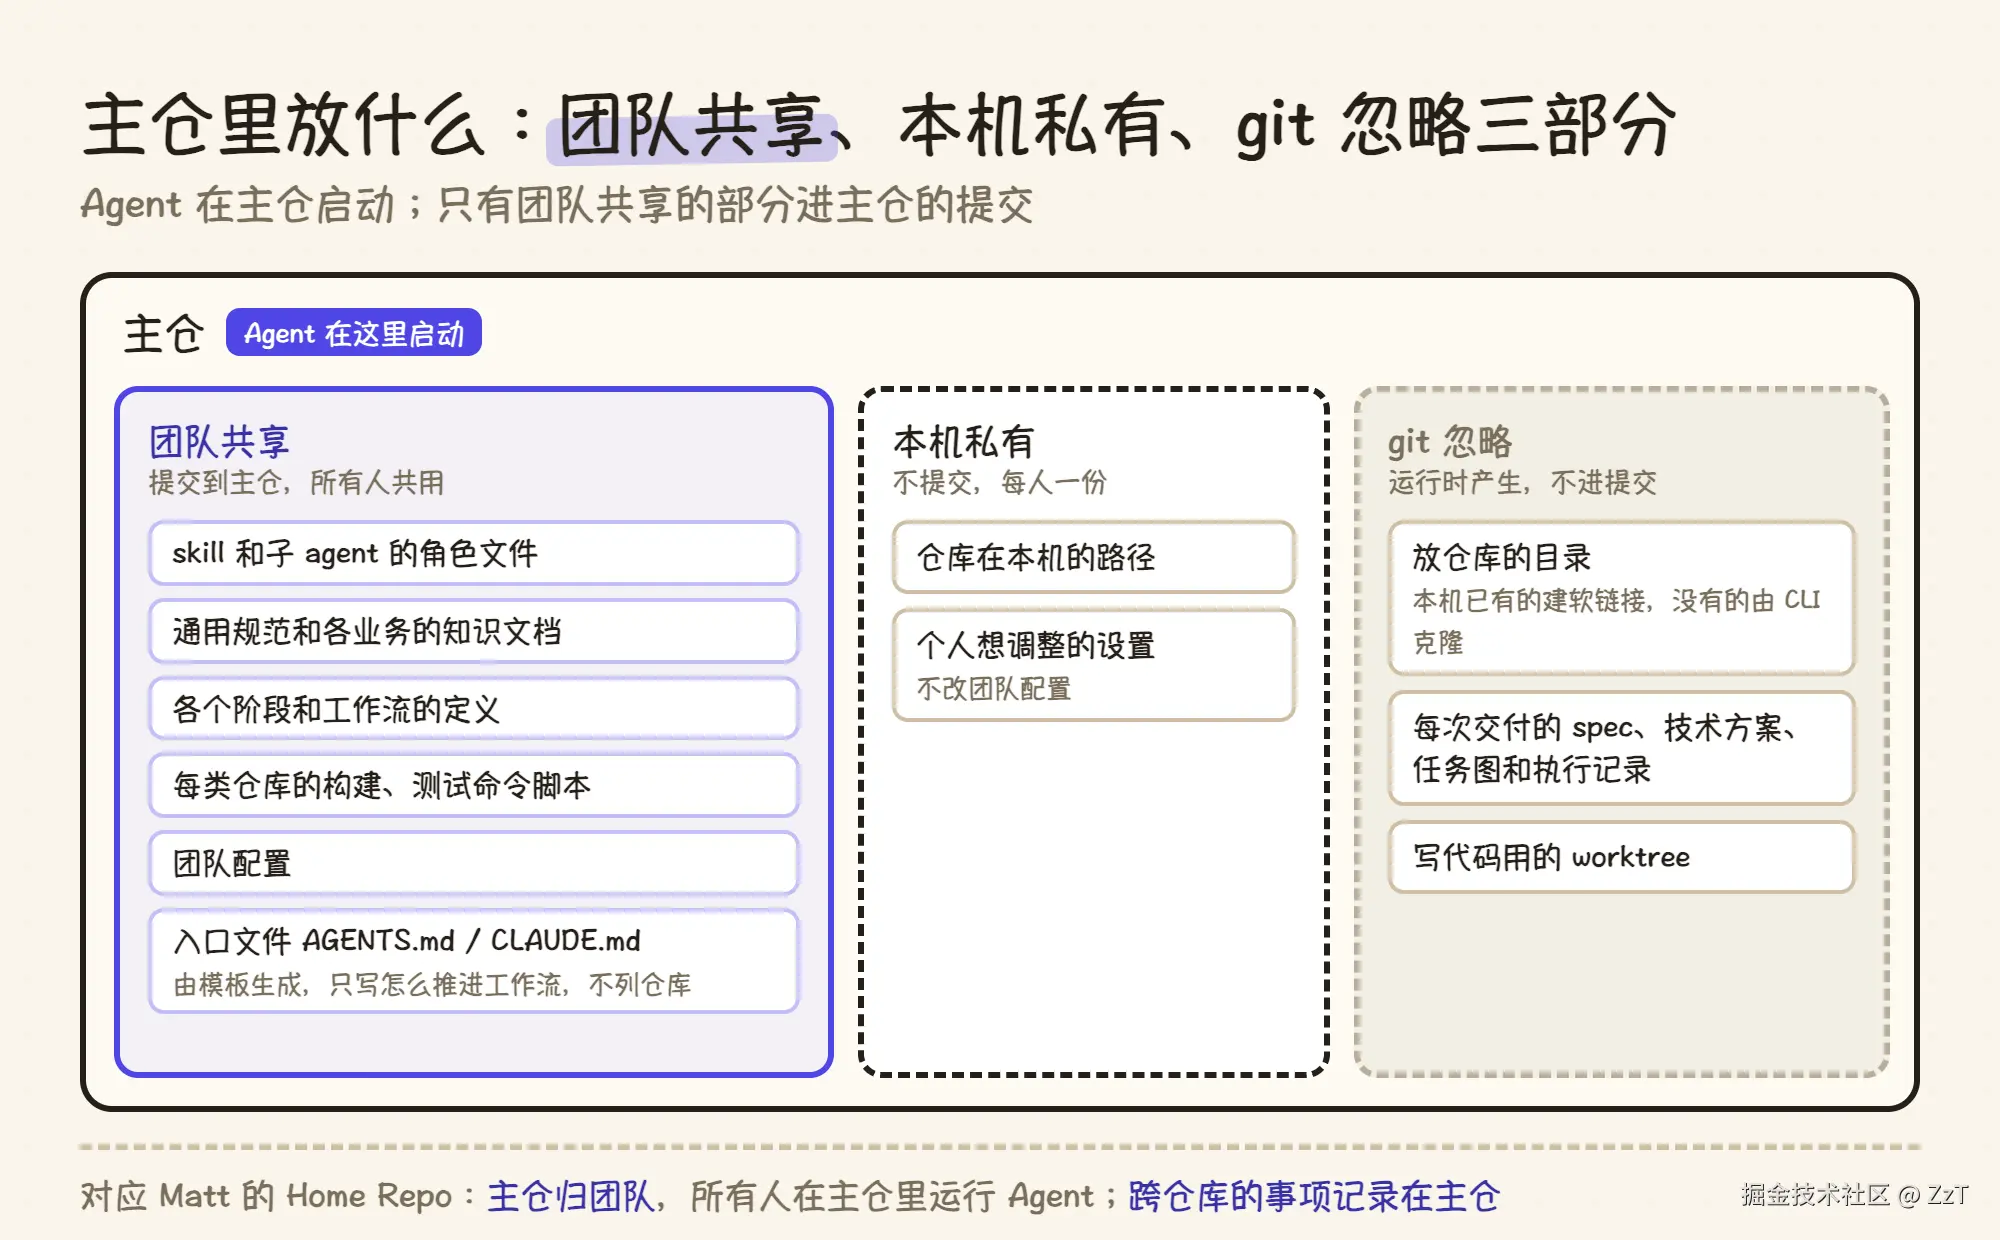
我们的主仓就是 Harness 仓库本身,团队共用。里面放的是:
- skill 和子 agent 的角色文件;
- 通用规范和各业务的知识文档;
- 各个阶段和工作流的定义;
- 每类仓库的构建、测试命令脚本;
- 团队配置。
Agent 在主仓里启动。宿主读取的入口文件(AGENTS.md、CLAUDE.md)由模板生成,只写怎么推进工作流、什么情况下读哪份文档,不列仓库清单。
每次交付的 spec、技术方案、任务图和执行记录,放在主仓里一个被 git 忽略的目录下。这对应 Matt 说的「跨仓库的事项记录在主仓」。
团队的东西和个人的东西分开放。团队配置所有人共用;仓库在本机的路径、个人想调整的设置,写在不提交的本地文件里,不改团队配置。
用一份仓库清单登记二十多个仓库
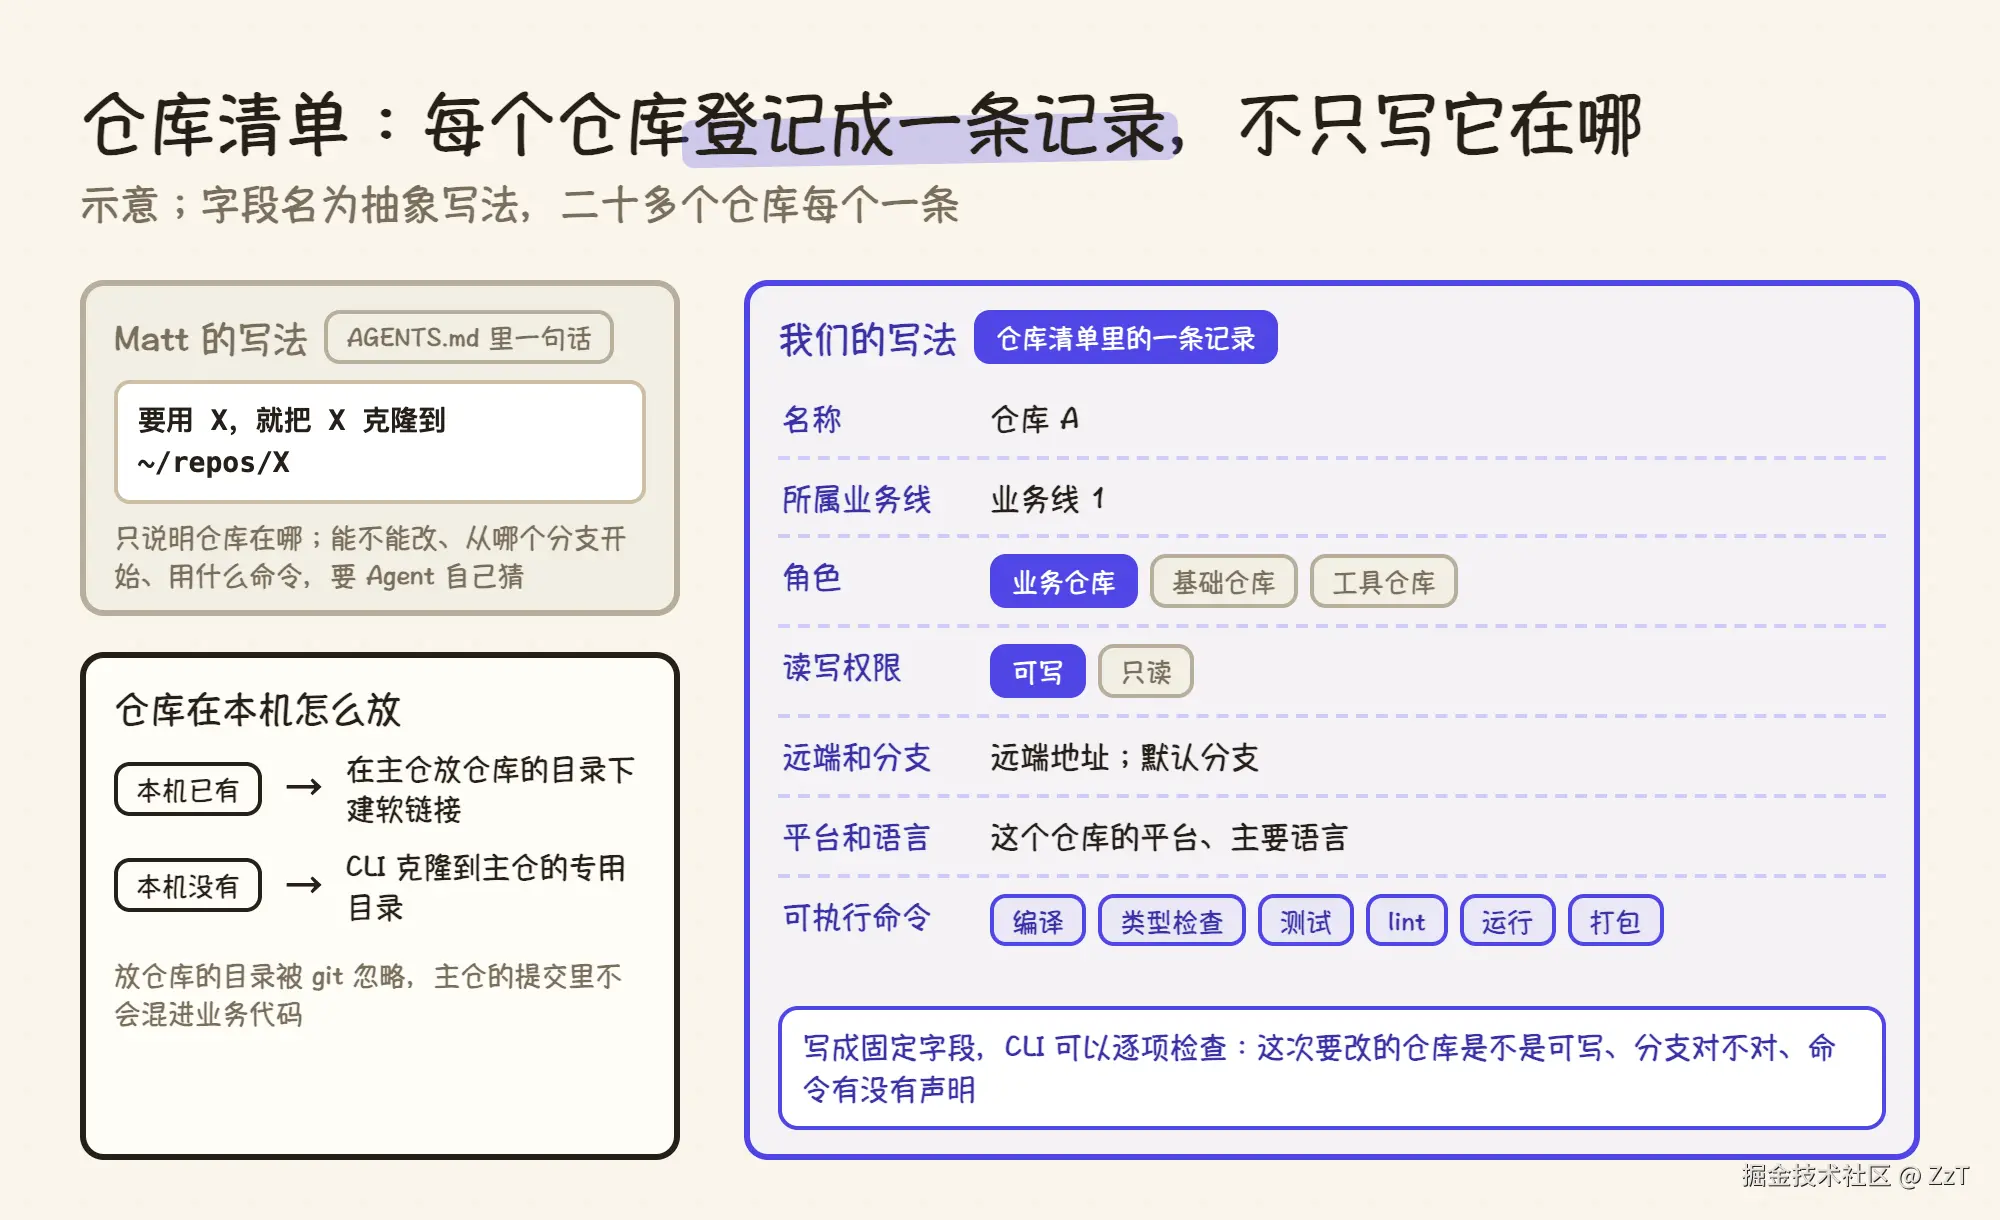
Matt 是在 AGENTS.md 里给每个仓库写一句话,说明它克隆在哪个目录。我们改成一份单独的仓库清单,目前登记了二十多个仓库。每个仓库记下这些字段:
- 所属业务线;
- 角色:业务仓库、基础仓库还是工具仓库;
- 读写权限:这个仓库允许改,还是只能读;
- 远端地址和默认分支;
- 平台和语言;
- 可以执行的命令:编译、类型检查、测试、lint 等。
只写一句话不够,是因为 Agent 要知道的不只是仓库在哪,还有能不能改、从哪个分支开始、用什么命令编译和测试。只写一句话,这些都要 Agent 自己猜;写成清单里的固定字段,CLI 可以逐项检查。
仓库在本机怎么放,分两种情况:
- 开发者本机已经有这个仓库:路径写在本地文件里,在主仓里专门放仓库的目录下建一个软链接指过去;
- 本机没有:由 CLI 克隆到主仓里的一个专用目录。
放仓库的目录被 git 忽略,主仓的提交里不会混进业务代码。这和那位学员「克隆进主仓再 gitignore」是同一个做法,只是多了一份清单记录每个仓库的规则。
每次交付先划定范围:读哪些仓库、写哪些仓库
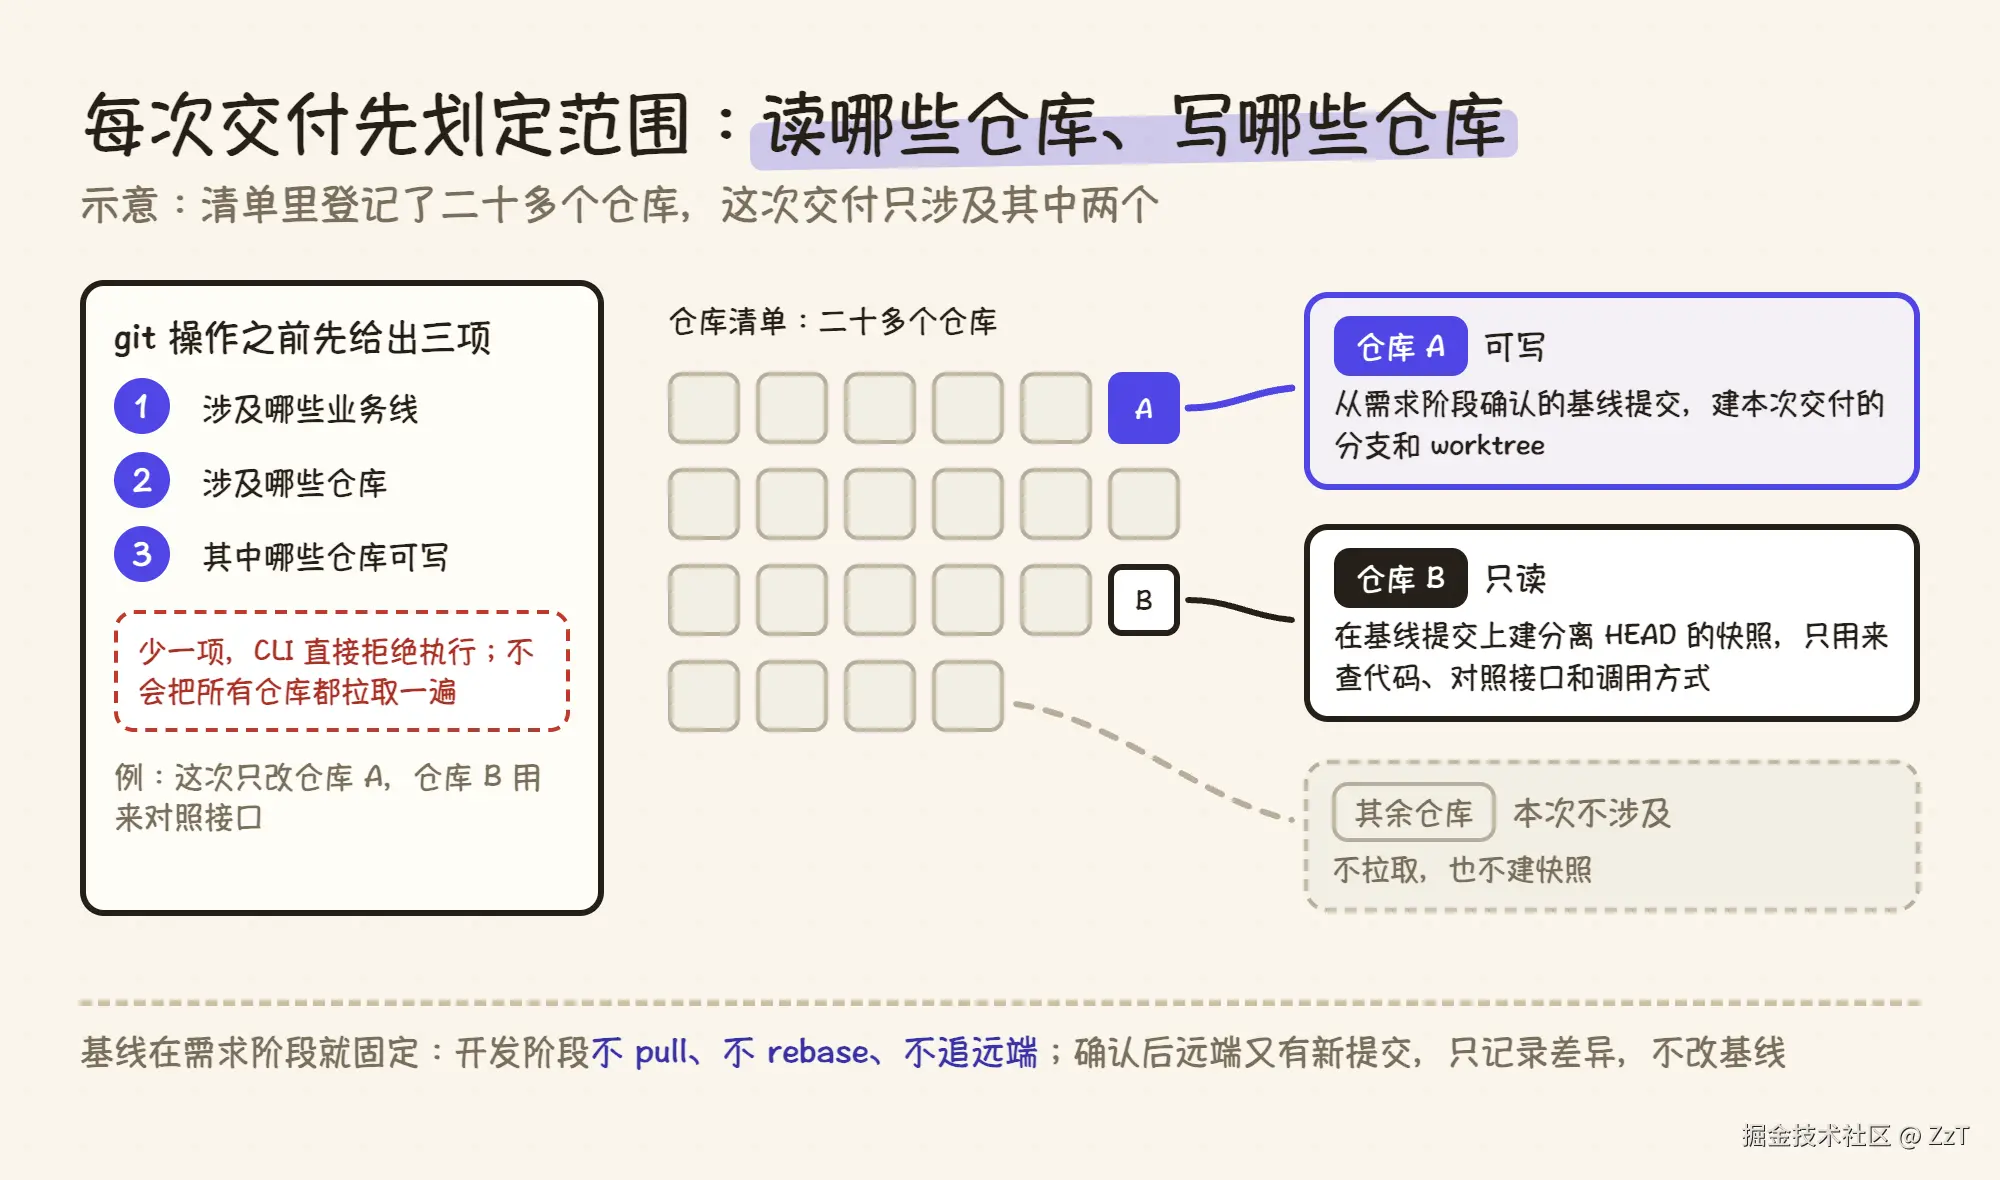
二十多个仓库,一次交付通常只涉及其中几个。任何 git 操作之前,必须先明确三项:这次涉及哪些业务线、哪些仓库、其中哪些仓库可写。少一项,CLI 直接拒绝执行,不会因为一次交付把所有仓库都拉取一遍。
涉及的仓库分两种处理:
- 只读的仓库:在需求阶段确认的基线提交上,建一个分离 HEAD 的快照,用来查代码、对照实现。比如这次只改仓库 A,仓库 B 只用来对照接口和调用方式;
- 可写的仓库:从基线提交建本次交付的分支和 worktree。
基线在需求阶段就固定了(第 03 篇讲过)。开发阶段不 pull、不 rebase、不追远端最新提交。确认之后远端又有新提交,只记录差异,不改基线,也不因此阻塞开发。
每个可写仓库一个 worktree,原工程目录不动
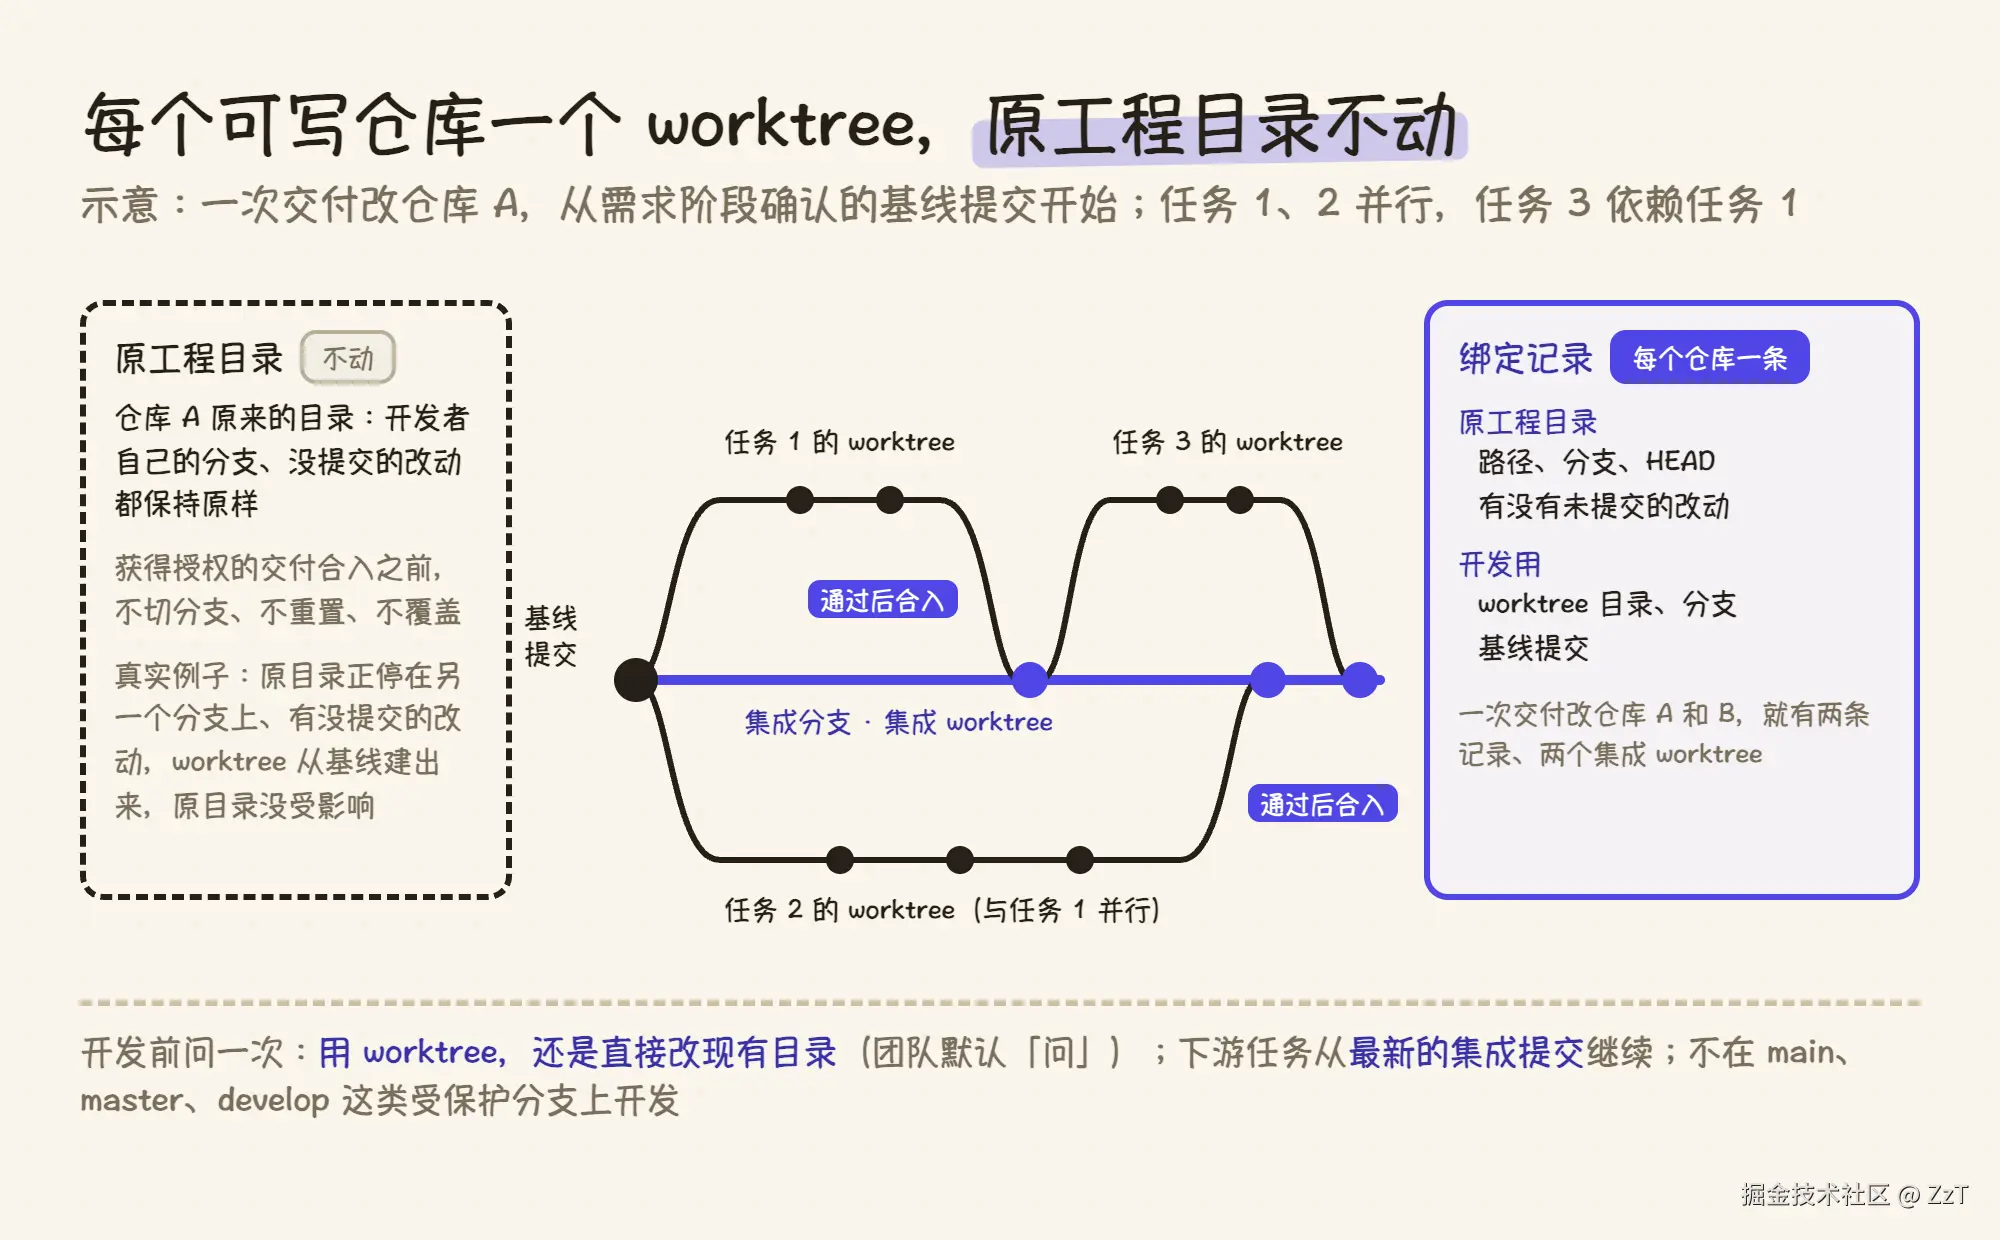
开发开始前,Agent 会问一次:用独立的 git worktree,还是直接改现有的工程目录。问题里写明具体是哪个工程,以及两种选择分别会发生什么:
- 用 worktree:新建一个独立的工作目录完成本次修改,原工程目录里的文件保持原样;
- 不用 worktree:直接修改现有工程目录里的文件。
回答记录下来,同一次交付不再问。团队配置里这一项默认是「问」,也可以配成总是用 worktree,或者总是改现有目录。直接改现有目录时,写入范围在开始前必须是干净的,范围外已有的修改保持不动。
用 worktree 时,按下面的方式组织:
- 每个可写仓库从基线提交建一个集成分支和对应的 worktree,作为本次交付唯一的集成目标;
- 并行写代码的任务,各自再从同一个基线建一个任务分支和 worktree,两个执行者不共用同一个目录或分支;
- 有依赖的任务按顺序推进:上游检查通过后合入集成分支,下游从最新的集成提交继续,不从没通过检查的分支继续。
每个仓库的对应关系写进一份绑定记录:原工程目录的路径、分支、HEAD、有没有未提交的改动;开发用的目录、分支和基线提交。
两个真实的例子:
- 一次交付同时改仓库 A 和仓库 B,两个仓库各有一个 worktree、一个任务分支,绑定记录里有两条;
- 另一次,仓库 A 的原工程目录正停在另一个分支上,还有开发者没提交的改动。worktree 从确认过的基线建出来,原目录里的改动没受影响。
另外两条规则:不在受保护的分支(main、master、develop 这类)上开发、合并或推送;获得授权的交付合入之前,原工程目录保持不变。
worktree 踩过的两个坑:磁盘空间和丢代码
磁盘空间不足
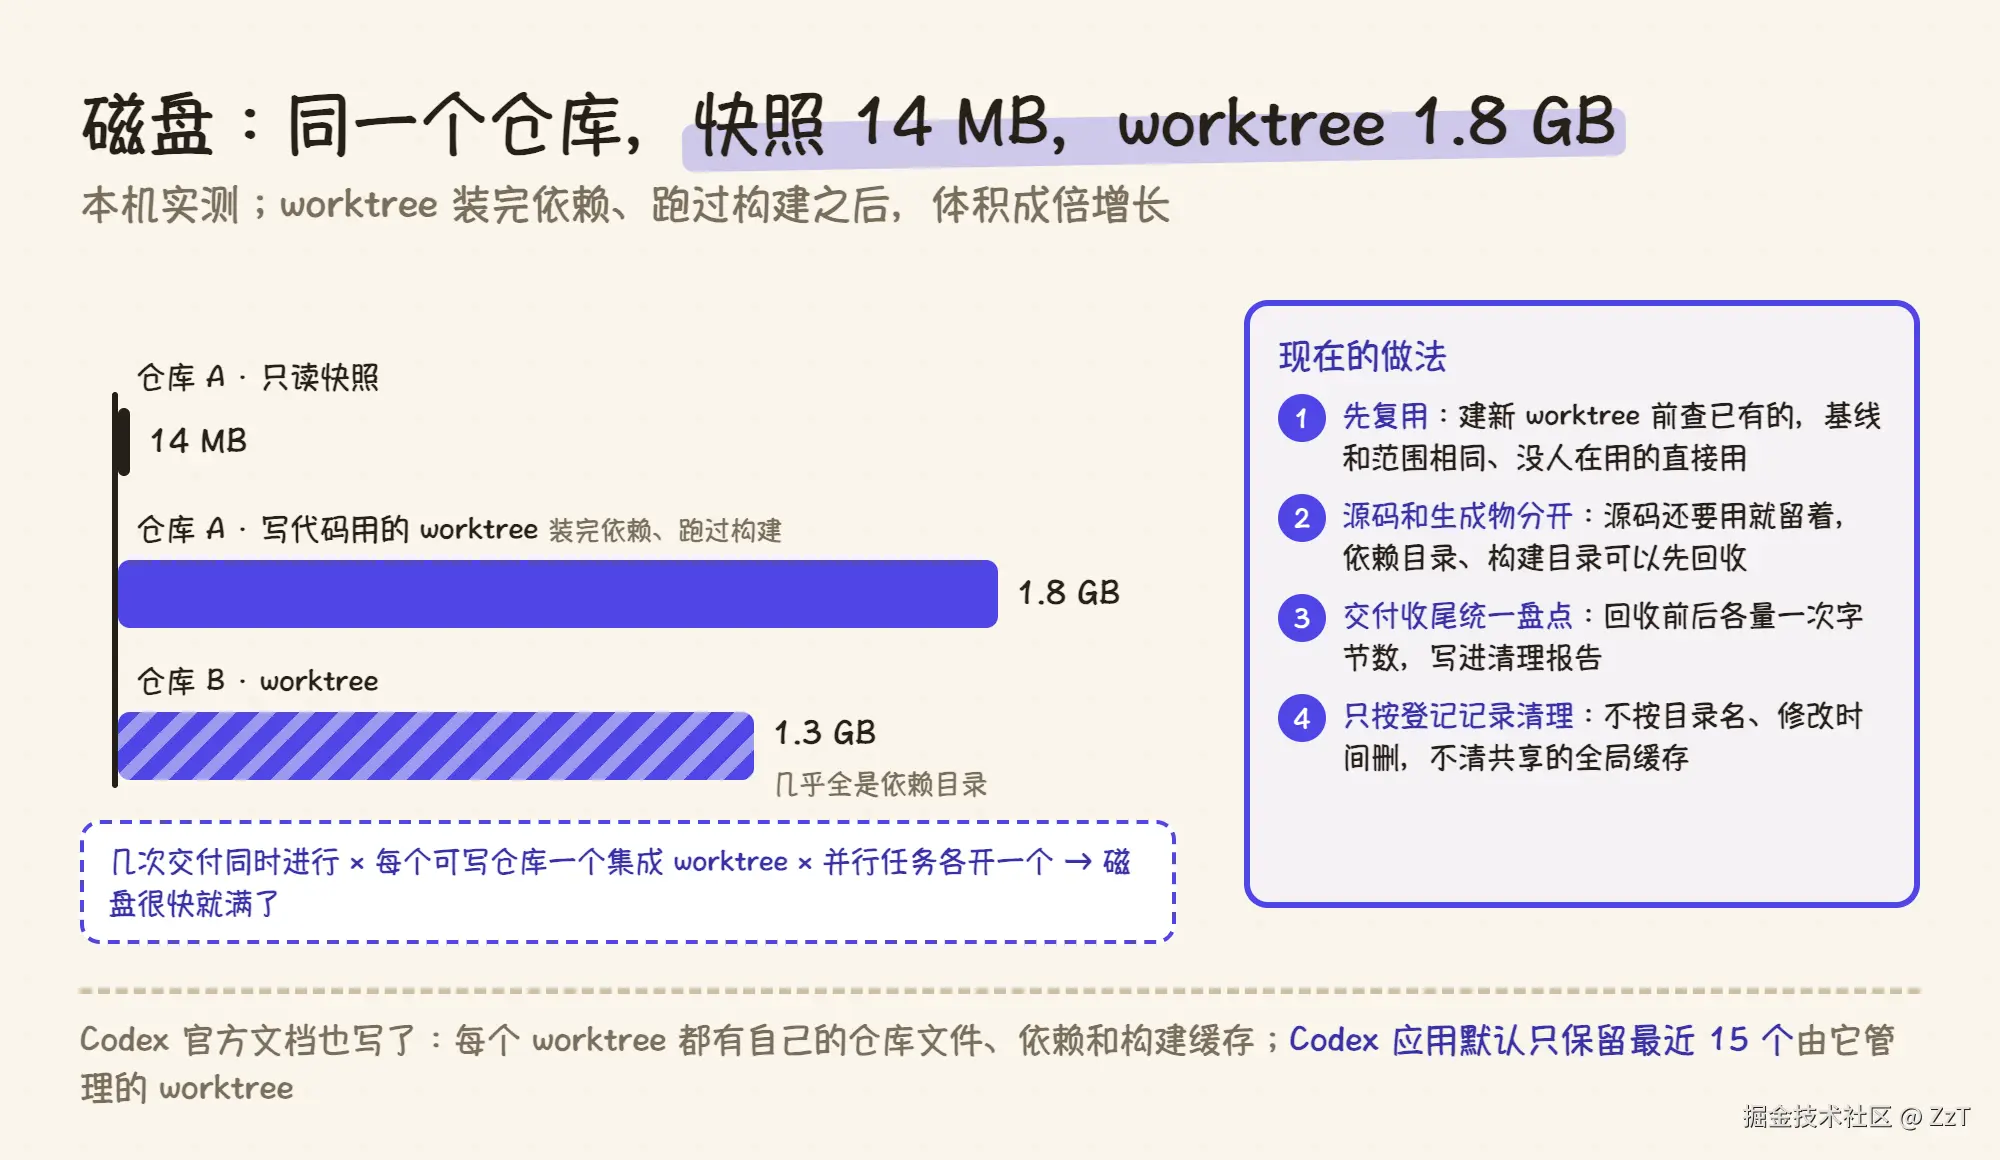
这是最大的坑。每个 worktree 都是一份完整的源码,装完依赖、跑过构建之后,体积会成倍增长。本机实测:同一个仓库,只读快照 14 MB,写代码用的 worktree 装完依赖、跑过构建后是 1.8 GB;另一个仓库的 worktree 有 1.3 GB,几乎全是依赖目录。
几次交付同时进行,每个可写仓库一个集成 worktree,并行任务再各开一个,磁盘很快就满了。Codex 的官方文档也提到这一点:每个 worktree 都有自己的一套仓库文件、依赖和构建缓存,很占磁盘,所以 Codex 应用默认只保留最近 15 个由它管理的 worktree。
现在的做法:
- 建新 worktree 之前,先查已有的 worktree,基线和范围相同、没有被占用的直接复用;
- 源码和能重建的生成物(依赖目录、构建目录)分开处理:源码还要用就留着,生成物可以先回收;
- 交付收尾时,必须盘点本次交付登记过的所有 worktree,能回收的回收,回收前后各量一次占用的字节数,写进清理报告;
- 只按登记记录找要清理的 worktree,不按目录名或修改时间判断「看着旧」就删,也不扫描其他交付的目录;不一次删光所有依赖目录,不清共享的全局缓存。
改动没合回,丢代码
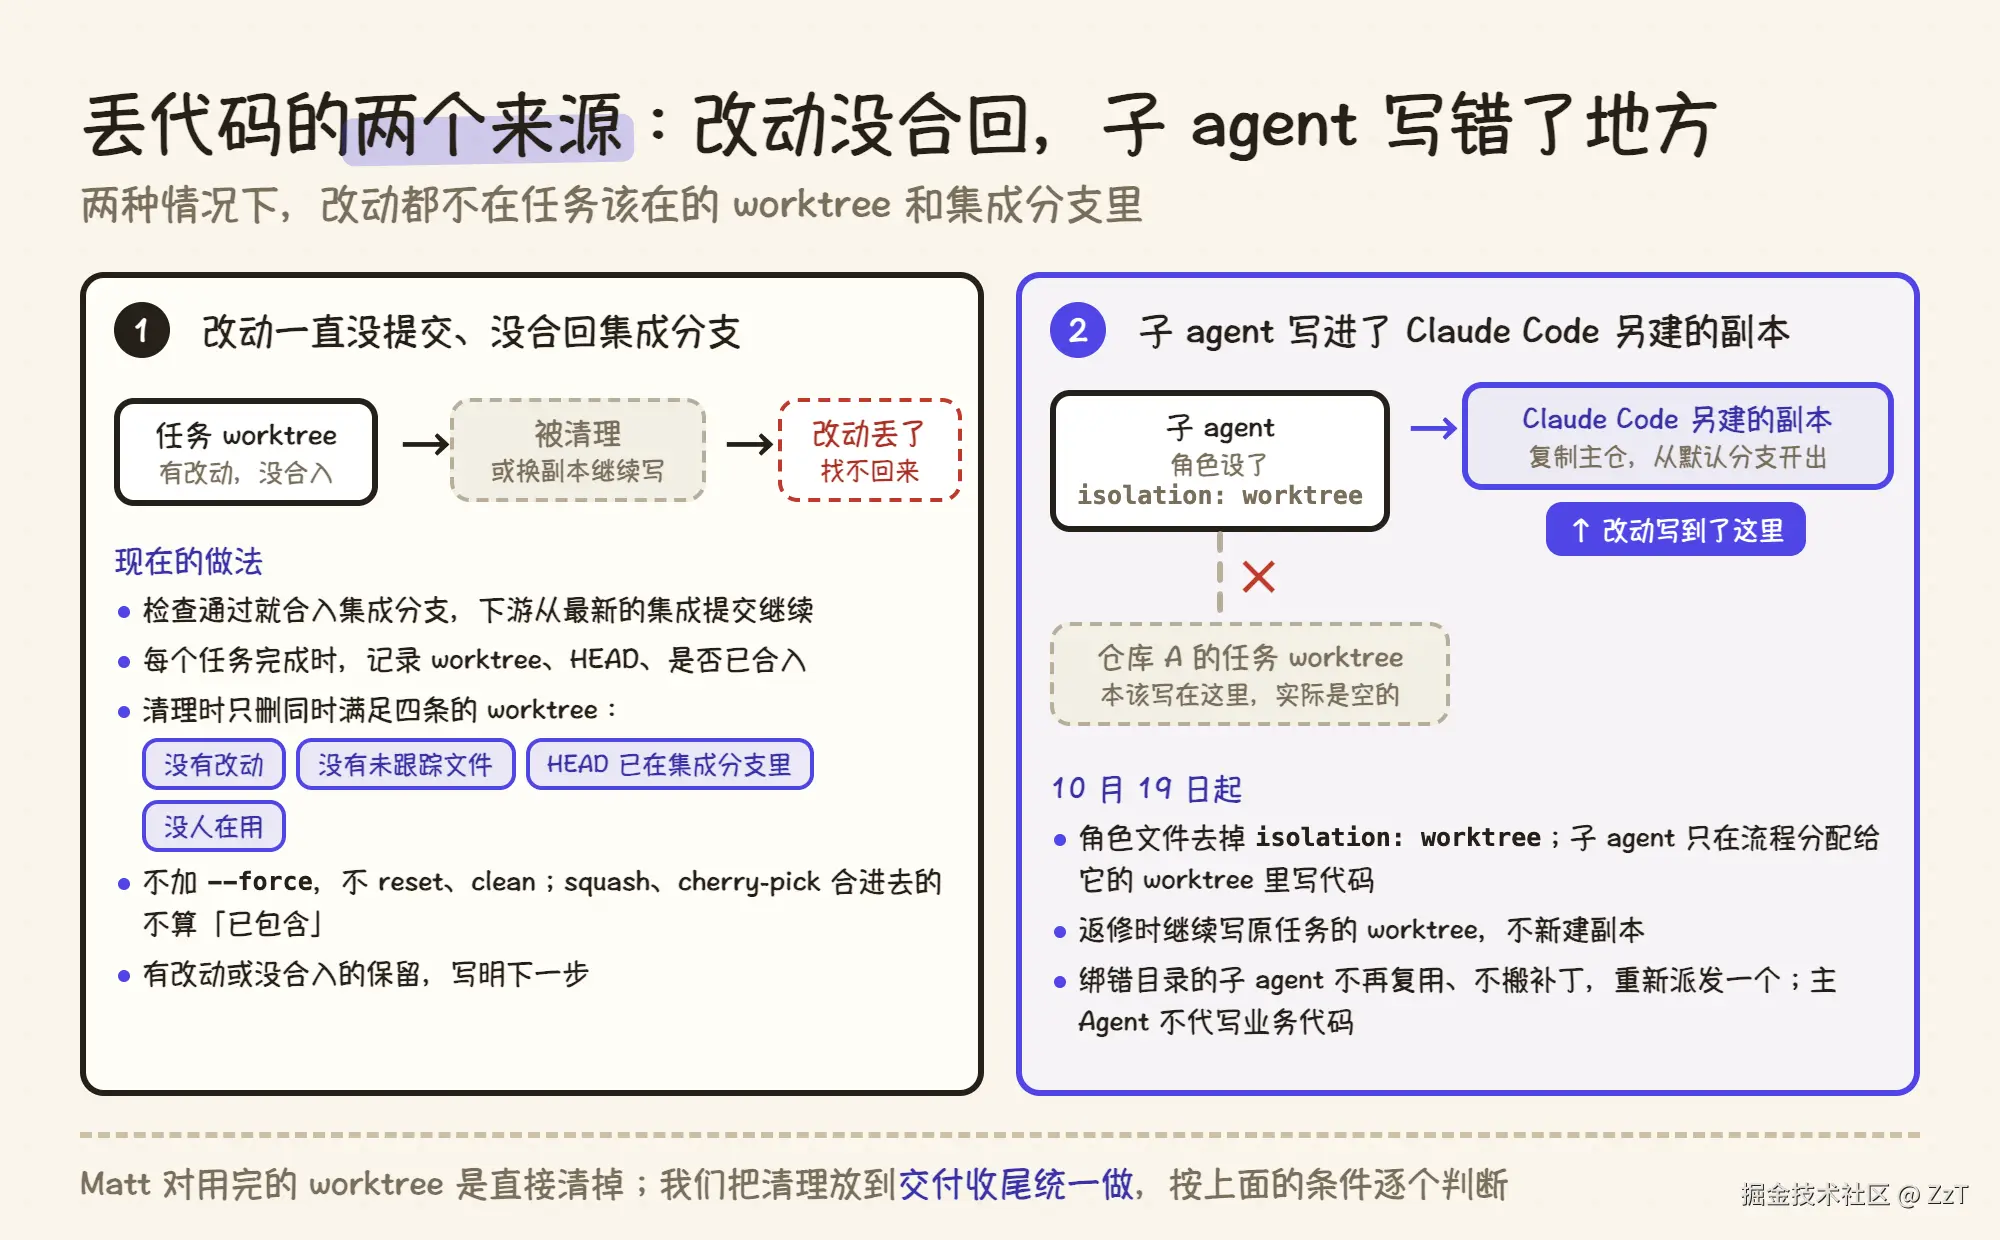
丢代码有两个来源。
第一个来源:worktree 里的改动一直没提交、没合回集成分支。worktree 一旦被清理,或者后续换了一个副本继续写,这部分改动就没了。
现在的做法:
- 每个任务检查通过后合入集成分支,下游任务从最新的集成提交继续;
- 每个任务完成时,记录它的 worktree、HEAD,以及是否已经合入;
- 清理时只删同时满足这几条的 worktree:没有改动,没有未跟踪的文件,HEAD 已经包含在保留的集成分支里,没有别的任务或进程在用;
git worktree remove本身只删干净的 worktree,有改动的要加--force才能删。我们不加--force,也不用 reset、clean 绕过 git 的拒绝;- 用 squash 或 cherry-pick 合进去的改动,不能当作「已经包含」的证明;
- 有改动或者没合入的 worktree 一律保留,写明下一步该做什么。
第二个来源:子 agent 的改动写到了别的地方,没写进任务的 worktree。
Claude Code 的子 agent 角色有一个选项 isolation: worktree。打开后,Claude Code 每次启动这个子 agent,都会自动给它另建一个副本,让它在副本里改代码。我们早期的角色文件打开了这个选项。
问题出在这个副本建在哪:Claude Code 复制的是启动目录所在的仓库,默认从这个仓库的默认分支开出来(Claude Code 文档)。我们的启动目录是主仓,所以子 agent 拿到的是一份主仓的副本,而不是任务对应的业务仓库 worktree。它的改动全写进了这份副本,任务 worktree 里什么都没有。
10 月 19 日,我们从角色文件里去掉了这个选项。现在的规则是:
- 子 agent 只在流程分配给它的 worktree 里写代码,Claude Code 不再给它另建副本;
- 返修时继续写原任务的 worktree,不新建副本;
- 已经启动、绑错了目录的子 agent 不再复用,也不把它的补丁搬回来,重新派发一个;主 Agent 不代替它写业务代码。
Matt 对用完的 worktree 是直接清掉。我们因为这两个坑,把清理放到交付收尾统一做,按上面的条件逐个判断,交付那篇再细讲。
构建和测试命令由主仓统一声明
这一点和 Matt 不同。他在回复里说,构建命令这类仓库自己的东西放在各个仓库里。我们是在仓库清单里给每个仓库声明一组命令:编译、类型检查、测试、lint、运行、打包等。命令脚本按仓库类型放在主仓,同一类仓库共用一套脚本。
原因是仓库多、技术栈不止一种。前端、后端服务、客户端,构建和测试的方式各不相同,让 Agent 自己猜命令很容易出错。声明过的命令可以审计,结果也能复现。
执行时守几条规则:
- 只执行声明过的命令,不自己编构建、测试、安装、启动命令;
- 命令的工作目录是获得授权的目标仓库,或者它的 worktree;
- 保留完整的日志和退出码,主会话里默认只返回最后 120 行;
- 编译、类型检查、测试分别按要求执行,不能互相替代。
同一个主仓同时支持 Claude Code 和 Codex
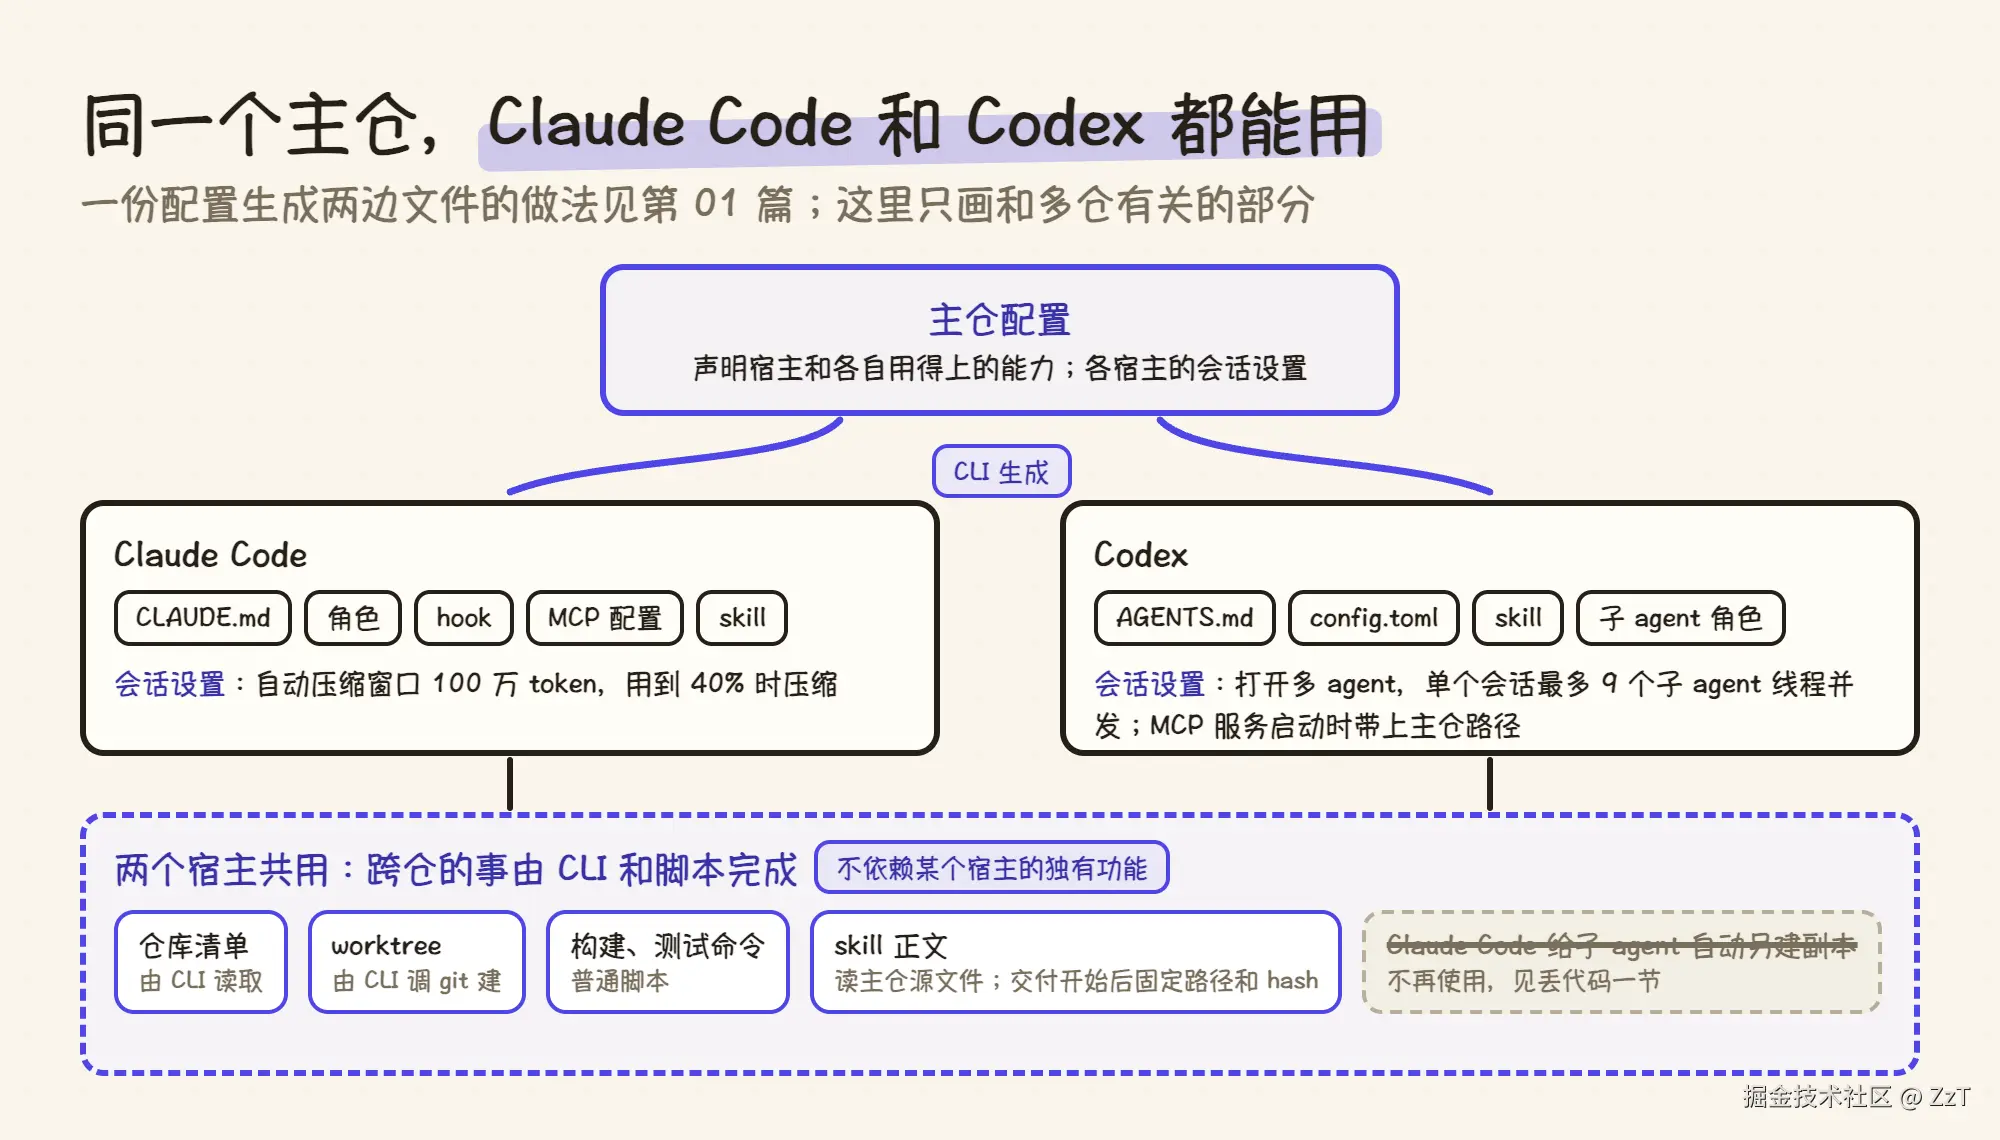
第 01 篇讲过通用做法:角色、skill、hook 这些配置只写一份,由 CLI 生成两个宿主各自需要的文件。这里只讲和多仓工作区有关的几点。
主仓配置里声明宿主和能力。 每个宿主一份适配配置,列出它用得上的能力。Claude Code 这边生成 CLAUDE.md、角色、hook、MCP 配置和 skill;Codex 这边生成 AGENTS.md、config.toml、skill 和子 agent 角色。
跨仓的事不依赖某个宿主的独有功能。 仓库清单由 CLI 读取,worktree 由 CLI 调 git 建,构建和测试是普通的脚本。不管在 Claude Code 还是 Codex 里运行,跨仓的流程都一样。Claude Code 给子 agent 自动另建副本的选项也不再使用,原因见上一节。
各宿主的会话设置写在同一份配置里。 比如 Claude Code 的自动压缩窗口设为 100 万 token,用到 40% 时压缩;Codex 打开多 agent,单个会话最多 9 个子 agent 线程并发,MCP 服务启动时带上主仓的路径。
skill 正文以主仓为准。 宿主目录里生成的 skill 只用来让宿主发现它,执行时读的是主仓里的源文件。一次交付开始后,用到的 skill 固定文件路径和 hash,之后主仓里的 skill 再更新,也不影响这次交付。
和 Home Repo 的对照
| Matt 的 Home Repo | 我们的做法 | |
|---|---|---|
| Agent 在哪运行 | 主仓 | 主仓 |
| 仓库怎么登记 | AGENTS.md 里每个仓库一句话 | 单独的仓库清单,记权限、分支、命令等字段 |
| 一次交付涉及哪些仓库 | 推文没提 | 先划定读哪些、写哪些,否则不执行 git 操作 |
| 代码写在哪 | 每个克隆里用 worktree | 每个可写仓库从基线建集成 worktree,并行任务各开一个 |
| 用完的 worktree | 直接清掉 | 交付收尾统一盘点,有改动、没合入的保留 |
| 构建命令 | 放在各仓库里 | 主仓按仓库类型统一声明 |
| 多个宿主 | 推文没提 | 同一份配置生成 Claude Code 和 Codex 各自的文件 |
| 团队 | 主仓归团队,所有人在主仓运行 | 同样;个人路径和偏好放在不提交的本地文件里 |
下一篇讲开发阶段的知识库。