一、认识 SALib,建立敏感性分析的完整思路
模型里有十几个参数,究竟哪个最影响结果?哪些参数必须认真测量,哪些可以适当简化?两个单独看起来不起眼的参数,会不会组合起来产生很大的影响?SALib 就是用来系统回答这些问题的 Python 工具库。
这篇教程沿着一条实用路线展开,从敏感性分析的基本概念,到 Sobol、Morris、FAST、PAWN 的使用,再进入时间序列、多输出、参数分组、非均匀分布、外部模型和计算加速。案例中的代码采用现代函数接口,尽量做到可以直接运行,同时解释结果该怎样读、哪些结论不能轻易下。
版本说明 PyPI 项目页面当前显示 SALib 1.6.0。在线文档的 latest 页面可能与正式发行版存在差异,因此科研项目应记录实际安装版本。下面的代码属于教学示例,未在本文环境中实际执行,示例中的理论结果与数值估计会明确区分。
1.1 SALib 负责什么
SALib 的核心工作有两部分。
- 生成输入样本,按照某种敏感性分析方法,设计模型应该在哪些参数组合上运行。
- 计算敏感性指标,把模型输出转换成参数重要性、交互作用等结果。
模型本身由你提供。它可以是一个 Python 函数,也可以是水文模型、有限元软件、能源系统模型,甚至通过命令行调用的可执行程序。
这种分离设计很灵活。你只需要把模型接成一个稳定的输入输出流程。官方入门文档将典型工作流概括为定义参数、生成样本、运行模型、分析输出四个步骤。

这里最容易被低估的是最左端。参数范围和概率分布,本身就是分析假设的一部分。
同一个模型,给参数设定不同的不确定范围,得到不同的重要性排序完全正常。
1.2 敏感性分析与不确定性分析有什么区别
可以把模型理解成一台加工机器。参数是原料,输出是产品。
- 不确定性分析关心产品可能落在哪个范围内,以及出现各种结果的概率。
- 敏感性分析关心这种变化主要来自哪些原料,以及它们如何共同发挥作用。
设模型为
Y=f(X1,X2,...,XD)
不确定性分析可能研究输出的均值、分位数、方差或超过阈值的概率。
敏感性分析则进一步追问,输出的这些变化中,有多少与某个输入有关。
两者通常使用同一批模型运行结果,但回答的问题不同。
1.3 局部分析与全局分析
局部敏感性分析常在一个基准点附近,轻微改变某个参数,观察输出变化。导数就是典型的局部指标。
∂xi∂f
它适合回答某个运行状态附近的问题,例如当前设计点上,厚度增加一点会使应力变化多少。
全局敏感性分析则让参数在指定范围内变化,研究整个输入空间。SALib 的主要方法属于这一类。
全局方法尤其适合以下情况。
- 模型具有明显非线性。
- 参数之间存在交互作用。
- 参数不确定范围较宽。
- 基准点难以代表整个系统。
- 希望给出面向测量、校准或模型简化的总体判断。
单因素逐个改变的方法容易错过交互作用。一个参数在基准点附近影响很小,在其他参数取值改变后,却可能变得十分重要。
1.4 如何选择方法
选择方法时,先看问题,再看预算。下面这张表可以作为起点。SALib 官方文档和 API 列出了这些方法及其接口。
| 方法 | 主要回答的问题 | 数据或计算特点 | 适合的场景 |
|---|---|---|---|
| Sobol | 各参数贡献多少输出方差,交互有多强 | 需要专门的结构化采样,成本较高 | 定量归因、交互分析、论文中的核心结果 |
| Morris | 哪些参数可能重要,哪些可以优先排除 | 相对节省模型运行次数 | 高维模型、昂贵仿真、前期筛选 |
| FAST | 各参数的一阶和总效应有多大 | 使用专门的频率编码采样 | 希望获得方差型指标的替代方案 |
| RBD-FAST | 参数的一阶方差效应有多大 | 可用于适当的现有输入输出数据 | 已有实验设计或仿真数据 |
| PAWN | 参数变化会如何改变输出分布 | 基于条件分布与无条件分布比较 | 偏态、多峰、阈值型输出 |
| Delta | 参数对完整输出分布影响多大 | 涉及分布估计,计算与样本需求需评估 | 方差不足以描述输出变化的情况 |
| DGSM | 参数的导数效应是否较大 | 需要导数或有限差分信息 | 平滑模型、辅助筛选与理论界限 |
| HDMR | 如何用低阶作用结构近似模型 | 涉及响应分解与近似拟合 | 高维系统的结构分析 |
实际项目中,一条很稳妥的路线是 Morris 筛选,再对重点参数开展 Sobol 定量分析。
不过,筛选后固定其他参数会改变分析问题。新的 Sobol 指标对应简化后的模型及其输入分布,不能直接当作原模型指标。
1.5 安装、环境检查与最小数据结构
建议在独立环境中安装,避免与其他科研软件的依赖冲突。
bash
python -m venv .venv

# Linux 或 macOS
source .venv/bin/activate

# Windows PowerShell
# .venv\Scripts\Activate.ps1

python -m pip install --upgrade pip
python -m pip install SALib numpy pandas matplotlib scipy
检查版本,并保存环境。
python
import sys
from importlib.metadata import version

for package in ["SALib", "numpy", "scipy", "pandas", "matplotlib"]:
    print(package, version(package))

print("Python", sys.version)
bash
python -m pip freeze > requirements-lock.txt具体 Python 与依赖版本要求以所安装 SALib 发行版的元数据为准。不要把旧教程中的依赖要求直接搬到新环境。
SALib 最基本的配置对象叫 problem。
python
problem = {
    "num_vars": 3,
    "names": ["length", "width", "height"],
    "bounds": [
        [1.0, 2.0],
        [0.5, 1.5],
        [0.2, 0.8],
    ],
}
它表达了三个参数的名称与取值范围。没有指定其他分布时,默认采用均匀分布。
常见数据形状如下。
| 对象 | 典型形状 | 含义 |
|---|---|---|
X |
模型运行次数 × 参数个数 |
每一行是一组参数 |
Y |
模型运行次数 |
每组参数对应一个标量输出 |
Y_multi |
模型运行次数 × 输出个数 |
每组参数对应多个输出 |
Y_time |
模型运行次数 × 时间点个数 |
每组参数对应一条时间序列 |
函数式分析接口通常每次处理一个标量输出向量。多输出和时间序列可以逐列分析;ProblemSpec 还提供了更方便的多输出组织方式。
二、深入 Sobol,从跑通代码到读懂交互作用
Sobol 方法适合做定量解释。它把输出方差拆分到参数及参数组合上,让参数重要性有一个清晰的概率意义。
理解它的关键,是区分一阶效应、总效应与交互作用。
2.1 一阶指数究竟表示什么
经典 Sobol 方差分解通常假设输入变量相互独立,模型输出具有有限且非零的方差。
一阶指数为
Si=Var(Y)VarXiE(Y∣Xi)
这个公式可以这样理解。
固定某个参数的取值,对其他参数造成的变化取平均。然后观察,这条平均响应随着该参数变化,能够产生多少输出方差。
如果一阶指数接近 0.6,可以理解为该参数的独立主效应约解释了输出方差的 60%。
它不表示参数增加 1%,输出就增加 60%。
Sobol 指标描述方差贡献,通常也不提供影响方向。判断参数增加会让输出上升还是下降,需要结合响应曲线、散点图或其他分析。
2.2 总效应与交互作用
总效应指数包含某个参数的一阶贡献,以及所有涉及它的交互贡献。
STi=1−Var(Y)VarX∼iE(Y∣X∼i)
其中, X∼i 表示除第一个指定参数以外的其他全部输入,这里的指定参数是下标为 i 的参数。
更直观地说,总效应衡量的是所有与这个参数有关的方差贡献。
二阶指数则描述两个参数共同产生、且无法由各自一阶作用解释的贡献。
Sij=Var(Y)VarE(Y∣Xi,Xj)−Vi−Vj
其中
Vi=VarE(Y∣Xi)
阅读结果时,可以抓住三个判断。
- 一阶指数较大,说明参数独立作用明显。
- 总效应较大,说明参数整体重要。
- 总效应明显高于一阶指数,说明该参数存在较强的交互贡献。
例如模型
Y=X1X2
在两个输入相互独立、都以零为均值的情况下,两个一阶指数都可能为零,但两个总效应都为一。
这很好地解释了一个常见误区。一阶指数很小,不能直接据此删掉参数。
2.3 案例一,Ishigami 基准函数
Ishigami 函数是敏感性分析中的经典测试模型。它兼具非线性和交互作用,很适合检验代码与解释逻辑。SALib 的官方入门教程也使用这一基准。
这里直接写出模型,便于看到每个参数如何进入计算。
Y=sin(X1)+7sin2(X2)+0.1X34sin(X1)
三个输入相互独立,并均匀分布在同一个区间。
Xi∼U(−π,π)
下面是一份完整示例。
python
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

from SALib.sample import sobol as sobol_sample
from SALib.analyze import sobol as sobol_analyze


def ishigami_model(X):
    X = np.asarray(X, dtype=float)

    x1 = X[:, 0]
    x2 = X[:, 1]
    x3 = X[:, 2]

    return (
        np.sin(x1)
        + 7.0 * np.sin(x2) ** 2
        + 0.1 * x3 ** 4 * np.sin(x1)
    )


problem = {
    "num_vars": 3,
    "names": ["x1", "x2", "x3"],
    "bounds": [[-np.pi, np.pi] for _ in range(3)],
}

base_N = 4096
second_order = True

X = sobol_sample.sample(
    problem,
    base_N,
    calc_second_order=second_order,
    scramble=True,
    seed=2026,
)

Y = ishigami_model(X)

assert X.shape == (base_N * (2 * problem["num_vars"] + 2), 3)
assert Y.shape == (X.shape[0],)
assert np.isfinite(Y).all()
assert np.var(Y) > 0.0

Si = sobol_analyze.analyze(
    problem,
    Y,
    calc_second_order=second_order,
    num_resamples=500,
    conf_level=0.95,
    seed=2027,
    print_to_console=False,
)

result = pd.DataFrame(
    {
        "S1": Si["S1"],
        "S1_conf": Si["S1_conf"],
        "ST": Si["ST"],
        "ST_conf": Si["ST_conf"],
    },
    index=problem["names"],
)

print("X shape:", X.shape)
print(result.round(4))

print("\nSecond-order interactions")
for i in range(problem["num_vars"]):
    for j in range(i + 1, problem["num_vars"]):
        print(
            problem["names"][i],
            problem["names"][j],
            Si["S2"][i, j],
            Si["S2_conf"][i, j],
        )

positions = np.arange(problem["num_vars"])
width = 0.36

fig, ax = plt.subplots(figsize=(7, 4))

ax.bar(
    positions - width / 2,
    result["S1"],
    width,
    yerr=result["S1_conf"],
    capsize=4,
    label="First-order",
)

ax.bar(
    positions + width / 2,
    result["ST"],
    width,
    yerr=result["ST_conf"],
    capsize=4,
    label="Total-order",
)

ax.set_xticks(positions)
ax.set_xticklabels(problem["names"])
ax.set_ylabel("Sobol index")
ax.legend()
fig.tight_layout()
plt.show()
代码里把采样模块和分析模块分别起了别名。两者都叫 sobol,使用别名可以避免导入后相互覆盖。
现代教程建议优先使用 SALib.sample.sobol.sample。一些旧示例仍使用 SALib.sample.saltelli.sample,后者在较新的版本中已被弃用。Sobol 序列、Saltelli 型样本构造和 Sobol 指标是相关但不同的概念。
2.4 应该得到什么结果
在上述模型及输入分布下,理论指标约为下表。实际运行得到的是有限样本估计,不会逐位相同。
| 参数 | 一阶指数 | 总效应指数 | 解释 |
|---|---|---|---|
x1 |
0.3139 | 0.5576 | 独立作用与交互作用都明显 |
x2 |
0.4424 | 0.4424 | 主要通过自身产生影响 |
x3 |
0 | 0.2437 | 主要通过与 x1 的交互产生影响 |
主要二阶交互来自 x1 与 x3,理论值约为 0.2437。
这组结果可以直接从模型结构中找到解释。
x2单独进入平方正弦项。x3只出现在乘积项中。x1既单独出现,也与x3联合作用。
还有两个很有用的检查关系。
i∑Si≤1
STi≥Si
这些关系针对经典独立输入条件下的真实指标。有限样本估计可能轻微违反它们。
**总效应之和可以大于一。**同一项交互作用会计入多个相关参数的总效应,因此不能把总效应简单归一化成总和为一的贡献饼图。
2.5 样本量与计算成本
Sobol 采样中的 N 是基础样本量,通常不等于实际模型运行次数。
无分组时,不计算二阶指数需要
M=N(D+2)
计算二阶指数需要
M=N(2D+2)
这里, D 是参数数量, M 是模型运行次数。采样器的实际输出形状是最可靠的成本依据。
以十个参数为例。
| 基础样本量 | 是否计算二阶 | 模型运行次数 |
|---|---|---|
| 1024 | 否 | 12288 |
| 1024 | 是 | 22528 |
| 4096 | 否 | 49152 |
| 4096 | 是 | 90112 |
如果模型运行一次要一分钟,成本会迅速增长。只需要参数排名和整体交互判断时,可以先关闭二阶计算。
python
X = sobol_sample.sample(
    problem,
    2048,
    calc_second_order=False,
    scramble=True,
    seed=42,
)

Y = ishigami_model(X)

Si = sobol_analyze.analyze(
    problem,
    Y,
    calc_second_order=False,
    seed=43,
)
采样与分析阶段的 calc_second_order 必须一致。
基础样本量一般优先选择二的整数次幂,有利于保持 Sobol 低差异序列的平衡性质。不要随意删掉采样行,也不要把普通随机采样或 Latin 超立方采样生成的输出直接交给 Sobol 分析器。
2.6 置信区间与收敛检查
S1_conf 和 ST_conf 是置信区间的半宽度,并非区间上界。默认的置信水平通常为 0.95,可通过 conf_level 调整。相关分析接口也允许设置重采样次数与随机种子。
例如一阶估计为 0.31,半宽度为 0.04,近似区间就是
0.31−0.04,0.31+0.04
它描述的是敏感性指标估计的统计不确定性,不能替代输入分布假设、模型结构误差等更广泛的不确定性评估。
建议从多个样本量与多个随机扰乱种子检查结果。
下面的代码接续前面的 problem 与 ishigami_model。
python
records = []

for base_N in [256, 512, 1024, 2048, 4096]:
    for sampling_seed in [11, 22, 33]:
        X_check = sobol_sample.sample(
            problem,
            base_N,
            calc_second_order=False,
            scramble=True,
            seed=sampling_seed,
        )

        Y_check = ishigami_model(X_check)

        Si_check = sobol_analyze.analyze(
            problem,
            Y_check,
            calc_second_order=False,
            num_resamples=300,
            seed=1000 + sampling_seed,
        )

        for i, name in enumerate(problem["names"]):
            records.append(
                {
                    "N": base_N,
                    "seed": sampling_seed,
                    "parameter": name,
                    "S1": Si_check["S1"][i],
                    "ST": Si_check["ST"][i],
                    "ST_conf": Si_check["ST_conf"][i],
                }
            )

convergence = pd.DataFrame(records)

summary = (
    convergence
    .groupby(["N", "parameter"])[["S1", "ST", "ST_conf"]]
    .mean()
)

print(summary)
判断收敛时,关注三个方面。
- 参数排序是否稳定。
- 指标数值是否趋于稳定。
- 不同种子之间的差异和置信区间是否足够小。
把 num_resamples 从 100 提高到 1000,主要是在改进置信区间估计,不会替代新增模型样本。
三、典型场景实战,从工程模型到现有数据
掌握 Sobol 后,可以把同一套思路迁移到真实任务。本节用几个完整或可衔接的案例,展示方法选择、代码组织与结果解释。
3.1 案例二,工程成本模型与 Morris 筛选
假设要估计一套小型系统的年度总成本,考虑以下因素。
- 能源需求。
- 设备效率。
- 能源单价。
- 安装费用。
- 年维护费用。
- 与能源成本相关的附加费率。
为方便演示,定义一个简化成本模型。
C=ηEp(1+r)+10Cinstall+Cmaintenance
这里的十年分摊属于教学假设,没有加入贴现率、残值等完整财务因素。
python
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

from SALib.sample import morris as morris_sample
from SALib.analyze import morris as morris_analyze


def annual_cost_model(X):
    X = np.asarray(X, dtype=float)

    demand = X[:, 0]
    efficiency = X[:, 1]
    price = X[:, 2]
    installation = X[:, 3]
    maintenance = X[:, 4]
    surcharge = X[:, 5]

    energy_cost = demand * price / efficiency

    return (
        energy_cost * (1.0 + surcharge)
        + installation / 10.0
        + maintenance
    )


cost_problem = {
    "num_vars": 6,
    "names": [
        "demand",
        "efficiency",
        "price",
        "installation",
        "maintenance",
        "surcharge",
    ],
    "bounds": [
        [8000.0, 16000.0],
        [0.70, 0.95],
        [0.40, 1.00],
        [10000.0, 30000.0],
        [300.0, 1500.0],
        [0.00, 0.20],
    ],
}

levels = 6

X_morris = morris_sample.sample(
    cost_problem,
    N=80,
    num_levels=levels,
    optimal_trajectories=20,
    local_optimization=True,
    seed=2026,
)

Y_morris = annual_cost_model(X_morris)

Si_morris = morris_analyze.analyze(
    cost_problem,
    X_morris,
    Y_morris,
    num_levels=levels,
    num_resamples=500,
    conf_level=0.95,
    seed=2027,
    print_to_console=False,
)

morris_table = pd.DataFrame(
    {
        "mu": Si_morris["mu"],
        "mu_star": Si_morris["mu_star"],
        "sigma": Si_morris["sigma"],
        "mu_star_conf": Si_morris["mu_star_conf"],
    },
    index=cost_problem["names"],
).sort_values("mu_star", ascending=False)

print("Model evaluations:", X_morris.shape[0])
print(morris_table)

fig, ax = plt.subplots(figsize=(7, 5))

ax.scatter(
    morris_table["mu_star"],
    morris_table["sigma"],
)

for name, row in morris_table.iterrows():
    ax.annotate(
        name,
        (row["mu_star"], row["sigma"]),
        xytext=(5, 5),
        textcoords="offset points",
    )

ax.set_xlabel("mu_star")
ax.set_ylabel("sigma")
fig.tight_layout()
plt.show()
Morris 通过多条轨迹,在不同位置依次扰动参数,计算基本效应。优化轨迹采样可以从候选轨迹中挑选覆盖更好的子集。上例生成 80 条候选轨迹,最终保留 20 条。无分组时,实际模型运行次数为
20(6+1)=140
候选轨迹生成与选择也会消耗计算资源,只是没有要求对全部候选点运行模型。
如何解释 Morris 结果
| 指标或模式 | 含义 | 解释边界 |
|---|---|---|
mu |
基本效应的平均值 | 正负效应可能相互抵消 |
mu_star |
基本效应绝对值的平均值 | 常用来做重要性筛选 |
sigma |
基本效应的标准差 | 较大可能来自非线性、交互或噪声 |
mu_star 大、sigma 小 |
效应较强,变化相对稳定 | 仍需结合模型结构理解 |
mu_star 大、sigma 大 |
重要且响应随位置明显变化 | 不能只凭这一点区分非线性与交互 |
| 两者都较小 | 在给定范围内影响可能较弱 | 需要结合轨迹数量与不确定性判断 |
**Morris 指标不能解释成方差贡献百分比。**它的定位是筛选与结构探索。
scaled=True 可以使用按输入输出标准差缩放的基本效应,有利于某些比较任务,但会改变指标含义。分析时应使用模型实际评价的输入,并在报告中说明是否进行了缩放。
3.2 对工程模型进一步做 Sobol 分析
下面的代码使用上一案例中的 cost_problem 与 annual_cost_model,保持全部六个参数,开展定量归因。
python
from SALib.sample import sobol as sobol_sample
from SALib.analyze import sobol as sobol_analyze

X_cost = sobol_sample.sample(
    cost_problem,
    4096,
    calc_second_order=False,
    scramble=True,
    seed=123,
)

Y_cost = annual_cost_model(X_cost)

Si_cost = sobol_analyze.analyze(
    cost_problem,
    Y_cost,
    calc_second_order=False,
    num_resamples=500,
    seed=124,
)

cost_sobol = pd.DataFrame(
    {
        "S1": Si_cost["S1"],
        "ST": Si_cost["ST"],
        "ST_conf": Si_cost["ST_conf"],
        "interaction_gap": Si_cost["ST"] - Si_cost["S1"],
    },
    index=cost_problem["names"],
).sort_values("ST", ascending=False)

print(cost_sobol)
这里新增的 interaction_gap 是总效应减去一阶效应,用来观察涉及该参数的交互贡献。
它与参数相关的全部高阶交互有关,不能直接当作某一对参数的二阶指数;不同参数的差值也不能简单相加,以免重复计算交互。
结果如何转化成行动,可以沿着这条路线理解。
- 能源单价重要,说明价格情景设定对成本结论影响大。
- 需求重要,说明需求预测质量很关键。
- 效率重要,说明性能测量或技术选型值得投入资源。
- 安装费用重要,说明采购报价的不确定性需要认真控制。
- 总效应明显高于一阶效应,说明该参数的作用依赖其他因素。
这些都是对当前成本模型和当前参数分布的判断。它们不能直接替代投资优化,也不能告诉你哪个参数最容易控制。
3.3 案例三,时间序列输出的逐时分析
许多模型的输出是一条曲线,例如温度、径流量、浓度或感染人数。此时敏感性通常也随时间变化。
考虑一个简化冷却模型。
T(t)=Tambient+(T0−Tambient)e−kt
参数包括初始温度、环境温度和冷却系数。
python
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

from SALib.sample import sobol as sobol_sample
from SALib.analyze import sobol as sobol_analyze


def cooling_model(X, times):
    initial = X[:, 0][:, None]
    ambient = X[:, 1][:, None]
    rate = X[:, 2][:, None]

    return ambient + (initial - ambient) * np.exp(
        -rate * times[None, :]
    )


cooling_problem = {
    "num_vars": 3,
    "names": ["initial_temperature", "ambient_temperature", "cooling_rate"],
    "bounds": [
        [70.0, 90.0],
        [15.0, 25.0],
        [0.05, 0.20],
    ],
}

times = np.linspace(0.0, 60.0, 121)

X_cooling = sobol_sample.sample(
    cooling_problem,
    2048,
    calc_second_order=False,
    scramble=True,
    seed=2026,
)

Y_time = cooling_model(X_cooling, times)

assert Y_time.shape == (X_cooling.shape[0], len(times))

S1_time = np.empty((len(times), cooling_problem["num_vars"]))
ST_time = np.empty_like(S1_time)

for j in range(len(times)):
    output_at_time = Y_time[:, j]

    if np.var(output_at_time) == 0.0:
        S1_time[j] = np.nan
        ST_time[j] = np.nan
        continue

    Si_t = sobol_analyze.analyze(
        cooling_problem,
        output_at_time,
        calc_second_order=False,
        num_resamples=200,
        seed=5000 + j,
    )

    S1_time[j] = Si_t["S1"]
    ST_time[j] = Si_t["ST"]

fig, ax = plt.subplots(figsize=(8, 4))

for i, name in enumerate(cooling_problem["names"]):
    ax.plot(times, ST_time[:, i], label=name)

ax.set_xlabel("Time")
ax.set_ylabel("Total-order Sobol index")
ax.legend()
fig.tight_layout()
plt.show()

time_result = pd.DataFrame(
    ST_time,
    columns=cooling_problem["names"],
)

time_result.insert(0, "time", times)
time_result.to_csv("cooling_total_effects.csv", index=False)
每一列都是一个时间点的标量输出,因此可以使用同一套 Sobol 样本逐列分析。增加分析时间点通常不需要新增参数采样,也不需要额外运行模型,前提是模型已经保存了这些时间点的结果。
这个案例有几个清晰的理论检查点。
- 在初始时刻,输出等于初始温度,因此初始温度决定全部输出方差。
- 随着时间增加,冷却系数会影响变化速度。
- 时间足够长时,温度趋近环境温度,环境温度逐渐主导结果。
**不要把整个时间序列矩阵直接展平后分析。**展平会破坏样本与输出之间的对应关系。
3.4 多输出与时间序列摘要指标
逐时分析很详细,但决策往往只关注几个指标。
- 最终温度。
- 最大值。
- 累积热暴露。
- 超过危险阈值的持续时间。
以下代码接续冷却案例,将曲线转成几个标量输出。
python
outputs = {
    "final_temperature": Y_time[:, -1],
    "maximum_temperature": Y_time.max(axis=1),
    "temperature_integral": np.trapezoid(
        Y_time,
        x=times,
        axis=1,
    ),
}

analysis_by_output = {}

for output_name, values in outputs.items():
    Si_output = sobol_analyze.analyze(
        cooling_problem,
        values,
        calc_second_order=False,
        num_resamples=300,
        seed=2028,
    )

    analysis_by_output[output_name] = pd.DataFrame(
        {
            "S1": Si_output["S1"],
            "ST": Si_output["ST"],
        },
        index=cooling_problem["names"],
    )

for output_name, table in analysis_by_output.items():
    print("\n", output_name)
    print(table)
在这个特定模型和参数范围下,温度单调下降,所以最大温度就是初始温度。这是一个有用的代码检查,不代表其他动态模型也有相同性质。
不同输出指标对应不同问题,参数排序当然可能不同。论文中应明确写出分析的是最终值、峰值、积分,还是整条曲线。
3.5 使用 ProblemSpec 组织多输出工作流
SALib 还提供 ProblemSpec 对象,可以串联采样、模型评价与分析,并组织多个输出。官方文档说明,这个接口会提供额外检查,也会带来一定运行开销。
下面是一份独立示例。
python
import numpy as np
from SALib import ProblemSpec


def response_model(X):
    x1 = X[:, 0]
    x2 = X[:, 1]
    x3 = X[:, 2]

    response_1 = x1 + x2 ** 2
    response_2 = x1 * x3

    return np.column_stack([response_1, response_2])


sp = ProblemSpec(
    {
        "names": ["x1", "x2", "x3"],
        "bounds": [[0.0, 1.0] for _ in range(3)],
        "outputs": ["response_1", "response_2"],
    }
)

(
    sp.sample_sobol(
        2048,
        calc_second_order=False,
        scramble=True,
        seed=101,
    )
    .evaluate(response_model)
    .analyze_sobol(
        calc_second_order=False,
        num_resamples=300,
        seed=102,
    )
)

print(sp.samples.shape)
print(sp.results.shape)

for output_name in ["response_1", "response_2"]:
    result = sp.analysis[output_name]
    print(output_name)
    print("S1:", result["S1"])
    print("ST:", result["ST"])
学习初期,函数式接口更容易看清 X、Y 和分析结果的关系。流程成熟以后,ProblemSpec 往往更便于管理。
3.6 案例四,偏态输出与 PAWN
Sobol 主要研究方差。当输出呈现明显偏态、多峰,或者任务关注阈值变化时,观察完整分布也很有价值。
PAWN 的基本思路是比较两种分布。
- 所有输入共同变化时的输出分布。
- 某个输入限制在一个局部区间时的输出分布。
如果限制某个输入后,输出分布变化明显,就说明这个输入有较强影响。SALib 的 PAWN 实现使用 Kolmogorov--Smirnov 距离比较分布。
考虑一个非线性的损失模型。
python
import numpy as np
import pandas as pd

from SALib.sample import latin
from SALib.analyze import pawn


def loss_model(X):
    loading = X[:, 0]
    resistance = X[:, 1]
    interaction = X[:, 2]

    margin = loading - resistance + 0.4 * loading * interaction

    return np.exp(3.0 * margin)


loss_problem = {
    "num_vars": 3,
    "names": ["loading", "resistance", "interaction"],
    "bounds": [
        [0.0, 1.0],
        [0.0, 1.0],
        [0.0, 1.0],
    ],
}

X_loss = latin.sample(
    loss_problem,
    8000,
    seed=2026,
)

Y_loss = loss_model(X_loss)

Si_pawn = pawn.analyze(
    loss_problem,
    X_loss,
    Y_loss,
    S=10,
    print_to_console=False,
    seed=2027,
)

pawn_table = pd.DataFrame(
    {
        "minimum": Si_pawn["minimum"],
        "mean": Si_pawn["mean"],
        "median": Si_pawn["median"],
        "maximum": Si_pawn["maximum"],
        "CV": Si_pawn["CV"],
    },
    index=loss_problem["names"],
).sort_values("median", ascending=False)

print(pawn_table)这里,S=10 表示将每个输入划分为十个条件区间。各区间得到一个分布距离,再计算最小值、均值、中位数等摘要。
中位数较大,说明限制该输入时,输出分布通常会出现更明显的变化。
不过需要守住几个边界。
- PAWN 数值不能直接解释成方差贡献比例。
- PAWN 与 Sobol 指标不能混在同一条百分比尺度上比较。
- 条件区间过多会让每个区间中的样本变少。
- 条件区间过少会掩盖局部变化。
- PAWN 比较的是整体分布,不能自动等同于专门的尾部风险分析。
如果真正关心失败概率,可以把输出改为阈值事件。
I(Y>ycritical)
再对这个事件输出开展相应分析。此时需要足够多的失败和未失败样本;如果所有样本都落在同一侧,输出方差为零,就无法正常进行方差型分析。
3.7 已有仿真或观测数据怎么处理
如果手头已有 X 和 Y,却不是按 Sobol 结构生成的,不能仅凭样本数量符合公式就使用 Sobol 分析器。
官方 FAQ 将 DMIM、RBD-FAST、PAWN 和 HDMR 列为可用于现有数据的分析途径。
可接续上面的 X_loss 和 Y_loss 使用 RBD-FAST。
python
from SALib.analyze import rbd_fast

Si_rbd = rbd_fast.analyze(
    loss_problem,
    X_loss,
    Y_loss,
    M=10,
    num_resamples=300,
    seed=2028,
)

print(
    pd.DataFrame(
        {
            "S1": Si_rbd["S1"],
            "S1_conf": Si_rbd["S1_conf"],
        },
        index=loss_problem["names"],
    )
)但能够接受现有数据,不代表任何现有数据都适合。
需要检查输入空间覆盖、样本量、变量之间的依赖,以及采样机制是否与研究问题一致。尤其是观测数据中的相关关系,不能自动解释成干预某个变量产生的因果效应。
3.8 案例五,FAST 的完整调用
FAST 通过不同频率编码输入变化,再从输出的频率结构中估计敏感性。
下面沿用成本模型,展示完整调用。
python
from SALib.sample import fast_sampler
from SALib.analyze import fast

harmonics = 4
N_fast = 1024

X_fast = fast_sampler.sample(
    cost_problem,
    N_fast,
    M=harmonics,
    seed=2026,
)

Y_fast = annual_cost_model(X_fast)

Si_fast = fast.analyze(
    cost_problem,
    Y_fast,
    M=harmonics,
    num_resamples=300,
    seed=2027,
)

fast_table = pd.DataFrame(
    {
        "S1": Si_fast["S1"],
        "ST": Si_fast["ST"],
    },
    index=cost_problem["names"],
)

print("Model evaluations:", X_fast.shape[0])
print(fast_table)
FAST 采样的模型运行次数通常为
Mruns=ND
采样器参数 M 表示谐波设置,与上式中的模型运行次数是不同概念。代码采用 harmonics 变量名,避免混淆。
采样器要求基础样本量满足相应频率条件,通常为
N>4M2
采样与分析中的谐波参数应保持一致。FAST 适合获取一阶与总效应,但这个接口不会像 Sobol 二阶分析那样,直接给出参数对之间的二阶交互矩阵。
3.9 非均匀分布,准确表达参数不确定性
现实中的参数未必均匀分布。
测量误差可能接近正态分布,始终为正的乘性参数可能接近对数正态分布,专家判断则可能使用三角分布。
SALib 通过 dists 指定边际分布。不过,一旦改变分布,bounds 的含义也可能改变。
| 分布标识 | bounds 的含义 |
容易误解的地方 |
|---|---|---|
unif |
下界、上界 | 区间内密度相同 |
norm |
均值、标准差 | 两个值不是上下界 |
lognorm |
对数空间的均值、标准差 | 不是原变量的均值与标准差 |
truncnorm |
下界、上界、均值、标准差 | 顺序不能与 SciPy 的标准化截断参数混用 |
下面的示例分别使用均匀、正态和对数正态分布。
python
import numpy as np

from SALib.sample import sobol as sobol_sample
from SALib.analyze import sobol as sobol_analyze

distribution_problem = {
    "num_vars": 3,
    "names": ["uniform_factor", "normal_factor", "positive_factor"],
    "bounds": [
        [0.0, 1.0],
        [10.0, 2.0],
        [0.0, 0.25],
    ],
    "dists": ["unif", "norm", "lognorm"],
}

X_dist = sobol_sample.sample(
    distribution_problem,
    2048,
    calc_second_order=False,
    scramble=True,
    seed=2026,
)

Y_dist = (
    X_dist[:, 0]
    + 0.2 * X_dist[:, 1]
    + X_dist[:, 2] ** 2
)

Si_dist = sobol_analyze.analyze(
    distribution_problem,
    Y_dist,
    calc_second_order=False,
    seed=2027,
)

print("S1:", Si_dist["S1"])
print("ST:", Si_dist["ST"])
如果原变量服从对数正态分布,已知其均值与标准差分别为 m 和 s,对数空间参数可转换为
σlog=ln(1+m2s2)
μlog=ln(m)−2σlog2
不要直接把原空间均值和标准差填进 lognorm 的参数配置。
另外,正态分布可能生成负值。如果参数具有严格物理边界,应考虑截断分布或更合适的正值分布。随意把负值裁剪为零,会改变你原先定义的概率模型。
3.10 参数分组,研究系统模块的整体影响
有时更关心整个模块,而不是单个参数,例如能源模块、投资模块和运维模块。
SALib 的 Sobol 与 Morris 方法支持参数分组。
下面的代码接续成本模型。
python
group_problem = {
    **cost_problem,
    "groups": [
        "energy",
        "energy",
        "energy",
        "investment",
        "operation",
        "energy",
    ],
}

X_group = sobol_sample.sample(
    group_problem,
    2048,
    calc_second_order=False,
    scramble=True,
    seed=2026,
)

Y_group = annual_cost_model(X_group)

Si_group = sobol_analyze.analyze(
    group_problem,
    Y_group,
    calc_second_order=False,
    seed=2027,
)

total_df, first_df = Si_group.to_df()

print(total_df)
print(first_df)分组后,结果对应组的作用。组内交互被包含在组自身效应中,因此组的一阶指数通常不能直接等于组内各参数一阶指数之和。
组数小于参数数时,分组设计通常能减少模型运行次数,但代价是丢失组内细节。X 仍然保留全部参数列,只是分析单位变成了组。
分组不会自动建立参数相关性,它与相关输入是两个不同的问题。
四、走向可靠应用,处理假设、性能与科研报告
代码能运行,只是入门。可靠的敏感性分析,还需要正确的输入假设、稳定的模型评价、合理的样本预算,以及清晰的解释边界。
4.1 输入相关与物理约束
经典 Sobol 分解建立在独立输入假设上。
现实系统中常见以下关系。
- 土壤参数具有统计相关性。
- 几种组分的比例之和必须为一。
- 长度与质量受到共同设计规则约束。
- 效率与能耗之间存在结构关系。
给 problem 中每个参数分别指定一个分布,并不会表达这些依赖关系。
如果直接采样相关输入,再套用独立输入的经典解释,指标可能混合统计依赖与模型作用,失去原有的清晰含义。
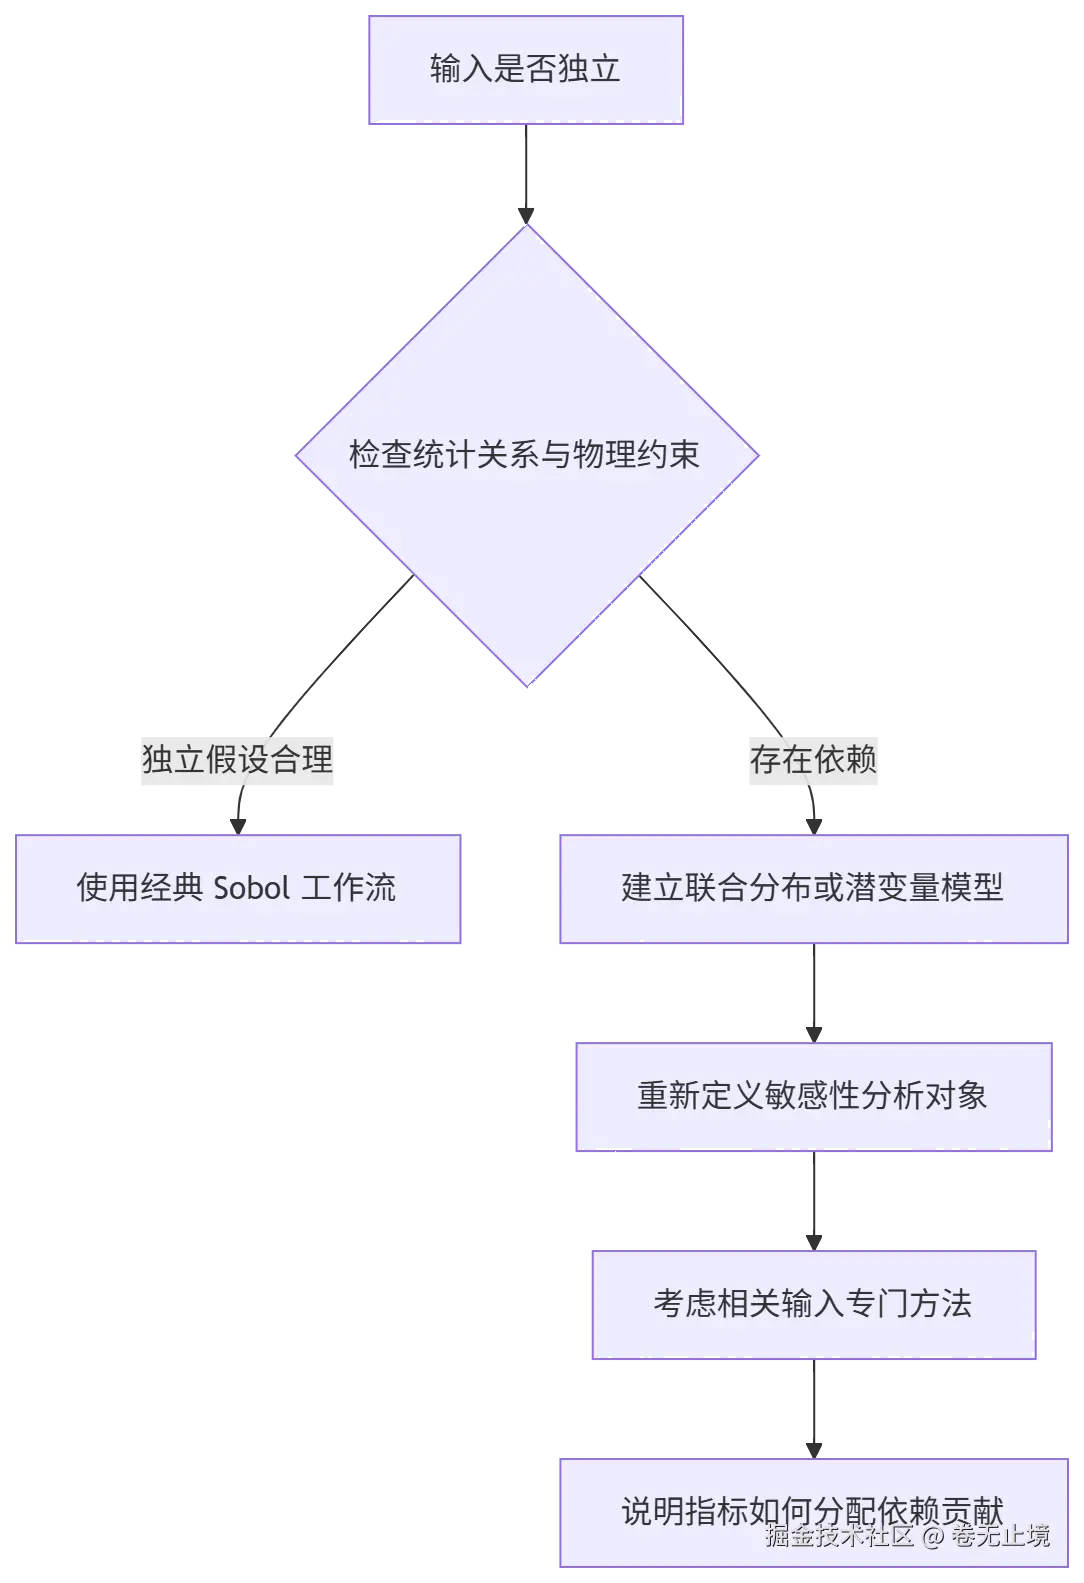
可行的处理思路包括以下几类。
- 用独立潜变量生成相关的物理参数,再分析潜变量的敏感性。
- 使用明确针对相关输入定义的方法,例如适当的 Shapley effects 方法。
- 针对设计约束重新参数化,例如用较少的自由变量构造满足比例和约束的参数。
使用潜变量后,得到的是潜变量的重要性。除非变换关系非常明确,否则不能直接将其重新命名为原物理参数的 Sobol 指标。
如果存在物理约束,也不要简单删掉不满足约束的 Sobol 样本行。删除会破坏结构化设计,还会改变输入分布。
4.2 外部模型与并行计算
SALib 的分离式工作流很适合外部仿真。
建议先构造一个单次模型评价函数,确保一组参数得到一个标量输出;然后再并行执行。
下面的示例使用独立 Python 脚本演示多进程。它计算一个简单确定性模型,实际项目中可以替换 evaluate_one 的内部逻辑。
python
import numpy as np
from concurrent.futures import ProcessPoolExecutor

from SALib.sample import sobol as sobol_sample
from SALib.analyze import sobol as sobol_analyze


def evaluate_one(row):
    a, b, c = row
    return float(a + b ** 2 + a * c)


def main():
    problem = {
        "num_vars": 3,
        "names": ["a", "b", "c"],
        "bounds": [[0.0, 1.0] for _ in range(3)],
    }

    X = sobol_sample.sample(
        problem,
        1024,
        calc_second_order=False,
        scramble=True,
        seed=2026,
    )

    with ProcessPoolExecutor(max_workers=4) as pool:
        Y = np.asarray(
            list(pool.map(evaluate_one, X, chunksize=64)),
            dtype=float,
        )

    assert Y.shape == (X.shape[0],)
    assert np.isfinite(Y).all()

    Si = sobol_analyze.analyze(
        problem,
        Y,
        calc_second_order=False,
        seed=2027,
    )

    print("ST:", Si["ST"])


if __name__ == "__main__":
    main()
pool.map 会按输入顺序返回结果,这对 Sobol 特别重要。如果使用 as_completed,必须通过样本编号把输出放回原始位置。
外部软件还应考虑以下工程细节。
- 每次运行使用独立工作目录,避免并行写同一个文件。
- 保存样本编号、参数、日志和运行状态。
- 设置超时机制。
- 对暂时性失败进行有限重试。
- 保存最终输出,支持中断后继续计算。
- 区分数值求解失败与模型定义中的真实失败事件。
如果使用进程池,Windows 和部分交互式环境对函数可导入性有要求。优先把并行程序放在独立脚本中。
对于可向量化的 NumPy 模型,批量计算往往比逐样本多进程更快。模型很便宜时,并行调度开销可能比计算本身还大。
4.3 模型失败、NaN 与零方差
敏感性分析前,应进行最基本的数据检查。
python
def validate_scalar_output(X, Y):
    Y = np.asarray(Y, dtype=float)

    if Y.ndim != 1:
        raise ValueError("Expected a one-dimensional output vector.")

    if len(Y) != len(X):
        raise ValueError("Input and output sample counts differ.")

    if not np.isfinite(Y).all():
        raise ValueError("Output contains NaN or infinite values.")

    if np.var(Y) == 0.0:
        raise ValueError("Output variance is zero.")

    return Y
输出方差为零时,方差型指标的分母为零,结果没有正常的定义。
常见原因包括以下几种。
- 模型没有读取变化的参数。
- 输出文件被缓存,返回了旧结果。
- 选择的输出在当前范围内本来就恒定。
- 阈值事件没有被任何样本触发。
- 参数单位或取值范围配置错误。
出现失败样本时,不要静默删除。可以重试、修复数值求解器、重新定义有效参数空间,或者把失败作为单独的研究输出。
直接把所有失败样本填成一个极大值,会人为构造新的响应模型。只有明确的物理或决策依据,才适合这样处理。
4.4 随机模型怎样分析
有些模型在相同参数下也会产生不同输出,例如随机个体模拟、排队系统或蒙特卡洛模型。
此时可写为
Y=f(X,ω)
其中, ω 表示内部随机性。
如果每组参数只运行一次,敏感性结果会同时受到参数变化和内部随机波动的影响。先明确研究目标很重要。
| 研究目标 | 常见处理方式 | 需要说明的内容 |
|---|---|---|
| 参数如何影响平均输出 | 每组参数重复运行,估计条件均值 | 重复次数与均值估计误差 |
| 参数如何影响输出波动 | 每组参数估计方差或分位数,再分析这些摘要 | 摘要估计是否稳定 |
| 参数与内部随机性共同贡献多少 | 显式建模随机输入或采用相应方法 | 随机性与参数作用如何分配 |
| 参数如何影响失败概率 | 每组参数重复运行,估计事件概率 | 稀有事件的样本需求 |
对于条件均值分析,可以在每组参数下运行多次,得到平均输出后再分析。但有限重复次数仍会残留估计噪声。
复用随机数流有时能降低参数比较中的噪声,不过需要有意识地设计,不能让并行调度顺序决定随机数使用方式。仅仅在全部运行中使用同一个固定随机种子,也不能保证回答的是平均输出问题。
4.5 昂贵模型与代理模型
如果直接运行几十万次有限元计算不可行,可以先训练代理模型,再让 SALib 分析代理模型。
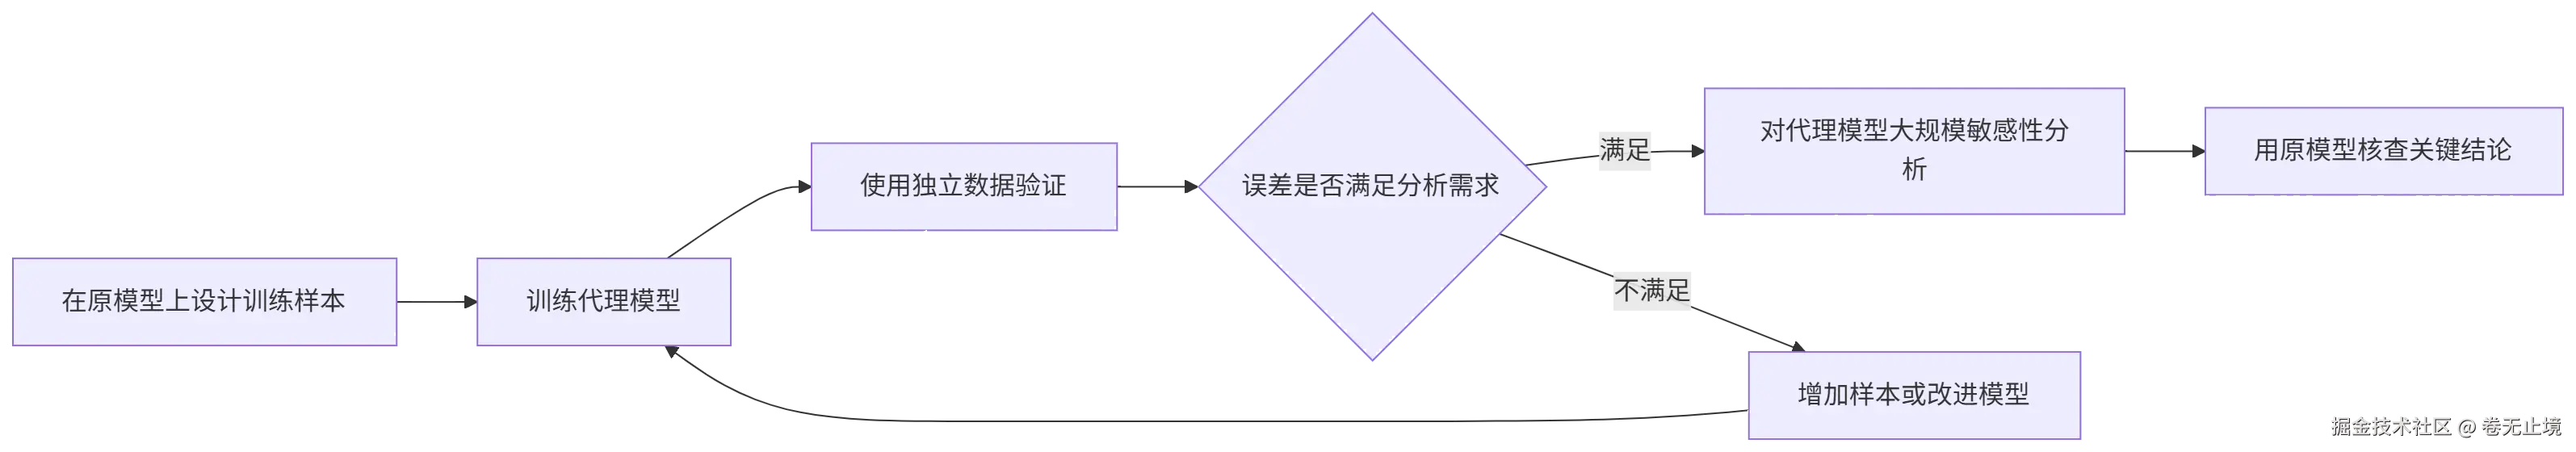
可选代理包括高斯过程、随机森林、梯度提升模型、多项式近似和神经网络。
这里最重要的是,对代理模型得到的敏感性指标,直接对应代理模型。
代理在整体预测误差上表现不错,也可能漏掉局部交互、边界行为或稀有事件。因此应当检查。
- 训练数据是否覆盖分析分布。
- 独立验证集误差是否足够小。
- 关键区域与阈值附近是否准确。
- 不同训练样本或代理模型下,重要性排序是否稳定。
- 原模型能否复核最重要的结论。
论文中应同时报告代理误差和敏感性估计不确定性。
4.6 结果解释中的常见陷阱
下面这些问题在实际项目里很常见,可以作为提交报告前的检查表。
| 问题 | 可能原因 | 建议处理 |
|---|---|---|
| Sobol 分析报样本数量错误 | 采样与分析的二阶设置不一致 | 检查两个阶段的参数 |
| 结果没有报错但明显异常 | 输出顺序改变,或使用了不匹配的采样 | 核对样本编号与设计结构 |
| 出现很小的负指数 | 有限样本估计误差 | 增加样本并查看置信区间 |
| 总效应略小于一阶效应 | 估计尚未充分收敛 | 检查种子稳定性与样本量 |
| 某个参数完全不重要 | 范围太窄、未进入模型或被其他因素掩盖 | 检查配置与模型实现 |
| 参数排名随范围变化 | 输入不确定性假设发生变化 | 将范围情景作为研究结果报告 |
| PAWN 与 Sobol 排名不同 | 指标关注的输出特征不同 | 分别解释,避免强行统一 |
Morris 的 sigma 很大 |
非线性、交互或内部噪声 | 结合响应图与进一步分析判断 |
| 结果全是 NaN | 输出无方差或存在非法值 | 检查模型输出 |
| 多输出结论被一个排名替代 | 没有区分评价指标 | 按输出分别报告 |
SALib 的 Sobol 分析器会对输出进行中心化和按标准差标准化,以减轻非中心化输出带来的估计偏差。一般无需提前对输出做同样的线性标准化。
但如果对输出取对数、平方或改成阈值事件,就改变了分析对象。例如,对成本和对数成本做敏感性分析,排序可能不同,两者都需要明确说明。
4.7 科研报告应该包含哪些信息
一份可复现的敏感性分析报告,至少应该交代以下内容。
模型与输出
- 模型方程、程序版本或仿真平台。
- 输出指标的定义、单位和时间范围。
- 模型是否包含内部随机性。
输入假设
- 参数名称、单位、范围和概率分布。
- 参数来源,例如测量、文献、专家判断或情景设定。
- 输入是否独立,是否有物理约束。
- 分析范围是否对应现实不确定性,还是探索性范围。
计算设计
- 敏感性分析方法。
- 基础样本量与实际模型运行次数。
- 是否计算二阶交互。
- 随机种子、重采样次数和置信水平。
- SALib、Python 及关键依赖版本。
- 失败样本、异常值和缺失值的处理。
结果与验证
- 指标表、置信区间与必要的交互结果。
- 样本量收敛和种子稳定性。
- 多输出之间的差异。
- 输入分布情景变化下的稳健性。
- 对参数测量、模型简化或后续研究的具体建议。
可使用这样的报告表述框架。
本研究在所设定的参数范围与独立输入分布下,采用 Sobol 方法分析目标输出的方差来源。参数重要性以总效应指数为主要依据,同时报告一阶指数与估计置信区间。通过增加基础样本量和改变采样随机种子,检查指标与排序的稳定性。相关结论适用于本文定义的模型、输出指标和输入不确定性情景。
这里没有填入未经实际运行验证的排名或数值,正式报告应补上真实结果。
4.8 从入门到熟练的学习路线
如果要把本教程转化成练习,可以按四个阶段推进。
-
跑通基准模型
运行 Ishigami 案例,确认数据形状,理解为什么
x3一阶效应为零却仍然重要。 -
掌握方法选择
对成本模型分别运行 Morris、Sobol 和 FAST,观察各方法结果及计算预算的差异。
-
处理实际输出与输入
完成冷却曲线逐时分析、摘要指标分析、PAWN 分布分析,以及非均匀分布和分组配置。
-
建立可信工作流
加入版本记录、失败检查、收敛验证、并行运行和结果保存,再接入自己的研究模型。
真正熟练使用 SALib,体现为能够把一个研究问题转换成明确的输入假设、合理的评价指标与可验证的计算设计。
**最重要的三句话是:参数重要性依赖你设定的不确定性范围;一阶效应小不等于参数可以删除;一次成功运行不等于结果已经可靠。**抓住这三点,SALib 就能从一组函数,变成帮助你理解模型、安排实验和组织科研论证的实用工具。
参考资料
SALib ProblemSpec Interface Basics