续 从命令到工作流:juejin-cli 如何让写作自动化更可靠 中的 juejin-cli, 开发了更加通用的CLI,支持多个平台自动化发布,具体使用场景,请继续阅读文章
写完一篇文章,往往只是发布工作的开始。
把它发到公众号,要处理排版、正文图片和封面;发到掘金,要选择分类、标签和专栏;如果还要做一篇小红书图文笔记,又需要准备适合那里的短正文和图片。切换平台之后,还得确认登录的是哪个账号、草稿有没有保存、文章是否真的发出去了。
wm 就是从这些重复而容易出错的工作出发的。
wm 是 WeMedia 的缩写,意为"自媒体"。它是一个供 AI 助手调用的多平台内容发布工具,安装后的命令名是 wm。
本文先介绍产品能解决什么问题,再从总体架构、项目结构和扩展方式入手,最后沿着一条发布请求解释具体实现。不需要你先了解源码。
实践说明:本文的正文保存、官网截图、架构图生成、平台查询、内容预览和发布流程均通过 wm CLI 完成。下文会结合实际命令说明这条工作流程。
一、先认识产品:AI 理解需求,wm 执行发布
下面是通过 wm content screenshot 截取的官网实景。
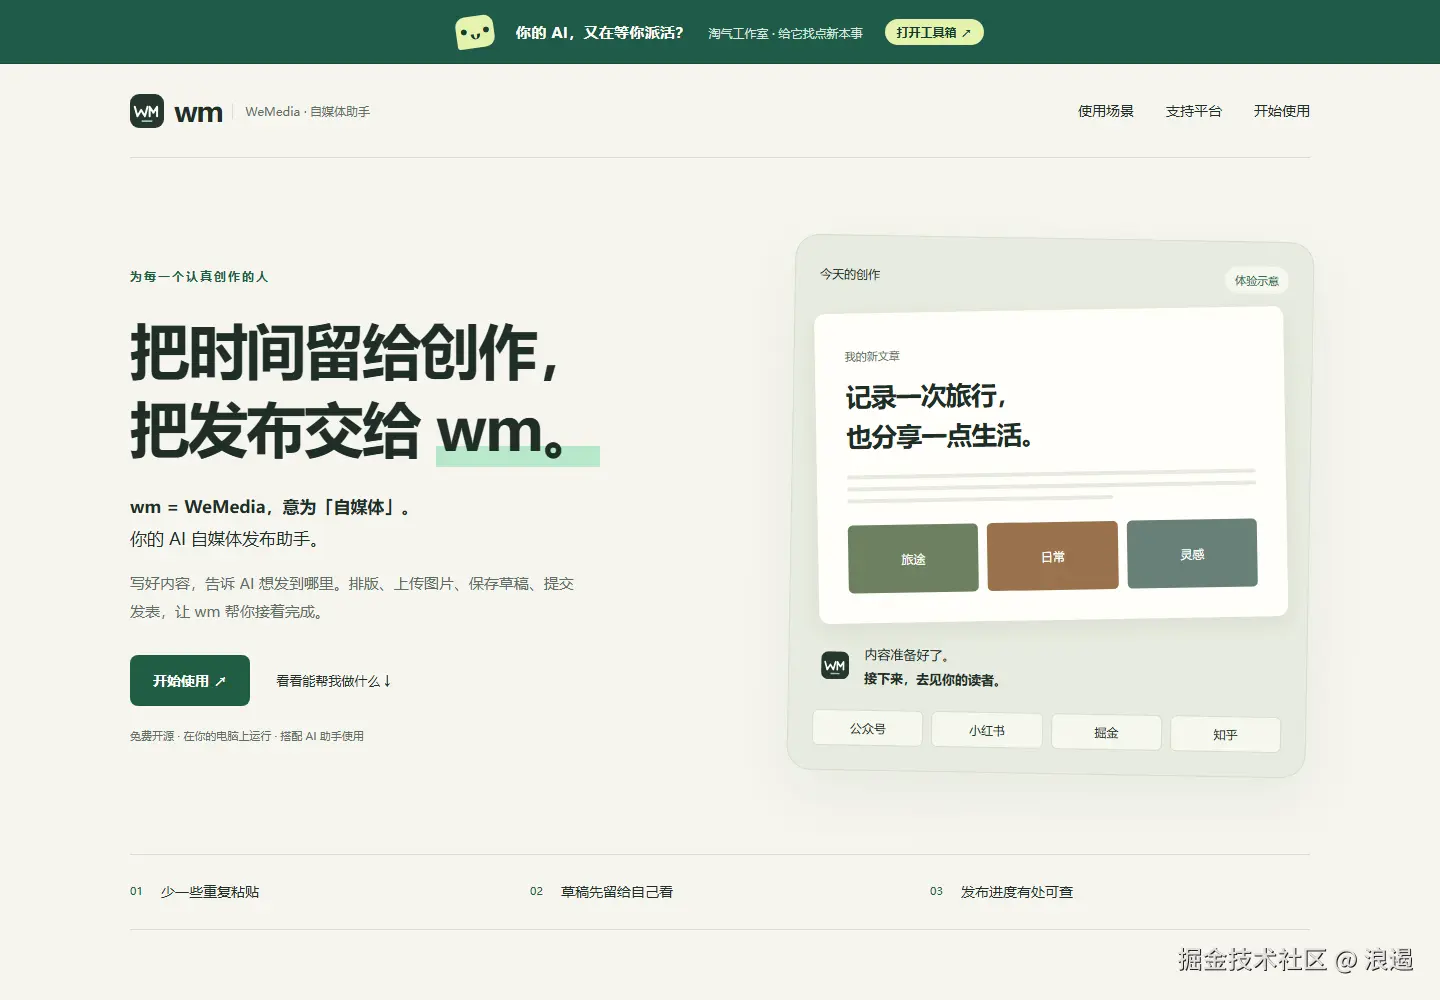
产品官网 的一句话定位是:把时间留给创作,把发布交给 wm。
这里有三个不同的角色:
| 角色 | 负责的事情 |
|---|---|
| 你 | 提供内容,说明目标账号和发布意图,完成必要的登录验证 |
| AI 助手 | 理解需求,整理输入,调用工具,并把结果解释给你 |
| wm | 准备平台内容,管理账号会话,执行上传、保存、发表与回查 |
wm 不自带一个替你思考的模型,也不把平台审核变成它能控制的事情。它提供的是一套明确、可检查的执行入口。
第一次使用,可以从一个很小的需求开始:
使用 wm,把这篇文章和配图保存到公众号草稿箱。先核对目标账号,检查封面与排版,只存草稿,暂不发表。
熟悉流程以后,再把目标扩展为多个平台。用户表达的是"帮我完成哪件事",AI 负责选择命令,wm 负责实际执行。
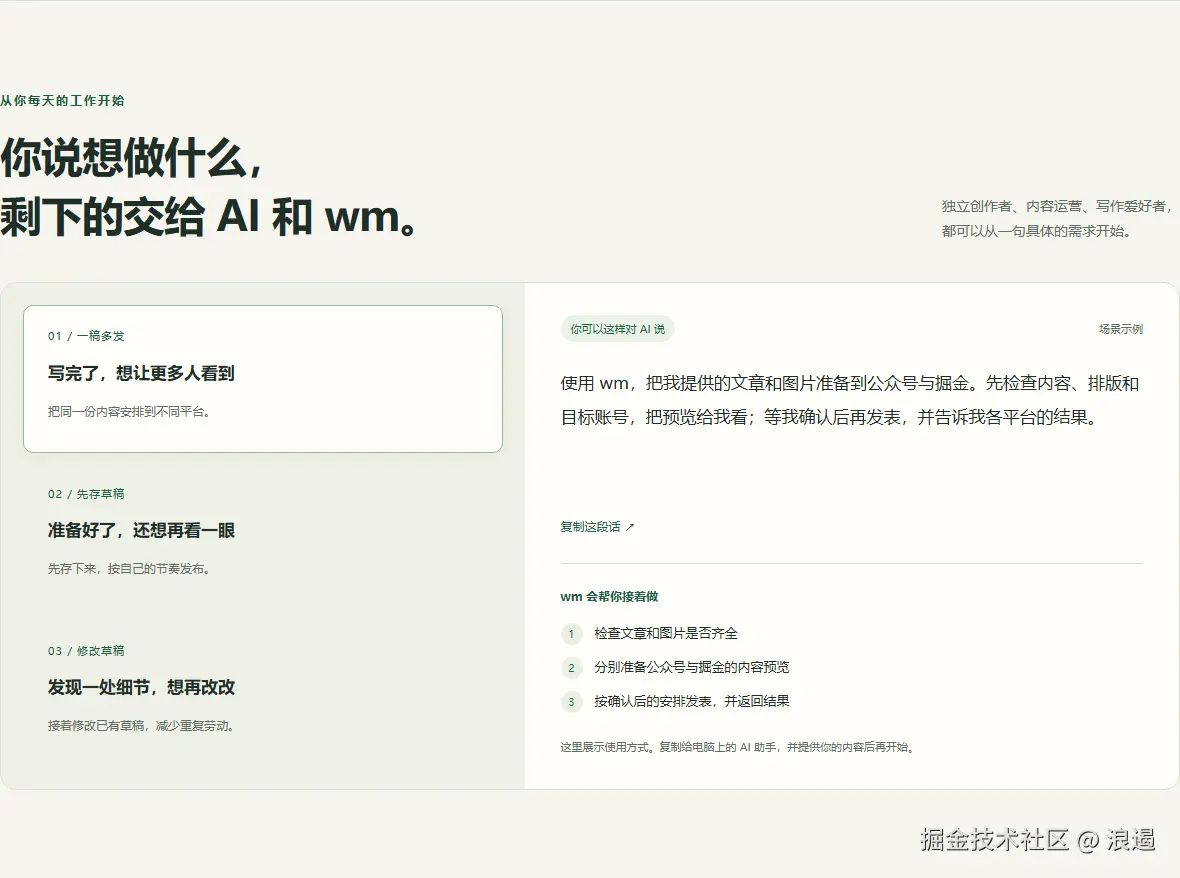
当前项目接入了掘金、微信公众号、小红书和知乎,但支持范围并不完全一样。例如,公众号与掘金支持修改已有草稿;小红书当前面向图文笔记,不提供保存草稿与视频发布;知乎当前支持专栏草稿创建、读取和发表,尚未提供已有草稿更新入口。
统一的是使用入口与执行机制,平台的实际能力仍然分别表达。 这也是理解后面架构的起点。
二、先看全貌:把变化和稳定的部分分开
多平台工具很容易从"几个发布脚本"开始,逐渐变成一个巨大的判断分支:如果是公众号就做排版,如果是掘金就补分类,如果断线就重试......
wm 的分层思路是先区分两类事情:
- 各平台都会遇到的事情:准备本次内容、识别目标账号、记录执行过程、核对失败结果。
- 必须由平台自己决定的事情:输入字段、图片限制、排版方式、接口请求、页面操作和成功判定。
下面的架构图由 wm content diagram 根据节点与连线定义生成。图中表达的是职责和主要调用关系,不是所有函数调用的完整时序。
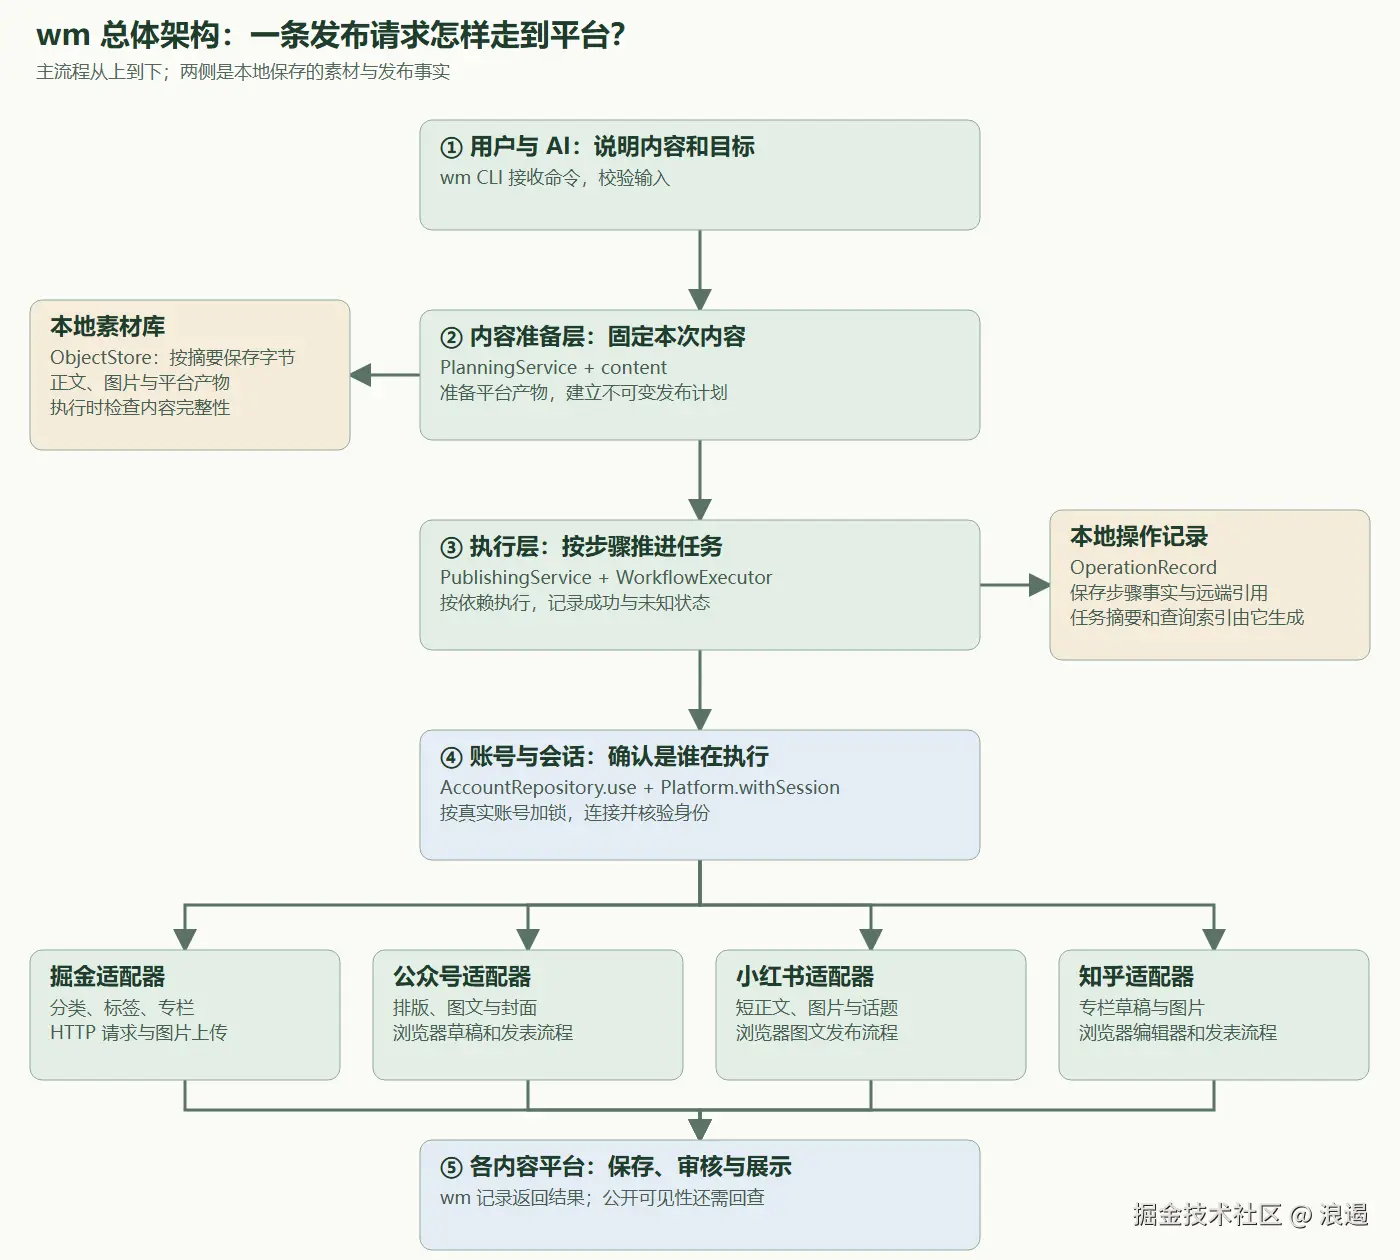
沿着主线理解就够了:
- 入口层把命令与文件变成经过校验的输入。
- 内容准备层生成各平台要使用的内容,并固定本次发布计划。
- 执行层根据计划推进步骤,把已经发生的事实保存下来。
- 账号与会话层保证连接的是正确账号,并协调同一账号的并发操作。
- 平台适配层负责真正的请求或浏览器操作,返回平台资源与处理结果。
两侧的本地存储也有明确分工:素材库回答"这次准备发布什么",操作记录回答"这次已经执行了什么"。这两个问题分开以后,内容修改和任务恢复就不容易互相干扰。
三、项目结构:目录边界就是责任边界
先看一个简化的源码结构:
text
src/
├─ wm.ts                  命令入口
├─ cli/                   命令注册、参数与输出
├─ core/                  能力、工作流、身份与内容契约
├─ content/               文档解析、素材发现、内容准备
├─ services/              计划、发布执行与结果查询
├─ runtime/               本地存储、账号、浏览器与工具安装
└─ platform/
   ├─ builtins.ts         装配内置平台
   ├─ juejin/             掘金规则与请求
   ├─ wechat/             公众号规则与页面流程
   ├─ xiaohongshu/        小红书规则与页面流程
└─ zhihu/ 知乎规则与页面流程这里值得借鉴的,不是目录数量,而是每类变化有一个明确的落点。
1. 平台变化,尽量只影响对应平台
比如掘金调整图片上传协议,修改应当落在 platform/juejin/;公众号编辑器改变了封面按钮,修改应当落在 platform/wechat/。
公共的内容处理和运行时模块不依赖具体平台实现。platform/builtins.ts 集中装配内置平台,发布服务通过注册表和能力契约工作。
这样,维护某个平台的页面选择器,不需要顺手修改任务恢复或本地文件存储。项目还用架构测试检查公共层不能反向导入具体平台,减少分层只停留在口头约定的情况。
2. "准备内容"和"执行写入"分开
PlanningService 负责准备计划;PublishingService 负责执行和协调任务。
这带来的实际价值是:可以先检查将要发布的内容,再决定何时执行。 如果第二个平台的输入有问题,准备阶段就能发现,而不是等第一个平台已经发布以后才报错。
对使用者来说,这是一份可审阅的预览;对实现来说,这是把本地准备和远端副作用拆成两个阶段。
3. 本地资源由运行时统一管理
账号目录、浏览器生命周期、文件存储等工作放在 runtime/,平台不必各自重复实现一套。
例如同一账号的锁、浏览器关闭和会话保存,属于所有平台都会遇到的问题。集中处理这些机制,有助于让平台代码专注于"这个网站应该怎么操作"。
四、扩展性:新增平台,不等于再复制一套工具
wm 的一个关键设计,是按"能力"组织平台功能。
可以把能力理解为平台公开的一项操作,例如保存草稿、读取文章、发表内容。每项能力说明自己的输入、输出,以及它是查询还是会修改远端内容。
这避免了强迫所有平台实现一个庞大的统一接口。小红书没有注册草稿保存能力,调用者就应当得到明确的不可用结果,而不是获得一个看似成功的空实现。
一份输入定义,服务三个地方
平台能力使用 Zod 定义输入结构。你可以把 Zod 理解为"用代码描述合法输入的规则"。同一份定义用于:
- 在入口处检查用户文件和参数;
- 给 TypeScript 处理器推导输入类型;
- 生成供 AI 查询的 JSON Schema。
命令语法则从 Commander 命令树生成。这样,实际执行的命令和 AI 读取的说明更容易保持一致,不需要再手工维护另一份平台参数清单。
例如 AI 可以先查询:
bash
wm schema --platform juejin --capability content.publish --json它看到的是当前注册的输入要求,而不是靠历史提示词猜分类、标签或专栏参数。
接入一个新平台,需要做什么?
一个典型的扩展过程是:
- 在
platform/<新平台>/实现登录、身份核验和会话连接。 - 声明这个平台真正支持的能力,以及各自的输入与输出。
- 实现内容准备逻辑,例如把文章变成平台需要的格式。
- 为写入能力编排步骤,提供请求或页面处理器;能回查的步骤补充回查逻辑。
- 在内置平台装配入口注册,并补上离线测试与真实账号验收。
原有的内容快照、账号绑定、任务记录、锁和结果查询机制可以继续复用。分类、专栏、话题等平台专属字段留在各自的定义里,而不必全部变成公共命令参数。
这并不意味着新增平台"只写配置就行"。页面自动化、上传协议、登录验证和成功判定仍然需要认真实现。分层的意义在于,把这些必要的工作集中在正确的位置。
项目测试里还包含自定义平台和二进制内容的例子,用来检查公共执行机制没有被某个现有平台或 Markdown 格式绑死。这比只在文档里说"支持扩展"更有说服力。
五、沿着一次发布,看清三个核心机制
整体结构清楚以后,再看具体实现。假设要把同一篇文章发到掘金和公众号。
1. 内容快照:固定"这一次"要发什么
如果你建立发布任务后,又修改了本地文章,稍后恢复任务时应该发布哪个版本?
wm 的做法是在准备阶段捕获本地正文和素材,保存内容修订与平台产物,再建立发布计划。ObjectStore 按内容摘要保存字节,并在读取时验证完整性。
这里的"摘要"可以理解为根据内容计算出的指纹。相同路径上的图片换了内容,指纹会改变;把同一份文件移动到另一个目录,也不应仅因为路径变化就当成一次新的发布意图。
执行阶段读取已经准备好的素材引用,而不是重新打开作者手边的原稿。因此,一个旧计划不会悄悄变成修改后的另一篇文章。
这个机制也有边界:远程图片如果只保存了 URL,并不意味着远程地址背后的图片字节已经被冻结。
2. 账号绑定:记住真实身份,而不只记住昵称
main 这样的账号别名很方便,但别名可以重新绑定。
如果一个任务只保存"发到 main",后来 main 指向另一个账号,恢复时就可能把文章发错地方。wm 会把任务绑定到平台与真实账号形成的稳定身份。
AccountRepository.use 按真实身份取得锁,Platform.withSession 建立连接并验证身份。同一真实账号的不同别名共享协调机制,旧任务也不会因为别名变化就改投另一个账号。
对第一次使用的人来说,只需要记住一点:命令里的别名是方便你选择账号的入口,任务执行时还会核对账号本身。
3. 操作记录:区分"失败"和"还不知道结果"
最难处理的情况往往不是平台明确拒绝,而是请求已经发出去,网络突然断开。
此时直接重新发送,可能生成重复文章。wm 把写入过程拆成有依赖的步骤,并用 OperationRecord 保存步骤状态、远端引用和回查信息。
任务摘要与文章索引用于方便查询,但是否执行过写入,以操作记录为准。索引丢失可以重建,不能因此认定"以前没有发过"。
恢复时大致有三种判断:
| 回查得到的情况 | 后续处理 |
|---|---|
| 有证据确认原操作已完成 | 保留原结果,跳过已完成步骤 |
| 有明确证据确认原操作未发生 | 允许继续相应步骤 |
| 仍然无法确定 | 保留未知状态,等待进一步核对 |
"列表里暂时没看到文章"不一定等于"文章没有提交"。审核、索引延迟都可能影响查询结果。
因此,wm 的目标是减少重复写入并提供可恢复的依据,而不是宣称跨所有平台都能实现绝对的"只执行一次"。平台如果没有足够的关联信息,工具也应当承认无法确定。
六、本文如何全程使用 wm CLI 完成
这篇文章也把自己的发布过程作为一次实践。
从准备素材到提交文章,可以把工作分为两个阶段:先在本地完成正文、截图和架构图,再连接目标平台检查并执行发布。wm content 负责公共素材准备,平台适配器负责各自的上传与发表规则。
下列示例统一使用 wm 命令名。使用时先通过 wm schema --json 查看所用版本支持的命令与参数。
先生成配图和正文
bash
# 官网实景截图:独立浏览器会话,不使用平台登录状态
wm content screenshot https://ganzhib.github.io/wemedia-cli/ \
  --width 1440 --height 1000 --output assets/website-hero.png --json

# 截取官网中的使用场景区域
wm content screenshot https://ganzhib.github.io/wemedia-cli/ \
  --selector '#playground' --output assets/website-scenarios.png --json

# 根据结构化节点与连线绘制本文架构图
wm content diagram-schema --json
wm content diagram architecture.json --output assets/architecture.png --json

# 将写好的正文从标准输入保存到本地文件
wm content write article.md --input - --json
截图命令返回本地图片及其摘要。绘图命令根据架构定义生成 PNG,图片不依赖平台是否支持 Mermaid。正文和配图都作为本地内容交给后续发布流程处理。
再确认专栏,建立可检查的发布计划
bash
wm auth login juejin --account main
wm platform exec juejin juejin.column.list --json
wm platform exec juejin juejin.category.list --json
wm article preview article.md --platform juejin --json
wm article plan article.md --to juejin:main --intent publish --json
wm plan inspect PLAN_ID --json
wm plan run PLAN_ID --json
本文目标是 CLI-Anything 专栏,ID 为 7706937894392823859,已经通过 wm 的专栏查询确认。分类、标签与专栏写在文章的平台配置中;正文图片由掘金适配器上传并替换引用,不使用独立的 juejin-cli 绕过流程。
PLAN_ID 是建立计划后实际返回的值。如果执行返回"已受理",还需要通过 wm job refresh 或资源查询核对公开状态;本文不把平台受理写成审核通过。
七、第一次尝试,可以从这里开始
如果你主要想使用产品,先安装当前预览版:
bash
npm install -g @ganzhibin/wemedia-cli@alpha然后让能操作本机的 AI 助手读取 wm 使用指导,引导你登录一个平台,先保存一份草稿。无需一开始就理解全部架构。
如果你更关心实现,可以按下面的顺序阅读源码:
src/cli/wm-program.ts:命令如何进入系统。src/services/planning.ts:如何固定本次内容和目标。src/services/publishing.ts与operations.ts:如何执行、记录和恢复。src/platform/juejin/adapter.ts:一个实际平台如何实现能力与步骤。
wm 值得借鉴的设计,是把"同一套执行机制"和"每个平台自己的规则"组织在清楚的边界里。内容、身份和执行事实各有明确归属,平台变化时才有机会把修改限制在局部。
它仍然是一个本机运行的预览版工具:文件锁与本地记录不等于分布式调度,多平台发布也不是跨站点事务。一个平台成功、另一个失败时,需要分别报告和处理。理解这些边界,才能合理使用它,也才能继续扩展它。
本文由 AI 协助撰写,结合源码组织架构说明;官网截图、架构绘图、正文落盘及平台发布操作使用 wm CLI。配图中的架构是对当前实现职责的概括,具体行为以源码、平台返回结果与实际验收记录为准。