作者:来自 Elastic Marcin Stożek
Elastic 全新的数据流功能可摄取任何数据,无论是否结构化,并对数据进行过滤、解析和丰富,让你在几分钟内就能开始调查,还可选择将数据路由到你自己的 存储 端点,例如亚马逊 S3。
 www.bilibili.com/video/BV13n...
Elasticsearch 在摄取时将原始日志转换为结构化、可搜索的数据。按照收集和分析日志(collect and analyze logs)教程,了解完整流程。立即开始免费云试用(free cloud trial),或在你的本地计算机(local machine)上试用 Elastic。
Elastic 数据流是 Elastic 云无 服务器 服务上面向遥测数据的托管数据管道。将任何遥测数据发送给它,它都会在日志、指标和追踪数据到达目标位置之前进行解析和丰富,然后决定将数据发送到哪里。你可以将完整记录发送到自己拥有的亚马逊 S3 存储桶,仅将实际查询的数据子集编入索引,也可以同时执行这两种操作。上游无须做任何更改。数据流的数据源支持开放遥测协议(OTLP)、Prometheus 远程写入以及 Elasticsearch 批量接口,因此 Logstash、Elastic Agent、Beats 和 Elastic 的开放遥测发行版(EDOT)都可以继续按现有方式发送数据。Elastic 负责运行执行处理任务的开放遥测(OTel)收集器,因此你无须为管道主机规划容量,也无须在凌晨两点排查出错的配置。私有预览版今日在 Elastic 云无服务器服务(Elastic Cloud Serverless)上开放。报名(Sign up)参与私有预览。
为什么数据流演变成了位于 Elasticsearch 前端的遥测数据管道
我们于 2025 年发布的数据流功能(Streams, which we released in 2025),最初用于在数据到达 Elasticsearch 后对其进行分区和处理。它很好地完成了这项工作,但作用范围止于集群边界:数据先进入 Elasticsearch,随后由数据流功能在那里处理,最终存储为 Elasticsearch 数据流。与此同时,每个 数据采集 器的解析器、字段映射和路由规则仍需手动编写。没有一个统一的位置可以查看或修改它们,而且每当数据格式发生变化时,它们就会悄然失效。
因此,我们重新构建了数据流功能,使其成为具备全新用户界面、能够将数据路由到亚马逊 S3 等任意端点的自主管理数据管道功能。我们还将它移到了集群前端,使其能够专注于管理数据管道。现在,处理发生在数据落地到任何位置之前,这改变了过滤和路由的意义。任何经过处理的数据都可以发送到 S3、Elasticsearch,或同时发送到两者,让你完全掌控遥测数据的存储位置。如果你已经在使用有线数据流或经典数据流,它们仍可继续工作;新模型是同一产品的演进。通过全新的数据流功能,你可以:
- 按自己的需求存储数据。
- 在全新用户界面中查看和管理数据摄取与处理。
- 无须任何配置即可使用,因为它是完全托管的。
在本文的其余部分,我们将逐一介绍它新增的功能。
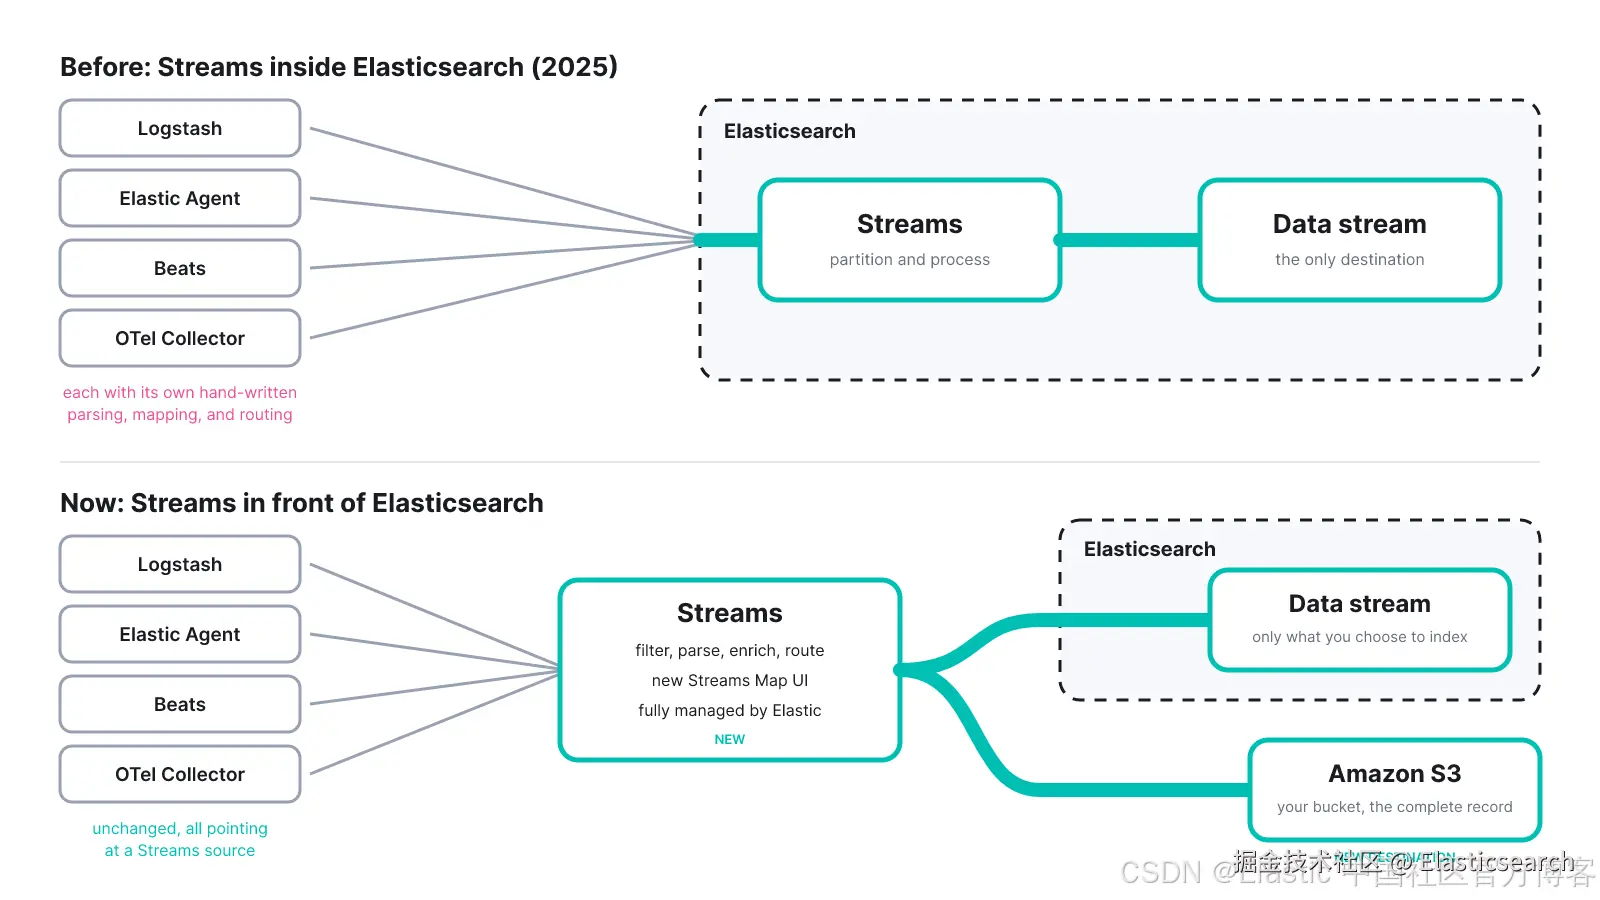 数据流功能从 Elasticsearch 内部移到了其前端。现在,处理过程由 Elastic 托管,可在全新的数据流映射图中查看,并可将数据路由到亚马逊 S3 和 Elasticsearch。
开放式设计:按你的需求将数据存储在亚马逊 S3 或 Elasticsearch 中
有些数据必须存放在你掌控的存储空间中,无论是你自己的 S3 存储桶,还是合规团队批准的位置。数据流功能会将数据直接路由到那里。复制路由会以换行符分隔的 JSON 格式将完整记录发送到你的存储桶,让你保留全部数据。通往 Elasticsearch 的路由只传输你需要查询的数据子集,该路由上的过滤器会在调试噪声进入索引之前将其丢弃。你只需为选择编入索引的数据支付 Elasticsearch 存储和保留费用,所有未编入索引的数据都会保留在你掌控的基础设施上。
S3 存储桶中的数据也能持续发挥作用。数据流功能写入 S3 的对象支持通过 Elasticsearch 查询语言(ES|QL)数据联邦(Elasticsearch Query Language (ES|QL) Data Federation)进行原地查询,该功能可直接读取存储桶中的 NDJSON 和 Parquet 文件,无须摄取这些文件。数据联邦现已在 Elastic 云无服务器服务上开放私有预览。这样,当调查需要某条未编入索引的记录时,你就可以使用与查询 Elasticsearch 相同的查询语言,访问存储桶中的数据。
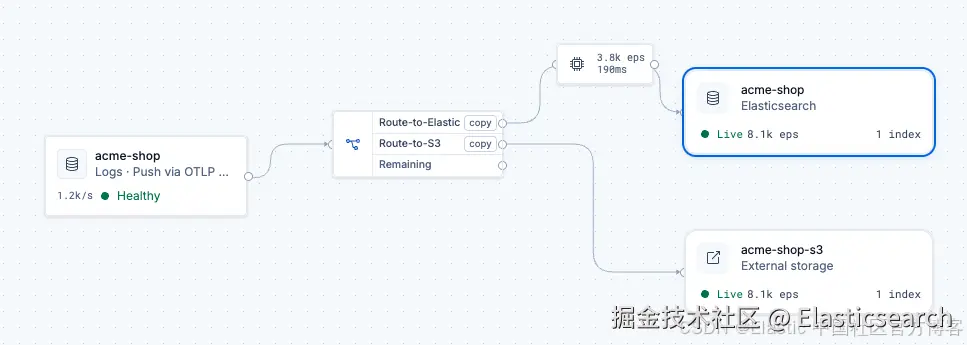 数据流映射图包含一个数据源和两个目标位置。完整记录发送到 S3,处理后的数据子集发送到 Elasticsearch。
在数据流映射图中查看和管理数据摄取
大多数管道都定义在配置文件中,难以大规模管理,调试起来也十分棘手。为此,我们构建了全新的用户界面 ------ 数据流映射图,将每个 数据源 、管道、路由器和目标位置都呈现在同一个屏幕上。打开管道,使用真实数据样本编辑其处理器时,你可以在保存之前看到提取出的字段。打开路由器,即可修改决定数据去向的条件。
要对管道进行版本控制,可以将完整配置导出为 YAML 文件,并通过拉取请求进行审查。然后,将其导入另一个环境。映射图和文件描述的是相同的数据流。
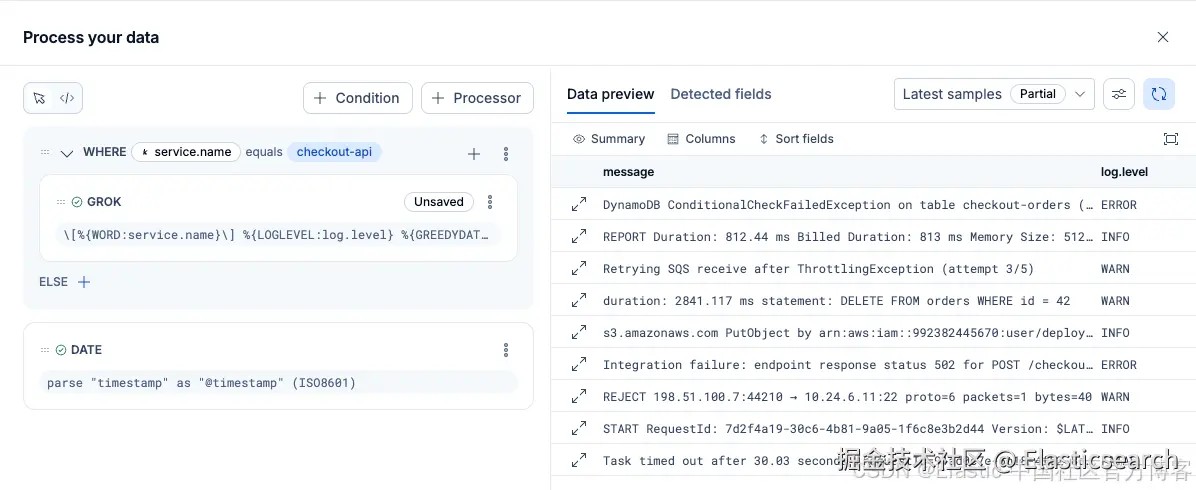 数据流管道编辑器,左侧是处理器,右侧是处理后数据的预览。
零运维;完全托管
数据流是完全托管的 Elastic 云服务 。你无须在本地或自己的云账户中安装或运行任何管道基础设施。目前,私有预览版仅在 Elastic 云无服务器服务上运行。后续将支持其他 Elastic 部署选项。
如果你目前自行运行开放遥测收集器(OTel Collectors),以下四项工作都需要你负责:
- 根据峰值数据量规划容量。
- 持续安装补丁。
- 在不丢失数据的情况下进行升级。
- 当数据停止传入时,查明哪个实例的配置出了问题。
使用数据流功能后,这四项工作都由 Elastic 负责。
数据处理在由 Elastic 运营、作为 Elastic 云服务一部分的开放遥测收集器中执行。它们位于 Elasticsearch 之外,因此解析、丰富和路由都会在数据到达你的项目之前完成,而且这些工作都不占用 Elasticsearch 的计算资源。原本用于准备数据的资源可以用于索引和搜索,而收集器则会随着摄取量的变化进行伸缩。
你看到的操作界面是数据流映射图。你可以在那里编辑管道和 路由器 ,或从纳入版本控制的 YAML 文件中导入配置,收集器会自动应用这些更改。你无须重启或重新部署任何组件。你的数据采集器始终指向同一个数据流数据源。
遥测数据管道在 Elastic 数据流中如何运作
在底层,数据从数据源进入,由管道进行处理,再由路由器分流,最终到达目标位置。_数据流_是从数据源到目标位置的任意一条路径,同一模型适用于日志、指标、追踪以及其他所有数据类型。
| 组件(Component) | 定义(What it is) | 运行位置(Where it runs) |
|---|---|---|
| 数据源 | 数据采集器发送数据的端点;接受开放遥测协议、Prometheus 远程写入和 Elasticsearch 批量请求 | Elastic 云无服务器服务 |
| 管道 | 一系列用于过滤、解析和丰富数据的处理器 | Elastic 托管的开放遥测收集器 |
| 路由器 | 决定数据发送到哪个目标位置的条件 | Elastic 托管的开放遥测收集器 |
| 目标位置 | 数据落地的位置:亚马逊 S3、Elasticsearch,或同时发送到两者 | 由你选择 |
其中两种管道与你已经运行的功能有所重叠,下面是它们的区别:
| 数据流管道(Stream pipeline) | Elasticsearch 摄取管道(Elasticsearch ingest pipeline) | |
|---|---|---|
| 运行位置(Runs in) | 集群外部,由 Elastic 托管的开放遥测收集器 | Elasticsearch 集群 |
| 运行时机(Runs when) | 数据到达任何目标位置之前 | 索引时,处理已经发往索引的数据 |
数据流数据源是数据采集器发送数据的端点,这意味着数据采集器本身的位置保持不变。数据流功能接受开放遥测协议、 Prometheus 远程写入和 Elasticsearch 批量请求。因此,Logstash、Elastic Agent、Beats 和 Elastic 的开放遥测发行版(EDOT)只需指向数据流数据源,即可继续发送数据,无须迁移到任何专有格式。使用数据流功能后,原本需要在每个数据采集器中分别编写的解析、丰富和路由逻辑,现在只需编写一次。未来,由集中管理功能管理的 Elastic Agent 也将能够指向数据流数据源。
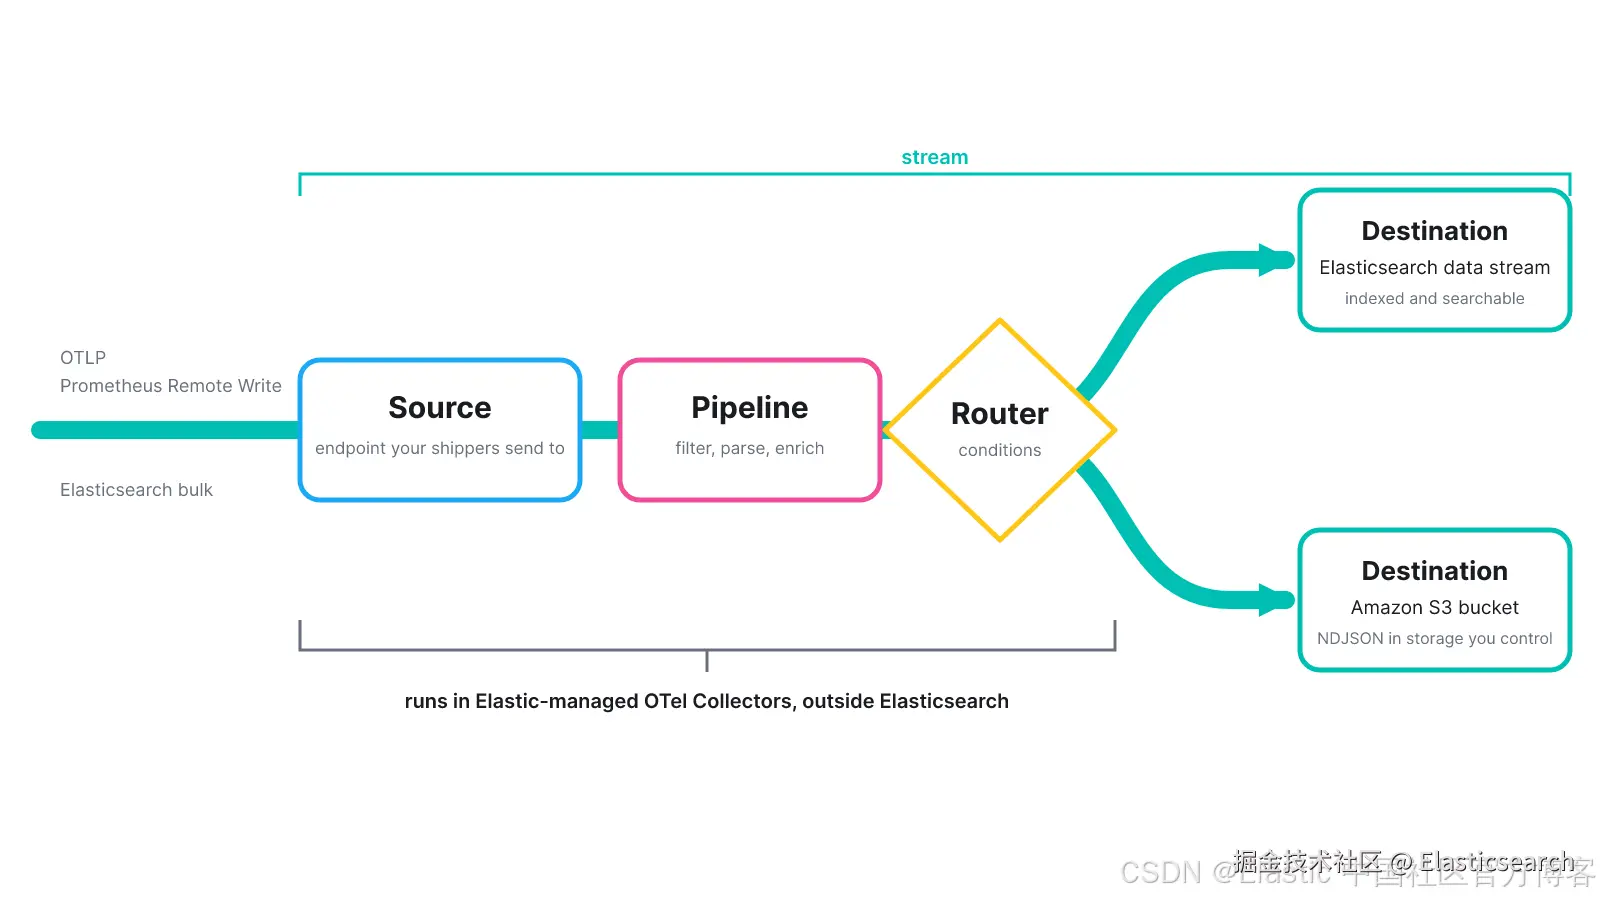 所有入口采用同一模型。
我们希望通过 Elastic 数据流私有预览了解什么
私有预览旨在帮助我们了解真实环境如何使用数据流功能,以及用户对其可靠性、吞吐量和延迟的期望。答案将来自那些使用自己的数据运行数据流功能,并告诉我们它在何处遇到瓶颈的用户,因此我们正在寻找积极参与的设计合作伙伴。
设计合作伙伴可以提前使用数据流功能,在私有预览期间免费使用,并与产品和工程团队直接交流反馈。作为回报,他们需要承诺在预览期间每周与我们进行一次简短通话。
最适合参与的是使用 Elastic 云无服务器服务的团队,他们通过多种数据采集器传输遥测数据,并且需要将数据存入自己掌控的 S3 存储桶。
你需要提供的内容:(What you need to provide:)
- 一个由你掌控的 S3 存储桶及其所在的亚马逊云服务区域。
- 一对具有该存储桶写入权限的访问密钥。
数据流功能会将密钥存储为密封凭据,因此它们绝不会出现在你导出的配置中。
预览期间的数据处理仅提供尽力而为的保障,因此,请将数据流功能作为现有可靠路径之外的第二条路径;对于无法承受丢失或无法重新传输的数据,不要通过数据流功能进行路由。
私有预览结束后,合作伙伴将进入公开技术预览阶段,届时数据流功能将向更多用户开放。我们预计这一阶段将于明年年初开始。
报名参与私有预览
我们会精心挑选客户参与预览,与我们合作改进设计。请告诉我们你正在运行哪些数据采集器、执行哪些处理,以及数据必须存储在哪里。我们会通过电子邮件通知入选的合作伙伴。立即报名(Sign up)。
原文:Managed observability pipelines with Elastic Streams | Elastic Observability Labs