MySQL 慢日志先别急着加索引:三个指标能拦掉大半误判
一份 123 条记录、累计 3783 秒的真实慢日志,最后只值得单独处理 1 条索引问题。真正让它慢的原因,加索引解决不了。这篇文章讲清楚:在动手建索引之前,先算哪三个数。
一、场景:一份出不了内网的慢日志
凌晨两点数据库告警。第二天拿到现场日志:123 条慢查询,累计耗时 3783 秒,平均一条慢 30 秒。
问题随之而来。这是内网环境的库,日志里有真实的表名和业务字段,不允许上传到任何外部服务;机器上没有外网,pip install 走不通,pt-query-digest 装不上;在线 SQL 分析平台一律不能用,连截图发群里都得先打码。
能用的只有一个 Python 3 解释器,和一份原始日志。
于是有了 analyze_slow_log.py:单文件,1780 行,零第三方依赖,只走标准库。跑完直接产出 Markdown 和 HTML 两份报告,全程不联网、不写临时文件、日志不出本机。
二、为什么不直接用现成工具
不是没试,是在内网环境下都卡在第一步:
| 方案 | 能力 | 内网环境下的问题 |
|---|---|---|
mysqldumpslow |
官方自带 | 只做最粗的归并,没有稳定性、并发度、改写建议 |
pt-query-digest |
强,业界标准 | 要装 Perl + 一堆依赖,内网机器往往没有;纯文本报告不好读 |
| 在线 SQL 分析 SaaS | 界面好、结论全 | 直接违规,日志必须上传 |
自己 grep + awk |
零依赖 | 多行 SQL、SET timestamp、5.6/5.7/8.0 三种格式差异,半小时就劝退 |
约束因此很明确:单文件、零依赖、兼容 5.6 / 5.7 / 8.0 慢日志格式、输出人能直接读的报告。
三、核心实现:先把 SQL 折叠成模板
排行榜的前提是「同类 SQL 归成一个模板」,否则 55 次执行会变成 55 行噪音。做法是折叠字面量:
python
import re

RE_STRING = re.compile(r"'(?:[^'\\]|\\.)*'|\"(?:[^\"\\]|\\.)*\"")
RE_HEX    = re.compile(r"\b0x[0-9a-fA-F]+\b")
RE_NUMBER = re.compile(r"(?<![\w.])-?\d+(?:\.\d+)?(?![\w.])")
# IN 值列表折叠成 in (?),但保留 in (select ...) 的结构
RE_IN_LIST = re.compile(r"\bin\s*\((?:\s*\?(?:\s*,\s*\?)*\s*)\)", re.I)

def fingerprint(sql: str) -> str:
    sql = RE_STRING.sub("?", sql)
    sql = RE_HEX.sub("?", sql)
    sql = RE_NUMBER.sub("?", sql)
    sql = RE_IN_LIST.sub("in (?)", sql)
    return re.sub(r"\s+", " ", sql).strip().lower()
效果是 where id in (1,2,3,4,5) 和 where id in (9,10) 归到同一个模板,55 次执行被算成一条 ------ 这才是它在库上的真实分量。
指纹是启发式的:极端动态 SQL(比如用
CONCAT拼出来的条件)仍可能归并错。这是这套方案的第一条局限,后面会统一列。
四、三个数,把误判拦在加索引之前
拿到慢日志的第一反应通常是「扫了多少行,加个索引」。下面三个数能把这种冲动先按住。
1. 平均并发度:它是不是在抢资源
text
平均并发度 = 累计查询耗时 ÷ 日志时间跨度上面那份日志:3783 秒的查询耗时,塞在 415 秒的窗口里,平均并发度 ≈ 9.1。意思是同一时刻平均有 9 个慢查询在跑。
这时候「每条都慢 30 秒」很可能不是每条都有自己的问题,而是一堆查询互相抢 CPU、IO 和连接。
报告里这个数 ≥ 1.5 就高亮告警,并直接写明:先怀疑批量并发打爆资源,而不是索引问题。
2. 稳定性(P95 ÷ 均值):它是每次都慢,还是偶尔慢
| 稳定性 | 含义 | 该做什么 |
|---|---|---|
| 1.x | 每次都这么慢 | 结构性问题 → 直接 EXPLAIN、加索引、改写法 |
| 1.5 ~ 3x | 主体稳定,略有抖动 | 先优化主体,再看抖动来源 |
| ≥ 3x | 不是每次都慢 | 查锁等待、长事务、缓存未命中、数据倾斜 |
抖动型不要急着加索引:它慢的那几次大概率不是没索引,而是被别的东西拖住了。优化优先级评分里抖动型会被 ×0.8 折价,就是防止它挤掉真正该做的索引优化。
3. 每行扫描耗时(ms/row):时间到底花在扫描上吗
text
ms/row = 平均耗时 ÷ 平均扫描行数正常索引扫描是微秒级,远小于 1 ms/行。如果一行扫下来要花几十上百毫秒,说明时间根本没花在扫描上,加索引的收益是零。
python
# g 为聚合后的指纹对象(avg_time / avg_examined / lock_ratio / avg_rows_sent 都取自它);
# slow_time、big_scan 及各项阈值来自命令行参数。以下只摘判定条件,完整实现在仓库的 classify() 里。
row_cost = g.avg_time * 1000 / g.avg_examined   # ms / 行

if (g.avg_time >= slow_time                  # 确实慢
        and g.avg_examined < big_scan     # 但没扫几行(小到 0 也要进,见第六节 bug 3)
        and row_cost >= 1.0               # 每行成本高得离谱
        and g.lock_ratio < 0.3            # 且不是锁等待
        and g.avg_rows_sent < 1000):      # 也不是搬大数据集
hit("P0", "耗时与扫描量不匹配(疑似资源争抢)")这条的修法是降并发,不是加索引 。另外,Rows_examined ≈ 0 却慢得离谱的(等锁、等 IO、子查询被反复执行),单独也判为同一类 ------ 判断条件里「扫描量小」不能写成 avg_examined > 0,否则最典型的样本会被排除掉。
五、真实复盘:184 行,扫了 30 秒
下面是真实日志跑出来的结果(已脱敏)。
报告开头:
text
慢查询条数:123        SQL 指纹(去重后模板):7
累计耗时:3,783.17s   单条 P95:55.73s   最大:57.60s
时间范围:02:01:02 ~ 02:07:57(415 秒)
平均并发度 ≈ 9.1
Top3 指纹占总耗时:94.9%
123 条慢查询挤在 7 分钟里,只有 7 个模板,前 3 个占了 95%。这是批量任务集中爆发最典型的样子。
排行榜(节选):
| # | 次数 | 总耗时 | 占比 | 平均 | P95 | 稳定性 | 扫描行 | 放大 | 命中 |
|---|---|---|---|---|---|---|---|---|---|
| 1 | 55 | 1684s | 44.5% | 30.6s | 55.7s | 波动 1.8x | 10106 | 184× | P0·资源争抢 P1·N+1 |
| 2 | 54 | 1629s | 43.1% | 30.2s | 55.7s | 波动 1.8x | 9884 | 183× | P0·资源争抢 P1·N+1 |
| 3 | 8 | 278s | 7.3% | 34.7s | 56.4s | 波动 1.6x | 292 | 36× | P0·资源争抢 |
| 4 | 3 | 98s | 2.6% | 32.6s | 42.3s | 稳定 1.3x | 0 | 0× | P0·资源争抢 |
| 7 | 1 | 4s | 0.1% | 3.9s | 3.9s | 样本少 | 32376 | 32376× | P1·缺索引 P2·NOT IN |
只看「扫描行 10106」这一列,很容易得出「扫了一万行,缺索引」的结论。
但报告给的是这句:
text
[P0] 耗时与扫描量不匹配(疑似资源争抢)

现象:平均每次只扫 184 行却耗时 30.63s,折合 166.7 ms/行(正常应 < 1.0 ms)
      执行 55 次,累计 1,684.45s
10106 是 55 次执行的累加值 ,平均每次只扫 184 行。184 行、30 秒、166.7 ms/行 ------ 正常索引扫描不可能是这个样子。而且 Lock_time = 0,不是锁等待。
结论因此完全变了:
- 不是缺索引,加了也没用;
- 是 02:01 那一刻批量任务一次性放开几十个查询互相抢资源,并发度 9.1 就是佐证;
- 真正该做的是把并发降到 5~10 一批,顺便查那几分钟的 CPU、IO、
Threads_running水位。
整份日志里唯一值得单独处理索引问题的,是最后那条 INSERT ... SELECT ... NOT IN(单次扫 32376 行,可改写成 NOT EXISTS)。
报告长这样(HTML 版,可直接分享给不看日志的人):
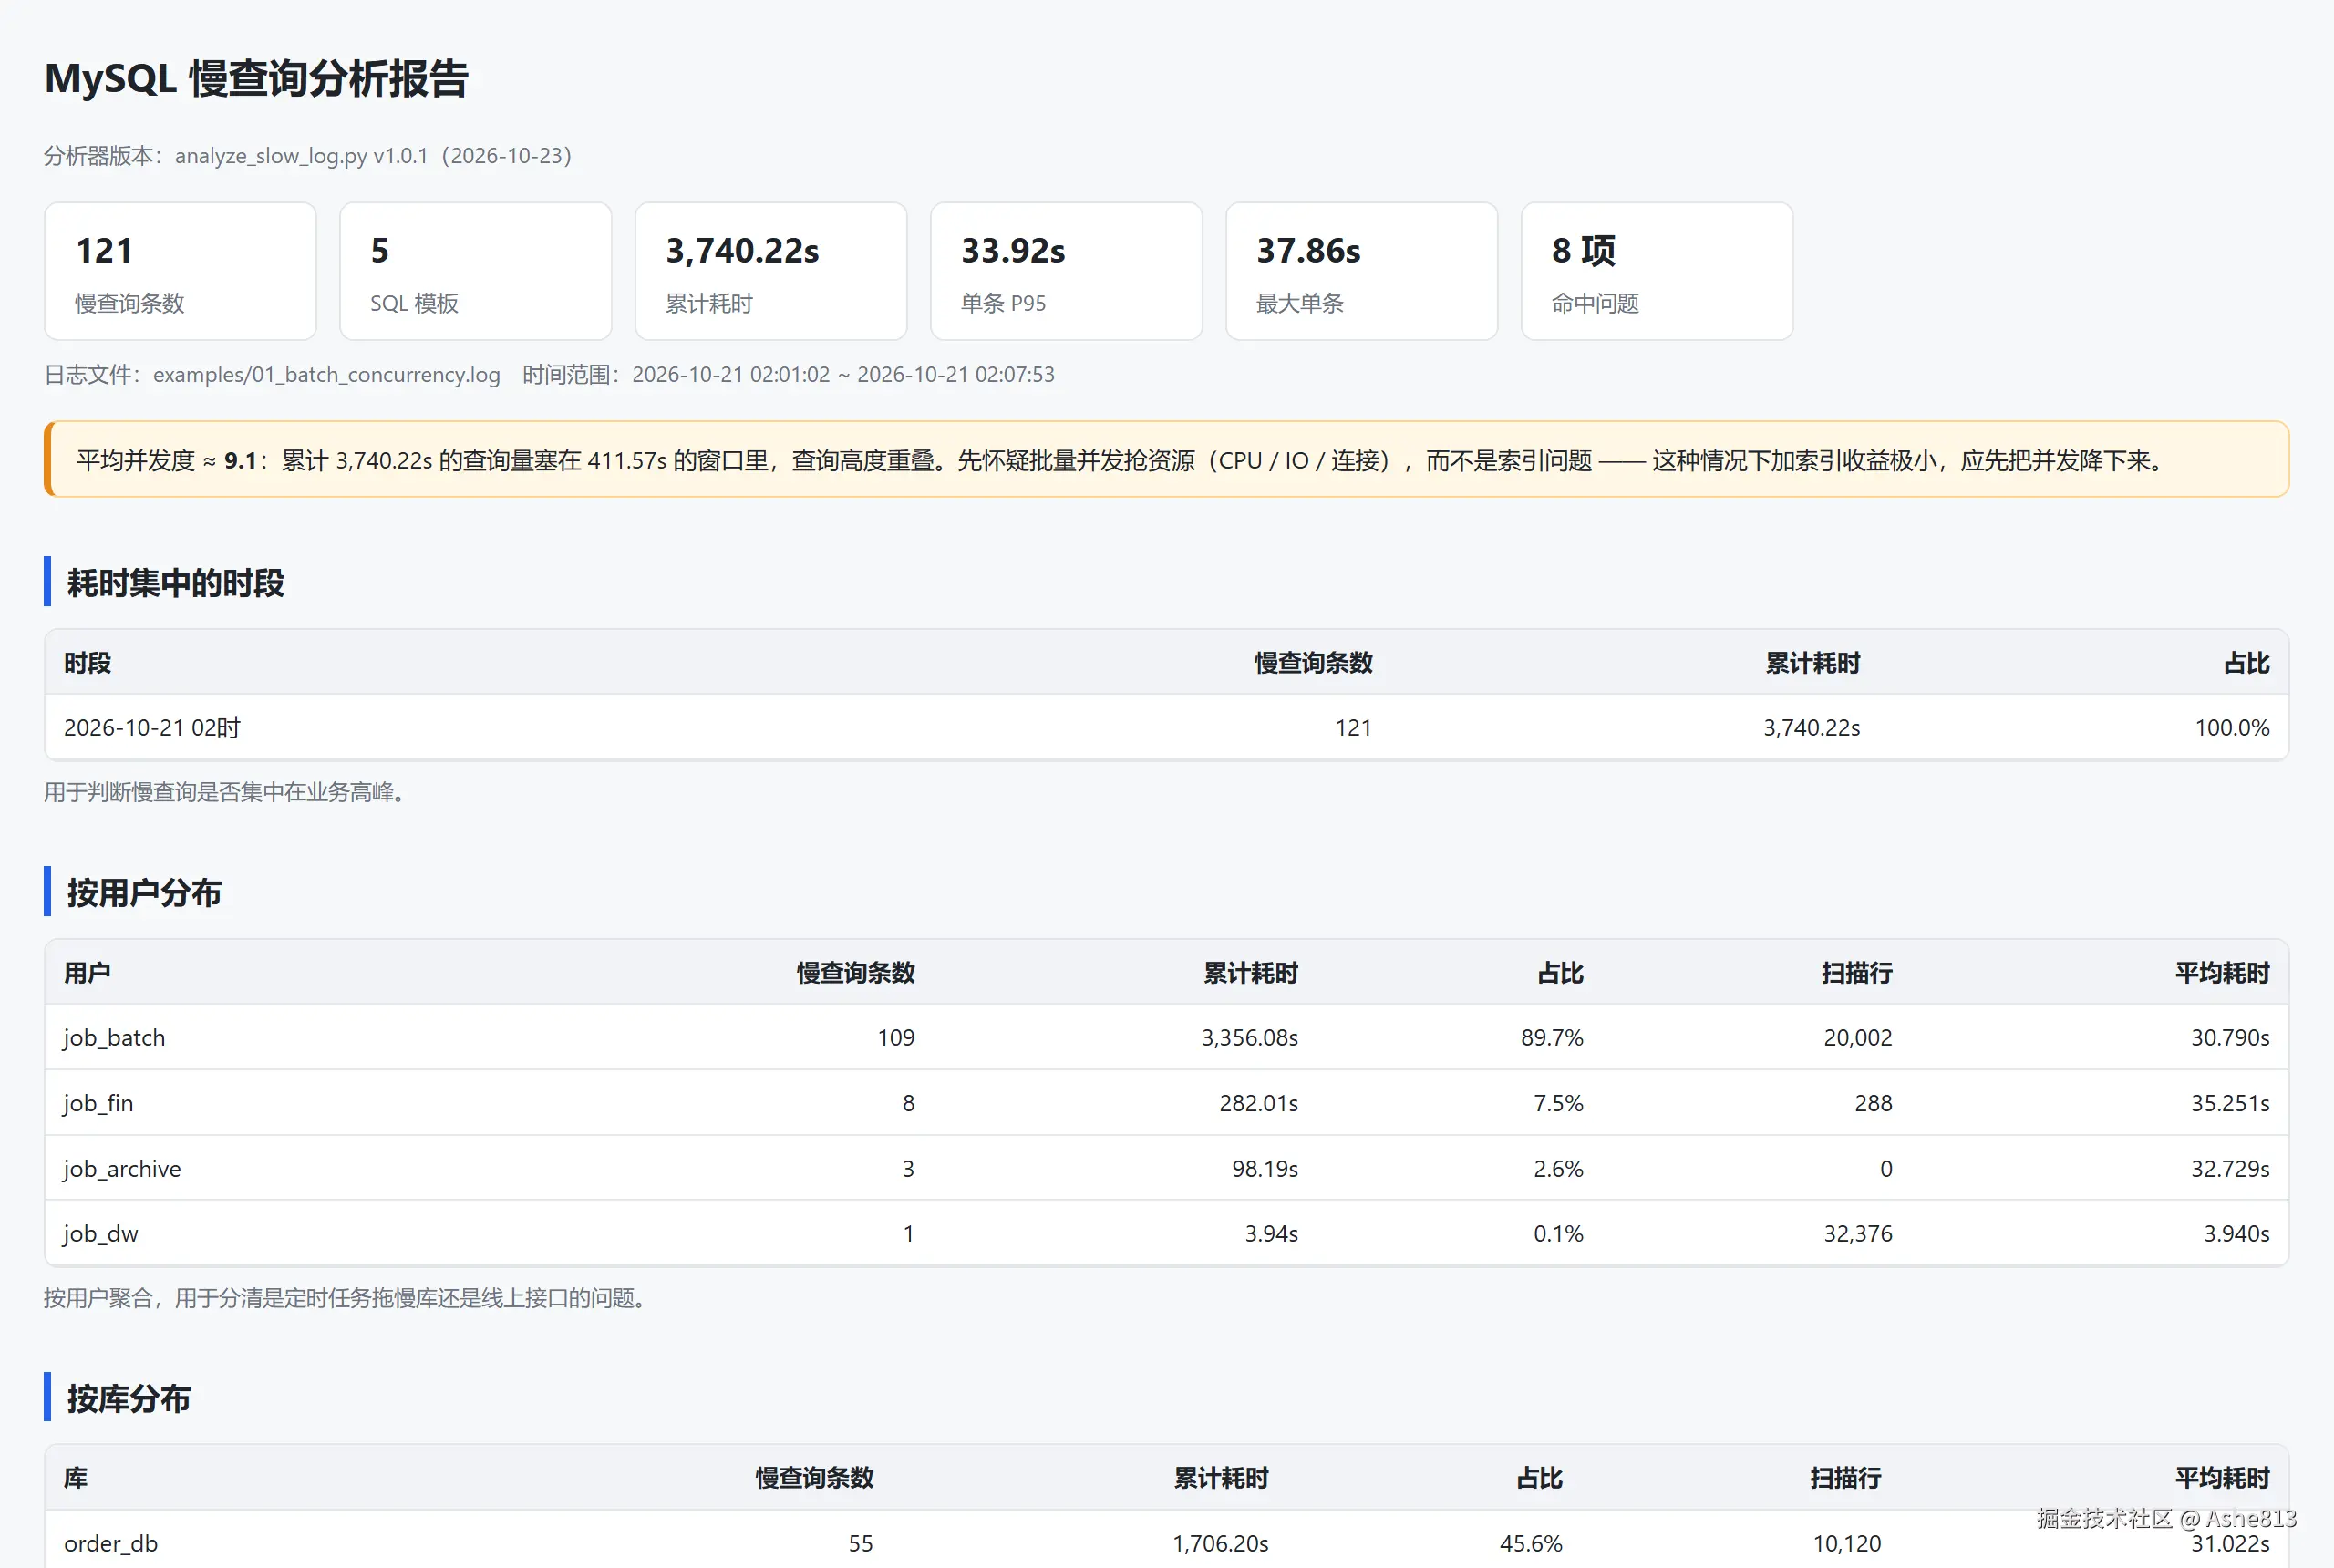
(图:顶部是统计卡和平均并发度告警条,往下按用户、按库、按时段分布,最后是带 P0/P1 徽标的指纹排行榜。截图取自仓库 examples/ 里那份样例日志的输出,与上文这份真实日志结构一致、数据不是同一份。)
如果按累加值判断,我们会给前两条 SQL 建两个完全无效的索引,而真正的元凶一个都没碰到。
六、三个真修过的 bug
这三个都是被真实日志打回来的:
- 累加值误判:早期版本用「总扫描行数 ≥ 10000」判定缺索引,55 次 × 184 行轻松过万。后来全部改成按平均每次判定,一共 5 处修正,误报清零。
- 单次样本定 P0:一条只执行 1 次、扫了 3 行、耗时 35 秒的记录被判 P0。改成 P0 必须同时满足「平均耗时 ≥ 5s 且执行 ≥ 3 次」,否则降 P1。
Rows_examined = 0漏报 :判定条件里写了avg_examined > 0,结果「3 次 / 32.6s / 扫描 0 行」这种最典型的资源争抢被直接排除。改成≤ 0也参与判定。
七、16 条内置规则速查
| 级别 | 规则 | 建议动作 |
|---|---|---|
| P0 | 耗时与扫描量不匹配(资源争抢) | 降并发,不是加索引 |
| P0 | 锁等待占比高(≥1s 或 ≥30%) | 查长事务、热点行、隔离级别 |
| P0 | 疑似缺索引 / 大范围扫描 | EXPLAIN + 建索引 |
| P0 | UPDATE/DELETE 缺 WHERE |
全表写,立刻止血 |
| P1 | 前置通配 LIKE '%x' |
改全文检索 / 冗余列 |
| P1 | WHERE 中对列用函数 |
改成范围条件,函数挪到常量侧 |
| P1 | 深分页 LIMIT 100000,10 |
延迟游标 / 上一页最大 ID |
| P1 | 疑似 N+1 循环查询 | 批量化、预加载、缓存 |
| P1 | 空转查询(SELECT 返回 0 行却狂扫) |
条件没走索引 / 逻辑可前置过滤 |
| P1 | 结果集过大(平均返回 ≥1000 行) | 分页 / 只取需要的列 / 聚合下推 |
| P2 | SELECT * 且扫描量大 |
只取需要的列,覆盖索引 |
| P2 | ORDER BY/GROUP BY 文件排序 |
建符合排序顺序的索引 |
| P2 | NOT IN 子查询 |
改 NOT EXISTS / LEFT JOIN |
| P2 | WHERE 用 OR |
改 UNION ALL 或拆成两条 |
| P2 | UNION 临时表 |
确认是否必要,改 UNION ALL |
| P2 | 耗时抖动明显(P95/均值 ≥ 3) | 查抖动来源,别急着加索引 |
几个刻意的例外,也是踩出来的:
- 空转查询只对
SELECT判定 :UPDATE/DELETE的Rows_sent本来就是 0,放进来会全量误报; - 不用「返回 ≤ 1 行」当阈值 :
COUNT(*)、SUM()这类聚合本来就扫完全表返回 1 行,那是正常的; - 候选索引只给单表:JOIN、子查询、函数包列的查询不给 DDL。瞎给索引比不给更坑。
同类问题在报告里会合并成一组(合计数 + 每个模板一行明细),并提示「这 N 个模板是同一类问题,通常一次处理就能全解决」。真实日志里 11 条命中合并成 5 组,可读性差别很大。
八、怎么跑
bash
# 最简:默认同时出 md + html,文件名带时间戳,不覆盖历史报告
python analyze_slow_log.py /path/to/slow.log

# 常用:只看 5 秒以上的,Top 30,顺带留一份 JSON 给二次处理
python analyze_slow_log.py slow.log --min-time 5 --top 30 --json result.json

# 只要 HTML(P0/P1 彩色徽标,明细可勾选「只看 P0/P1」)
python analyze_slow_log.py slow.log --out report.html

# CI / 定期任务:固定文件名,不加时间戳
python analyze_slow_log.py slow.log --no-stamp --out /data/weekly-slow.md

# 输入是 mysql.slow_log 表导出的 TSV
python analyze_slow_log.py slow_log.tsv --slowlog-table
阈值都能按自己的库调:
| 参数 | 默认 | 作用 |
|---|---|---|
--big-scan-rows |
10000 | 扫描行数告警线(大表可放大到 10 万) |
--rows-ratio |
50 | 扫描/返回放大倍数告警线 |
--slow-time |
1.0 | 判定「慢」的秒数 |
--jitter-ratio |
3.0 | P95/均值超过它算抖动 |
--row-cost-ms |
1.0 | 每行扫描耗时超过它疑似资源争抢 |
--context |
20 | 报告末尾附最慢 N 条原始日志块 |
性能上:流式读取,不整份进内存;只对 # 开头的行做元信息正则匹配。压测数据(另一份日志)是 75 MB / 148 万行 / 26 万条记录,解析 7.8s + 聚合 5.4s。本文案例只有 123 条,秒级出报告。
报告里每条明细都带源文件行号和原始时间戳,可以直接跳回原文:
bash
sed -n '10420,10460p' mysql_slow_query_02_00.log九、它做不到什么
- 指纹是启发式的 :字面量、数字、IN 列表折叠成
?,极端动态 SQL 可能归并错; - 看不到执行计划 :所有结论都是「日志证据 + 规则」,最终必须用
EXPLAIN/EXPLAIN ANALYZE落地确认; - 慢日志本身有盲区 :
long_query_time设得大,那些「单次不慢但执行一万次」的查询根本不会进日志。所以 N+1 检测出来的一定只是冰山一角; - 候选索引只覆盖单表,复杂查询请自己判断。
十、总结
慢日志分析最容易犯的错,就是看到「扫描行数大」就加索引。
真正该先问的是三个问题:
- 这些慢查询是不是挤在同一时间?(平均并发度)
- 它是每次都慢,还是偶尔慢?(P95 ÷ 均值)
- 它每行扫描花了多久?(ms/row,正常应远小于 1)
三个数算完,「加索引」这个动作还能不能剩下,答案基本就出来了。
这套分析器做的事,说到底就是把这三个数摆到报告第一行。跑过之后如果哪条规则在你的库上总是误报,那多半是阈值没调,不是规则不对。
脚本地址(MIT,单文件,Python 3.10+ 直接跑,附三份样例日志):gitee.com/shice-note/...
如果你也遇到过「扫了一万行但其实不缺索引」的慢日志,欢迎在评论区贴报告开头几行,一起看。