手头目前跑着 5 个面向北美和欧洲用户的英文独立站与微 SaaS。随着日常售前技术咨询和账单工单变多,我们面临一个非常现实的架构矛盾:
- 海外商业客服 SaaS 的「按次抽成税」太重 :以 Intercom Fin AI 为例,除了坐席月租外,AI 每成功回答一次问题额外收取
$0.99(哪怕只是命中文档里写得清清楚楚的参数说明)。月咨询量一旦上到 3,000 次,年软件账单直接突破两万美金; - 传统开源 RAG + 客服容器栈太吃内存 :腾讯开源的
WeKnora v0.9在混合检索(BM25 + 稠密向量 + ReRank)与知识库管理工作台上完成度非常高,但标准容器编排(PostgreSQL + Redis + PythondocreadergRPC 解析服务)通常推荐8 GB ~ 16 GB内存;而且原生定位偏内部知识问答,缺少面向外部多站点的匿名访客悬浮挂件、多品牌防串味隔离、跨时差 SLA 工单状态机与飞书/Slack 告警闭环; - 绝对不想魔改上游源码:一旦直接改动了上游仓库的表结构或内部路由,后续跟进上游新版本就会陷入痛苦的 Merge 泥潭。
过去两周,我们在严格保持 git diff upstream == 0(100% 零侵入上游源码) 的前提下,用纯 Go 编写了一套伴生多站点客服与跨时差工单网关(内部代号 RelayResolve ),把整套生产栈直接塞进了一台 2 vCPU / 1.9 GiB RAM 的 AWS 东京轻量云主机里。
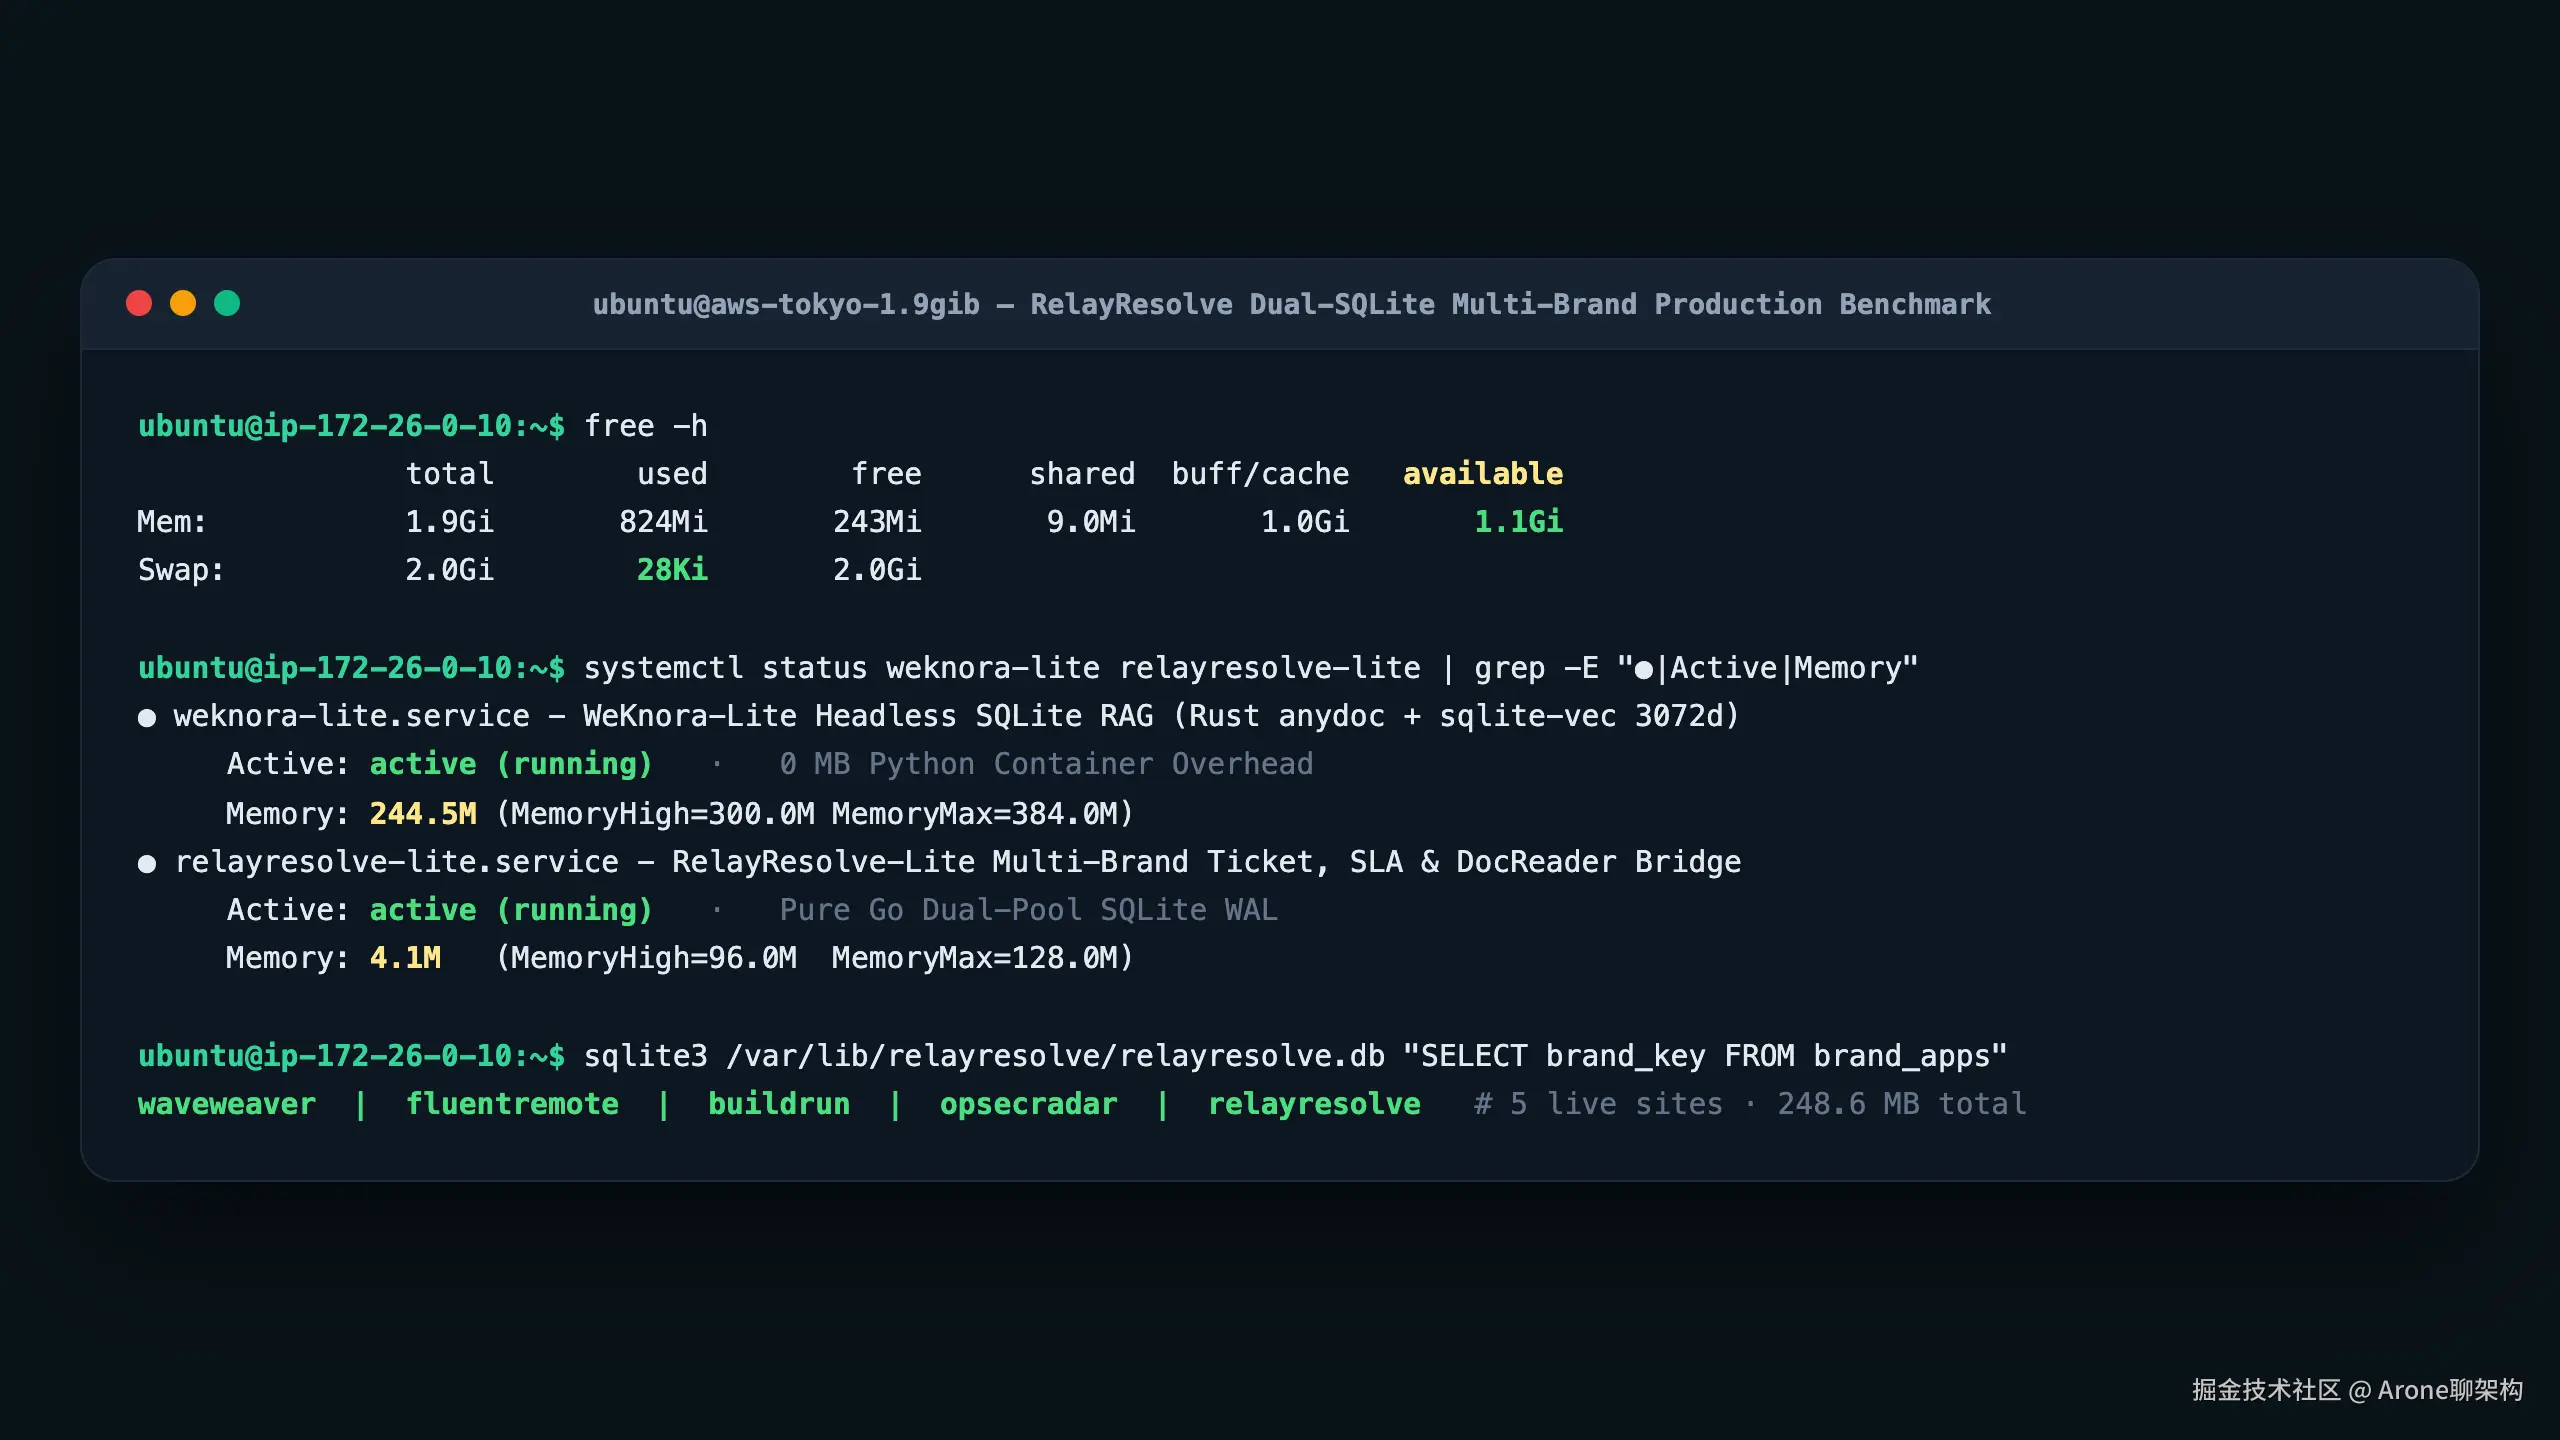
目前 5 个海外生产站点全量挂载运行,整机常驻总内存仅 248.6 MB ,主机还剩 1.1 GiB 可用内存。本文复盘其中最关键的 4 个工程设计与踩坑细节。
一、 砍掉 1.5GB Python 容器:Rust anydoc 静态内嵌 + 纯 Go 回环解析桥
在小内存机器上跑 RAG 知识库,最大的内存吞噬兽往往不是 Go 主进程,而是负责解析 PDF、Office 和网页归档的 Python 依赖栈。我们采用了「双路协同」的无容器瘦身方案:
- 编译期静态链接内置 Rust 解析器 :编译
WeKnora-lite单二进制时开启-tags "sqlite_fts5 anydoc",直接在进程内原生解析复杂的.pdf、.docx、.xlsx、.pptx与.epub文档,省去外部 Python 进程常驻开销; - 纯 Go 实现
DOCREADER_TRANSPORT=http本地回环桥 :针对.html、.htm、.mhtml(网页归档)与.xmind等扩展格式,我们在伴生 Go 服务内部实现了仅监听127.0.0.1回环地址的/internal/docreader/{list-engines,read}接口(公网 Nginx 层对/internal/强制返回HTTP 403),配合SSRF_WHITELIST_EXTRA=127.0.0.1,localhost,在 0 MB 额外 Python 容器开销 下点亮了全部文档格式的解析链路。
同时通过 systemd 为两个守护进程加上严格的资源护栏,彻底杜绝突发大文件解析拖垮宿主机:
ini
ini
# /etc/systemd/system/weknora-lite.service 核心内存护栏
[Service]
MemoryHigh=300M
MemoryMax=384M
ExecStart=/opt/relayresolve/weknora/WeKnora-lite
# /etc/systemd/system/relayresolve-lite.service 核心内存护栏
[Service]
MemoryHigh=96M
MemoryMax=128M
ExecStart=/opt/relayresolve/relayresolve/relayresolve-lite实测线上稳定运行后,weknora-lite 常驻约 244.5 MB(含 sqlite-vec 3072 维向量索引),伴生工单与网关进程 relayresolve-lite 常驻仅 4.1 ~ 24 MB,Swap 占用几乎为零(28 KiB)。
二、 解决纯 Go SQLite 并发写锁死锁:读写双连接池隔离
为了实现真正的「零外部数据库依赖(5 分钟寄生任意 2GB 主机)」,工单状态机与 SLA 巡检引擎在轻量模式下采用了纯 Go 无 CGO 的 modernc.org/sqlite。
上线压测初期我们踩到了一个经典的坑:当后台 SLA 定时巡检协程正在扫描即将超时的工单并开启写事务时,如果恰好有客服在前端点击「认领工单 / 完成首次响应停表」,单连接池多协程并发写会偶发触发 SQLITE_BUSY (database is locked) 甚至长达数十秒的锁等待。
最终的解法是在存储层将 SQLite 拆分为**「多并发读池 + 单串行写池」**,并统一开启 WAL 日志与 IMMEDIATE 事务:
scss
go
// 读连接池:充分利用 WAL 模式多读并发,支撑挂件配置拉取与工单列表高频查询
readDB, err := sql.Open("sqlite", dsn+"?_pragma=journal_mode(WAL)&_pragma=busy_timeout(5000)&_pragma=foreign_keys(1)")
readDB.SetMaxOpenConns(8)
// 写连接池:严格限制单连接串行落盘,从根源上消除 SQLite 写锁竞争
writeDB, err := sql.Open("sqlite", dsn+"?_pragma=journal_mode(WAL)&_pragma=synchronous(NORMAL)&_pragma=busy_timeout(5000)&_pragma=txlock(immediate)")
writeDB.SetMaxOpenConns(1)
writeDB.SetMaxIdleConns(1)
同时在 Repository 层保持标准 ANSI SQL 兼容,当团队后续单量暴涨或需要多机横向扩展时,无需改动任何业务代码,只需把环境变量 RELAYRESOLVE_DB_DSN 从 sqlite://... 切换为 postgres://... 即可无缝升配至 PostgreSQL 16。
三、 「desk + kb 双子星网关」与 45 秒单次核销免密 SSO
既然坚持不改上游一行代码,又要给运营和客服提供极简的日常接单体验,我们采用了双子星反向代理架构:
desk.<domain>(日常客服与多站总控台) :负责高频的跨站点工单分诊、SLA 倒计时监控、AI 模型一键配模(支持 Gemini / OpenAI / 硅基流动等兼容接口)以及 60 秒建站向导;kb.<domain>(原生专业知识库工作台) :直接反向代理原生前端,但在 Nginx 层封锁公网注册接口(/api/v1/auth/register -> 403)。当管理员需要上传百页英文硬件 PDF 手册、精细调整分块(Chunking)参数或测试混合重排时,只需在desk点击「专业管理 ↗」,后端通过回环标准接口签发一张 45 秒有效、阅后即焚的单次核销票据(/__rr_kb_sso) ,免密深链直跳对应知识库详情页。
这样既 100% 保留了上游持续演进的高级 RAG 调优能力,又对公网匿名访客保持了极小的安全暴露面。
四、 「外分内合」五层多品牌隔离与跨洋时差 SLA
对于同时运营多个海外独立站的团队而言,最怕「A 站的聊天窗搜出了 B 站的价格条款」或者「回信邮箱串号露馅」。我们在伴生层做了五重物理隔离:
- 独立凭证与 CORS 源校验 :每个站点分配独立的
public_app_key与严格匹配的域名白名单(裸域 +www); - 知识库物理隔离 :每个
brand_key强绑定专属的primary_kb_id,检索请求在网关层按服务端绑定关系强注入,前端无法篡改越权; - 单发信域多品牌身份伪装 :底层在 Resend 仅需配置验证 1 个发信域,工单回执邮件会自动根据来源站点动态渲染为
Brand A Support、Brand B Support及对应品牌主题色; - 欧美日营业日历与飞书签名卡片 :内嵌
time/tzdata时区库,预置美东(America/New_York)、伦敦(Europe/London)、东京(Asia/Tokyo)营业时间窗口。前端英文挂件拦截解答约 70% 常规文档提问(附带[1][2]原文引用角标防幻觉);遇到退款、账单或低置信度复杂报错时,1 秒生成TKT-*工单,通过带 HMAC-SHA256 签名的飞书交互卡或 Slack Block Kit 秒推国内值班群。
小结
在 AI 应用落地的下半场,相比动辄拉起十几个微服务容器的重型架构,「单机低内存高密度 + 确定性的人机接力状态机 + 零侵入复用优秀开源检索内核」 往往更契合精锐小团队的真实生产需求。
这套伴生网关已经在我们自有的 5 个英文站点上稳定跑通了混合检索秒答与跨时区工单升级闭环。如果你也在折腾 WeKnora 私有化落地、Go + SQLite 向量检索或者多站点隔离网关,欢迎在评论区一起交流踩坑细节!(待账号过新手期完善个人主页后补充在线测试环境)