1. 起因:我只是想传个 50MB 的安装包
事情很朴素。同事在另一个城市,我要把一个 40 多 MB 的客户端安装包发给他。
微信:超过 100MB 才拦,40MB 能发,但对方电脑上没登微信,手机转存再下载,折腾。 网盘:要登录、要转存、要开会员才不限速,为了一个文件注册一个账号,不值。 临时文件站:能用的要么广告糊脸,要么上传完给我一个 32 位哈希链接,还得复制粘贴一长串。
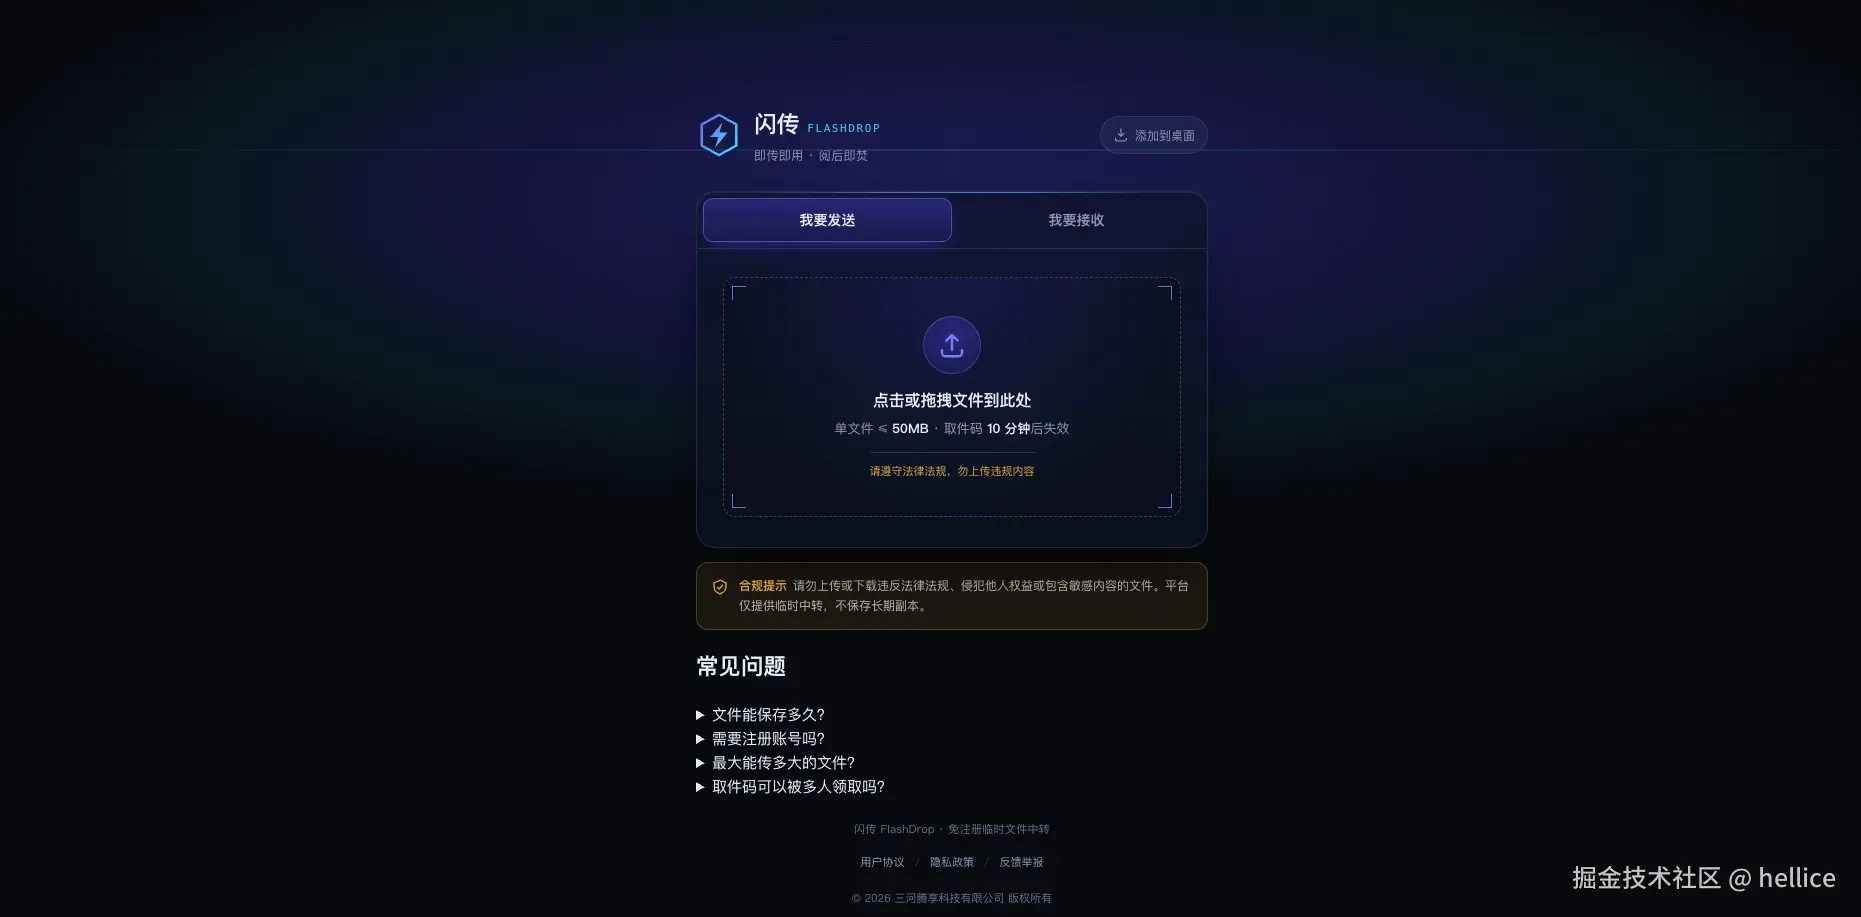
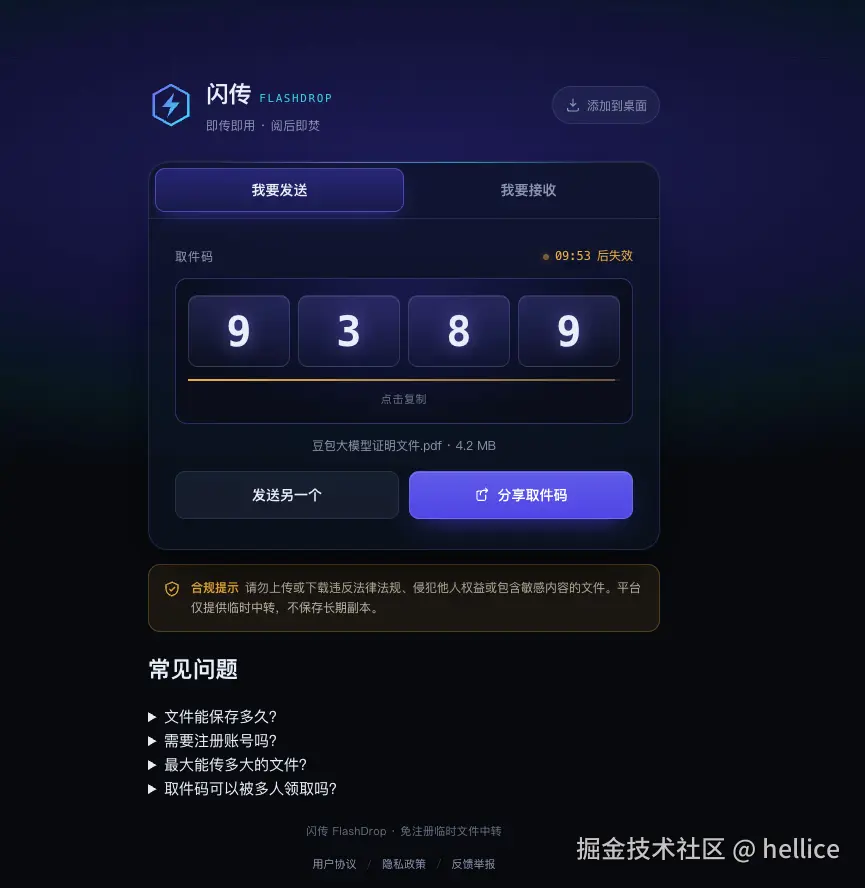
我想要的其实就一句话:上传,得到一个 4 位数字,告诉对方,对方输进去就能下。
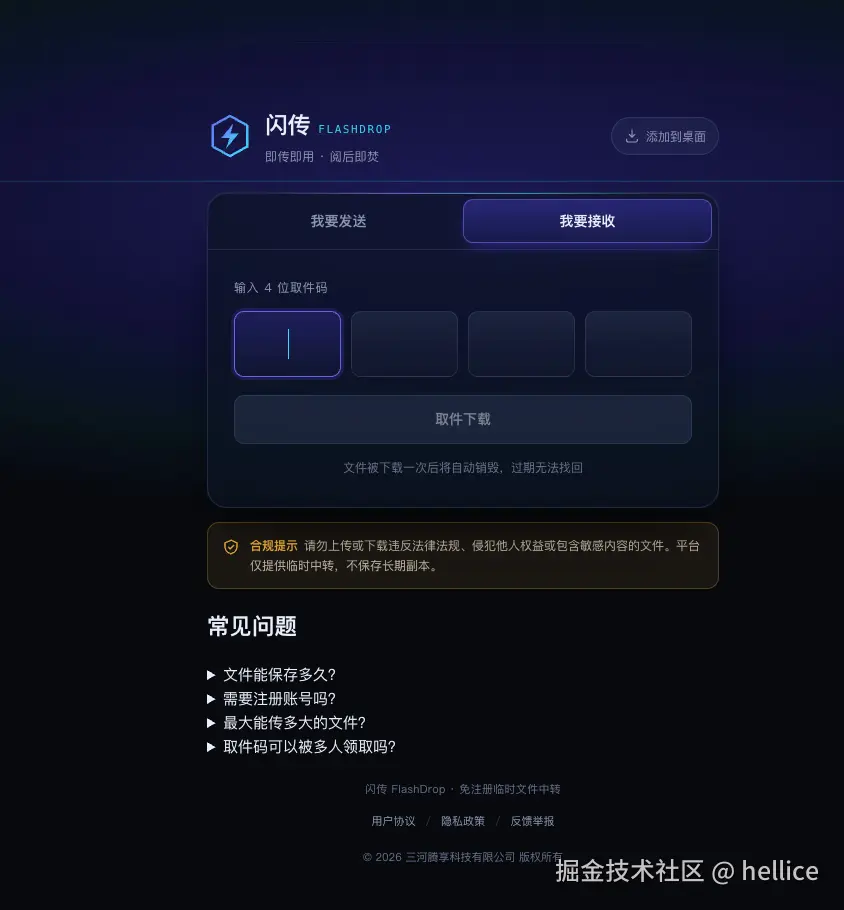
于是有了 闪传 FlashDrop:免注册、免安装,上传即得 4 位取件码,10 分钟有效,下载一次即销毁,单文件上限 50MB。
这篇文章不吹产品,主要写做的时候踩了哪些坑,以及为什么最后代码只有这么点。如果你也想给自己团队搭一个内网/半公开的临时中转站,可以直接抄。
2. 产品边界:先想清楚「不做什么」
我见过太多小工具死在「功能越加越多」上。所以动手前先把边界钉死:
- 不建账号体系。没有注册、没有登录、没有「我的文件」。
- 不做文件归档。文件是消耗品,取走即焚,过期即删。
- 不做断点续传、不做分片上传。50MB 以内,一次 POST 完事。
- 不做长期存储。元信息只驻留内存,进程一重启,所有取件码立即失效。
最后这条一开始被同事质疑:「重启就丢,是不是太脆了?」
我的回答是:这正是产品定位。它叫「临时中转」,不叫「网盘」。如果重启后取件码还能用,那它就是在偷偷做持久化存储,用户会开始拿它存东西,然后你就得考虑备份、考虑磁盘满、考虑数据合规。把「易失」写进设计里,反而省掉了一整类问题。
3. 技术选型:为什么是 Express + Multer
技术栈很保守:
- Node.js ≥ 18(我本地是 22)
- Express 4 + Multer 2
- 前端单页 HTML + 原生 JS + 手写 CSS,零 CDN 依赖
- 文件落盘
data/tmp,元信息驻留内存
选 Express 不是因为先进,是因为够无聊。这种小工具最怕的是「半年后回来看不懂」,Express + Multer 的组合几乎每个 Node 开发者都能在十分钟内读懂全部路由。
前端零 CDN 是刻意的。国内网络环境下,一个 CDN 挂掉,整个页面白屏,用户还以为你站点挂了。手写 CSS 也就两百行,图标用内联 SVG,og 图本地放,PWA 清单和 Service Worker 都自己写------外壳可缓存,接口和文件绝不缓存。
4. 核心设计:取件码怎么发、怎么收、怎么销毁
整个存储层就六个方法,server/store.js 里:
js
// 取件码存储:issue / peek / take / restore / drop / sweep
issue(fileMeta)   // 生成 4 位码,写入内存 Map,返回 code + expiresAt
peek(code)        // 只读检查:存在?过期?已领取?------ 不消耗次数
take(code)        // 真正领取:标记已领取,返回文件元信息
restore(code)     // 下发失败时回滚「已领取」标记
drop(code)        // 主动删除(下载完成后清理)
sweep()           // 定时扫描,清理过期条目与残留文件
这里有两个设计点值得说:
第一,peek 和 take 必须分开。
前端在用户输入 4 位码后,会先调 GET /api/check/:code 做预校验,告诉用户「这个码有效 / 已过期 / 已被领取」。如果预校验也消耗领取次数,那用户手抖输错一次、或者刷新一下页面,文件就没了------这是灾难。
所以 check 是纯只读的,只有 GET /download/:code 才真正 take。
第二,restore 是踩坑之后加的。
最初的实现是:take 里直接把状态改成「已领取」,然后 res.sendFile() 下发。听起来没问题,但实际测试时发现------如果客户端在传输中途断开,sendFile 报错,文件却已经被标记成「已领取」了。用户网络抖一下,文件就永久报废。
于是加了 restore:下发失败时把状态回滚成「未领取」。代码大概是这样:
js
app.get('/download/:code', async (req, res) => {
  const meta = store.take(req.params.code);
  if (!meta) return res.status(410).render('gone');

  res.sendFile(meta.path, (err) => {
    if (err) {
      // 传输失败:回滚,让用户还能再试一次
      store.restore(req.params.code);
      if (!res.headersSent) res.status(500).end();
      return;
    }
    store.drop(req.params.code); // 成功才真正销毁
  });
});
这个细节在需求文档里根本不会写,但它是「下载一次即销毁」能不能真正可用的分水岭。
5. 踩坑实录
5.1 4 位码的碰撞概率,比我想的高
4 位数字只有 10000 种组合。听起来很多?在「10 分钟有效 + 同时在线几十个文件」的场景下,生日悖论告诉我们:同时存在 100 个活跃码时,新码撞车的概率已经接近 1%。
我的处理很简单:issue 时循环重试,撞了就换一个,最多试 20 次,全撞就返回 503 让用户稍后再试。同时 sweep 每 30 秒清一次过期条目,把活跃码数量压下去。
js
issue(meta) {
  for (let i = 0; i < 20; i++) {
    const code = String(Math.floor(Math.random() * 10000)).padStart(4, '0');
    if (!this.map.has(code)) {
      this.map.set(code, { ...meta, expiresAt: Date.now() + TTL });
      return code;
    }
  }
  throw new Error('code_exhausted');
}顺带一提,padStart(4, '0') 千万别漏。我第一版忘了,结果 0123 变成了 123,用户输 4 位永远对不上,排查了半小时。
5.2 Multer 的 limits 不生效?因为顺序写反了
Multer 2 的 limits.fileSize 是能拦住超大文件的,但它拦的方式是「边写边判断,超了就中断」 ,此时文件可能已经部分落盘了。如果你在 fileFilter 里做类型校验,要注意 fileFilter 在文件流开始前执行,而 limits 在流中触发。
我最初的写法是:
js
const upload = multer({
  dest: 'data/tmp',
  limits: { fileSize: MAX_FILE_MB * 1024 * 1024 },
  fileFilter: (req, file, cb) => {
    if (BLOCKED.includes(file.mimetype)) return cb(null, false);
    cb(null, true);
  }
});问题在于:被 fileFilter 拒绝的文件,Multer 不会自动清理已写入的临时文件 。测试时 data/tmp 里堆了一堆 0 字节和半截文件。
解决办法是在错误处理中间件里统一扫一遍 req.file?.path 并 fs.unlink,同时 sweep 里也兜底清理「不在内存 Map 中的孤儿文件」。
5.3 限流不能只按 IP,还要按「失败次数」
server/ratelimit.js 用的是滑动窗口。上传、预校验、反馈各有各的配额,这些都好办。
真正麻烦的是取件码爆破。4 位码只有 1 万种可能,如果不限制失败次数,脚本一分钟就能把整个码空间刷一遍,把所有在途文件都「领走」。
所以除了常规限流,我单独加了一层:同一 IP 在窗口期内取件码失败超过 CHECK_FAIL_LIMIT(默认 10 次),直接封锁 CHECK_BLOCK_MIN(默认 15 分钟)。
js
function checkFail(ip) {
  const rec = failMap.get(ip) || { count: 0, until: 0 };
  if (Date.now() < rec.until) return false; // 仍在封锁期
  rec.count += 1;
  if (rec.count >= CHECK_FAIL_LIMIT) {
    rec.until = Date.now() + CHECK_BLOCK_MIN * 60 * 1000;
    rec.count = 0;
  }
  failMap.set(ip, rec);
  return true;
}这里有个坑:TRUST_PROXY 必须配对 。部署在 Nginx 后面时,req.ip 拿到的是 127.0.0.1,所有用户共享一个 IP,一个人输错十次,全站被封。所以配置里 TRUST_PROXY=1,让 Express 从 X-Forwarded-For 取真实 IP;直连对外时改回 0,否则伪造头就能绕过限流。
5.4 优雅退出:别让 sweep 定时器把进程吊死
setInterval 的定时器如果不 unref(),Node 进程在收到 SIGTERM 后不会退出,PM2 会以为你卡死,直接 SIGKILL,正在传输的文件全断。
js
const timer = setInterval(() => store.sweep(), CLEAN_INTERVAL_SEC * 1000);
timer.unref();

process.on('SIGTERM', () => {
  clearInterval(timer);
  server.close(() => process.exit(0));
  setTimeout(() => process.exit(1), 5000).unref(); // 兜底强退
});
CLEAN_INTERVAL_SEC 默认 30 秒,必须明显小于 TTL(10 分钟) ,否则过期文件会在磁盘上多躺一会儿。这个约束我写进了 .env.example 的注释里。
5.5 宝塔部署:内置 node_modules 省掉一整类事故
发布包 闪传-FlashDrop-v1.0.zip 里直接内置了 node_modules 。服务器上不需要 npm install,也不需要任何构建步骤。
为什么这么做?因为宝塔的 Node 项目环境里,npm install 经常因为网络、镜像源、node-gyp 编译失败而卡住,尤其是服务器上没有装 Python 或 build-essential 的时候。内置依赖,上传解压就能跑,把「部署失败」这个变量直接消掉。
部署步骤:
- 宝塔 → 文件 → 上传 zip 到
/www/wwwroot/,右键解压,得到闪传目录(可改名flashdrop)。 - 宝塔 → 网站 → 添加站点(纯静态即可),记下域名。
- 宝塔 → 网站 → Node 项目(或软件商店的 PM2 管理器)→ 添加项目:
- 项目路径:
/www/wwwroot/flashdrop - 启动文件:
server/index.js - 端口:
3005(或你在.env里配的PORT)
- 项目路径:
- 站点设置里加反向代理,把
/转发到http://127.0.0.1:3005。 .env里TRUST_PROXY=1,ICP填自己的备案号。
这里踩过一个坑 :宝塔的 Node 项目管理器默认会用 npm start 启动,如果你的 package.json 里 start 脚本写的是 node server/index.js,那没问题;但如果它读的是「启动文件」字段,就要确保填的是相对路径 server/index.js 而不是绝对路径,否则 PM2 会报 Cannot find module。
6. 接口一览
| 方法 | 路径 | 说明 |
|---|---|---|
| POST | /upload |
multipart/form-data,字段名 file。返回 code、expiresAt、filename、sizeText |
| GET | /api/check/:code |
预校验,只读不消耗领取次数,返回 {available, reason} |
| GET | /download/:code |
真正的领取:校验通过即标记已领取并下发文件,再次访问返回 410 |
| POST | /api/feedback |
{feedback_type, content, contact},追加写入 data/feedback.jsonl |
| GET | /api/health |
运行状态与计数,可给监控用 |
错误码约定:413 file_too_large、415 type_blocked、429 rate_limited、410(已领取或已过期)。
7. 配置项
复制 .env.example 为 .env 后按需修改,全部有默认值:
| 变量 | 默认 | 说明 |
|---|---|---|
PORT / HOST |
3000 / 0.0.0.0 |
监听地址 |
MAX_FILE_MB |
50 |
单文件上限 |
TTL_MINUTES |
10 |
取件码有效期 |
CLEAN_INTERVAL_SEC |
30 |
过期清理间隔,需明显小于 TTL |
RATE_UPLOAD_PER_MIN |
12 |
每 IP 每分钟上传次数 |
RATE_CHECK_PER_MIN |
30 |
每 IP 每分钟预校验次数 |
RATE_FEEDBACK_PER_MIN |
5 |
每 IP 每分钟反馈次数 |
CHECK_FAIL_LIMIT |
10 |
窗口期内取件码失败次数上限 |
CHECK_BLOCK_MIN |
15 |
触发上限后封锁该 IP 的时长(分钟) |
TRUST_PROXY |
1 |
部署在 Nginx 后面保持 1,直连对外时改 0 |
ICP |
冀 ICP 备 2025115369 号 |
页脚备案号 |
8. 快速开始
bash
npm install
npm start            # 默认 http://localhost:3005
PORT=3210 npm start  # 临时换端口
npm run dev          # 文件变动自动重启
首次运行会自动创建 data/tmp 与 data/feedback.jsonl。
目录结构:
text
server/
  config.js      # .env 解析与默认值(不依赖 dotenv)
  index.js       # 路由、上传校验、错误页、优雅退出
  store.js       # 取件码存储:issue / peek / take / restore / drop / sweep
  ratelimit.js   # 滑动窗口限流 + 取件码失败封锁
public/
  index.html     # 单页:双 Tab + 5 个弹窗 + 合规提示 + 页脚
  assets/        # app.css / app.js / 图标 / og 图
  manifest.json  # PWA 清单
  sw.js          # Service Worker(只缓存外壳,不碰接口与文件)
data/            # 运行时目录:tmp/ 与 feedback.jsonl
9. 一些取舍与反思
关于「下载一次即销毁」的体验。 这个规则很爽,但也很吓人。用户点下载,浏览器弹窗问「保存到哪」,如果他手滑点了取消,文件就没了。所以我在下载页加了一句提示:「点击下载后请勿取消,文件仅可领取一次」。这不是技术问题,是产品问题。
关于内存存储。 元信息驻留内存意味着单机、单进程。要横向扩展就得换 Redis,但那就违背了「一个 zip 解压就能跑」的初衷。我选择接受这个限制,并在 README 里写清楚。
关于 50MB 上限。 这个数字是拍脑袋定的,但事后看挺合理:再大就该用网盘了,再小就传不了安装包。限制本身就是产品的一部分。
10. 结语
整个项目代码量不大,server/ 下四个文件加起来三百多行。真正花时间的不是写功能,而是想清楚哪些功能不该有,以及处理那些「需求文档不会写、但线上一定会遇到」的边界:传输中断、码碰撞、代理 IP、定时器吊死、部署环境缺依赖。
如果你也想试试,可以直接打开 fd.tengxiangtech.com/ 传个文件感受一下;想自己搭,按第 5.5 节的步骤走,宝塔上传解压就能跑。
有踩过类似的坑,欢迎在评论区聊聊。