「前端已经加上这个字段了。」 「宿主这边还没看到。」 「运行时忽略了它,云端却当成必填。」
有一次,前端给「创建工单」加了可选字段 priority。宿主那一侧的结构还是旧的,多出来的字段被悄悄丢掉。运行时按自己的类型放行了,云端却把这个字段当成必填,请求到最后一跳才失败。三端没有一个人报错,直到联调才对上。同一个字段如果在 TypeScript、Rust、Node、Python 和 Java 里各写一遍,三个月后谁也说不清哪一遍才算数。漂移是静默的:宽松解析会把多出来或少掉的字段吞下去,单测各自通过,问题要到联调甚至用户那里才出现。
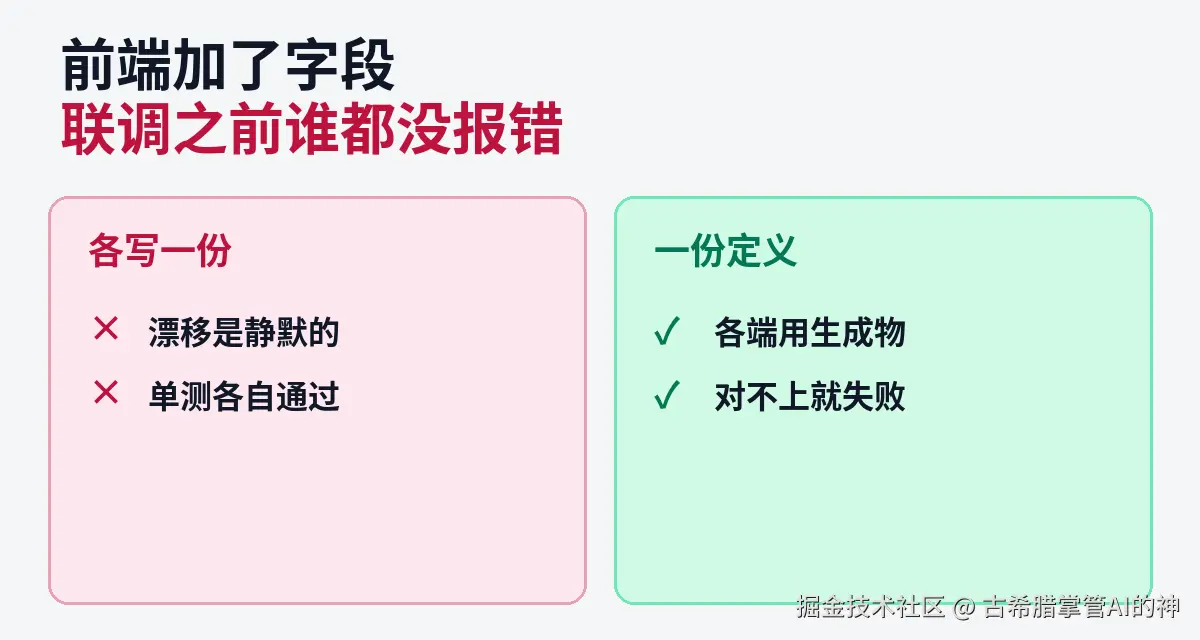
同一份定义,既用来校验,也用来导出各端契约
一个桌面智能体的典型请求会穿过很多层。界面用 TypeScript 发出命令,Rust 宿主收到后分发,对话引擎用 Node 处理,工作流引擎用 Python 处理,部分结果还要写回 Java 云端。方向很明确:一个字段只在一个地方定义,其余各端要么是它的生成物,要么和它比对。
候选通常有三种:手写 JSON Schema、用 TypeScript 定义再导出,或者用 Pydantic 定义再导出。手写 JSON Schema 最中立,但写起来冗长,评审时也很难看出业务语义。用 TypeScript 定义很适合前端,但工作流引擎是 Python,还得再做一次运行时校验。
Pydantic 正好站在中间:它本身就能做运行时校验,Python 侧可以直接用;它还能导出标准 JSON Schema,其他语言再从 Schema 生成类型或做校验。
契约基类的关键配置是这两项:
python
from pydantic import BaseModel, ConfigDict

class ContractBase(BaseModel):
    model_config = ConfigDict(extra="forbid", validate_assignment=True)
extra="forbid" 让未知字段直接校验失败,而不是被悄悄忽略。validate_assignment=True 让对象创建之后的赋值也要过校验,避免某段代码中途写进一个非法值。基类上还可以统一打开去除首尾空白、按字段名填充这类选项。绝大多数请求和响应模型继承这个基类,严格就成了默认值,而不是每个人自己记着开。
例外也要能说清。比如批注和引用这类正文,原样保留空白很重要,就在子类里把空白裁剪关掉。少数移动端模型直接用更严格的 strict=True。例外可以有,但必须是显式写出来的。
没有全局生成器,每个领域自己出一份
下图要看的是从上到下的三层:最上面是 Pydantic 模型,中间是按领域拆开的生成器,下面是各个消费方。每个消费方下面写着它和契约的实际关系。
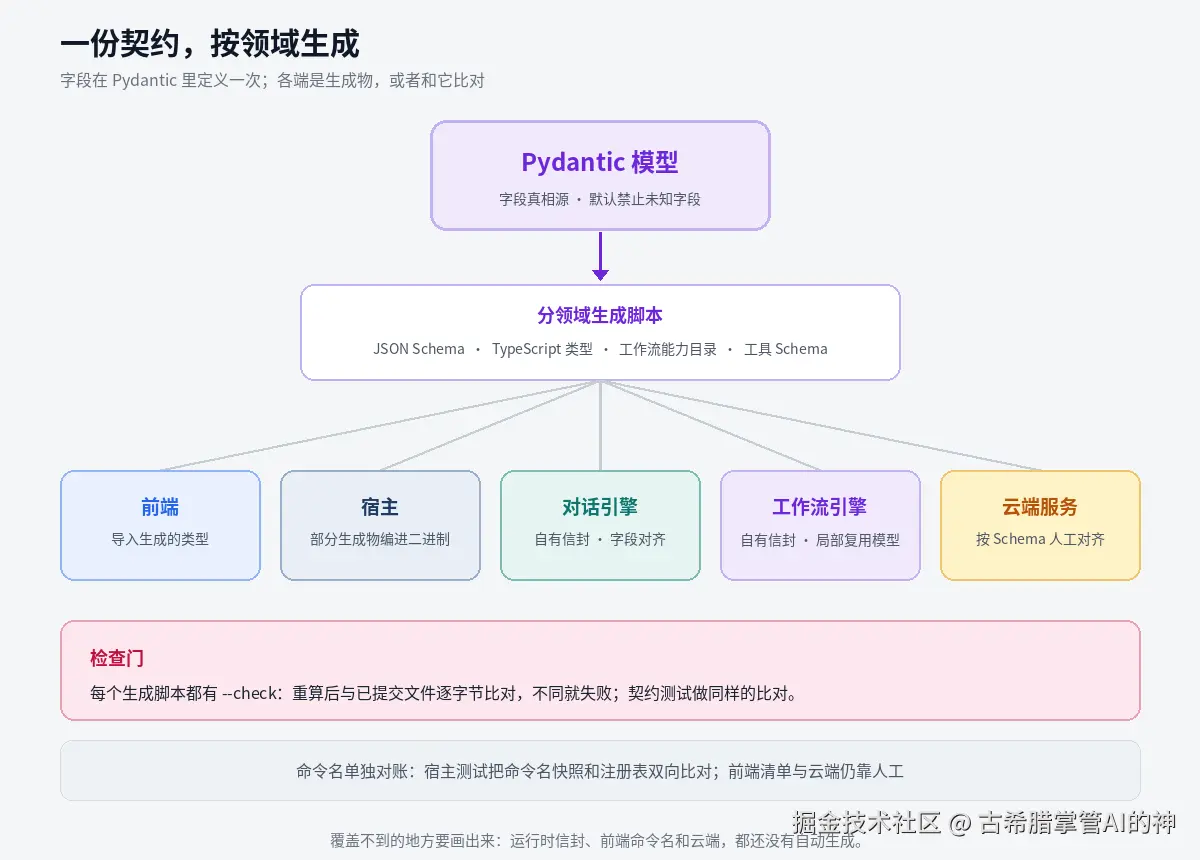
这里没有一个「全局生成器」,而是每个领域一个生成脚本。改工作流契约时不会顺带重写知识库的生成物,评审时的差异也更集中。生成物大致有四类。JSON Schema 是标准格式,任何语言都能拿来校验;TypeScript 类型给前端直接导入,编辑器就能提示字段名和必填项;工作流能力目录是可用能力的清单,第 8 篇里节点执行时用它确认引用的能力确实存在;此外还有工具与命令映射,例如看板取数技能的命令到 Schema 的映射,以及给模型用的工具 Schema。
消费方和契约的关系并不一样,这一点要如实写出来。前端直接导入生成的 TypeScript 类型,但 IPC 层还有一份手写的命令类型,与生成类型并存。宿主把能力目录、部分 Schema 用编译期内嵌的方式打进二进制,启动时反序列化并自校验,不在运行时读文件。两个运行时各自维护一份请求信封,字段名与宿主一致,局部直接复用契约模型,它们不是同一份生成物。云端的 Java 服务在另一个仓库,按 Schema 和共享样例人工对齐,没有自动生成。
「未知字段即拒绝」要写在每条载荷上,不能只靠信封
严格校验最容易被误解的地方,是信封与载荷的分层。一条命令由两部分组成:信封,也就是命令名、追踪编号、请求上下文;载荷,也就是这条命令自己的业务字段。基类上的 extra="forbid" 约束的是模型本身。如果信封里的载荷字段被声明成一个通用的 JSON 对象,那么载荷里多出来的字段并不会被信封挡住。
所以「未知字段即拒绝」要落实到每条命令自己的载荷模型上,而不是只靠信封。宿主这一侧也是一样的道理:一部分领域的请求结构加了 serde 的 deny_unknown_fields,未知字段在反序列化时就失败;但通用信封本身没有加,未知字段会被忽略。
rust
#[derive(serde::Deserialize)]
#[serde(deny_unknown_fields)]
struct ExportRequest {
    dataset_id: String,
    // 只能出现这里声明的字段
}
这段代码只想说明一件事:严格应该写在每一个载荷类型上,而不是寄希望于外层信封。宿主分发命令时按命令名找处理器,并不会对每条命令做一次通用的 Schema 校验。确实需要按 Schema 校验的处理器,例如看板取数技能,会在处理器内部用内嵌的 Schema 校验载荷。工作流节点输出用的是一个手写的受控子集校验器,只支持对象、数组、标量、枚举和区间。Rust 侧和前端侧各有一份,并用同一组样例对齐。
漂移应该在合并前失败,而不是等用户点按钮
有了生成器还不够。总会有人改了模型却忘了重新生成,或者改了生成物却没改模型。下面的动图演示一次改字段的完整过程。要盯住的是第 2 步检查门变红,以及第 4 步前端类型检查报错。
每个生成脚本都有一个 --check 模式:重新计算生成结果,不写文件,只和已提交的文件逐字节比对,不同就以非零状态退出。对应的测试也做同样的比对,所以跑一遍契约测试就能发现漂移。这相当于把生成器当作纯函数:同样的输入必须得到同样的输出。
需要诚实说明的一点是:这道检查目前靠契约测试和提交前检查执行,还没有接进每一条持续集成流水线。如果你也在做类似的事,建议第一天就把 --check 放进流水线,比事后补要便宜得多。
命令名还没从契约生成,要靠对账锁住
命令名是另一类契约,处理方式和字段不同。IPC 命令名目前不是从 Pydantic 生成的。前端有一份手写的命令名清单,宿主有自己的注册表。宿主侧有一个测试,把一份命令名快照和注册表做双向比对:不能重复,不能有注册了却不在清单里的「孤儿」,也不能有清单里有却没注册的命令。
前端清单和宿主注册表之间还没有自动对账。这是一个已知缺口:前端拼错一个命令名,要到运行时才会收到「未知命令」。下一步自然是把命令名也纳入生成,或者至少让两边在测试里对一次。
版本按领域走,不做一次全局协商
契约要演进,就要有版本。这里的做法是分领域版本,而不是一个全局协议版本。请求上下文带一个契约版本号;数据传输配置有自己的版本;工作流智能体节点只接受缺省的第一版或显式的第二版;看板后台任务有自己的协议版本。某个领域的客户端能力不够时,由该领域返回明确提示,例如「请更新并重启客户端」。
在严格模式下,下面这套约定几乎是必需的。新增可选字段是兼容变更:旧客户端不发,新服务端用默认值。新增必填字段是破坏性变更,要么先以可选形式上线,等各端升级后再改成必填,要么新开一条命令或升一个领域版本。删除字段先标记废弃,保留一个发布周期,再从模型里移除。改字段含义一律不做,含义变了,就换一个字段名。
改一个字段变慢了,是我们愿意付的代价
以前改一处,现在要改模型、重新生成、提交生成物、过检查。好处是每一次漂移都在合并前暴露。生成物要提交进仓库,评审能看到 Schema 和类型的差异,代价是差异变大;我们认为「评审时看得见」比「仓库干净」更重要。严格会拒绝看起来无害的请求,比如多传一个调试字段就失败,初期会不适应,但它逼着大家把调试数据放进专门的字段。
覆盖不到的地方更要列出来。两个运行时的信封、前端命令名清单、云端 Java 都还靠人工对齐。写进评审清单,比假装「全链路自动化」更有用。
各写一份,出错时没人报错;一份定义,错了会在合并前响。严格要落在每一条命令的载荷上,而不是只靠外层信封。
参考资料
- Pydantic 团队,《Pydantic Validation》,pydantic.dev/docs/valida...
- Pydantic 团队,《Configuration》,pydantic.dev/docs/valida...
- Pydantic 团队,《JSON Schema》,pydantic.dev/docs/valida...
- JSON Schema 社区,《JSON Schema》,json-schema.org/
- Serde 团队,《Container attributes》,serde.rs/container-a...