💡 一句话总结:Penn State 团队给 coding agent 做了一次「逐步验尸」:每一步都偷拍仓库快照、事后用官方测试回放------结果发现 agent 大多早就把活干完了,中位 35--60% 的步骤花在「已经解对」之后,还有一小撮运行临走前把对的改错。做 agent 产品和天天用 agent 的都该看看。
导语:你肯定见过这个场面
先问一个你可能刚经历过的问题:让 Claude Code、Cursor 或者随便哪个 coding agent 修一个 bug,它吭哧吭哧读了一堆文件,改了一版代码,测试过了,然后呢?
然后它开始「庆祝胜利」:再跑一遍测试、把改动 diff 又看了一遍、翻了几个根本不用碰的文件、写了个额外的检查脚本......最后慢悠悠地跟你说「任务完成了」。你盯着屏幕右下角的 token 计数,心里默算这一波又烧了多少额度。
更气人的剧本是:它中途明明已经改对了,后面又手痒改了两下,把对的改错了,最后提交一个编译不过的补丁。你只好说「再试一次」,它从头再来一遍。听起来离谱?数据就是这么写的。
宾州州立大学(Penn State)的这篇新论文 Termination Lag: Coding Agents Solve Early but Stop Late (arXiv 2611.14960,2026-11-11),第一次把这个「解完了却停不下来」的现象系统量化了。作者给这个间隔起了个名字:termination lag(终止延迟)------从 agent 第一次产出正确补丁,到它自己停下来,中间隔了多少步。
想自己动手?
- 📄 论文:arXiv 2611.14960
- 📄 HTML 全文:arxiv.org/html/2611.1...
这篇论文到底想解决什么问题?
要理解痛点,得先看现在怎么评 agent。SWE-bench 这类基准的评分逻辑很简单:agent 跑完之后提交最终补丁,官方测试一跑,过了就得分,没过就零分。
这套规则有个盲区:它只看终态,不看过程。两个 agent 都在第 10 步就改出了正确代码,一个当场收手,另一个又多跑 40 步重跑测试、检查调用点、review 自己的 diff------基准给它们完全相同的分数。但成本差了 4 倍,时延差了 4 倍,把已经改对的代码再次改坏的风险也完全不同。
换句话说,现在的评测把两种能力搅在了一起:写出正确修复的能力 ,和意识到修复已经完成的能力。榜单只测了前者。而后者------知道什么时候该停------恰恰是真实生产环境里最值钱的能力之一,因为 agent 的每一步都是一次模型调用:上下文越滚越大,token、延迟、算力全在涨。
那怎么把这两种能力拆开测?难点在于:没人知道 agent 是在哪一步「实际上」把任务解决的------agent 自己不说,框架也不记录。这正是这篇论文要补的测量空白。
它的思路是什么?
作者的思路说穿了很朴素,但执行得很干净:既然 agent 不报告自己的进度,那就全程偷拍,事后回放判卷。
具体分三步走:
- 🕵️ 逐步抓拍:在 agent 和模型 API 之间架一个日志代理,趁 agent 每次等待模型响应的空档,用临时 Git index 把当前仓库状态与任务基线 commit 做一个 diff 存下来。全程不碰 agent 的工作区,agent 完全无感。
- 🔬 离线回测 :整个运行结束后,把每个去重后的快照补丁丢进隔离容器,用 SWE-bench 的官方评测程序跑官方测试。关键设计:agent 从头到尾看不到任何回测结果,所以它的行为完全不受测量影响------它该瞎忙还瞎忙,测出来的才是自然状态。
- 📐 三个指标:TTFCP(首个正确补丁出现在第几步)、TL(termination lag = 自停步数 − 首解步数)、NTL(归一化版本,即整段轨迹里「解对之后」的占比)。
这套管线跑在了相当宽的面上:5 个模型 (Qwen3-Coder-30B、Laguna-XS.2、Seed-OSS-36B 三个开源模型,外加 Claude Haiku 5.5 和 GPT-6 Luna 两个闭源模型)、2 个 agent 框架 (OpenHands 为主,mini-SWE-agent 验证框架无关性)、3 个基准(SWE-bench Verified 的 500 个 Python 任务、Multilingual 的 9 语言 300 任务、更难的 SWE-bench Pro)。
为什么要铺这么宽?因为如果只有某一个模型有「停不下来」的毛病,那可能是个别模型的训练问题;如果大家都有,那就是 agent 范式本身的结构性问题。先卖个关子,答案在下一节。
效果到底怎么样?
先说最反直觉的发现:正确补丁出现得早得离谱。
在所有到达过正确补丁的运行里,Qwen3-Coder 在 SWE-bench Verified 上 82% 的运行第一次改源码就已经是对的;Laguna-XS.2 是 70%,GPT-6 Luna 是 80%。也就是说,agent 花几十步读代码、定位问题之后,往往一出手就是正解。哪怕把所有设置拉通看,这个比例也在 38--82% 之间------多数情况下到达正确平均只需要 1.3--3.6 个不同的补丁。
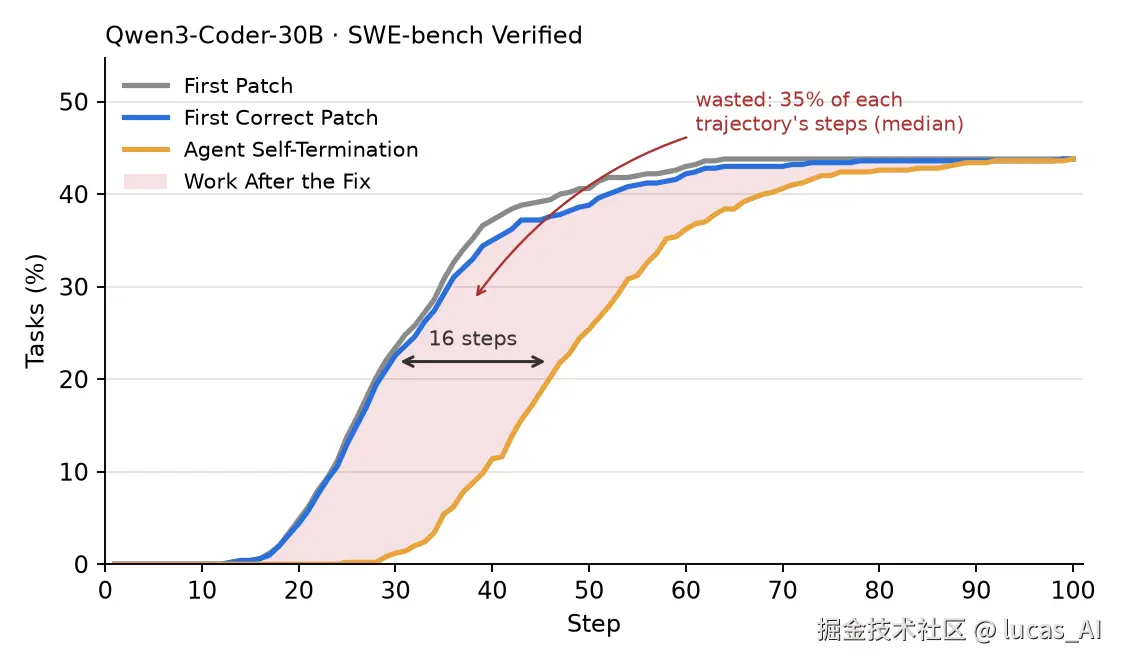 图说:蓝线(解对了)远远先于橙线(停下来了)抬头,中间的空档就是 agent「收不了手」的时间。
那解对之后呢?这就是标题里那个数字了:成功运行中,中位数 35--60% 的步骤发生在首个正确补丁之后。Qwen3-Coder 在 Verified 上中位 TL 是 16 步(NTL 35%),Laguna-XS.2 最严重------中位 57 步、NTL 60%,而且解对之后上下文还要继续膨胀 78%。
这里我最想强调的是 +78% 上下文增长这个数字。这意味着一半的 token 开销花在了「确认自己已经做对」上------同样的预算,本来可以多跑一个任务。
那这些多出来的步骤都在干什么?论文把解后行为分了类,结果相当扎心:
- 🔍 验证类占 48--63%:跑既有测试、写额外测试脚本、构建项目------反复确认自己已经做对的事
- 🧭 探索类占 15--29%:翻文件、搜代码、用 git 看变更------解对之后还在逛仓库
- ✏️ 真正再改源码的只占 2--6%:绝大多数后续编辑并没有实质必要性
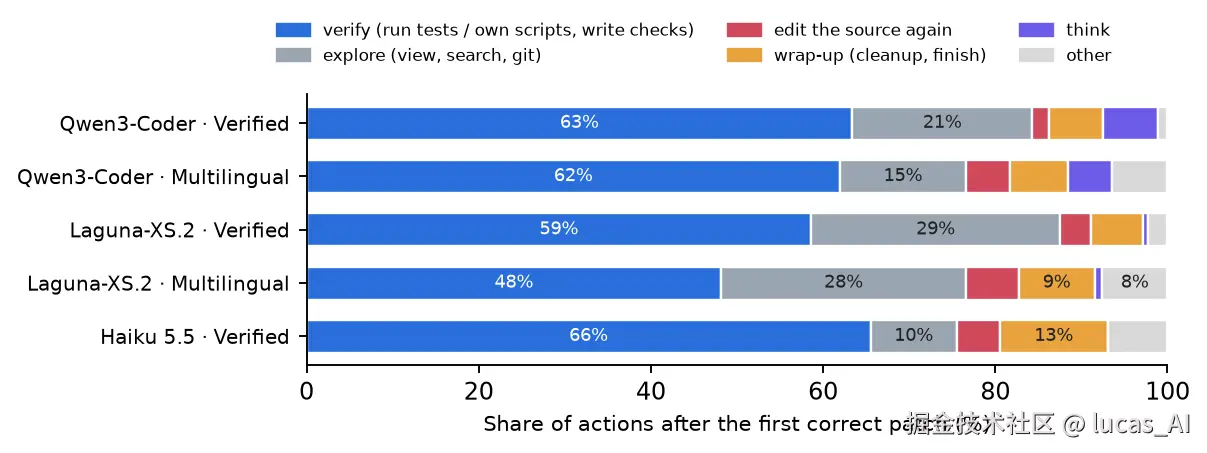 图说:各设置下解后步骤的构成比例,验证(最深色)普遍过半。
还没完。这些后续动作不光烧钱,还真的会坏事 :在到达过正确补丁的运行里,1--8% 最终把对的改错、以错误补丁收场(Laguna-XS.2 在 Multilingual 上甚至有 31% 的运行中途改坏过、靠后面又修回来)。换句话说,如果 agent 在第一个正确补丁处就停手,这些失败本来可以全部避免。
作者还算了一笔 oracle 账:假设有个理想停止器,每个运行都在首解处掐停------所有原本能解对的任务一个不少,同时每个成功轨迹省掉中位 35--60% 的步数。这就是早停优化的收益上界。
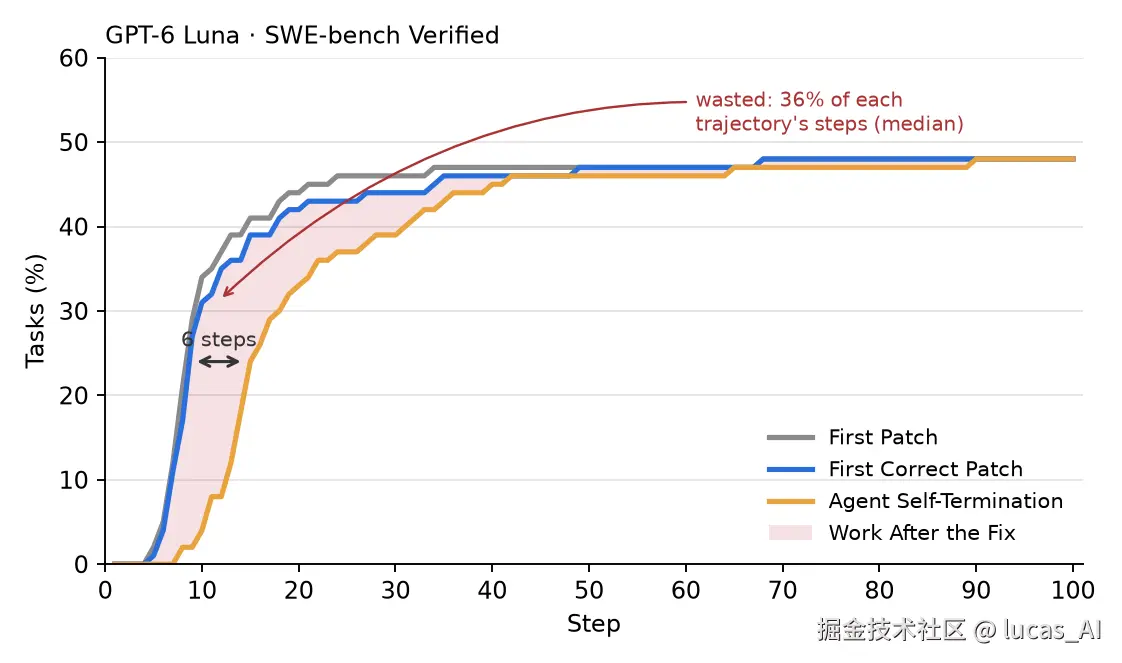 图说:闭源旗舰模型也一样:解对了很久之后才停手。
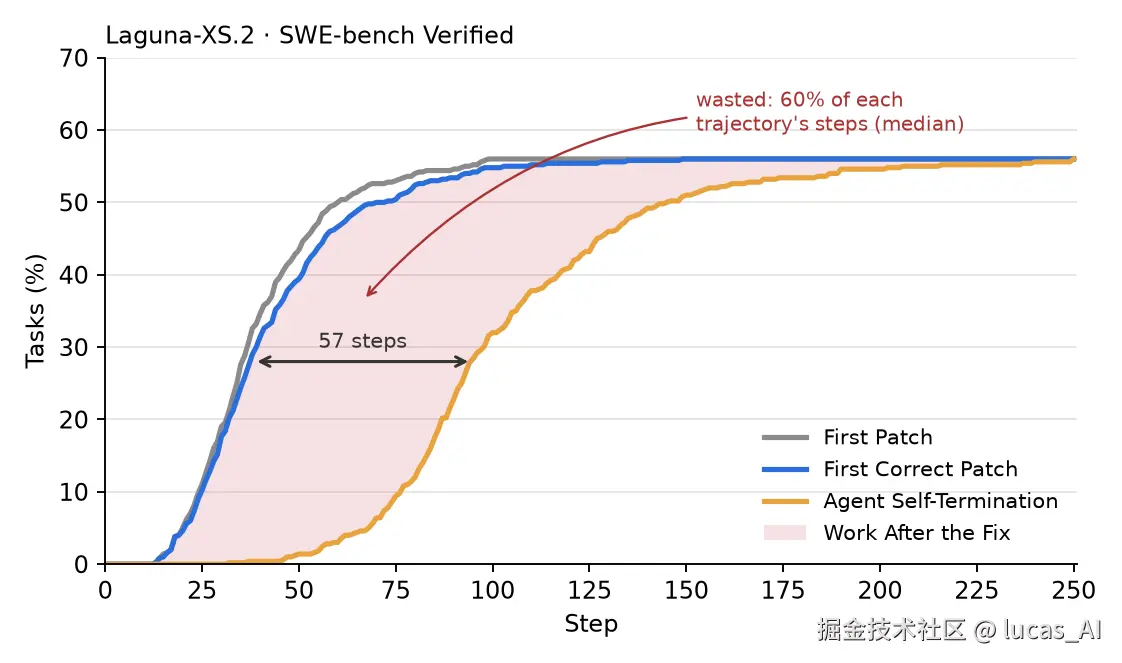 图说:所有核心设置里最严重的案例------中位 57 步的终止延迟、解对后上下文再涨 78%。
至于开头的悬念:这个现象跨模型、跨基准、跨框架全都成立,闭源的 Haiku 5.5(NTL 54%)和 GPT-6 Luna(NTL 36%)一样中招。它是 agent 范式的结构性问题,不是哪家模型的锅。
为什么你要关心?
如果你只是「用」agent 的人,这篇论文给了你三条可以直接落地的启示:
- 给你的 agent 上「变更冻结」护栏:agent 自己跑测试通过后,警惕它继续动源码------那 1--8% 的「临走改错」就是你不设防的代价。至少在 CI 里对 agent 的后续编辑保持怀疑。
- 把「第一步就改对」当默认假设:82% 首改即对意味着,与其让 agent 无限迭代,不如让它改完第一版就给你看 diff------多数时候你省下的不是几个 token,而是整段验证马拉松。
- 用 NTL 的眼光挑工具:两个 solve rate 打平的 agent,成本可能差一倍。选型时问一句「你们解对之后平均还要跑多少步」,比多看一个榜单名次有用。
如果你是做 agent 框架/产品的,这篇论文等于把需求文档写好了:停止时机是 agent 性能的一个独立维度,上界收益 35--60% 步数、下界风险 1--8% 的自我破坏。TTFCP/TL/NTL 三个指标可以直接搬进你的回归评测,和 solve rate 并报。
再往远看一层:这篇论文只量化了「能省多少」,没有给出「停在哪」的具体规则。基于自建测试通过状态 + diff 冻结时长的启发式停止器,我觉得是接下来最顺理成章(也最容易被各框架内卷出来)的方向------这只代表我基于论文数据的推测,不是论文自己的结论。
理性看待
诚实说几句局限。其一,「正确」的判定完全依赖官方测试套件,「首补即对 82%」严格来说是「首个补丁已通过官方测试」,与「真正修好了问题」之间有已知缝隙(SWE-bench 类基准的测试覆盖偏窄是老问题)。其二,每个任务只跑一次,没有随机种子方差,个别设置的样本也不大(比如 Seed-OSS 在 Pro 上解出的任务很少)。其三,行为分类是按工具调用规则打的标签,「验证」里混着多少无意义的重复跑测试,论文没有再拆。这些都不动摇主结论,但引用数字时记得口径。