作者:来自 Elastic Scott Martens, Sofia Vasileva
我们原以为更多候选结果会有所帮助,但在 Elasticsearch 的 25 项基准测试中,jina-reranker-v3.5 在 BM25 搜索中以 100 个候选结果取得最佳表现,而在语义搜索中,仅需 20 个候选结果就达到峰值;候选结果增加到 200 个时,得分甚至低于完全不使用重排序模型的情况。
亲自体验 Elasticsearch:深入探索 Elasticsearch 实验室代码仓库(Elasticsearch Labs repo)中的示例笔记本,开始免费云试用(free cloud trial),或立即在本地计算机上(local machine now)试用 Elastic。
我们最近在 25 项检索基准测试中测试了 jina-reranker-v3.5,以确定哪种候选池大小能在准确率与 词元 成本之间实现最佳平衡。对 Elasticsearch BM25 检索出的前 100 个候选结果进行重排序(Reranking),平均可将误差降低约 21%;将候选池减半至 50 个,准确率大约损失 2%,词元用量则减少一半。使用 jina-embeddings-v5-text-small 的语义搜索(Semantic search)更早达到峰值:仅需 20 个候选结果,误差便降低了 8.5%。输入 200 个候选结果时,平均得分甚至低于完全不使用重排序模型的情况。候选结果并非越多越好。初始检索效果越差,重排序模型需要的候选结果就越多,可供它改进的空间也越大。
什么是重排序模型?
重排序 人工智能 模型以查询和候选匹配项为输入,独立生成新的排名,按照匹配程度从高到低排列候选结果。
理论上,你可以将整个数据库交给它们排序,单独用它们完成检索。但这种使用方式的成本高得难以承受,无论是计算资源,还是通过应用程序编程接口调用产生的词元费用。这相当于每次查询都让人工智能模型读取整个数据库。实际应用中,重排序模型几乎总是与嵌入(embeddings)等更高效的检索方式结合使用,先筛选出候选匹配项,再由重排序模型重新评估。
重排序模型大致分为三种类型:逐点式 、成对式_和_列表式。它们的区别在于一次可以输入多少个候选结果、需要运行多少次模型,以及能否得到一致的排序。
| 类型(Type) | 输入(Input) | 处理 N 个候选结果的模型运行次数(Model runs for N candidates) | 排序是否一致?(Consistent ordering?) | 候选数量限制(Candidate limit) | 示例(Example) |
|---|---|---|---|---|---|
| 逐点式 | 查询和一个候选结果 | N 次,每个候选结果一次 | 是,候选结果按得分排序 | 任意数量 | jina-colbert-v2 |
| 成对式 | 查询和两个候选结果 | N−1 次,每次比较两个 | 否,甲可能胜过乙,乙胜过丙,而丙又胜过(beats)甲 | 任意数量 | 成对重排序模型 |
| 列表式 | 查询和整个候选池 | 1 次 | 是,模型直接返回排序 | 取决于模型输入容量 | jina-reranker-v3.5 |
| [表 1:重排序模型类型对比。] |
!\[\](https://i-blog.csdnimg.cn/direct/125644bd29c945a89d94db02b67c71db.png) 图 1:逐点式重排序模型。
逐点式重排序模型(Pointwise rerankers _)_以一个查询和一个候选匹配项为输入,输出一个得分,然后根据得分对多个检索候选结果进行排序。这类模型可以评估任意数量的候选结果,但需要为每个候选结果运行一次完整模型。当需要评估大量候选结果时,这类重排序模型最为适用,例如缺乏高质量的第一阶段检索,或在联合搜索等场景中,候选结果来自多个来源,而这些来源并不向你提供得分或排名。如果你能够将候选池有效缩小到少量极有可能是最佳匹配的候选结果,那么与其他方案相比,这种方案的成本相对较高。
jina-colbert-v2 就是一种逐点式重排序模型。它接收一组查询与文档配对,并返回一个得分。不过,最高效的使用方式是批量处理文档,并为每份文档返回得分,这样就无须针对每份文档单独重新编码查询。
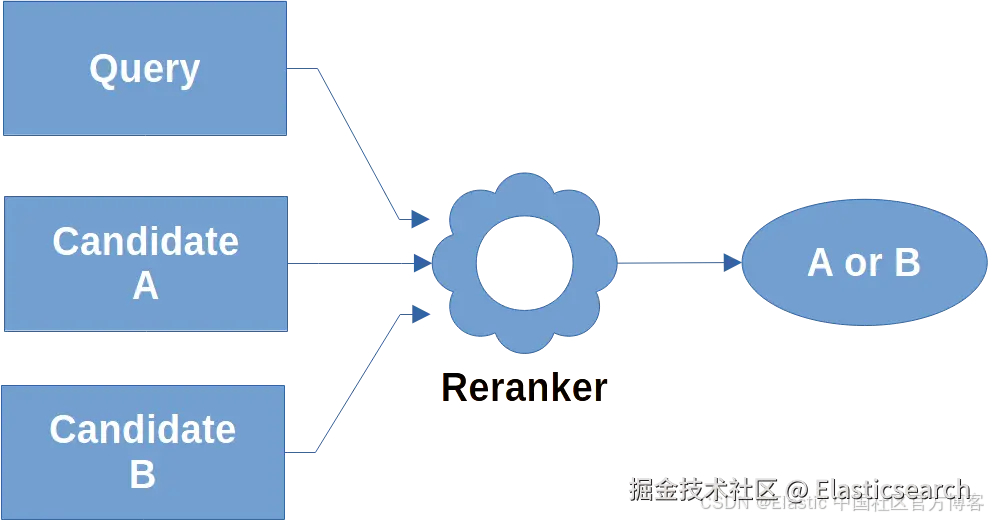 图 2:成对式重排序模型。
_成对式重排序模型(Pairwise rerankers)_接收一个查询和两个候选结果,并判断哪个候选结果更匹配。你可以像淘汰赛一样,每次比较两个候选结果,从而对任意数量的候选结果进行重排序。但这意味着,如果有 N 个候选匹配项,就需要运行模型 N-1 次,几乎与逐点式重排序模型一样多。此外,这类模型无法保证排序的一致性。根据重排序模型的判断,如果候选结果甲优于候选结果乙,候选结果乙优于候选结果丙,仍可能出现候选结果丙的排名高于候选结果甲的情况。
成对重排序模型(PairReranker)就是一种成对式重排序模型,专门用于对文本生成模型的候选输出进行排序。
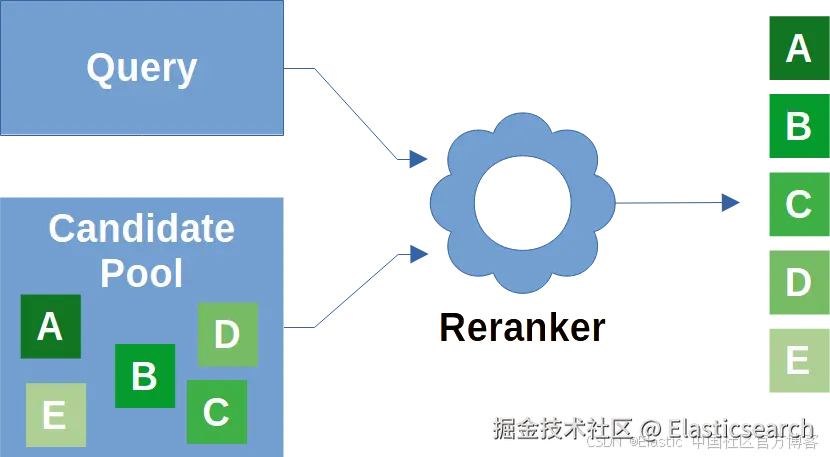 图 3:列表式重排序模型。
_列表式重排序模型(Listwise rerankers)_接收一个查询和一组候选结果,并按匹配程度从高到低对它们进行排序。这类模型只能处理模型输入容量所能容纳的候选结果数量,而且模型规模通常比逐点式模型稍大。不过,你只需调用一次模型,就能评估整个候选池。
在直接对比中,列表式重排序(reranking)的表现通常优于逐点式和成对式重排序,但它只能处理少量候选匹配项。当候选结果数量庞大,或列表式重排序模型相对较高的资源需求成为问题时,逐点式和成对式重排序模型可能是更好的选择。
本文使用 Elastic | Jina 人工智能(Jina AI) 最新的列表式重排序模型 jina-reranker-v3.5,研究两个变量:
- 初始检索步骤的质量和候选池的质量如何影响列表式重排序模型的输出?
jina-reranker-v3.5需要多少个候选匹配项才能返回最佳匹配结果?
结果表明,这两个变量并非完全相互独立。
重排序如何改善 Elasticsearch BM25 搜索
BM25 是经典的文本 信息检索 算法。它不使用人工智能模型,但速度极快、计算需求低,而且内置于 Elasticsearch。尽管近年来人工智能驱动的搜索通常表现更好,BM25 仍被广泛使用,部分原因是其成本低、速度快,另一部分原因是,这种已有三十多年历史的算法,让许多用户习惯了搜索系统按照 BM25 的方式运行。
我们从四套广泛使用的基准测试套件中选取了一组标准文本检索基准测试,用于评估 jina-reranker-v3.5 与 BM25 检索出的候选结果结合使用时的表现:
-
信息检索基准测试(Benchmarking-IR (BEIR))是经典的英语文本信息检索基准测试,应用广泛,包含来自不同领域的多种材料。我们使用了其中的一个子集。坦白说,我们排除了最大的数据集,因为对它们进行测试需要花费更多时间。
-
社区问答重复问题数据集(CQADupStack)是一组问答数据集,主要涉及信息技术,内容来自 堆栈交流(Stack Exchange)网站上的论坛。
-
代码信息检索基准测试(Code Information Retrieval Benchmark (CoIR))是一组代码检索数据集。我们只使用了其中三个数据集,它们的规模都相对较小,且涉及自然语言查询或文档。
-
高难度推理检索基准测试(BRIGHT)是一个专门设计为让传统检索算法难以应对的数据集。其作者创建它是为了测试文本检索系统的推理能力,确保 BM25 等词法检索方案和基于嵌入的语义检索都难以找到匹配结果。大多数传统检索系统,包括语义搜索,在该基准测试中的得分都很低。我们特意选择这些数据集,以观察
jina-reranker-v3.5在极其困难的条件下是否仍能带来价值。
下表展示了每个 数据集 以归一化折损累计增益(nDCG)@10 衡量的检索得分,对比了单独使用 Elasticsearch 的 BM25 实现(Elastic 云上的 Elasticsearch 无服务器服务(Elasticsearch Serverless on Elastic Cloud),使用英语分析器和默认 BM25 设置),以及结合重排序模型、分别采用 10、20、50、100 和 200 个候选结果时的表现。我们的 BM25 基线配置为仅检索 200 个候选结果,因此没有测试更大的候选列表。
| 基准测试套件 | 数据集 | 仅使用 BM25 | 重排序@10 | 重排序@20 | 重排序@50 | 重排序@100 | 重排序@200 |
|---|---|---|---|---|---|---|---|
| 信息检索基准测试 | 科学事实 | 0.6836 | 0.7389 | 0.7583 | 0.7647 | 0.7607 | 0.7392 |
| 信息检索基准测试 | 文本检索会议新冠疫情数据集 | 0.6191 | 0.6533 | 0.7320 | 0.7994 | 0.8280 | 0.8191 |
| 信息检索基准测试 | Quora | 0.8066 | 0.8667 | 0.8857 | 0.8971 | 0.9007 | 0.8838 |
| 信息检索基准测试 | 论点分析 | 0.4782 | 0.6645 | 0.7477 | 0.7889 | 0.8028 | 0.7786 |
| 信息检索基准测试 | Webis-Touche2020 | 0.3381 | 0.3394 | 0.3821 | 0.3407 | 0.3155 | 0.2534 |
| 信息检索基准测试 | 营养学语料库 | 0.3232 | 0.3397 | 0.3504 | 0.3535 | 0.3521 | 0.3375 |
| 信息检索基准测试 | 金融问答 | 0.2506 | 0.3240 | 0.3704 | 0.4208 | 0.4500 | 0.4313 |
| 信息检索基准测试 | 科学文档 | 0.1547 | 0.1776 | 0.2024 | 0.2081 | 0.2150 | 0.1951 |
| 社区问答重复问题数据集 | 游戏 | 0.4876 | 0.5446 | 0.5767 | 0.6070 | 0.6274 | 0.6105 |
| 社区问答重复问题数据集 | 安卓 | 0.3932 | 0.4435 | 0.4724 | 0.5140 | 0.5279 | 0.4986 |
| 社区问答重复问题数据集 | 英语 | 0.3488 | 0.4021 | 0.4357 | 0.4683 | 0.4841 | 0.4697 |
| 社区问答重复问题数据集 | 物理 | 0.3488 | 0.4053 | 0.4357 | 0.4641 | 0.4873 | 0.4748 |
| 社区问答重复问题数据集 | 网站管理员 | 0.3145 | 0.3546 | 0.3837 | 0.4103 | 0.4195 | 0.4049 |
| 社区问答重复问题数据集 | 程序员 | 0.2997 | 0.3488 | 0.3744 | 0.4169 | 0.4300 | 0.4139 |
| 社区问答重复问题数据集 | 地理信息系统 | 0.3055 | 0.3555 | 0.3923 | 0.4235 | 0.4412 | 0.4301 |
| 社区问答重复问题数据集 | Unix | 0.2965 | 0.3428 | 0.3715 | 0.4085 | 0.4310 | 0.4152 |
| 社区问答重复问题数据集 | 统计学 | 0.2926 | 0.3311 | 0.3541 | 0.3915 | 0.4016 | 0.3862 |
| 社区问答重复问题数据集 | WordPress | 0.2728 | 0.3230 | 0.3490 | 0.3729 | 0.3864 | 0.3543 |
| 社区问答重复问题数据集 | TeX | 0.2441 | 0.2715 | 0.2948 | 0.3205 | 0.3313 | 0.3112 |
| 社区问答重复问题数据集 | Mathematica | 0.2140 | 0.2576 | 0.2923 | 0.3176 | 0.3367 | 0.3266 |
| 代码信息检索基准测试 | 堆栈溢出问答 | 0.6724 | 0.7431 | 0.7697 | 0.8100 | 0.8351 | 0.8560 |
| 代码信息检索基准测试 | 代码搜索问答 | 0.1714 | 0.1937 | 0.2283 | 0.2609 | 0.2828 | 0.2935 |
| 代码信息检索基准测试 | 应用程序 | 0.0485 | 0.0701 | 0.0969 | 0.1354 | 0.1779 | 0.2399 |
| 高难度推理检索基准测试 | 力扣 | 0.1439 | 0.1439 | 0.1498 | 0.1268 | 0.1226 | 0.1341 |
| 高难度推理检索基准测试 | 堆栈溢出 | 0.1405 | 0.1417 | 0.1492 | 0.1551 | 0.1674 | 0.1543 |
| [表 2:使用 jina-reranker-v3.5 和不同候选池大小的 BM25 搜索。] |
使用 jina-reranker-v3.5 进行重排序,可以在每项基准测试中提高 BM25 的基础得分,但对于列表式重排序模型,效果取决于候选池的大小。如果候选池过大,加入重排序模型有时反而会比完全不使用重排序模型更差。在表 2 中,你可以看到 力扣 和 Webis-Touche2020 基准测试出现了这种情况。
如果使用逐点式或成对式重排序,就不会出现这种情况。无论输入多少个候选结果,它们都会产生相同的排序。如果候选结果甲优于候选结果乙,加入候选结果丙也绝不会改变这一点。但列表式重排序模型会同时查看整个候选列表,当输入信息过多时,就会受到注意力稀释和噪声累积的影响。人工智能并非魔法。基于注意力机制的模型资源有限,当这些资源被进一步分散时,表现就会变差。
这里可以看到,向 jina-reranker-v3.5 提供 200 个候选结果,效果反而不如只提供排名前 100 的候选结果。只有三项代码信息检索基准测试在候选数量为 200 时,得分高于更小候选池的情况。在某些情况下,仅使用 50 个候选结果的得分高于使用 100 个。还有两项基准测试在候选数量为 20 时得分达到峰值。
最佳候选池大小的差异,凸显了在任何场景中部署人工智能时都需要重点考虑的一点:基准测试只能非常间接地反映模型在你的数据和流程中的表现,因此,跟踪所选人工智能模型在你的使用场景和数据上的表现十分重要。
不过,如果观察 jina-reranker-v3.5 在不同基准测试中降低了多少误差,我们仍然可以大致了解预期能获得什么样的结果:
| 重排序候选数量(Number of reranking candidates) | 10 | 20 | 50 | 100 | 200 |
|---|---|---|---|---|---|
| 所有数据集的平均误差降幅(Average reduction in error across all datasets) | 0.0878 | 0.1433 | 0.1875 | 0.2097 | 0.1873 |
| [表 3:不同候选池大小下 BM25 的误差降幅。] |
!\[\](https://i-blog.csdnimg.cn/direct/c3957ee0c8f04344b5cc25acadac68c4.png) 图 4:BM25 结合重排序时,各项基准测试的平均误差降幅与候选池大小的关系。
可以看到,在使用 Elasticsearch BM25 的这一场景中,性能在候选数量约为 100 时达到峰值,但使用 50 个候选结果只会让误差略微增加(以 nDCG@10 衡量,约为 2%)。将发送给重排序模型的候选数量减半,会使词元数量减少一半,从而降低 50% 的成本,并缩短延迟。在 25 项基准测试中,只有两项在候选池从 100 缩小到 50 时,误差增幅超过 10%:信息检索基准测试中的文本检索会议新冠疫情数据集,以及代码信息检索基准测试中的堆栈溢出问答数据集。这两种情况都是因为候选数量为 50 时,误差率就已经很低。
这些测试表明,将 jina-reranker-v3.5 与 Elasticsearch 的 BM25 实现结合使用时,最划算的选择是仅使用 50 个候选结果。
重排序在 语义向量 搜索中的表现如何
但如果初始搜索方案更好呢?这些结论是否也适用于使用人工智能生成嵌入向量的 语义搜索 ?
简短结论:不适用。
我们使用 jina-embeddings-v5-text-small 生成的嵌入向量和向量搜索替代 BM25,进行了相同的测试。首先,使用该模型的语义搜索所产生的结果明显优于 BM25,在所选基准测试中,平均误差降低了 25.7%。只有一项基准测试例外,Jina 的语义搜索表现更差,但差距并不大:
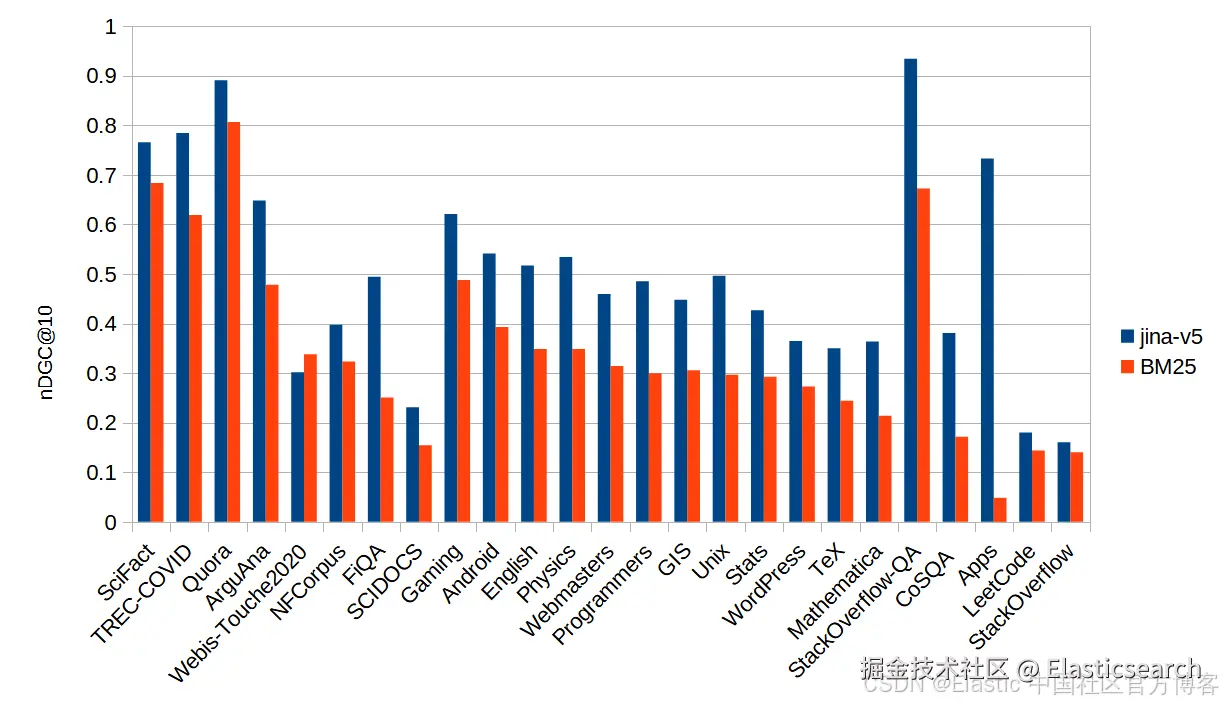 图 5:BM25 与 jina-embeddings-v5-text-small 在各项基准测试中的表现对比。
不过,在候选数量为 100 时使用 jina-reranker-v3.5,可以提高 BM25 的得分,使其足以媲美 Jina 最佳的语义检索效果:
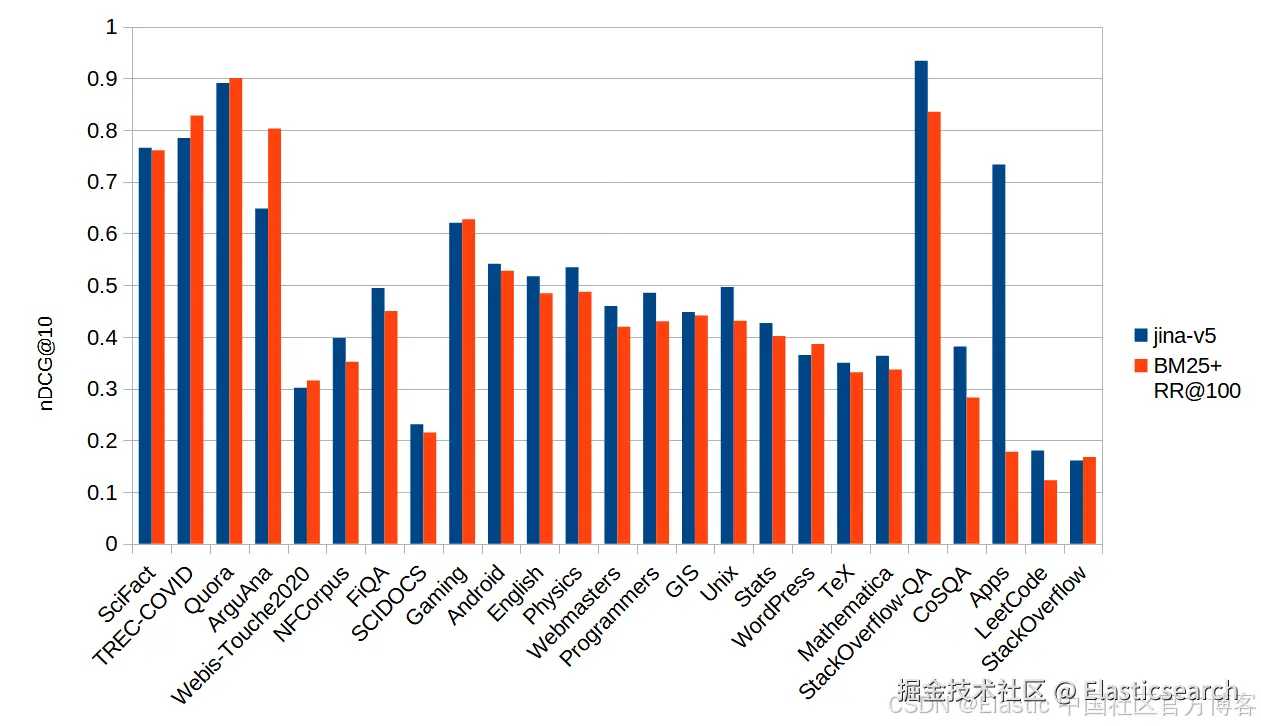 图 6:BM25 结合 jina-reranker-v3.5(使用 100 个候选结果)与单独使用 jina-embeddings-v5-text-small 在各项基准测试中的表现对比。
总体而言, jina-embeddings -v5-text-small 在这些检索基准测试中的表现更好,但优势已大幅缩小。在这些基准测试中,与 BM25 结合 jina-reranker-v3.5 相比,jina-embeddings-v5-text-small 平均将误差降低了 4.2%。在半数信息检索基准测试中,BM25 结合重排序的表现实际上超过了语义搜索。
但是,如果一个优秀的列表式重排序模型能让质量较低的检索效果接近最先进的基于语义嵌入的检索,那么,当我们先使用最佳检索方案时,它还能带来多大提升?
我们使用 jina-embeddings-v5-text-small 进行语义搜索,以相同的候选池大小重复测试:10、20、50、100 和 200。结果如下:
| Dataset | v5-text Alone | RR @10 | RR @20 | RR @50 | RR @100 | RR @200 |
|---|---|---|---|---|---|---|
| BEIR | ||||||
| SciFact | 0.7655 | 0.7935 | 0.7895 | 0.7795 | 0.7768 | 0.7541 |
| TREC-COVID | 0.7846 | 0.8223 | 0.8355 | 0.8583 | 0.8642 | 0.8053 |
| Quora | 0.8909 | 0.9024 | 0.9067 | 0.9068 | 0.9063 | 0.9013 |
| ArguAna | 0.6485 | 0.7819 | 0.8111 | 0.8173 | 0.8183 | 0.8007 |
| Webis-Touche2020 | 0.3015 | 0.3151 | 0.3293 | 0.3234 | 0.3247 | 0.2903 |
| NFCorpus | 0.3978 | 0.4033 | 0.4001 | 0.3976 | 0.3841 | 0.3364 |
| FiQA | 0.4946 | 0.5145 | 0.5205 | 0.5182 | 0.5103 | 0.4496 |
| SCIDOCS | 0.2310 | 0.2415 | 0.2517 | 0.2393 | 0.2267 | 0.1826 |
| CQADupStack | ||||||
| Gaming | 0.6209 | 0.6536 | 0.6676 | 0.6604 | 0.6536 | 0.6048 |
| Android | 0.5412 | 0.5627 | 0.5782 | 0.5713 | 0.5596 | 0.5157 |
| English | 0.5171 | 0.5418 | 0.5533 | 0.5534 | 0.5490 | 0.5072 |
| Physics | 0.5344 | 0.5407 | 0.5404 | 0.5395 | 0.5293 | 0.4923 |
| Webmasters | 0.4595 | 0.4660 | 0.4763 | 0.4675 | 0.4621 | 0.4124 |
| Programmers | 0.4851 | 0.5017 | 0.5005 | 0.4911 | 0.4795 | 0.4260 |
| GIS | 0.4480 | 0.4745 | 0.4846 | 0.4873 | 0.4850 | 0.4325 |
| Unix | 0.4964 | 0.5055 | 0.5200 | 0.5052 | 0.4923 | 0.4455 |
| Stats | 0.4266 | 0.4377 | 0.4492 | 0.4514 | 0.4432 | 0.4046 |
| WordPress | 0.3647 | 0.3890 | 0.4112 | 0.4147 | 0.4169 | 0.3695 |
| TeX | 0.3500 | 0.3707 | 0.3786 | 0.3767 | 0.3687 | 0.3242 |
| Mathematica | 0.3636 | 0.3770 | 0.3891 | 0.3732 | 0.3659 | 0.3244 |
| CoIR | ||||||
| StackOverflow-QA | 0.9341 | 0.9486 | 0.9470 | 0.9437 | 0.9414 | 0.9322 |
| CoSQA* | 0.3812 | 0.3687 | 0.3782 | 0.3725 | 0.3628 | 0.3403 |
| Apps | 0.7332 | 0.7823 | 0.7897 | 0.7823 | 0.7695 | 0.7355 |
| BRIGHT | ||||||
| LeetCode | 0.1803 | 0.1689 | 0.1546 | 0.1232 | 0.1141 | 0.0878 |
| StackOverflow | 0.1606 | 0.1631 | 0.1754 | 0.1665 | 0.1432 | 0.1327 |
| [*CoSQA 的得分在不同运行之间会有约 0.01 的波动。表 4:使用 jina-embeddings-v5-text-small 进行语义向量搜索,结合 `jina-reranker-v3.5` 和不同候选池大小的结果。] |
更好的第一阶段检索会改变最佳候选池大小。平均而言,最佳候选池要小得多,而且不同基准测试的最佳候选池大小也更加分散。使用 200 个候选结果时,平均效果实际上比完全不使用重排序模型更差。对于高难度推理检索基准测试中的力扣数据集和代码信息检索基准测试中的代码搜索问答数据集,无论候选池大小如何,重排序后的得分都低于单独使用检索模型的得分。
| 重排序候选数量(Number of reranking candidates) | 10 | 20 | 50 | 100 | 200 |
|---|---|---|---|---|---|
| 所有数据集的平均误差降幅(Average reduction in error across all datasets) | 0.0661 | 0.0848 | 0.0767 | 0.0629 | -0.0239 |
| [表 5:不同候选池大小下语义向量搜索的误差降幅。] |
!\[\](https://i-blog.csdnimg.cn/direct/fd385934cca44874b40c10da56114a47.png) 图 7:语义向量搜索结合重排序时,各项基准测试的平均误差降幅与候选池大小的关系。
与 jina-embeddings-v5-text-small 结合使用时,重排序在候选数量为 20 时表现最佳,而 BM25 则需要 100 个。这表明,采用更好的策略获取初始候选池,可以降低后续使用重排序模型的成本。不过,更好的初始搜索系统也会减少重排序模型带来的额外价值。对 BM25 找到的前 100 个候选结果进行重排序,平均可将误差降低 20% 以上。而对 jina-embeddings-v5-text-small 找到的前 20 个候选结果(表现最佳的候选池大小)进行重排序,平均仅将误差降低约 8.5%。
如果将 BM25 结合 jina-reranker-v3.5,与 jina-embeddings-v5-text-small 结合 jina-reranker-v3.5 进行比较,语义搜索与智能重排序模型的组合在每项基准测试中的得分都更高。
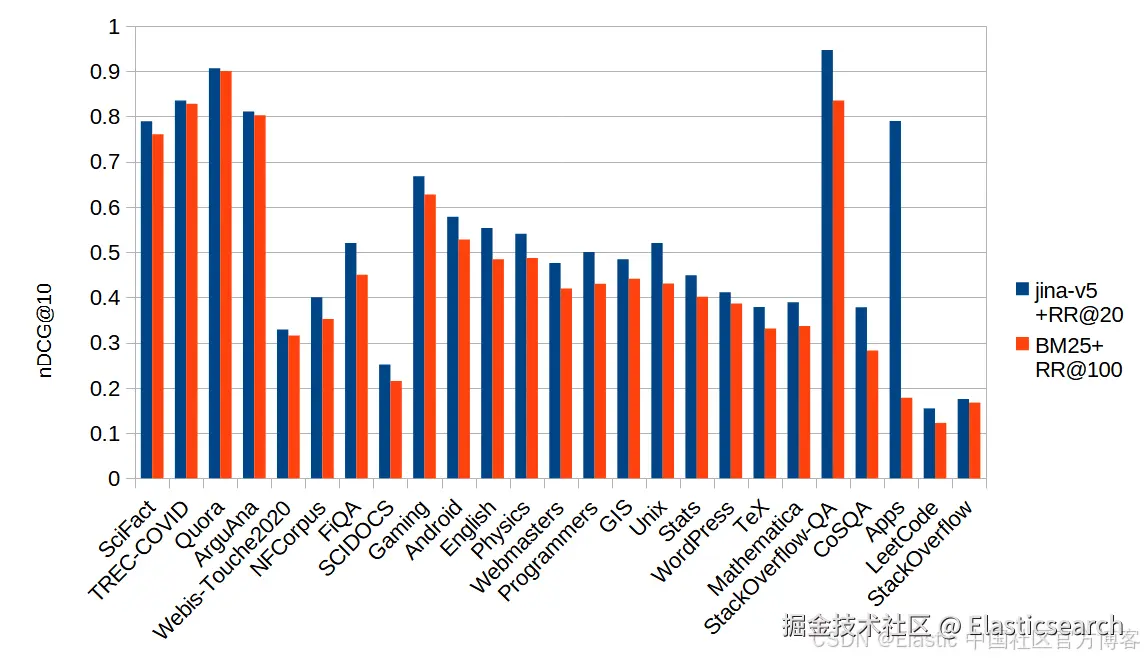 图 8:在各项基准测试中,使用 jina-embeddings-v5-text-small 和 jina-reranker-v3.5 的语义向量搜索(使用 20 个候选结果),与 Elasticsearch BM25 结合重排序(使用 100 个候选结果)的表现对比。
不过,差距可能比你预想的更小。与 BM25 结合 jina-reranker-v3.5 相比,使用 jina-embeddings-v5-text-small 结合 jina-reranker-v3.5,平均将误差降低了 13.26%。这一降幅大约是不使用重排序模型时,jina-embeddings-v5-text-small 相较于 BM25 的误差降幅的一半。
调优列表式重排序模型时,哪些因素最重要
本文使用了一种高性能列表式重排序模型。其中一些计算结果可能并不完全适用于其他重排序模型。不过,列表式重排序模型通常都会面临与本文所述类似的问题。我们的研究尚未达到严格的科学标准,但仍可从这些结果中提炼出一些部署列表式重排序模型的通用原则:
应该向重排序模型发送多少个候选结果?
发送给重排序模型的候选数量不同,结果可能存在显著差异。我们只测试了使用固定数量的策略。根据初始搜索返回的信息,你或许能够判断有多少个候选结果值得发送给重排序模型。BM25 和基于语义嵌入的搜索都会随结果返回得分。某种策略,例如得分阈值,或许能够改善重排序模型的表现。我们没有测试这种可能性。
但我们确实发现,提供给重排序模型的候选结果可能过多。数量更多并不总是更好,反而常常更差。
初始搜索越好,重排序模型带来的额外提升就越小
这一结果符合我们的预期。检索系统犯的错误越少,重排序能够带来的改进空间就越小。现在,我们有了一些实证依据来支持这一点。我们还表明,优秀的重排序模型能够充分改善相对较差的初始搜索,使其足以媲美高性能语义搜索。这一结果对许多实际使用场景都很重要。尤其是 BM25,它成本低、效率高、速度快,而且在信息检索领域根基深厚。Elasticsearch 内置的增强版 BM25 实现本身就已经是一个非常强大的检索系统。与围绕语义搜索重新设计整个检索流程相比,将 jina-reranker-v3.5 添加到 BM25 流程中可能更容易。
初始搜索越差,所需的候选池就越大
两个数据点尚不足以下定论,但我们测试中最佳候选池大小的差距(BM25 为 100,jina-embeddings-v5-text-small 为 20)具有一定启示意义。这意味着,相较于使用语义搜索,采用 BM25 结合重排序模型可能节省计算资源、延迟或成本,但由于需要向重排序模型传入大得多的候选池,这些节省可能会被增加的重排序成本部分抵消。
不同数据集之间的重排序结果差异有多大?
不同基准测试中,重排序的影响和最佳候选池大小可能存在很大差异,这意味着不同真实使用场景之间的差异至少也可能同样大。我们鼓励你使用自己的数据进行测试,并尝试自行优化流程,因为任何一组基准测试都不可能与你的流程完全一致。jina- reranker -v3.5 和 jina-embeddings-v5-text-small 均可通过 Elastic 推理服务(Elastic Inference Service)(Elastic 推理服务(EIS))在 Elasticsearch 中使用。你可以注册一个可免费使用 14 天的 Elastic 云实例(sign up for a free Elastic Cloud instance),亲自尝试。
如何将 jina-reranker-v3.5 添加到你的 Elasticsearch 流程中
你可以使用自己的数据验证所有这些发现,无须自行托管任何模型。使用 Elastic 云服务(Elastic Cloud),意味着 Elastic 会托管所有组件,并管理整个搜索流程和人工智能技术栈。
如果你已经在 Elasticsearch 中使用 BM25 搜索(If you already use BM25 search in Elasticsearch) ,则可以添加 jina-reranker-v3.5,无须重新索引任何数据:
- 为重排序模型创建一个 Elastic 推理(Inference)应用程序编程接口端点。
- 在现有查询中添加一个文本相似度重排序检索器(text_similarity_reranker)。
- 将
rank_window_size设置为 100。该参数控制发送给重排序模型的候选数量,也就是我们在本文中测试的变量。 - 将
rank_window_size设置为 50 后重新运行,并比较结果。在我们的测试中,较小的候选池仅损失了极少的准确率,词元用量却减少了一半。
如果你使用语义向量搜索(If you use semantic vector search),配置方式和起始设置都会有所不同:
- 使用 jina-embeddings-v5-text-small 和语义文本字段(semantic_text)为数据建立索引。
- 添加一个使用
jina-reranker-v3.5的text_similarity_reranker检索器。 - 将
rank_window_size设置为 20,而不是 100。更好的初始检索需要小得多的候选池,对于某些数据,最佳大小还会更小。 - 不要假定更多候选结果会有所帮助。我们发现,对 200 个语义搜索候选结果进行重排序,平均效果比完全不进行重排序更差。
有关在现有 Elastic 搜索流程中使用 jina-reranker-v3.5 的更多信息,请参阅 Elasticsearch 文本重排序文档(Elasticsearch documentation on text reranking)。
jina-embeddings-v5-text-small 和 jina-reranker-v3.5 也都可以通过 Jina 应用程序编程接口使用,并提供免费词元供你试用;它们还提供可在你自己的硬件上运行的 Jina 本地部署(Jina on-prem)容器。两者的模型权重均已发布在拥抱脸(Hugging Face)上,可在非商业许可证下用于测试和研究。如需商业使用,请联系 Elastic 销售团队(Elastic sales)。
你的流程所适用的最佳候选池大小取决于你的数据,因此应实际测量,而不是盲信任何默认值,包括我们给出的默认值。
原文:Reranking in Elasticsearch: How many candidates to send | Elasticsearch Labs