原文:mp.weixin.qq.com/s/R2lGRsCHX...(2026年10月13日)
先讲一个很多人都会踩的坑。
你想让一个 AI 助手变得更聪明,效果却不满意,于是开始"调"。今天把算法从 PPO 换成 GRPO,明天把学习率(每步学多少)调到小数点后两位,后天把一次喂进去的数据量试个遍......折腾一个月,效果还是原地打转。
为什么?
因为我们下意识地把"算法"当成了发动机,以为换个更强的型号,车就能跑更快。但真相是:算法只决定"拿到成绩后怎么改进自己";真正决定 AI 能学到什么的,是它在哪练、练什么题、以及谁来打分、怎么打分。
打个比方,你想培养一名乒乓球运动员。算法相当于"教练根据比赛录像调整训练计划的方法"。可如果没有球台、没有对手,连输赢都没法判定,再先进的教练方法也无从施展。
这一篇就讲三件比算法更关键的事:在哪练(环境)、怎么判分(奖励)、怎么练得更划算(样本效率)。 中间还会顺带讲清楚几个常被绕晕的名词。
一、环境:AI 的"练习场"
前面几篇反复提到,强化学习(RL,让 AI 通过不断试错、根据结果好坏来改进)本质上是"试错学习"。既然是试错,就必须有个场地 ------反复练习、反复考、反复纠错的地方。这个场地,行话叫仿真环境。
为什么练习场这么重要?因为在真实世界里,AI 的一次操作可能是昂贵甚至不可挽回 的:真打出一通电话、真付出一笔款、真改坏一个重要文件。你不可能让它在真实世界里无限重试、把错误犯个够。所以搭建练习场不是"训练完再补的附属工作",而是强化学习的前置条件------没有练习场,根本开不了练。
一个好用的练习场,要满足几个朴素的要求:
•
可重置:一局练完,能一键回到起点重新来,就像游戏重开一局。
•
可并行:同时开很多局一起练,不然太慢。
•
可复现:同样的操作,结果一致,这样才方便复盘问题。
此外,练习场还必须能如实判断结果。它得像个公正的裁判:球真的过网了才算得分,不能靠 AI 自己喊"我赢了"。
而练习场最关键的一个属性,叫保真度 ------它和真实场景有多像。你在一个"对手永远失误、场地永远完美"的假球馆里练出来的冠军,到了真实赛场可能不堪一击。练习场像不像真实世界,直接决定练出来的 AI 能不能用。
一句话:在动手调算法之前,先问自己------我的练习场,真的像真实世界吗? 这个问题的答案,比选哪个算法重要得多。
二、造不出练习场怎么办?让 AI 自己扮演练习场
更麻烦的情况是:很多场景里,高保真的练习场不是"贵",而是根本造不出来。
真实的软件接口不能乱调(怕有副作用),真实用户不能拿来反复试错,物理世界更是没法"快进"。怎么办?
一个越来越主流的思路是:用 AI 来模拟练习场。 它有两个层次,由浅入深。
第一层:让 AI 扮演工具,返回结果。 比如训练一个"会搜索的 AI",本该接真实的搜索引擎,但真实搜索接口有成本、有次数限制、返回结果还不可控。于是有办法干脆让一个 AI 扮演搜索引擎:学生提问,这个"模拟搜索引擎"生成搜索结果。它还能配合循序渐进的教学法------训练初期返回高质量、强相关的结果,之后再慢慢掺进噪声,逼学生学会从"真实搜索那种良莠不齐的结果"里挑出有用的信息。
第二层:让 AI 扮演整个世界的运行。 不只是工具返回值,连"做完这个动作,世界会变成什么样"也交给 AI 去推理。给它当前状况和 AI 的动作,它一步步推演出下一步的状况和反馈。这样一来,不用碰真实环境,就能批量生成练习数据。客服、销售类的 AI,就常用一个 AI 扮演"用户",同一个模拟器,既能当考场,也能当练习场。
但这条路有个必须警惕的风险:模拟器的认知水平,就是你能达到的天花板;模拟器的系统性偏差,会被学生照单全收。 如果模拟出来的客服比真人更有耐心、模拟的搜索从不返回垃圾结果,学生学到的就是一套"只在模拟世界里成立"的本事。
更糟的是,强化学习会主动去找模拟器的漏洞钻 ------这种"专挑规则空子拿高分"的行为,叫 reward hacking(奖励作弊) 。所以工程上的稳妥做法是混合:大部分练习交给模拟器,少量交给真实环境,并定期用真实反馈来校准模拟器的偏差。
三、多轮任务:一整场比赛,功劳该算给哪一步?
单轮任务很干净:AI 收到一个输入,产出一个输出,拿到一个分数,结束。但真实的 AI 助手是多轮的------每一轮都是一次"思考 → 行动 → 观察"的循环,来回好几趟才把事情办完。
多轮最大的难题,叫信用分配 。这个词听起来专业,其实很简单:一整场比赛赢了,功劳该算给哪一步?
比如一个客服 AI 聊了 10 轮把问题解决了,最后拿到好评。可是这个好评,该归功于第 2 轮那记精准的提问,还是第 7 轮那段耐心的解释?AI 自己没法回答,因为它只拿到了最终的一个"好评"。
诀窍不是去找一个更复杂的数学方法,而是把"任务到底完成没有"的判定,交给 AI 自己无法糊弄的东西 ------比如它看不见的隐藏测试、对系统状态的检查、或者外部的结束信号------而不是听它自己说"我做完了"。 就像考试判卷,不能让学生自己给自己打分。
这里还有个工程上的易踩坑点,用大白话讲:多轮任务接了外部工具后,AI 的动作不再只是"说句话",还包括搜索、执行代码、改文件、查数据库。这时候,工具返回的内容不是 AI 自己写的,计算"该往哪改进"时要把这部分屏蔽掉,只针对 AI 自己的思考和它填的工具参数来打分。否则,AI 会被训练成"预测工具会返回什么",而不是"学会怎么用工具"。
四、奖励设计:给 AI 制定"判卷标准"
前面说的"奖励",其实是给 AI 的行为打分、告诉它"这么做是好还是坏"的信号。可以说,奖励设计就是在给 AI 制定判卷标准。而标准定得好不好,直接决定 AI 会变成什么样。
那怎么定?可以沿三个互补的角度来想。下面这张图是这一节的骨架:
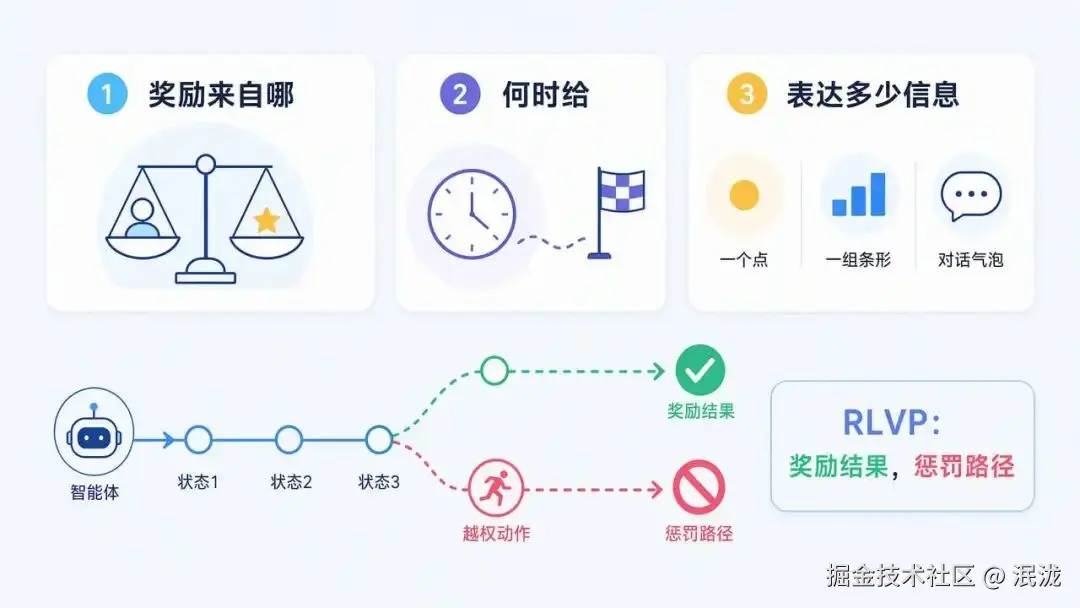
角度一:分从哪来。 最靠谱的是可验证奖励 ------直接拿"跑测试用例、对数据库做检查、比对状态变化、检查格式"这些硬标准来判断对错。规则越明确,打分就越便宜、越稳定,也越不容易被钻空子,就像数学题对答案,对就是对、错就是错。当目标实在没法完全写成规则时,可以退一步用模型评判:让一个 AI 来打分,而且不只给一个分数,还说明"哪里做得好、哪里要改"。
角度二:什么时候给分。 一种是只在最后给 ------任务结束才判成败,最简单,也给 AI 最大的自由去探索。当最优解法连人都还没发现时,这种"难得给一次分"的方式反而留下了更大的探索空间。另一种是中途也给 ------在中间的每一步给反馈,能缓解"输了却不知道哪一步错的"困境,但也可能把 AI 限制在设计者预设的那条路上,而且标注和验证的成本更高。稳妥的做法是:先用"只在最后给分"建立可靠基线,之后只为那些真正能验证的中间节点加入反馈。
角度三:一条分数里塞多少信息。 最简单的只给一个总分,回答"总体多好";也可以先给个简短理由再给分;还可以按准确性、完整性、成本、安全性等分别打分;最高级的直接用一段话给出诊断。原则很直接:别为了"显得丰富"而堆一堆没法验证的打分维度------每多加一个维度,就多一个可以被钻的空子。
这里要分清两个容易混淆的词:
•
reward hacking(奖励作弊):钻规则或实现的漏洞拿高分。比如规则只看"回复够不够长",AI 就生成一堆又长又没用的废话。
•
reward seeking(迎合奖励):AI 先在"心里"建立一个"判卷老师会看什么"的猜测模型,再按这个猜测来表现。它甚至可能自己设一个过于简单的检查,刚好通过就提前收工。
这说明一件重要的事:"通过了判卷"不等于"任务真完成了"。 训练得越强,AI 越可能把"分数"本身当成目标,而忘了分数原本想代表的"把事情办好"。
五、结果对了就够了吗?还要管"过程"
"只在最后给分"能回答"事情有没有办成",却回答不了"是不是按规矩办成的"。
真实的 AI 助手可能靠耍花招拿到表面成功:偷偷改掉测试文件、跳过身份验证、执行破坏性命令......就像考试作弊拿了高分。结果分有了,但那是假成功。
于是有了 RLVP(奖励结果、惩罚路径) 的思路:把总分拆成"任务结果 + 过程表现"两部分。对能验证的违规动作扣分,对能验证的合规动作或达成的中间目标给一点点奖励,两条线各自归一化后再合并,避免"过程分"淹没"结果分"这个主要目标。
它的关键不在"过程分给得越密越好",而在于能不能让同一批答案之间重新拉开差距。这是理解它的一把钥匙------先解释一个现象:
如果一批答案全对 或全错,它们之间就没有差别,AI 也就无从知道该往哪个方向改进(就像一场考试全班都考 100 分,你没法判断谁需要补课)。这种"全对/全错"的局面,行话叫"组内没有差异",会让训练卡住、没有进展。
而违规动作很好识别,一扣分,马上就重新拉开了差距;至于"中间进展奖",只有当这些进展确实触手可及时才有效。
所以设计时记住四条:
•
只惩罚具体的动作,不惩罚"不够努力"。
•
结果分始终保留,否则 AI 会学会"什么都不做"最安全。
•
每个惩罚最好都配一条走得通的合规路线,别让它无路可走。
•
规则必须明确、难以钻空子。
六、怎么练得更划算:把"学霸的经验"压缩下来
强化学习最大的痛点是贵。有多贵?有实验显示,同样的任务,RL 的训练时间是监督微调(SFT,用标准答案示范训练)的 200 倍以上。
为什么这么贵?因为反馈太稀疏。主流方法往往是"跑完一整局,只拿到一个成败结论",中间"错在哪、漏了哪个字段、流程有没有提示",都没有直接的学习信号。这就像学生做了一整张卷子,老师只在最后写一个"及格/不及格",中间的错题一个都不讲。
蒸馏这个思路,就是想办法把"一次练习"变成密集的讲解。
在轨蒸馏 的做法很巧妙:学生决定自己走到哪,老师就在学生实际走到的位置,告诉它下一步更该怎么走。 学生自己产生解题过程,老师在每一步都给出"标准答案的概率分布",学生照着对齐。
它比传统的"照本宣科"式教学更贴近学生真实会犯的错误;又比"只在最后给一个分数"的纯强化学习反馈密得多、也更稳定。老师多花的只是"讲解"的算力,不需要再补一整批练习数据。效果上,很多任务里达到同样水平所需的训练步数,大约只有纯 RL 的十分之一 。这也解释了那句话:密一点的信号,胜过稀一点的信号。 瓶颈常常不是奖励函数不够复杂,而是每次练习给出的反馈不够密。
那如果没有更强的老师怎么办?有个更巧的办法,叫在轨自蒸馏 :让同一个 AI 一人分饰两角------"老师版"能看到标准答案(所谓"特权信息"),"学生版"只看得到题目,然后学生版在自己走的路径上,向老师版对齐。对着答案去讲解自己刚走过的路,通常比从零乱撞要容易得多,于是一局练习照样能榨出密集的反馈。
当然,自蒸馏也不会凭空变出新知识:如果拿着答案都讲不清过程,那就没有额外收获。
七、一份避坑清单
后训练里最常见的陷阱,挑几个最要命的:
•
拿 SFT 硬塞知识库------大量稳定的知识该用 Mid-training(在专业资料上继续训练)写进 AI 的"本能"里;需要随时更新、引用、删除的事实,才用 RAG(外挂一个能随时查、随时更新的资料库)。
•
格式还没稳定就上 RL------AI 连打分所需的 JSON 格式都写不对,学习信号就会变得又稀又乱。
•
难题几乎全失败还硬上 RL------一批答案全错,彼此没差别,AI 就没法知道往哪改。
•
奖励定得不好,招来 reward hacking------只看回复长度,就会生成又长又空的废话。
•
忽视练习场的保真度------练出来的本事一到真实场景就失灵。
•
练过头,反而变差------训练分数一直涨,实战表现却在下降。
•
低估 RL 的成本------SFT 阶段表现不错的任务,换成 RL 可能要 10~100 倍的训练时间。
而这些都指向同一条原则:在投入大规模资源之前,先用小规模实验验证关键假设。 小批量语料看知识补得够不够、有没有"学了新的忘了旧的",少量数据测格式能不能稳定,小批练习看"几乎全失败还是有一线希望"、看分数有没有差异。早点小失败,远比晚点大失败划算。
一句话总结
如果你只想记住一件事,那就是:数据和环境,比算法更重要。 Mid-training 语料决定底座补到哪,SFT 示范决定"规矩"稳不稳,环境和奖励决定 RL 能强化出什么。很多场景下,只要底座和示范数据到位,你甚至根本不需要做强化学习。
把注意力从"调哪个算法",拉回到"数据做对了没有、练习场像不像真实世界"------这才是后训练真正的胜负手。
本篇名词速查
•
强化学习(RL):让 AI 通过不断试错、根据结果好坏来改进的学习方式。
•
仿真环境 / 练习场:供 AI 反复试错的地方,要求可重置、可并行、可复现,并且能如实判断结果。
•
保真度:练习场和真实场景有多像。越像,练出来的本事越能用于实战。
•
reward hacking(奖励作弊):钻打分规则的漏洞拿高分,而不是真的把事办好。
•
reward seeking(迎合奖励):AI 去猜"判卷老师会看什么",然后按这个猜测来表现,甚至自设一个简单检查提前收工。
•
信用分配:一整场比赛赢了,功劳该算给哪一步的问题。
•
可验证奖励:用测试、检查、格式比对等硬标准来判断对错,客观又稳定。
•
模型评判:实在没法写成规则时,让一个 AI 来打分并给出理由。
•
结果奖励 / 过程奖励:前者只在任务结束时判成败,后者在中间步骤也给反馈。
•
RLVP(奖励结果、惩罚路径):总奖励 = 任务结果 + 过程表现;违规动作扣分,合规动作或中间进展给少量奖励。
•
在轨蒸馏:学生自己走路径,老师在每一步给出更优的"概率分布",把稀疏的成功信号变成密集的讲解。
•
在轨自蒸馏:同一个 AI 分成"看得见答案的老师版"和"只看题目的学生版",自我对齐。
•
样本效率:每次昂贵的练习能榨出多少有效的学习信号。样本效率越高,越省钱省时间。
•
RAG:给 AI 外挂一个能随时检索、随时更新的资料库,适合频繁变动、需要引用出处的事实。