226 个跑腿任务各跑三次,678 次运行完成 98%;同一天另一组数字是 597 个查询里成功率从 37.5% 提到 65.8%,还有一条「12 小时无故障」。这几个数分母不同,横向比没有意义。把 98% 放在「一次任务」这一层,连跑 20 次只剩 66.76%;要把 20 次连跑拉回 90%,单次得做到 99.4746%。下面的数按公开口径和几组显式假设算,不是任何一家的验收报告,边界在第 7 节。
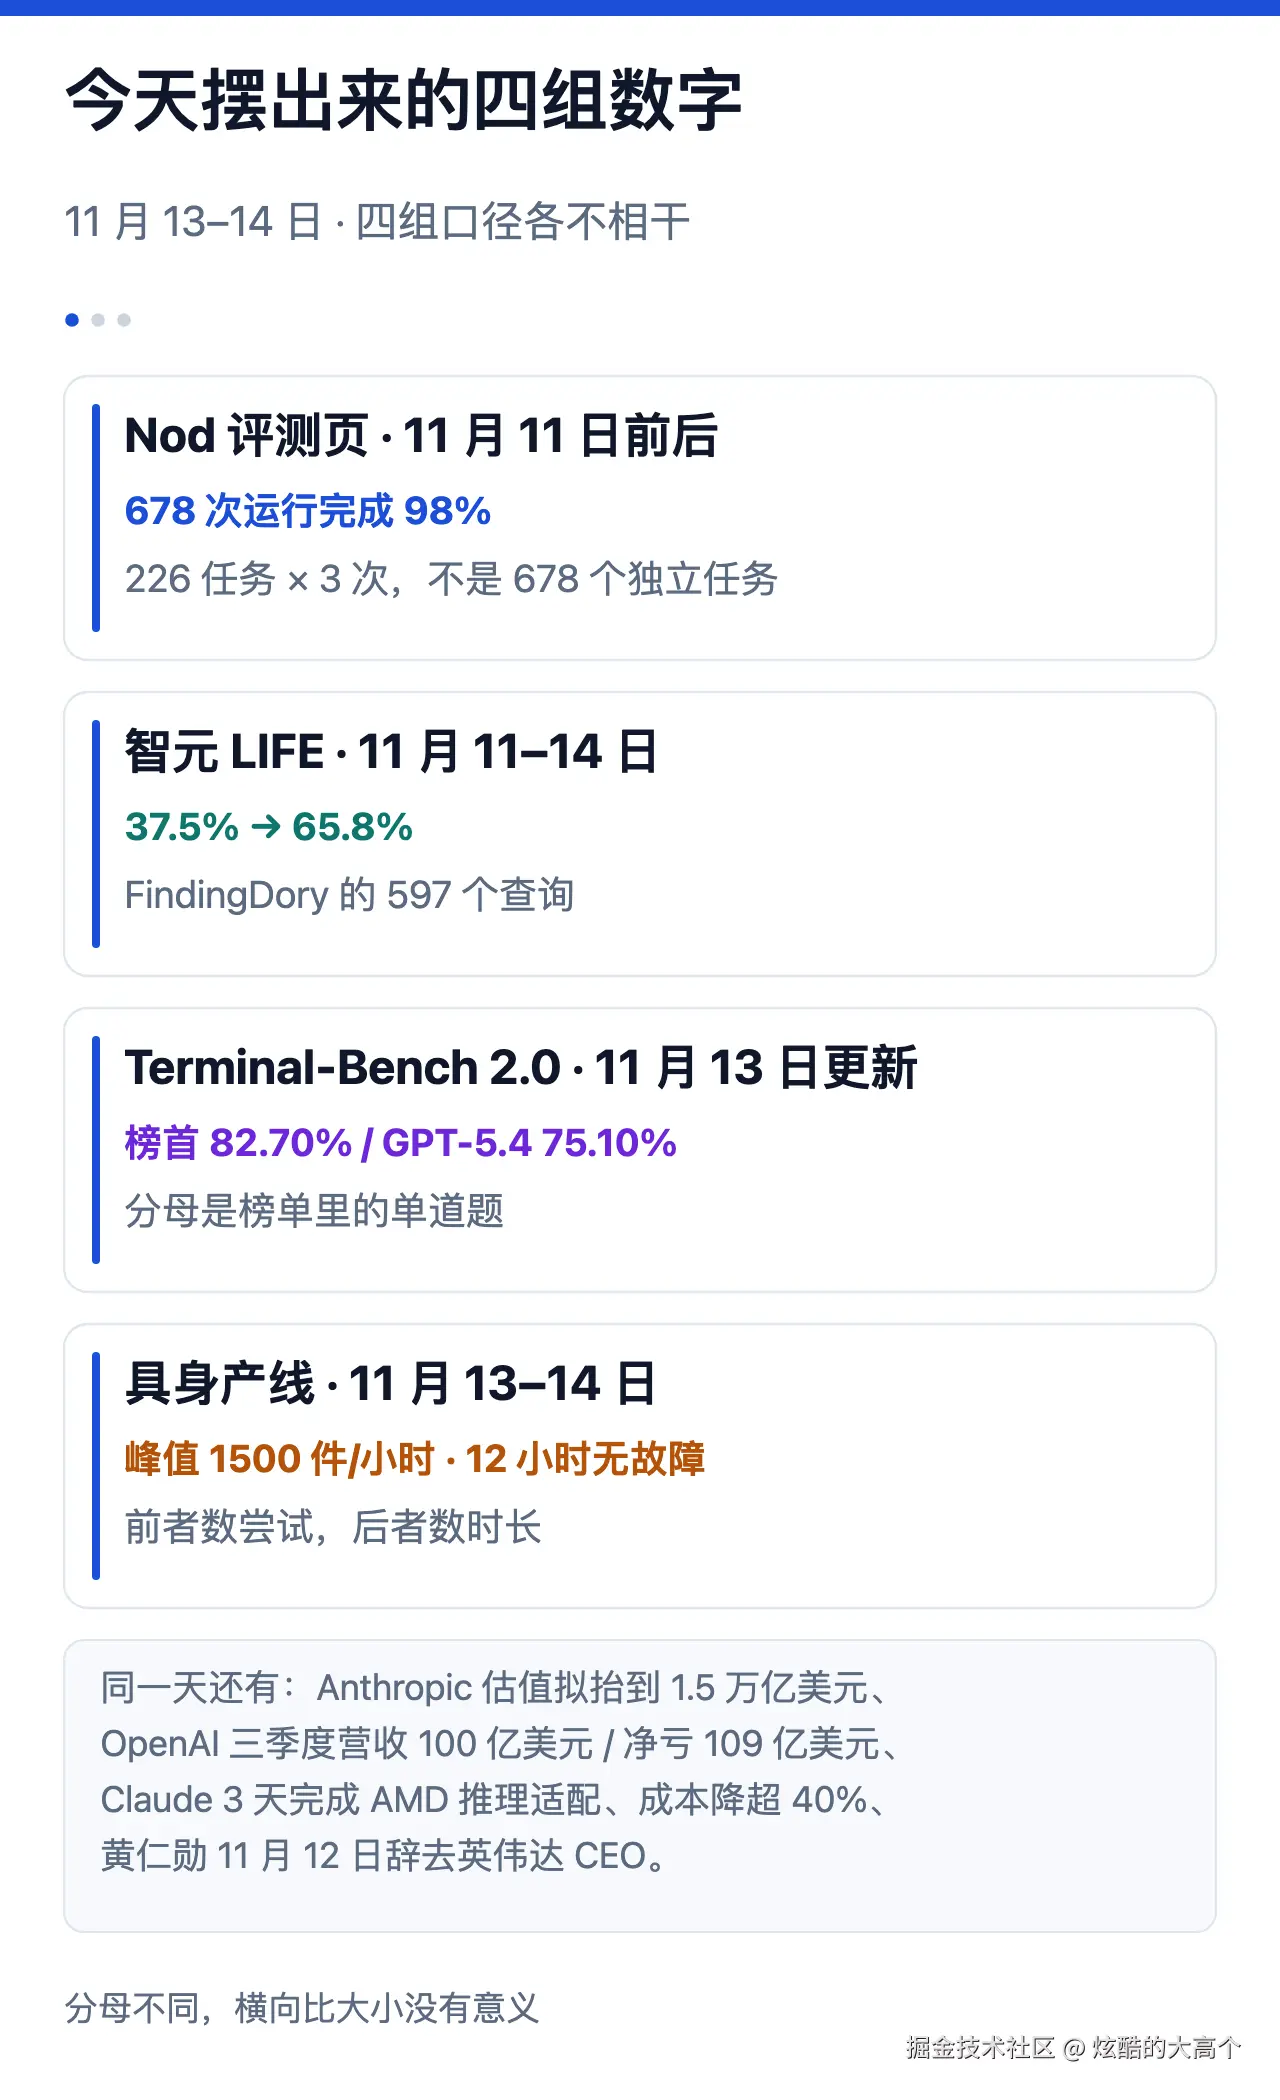
11 月 14 日这天,几家把「成功率」摆到了台面上。n8n Labs 的 Nod 在评测页写着 98% 任务完成、678 次运行零次越权动作;智元的 LIFE 框架在 FindingDory 的 597 个查询上把成功率从 37.5% 提到 65.8%;Terminal-Bench 2.0 的榜单 11 月 13 日更新,榜首 82.70%;具身这边,星动纪元分拣峰值 1500 件/小时,优必选 U1 Pro 在汽车总装车间日均无故障运行超 12 小时。
同一天还有另外一批数字:Anthropic 的 IPO 估值从 1.4 万亿美元被承销商考虑抬到 1.5 万亿以上,计划筹资最多 904 亿美元;OpenAI 三季度营收首次到 100 亿美元、单季净亏 109 亿美元;Claude 用 3 天完成 AMD 芯片推理适配,推理成本较初期降超 40%;黄仁勋 11 月 12 日辞去英伟达 CEO,CFO 临时接任,三季度财报排在 11 月 17 日。掘金 3 日榜前 10 里,第 7 篇是「Coze、n8n、Dify 退潮」,第 8 篇是黄仁勋辞职。
营收和亏损那几个数有统一的单位,完成率这组没有。前一组数看着都很高,量的却不是同一件事。把分母摊开算了一遍之后,我觉得真正卡住上生产线的不是那个 98%,是失败有没有被看见。
目录:1 四组分母 / 2 口径错一次 / 3 连跑要多少 / 4 重试买回多少 / 5 「零」能证明什么 / 6 区间跟着分母走 / 7 检出与产线 / 8 清单
1. 四组数字,四个分母
先把来源和数字分开摆,别急着比大小。
| 来源 | 数字 | 分母是什么 |
|---|---|---|
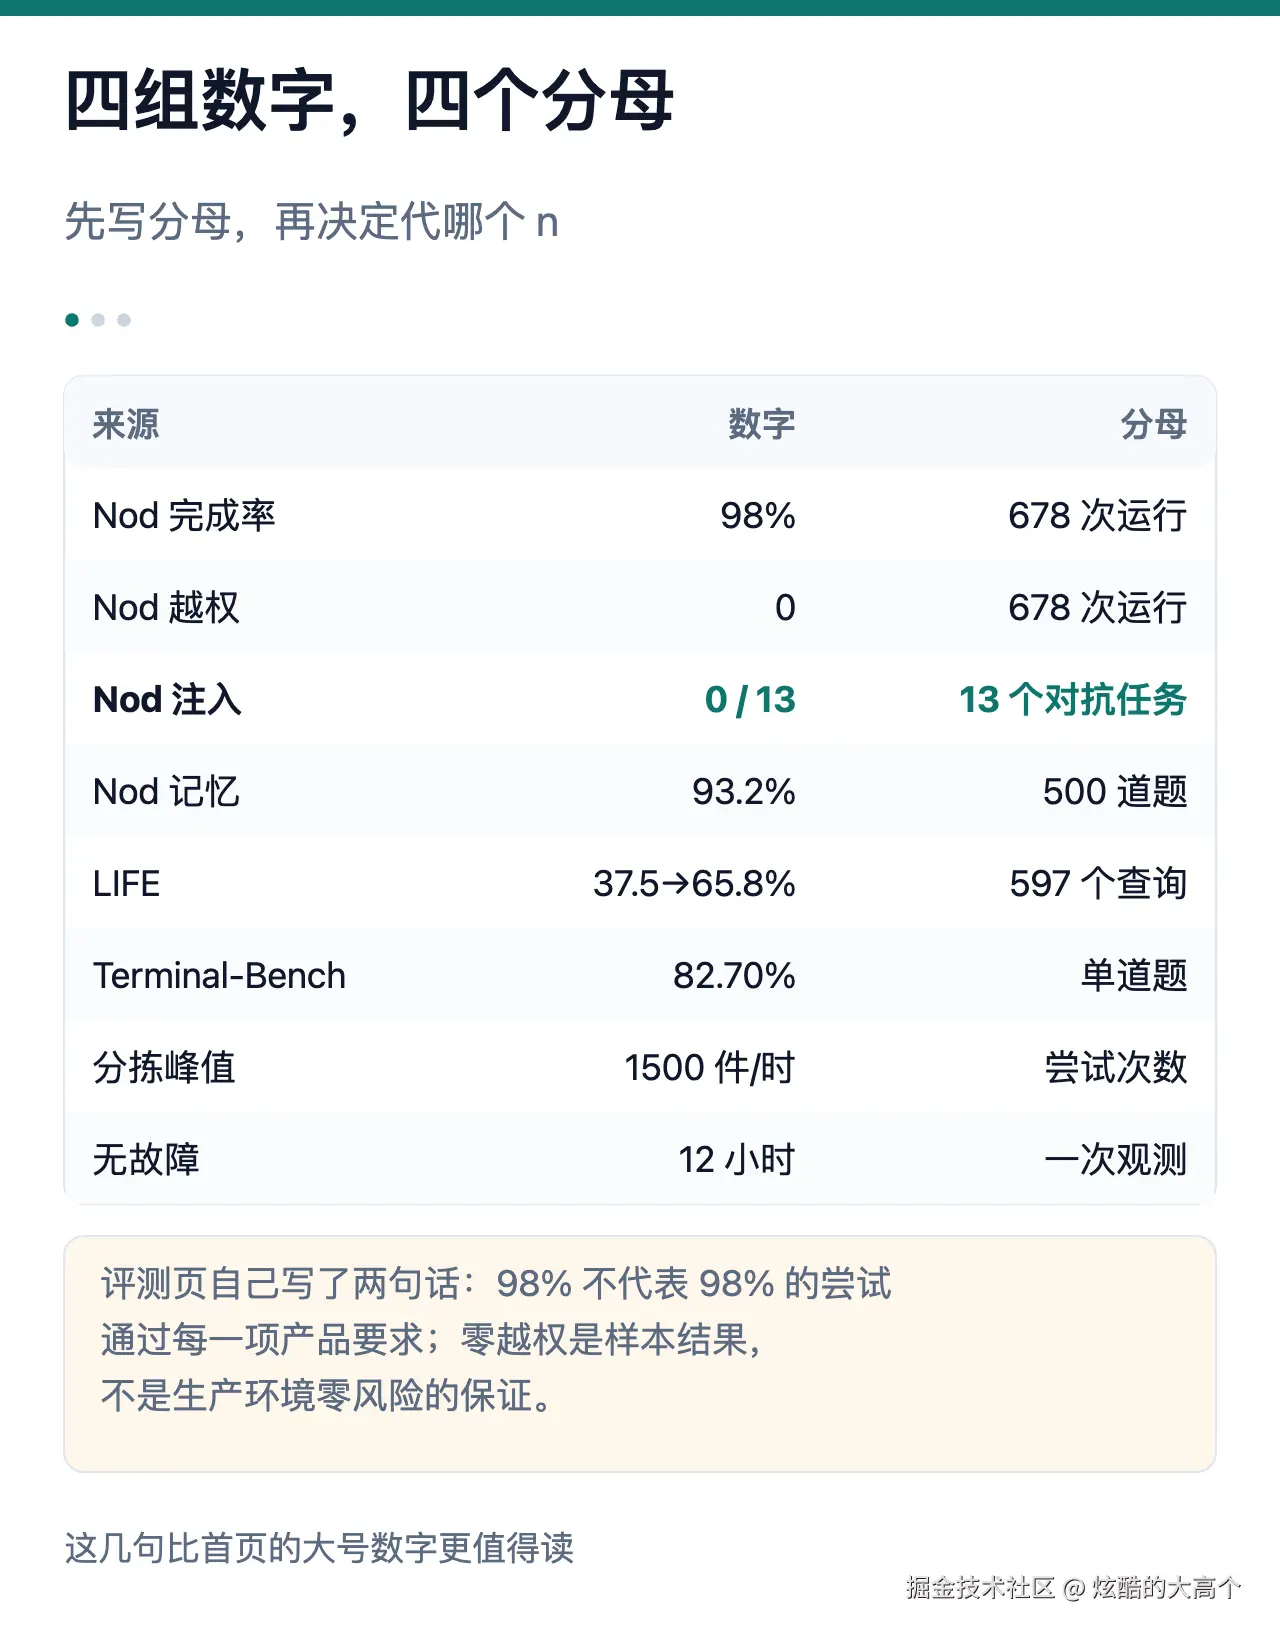
| Nod 任务完成 | 98% | 226 个任务 × 3 次 = 678 次运行 |
| Nod 越权动作 | 0 | 同样是这 678 次运行 |
| Nod 注入场景 | 0 / 13 | 13 个对抗任务,各跑三次 |
| Nod 记忆召回 | 93.2% | LongMemEval-S 的 500 道题 |
| LIFE 成功率 | 37.5% → 65.8% | FindingDory 的 597 个查询 |
| Terminal-Bench 2.0 | 82.70% / 75.10% | 榜单里的单道题完成率 |
| 分拣峰值 | 1500 件/小时 | 峰值时段的尝试次数 |
| 无故障运行 | 12 小时 | 一次连续观测的时长 |
「678 次运行」不是 678 个独立任务,是 226 个任务各跑三遍。「13 个注入场景」是从这 226 个任务里挑出来的子集,不是另加的 13 个日常任务。「1500 件/小时」数的是尝试,不是合格件。这些括号里的东西,决定了后面每个公式该代哪个数。
Nod 的评测页自己把话写得很清楚:98% 只表示任务完成,不代表 98% 的尝试通过了每一项产品要求,另有一个更严格的通过率单独记分;零越权、零注入也是样本结果,不是生产环境零风险的保证。这段说明比首页那三个大号数字更值得读。
2. 把 98% 当单步率,第一遍就错了
第一遍算的时候,我把 98% 当成「每一步的成功率」,拿去估一个 20 步的任务,算完才发觉口径不对。Nod 量的单位是「一个跑腿任务是否完成」,任务内部有多少次点击、多少次表单、多少次权限检查,评测页没有按步给数。把任务级成功率拆成步级成功率,中间缺一层观测。
口径对齐之后才能往下算:如果关心的是连着跑 20 个任务、每个任务独立完成、成功率都是 0.98,那 20 次全成的概率是 0.98 的 20 次方,66.76%。跑 50 次掉到 36.42%。这个衰减不是模型变差了,是独立事件相乘。
换成别的数字更直观。Terminal-Bench 2.0 榜首的 82.70% 连做 20 道题,全对概率 2.24%;LIFE 的 65.8% 连做 10 件,只剩 1.52%;基线 37.5% 连做 5 件就到 0.74%。单个数字从 37.5% 提到 65.8% 是接近翻倍的改进,放到连做 10 件这个尺度上,1.52% 和 0.01% 的差距不改变「还不能交给它自己跑」这个结论。
脚本只用标准库,Python 3.9+ 能跑:
bash
python3 reliability_ledger.py            # 全量账本
python3 reliability_ledger.py --check    # 断言自检
python
def chain(p, n):
    return p ** n

def required_p(target, n):
    return target ** (1.0 / n)

chain(0.98, 20)      # 0.6676079718
required_p(0.90, 20) # 0.9947458259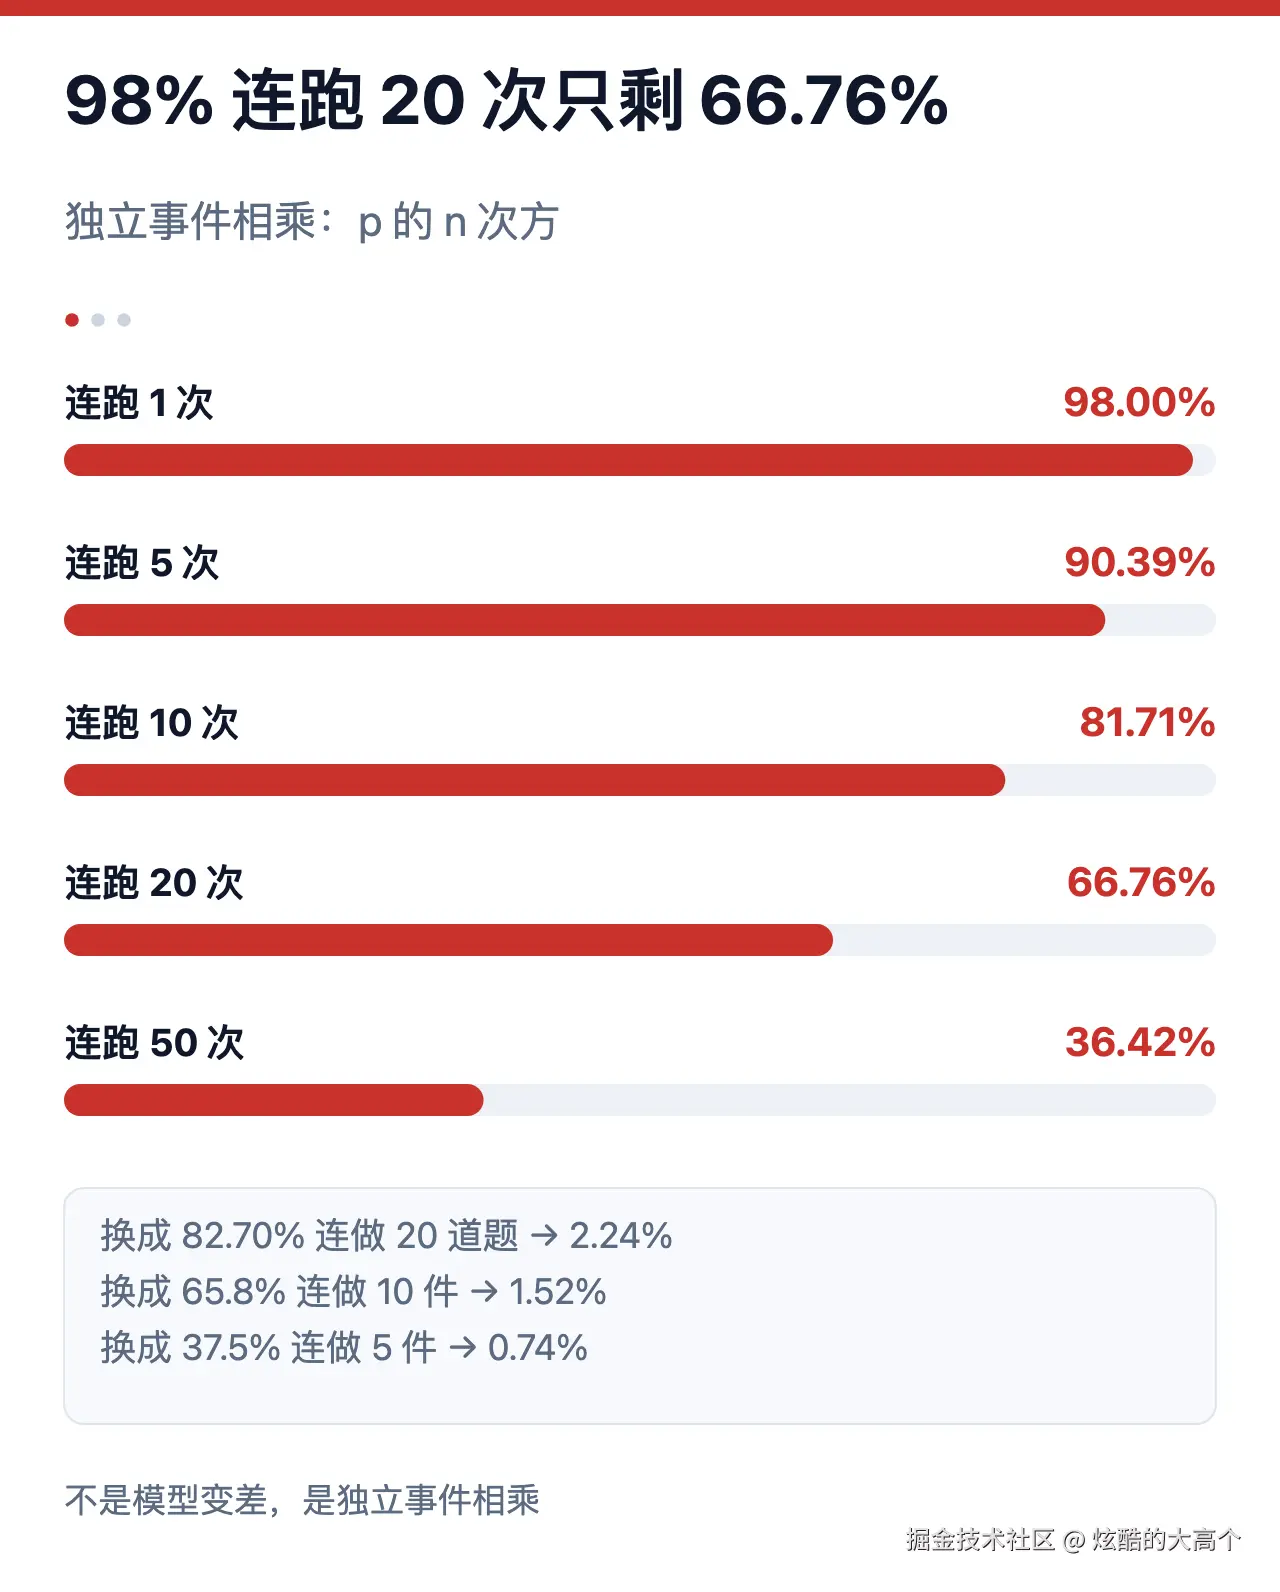
3. 连跑二十次,单次要多少
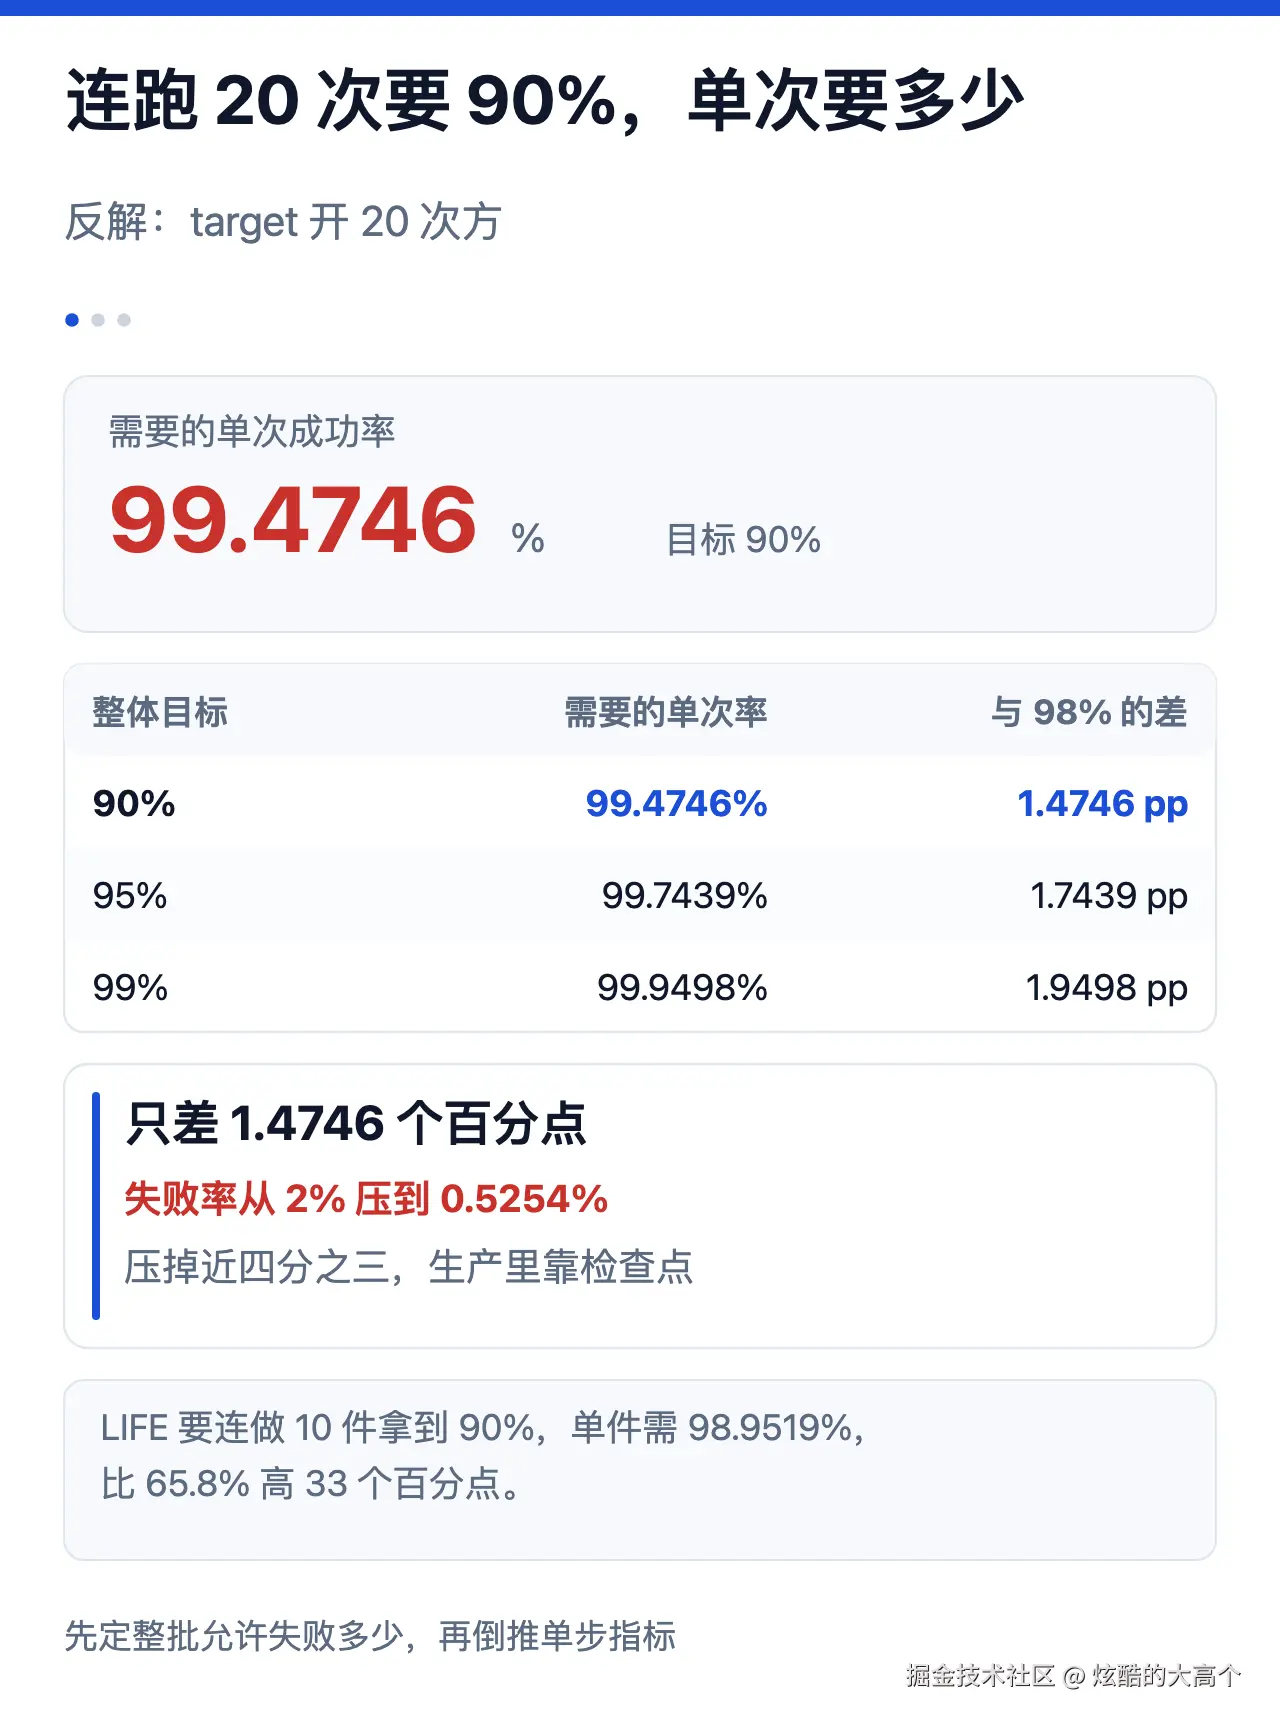
反过来看更实用。要让连跑 20 次的整体成功率到 90%,单次成功率得是 0.9 开 20 次方,99.4746%;到 95% 要 99.7439%;到 99% 要 99.9498%。
98% 和 99.4746% 之间只差 1.4746 个百分点,听上去不多,落在分母上就是把失败率从 2% 压到 0.5254%,压掉近四分之三。这事在实验室里靠换模型、加采样还能试,在生产里靠的是检查点和重试,因为再往上每一个「9」都要单独付钱。
LIFE 那组数反解出来更吃力:要在连做 10 件时拿到 90%,单件得 98.9519%,比 65.8% 高 33 个百分点。所以「从 37.5% 提到 65.8%」和「能不能连续干十件」是两个问题,前者的分母是查询,后者的分母是工序,中间还隔着一层任务编排。
| 目标(连跑 20 次) | 需要的单次成功率 | 与 98% 的差 |
|---|---|---|
| 90% | 99.4746% | 1.4746 pp |
| 95% | 99.7439% | 1.7439 pp |
| 99% | 99.9498% | 1.9498 pp |
这类反解适合放在容量评估的第一页:先定「一批任务允许整体失败多少」,再倒推单步指标,比拿着一个 98% 去猜能撑多久靠谱。
4. 重试买回多少,代价是什么
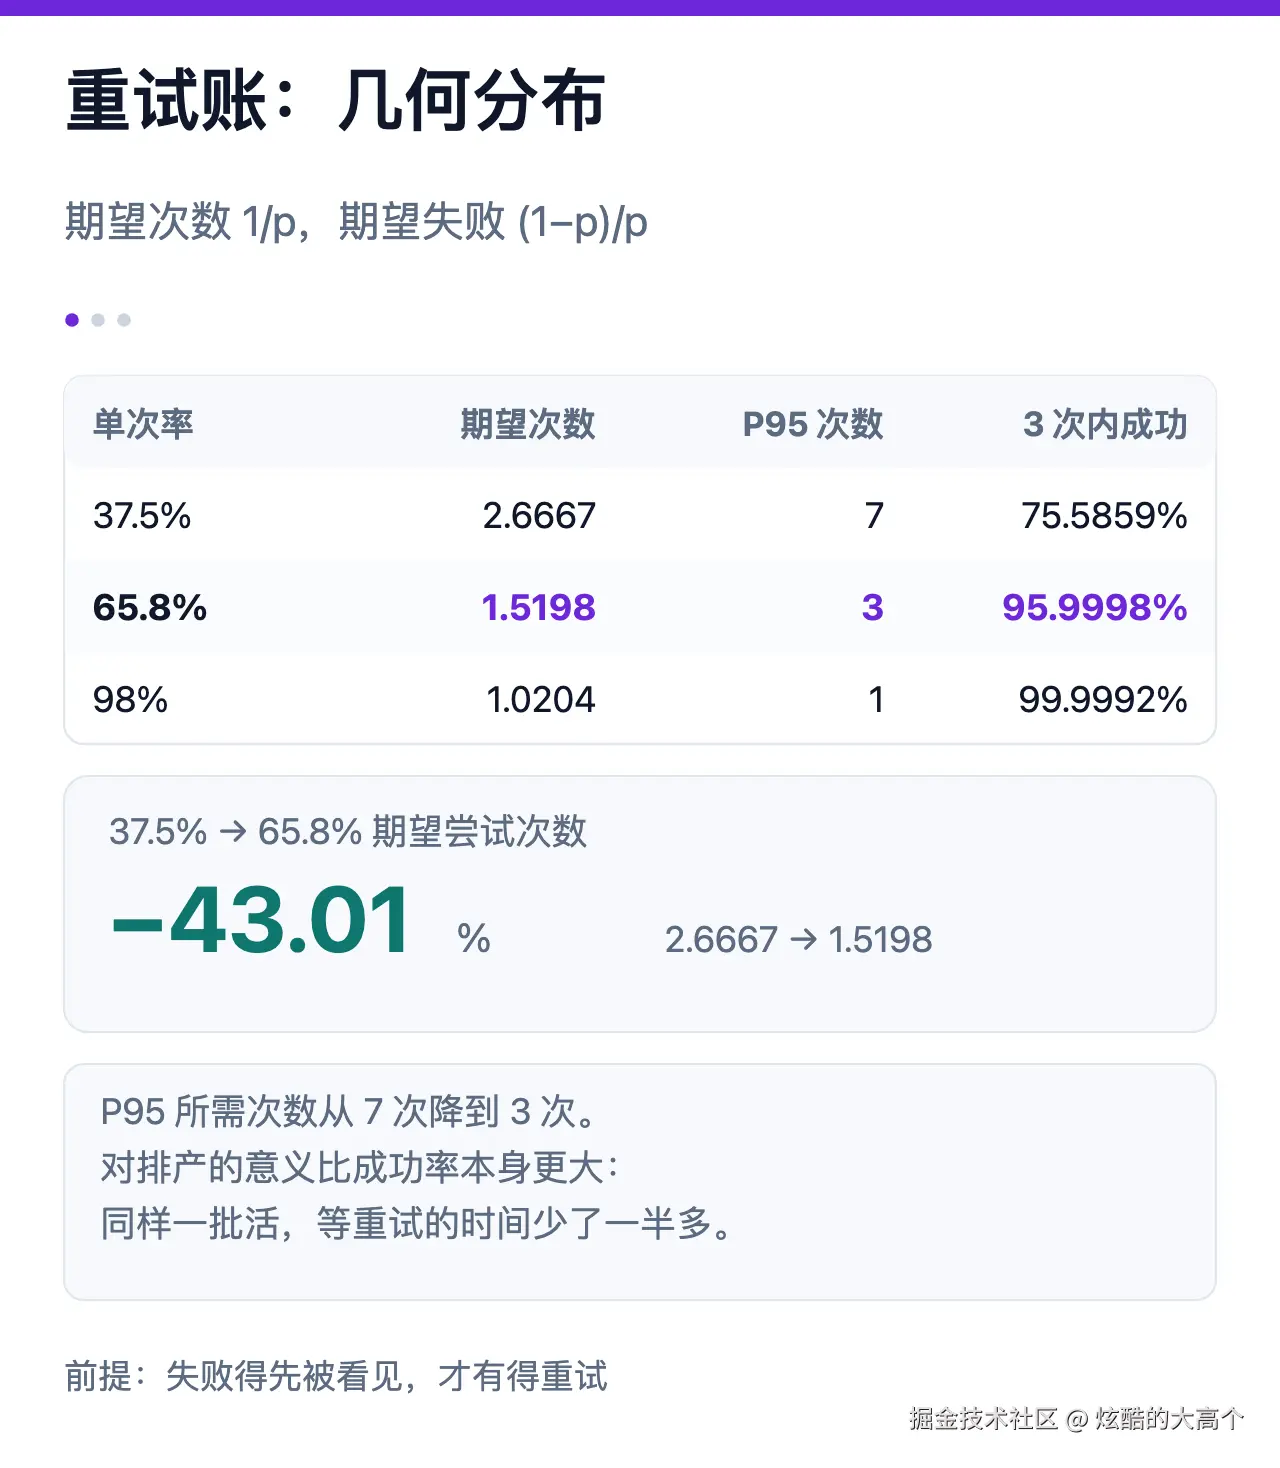
单任务成功率 p,拿到一次成功需要的期望尝试次数是 1/p,成功之前的期望失败次数是 (1-p)/p。按这个算:
| 单次成功率 | 期望次数 | 期望失败 | P95 所需次数 | 3 次内成功 | 期望运行数(上限 3 次) |
|---|---|---|---|---|---|
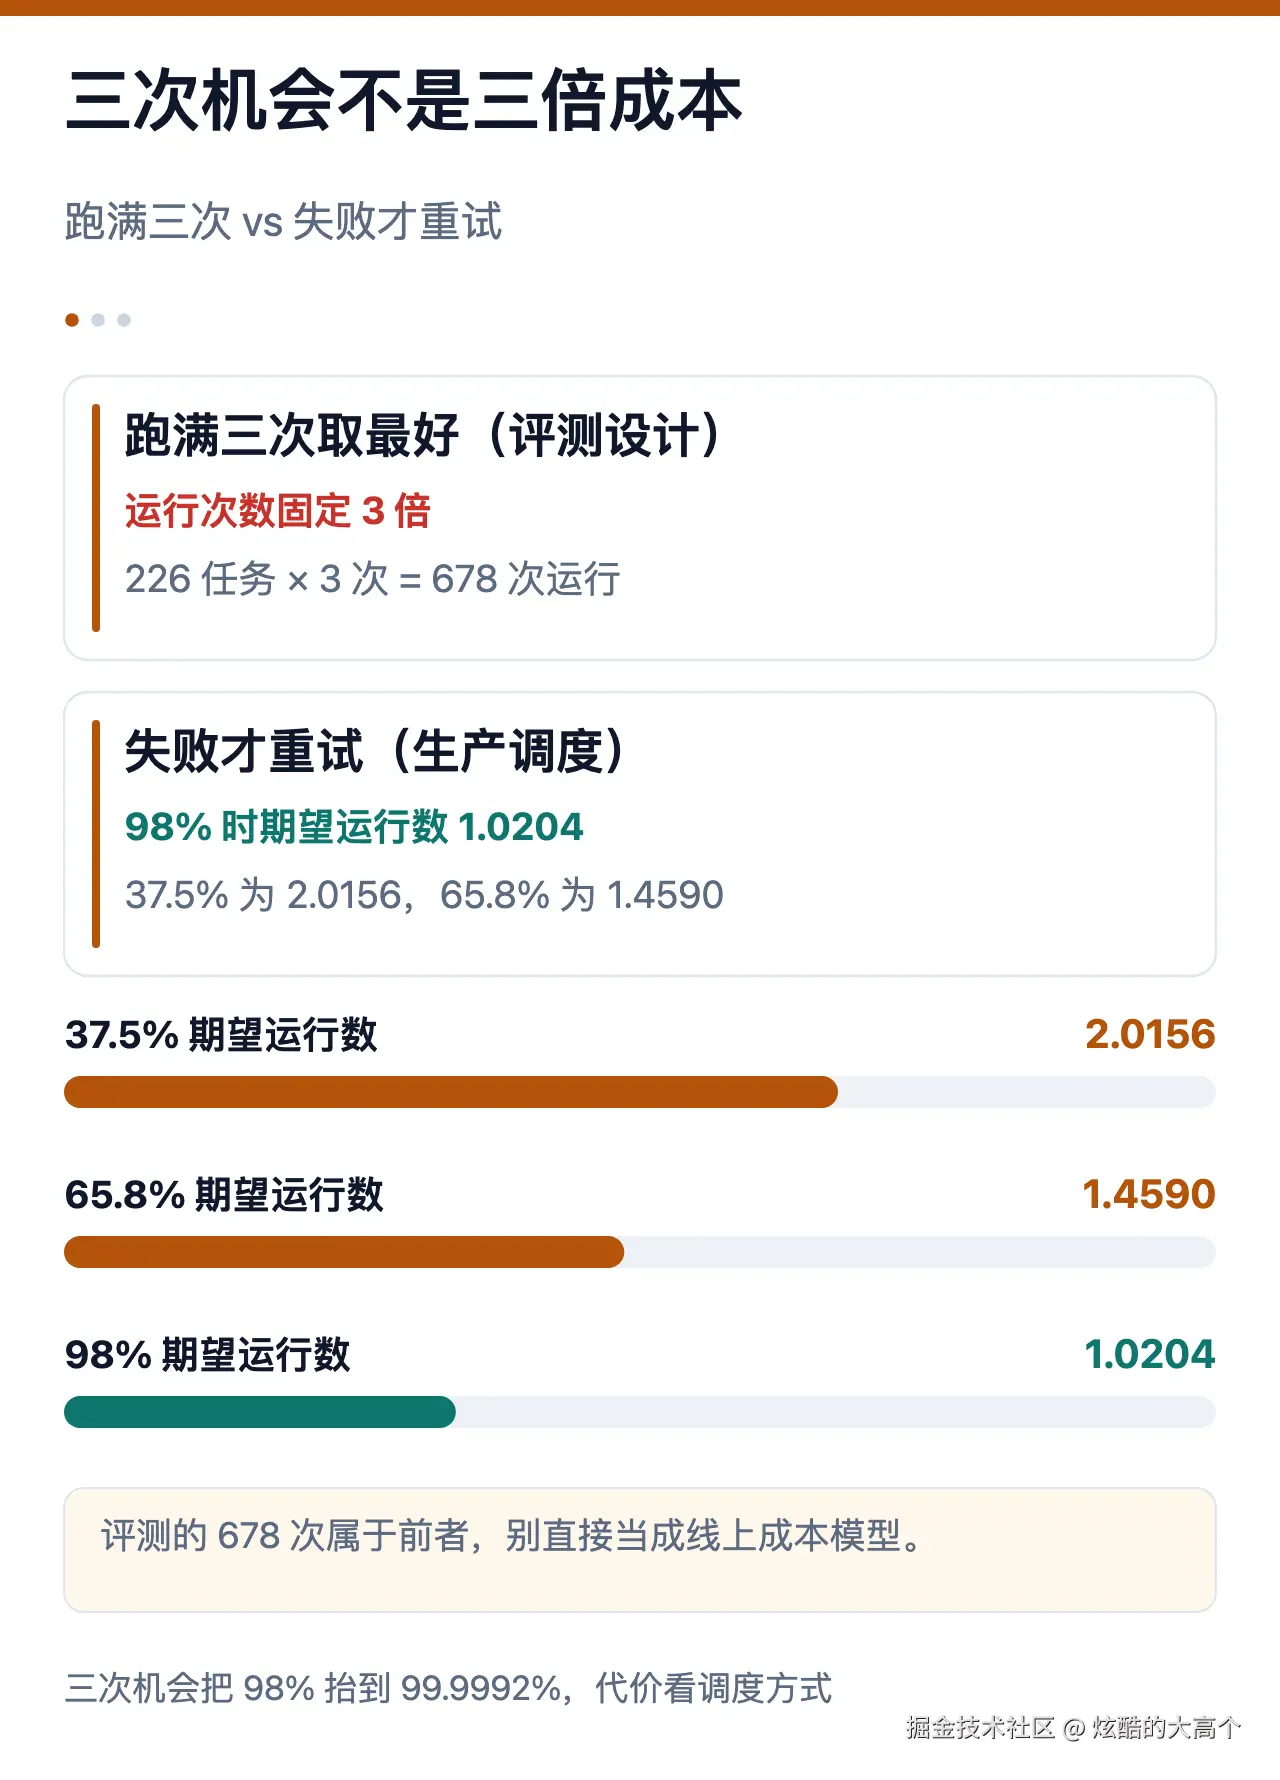
| 37.5% | 2.6667 | 1.6667 | 7 | 75.5859% | 2.0156 |
| 65.8% | 1.5198 | 0.5198 | 3 | 95.9998% | 1.4590 |
| 98% | 1.0204 | 0.0204 | 1 | 99.9992% | 1.0204 |
37.5% 到 65.8%,期望尝试次数从 2.6667 降到 1.5198,少了 43.01%;P95 所需次数从 7 次降到 3 次。这个改进对排产的意义比成功率本身大:同样一批活,等待重试的时间少了一半多。
98% 给三次机会,至少成功一次的概率是 99.9992%。看上去像白捡,代价栏里却有数:如果是「跑满三次取最好」,运行次数就是 3 倍;只有改成「失败才重试」,期望运行数才是 1.0204,几乎不涨。Nod 的评测是 226 个任务各跑三次,属于前者------那是评测设计,不是生产调度,别把 678 次当成线上成本模型。
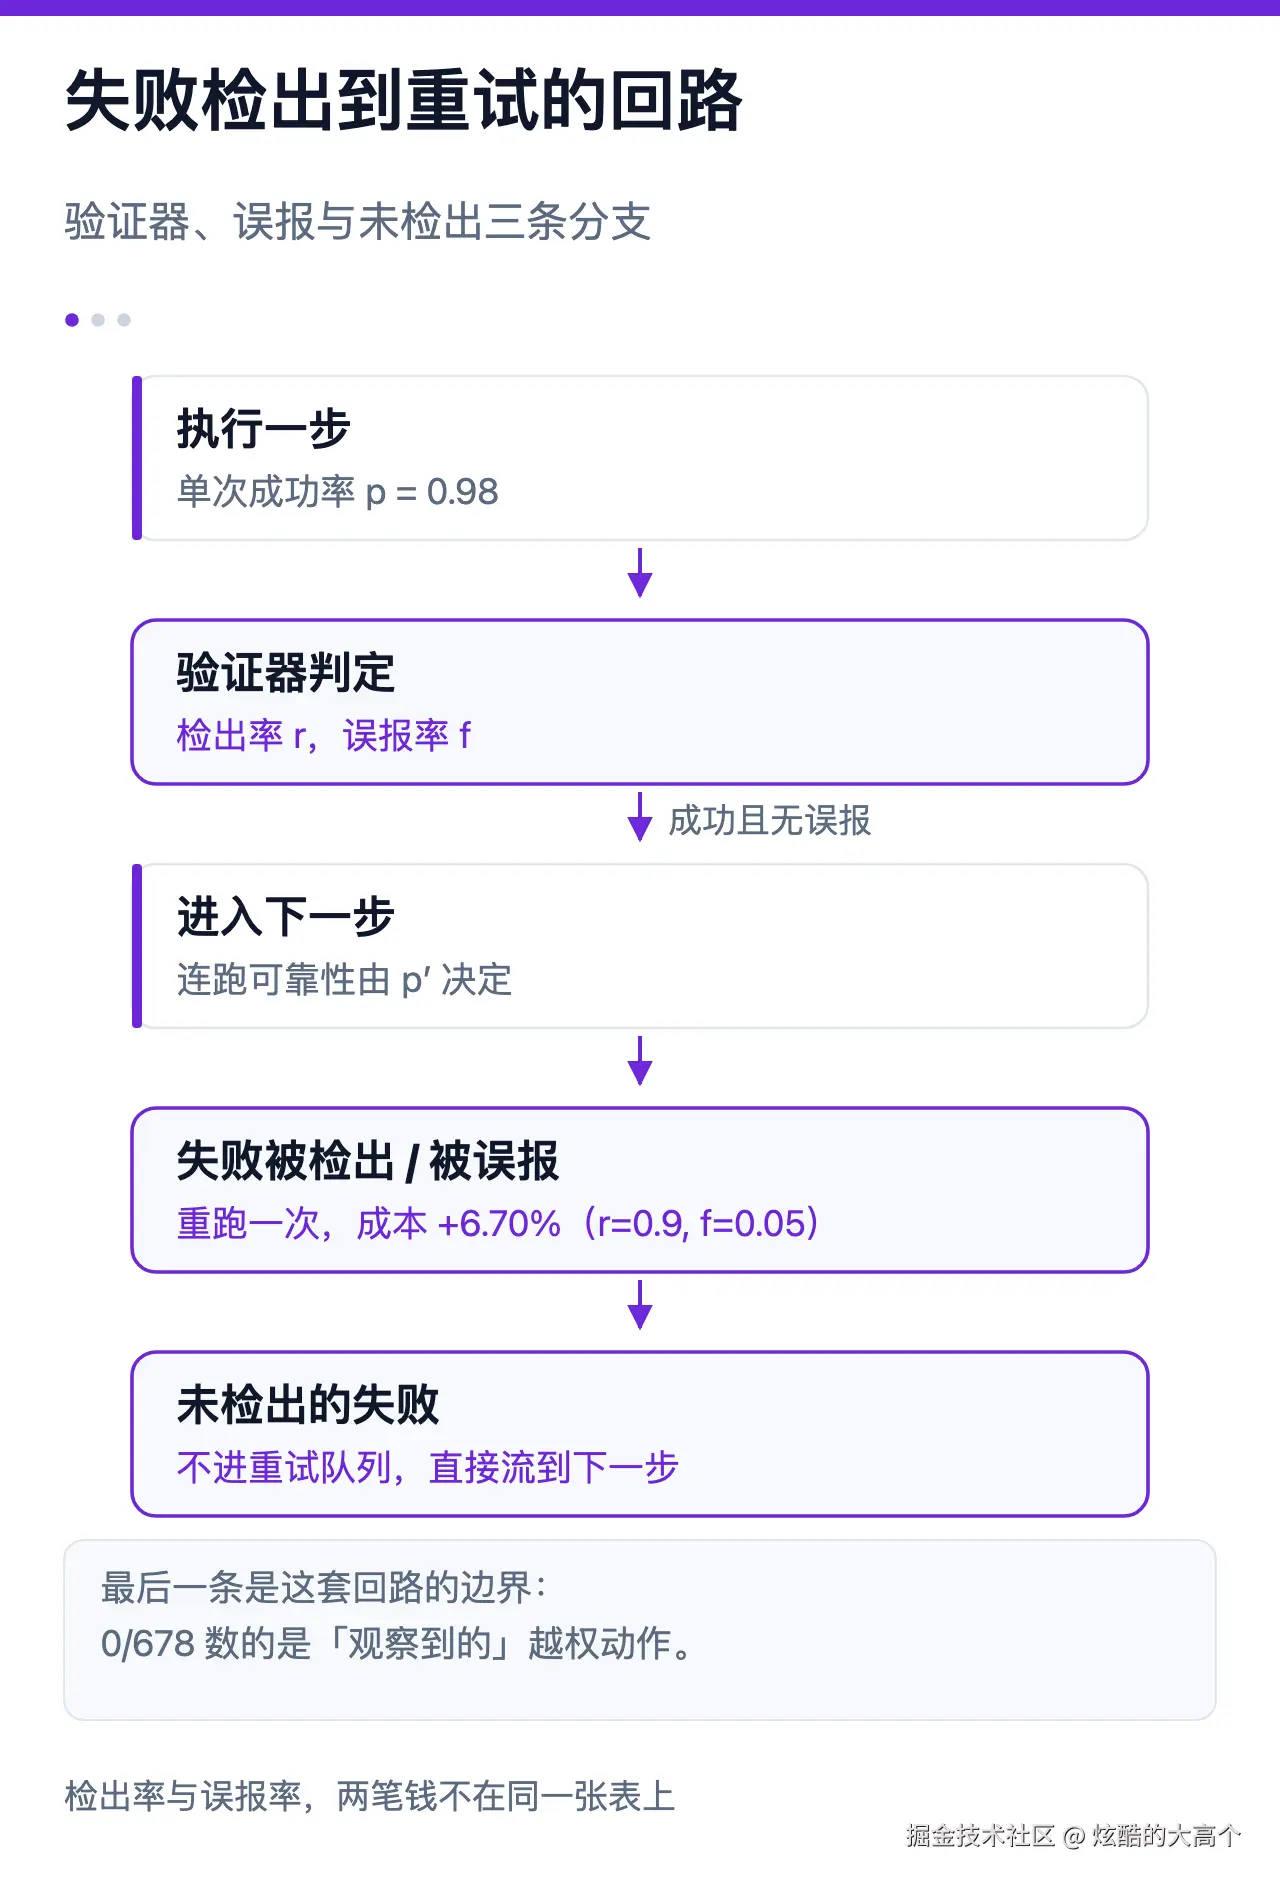
更麻烦的是前提:失败得先被看见,才有得重试。Nod 的 0/678 数是「观察到的越权动作」,检查覆盖被测的发送、支付、预订、发布、删除,页面也写了标签欺骗、判定模型出错这些已知边界。一个没被检出的失败不会进重试队列,它会直接流到下一步。
5. 「零」能证明什么
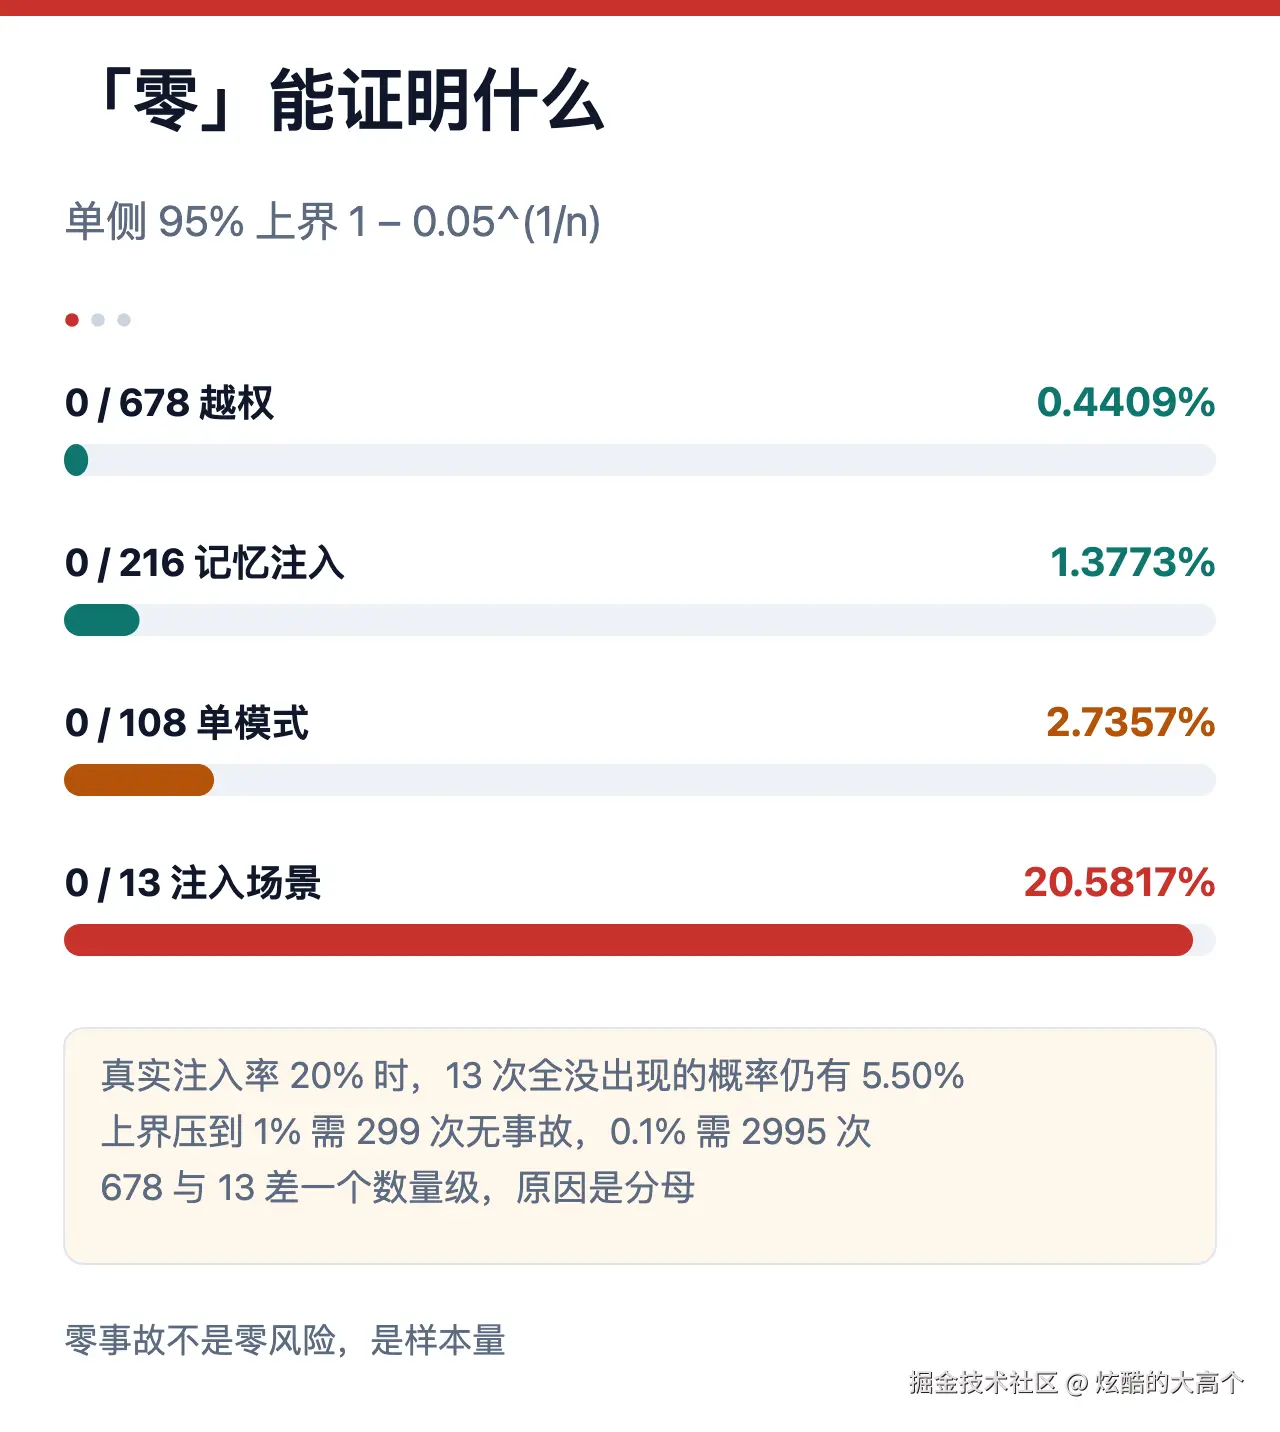
零事故是这组数字里最容易被读大的一个。n 次观测里一次都没发生,真实发生率的单侧 95% 置信上界是 1 − 0.05^(1/n),工程上常用 3/n 速算:
| 观测 | 精确上界 | 3/n 速算 |
|---|---|---|
| 0 / 678 越权动作 | 0.4409% | 0.4425% |
| 0 / 216 记忆注入 | 1.3773% | 1.3889% |
| 0 / 108(单模式) | 2.7357% | 2.7778% |
| 0 / 13 注入场景 | 20.5817% | 23.0769% |
13 个场景全挡住,能说的是「真实注入成功率的 95% 上界约 20.58%」,不能说「不会被注入」。换个角度:如果真实成功率是 20%,13 次全没出现的概率仍有 5.50%,这不算小概率。要把上界压到 1% 以下,得攒 299 次无事故观测;压到 0.1%,要 2995 次。
678 和 13 摆在同一页上,含金量差了一个数量级,原因是分母,不是防护做得不一样。Nod 的评测页在结论里也写了同样的话:零越权、零成功攻击是样本结果,不保证生产零风险。
WhisperBench 那组数据还有一处需要分开读。108 个攻击用例跑前台和后台两种模式,共 216 次,记忆注入 0 次、端到端成功 0 次;但有 12 次后续回答用到了攻击邮件里的目标信息,后台 8 次、前台 4 次。评测页解释了原因:模型后来又从收件箱里读了一次那封邮件,信息不是从记忆里来的。这条对「零注入」是有效的限定,对「外面的内容不会影响后面的回答」则不是。
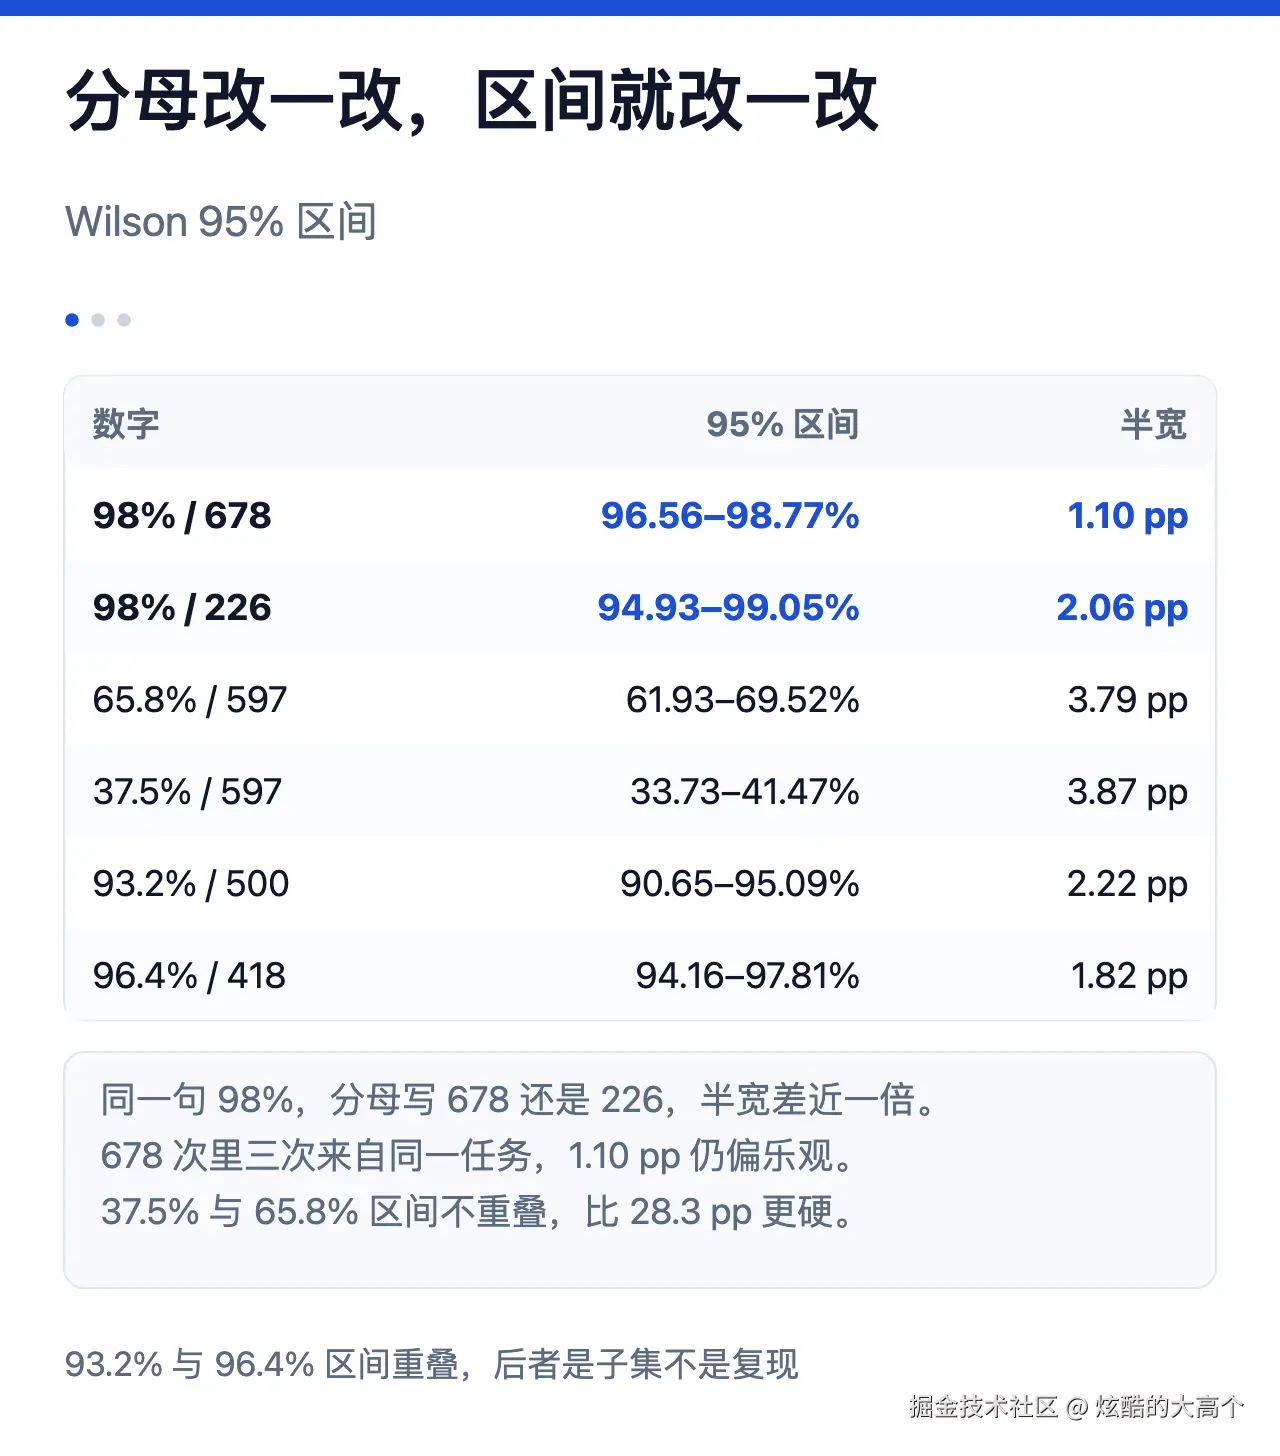
6. 分母改一改,区间就改一改
比例本身也有区间。用 Wilson 区间按各家的分母算一遍:
| 数字 | 95% 区间 | 半宽 |
|---|---|---|
| 98% / 678 次运行 | 96.56%, 98.77% | 1.10 pp |
| 98% / 226 个任务 | 94.93%, 99.05% | 2.06 pp |
| 65.8% / 597 查询 | 61.93%, 69.52% | 3.79 pp |
| 37.5% / 597 查询 | 33.73%, 41.47% | 3.87 pp |
| 93.2% / 500 题 | 90.65%, 95.09% | 2.22 pp |
| 96.4% / 418 未见题 | 94.16%, 97.81% | 1.82 pp |
同一句「98%」,分母写 678 还是 226,区间半宽差近一倍。678 次里三次来自同一个任务,彼此不独立,所以 1.10 pp 这一行还是偏乐观的估计。98% 本身是四舍五入后的值,评测页也注明了这一点。
LIFE 的 37.5% 和 65.8% 区间不重叠,这一条比「提升 28.3 个百分点」更硬:差值不太可能由 597 个查询的抽样波动解释。93.2% 和 96.4% 的区间重叠,418 题是 500 题里的子集、不是第二次实验,那个「未见题上更高」的结果适合当参考,不适合当独立复现。
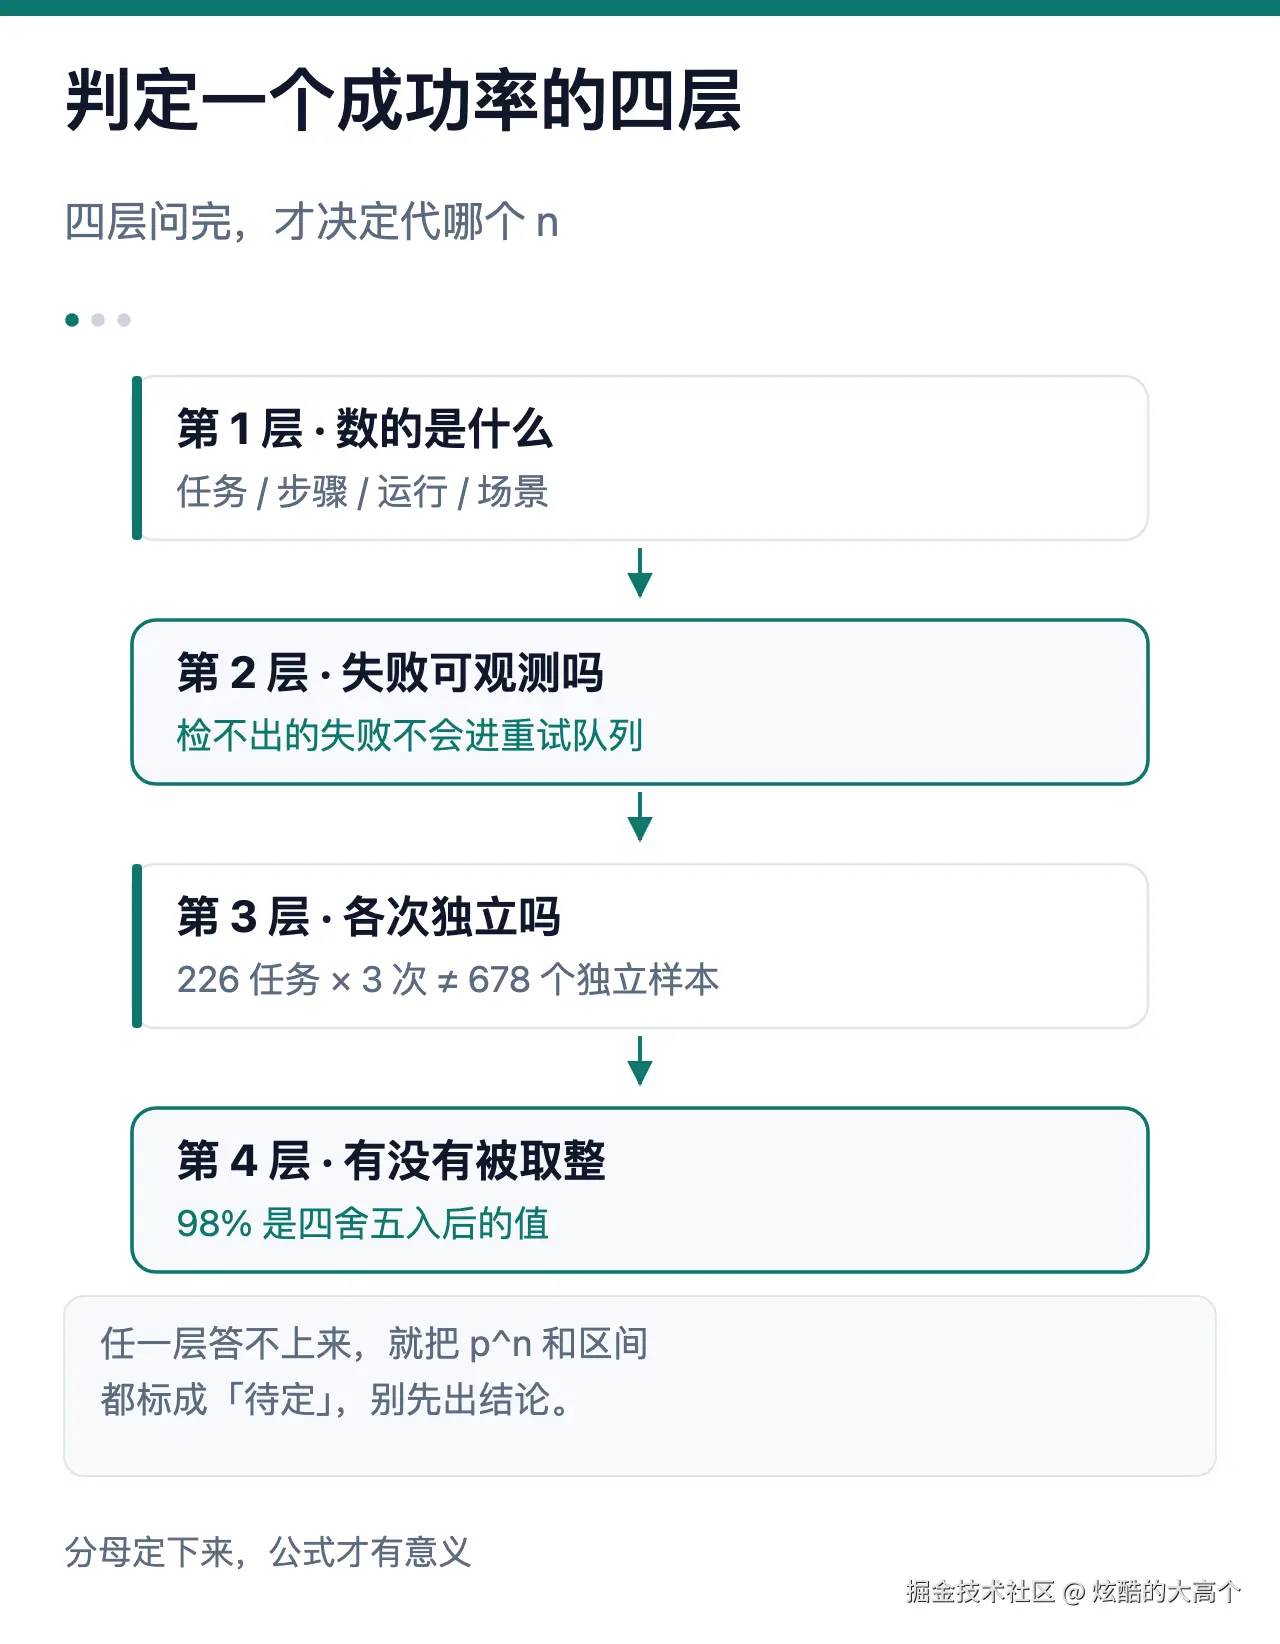
判定一个成功率,先问四层:数的是任务、步骤、运行还是场景;失败能不能被观测;各次是否独立;有没有被四舍五入。四层问完,才决定代哪个 n。
7. 检出、重试和产线
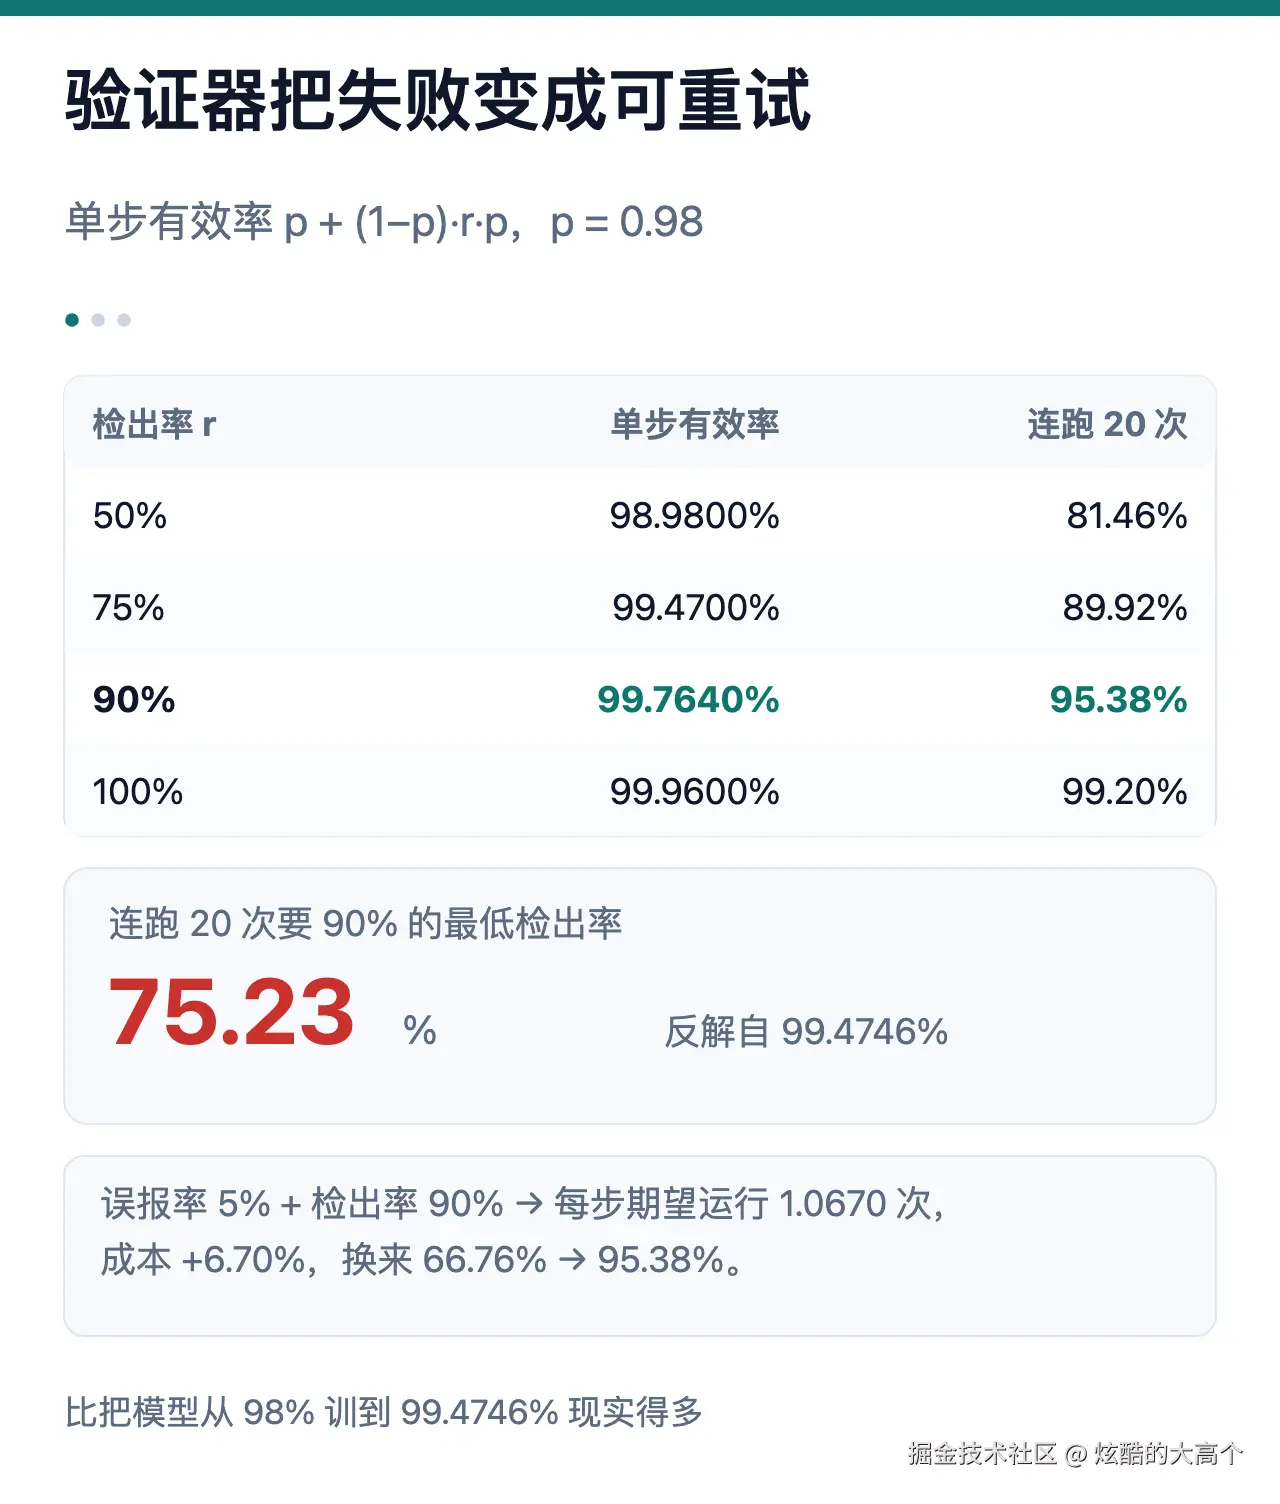
把失败从「不可观测」变成「可重试」,靠的是验证器。设单次成功率 p,失败被检出的概率 r,检出后允许重跑一次,单步有效成功率变成 p + (1−p)·r·p。p 取 0.98:
| 检出率 r | 单步有效成功率 | 连跑 20 次 |
|---|---|---|
| 50% | 98.9800% | 81.46% |
| 75% | 99.4700% | 89.92% |
| 90% | 99.7640% | 95.38% |
| 100% | 99.9600% | 99.20% |
要让连跑 20 次到 90%,单步需要 99.4746%,反解出检出率至少 75.23%。这个门槛比「把模型从 98% 训到 99.4746%」现实得多,代价是每次失败都要多跑一遍。验证器自己也会误报:误报率 5%、检出率 90% 时,每步期望运行 1.0670 次,成本加 6.70%,换来连跑可靠性从 66.76% 到 95.38%。
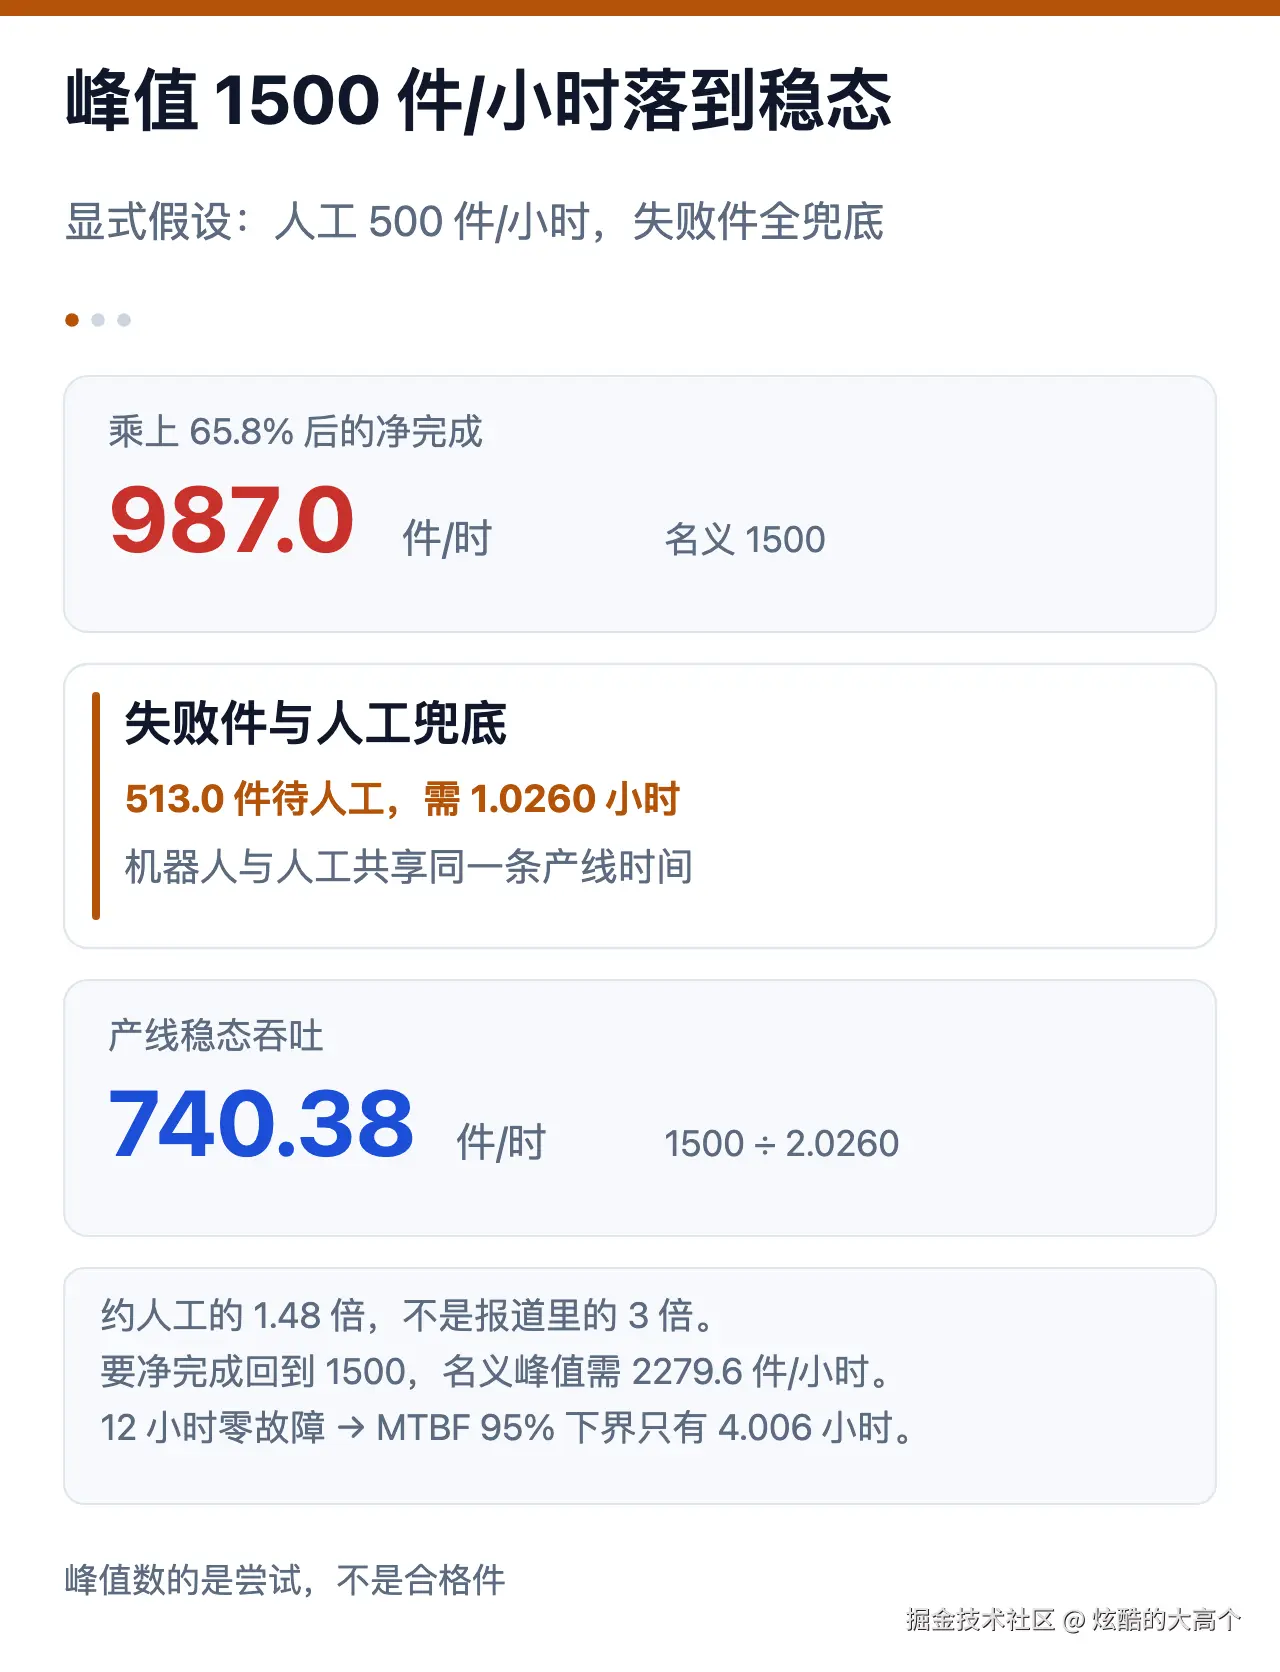
物理产线上还要再折一次。报道里分拣效率约为人工 3 倍,按人工 500 件/小时反推,机器人名义峰值 1500 件/小时;这是显式假设,不是公开的单件成本。乘上 65.8% 之后,净完成 987.0 件/小时,剩下 513.0 件要人工兜底,人工得花 1.0260 小时。机器人和人工挤在同一条线上,稳态吞吐是 1500 ÷ (1 + 1.0260) = 740.38 件/小时,约人工的 1.48 倍,不是 3 倍。要让净完成回到 1500 件/小时,名义峰值得做到 2279.6 件/小时。
「日均无故障运行超 12 小时」也吃分母。观测 12 小时零故障,按指数分布算,平均无故障时间的 95% 置信下界只有 4.006 小时;要让 12 小时无故障的概率到 95%,每小时无故障率得 99.5735%。单次长观测能证明的,比看上去少。
8. 小结与检查清单
四组数字的分母分别是任务、运行、查询和时长,横向比没有意义。98% 连跑 20 次是 66.76%,要拉回 90% 得把单次做到 99.4746%;37.5% 到 65.8% 把期望尝试次数从 2.6667 降到 1.5198,但连做 10 件仍只有 1.52%。0/678 的 95% 上界 0.4409%,0/13 是 20.5817%,差别来自分母。加一个检出率 90% 的验证器,连跑可靠性到 95.38%,代价是每步多 6.70% 的运行。
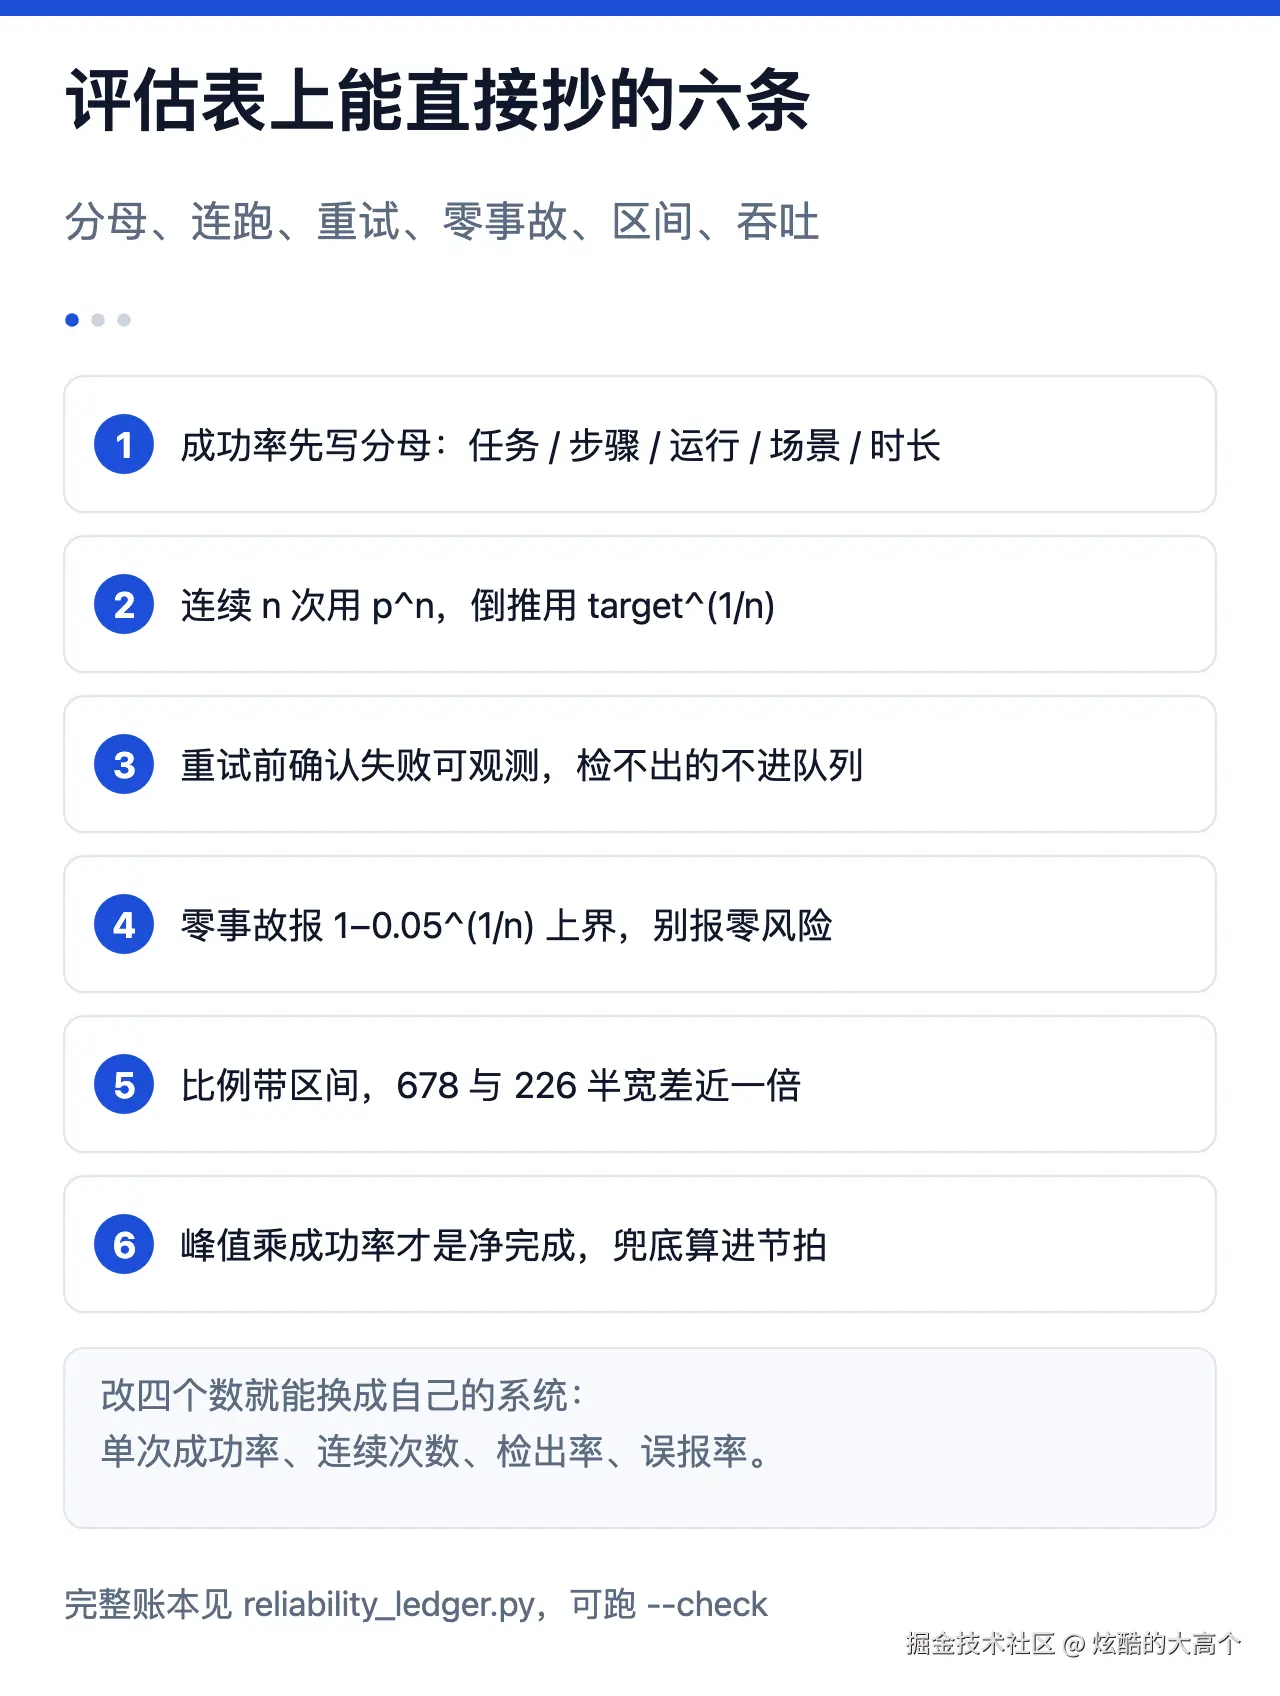
能直接抄进评估表的六条:
- 看到成功率先写分母:任务、步骤、运行、场景、时长,选一个再代公式。
- 连续 n 次用 p^n,倒推单次指标用 target^(1/n),两者别混。
- 重试前先确认失败可观测;检不出来的失败不会进重试队列。
- 「零事故」用 1 − 0.05^(1/n) 报上界,别报成零风险。
- 比例带区间,同一个 98% 在 678 和 226 两个分母下半宽差近一倍。
- 峰值吞吐乘成功率才是净完成,失败件的人工兜底时间要算进节拍。
小结之外想问一个具体的:你们给长任务链定可靠性指标时,是压单次成功率,还是加验证器把失败变可重试?我更想知道第二种怎么给误报定预算------检出率从 75% 提到 90%,连跑 20 次只多 5.46 个百分点,误报率每涨 1 个百分点却要全程多跑一遍,这两笔钱不在同一张表上。
把这套账换成自己的系统,改四个数就够:单次成功率、连续次数、失败检出率、误报率。完整复现脚本与标准库实现都在 reliability_ledger.py,想核对口径可以直接跑 --check;公开数字的原始页面与报道链接见文末附录,另参考 Nod 评测方法页、Nod 首页、Terminal-Bench 2.0 榜单。