上一篇讲了模型接入。这一篇继续处理接入之后的问题:从用户开口,到助手执行工具、返回答案,再到下一轮追问,中间需要哪些环节。
文章先讲通用机制,再对照框架与模型接口,最后回到我们自己的实现 Mina,说明每个选择的依据。
背景:先选实时语音路线,再看能否落地
我们要做一个能参与会议的助手,支持自然接话、等待补充、接受打断,以及查询日历和调用业务工具。选模型时,需要同时看两类能力:
- 语音交互:听懂输入、控制接话时机,并持续生成自然的语音。
- 业务执行:生成可靠的调用参数,让应用完成查询,再根据结果继续回答。
语音榜单为什么让我们优先看 Realtime
我们参考 Speech-to-Speech 榜单,评估模型的语音对话能力。Artificial Analysis 将语音推理、交互节奏、Agent 任务表现和响应速度分别展示。
截至 2026 年 11 月 14 日,StepAudio 3 Realtime 与 Qwen Audio 3.0 Realtime Plus 位于语音推理和交互节奏前列。这支持我们优先考察面向语音输入输出的原生实时模型 。各榜单分别衡量特定能力,具体业务效果还需要用场景样本验证。Artificial Analysis Speech-to-Speech 榜单
| 我们关心的能力 | 对应的评测信息 | 对会议助手的意义 |
|---|---|---|
| 听懂并回答 | 语音推理 | 查询条件能否理解正确 |
| 自然接话 | 交互节奏、停顿与打断 | 是否容易抢答或误打断 |
| 完成业务 | Agent 任务表现 | 工具调用能否推进任务 |
| 等待与成本 | 首音延迟、调用价格 | 能否持续用于实际对话 |
原生实时路线让模型直接处理声音。另一条常见路线是级联:分别经过语音识别、文本模型和语音合成,适合需要独立选择这些组件的系统。两种路线都可以流式运行;本文沿原生 Realtime 路线展开。
国内选型还要区分 App 体验与 API 版本
豆包 App 已上线的音视频全双工模型叫 SeedRealtime ,我本来是想用豆包对应的模型,我期望的是我们的语音对话体验可以达到豆包的水准,但是目前此模型还没公开。它与火山引擎公开文档中的 Seeduplex(实时语音模型 3.0) 需要分别看待。SeedRealtime 官方介绍
| 对象 | 本次能确认的接入信息 |
|---|---|
| SeedRealtime | 官方介绍和模型目录提供豆包 App 体验入口;本次未确认到可直接等同于 App 新版本能力的公开 API 入口 |
| Seeduplex | 火山引擎已有公开 API 文档和工具调用协议,本文按 session.model=1.2.6.1 讲解 |
| Qwen-Omni-Realtime | 百炼提供公开接入与事件文档,本文以 qwen3.8-omni-flash-realtime 的 WebSocket Function Calling 路径为例 |
API 的开放范围需要单独确认。 公开文档中还出现了 Doubao-Seed-Realtime-1.0 的说明;它是否对应 App 同一版本,本次尚未确认。选型时应以实际可开通的接口和能力为准。
因此,我们的选型顺序是:先用语音评测筛选路线,再用实际可接入性和工具控制能力确定落地方案。文末再说明这些条件怎样落到 Mina。
从一次唤醒进入两轮对话
先用一段示意对话说明我们要完成的交互。以下会议信息为示例。
用户: 小助手,查一下今天的会议......下午最近的一场。
助手: 下午三点有一场项目评审。
用户: 都有谁参加?
助手: 我查一下这场会议的参会名单。
这段对话需要处理以下几个环节:
- 唤醒:识别"小助手",确认用户正在向助手发起请求。
- 轮次判断:用户说完"今天的会议"后停了一下,需要等"下午最近的一场"补充完整,再开始回答。
- 工具调用:根据用户给出的条件查询日历,拿到真实的会议安排。
- 多轮衔接:用户追问"都有谁参加"时,关联上一轮查到的会议,继续查询参会名单。
这些环节由应用和模型配合完成:
- 应用负责接收音频、控制交互流程、执行工具。
- 模型负责理解用户的意思、生成工具调用请求,并根据结果回答。
下面按一轮对话的处理顺序展开。实际运行时,音频采集、传输和检测会同时进行。
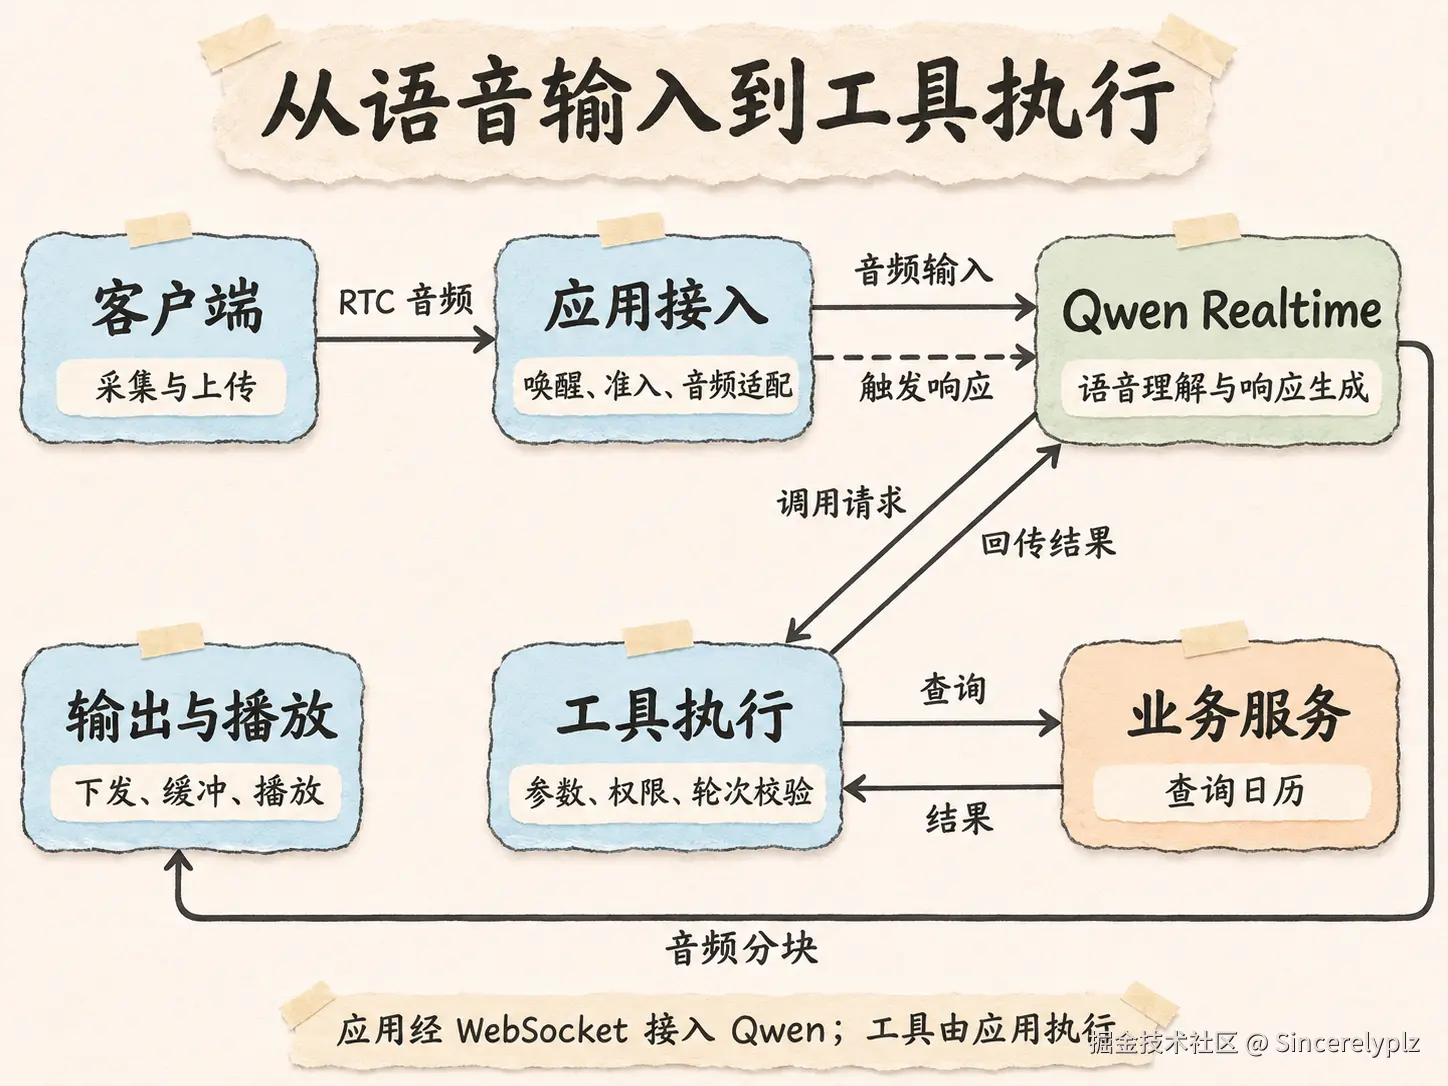
虚线表示应用触发响应;实线表示音频或工具数据。
这里先分清框架、模型和应用的职责:
| 层次 | 典型对象 | 负责什么 |
|---|---|---|
| 编排框架 | Pipecat、LiveKit Agents、TEN Framework | 组织音频、模型服务、工具及控制事件 |
| 实时模型服务 | Qwen Realtime、OpenAI Realtime、豆包 Seeduplex | 理解音频、生成工具请求与回答 |
| 业务应用 | 使用上述能力构建的会议助手等产品 | 决定交互规则、业务权限和实际工具实现 |
Pipecat 用 Frame 与 Processor 组织处理管线;LiveKit Agents 通过 AgentSession 管理会话;TEN Framework 用 Extension 与 Graph 组合处理能力。它们与模型服务处于不同层次。
LiveKit 的音视频传输也能单独供 Pipecat 使用,传输层与 Agent 框架可以分别选择。
唤醒:先确认这句话是在叫助手
会议中一直有人说话。助手如果对每句话都回应,很快就会打断正常讨论。唤醒的作用,就是给交互一个明确的入口。
说"小助手"是一种入口,点击语音按钮、按快捷键也是。后两种由用户直接启动;采用唤醒词时,系统需要从持续输入的声音里找到约定的名字。
常见的检测方法有两种:
- 直接检测声音里的关键词。 这类方法叫 KWS(Keyword Spotting),使用专门的模型识别唤醒词,无需等整句话转写完成。
- 先转写,再匹配文字。 复用已有的语音识别链路,在结果里寻找名字或短语,启动时间也会受转写速度影响。
除了检测方法,还要区分检测器运行的位置:
- 客户端检测:可以先判断是否唤醒,再连接后端。
- 服务端检测:声音已经经过网络传输,检测器再决定是否进入后续交互。
唤醒时,首句往往已经开始了
用户通常会连着说"小助手,查一下今天的会议",不会特意等系统准备好。检测器确认命中需要时间,这期间的"查一下"也必须保留下来。
采用唤醒词时,可以通过音频缓存保住首句:
- 检测期间,持续缓存近期音频。
- 唤醒命中后,补送检测期间已经说出的部分。
- 补送完成后,接上后续实时输入。
调试时,除了确认名字能被识别,还要检查"唤醒词 + 连续指令"是否丢字。
几个常见入口的区别可以放在一起看:
| 实现 | 如何进入交互 |
|---|---|
Pipecat WakePhraseUserTurnStartStrategy |
在最终转写里匹配短语,命中后开启交互窗口 |
LiveKit livekit-wakeword |
在客户端运行 ONNX 唤醒词模型,官方示例在命中后连接房间 |
| Codex Voice | 公开文档确认按钮与配置的快捷键入口,内部检测模型未披露 |
会话准备:让后续输入有明确的归属
"小助手"被识别出来以后,系统要记住是谁在发起请求。否则旁边的人接了一句话,也可能被拼进"查会议"的指令里。
会话准备包含两方面工作:
- 确定交互归属:将本次交互绑定到发言人,并保留一个有效窗口。同一人在窗口内可以继续说;换人发起请求时,再按接入规则更新归属。
- 准备模型连接 :配置音频格式、助手指令和可用工具。Qwen 通过
session.update更新这些内容。
连接和工具目录可以提前准备,唤醒后再补充当前用户的业务上下文,减少首轮等待。发言准入决定哪些声音进入对话,业务权限决定能访问哪些数据,查询日历时仍需单独校验权限。
确定发言人、准备好模型会话后,就可以持续向模型发送音频。
音频输入:边说边传,避免在队列里等
一段音频从麦克风到模型,经过以下处理:
- 采集与预处理:客户端采集声音,按接入配置做回声消除和降噪。
- 传输到 Agent:通过 RTC 发送音频。
- 适配与上传:Agent 将音频转换成模型要求的格式,分块上传。
处理按音频块持续推进。用户还在说"下午最近的一场"时,前面的声音已经可以到达模型。
这里最容易混淆的是音频格式。RTC 的媒体编码与模型接口接受的格式可能不同,中间需要解码或重采样。以本文的 Qwen WebSocket 配置为例,输入采用 16 kHz 单声道 PCM,通过 input_audio_buffer.append 持续发送;输出采用 24 kHz PCM。
让这条输入链路保持流畅,主要看两件事:
- 分块是否合适。 音频攒得太多再发,会增加等待;块太小,则会增加消息和调度开销。
- 消费能否跟上采集。 音频回调里如果同步等待业务查询,后面的声音就会积压。此时只改分块大小,解决不了队列堵塞。
分块是传输单位,一句话通常跨过很多个块。判断用户何时说完,需要继续观察声音本身。
VAD:发现用户开始说话和停下来
用户说到"今天的会议"时停了一下。系统首先能观察到的是:刚才有语音,现在安静了。
VAD,也就是语音活动检测,负责发现这种变化。它持续区分语音与非语音,产生开始发声、停止发声等信号。为避免短促噪声造成反复切换,检测器通常会观察连续一段音频,再确认状态变化。
静音观察时间会影响检测结果:
- 时间短:反应快,但容易被短暂停顿触发。
- 时间长:边界更稳定,等待也会增加。
Qwen 提供服务端 VAD;TEN VAD 则是可以自行接入的语音活动检测组件。它们在这个阶段提供的是停声信号;用户是否已经表达完整,留给下一步判断。
轮次结束:给补充条件留出时间
如果系统在"今天的会议"后立刻开始查询,"下午最近的一场"就赶不上这一轮了。用户明明只说了一个请求,助手却提前回答,甚至把补充条件当成新问题。
语音里的停顿,可能只是用户在组织后半句话。 轮次结束检测要判断的,就是这个停顿是否意味着用户已经交出话语权。
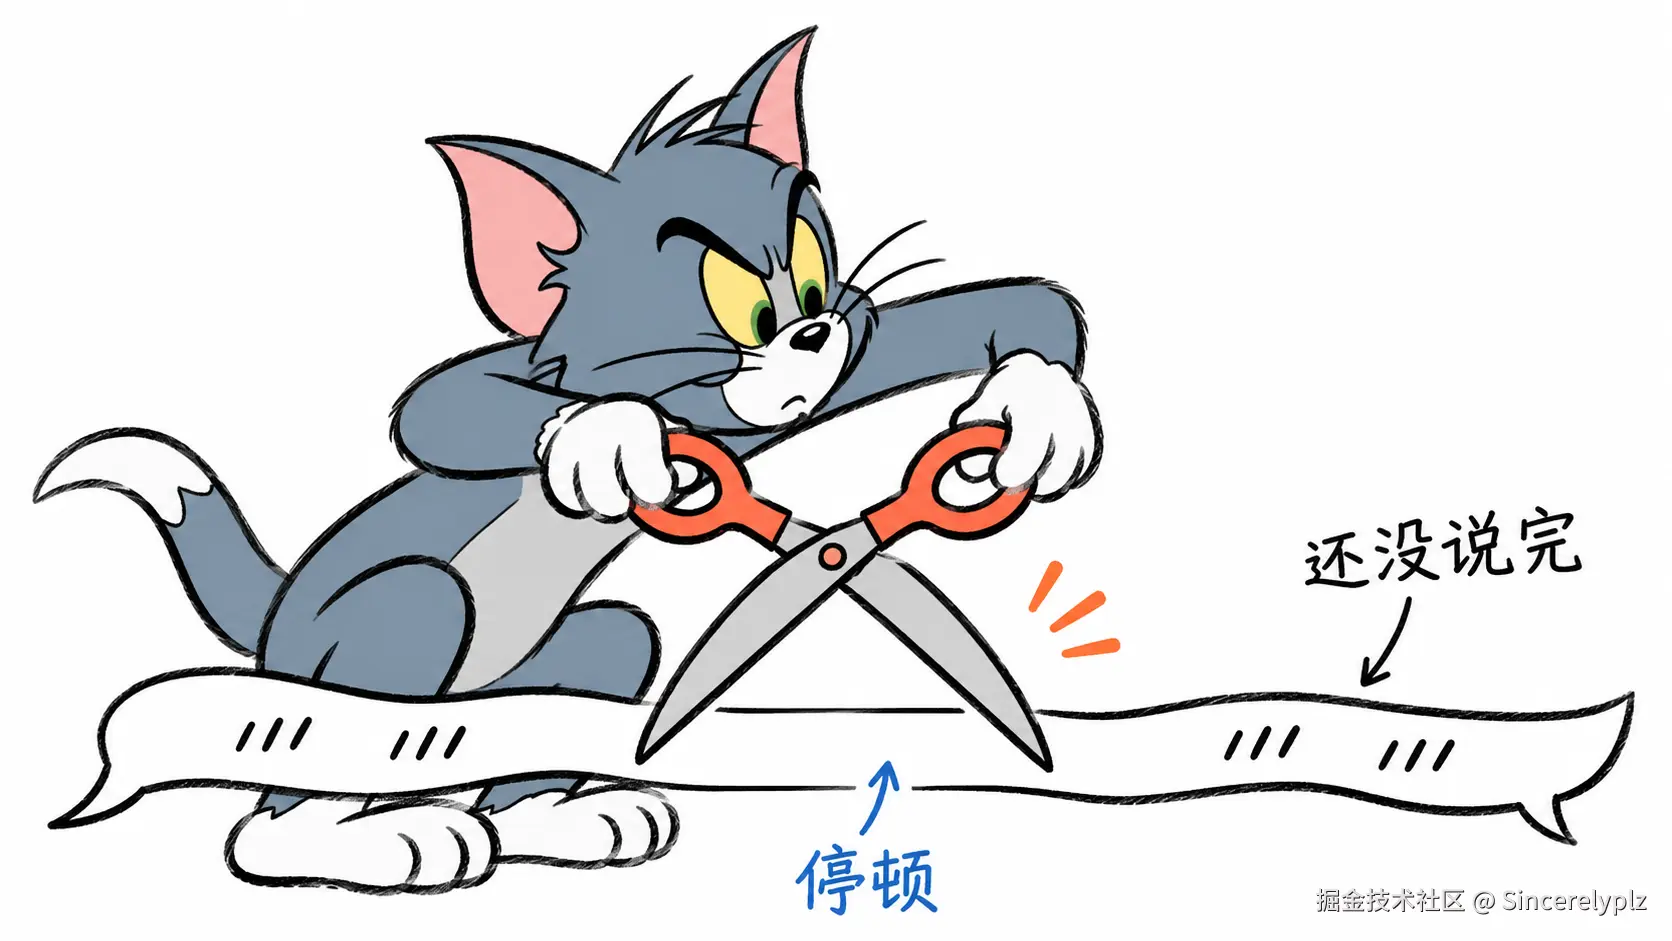
在停顿处过早提交这一轮,会漏掉后续补充条件。
最直接的做法是等一个静音窗口。超过设定时长仍没有新声音,就认为这一轮结束。它容易实现,但对所有停顿采用同一标准:窗口缩短会更容易抢答,拉长又会让每次正常回答都慢一点。
为了区分这些情况,可以引入专门的轮次模型:
- 文本轮次模型:根据转写内容判断表达是否完整,需要等待可用的转写结果。
- 音频轮次模型:直接利用音频中的内容、语调和节奏等信号,需要音频上下文和模型推理。
| 实现 | 用什么判断 |
|---|---|
| TEN Turn Detection | 根据文本输出 finished、unfinished 或 wait;wait 对应用户明确要求等待 |
| Pipecat Smart Turn | 直接处理音频,结合内容与韵律判断是否结束 |
| LiveKit 轮次检测器 | 提供音频和文本两种路线,音频路线可用于不额外接入语音识别的 Realtime 场景 |
可以由应用接入这些检测器,也可以沿用 Realtime 服务自带的策略。最终触发回答的责任要明确:两边都自动触发,可能重复回应;两边依次等待,则会增加延迟。
外接轮次模型前,需要确认供应商的控制能力:
- 能否关闭内置的自动响应或轮次策略。
- 能否由应用手动提交输入、触发响应。
Smart Turn 与 TEN:准确率之外,还要看接入成本
两者的计算规模差别很大:Smart Turn V3.2 基于 Whisper Tiny,约 800 万参数,INT8 权重约 8 MB;TEN Turn Detection 基于 Qwen2.5-7B,语音输入还需先经过 ASR。
2025 年的 Easy Turn 论文在同一测试集、单张 RTX 4090 上比较过两条路线:
| 指标 | Smart Turn V2 | Paraformer ASR + TEN |
|---|---|---|
| 完整表达识别准确率 | 78.67% | 86.67% |
| 未完整表达识别准确率 | 62.00% | 89.30% |
| 平均推理耗时 | 27 ms | 204 ms |
| 显存占用 | 370 MB | 15,419 MB |
测试集共 800 条,真实录音与合成语音各占一半。表中使用旧版 Smart Turn V2,耗时统计范围为被测方案的推理过程。 用户停声到听见回答还会经过收句、回答生成和播放等环节。这组数据说明了该评测下的准确率与计算成本取舍;当前版本的比较需要另做同条件测试。论文表 2 与实验设置
作为当前版本参考,Smart Turn V3.2 CPU 版在官方 31,527 条样本上的准确率为 92.63%,其中 929 条中文样本为 85.79%。这组数据与上表来自不同测试集,应分别看待。官方评测报告
落到中文会议场景,选择时更值得比较的是:在相同抢答率下要等多久,或在相同等待时间下会抢答多少次。
上下文与响应:把完整请求交给模型
用户终于说完了:
查一下今天的会议,下午最近的一场。
要处理这句话,应用需要补齐日期、时区和业务身份等背景。
这一轮交给模型的信息可以分成几部分:
- 当前请求:用户刚说出的查询条件。
- 业务背景:当前日期、时区和业务身份相关的上下文。
- 对话历史:理解本轮输入时需要延续的内容。
- 工具说明:本轮可用的工具及参数。
当前没有用到的会议历史和业务工具,可以先不加入。这样模型要处理的内容更集中,工具之间也更容易区分。
以应用控制响应的接法为例,可以保留 Qwen 服务端 VAD,关闭自动响应,将回应时机交给应用:
- 接收检测事件,完成轮次判断。
- 确认输入属于当前发言人,且这一轮可以回应。
- 发送
response.create,请求模型生成响应。
Realtime 在接收音频时已经可以处理输入,这里说的是生成响应的触发点。接下来,模型可以直接回答,也可以提出工具调用。日历内容需要从业务系统获取,我们的例子会走向后者。
工具执行:把查询意图变成一次业务调用
真实的会议安排需要查询日历服务。应用先在会话中提供工具描述,例如查询最近会议需要日期、时间范围和时区。模型据此生成调用请求,应用再执行查询。
先声明工具,再处理调用
工具声明包含名称、用途和参数结构。以 Qwen 为例,下面是 session.update 中的工具配置片段,省略了音频等其他会话参数:
json
{
  "type": "session.update",
  "session": {
    "tools": [{
      "type": "function",
      "function": {
        "name": "get_next_meeting",
        "description": "查询指定日期和时间范围内最近的一场会议",
        "parameters": {
          "type": "object",
          "properties": {
            "date": {"type": "string", "description": "日期,格式 YYYY-MM-DD"},
            "period": {"type": "string", "enum": ["morning", "afternoon"]},
            "timezone": {"type": "string"}
          },
          "required": ["date", "period", "timezone"]
        }
      }
    }]
  }
}
三家的函数定义结构如下,适配时需要分别封装:
| 服务 | tools 中的自定义函数结构 |
|---|---|
| Qwen | type=function,名称、描述和参数放在嵌套的 function 对象里 |
| OpenAI Realtime | type=function,name、description、parameters 与 type 同级 |
| 豆包 Seeduplex | 公开示例采用 type=function,名称、描述和参数同级 |
本节和后面的时序图围绕应用执行的 Function Calling 展开。供应商托管的远程 MCP 工具则由服务端执行。
收到请求后,由应用执行
Qwen 用 response.function_call_arguments.done 交付完整参数。下面省略了其他元数据,工具名与参数为本文示例:
json
{
  "type": "response.function_call_arguments.done",
  "name": "get_next_meeting",
  "call_id": "call_example",
  "arguments": "{\"date\":\"2026-11-14\",\"period\":\"afternoon\",\"timezone\":\"Asia/Shanghai\"}"
}
这份请求相当于模型说:"请帮我执行这个查询。"应用收到后,按顺序完成以下处理:
- 解析参数:检查日期、时间范围等字段是否合法。
- 校验执行条件:从可信业务会话取得身份与权限,并确认请求仍属于有效轮次。
- 执行查询:调用日历服务,获得结果或错误。
- 准备回传 :保留调用标识
call_id,关联本次结果。
模型负责提出调用,应用负责决定能否执行并完成执行。 Pipecat 和 LiveKit Agents 都提供了工具接入方式,业务权限仍需要在实际执行处落实。
示例只用一个工具就能查到会议。涉及多个工具时,按依赖关系安排执行:
- 有依赖,串行执行:先得到会议 ID,再查这场会议的参会人。
- 无依赖,可以并行:分别查询两个互不依赖的日历。
工具执行很久时,先返回明确的任务状态
查一次日历通常可以在本轮完成。较长的业务可以交给后台任务,前台先反馈"已受理"。用户追问进度时,通过任务 ID 查询同一个任务,避免重复发起。
应用需要保留任务 ID,并将执行状态明确返回给模型:
| 状态 | 含义与处理 |
|---|---|
| 已受理 | 任务已接收,后续通过同一个任务 ID 查询进度 |
| 已完成 | 已获得确定结果,可以向用户报告完成 |
| 失败 | 返回失败原因,供模型说明情况或安排后续处理 |
| 结果未知 | 写操作已提交但缺少可靠回执,先查询状态,再结合幂等机制决定是否重试 |
结果回传与续答:让模型根据查询结果回答
日历服务返回了下午三点的项目评审。查询虽然已经完成,用户还没听到答案。应用要把这条记录交回模型,模型才能把它组织成一句自然的回复。
Qwen:回传结果,再显式触发续答
回传结果中有两种不同用途的标识:
- 调用标识
call_id:关联刚才的工具请求与这份结果。 - 会议标识
event_id:标识业务中的真实会议,供后续查询参会人等操作使用。
json
{
  "type": "conversation.item.create",
  "item": {
    "type": "function_call_output",
    "call_id": "call_example",
    "output": "{\"status\":\"ok\",\"event_id\":\"evt_example\",\"title\":\"项目评审\",\"start_at\":\"2026-11-14T15:00:00+08:00\"}"
  }
}
Qwen 的原生工具续答分两步完成:
- 回传结果 :发送
conversation.item.create,将业务数据写回会话,并关联原call_id。 - 请求续答 :发送
response.create,让模型基于结果继续生成。
如果信息仍不够,模型也可能再次请求工具。
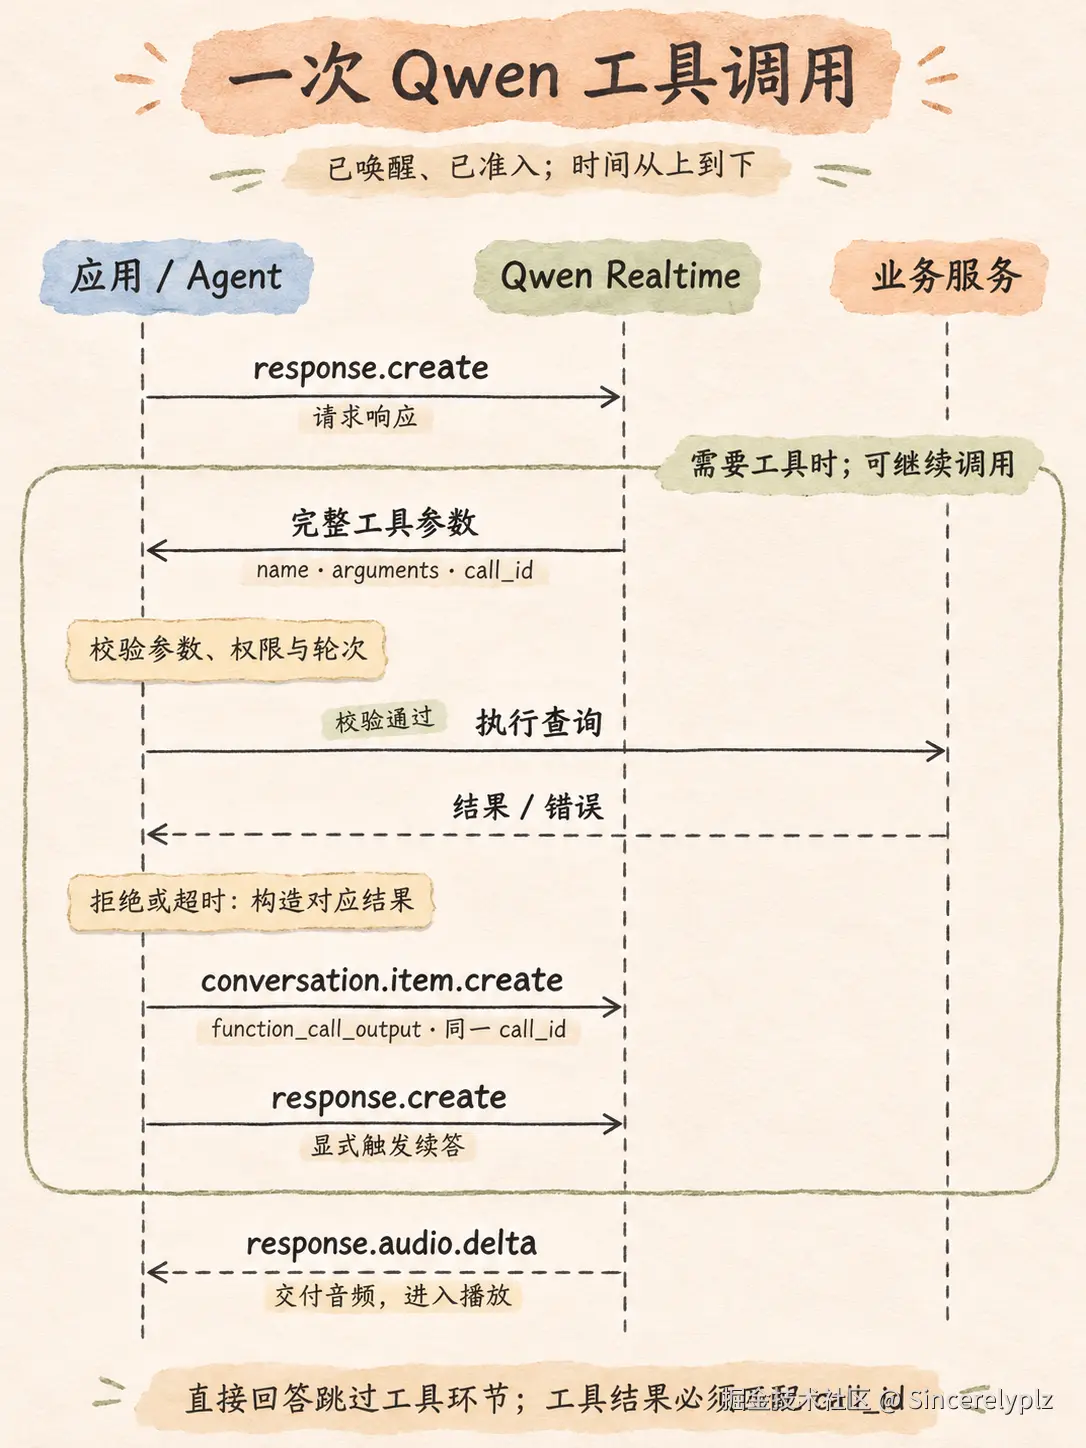
校验通过才调用业务服务;拒绝和超时也要生成对应结果。
豆包 Seeduplex:收齐这一批结果后自动续答
这里使用公开 JSON 协议的 session.model=1.2.6.1。应用在 session.update.tools 中声明函数,随后按以下链路处理:
- 接收
response.function_call_arguments.done,逐项读取items中的调用及call_id。 - 校验并执行工具,分别保存每个调用的结果。
- 聚合该批结果,通过
conversation.item.create回传。 - 服务端收齐结果后继续生成回答,这条路径无需另发
response.create。
豆包的回传项使用 role=tool 和 content,与 Qwen 的 function_call_output 结构不同。下面是一个调用的结果示例:
json
{
  "type": "conversation.item.create",
  "items": [{
    "role": "tool",
    "call_id": "call_example",
    "content": [{
      "type": "input_text",
      "text": "{\"status\":\"ok\",\"event_id\":\"evt_example\",\"title\":\"项目评审\",\"start_at\":\"2026-11-14T15:00:00+08:00\"}"
    }]
  }]
}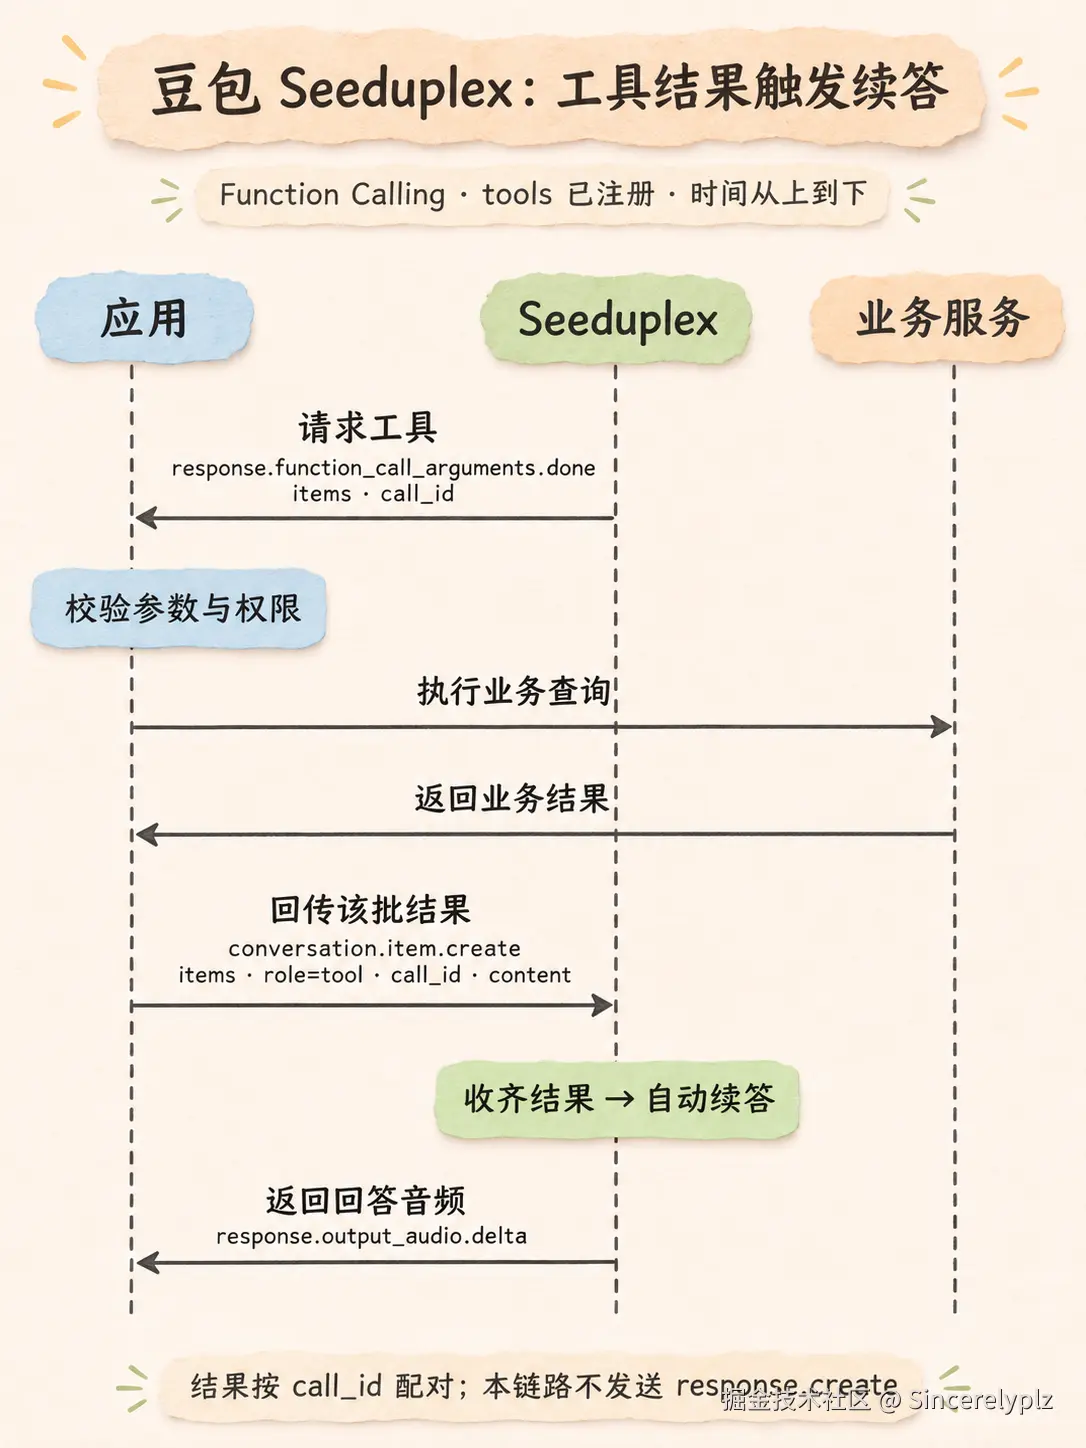
该图适用于公开的 Seeduplex 协议。SeedRealtime 的 API 接入信息仍待确认。
一批中有调用被拒绝或执行失败,也要回传对应结果。业务执行能否并行,仍取决于调用之间是否存在依赖。
OpenAI Realtime:应用执行函数,结果写回会话
OpenAI Realtime 同样支持应用自定义函数。工具可通过 session.update 配置到会话,也可通过 response.create 只配置到一次响应。
以完成响应后处理工具的接法为例:
- 收到
response.done,遍历response.output,找到type=function_call的项目。 - 读取
name、完整arguments和call_id,校验后执行业务。 - 发送
conversation.item.create,写入type=function_call_output、原call_id和字符串形式的output。 - 再发送
response.create,请求模型结合结果继续回答。
第 3 步的工具结果结构与前面的 Qwen 示例相同。函数声明层级和 WebSocket 音频事件仍需分别适配。
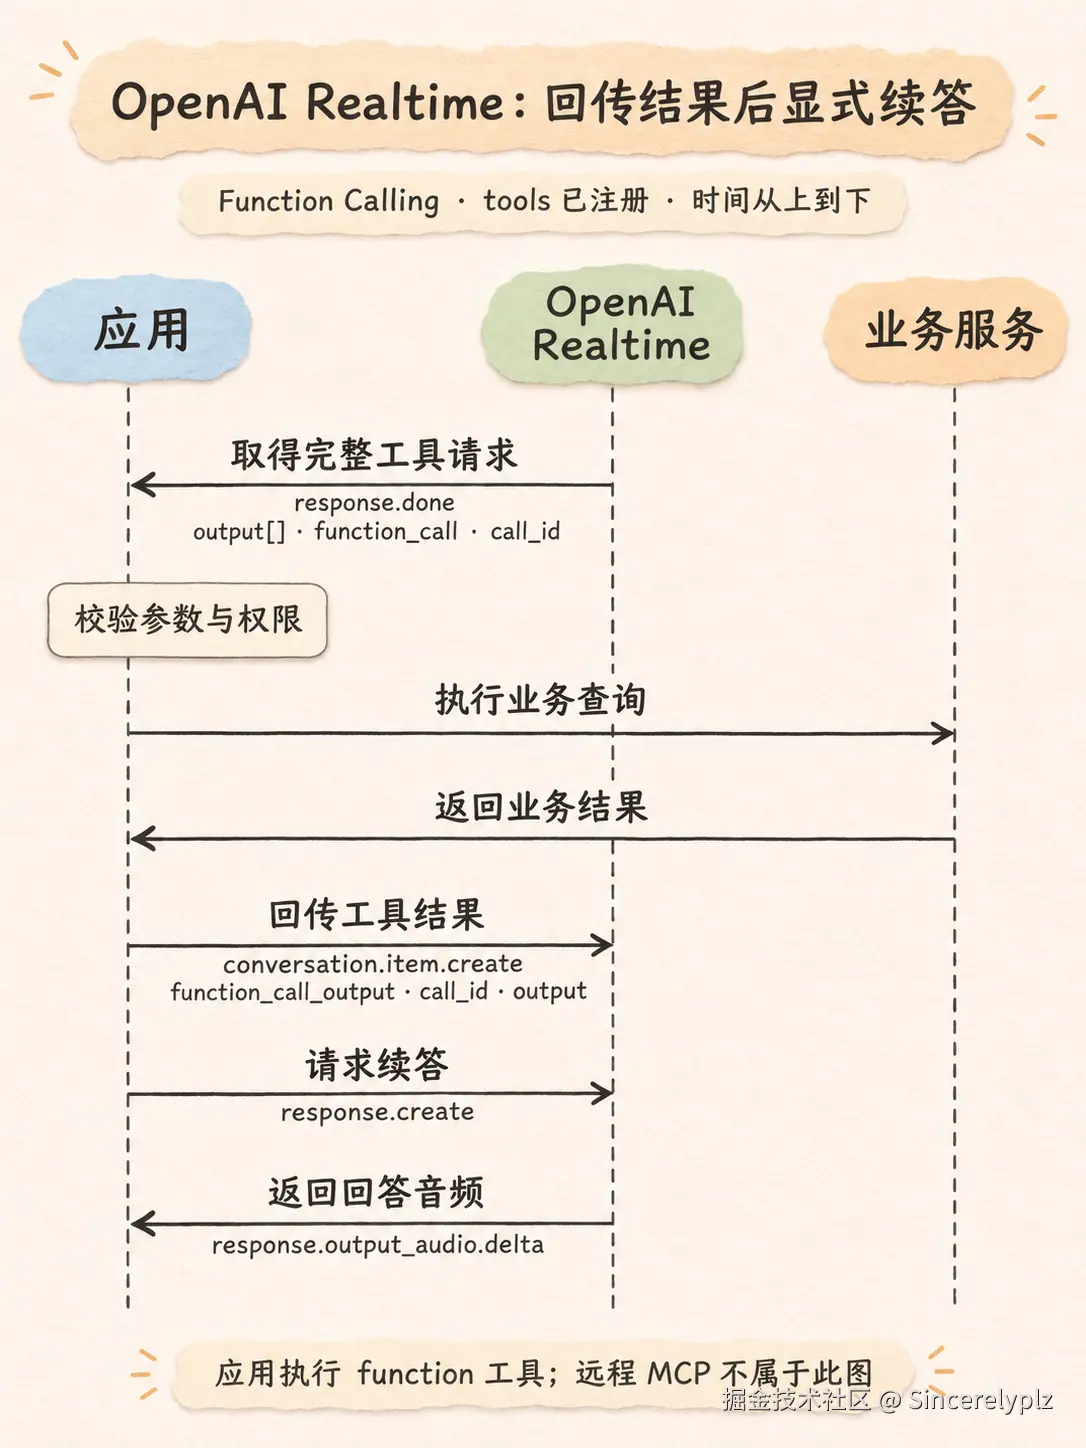
图中采用 response.done 收集完整调用。应用也可以按需处理其他工具事件。
对比时,重点看回传格式与续答责任
| 服务 | 应用回传的结果结构 | 续答由谁触发 |
|---|---|---|
| Qwen | item.type=function_call_output,携带 call_id 与 output |
应用发送 response.create |
| 豆包 Seeduplex | items[] 中放 role=tool、call_id 与 content |
服务端收齐该批结果后继续生成 |
| OpenAI Realtime | item.type=function_call_output,携带 call_id 与 output |
应用发送 response.create |
因此,适配器至少要分别处理工具声明、调用事件、结果封装和续答触发。对自动续答的路径,应在回传结果前完成本轮状态准备。
流式播放:让用户尽早听到答案
模型开始回答"下午三点有一场项目评审"时,音频会分块返回。应用收到一部分,就可以将它送进播放链路,让生成与播放同时进行。
text
模型音频分块 → 应用输出队列 → 格式适配与发送 → 客户端缓冲 → 播放播放缓冲需要在等待时间与声音连续性之间取舍:
- 等整段生成完再播放:用户会多等后半段音频的生成时间。
- 完全不留缓冲:网络稍有抖动,声音就可能断续。
采用流式播放时,可以边生成边交付,并按实际网络状况保留适量缓冲。
三家在本文 WebSocket 路径下的音频事件如下:
| 服务 | 音频分块事件 |
|---|---|
| Qwen | response.audio.delta |
| 豆包 Seeduplex | response.output_audio.delta |
| OpenAI Realtime | response.output_audio.delta |
适配层将事件转换成后续输出链路能处理的音频,客户端再按播放节奏消费。
应用也可以为控制反馈、受理反馈和已确定的结果保留独立语音合成分支。已有文本直接合成为语音,能够省去再次由模型组织措辞的过程。
听到反馈与拿到结果,是两个不同的时间点。 "我查一下"让用户知道请求已被接收,"下午三点有项目评审"才提供查询结果。后面的耗时分析会分别记录首声和有效回答。
打断:接收改口,同时停下旧回答
现在给示例增加一种情况:助手刚开始播报,用户插入一句:
等等,只看我主持的。
查询条件变了,旧回答已经不再适用。
系统需要在播放期间继续接收输入,并判断这次发声是否应当打断。VAD 可以提供发声信号,再结合发言人、词数或专门策略过滤回声、旁人的讨论和简单附和。
确认接受这次打断后,几个动作要配合进行:
- 停止播放:清理应用和客户端中尚未播放的旧音频。
- 停止旧生成:取消生成,或停止交付它后续产生的内容。
- 使旧轮次失效:过滤晚到的音频与工具结果。
- 处理业务任务:根据执行状态决定后续处理。
这些动作可以并行发起。客户端应立即停止播报;工具取消由应用根据业务状态另行处理,有些请求需要等待执行结果。
停止播放之后,旧结果仍可能到达
假设日历查询已经发出,用户这时改口,旧查询仍可能正常返回。应用要将结果关联到原轮次,避免它混入新的回答。这也是轮次标识的作用:帮助应用判断一份结果是否还适合交给用户。
对于写入类工具,停止播报后,已提交的业务操作仍可能继续执行。 应用需要收取回执或查询最终状态,确认实际结果。
对话历史也应尽量与实际播放进度一致。用户只听到半句话时,历史应记录实际传达的部分;截断能力取决于供应商接口和适配实现。
接受的新条件随后进入下一轮,沿输入、轮次判断和工具调用继续处理。
多轮对话:让"谁参加"接上刚才那场会议
回到正常完成第一轮的情况。用户听完会议时间,接着追问:
助手: 下午三点有一场项目评审。
用户: 都有谁参加?
第二句话省略了会议名称,却并不难理解,因为对话已经确定了对象。应用保留上一轮返回的 evt_example,模型就可以基于这场会议继续请求参会名单,无需重新查一遍"今天的会议"。如果前面仍有多场候选,则需要先澄清指代。
会议 ID 让追问落到具体对象,对话历史帮助模型理解省略的条件。
除了理解追问,系统还要管理收听状态,让用户不用每说一句都重新喊"小助手"。一种可采用的交互窗口策略是:
- 窗口有效时:同一发言人可以直接继续输入。
- 思考和播报期间:暂停静默计时,避免查询或回复尚未结束就退出交互。
- 回到收听后:重新开始计时,超时后再回到等待唤醒。
到这里,持续对话实际依赖三类状态:
| 状态 | 负责保留什么 |
|---|---|
| 交互状态 | 当前发言人,以及还能否直接继续说话 |
| 对话上下文 | 已确定的会议、查询条件与必要的历史回复 |
| 业务任务状态 | 后台任务的进度和执行结果 |
这三类状态分别管理:
- 交互窗口过期:结束免唤醒收听。
- 后台任务仍在执行:继续跟踪进度和结果。
- 上下文变长:保留当前对象、必要工具回执和近期对话,再压缩较远历史。
这样,第二轮复用了第一轮建立的上下文与连接,新的声音仍然经过相同的输入、判断、调用和播放过程。
可观测性:把"回答慢"定位到具体阶段
沿着这次查询看下来,用户的等待可能发生在收句、工具执行,也可能发生在结果已经返回之后。只记录一个总耗时,很难决定先优化哪里。
先分清用户在等什么
从本轮用户语音结束开始,可以观察三个不同的终点:
| 指标 | 到什么时候结束 | 示例 |
|---|---|---|
| 首声延迟 | 首段反馈开始播放 | "我查一下" |
| 有效回答延迟 | 包含结果的回答开始播放 | "下午三点有一场项目评审" |
| 任务完成延迟 | 业务获得确定执行结果 | 日历查询成功返回 |
任务可能先完成,模型随后才播报;也可能先播放受理反馈,业务在后台继续运行。因此这三个指标需要分别统计。首次唤醒和会话准备另外记录,才能覆盖说出指令之前的启动成本。
沿一轮请求记录时间点
以应用控制响应的 Qwen 路径为例,本文建议按以下区间埋点,指标名称由应用自行定义。
| 区间 | 起点 → 终点 |
|---|---|
| 轮次等待 | 用户语音结束 → 应用确认轮次结束 |
| 响应准备 | 轮次确认 → 发出响应请求 |
| 工具决策 | 响应请求 → 完整工具参数就绪 |
| 工具调度 | 参数就绪 → 工具处理函数开始执行 |
| 工具执行 | 开始执行 → 产生结果 |
| 结果回传 | 产生结果 → 发送完成 |
| 结果续答 | 结果发送完成 → 首块结果音频到达 |
| 播放准备 | 首块结果音频到达应用 → 客户端开始播放 |
例如,参数就绪后,工具可能还在排队等待执行;应用拿到音频后,客户端也可能还在缓冲。把这些边界分开,才能解释"查询很快,听到答案却很慢"。
不同接入方式可以利用不同的埋点位置:
- LiveKit:会话 trace 已覆盖轮次等待、工具执行和实时推理等阶段。
- Pipecat 自定义适配:在处理节点、模型事件和工具函数处补点。
- 豆包自动响应路径:按实际可观察的服务端事件划分阶段,并单独记录应用放行等待。
Grafana 中保留四组视图
- 整体等待:首声、有效回答的 P50/P95 与失败率,区分直接回答、工具调用、冷启动和独立语音合成。
- 阶段耗时:查看收句、工具、续答和播放准备的分布,找到最值得继续检查的一段。
- 交互质量:结合标注或抽检,观察误唤醒、漏唤醒、首句丢失、抢答和误打断。
- 单次请求追踪:将一轮里的输入、调用和输出串起来,解释具体一次等待。
指标分组与单次请求关联使用不同的信息:
- 指标标签:模型、工具和响应路径,用于汇总比较。
- 日志或 trace 字段 :会话 ID、轮次 ID、
call_id和任务 ID,用于定位具体请求,避免指标标签数量无限增长。
测量时有几个会影响结论的前提,需要统一处理:
- 停声起点 :客户端实际停声时刻需要在采集端记录。服务端的
speech_stopped则包含传输与检测等待。 - 播放终点与时钟:要确认用户何时听见,需要客户端播放回执和跨端时钟校准;缺少回执时,只报告已观察到的服务端边界。
- 统计口径:总延迟的 P95 应从完整请求耗时的分布中计算。并行与重叠阶段应回到同一次请求,沿实际关键路径分析。
有了这些数据,就能将现象对应到排查方向:
| 现象 | 优先检查 |
|---|---|
| 轮次等待高 | 静音窗口、语义检测和最终转写依赖 |
| 工具很快返回,有效回答仍慢 | 结果回传、续答和播放 |
调整后用同一组请求复测,同时抽检是否更容易抢答、漏条件或误打断,确认缩短等待后仍能完整处理用户请求。
我们的选择:把这些能力组合成 Mina
Mina 是我们自己的会议助手实现。前面的框架和模型提供基础能力,我们再按会议场景决定唤醒、发言归属、工具执行和任务生命周期。
为什么最终选择 Qwen
这次选择主要考虑三点:
- 先选原生实时路线:语音榜单里,这类模型在语音推理与自然交互上表现突出,符合我们对接话、追问和打断的需求。
- 优先采用实际可接入的服务:国内落地时,我们先使用公开 API 和工具协议明确的 Qwen,持续关注豆包 App 新模型能力的开放进展。Seeduplex 已有公开接口,仍可作为独立候选评估。
- 保留应用的控制位置:Qwen 的会话配置、Function Calling 和显式续答,让我们能在业务校验完成后再放行回应。
当前代码默认使用 qwen3.8-omni-flash-realtime;榜单评测的型号为 Qwen Audio 3.0 Realtime Plus。榜单帮助确定考察方向,当前接入型号的效果仍需用会议样本验证。
Mina 的具体组合
| 环节 | 当前实现与取舍 |
|---|---|
| 音频传输 | 使用 Agora 将参会人音轨送到 Agent,沿用现有会议接入 |
| 唤醒 | 在 Agent 服务端使用 sherpa_onnx.KeywordSpotter 分音轨检测;缓存并补送唤醒期间的声音,保住首句 |
| 发言准入 | 绑定当前发言人和交互窗口,避免其他人的讨论混入请求 |
| Qwen 响应 | 保留服务端 VAD,关闭自动响应和自动打断,由应用完成检查后发送 response.create |
| 工具调度 | 自定义适配收齐完整响应后执行工具,将参数就绪后的等待单独计入调度耗时 |
| 长任务 | 委托后台 MeetingAgent,语音前台反馈受理状态,并通过任务 ID 查询后续进度 |
| 多轮状态 | ConversationState 在思考与播报时暂停静默计时,回到收听后恢复计时 |
| 固定反馈 | 部分控制反馈、受理反馈和已确定结果使用独立语音合成分支 |
Mina 也保留豆包适配。由于服务端会自动响应,适配器暂存尚未准入的模型事件,放行后再交付,并在执行工具前检查轮次有效性。这套控制策略由 Mina 的适配层实现,服务于会议交互。
后续比较模型时,我们会用同一组会议请求检查有效回答时间、工具成功率、漏条件和误打断,再决定是否调整这套组合。
参考资料
- Qwen Realtime:实时多模态
- Qwen Realtime 客户端事件:工具定义与结果回传
- Qwen Realtime 服务端事件:函数调用参数与音频
- OpenAI Realtime:工具与 MCP
- OpenAI Realtime:会话、函数调用与音频输出
- 豆包 Seeduplex API:工具字段与结果回传
- ByteDance Seed 模型目录
- Pipecat Frames
- Pipecat LiveKit Transport
- Pipecat LLM Service 与工具调用接口
- LiveKit AgentSession
- LiveKit Realtime Models
- LiveKit Turn Detection
- Pipecat User Turn Strategies
- Pipecat Smart Turn
- TEN Framework:Extension 与 Graph
- TEN Turn Detection
- LiveKit Wakeword Detection
- LiveKit 音频与文本轮次模型
- Codex Voice 使用说明
- LiveKit Session Traces and Metrics
- 火山引擎全双工接入与工具调用