在 Claude Code 里跑长任务,对话长到一定程度就会触发自动压缩(compaction),把之前的对话替换成一份摘要;平时也可以手动输入 /compact 触发压缩。很多项目周期长,一个会话里往往会经历多次压缩。
但不少关键决定只存在于对话里------比如「这个词别用」「这个话题不写」。它们不会直接写进产出的代码或文档里,一旦在压缩时被摘要漏掉,后面就哪里都找不回来了。
开发者 Murooka(dev.to 账号 murooka_az_dev)先在日文技术社区 Zenn 发布了自己的实测,随后于 2026-11-13 在 dev.to 发布了英文版文章「Claude Code Forgets My Instructions as Compactions Pile Up. One Added Prompt Stopped It: 0 Lost After 3 Compactions」。他用自己开发 VS Code 插件时的真实对话做了多轮压缩实验,测出了两个关键结论:
- 第 1 次压缩没有丢掉任何用户指令,但连续压缩到第 3 次时,两段对话分别丢掉了 33% 和 57% 的指令。 原因不是单次摘要写得差,而是摘要不会把「上一轮摘要里的历史用户消息列表」接力抄到下一轮。
- 只要在
/compact后面加一段提示词,要求把包括上一轮摘要在内的全部用户消息原样抄录下来,连续 3 轮压缩后的指令丢失率可以直接降到 0%。
同时,他的测试也测出了这段提示词的失效边界:当单次会话消息累积到上百条、上万字时,靠大模型抄原文依然会出现漏抄和截断,而且塞入原文列表会挤压摘要里其他小节的篇幅。下面把实验方法、根因定位、配置方式和边界条件完整拆开来看。
实验是怎么做的
这组实验由 Murooka 在开发一个 VS Code 插件的过程中完成,样本直接取自他开发过程中的 2 段真实日文对话(对话 A、对话 B)。
为了模拟真实长会话里的连续压缩,他的实验流程是:在某处截断对话 → 执行 /compact(第 1 轮)→ 在生成的摘要后面接上这段对话真实的后续内容 → 再执行 /compact(第 2 轮)→ 再接上后续并执行 /compact(第 3 轮)。
在普通 /compact 下,每轮压缩前后的 token 数和消息数变化如下:
- 对话 A :3 轮压缩前后的 token 数为
227k → 11k;43k → 6k;34k → 7k。作者发出的消息累计为24 → 42 → 72条。 - 对话 B :3 轮压缩前后的 token 数为
388k → 8k;63k → 7k;16k → 5k。作者发出的消息累计为36 → 83 → 86条。
在评估方式上,Murooka 从每段对话里各挑出 18 条自己下过的指令和决定。每次压缩后,让另起的一个 Claude(Opus 5.5)负责打分,检查压缩后的摘要里还能不能读到这条指令。整套流程在每段对话上各重复 3 次;打分时隐藏了具体使用的是哪种压缩方法,评分一致率在 89%--99% 之间。
实验环境也做了严格固定:
- 摘要模型固定为
Opus 5.5。 - 手动压缩实验使用的 Claude Code 版本为
2.1.319和2.1.321(Murooka 确认这两个版本内置的摘要提示词逐字相同);后面测试自动压缩时使用的是2.1.322。 - 实验过程中没有新加载用户设置、记忆和
CLAUDE.md。
需要说明的是,Murooka 在正文和评论区都明确指出:实验只统计「压缩后这条指令还写没写在摘要里」,没有测 Claude 在压缩之后是否真的照着指令去做。
第一次压缩丢什么、不丢什么
测完第 1 轮压缩后,结果和很多人的直觉相反:18 条用户指令一条没丢。
真正丢失的是其他两类信息:
- 继续工作需要的事实(包括做完了什么、还剩什么、作者接受过的方案内容):写清楚的占 70%,部分写到的占 23%,完全没有的占 7%。
- 在对话里出现 3 次以上的文件名和 ID:对话 A 保留了 46%--71%,对话 B 只保留了 21%--23%。
Murooka 对此的解释是:平时大家觉得「压缩一次就忘」,忘掉的其实是上下文事实和具体文件名,而不是指令本身;另一个原因是长任务里自动压缩会在不知不觉间发生很多次,让人误以为只压了一次。
从第 2 次压缩开始丢指令的原因
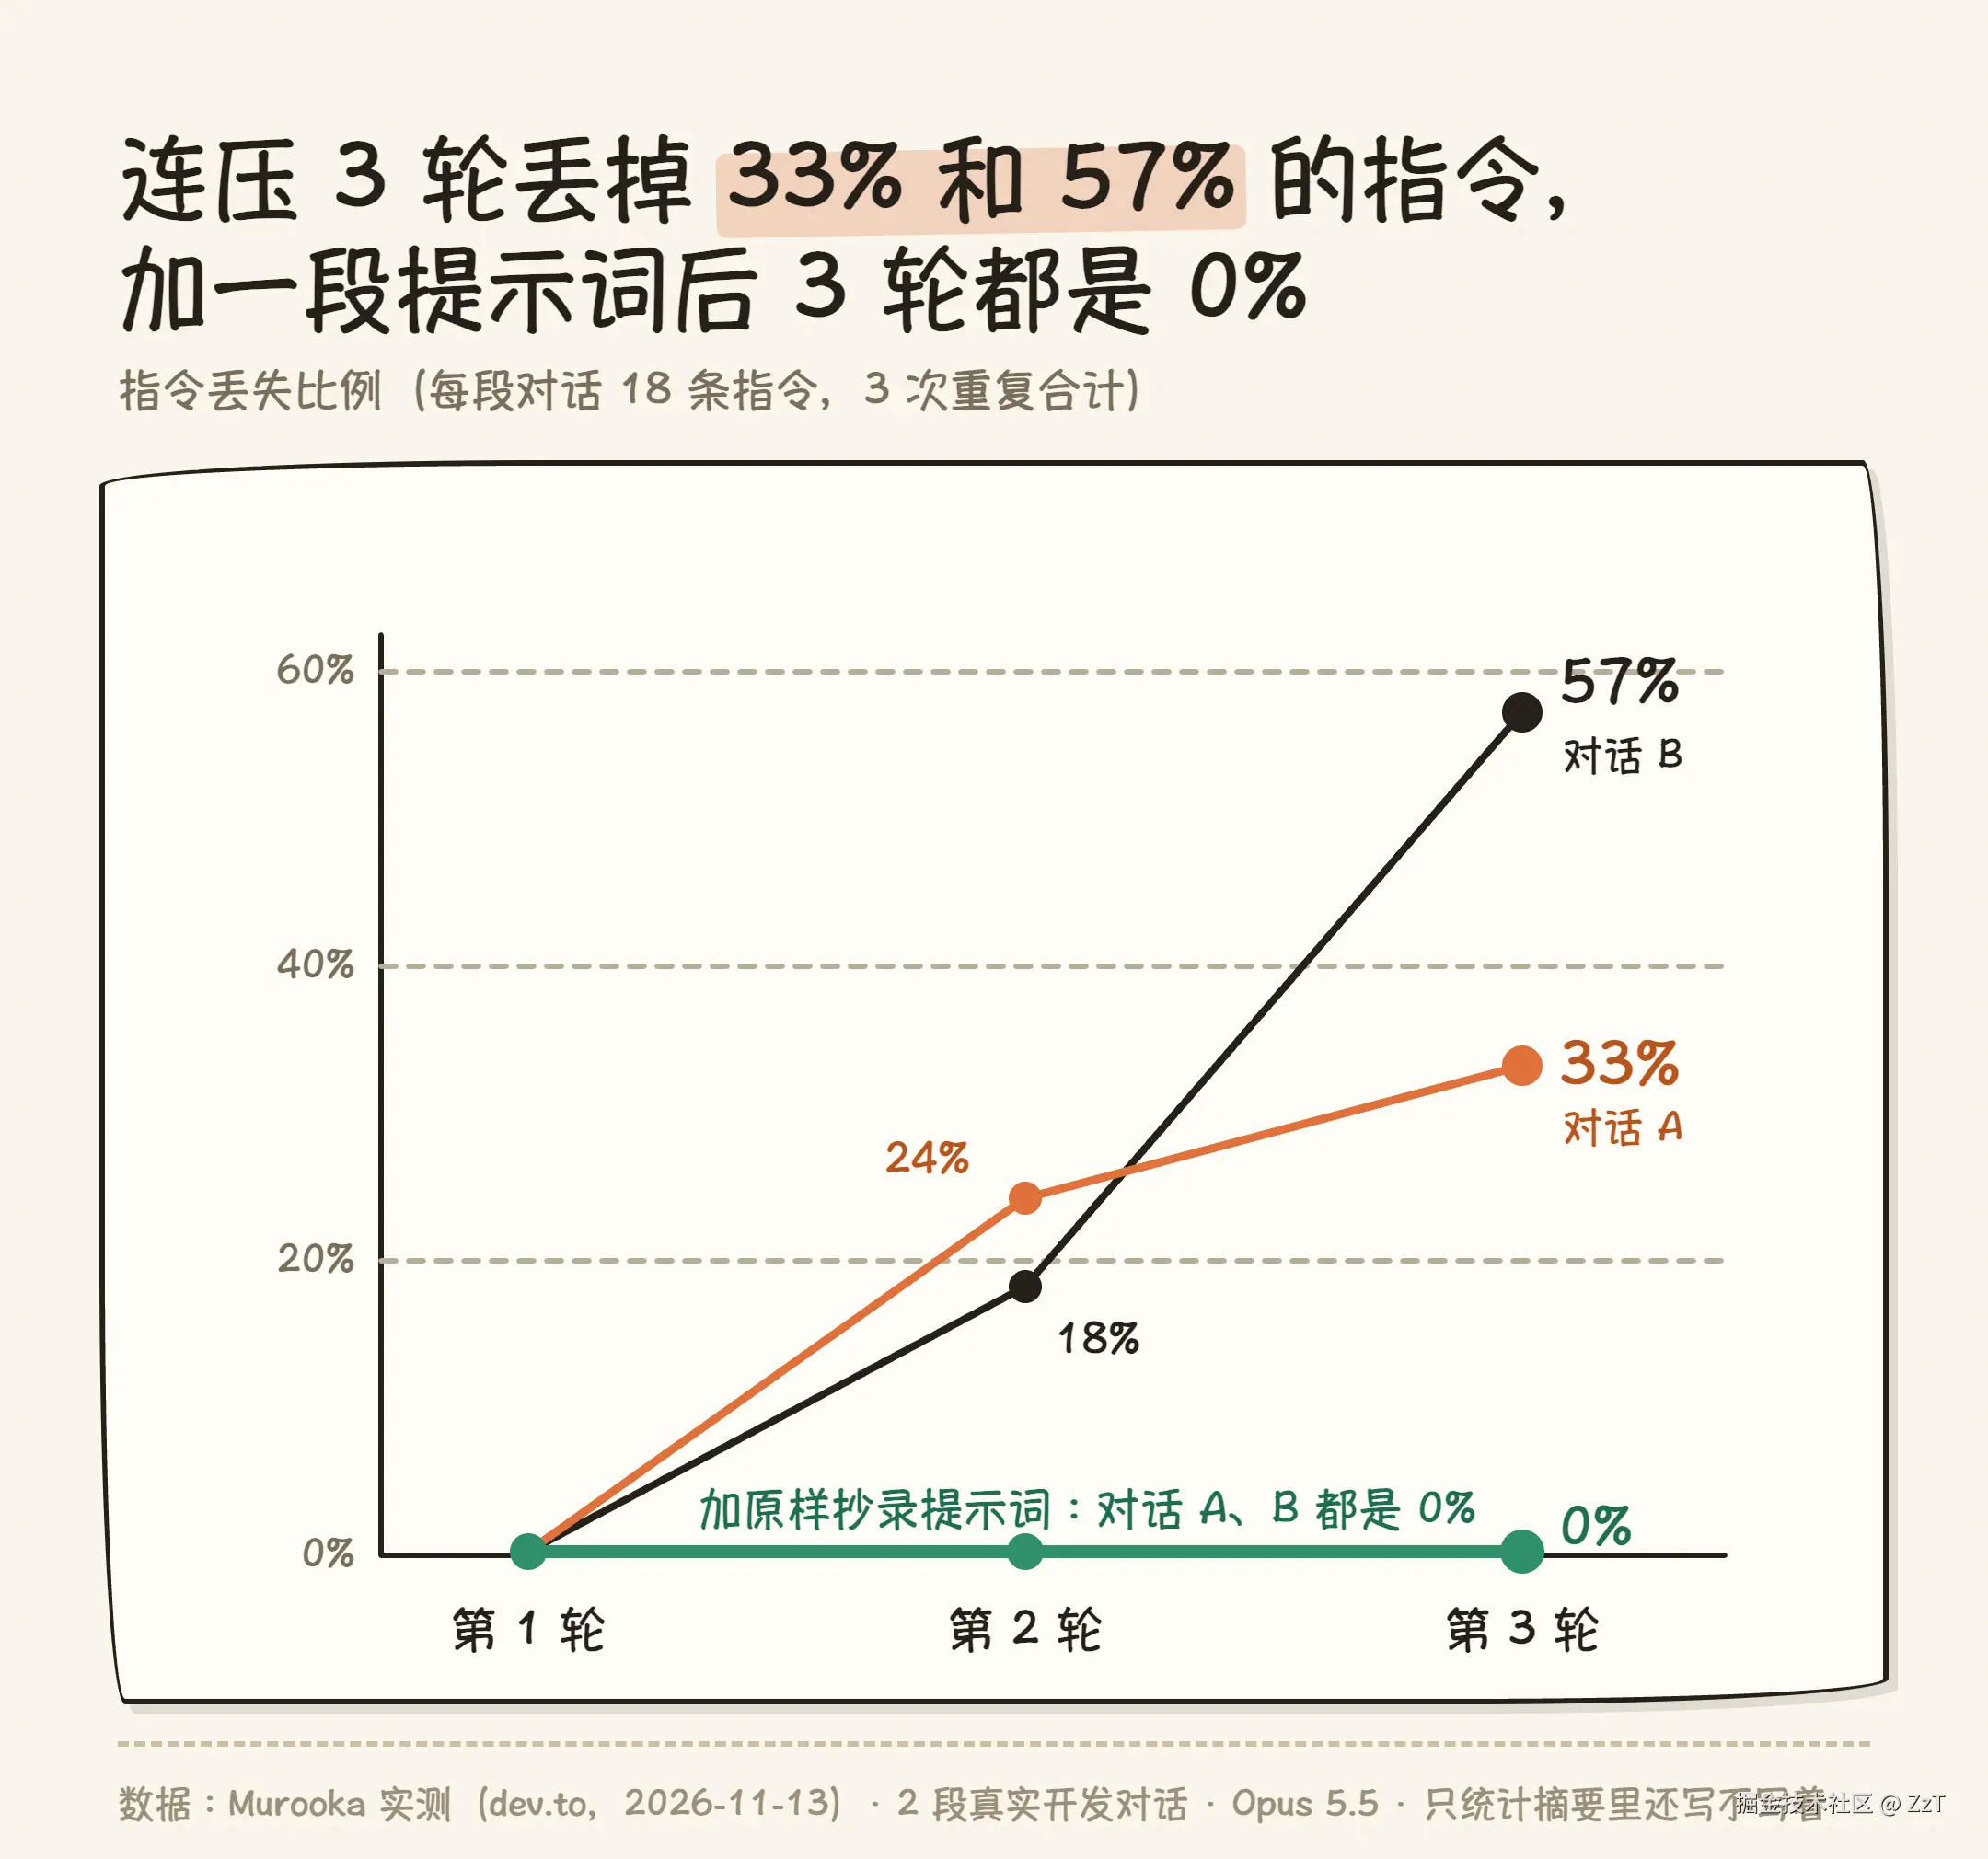
一旦进入第 2 轮和第 3 轮压缩,用户指令就开始成批消失。Murooka 测出的指令丢失比例(第 1 / 2 / 3 轮后)如下:
- 对话 A :
0% / 24% / 33% - 对话 B :
0% / 18% / 57%
比如在第 3 轮压缩后丢掉的作者原话(日文原文经英文转成中文)里有「先修 bug」和「只要别把设计搞乱就行」。在重复的 3 次实验里,前一条 3 次全丢,后一条丢了 2 次。
Murooka 一开始以为原因是自己的消息太短:对话 A 的 72 条消息加起来一共 3,403 个字符,平均不到 50 字,里面有很多像「用日语」「A 就行」这样的一句话,摘要模型可能分不出哪句重要。
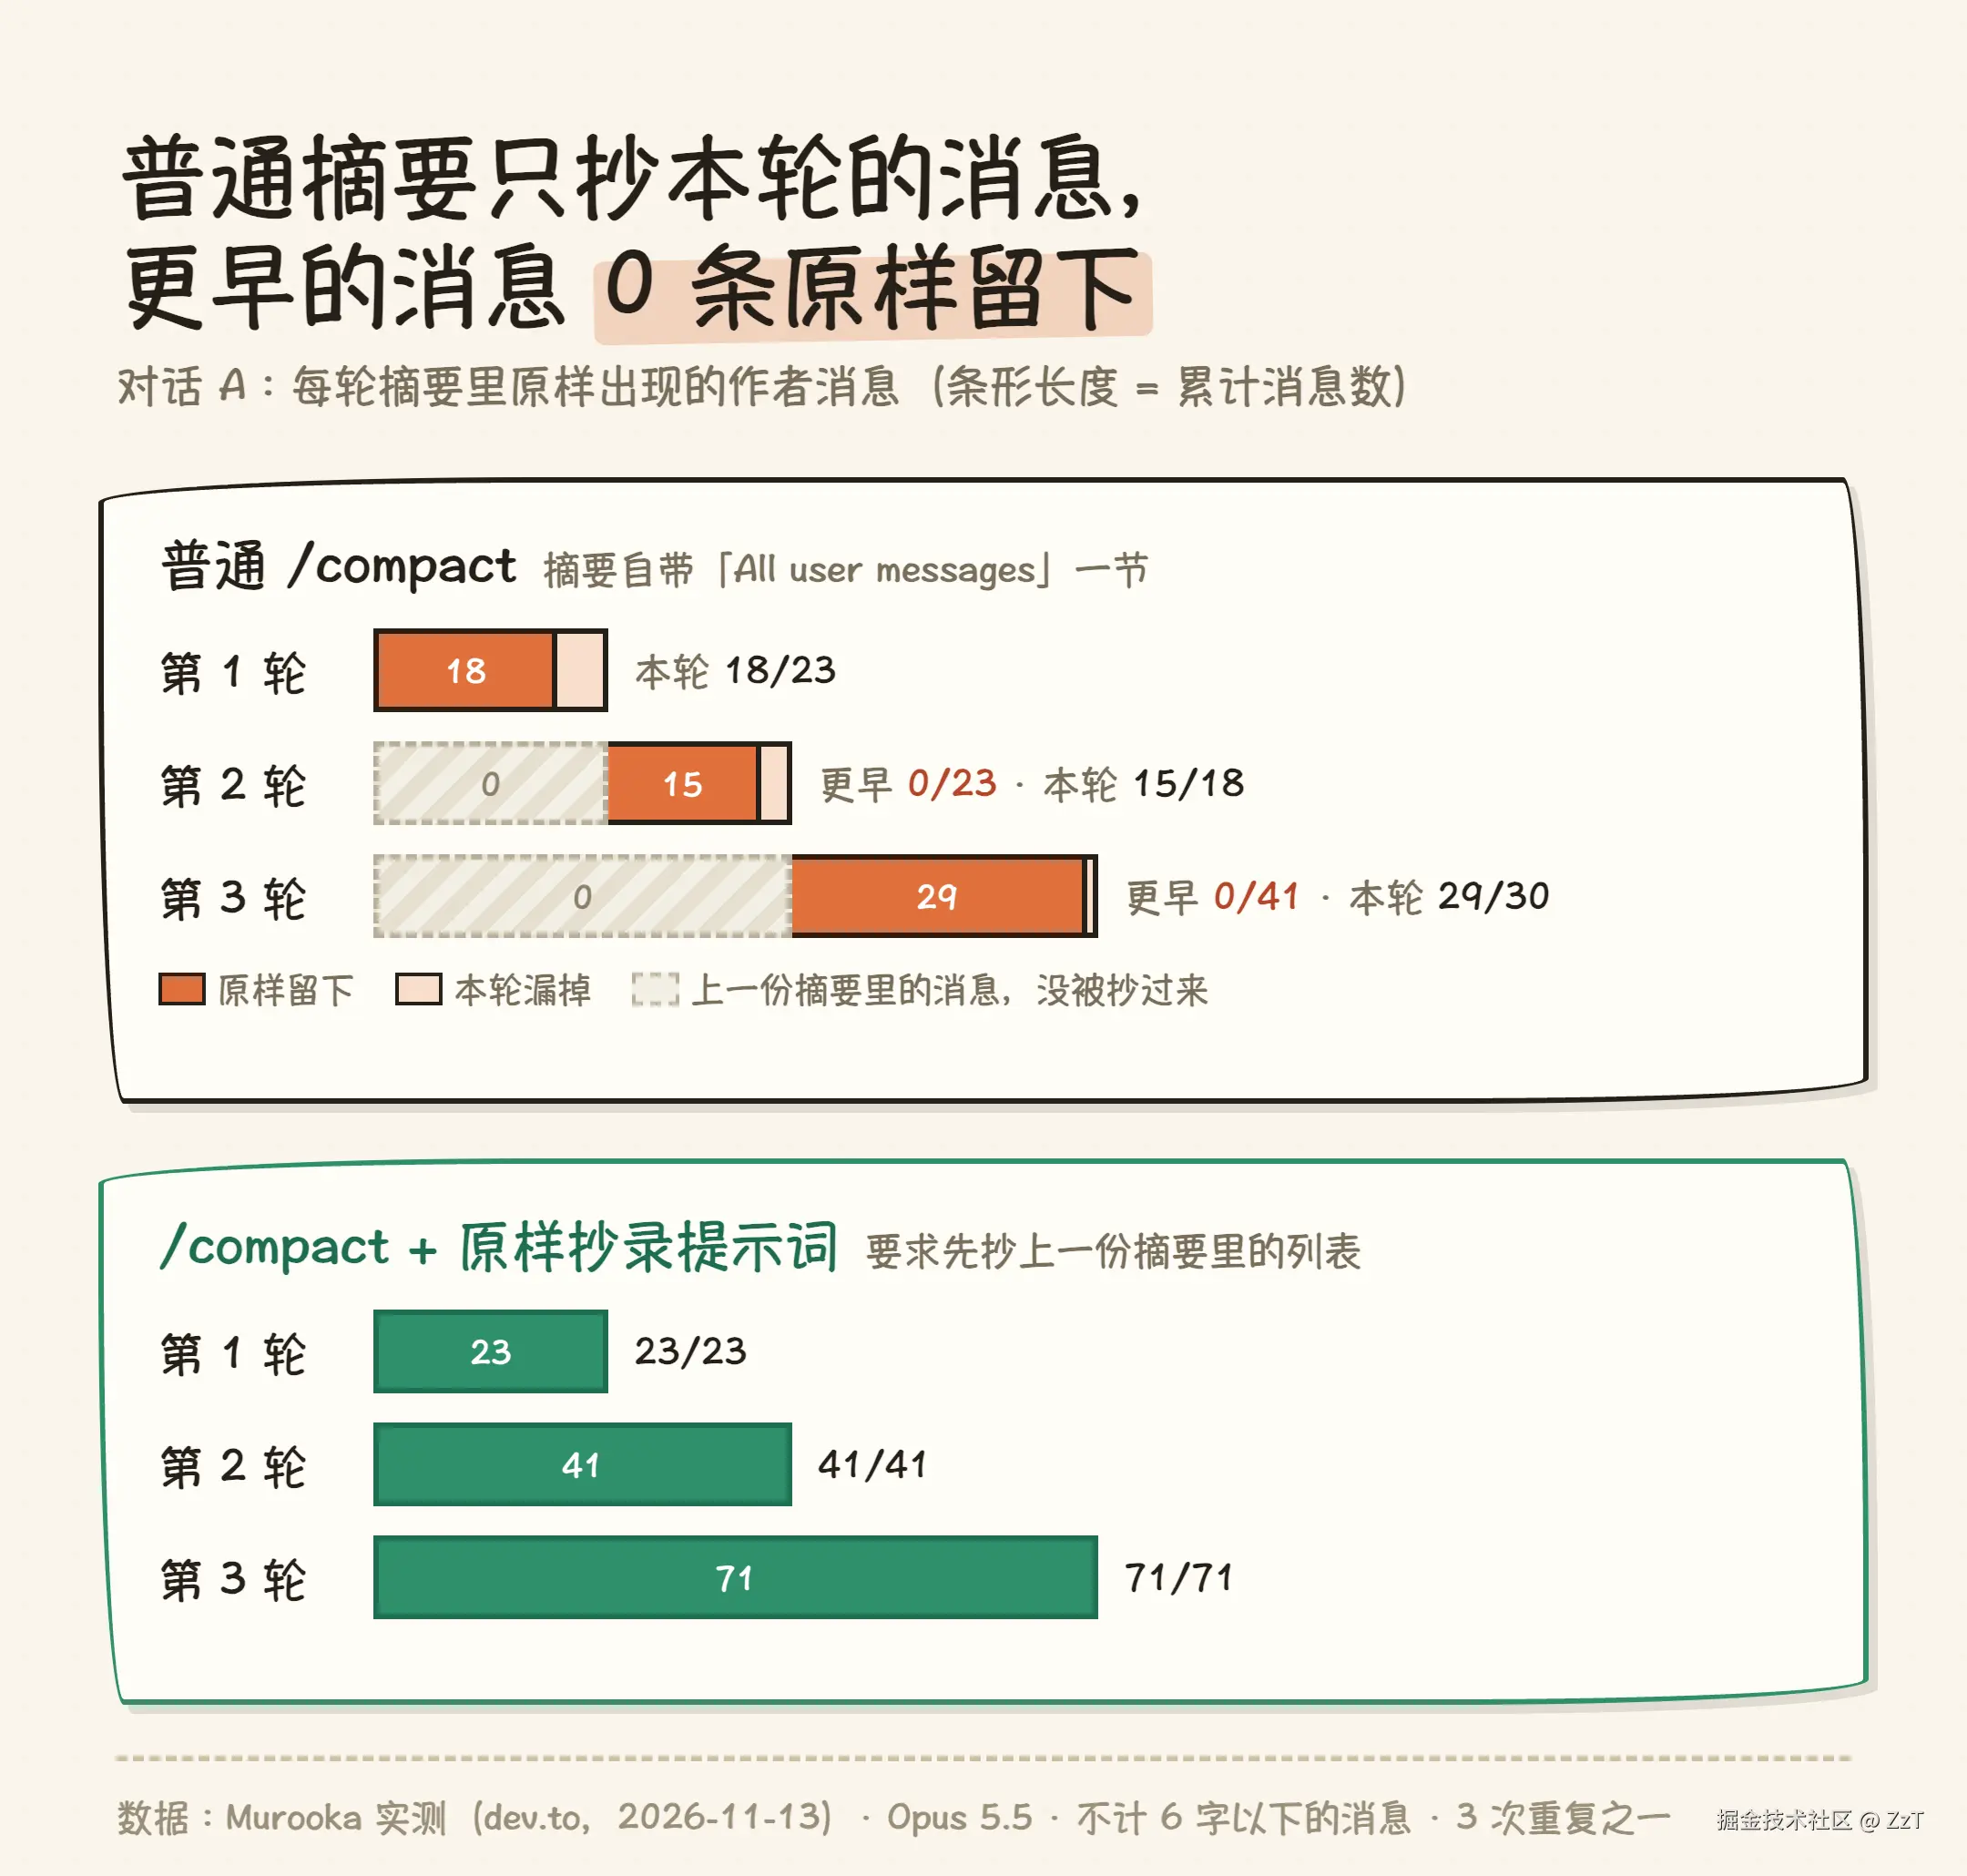
但他逐条数过摘要内容后发现,真正的原因不是消息短。Claude Code 生成的摘要里本来就有一个名为 All user messages(全部用户消息)的小节。Murooka 统计了每轮摘要里原样出现的作者消息数(不足 6 个字符的消息不计):
| 轮次 | 对话 A:本轮新消息 | 对话 A:更早的消息 | 对话 B:本轮新消息 | 对话 B:更早的消息 |
|---|---|---|---|---|
| 第 1 轮 | 18/23 | --- | 30/34 | --- |
| 第 2 轮 | 15/18 | 0/23 | 45/47 | 0/34 |
| 第 3 轮 | 29/30 | 0/41 | 2/2 | 0/81 |
这张表直接暴露了问题所在:摘要会抄录本轮新发的消息,但绝不会把上一份摘要里的消息列表抄进下一份摘要。 第 2 轮压缩读到了第 1 轮的摘要,但上一轮那份消息列表被整体改写成了「之前的讨论」;只要某项决定没在这段概括里被捡起来,它从此就彻底消失了。
为了验证是不是因为对话变长才丢信息,Murooka 做了一组对照实验:把同一段对话直接拉到第 3 轮结束时的完整长度,但只执行一次压缩。在 3 次实验共 54 项指令中,只压缩一次时,对话 A 丢失 0 项、对话 B 丢失 2 项;而连续压缩 3 轮时,对话 A 和对话 B 分别丢失了 18 项和 31 项。同样长度下,只有反复压缩才会导致大量丢失。
这也和我们自己的观察一致:我们翻了自己一个压缩过多次的 Claude Code 长会话,摘要里的 All user messages 一节确实只列了上一次压缩之后的消息;更早的指令没有原文,只以转述的形式散在别的段落里。
Claude Code 官方文档其实也提到了这一现象:
The summary keeps your requests and key code snippets, but detailed instructions from early in the conversation may be lost. Put persistent rules in CLAUDE.md rather than relying on conversation history.
一段提示词:手动 /compact 怎么用
既然症结在于上一轮的用户消息列表没能传给下一轮,修法就很直接:把全部用户消息原样带到下一轮。
Murooka 在相同实验条件下测试了两种方案:
- 用程序直接从对话日志里抽出用户消息,贴在摘要后面(他把这个做法做进了自己的插件里);
- 不写代码,只在
/compact后面追加一段提示词,要求摘要把包括上一份摘要在内的所有用户消息原样抄下来。
实测结果是:这两种方法在对话 A 和对话 B 的第 1 / 2 / 3 轮压缩后,指令丢失率全部是 0% / 0% / 0%。在手动压缩的 2 段对话 × 3 轮 × 3 次 = 18 份摘要里,作者发出的每一条消息(到第 3 轮时分别是 72 条和 86 条)都原样出现在摘要里,只有空白字符的差别。
Murooka 给出的英文版提示词如下(注:他实测的是日文原版,英文翻译本身没测;提示词里的 1000 是按日文字数定的):
text
/compact At the end of the summary, add a section titled "User messages (verbatim)". In it, copy every message the user sent in this conversation, in order from first to last, without omitting any and without rephrasing, verbatim. If the previous summary has the same section, copy all of its contents verbatim at the start. Only for a message longer than 1000 characters, you may omit the middle, keeping the beginning and the end. Write all other sections as usual.我们按原意改写的中文版如下(注:这个中文版我们没有实测):
text
/compact 在摘要末尾加一个标题为「用户消息(原文)」的小节。按从早到晚的顺序,把用户在这次对话里发的每一条消息原样抄进去,不省略、不改写。如果上一份摘要里已经有这个小节,先把它的全部内容原样抄在最前面。只有超过 1000 字的消息可以省略中间部分,保留开头和结尾。其他小节照常写。Murooka 指出,这段提示词里最关键的是第三句------「如果上一份摘要里已经有这个小节,先把它的全部内容原样抄在最前面」。正是这句话强迫模型把普通摘要默认丢弃的历史列表一轮接一轮传下去。
手动使用这段提示词时要注意:每次压缩都必须带上它;如果中间不小心插进了一次没带提示词的自动压缩,那一轮就会退回普通摘要,历史消息链条随之断开。
顺带一提,Murooka 还试过另一种思路:让 AI 在压缩时专门整理一份「决定清单」。测试下来,3 轮后指令丢失率虽然降到了对话 A 20%、对话 B 26%,但副作用是清单里凭空捏造出了作者从没做过的「用户决定」(第 1 到 3 轮合计,对话 A 出现了 5 条假决定、对话 B 出现了 6 条;而普通摘要是 0 条)。因此他放弃了让 AI 总结清单的做法,改成了只带原文。
自动压缩怎么挂:CLAUDE.md 和 PreCompact hook
靠手动敲 /compact 很容易漏,如果要在接近上下文上限触发自动压缩时也自动生效,可以根据 Claude Code 官方文档提供的机制挂载。官方文档说明,自动压缩和 /compact 走同一个流程,既可以在执行 /compact 时带上重点(官方例子:/compact Focus on code samples and API usage),也可以通过配置文件或 Hook 控制。Murooka 在 Claude Code 2.1.322 上实测了两种自动挂载方案:
方案一:写进 CLAUDE.md
在项目根目录的 CLAUDE.md 里建一个 # Compact Instructions 小节,把上面的提示词(去掉开头的 /compact)放进去。
Murooka 的实测结果是:必须在对话开始前就写好。 对话开始前写好时,触发自动压缩后 24 条消息全部原样出现;但如果对话进行到一半才去改 CLAUDE.md,赶不上下一次压缩,摘要里不会生成那个小节,结果只有 19/24 条消息原样出现。这是因为 CLAUDE.md 在对话开始时加载,下一次从磁盘重新读入要等到压缩完成之后。
方案二:使用 PreCompact hook
根据官方文档,PreCompact 会在压缩前触发,matcher 可以设为 manual(手动 /compact)或 auto(自动压缩)。当 hook 正常退出时,Claude Code 会把它的标准输出当作本次压缩摘要的附加指令(每个 hook 的输出要控制在 10,000 字符以内;如果退出码为 2,则会阻止这次压缩)。
Murooka 的做法是把去掉 /compact 的提示词存进 .claude/compact-prompt.txt,再在项目的 .claude/settings.json 里写入以下配置:
json
{
  "hooks": {
    "PreCompact": [
      {
        "matcher": "auto",
        "hooks": [
          { "type": "command", "command": "cat \"$CLAUDE_PROJECT_DIR/.claude/compact-prompt.txt\"" }
        ]
      }
    ]
  }
}
Murooka 实测这套配置同样做到了 24 条消息全部原样出现。实际使用时有几个细节要注意:
- 这里
matcher只配了auto,所以手动执行/compact时仍然要自己带上提示词; - 配置文件改好后,需要新开一个会话才会生效;
- hook 运行时在界面上不留痕迹,第一次触发自动压缩后,最好去摘要里检查一下有没有生成对应小节;
- 命令里用了
cat,在 Windows 上运行需要 Git Bash。
这段提示词的边界
把提示词挂上并不等于一劳永逸。Murooka 接着做了压力测试和内容分析,找出了提示词方案的四个明确边界:
第一,消息攒得太多时,AI 照样会抄丢、抄错。 Murooka 用第三段真实开发对话 C 做了测试:共 133 条消息,约 12,000 字,其中包含粘贴进来的长消息。提示词方式在第 1 轮(45 条)全部原样保留,到第 2 轮(114 条)开始出错。第 3 轮压缩后:133 条消息里有 129 条原样保留;1 条(34 字)整条丢失,而且下一轮再也找不回来;2 条不到 1000 字的消息(888 字、610 字)被截掉了中间部分,违反了提示词规则;还有一条 2,616 字的长消息,中间部分没有省略而是被换成了 AI 自己写的概括。相比之下,他在插件里用程序抽取的方式是 133/133 全中(生成体积大约是提示词方式的两倍)。Murooka 的结论很明确:只要还是让 AI 在抄,就不能保证消息越积越多时不丢。
第二,摘要总体积没变大,但挤压了其他小节。 第 3 轮压缩后,提示词方式生成的摘要在对话 A 约 6,600 tokens、对话 B 约 5,100 tokens,和普通摘要(约 7,000 和 4,600 tokens)差不多。总长度没涨,是因为塞进消息列表后,其他小节被压短了------在对话 A 第 3 轮里,摘要中 Primary Request and Intent 一节从约 2,000 字直接缩水到了约 400 字。
第三,「拍板接受的方案」更容易丢上下文。 在每段对话挑出的 15 条「继续工作需要的事实」里,第 3 轮后「写清楚」的比例,普通摘要是 49%,提示词方式是 43%,整体差距在噪声范围内(「完全没写」的比例普通摘要是 28%,提示词方式降到了 8%)。但细分到「Claude 提出、作者接受的方案内容」这一类时,普通摘要保留了 50%,提示词方式却跌到了 33%------因为方案是 Claude 写的,作者当时只回了一句「就这么办」,光抄用户原话救不回方案本身。
第四,留住了原话,不等于搞清了当前状态。 哪怕原文一字不差地留下来,还有两个语义问题:一是原文在,但看不出它现在还算不算数、具体指什么(对话 B 第 3 轮里这类情况占约 19%--20%),比如一句「不用做得太花哨」,脱离上下文后根本不知道指的是哪个模块;二是作者后来已经撤回的决定,有时在摘要正文里仍被写成有效。正如 Murooka 所说,「不丢消息」和「知道每条消息现在的状态」是两个问题。
和几篇论文的结论对照
Murooka 还在文章里对比了近期几篇研究上下文压缩的论文(以下数据均取自各论文摘要):
- Lost in Context Compaction(arXiv 2608.11242) :测试中的压缩器平均只保留了 17% 的用户附加约束;在一个邮箱实验里,压缩前 agent 未经批准删邮件的次数是 0,压缩后在
30/100个会话里未经批准就删了邮件;而把约束单独保存并追加在压缩结果后面,三个测试场景的约束保留率都超过了 90%。 - Governance Decay(arXiv 2606.22528):跨 7 个模型家族、1,323 个回合的测试显示,约束在完整上下文里时违规率为 0%,压缩后违规率升到 30%,有的模型高达 59%;把约束从压缩过程里隔离出来(Constraint Pinning)后,违规率重新回到 0%。
- Benchmarks Are Surprisingly Compaction-Friendly(arXiv 2610.31778):在 ProgramBench 上,第一次压缩的摘要平均就丢掉约三分之一的防作弊规则,而且丢失比例随压缩次数单调上升;在对真实用户会话的分析里,「agent 应该怎么做、不该做什么」这类指令被丢掉的次数,约是「要做什么」这类功能需求的 6 倍。
- Compact-Bench(arXiv 2610.31710):LLM 自己写的摘要最多只能保留 16.0% 反复出现的细节(如路径、ID),而机械抽取能保留 79.1%。
Murooka 指出,这些论文大多测的不是 Claude Code 自己的 /compact,也没有在同样条件下跟踪真实对话的第 1、2、3 次连续压缩;他自己的实验在第 1 轮之所以不丢指令,很可能就是因为 Claude Code 默认摘要里自带了 All user messages 这一节。但所有研究指向的大方向完全一致:把约束条件和用户原话放在会丢信息的摘要生成过程之外,才能真正保住它们。
结论:哪些规则写进文件,哪些靠提示词带过去
结合 Claude Code 官方文档的机制和 Murooka 的实测数据,日常使用中可以把规则和指令按生命周期分成两层来处理:
- 跨会话的长期规则,直接写进
CLAUDE.md。 官方文档明确建议,只要某条规则需要持久生效,就应该放进项目根目录的CLAUDE.md,而不是依赖对话历史------因为每次压缩结束后,Claude Code 都会从磁盘重新读入CLAUDE.md,完全绕开了摘要损耗。 - 当前任务里的临时决定,靠压缩提示词或 Hook 把原话带过去。 开发途中随口交代的「先修 bug」「这个词别用」「只要别把设计搞乱就行」,没必要每句都去改
CLAUDE.md。提前在CLAUDE.md的# Compact Instructions或PreCompacthook 里配好原文抄录指令,就能在几十条消息的常规长任务里把多轮压缩的指令丢失率压到 0%。
最后也要留个心眼:如果对话已经滚到了上百条消息,或者你在对话里只回了一句「就这么办」来拍板 Claude 的长方案,又或者推翻了之前的某个决定,单靠抄录用户原文也兜不住底------把拍板后的方案写进文档,或者适时开一个干净的新会话,依然省不掉。
参考链接
- 英文原文:dev.to/murooka_az_...
- 日文原文:zenn.dev/murooka_az/...
- Claude Code 文档 How Claude Code works:code.claude.com/docs/en/how...
- Claude Code 文档 What survives compaction:code.claude.com/docs/en/con...
- Claude Code 文档 Hooks(PreCompact):code.claude.com/docs/en/hoo...
- Claude Code 文档 Manage costs(Compact instructions):code.claude.com/docs/en/cos...
- arXiv 2608.11242:arxiv.org/abs/2608.11...
- arXiv 2606.22528:arxiv.org/abs/2606.22...
- arXiv 2610.31778:arxiv.org/abs/2610.31...
- arXiv 2610.31710:arxiv.org/abs/2610.31...