a + b 在源码里只有一行,编译出来的指令却取决于类型:int 是 iadd,long 是 ladd,float 是 fadd,double 是 dadd。
第一篇的 add 已经用过 iadd,上一篇的 spin 用过 iinc;这一篇从规范 3.3 节的算术例子出发,把"指令名里的类型前缀"这件事讲清楚。
3.3 的例子:算术在操作数栈上做
3.3 节开头说 ⬇️
The Java Virtual Machine generally does arithmetic on its operand stack. (The exception is the iinc instruction, which directly increments the value of a local variable.)
例子是把一个整数按 2 的幂对齐 ⬇️
java
int align2grain(int i, int grain) {
    return ((i + grain - 1) & ~(grain - 1));
}
javac 编译后用 javap -v 反汇编,是 12 条指令 ⬇️
text
  int align2grain(int, int);
    descriptor: (II)I
    flags: (0x0000)
    Code:
      stack=3, locals=3, args_size=3
         0: iload_1
         1: iload_2
         2: iadd
         3: iconst_1
         4: isub
         5: iload_2
         6: iconst_1
         7: isub
         8: iconst_m1
         9: ixor
        10: iand
        11: ireturn
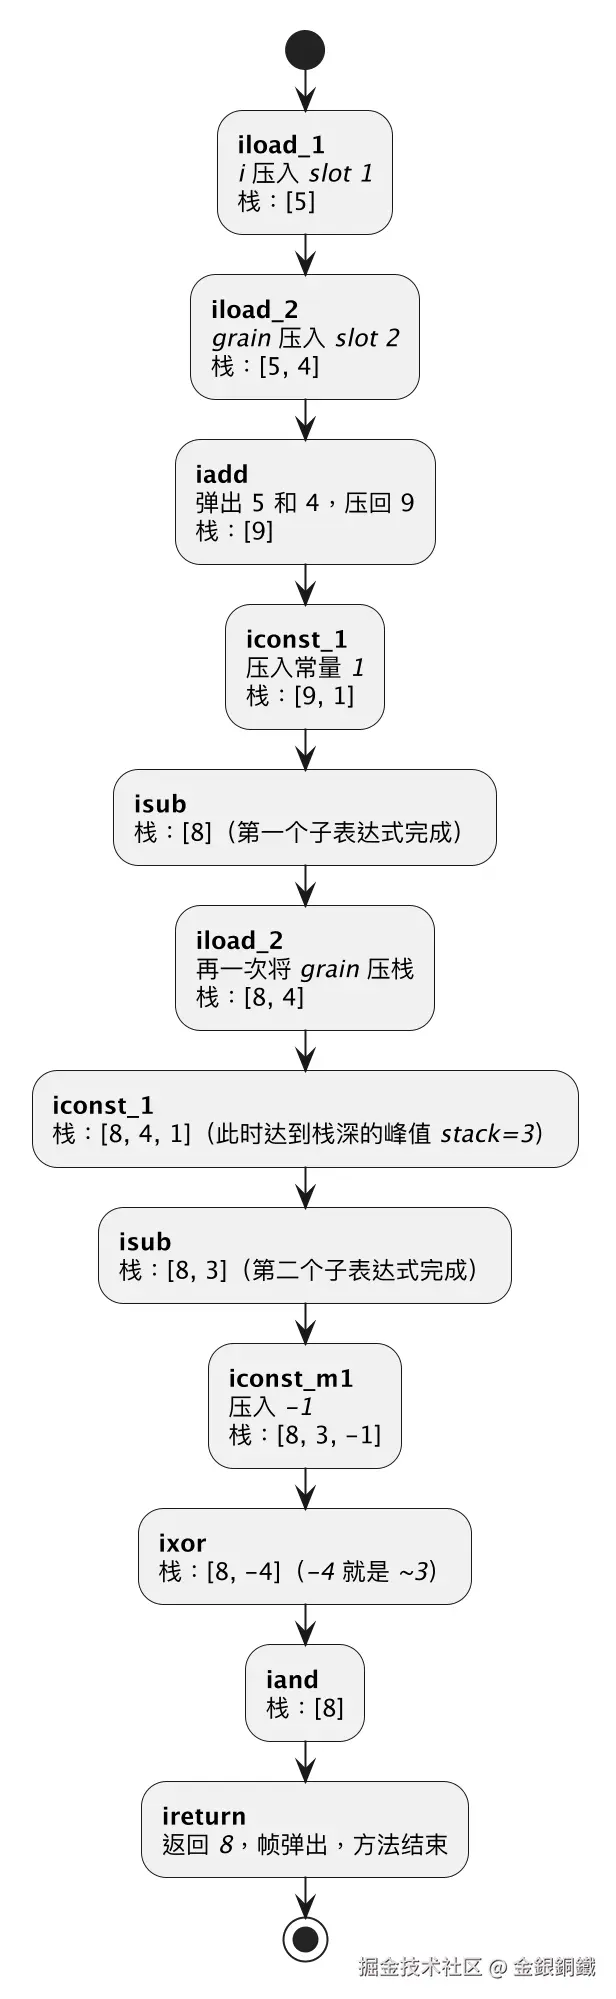
它是实例方法,所以 locals=3:slot 0 是 this,i 和 grain 从 slot 1、slot 2 开始,加载指令是 iload_1、iload_2。stack=3:两个子表达式要在栈上轮流搭,峰值到 3,后面第二张截图就是它。
先用一张流程图把 12 条指令串起来(PlantUML 源码)⬇️
一步一步看栈 ⬇️
iload_1、iload_2压入i和grain,iadd弹出两个,压回i + grainiconst_1、isub得到i + grain - 1- 再压一次
grain,iconst_1、isub得到grain - 1 iconst_m1压入-1,ixor算出~(grain - 1)(因为~x == -1 ^ x)iand把两半按位与,ireturn返回
每个子计算的结果都留在栈上,供外层使用。这就是"栈式机器":没有寄存器编号,只有压栈和弹栈。
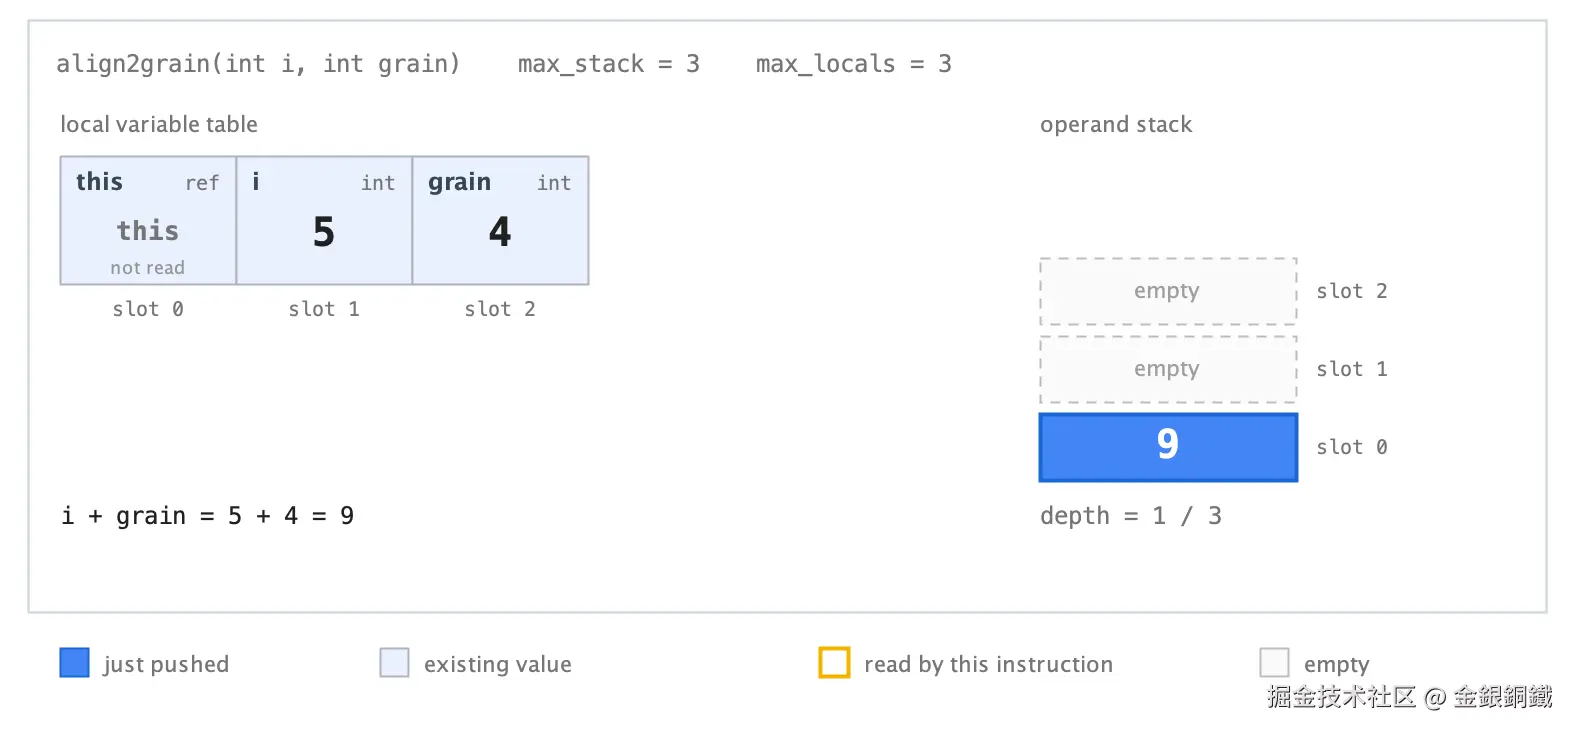
两张截图都取 i = 5、grain = 4。第一张:iadd 弹出 5 和 4,把 9 压回,栈上占 1 个 slot。
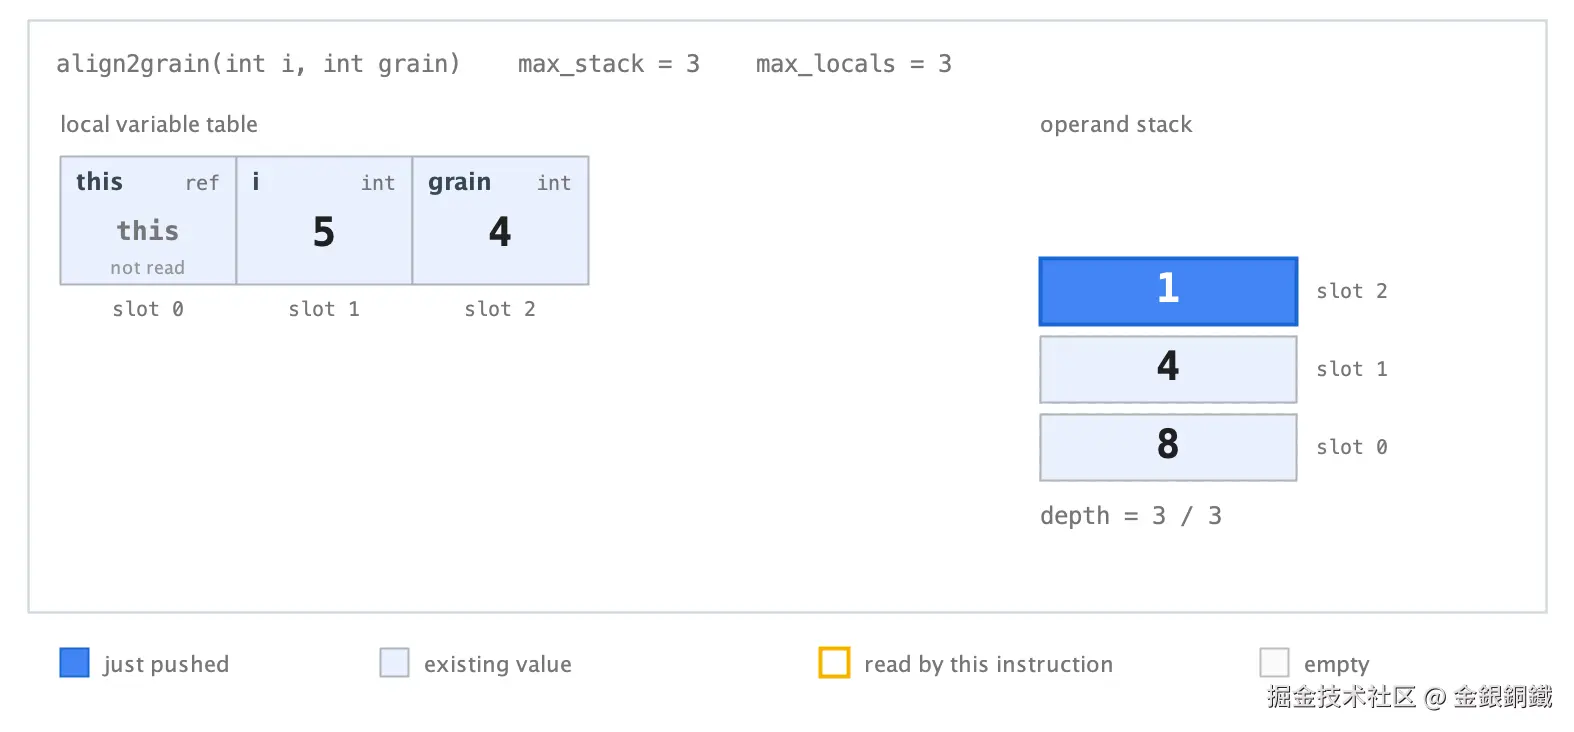
第二张是关键:第一个子表达式的结果 8 停在栈底,第二个子表达式在它上面继续搭,栈上占 3 个 slot,这正是 stack=3 的来源。iand 收拢之后只剩一个 8,ireturn 把它交给调用方。注意栈上的 1 不是从局部变量来的------常量直接由指令压栈,后面的 -1 同理。
同一行 a + b,四种指令
换一个更小的例子,四种类型各写一个 add ⬇️
java
public class Arith {
    public int add(int a, int b) { return a + b; }
    public long add(long a, long b) { return a + b; }
    public float add(float a, float b) { return a + b; }
    public double add(double a, double b) { return a + b; }
}
四种类型的产物对比 ⬇️
| 方法 | 指令 | stack= |
locals= |
|---|---|---|---|
add(int, int) |
iload_1、iload_2、iadd、ireturn |
2 | 3 |
add(long, long) |
lload_1、lload_3、ladd、lreturn |
4 | 5 |
add(float, float) |
fload_1、fload_2、fadd、freturn |
2 | 3 |
add(double, double) |
dload_1、dload_3、dadd、dreturn |
4 | 5 |
形状完全一样,只是前缀不同:i、l、f、d。
add(long, long) 的完整输出 ⬇️
text
  public long add(long, long);
    descriptor: (JJ)J
    flags: (0x0001) ACC_PUBLIC
    Code:
      stack=4, locals=5, args_size=3
         0: lload_1
         1: lload_3
         2: ladd
         3: lreturn
float 和 double 的产物只是把前缀换成 f、d。注意 dload_3 和上面的 lload_3 一样从 slot 3 取值:a 是 double,已经占掉 slot 1 和 slot 2,b 只能从 slot 3 开始。
规范 2.2 节解释了为什么不能只有一条加法指令 ⬇️
Instead, the instruction set of the Java Virtual Machine distinguishes its operand types using instructions intended to operate on values of specific types. For instance, iadd , ladd , fadd , and dadd are all Java Virtual Machine instructions that add two numeric values and produce numeric results, but each is specialized for its operand type: int, long, float, and double, respectively.
JVM 里的值不带类型标签。运行时不会检查这个值是 int 还是 float;类型信息在编译期就编码进了操作码。iadd 就是"两个 int 相加",ladd 就是"两个 long 相加",不存在"通用加法"。
严格说,类型信息并没有消失,只是提前用掉了:类加载时验证器(4.10 节)按字节码静态推断每个位置的类型,推断失败就拒绝加载。运行期的操作数栈上确实没有标签,正确性由指令本身保证。
类型不同时,先转换
iadd 只接受两个 int,ladd 只接受两个 long。如果一个是 int、一个是 long 呢 ⬇️
java
long add(int i, long l) {
    return i + l;
}
text
  long add(int, long);
    descriptor: (IJ)J
    flags: (0x0000)
    Code:
      stack=4, locals=4, args_size=3
         0: iload_1
         1: i2l
         2: lload_2
         3: ladd
         4: lreturn
i2l 把 int 转成 long,ladd 才有两个 long 可以相加。转换指令也带前缀,格式是"源类型 + 2 + 目标类型":i2l、l2i、i2f、d2i 都是这个规则。编译器必须显式插入转换,这是类型化指令集的直接代价。
这五行指令和第一篇动手题里把 add 改成 (int, long) 之后的输出一模一样------int 和 long 相加,int 先转换,在哪一行都一样。
顺带提一句栈深:iload_1 压入的 i 占 1 个 slot,i2l 执行后这 1 个 slot 变成 2 个;lload_2 再压入占 2 个 slot 的 l,栈上到 4 个 slot,即 stack=4。i2l 改的不只是类型,还有宽度------这正是下一节要说的。
指令名的前缀
看多了会发现,指令名的第一个字母就是类型 ⬇️
| 前缀 | 类型 | 例子 |
|---|---|---|
i |
int |
iload_1、istore_1、iadd、ireturn |
l |
long |
lload_1、lstore_1、ladd、lreturn |
f |
float |
fload_1、fstore_1、fadd、freturn |
d |
double |
dload_1、dstore_1、dadd、dreturn |
a |
reference |
aload_1、astore_1、areturn |
b |
byte |
baload、bastore |
c |
char |
caload、castore |
s |
short |
saload、sastore |
第一个字母说完了,剩下的部分说的是运算。同一套前缀配上五种算术,就是一张完整的矩阵 ⬇️
| 前缀 | 加法 | 减法 | 乘法 | 除法 | 取余 |
|---|---|---|---|---|---|
i |
iadd |
isub |
imul |
idiv |
irem |
l |
ladd |
lsub |
lmul |
ldiv |
lrem |
f |
fadd |
fsub |
fmul |
fdiv |
frem |
d |
dadd |
dsub |
dmul |
ddiv |
drem |
光这五种运算就有 20 条指令。它们的关系比名字看上去更近:iadd 和 isub 的栈行为完全一样------都弹出两个、压回一个,只是中间做的运算不同。所以两个维度各管一件事:类型 决定每个值占几个 slot,运算只决定弹出之后算什么。
算术也不止这五种:取负是 ineg、lneg,移位是 ishl、lshl,位运算是 iand、ior、ixor,命名规则一模一样。完整的清单在 6.5 节,这里只取最常见的五种做对照。
但不是每种类型都有全套指令。2.11.1 节的类型支持表里,int 一列最满;byte、char、short 没有标量 load、store、add,它们先提升成 int 再算,结果用 i2b、i2c、i2s 截回去。这也是为什么没有 badd、cadd、sadd。
还有一处容易看错:bipush、sipush 里的 b / s 说的是立即数 的宽度------bipush 带一个 8 位操作数,sipush 带一个 16 位操作数------不是栈上值的类型:它们压进栈的仍然是 int。
栈深:long 和 double 占两个 slot
前缀换了,栈深也跟着换。2.6.2 节定义过 ⬇️
At any point in time, an operand stack has an associated depth, where a value of type long or double contributes two units to the depth and a value of any other type contributes one unit.
所以同样是 a + b:
| 方法 | 指令 | stack= |
最深时栈上是什么 |
|---|---|---|---|
add(int, int) |
iadd |
2 | 两个 int,各占 1 个 slot |
add(long, long) |
ladd |
4 | 两个 long,各占 2 个 slot |
iadd 弹两个、压回一个,栈上净少 1 个 slot;ladd 弹四个、压回两个,净少 2 个。
配套 demo 把同一段代码的两种类型放在一起 ⬇️
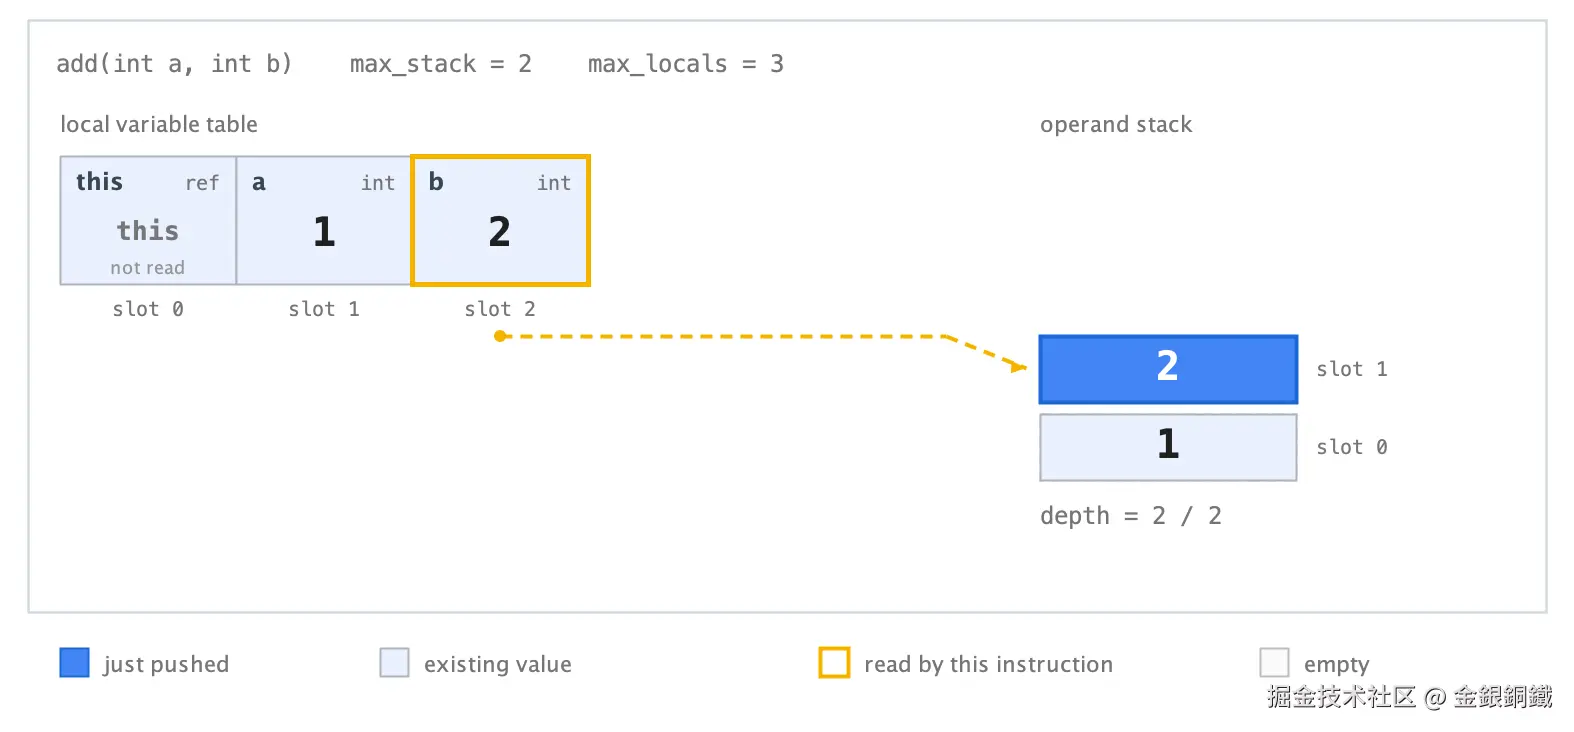
第一张:两个 int 在栈上,占 2 个 slot,即 stack=2。
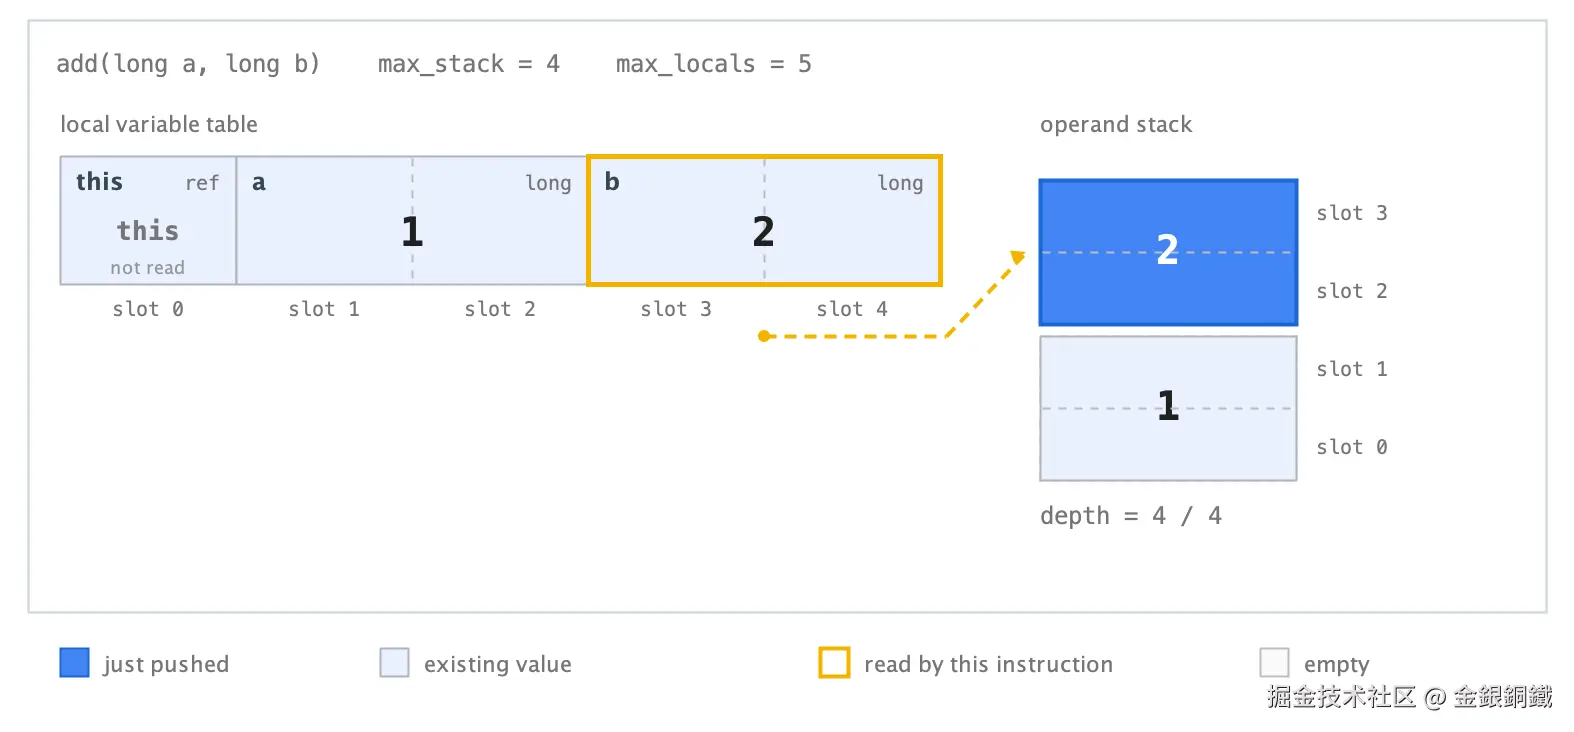
第二张执行的是同一行 a + b,只是类型换成了 long:左边局部变量表里,long 的参数占两个 slot;右边操作数栈里,long 的值也占两个 slot,栈上共 4 个 slot,即 stack=4。
iinc 只对 int 局部变量有效
3.3 节把 iinc 单独拿出来,就是因为它是算术指令里唯一不经过操作数栈的。
看两个 i++ ⬇️
java
void inc(int i) { i++; }
void inc(long i) { i++; }
text
  void inc(int);
    descriptor: (I)V
    flags: (0x0000)
    Code:
      stack=0, locals=2, args_size=2
         0: iinc          1, 1
         3: return

  void inc(long);
    descriptor: (J)V
    flags: (0x0000)
    Code:
      stack=4, locals=3, args_size=2
         0: lload_1
         1: lconst_1
         2: ladd
         3: lstore_1
         4: return
int 版一条 iinc 就够:slot 1 加 1,不碰栈。long 版没有 linc,只能把值压栈、加 1、再存回去。两个 stack= 把差别写到了明处:inc(int) 是 0------整条方法没有任何指令碰栈;inc(long) 是 4------栈上同时放过占 2 个 slot 的两个 long。
配套 demo
以下截图来自配套的 ArithmeticDemo.java:一个 Swing 窗口,用下拉框在 add(int, int)、add(long, long) 和 align2grain(int, int) 之间切换,单步观察局部变量表和操作数栈的变化;前两项对照类型前缀,第三项就是 3.3 节的例子。下载后运行(需 JDK 16+,用到了 record;本文用 JDK 21)⬇️
bash
javac ArithmeticDemo.java
java ArithmeticDemo窗口上方可以切换方法、调整参数取值,Step ▶ 单步执行,Run 自动播放剩下的指令,Reset 回到刚建帧的状态 ⬇️
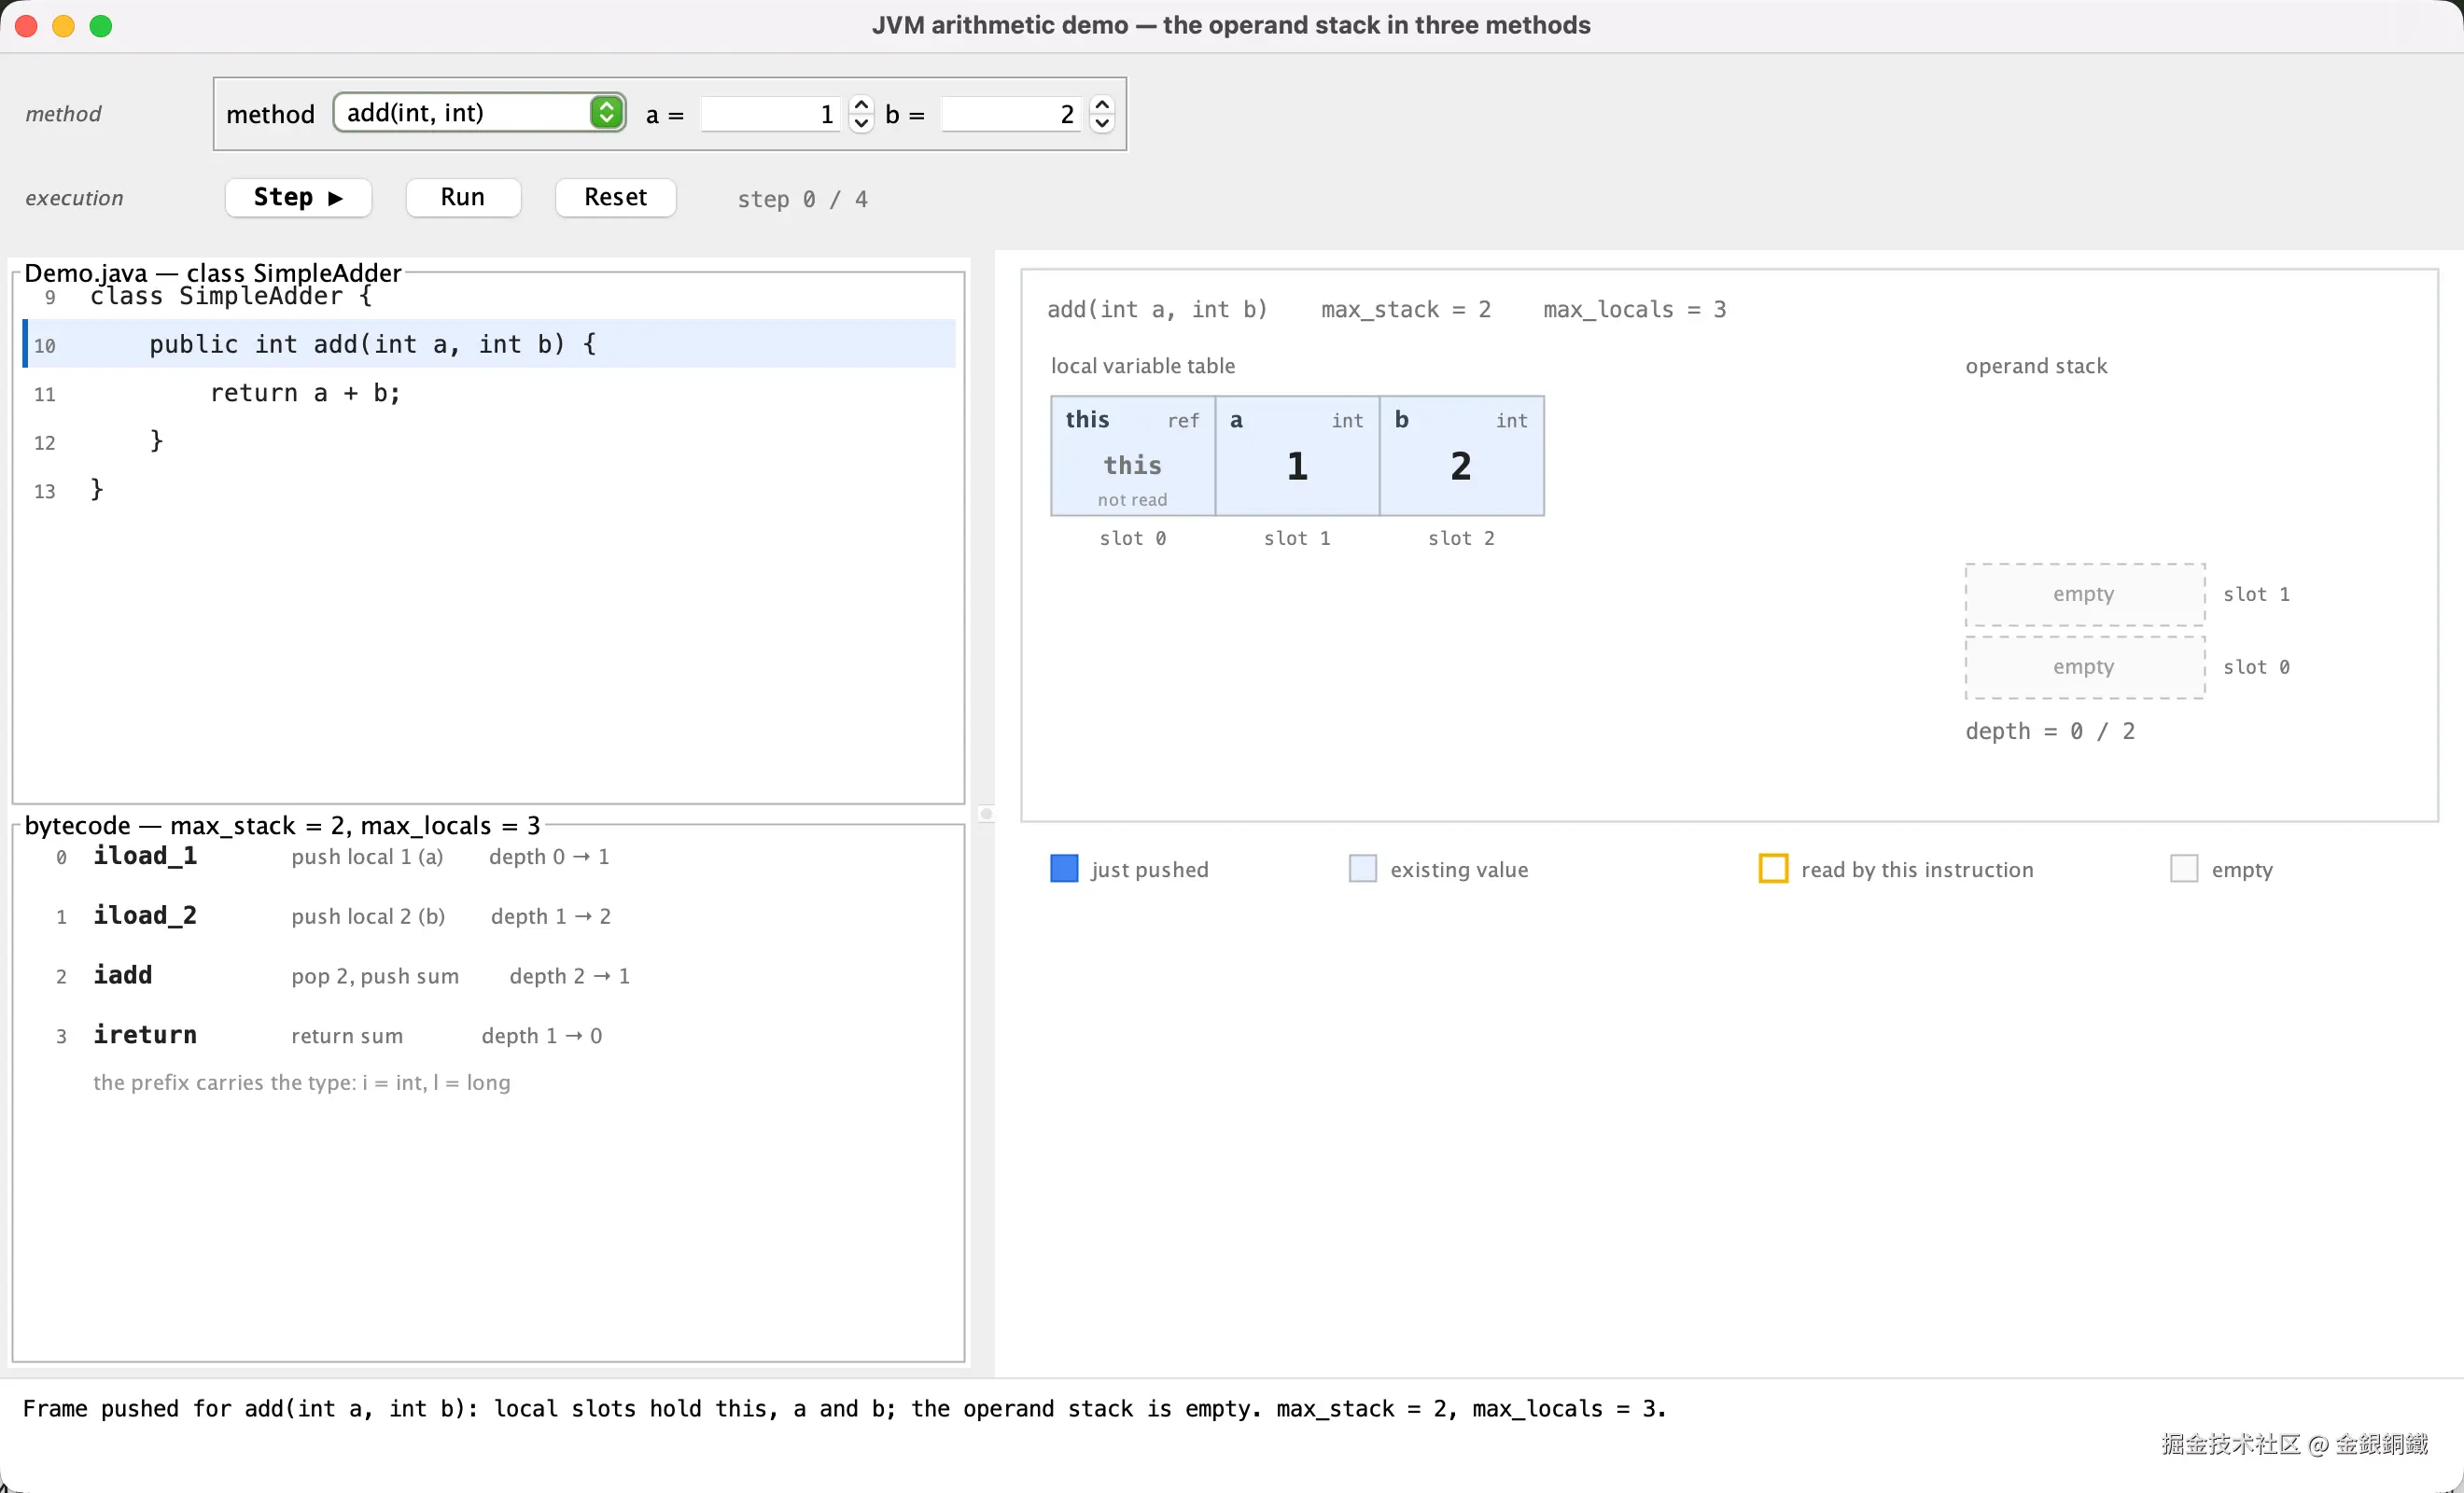
上图是完整的运行窗口:上方工具栏负责切换方法和调整参数,左边是源码和字节码(一次只显示当前选中的方法),右边帧面板(局部变量表 + 操作数栈)就是前面四张截图的画面;切换方法后,指令和源码高亮都会跟着换。
蓝色表示本步写入或压入的值,琥珀色边框表示本步读取的 slot。
demo 只放了 int 和 long 两种 add,因为宽度只有两种:float 与 int 同宽(占 1 个 slot),double 与 long 同宽(占 2 个 slot)。前缀换了,栈上的形状不变,再补两个方法也只是重复同一种画法。
数字对照
| 数字 | 含义 | 在 add(long, long) 里 |
|---|---|---|
locals=5 |
局部变量表的 slot 数 | this 1 + a 2 + b 2 |
stack=4 |
操作数栈的最大深度 | lload_3 之后栈上的两个 long |
args_size=3 |
参数个数(不是 slot 数) | this 也算一个参数 |
args_size=3 与 locals=5 含义不同:add 是实例方法,this 也算一个参数;a、b 虽然只有两个参数,却各占两个 slot。第一篇的 add(int, int) 里两者碰巧相等(都是 3),这里就分开了------locals 是 slot 数,args_size 是参数个数,这条从第一篇贯穿到这里。
留一道动手题:给 Arith 加一个 public int add(byte a, byte b) { return a + b; } 再 javap 一下------指令是什么?为什么没有 badd?
下面是参考答案,建议先自己动手试试再往下看。
text
  public int add(byte, byte);
    descriptor: (BB)I
    flags: (0x0001) ACC_PUBLIC
    Code:
      stack=2, locals=3, args_size=3
         0: iload_1
         1: iload_2
         2: iadd
         3: ireturn
指令和 add(int, int) 完全一样:byte 一上栈就被提升成 int(2.11.1 节),算术用的自然就是 int 那套指令。参数的 byte 类型只剩方法描述符里的 (BB) 还能看出来------运算时它已经是 int 了。
小结
- 算术在操作数栈上做 :弹出操作数,压回结果;
iinc是唯一直接改局部变量的例外。 - 指令名是"类型 + 运算" :前缀
i、l、f、d对应int、long、float、double,后半截才是运算,所以有isub、lmul、drem。 - 没有通用加法 :
iadd、ladd、fadd、dadd是四条指令,类型在编译期定死。 - 栈深由类型决定 :
int占 1 个slot,long/double占 2 个,所以add(long, long)的stack=是 4。 iinc只对int局部变量有效 :long的i++要拆成lload+ladd+lstore。
下一篇看 3.4 节的运行时常量池访问:ldc、ldc_w、ldc2_w 分别取什么,以及 100 和 1000000 为什么走不同的指令。