原文:mp.weixin.qq.com/s/XlJoIj-Tx...(2026年10月02日)
 前两篇讲的是"怎么记"。可记忆和知识一旦多起来,新的难题就冒出来了:需要的时候,怎么快速找到相关的那几条?
你大概遇到过这种情况:大模型知识渊博,却不知道你公司这周刚更新的退款政策;它的训练数据停在某个日期,而现实一直在变。解决办法叫 RAG(Retrieval-Augmented Generation,检索增强生成)------把模型的思考能力,和外挂知识库的广度、时效结合起来。下面,就把它拆开看。
一、RAG 的三步:检索 → 增强 → 生成
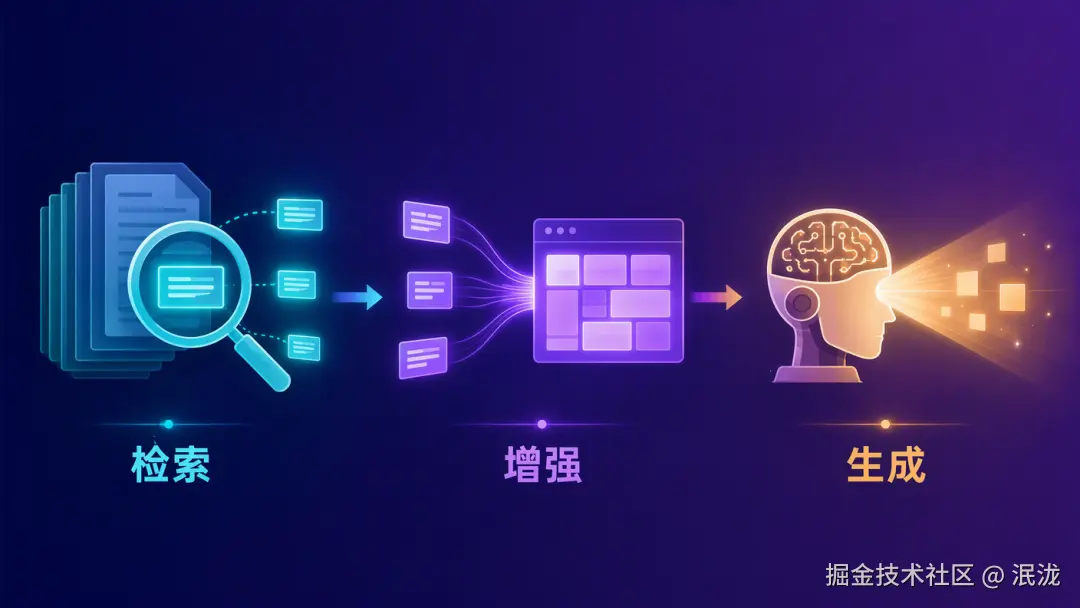
先看它最朴素的样子。用户问:"我买的东西想退款,流程是什么?"系统大致做三件事:从知识库里检索 出相关片段,把这些片段注入 模型的上下文,让模型基于片段生成答案。
python
query = "退款流程"
results = retriever.search(query, top_k=2)
# 命中:
#  "退款政策:订单签收后 7 天内可申请全额退款,需提供订单号......"
#  "退款操作步骤:1. 进入'我的订单' 2. 选择订单 3. 点击'申请退款'......"
answer = llm.generate(system="你是客服助手。", context=results, question=query)
关键在于,模型回答时手里有了"最新的那几页资料",而不是凭记忆瞎编。下面顺着数据流动的顺序,看三个核心环节:文档怎么切开(分块),怎么"按意思"和"按字面"去检索(稠密与稀疏),两条路又怎么合到一起(混合检索)。
二、第一步:把文档切开(Chunking)
在能检索之前,还有一道离线工序------分块 :把长文档切成适合独立检索的小片(chunk)。为什么必须切?两个原因。一是嵌入模型对输入长度有限制,而且整篇文档压成一个向量时,多个主题混在一起,向量反而说不清任何一个主题。二是检索的目标是只把相关的那部分塞进上下文,块太大就会带进一堆无关内容,既浪费窗口,又稀释注意力。
常见策略有三类:固定大小切分 (按固定 token 数切,块间留一点重叠,实现简单但会拦腰截断段落)、递归/结构感知切分 (按标题、段落、句子这些自然边界递归地切,是生产系统最常用的默认选择)、语义切分(算相邻句子的相似度,在语义"断崖"处下刀,质量更高但更费算力)。
块太大太小都不好:太小,单块信息残缺("该公司收入增长 3%"------哪家公司?哪个季度?);太大,一个块混多个主题,检索变糊。常见起点是每块 256--1024 token、相邻重叠 10%--20%,再按实测调。
这里还埋着一个伏笔:无论哪种切法,都会切断片段与原文档的联系------"该公司"指代谁、这段话出自哪份报告,这些信息留在了块外面。这个"孤儿分块"问题,第五篇会正面解决。
三、第二步的两个引擎:稠密 vs 稀疏
检索器有两条技术路线,一个靠"意思像不像",一个靠"词对不对得上"。
稠密嵌入:理解语义
计算机看不懂"苹果"是什么意思。嵌入(Embedding) 的思路是:把每个词或句子变成一串数字(向量),并且让语义相近的内容,变出来的数字串也相近。可以把它想成一张高维地图,每个句子是地图上的一个点,意思越近,点越靠。
怎么衡量两个向量有多近?常用余弦相似度------看两个向量的夹角,越接近 1 越相似:
为什么用夹角而不是距离?因为我们关心方向(语义是否相近),而不是长度(文本长短或词频高低)。两篇内容相同但长短不同的文档,向量长度不同、方向一致,余弦相似度能正确判断它们"是一回事"。
这项技术也在进化。早期的 Word2Vec 只能捕捉词的共现关系,给 "bank" 一个固定向量,分不清"河岸"和"银行"。而 BERT、BGE-M3 这类上下文感知模型,会把整个句子纳入考量,同一个词在不同语境里得到不同的向量------从"词汇级"语义跃迁到了"语境级"。
当知识库有上百万条,逐一算相似度太慢,就需要 ANN(近似最近邻) 索引来加速------先用一个巧妙的索引结构筛出"可能最像"的一小撮,再精确比对。两个主流实现是 ANNOY (基于树,构建快、省内存,但不支持增量更新)和 HNSW(基于图,内存高但精度极高,支持动态增删)。选型上,数据不常变就用 ANNOY,要实时加新内容就用 HNSW。
稀疏嵌入:精确匹配关键词
稀疏嵌入走的是另一条路,根子在传统信息检索------精确的关键词匹配 。它把文档表示成一个超高维向量,绝大多数维度是 0,只有出现的词对应维度非 0。理论起点是词袋模型:只数哪些词出现了、出现几次,完全不管顺序(所以"猫追狗"和"狗追猫"在它眼里一模一样)。
在此基础上演化出 TF-IDF:一个词在当前文档里出现得越多、在整个语料库里越少见,它就越重要。
但原始 TF 有个毛病:词出现 10 次就得 5 次的整整两倍,长文档也容易仅因为字多而得分虚高。BM25 是对这两个毛病的经典修正------它引入"词频饱和"和"长度归一化":
直觉没变,还是"词越稀有越重要",但有了两个旋钮: k_1 控制词频饱和速度(重复出现的边际贡献递减), b 控制长度归一化的强度(长文档不吃亏)。
稀疏检索的实现依赖倒排索引------一张"从词到文档"的反向映射表。普通索引是"给定文档,列出它含哪些词",倒排索引反过来:"给定一个词,立刻找到所有含它的文档"。它像书末的术语索引页:你查 TCP,它告诉你第 45、112、203 页提到过。
稀疏检索的长处和短处都很鲜明:查技术代码、人名这种精确词,它特别准;但它读不懂同义词------你搜 "kitty",它找不到只写了 "cat" 的文档。
四、第三步:把两个引擎合起来
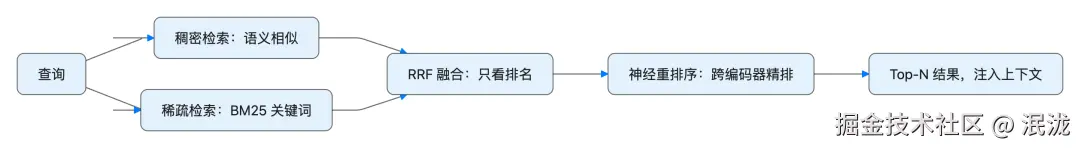
既然稠密懂语义但会漏关键词,稀疏精确但读不懂同义词,那干脆两个都跑,结果合并 ------这就是混合检索。难点在于:两路得分没法直接比。稠密的余弦相似度通常落在 0--1,稀疏的 BM25 可能是 0 到几十,尺度和分布完全不同。
一个常用且稳健的融合方法是 RRF(倒数排名融合):彻底抛开原始分数,只看排名,每个文档的综合得分是它在各路里排名倒数之和:
其中常数 k(常取 60)用来压低排名最靠前几位之间的差距。RRF 简单稳健,但只用了排名信息,丢掉了原始分里的相关性信号。
所以流水线还有第三个阶段------神经重排序 。它换了一种更强的匹配范式:让跨编码器 把查询和候选文档拼在一起逐字比对,精度远高于检索阶段双编码器 各算各的。打个比方,双编码器像让猎头看简历做初筛(快、能处理海量),跨编码器像面试官和候选人深谈(慢、但准)。做法是:从融合后的候选池里挑靠前的几十个逐一精排,得到最终顺序。注意重排序不替代融合------融合负责产生统一候选池,重排序负责在这个池子里精排。
 怎么知道这条流水线调得好不好?三个常用指标:recall@k (该找的有没有进前 k 个结果里)、MRR (第一个相关结果排得多靠前)、nDCG(整个排序列表的质量)。
小结
RAG 的逻辑其实很朴素:把大模型的"脑子"和外挂知识库的"资料"接起来。第一步分块把文档切成可检索的小片;第二步用稠密(懂语义)和稀疏(认关键词)两套引擎去检索;第三步用混合检索和重排序把两路结果合成一份高质量候选。
但这套"扁平化"的检索,很快会撞到天花板------有些问题它天生答不好,比如"知识库里黑猫白猫各占多少"。下一篇,就来看知识如何"长出骨架":RAPTOR、GraphRAG,以及一个把整个上下文做成"文件系统"的开源项目 OpenViking。
🔗
延伸阅读(开源项目) :嵌入模型可用 BGE-M3 (BAAI,支持稠密+稀疏+多向量);重排序用 bge-reranker-v2-m3 ;ANN 索引有 hnswlib 与 annoy ;想从零理解 BM25,可搜教学项目 rank_bm25。它们对应书里 chapter3 的 dense-embedding、sparse-embedding、retrieval-pipeline 实验。