原文:mp.weixin.qq.com/s/zVrNCMMwO...(2026年09月27日)
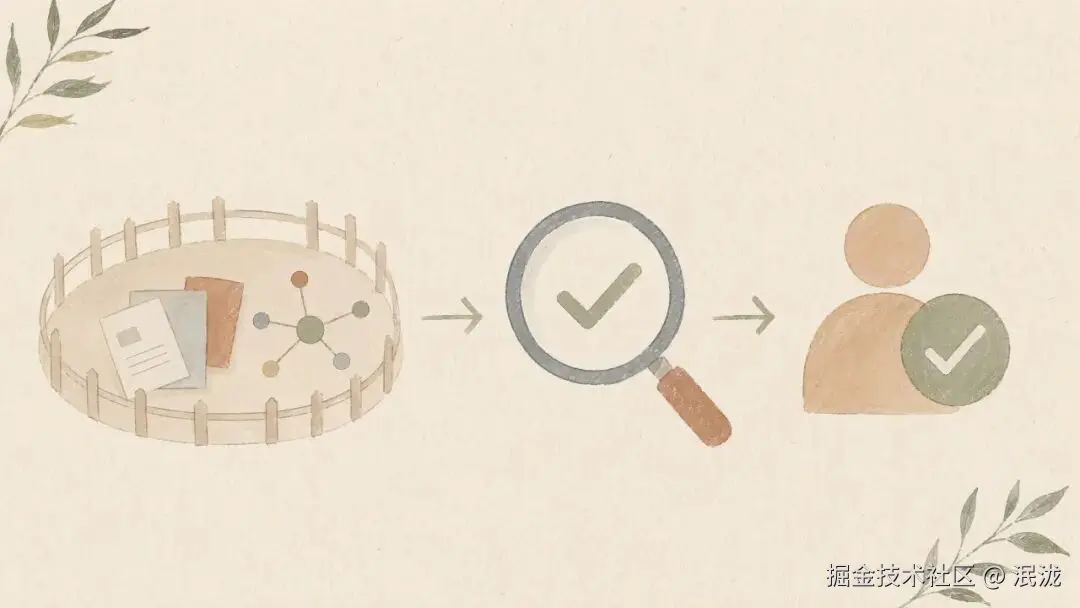
TL;DR:能执行的 Agent,难点不在"能做多少",而在行动前划定范围、行动后验证结果、不确定时把决定权交还人类。
读错一份文件,可以重新读;把错误邮件发给客户,却很难像撤销本地编辑那样收回。
AI Agent 是能分步骤使用工具完成任务的助手;读文件是感知 ,改文件、建订单、发消息则是执行 。执行会留下副作用------也就是让外部世界真的发生变化。比如客服让 Agent 草拟退款邮件与让它直接发给客户,表面只差一个按钮,风险却完全不同。
因此,在执行前先要划出范围:它只能改获准修改的文件,不能仅凭一句含糊指令访问所有资料;付款、发信等动作还要控制权限。系统可以用危险命令黑名单挡住一些显眼错误,但换个写法就可能绕过。
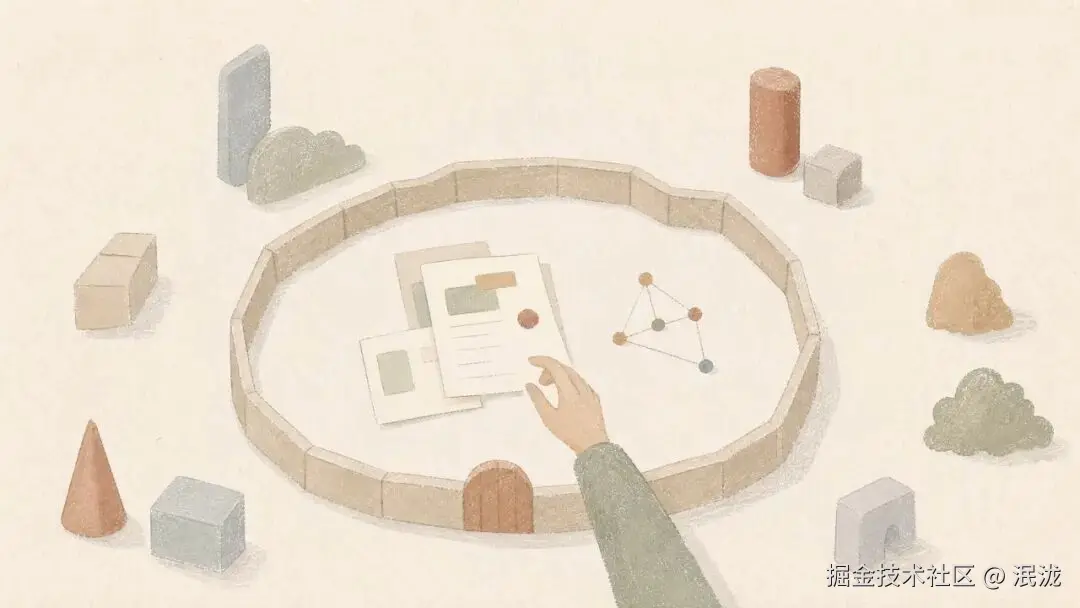
还有一个常见误解:电脑里的 Python"虚拟环境"只是把程序依赖分开,不会限制代码读取文件或访问网络。真正的沙盒更像有围墙的实验室,限制程序能碰到的文件、网络和资源;风险越高,围墙和人工审批就该越严格。
 简报
审核不是让模型说一句"我检查过了"
本节要点:审核看的是具体动作,不是让另一个模型口头背书;高风险或无法判断时,仍要交给人。
给高风险动作多加一道检查,可以有两种"第二视角"。
一种叫提议者---审核者:就像报销先由经办人填写、再由另一人审核,Agent 提议发信或改关键文件,另一个独立视角在执行前检查是否合理;执行后还可以看实际结果是否符合要求。
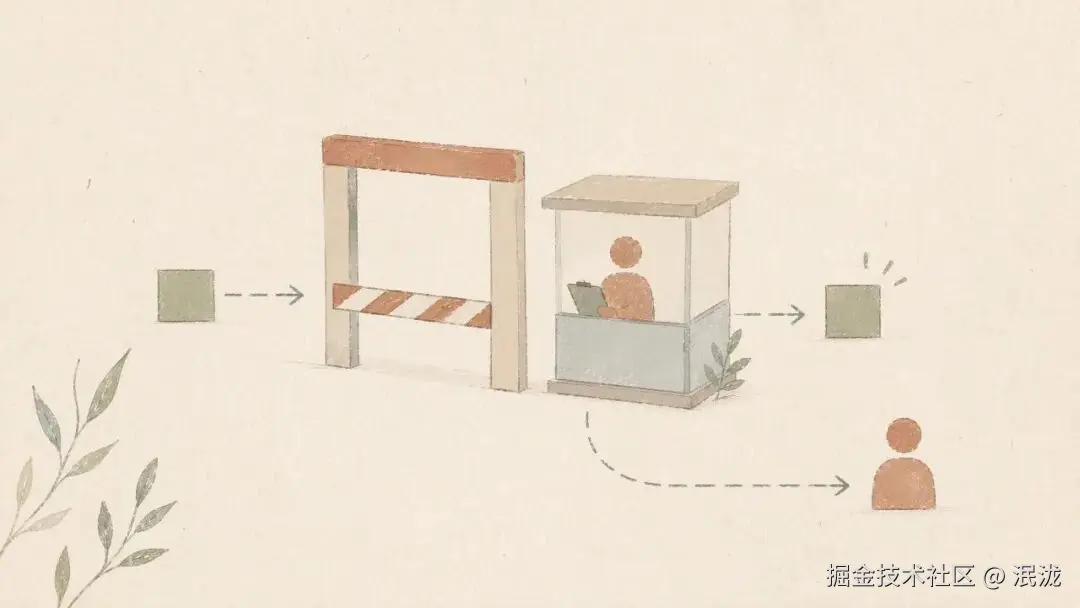
另一种叫 Sidecar ,可理解为伴随 Agent 工作的小型安全门卫:主 Agent 刚提出"调用什么工具、传什么参数",门卫便判断这次动作的风险。检查可以与主 Agent 后续的文字生成并行,但这次动作必须等放行后才能执行。
门卫看的是具体动作,不是让另一个模型凭一句"我检查过了"背书;遇到高风险或无法判断的情况,仍要交给人。
 动作做完还得验。假设 Agent 更新了给客户看的报价表,仅返回"文件已保存"远远不够;还应核对金额公式、文件能否打开,必要时让负责人看过。对代码,也可以自动做语法检查,把错误位置返回给 Agent。原则很朴素:按下按钮成功,不等于事情做对了。
更危险的是"看起来失败"。例如 Agent 点击创建订单,页面转圈后显示超时。订单可能已经创建,只是确认消息没传回来;这时再次点击就可能出现两笔订单。
防重复的一种办法是给同一笔操作一个唯一编号,让系统识别"这是刚才那一次";另一种是先查订单状态,再决定是否重试。这类重复执行不会改变最终结果的设计,叫幂等性。
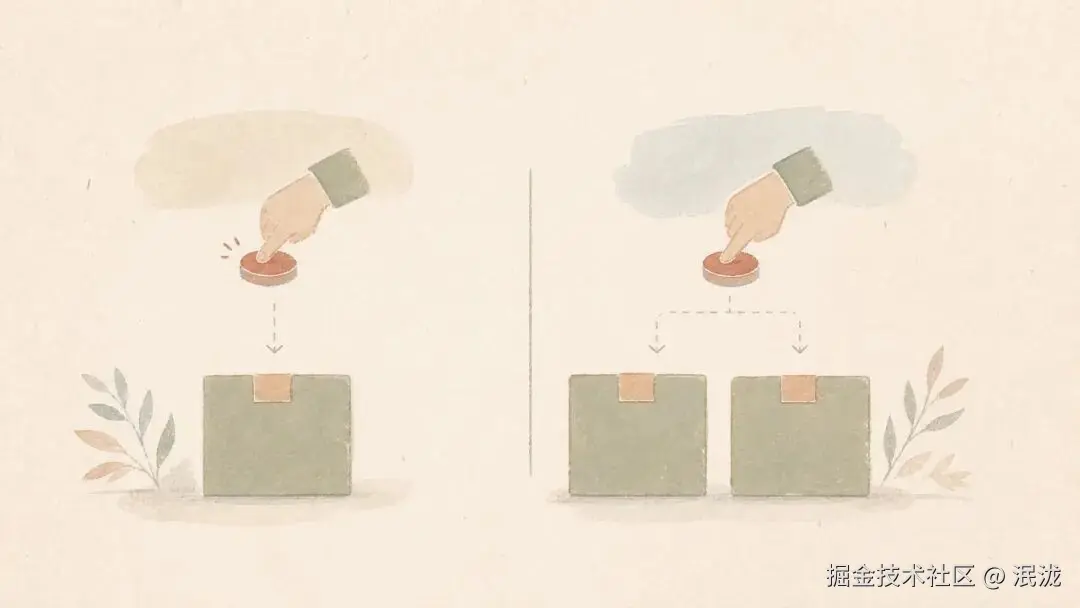 发邮件、转账这类会产生外部事件的操作,尤其不能把"没收到成功回执"直接当成"没发生",应先核实,再由人或受控流程决定下一步。
简报
协作是在传递责任,不只是拆分任务
本节要点:拆分任务的同时要指定责任------谁核实、谁拍板;沉默不等于批准。
复杂任务可以交给子 Agent:也就是由主助手分配明确小任务的另一个 AI 助手。比如准备客户提案时,一个查行业资料,一个整理已有销售数据;主 Agent 还得规定"只交付找到的证据,不得自行发给客户",并明确由谁核实数据。否则两个助手都以为对方做了检查,错误就会汇进最后的提案。
需要负责人拍板时,让人进入流程,叫 HITL(人在回路);若负责人没回复,默认应继续等待或停下,而不是把沉默当批准。
看开源项目时,也别把"项目有代码"误读为"所有场景都验证通过"。这个项目的实验总览记载:execution-tools 的 20 次正式调用中,15 项验证要求已通过 13 项,真实日历和邮件所需的授权仍是阻塞项。
前面提到的客户邮件与订单都是帮助理解风险的假设例子,不是这套项目已经完成的实验。看任何 Agent 演示,都值得追问:是设计方案、实际运行结果,还是仍需授权后才能验证的能力?
能干活的 Agent,不是把所有动作都自动化;它应当在行动前辨认风险,在行动后验证结果,在不确定时保留交还人类的出口。