2026-11-15,开发者 mizoko 在 dev.to 发表了《I Tested Three Claude Code Review Skills for Six Months. The Simplest One Won.》。过去半年里,他为一个移动端 App 和一个后端写了三个审查 PR 的 skill(skill 是 Claude Code 里可复用的指令包),攒下上千条审查评论并逐一核对。
在看最终结论之前,先把文中用到的统计范围和几个核心指标怎么算说清楚(作者在统计前先定死定义,中途不改):
- 统计范围:只纳入已合并、且 PR 作者回复过评论的 PR。
- 修复率 :已修复的评论数 ÷ 这个 skill 发出的评论数。「已修复」指代码确实因为这条评论改了,作者根据之后的回复和提交判断。例如,
review-pr发了 354 条评论,其中 244 条已修复,修复率就是 68.9%。 - 错误评论比例:说错了的评论占这个 skill 全部评论的比例。作者没有给「错误」单独下定义;文中能看到的例子是 8 月那几条:指向的代码已经被更早的提交修掉、把有意为之的行为当成了问题、依据了一个错误的先例后来撤回。
- 每个 PR 评论数:平均每个 PR 收到这个 skill 的几条评论。
- 「正确但优先级低」与「超出这个 PR 的范围」:作者把没修的评论按原因拆开后得到的两类------评论本身没说错,但不急,或者不属于这个 PR 要解决的事,所以没改。比例按这个 skill 的全部评论算。
按这套口径算下来,结果很直接:三个 skill 的错误评论比例都在 10% 左右,但最简单的基础款 review-pr 修复率最高,达到 68.9%;堆了最多并行子 agent 的 deep-review 修复率垫底,只有 59.2%。半年后留下来的只有最简单的那个,按计划定时跑;复杂的和专抓细枝末节的都停了。
三个审查 skill 的做法与 1,306 条评论来源
mizoko 在半年里实际跑的三个 skill 复杂度差异明显:
review-pr:基础款,直接在 PR 上逐行评论。deep-review:最复杂的一款,按「审查视角」并行跑子 agent,一个视角一个,视角数量从 11 个一路加到了 14 个。原文没写deep-review有没有对候选评论做验证、去重或排序这一步。nitpick-pr:只发细枝末节(nit 级别)的评论。
统计期为 2026-04-01 到 2026-11-13,期间共产生 1,691 条评论,按上述统计范围共纳入 1,306 条。这 1,306 条里有 470 条(占 36%)分不清具体是哪个 skill 发的,下面每个 skill 的数字都受这一条影响。
三个 skill 错误率都在 10% 左右,review-pr 修复率 68.9% 最高
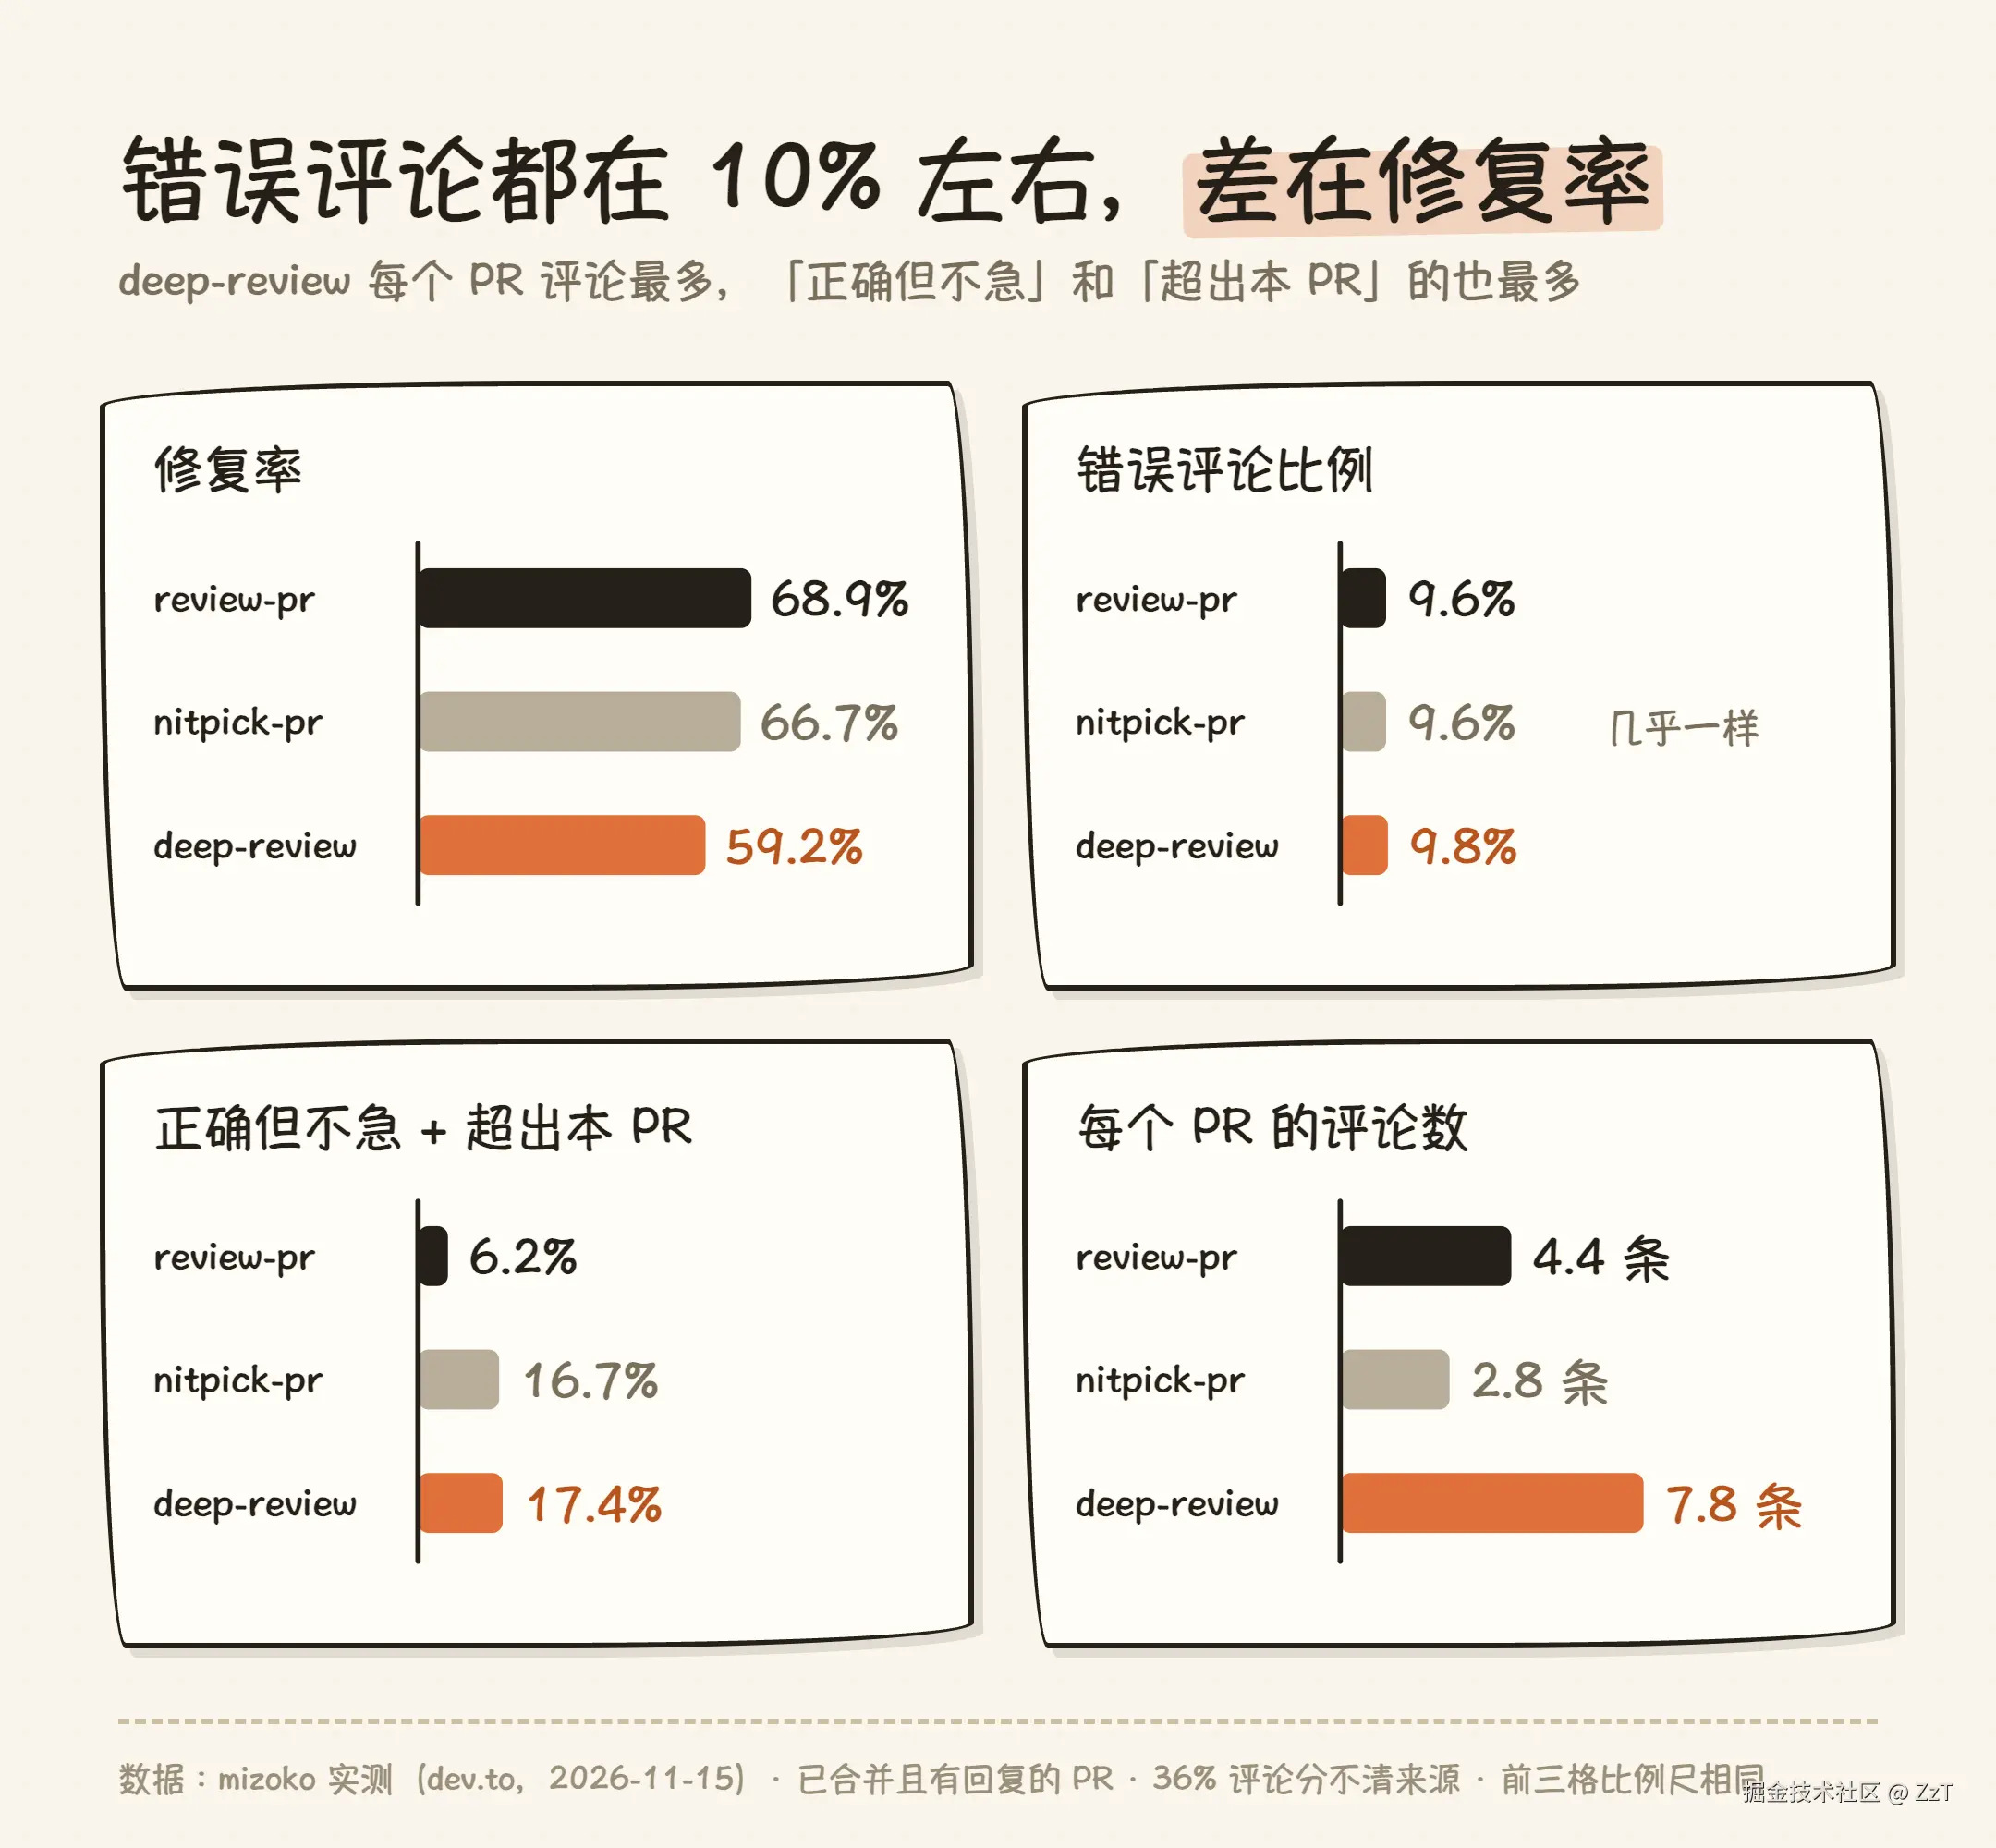
按上述口径拆开后,三个 skill 的统计结果如下:
| Skill | 评论数 | 每个 PR 评论数 | 已修复 | 修复率 | 错误评论比例 |
|---|---|---|---|---|---|
| review-pr | 354 | 4.4 | 244 | 68.9% | 9.6% |
| nitpick-pr | 114 | 2.8 | 76 | 66.7% | 9.6% |
| deep-review | 368 | 7.8 | 218 | 59.2% | 9.8% |
| 合计(含分不清来源的) | 1,306 | 9.7 | 789 | 60.4% | 11.2% |
最复杂的 deep-review 修复率最低。与此同时,三个 skill 的错误评论比例分别是 9.6%、9.6% 和 9.8%(含分不清来源的合计为 11.2%),都在 10% 左右,所以修复率的差距并不是准确率造成的。
mizoko 表示,这个结果和他的日常感觉一致:review-pr 一直像是留下最有用评论的那个。真正让他意外的不是排名,而是按定死的标准重新数一遍后,日常感觉站住了。
deep-review 每个 PR 评论 7.8 条,17.4% 低优先级或超范围
错误率几乎一样,跑了 14 个并行视角的 deep-review 输在了哪里?mizoko 把所有「没修」的评论按原因拆开后,差异非常清楚:在 deep-review 的全部评论里,「正确但优先级低」和「超出这个 PR 的范围」两类合计占到 17.4%;同样两类在 review-pr 里是 6.2%,在 nitpick-pr 里是 16.7%。
评论密度也拉开了差距:deep-review 平均每个 PR 发 7.8 条评论,review-pr 是 4.4 条,前者约为后者的 1.8 倍。作者的解释切中要害:一条正确的评论,如果不属于这个 PR,照样会被忽略;一旦数量多起来,连其余本来有用的评论也会变成噪音。
review-pr 在 8 月出现 15 条错误评论,8 条集中在两个 PR
赢下对比的 review-pr 也并非全程平稳。8 月份,它的错误评论突然变多,单月共出现 15 条,其中 8 条集中在两个 PR:
- 一个移动端 PR 里,3 条评论指向的代码已经被更早的提交修掉了,另有 2 条把有意为之的行为当成了问题。
- 一个后端 PR 里,3 条评论依据了一个错误的先例,后来撤回。
9 月以后,review-pr 的错误率回到了 0% 到 5.6% 之间。由于作者没有记录当时改了什么,复盘时也没有强行去猜原因。
nitpick-pr 修复率 66.7%,但只查格式问题被完全停用
单看表格,nitpick-pr 的修复率达到 66.7%,排在第二,错误评论比例同样是 9.6%。但 mizoko 完全停用了它------因为它的评论都是格式层面的,发现不了严重问题。用他的原话说,修复率高和值得跑是两回事。顺手改掉格式小问题很容易推高修复率,却产不出核心质量价值。
统计的三条局限,以及用合并后 30 天修复回溯漏报
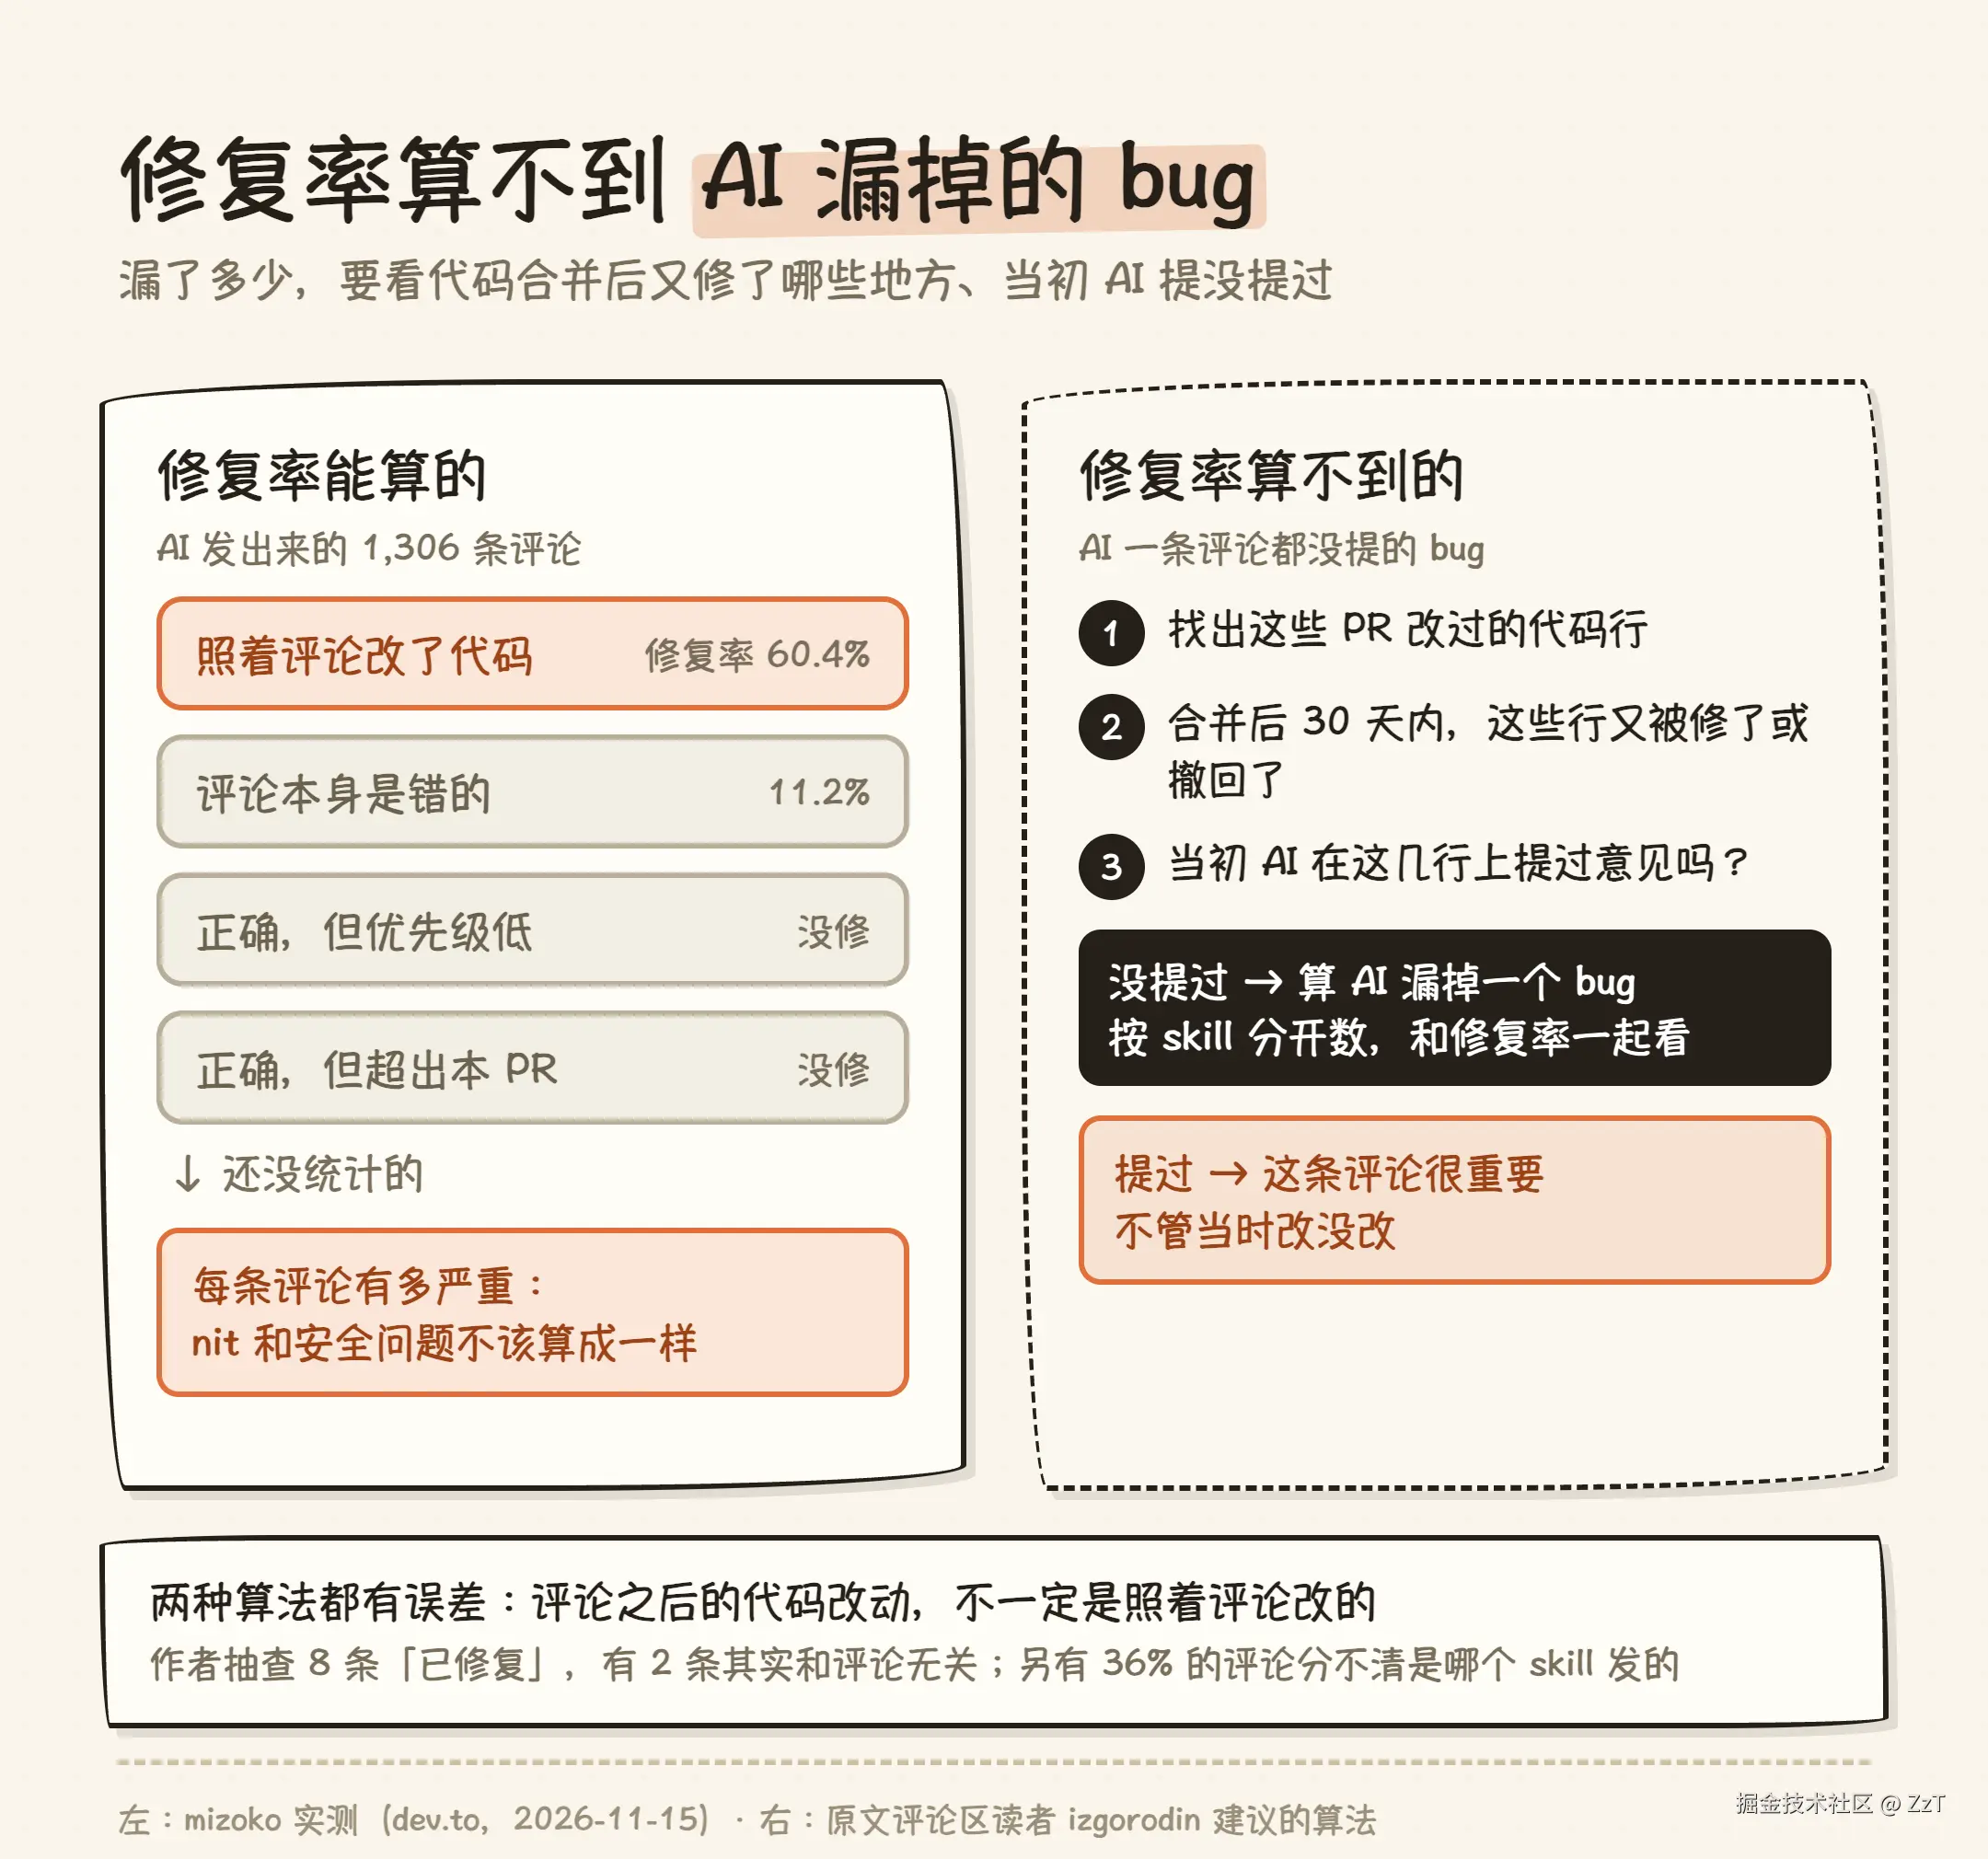
mizoko 自己列出了这组实测数据的三条局限:
- 只统计「已合并且有回复」的 PR,会让算出来的修复率比统计全部评论时偏高。
- 「已修复」的判断有噪音:抽查 8 条判为已修复的评论,发现有 2 条的代码改动其实和评论无关。
- 36% 的评论分不清来源,8 月份尤其多。
评论区的两条回复进一步补齐了评估盲区。读者 nilesharma0108 指出,修复率加上误报率,比单看发现了多少问题更能说明问题;他建议再按严重程度分开统计,免得一条无关紧要的 nit 和一个正确性或安全问题算成一样,并追问能不能追踪被审查者推翻的评论、被回滚的修复,来估计一条评论的长期价值。
读者 izgorodin 则点出了表格之外的另一半:修复率和错误率看的都是「已经发出来的评论」,而作者文末提到的「每条评论有多严重」还有另一面在两列里都看不见------三个 skill 都没评论到的问题。一个 skill 可以评论得更少、更好,却和别的 skill 漏掉同样的 bug,表里什么也显示不出来。
izgorodin 给出了具体的漏报数法:对统计期内已合并的 PR,找之后 30 天内修复或回滚这些 PR 改过的行的提交,再看当初有没有审查评论碰过这些行;有修复、却没有评论落在这些行上,就算一次漏报。按 skill 拆开后,就能得到一个与修复率对照的指标;同时,一条评论如果落在后来需要紧急修复的行上,不管 PR 作者当时有没有采纳,它就是严重的。不过他也提醒,这套数法同样受 36% 分不清来源的限制;而且抽查里 8 条有 2 条改动和评论无关,说明「已修复」和「漏报」两边有同一个风险:评论附近的提交,不一定是因为评论才改的。
Claude Code 官方审查与 OpenAI Codex 的过滤和控量做法
对照 deep-review 暴露的问题------多子 agent 并行却缺过滤、超范围问题混入当前 PR、nit 干扰注意力------再看官方与主流工具的设计,能看清成熟方案是怎么收敛噪音的。
根据 2026-11-16 读取的 Claude Code 文档,Anthropic 面向 Team 和 Enterprise 计划提供的托管服务 Code Review(用于 GitHub PR 自动审查),流程明确分为四步:多个 agent 并行检查 diff 和周边代码 → 验证步骤对照代码检查候选问题、过滤误报 → 剩下的去重、按严重程度排序 → 发到 PR 上。
在审查范围与颗粒度上,托管版 Code Review 做了几处针对性约束:
- 默认聚焦正确性:文档原话为「bugs that would break production, not formatting preferences or missing test coverage」。
- 三档严重级别:分为 🔴 Important(合并前应该修的 bug)、🟡 Nit(小问题,值得修但不阻塞)、🟣 Pre-existing(代码库里本来就有、不是这个 PR 引入的 bug),直接把非本 PR 引入的存量问题单列出来。审查档位则分 Quick、Standard(默认)、Deep 三档,越细越贵。
- 用
REVIEW.md控量降噪 :在仓库根目录放REVIEW.md可调整审查规则,文档原话称这是「how you cut nit volume, stop comments on generated files, or add a rule your team cares about」。文档给出的写法包括:限制每次审查的 nit 数量(如「Report at most five Nits per review」,文档说这样「keeps reviews actionable」);列出跳过的路径和问题类别(生成的代码、lock 文件、CI 已经检查的 lint 和格式);对某类发现要求给证据,例如「behavior claims need afile:linecitation in the source, not an inference from naming」,文档说明这能减少误报。
Anthropic 在 2026-03-09 发布 Code Review 时的文章(现已正式上线)披露过其在 Anthropic 内部的运行数据:内部几乎每个 PR 都跑;以前 16% 的 PR 能得到有实质内容的审查评论,现在升至 54%;超过 1,000 行改动的大 PR 中,84% 有发现,平均 7.5 个问题;50 行以下的小 PR 中,31% 有发现,平均 0.5 个;工程师标记为错误的发现不到 1%;平均一次审查约 20 分钟,按 token 计费平均 15 到 25 美元;管理后台可查看审查过的 PR 数、接受率(acceptance rate)和总费用。这里必须注意口径差异:Anthropic 的「不到 1% 被标为错误」是内部工程师在 PR 上标记的结果,mizoko 的约 10% 是他按自己的定义重新数的,两者的系统、代码库和统计口径都不同,不能直接拿来比高低。
对于本地会话里运行的 Claude Code 自带 /code-review 命令(任何计划都能用),文档对审查力度的说明原话是:「At low, the review reports the findings it's most confident in, so you see fewer false positives. From medium through max, the review broadens coverage.」通过发现列表报告时默认上限 32 条,也可通过以下参数限制最多报告几条:
text
--max-findings <n>此外,本地 /code-review 读项目的 CLAUDE.md,不读 REVIEW.md(REVIEW.md 只给托管服务用);它可以放进定时任务里跑,若项目里或个人目录下有同名为 code-review 的 skill,则会替换掉自带的这个命令。
OpenAI 在 2025-09-15 发布 GPT-5-Codex 时的文章也体现了同样的评估取向。OpenAI 当时在热门开源仓库最近的提交上评估代码审查,由有经验的工程师逐条评判评论是否正确、是否重要,结论原文是:「comments by GPT‑5‑Codex are less likely to be incorrect or unimportant, reserving more user attention for critical issues」。文中三张图对比了 GPT-5 high 与 GPT-5-Codex high:错误评论比例从 13.7% 降到 4.4%,高影响评论比例从 39.4% 升到 52.4%,每个 PR 平均评论数从 1.32 降到 0.93。这是一年多前基于 OpenAI 自己评测集的模型评估,与 mizoko 的业务统计及 Anthropic 的内部运行数据口径均不同,不能直接比数字高低;真正可以对照的是它看的三个维度:错没错、重不重要、每个 PR 发多少条。
评估审查 skill 要看修复率、错误率、每 PR 评论数、严重程度与漏报
综合 mizoko 半年的实测与各方做法,评估代码审查 skill 时光看错误评论比例分不出高下,更不能把评论数量当成目标。真正值得盯住的是这组组合指标:修复率(或接受率)、错误评论比例、每个 PR 的平均评论数 ,再往下细化到评论的严重程度 以及合并后 30 天回溯的漏报情况。像 mizoko 那样先把口径定死,保留逐条评论的数据和统计脚本,每个月按同样口径重算一次,哪个 skill 值得留、哪个该停掉,账面自己会说话。
参考链接
- 原文:dev.to/mizoko/i-te...
- Claude Code 文档 Code Review:code.claude.com/docs/en/cod...
- Claude Code 文档 Customize Code Review(REVIEW.md):code.claude.com/docs/en/cod...
- Claude Code 文档 Read and request reviews on a pull request(严重级别):code.claude.com/docs/en/cod...
- Claude Code 文档 Review locally with /code-review:code.claude.com/docs/en/cod...
- Anthropic:Code Review for Claude Code(2026-03-09):claude.com/resources/a...
- OpenAI:Introducing upgrades to Codex(2025-09-15):openai.com/index/intro...