我原来觉得,Workrun 的对话入口应该有一个足够能干的主 Agent。
用户说什么,它先理解。普通问题自己回答,需要工具就调用工具,需要 Workflow 就交给规划 Agent,方案确认后再交给编排 Agent。复杂性留在内部,用户只面对一个输入框。
直到我发了一句:
你好,今天过得怎么样?
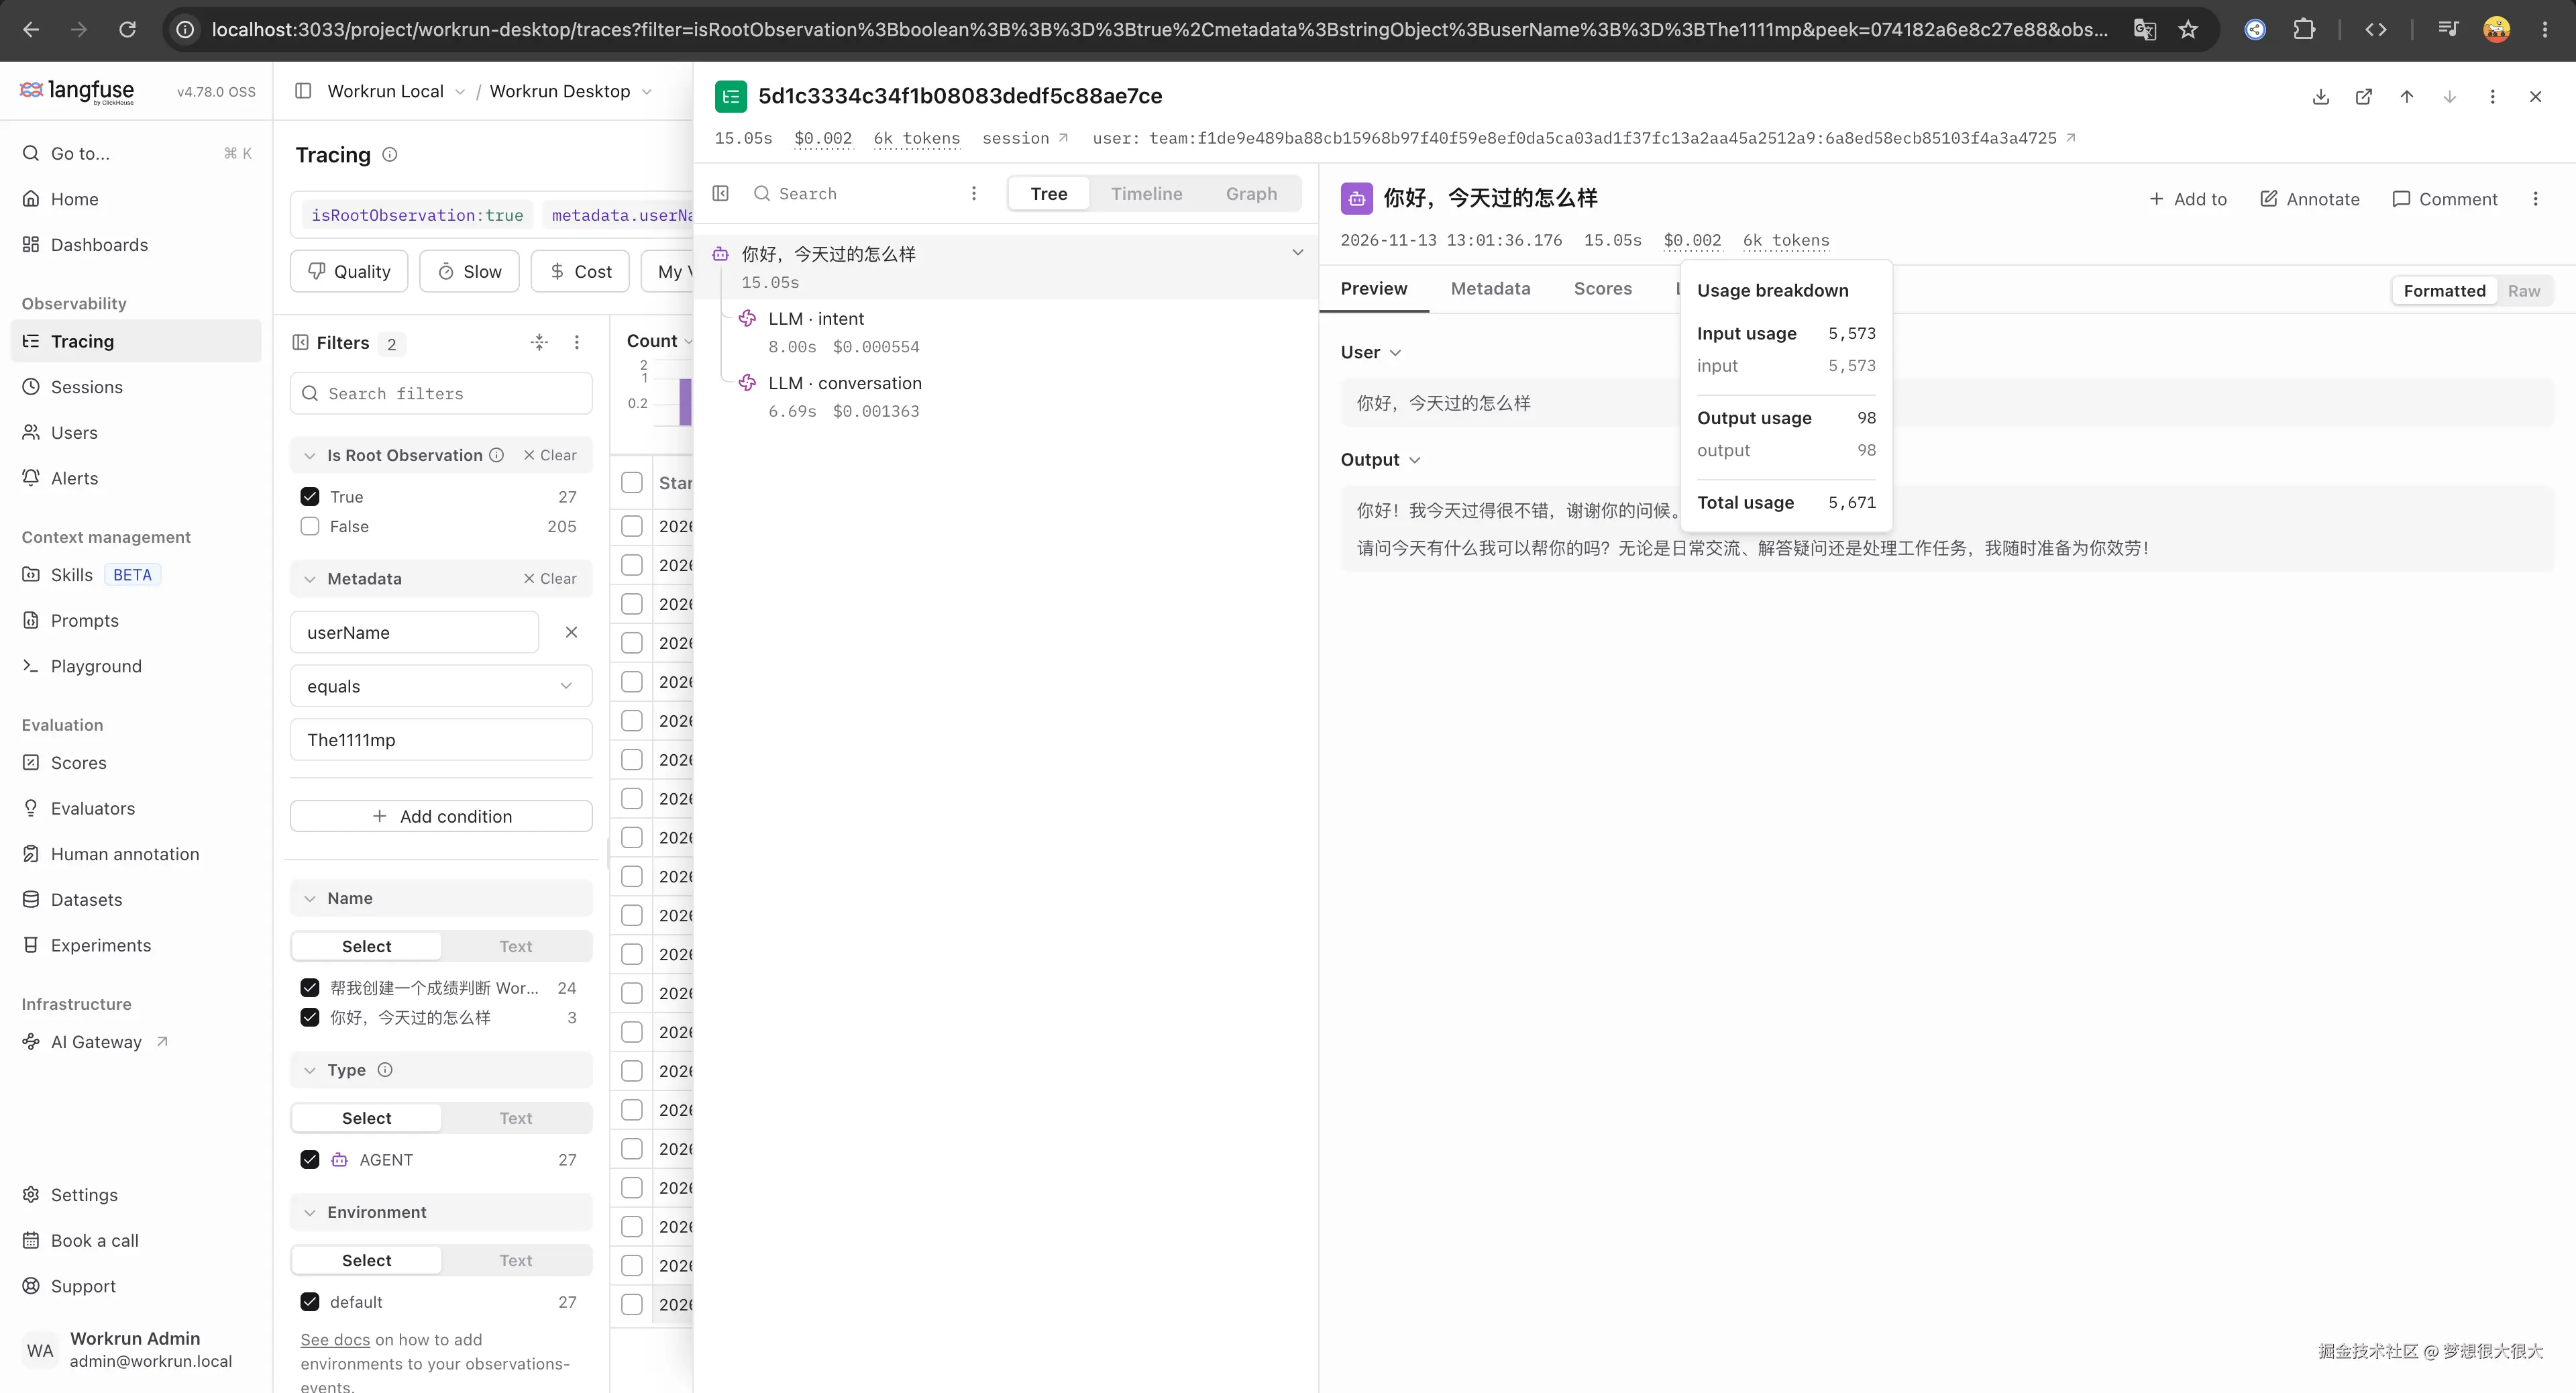
回复没有异常,Workrun 自带的用量统计却显示:5671 Token。
这个数字让我不太舒服。倒不是一次问候的费用有多高,而是我解释不了它。用户没有提出复杂需求,系统为什么要做这么多准备?如果连这笔账都说不清,后面继续加工具、加 Skill、加 Agent,我又凭什么判断成本是合理的?
我最初怀疑提示词太长。回头看,这个怀疑没错,但也不够。后来真正改动的,是模型参与决策的范围,以及系统把信息交给模型的方式。
我缺少的不是另一个总数
Workrun 并非没有监控。除了界面的 Token 统计,之前还接了 OpenTelemetry,用 Rust 的 tracing 和 ADK 的 OTLP Layer 导出运行信息。
早期接入的核心代码是:
rust
let filter = Targets::new()
    .with_target("workrun_lib", LevelFilter::INFO)
    .with_target("adk_", LevelFilter::INFO);

let layer =
    adk_telemetry::build_otlp_layer::<tracing_subscriber::Registry>(
        SERVICE_NAME,
        &endpoint,
    )?;
它适合帮我检查执行过程。但我当时需要回答的问题已经变了:不是某个函数为什么慢,而是一次模型请求为什么需要这么大的输入。
一次用户交互可能包含多次模型调用。工具的返回值进入下一轮上下文,之前的历史又被读一次。只知道总用量,即使再画一张统计图,也看不出哪一步值得改。
我想直接打开一次调用,看看完整的消息、工具定义、返回内容,以及下一次调用为什么发生。Langfuse 提供的 LLM 观测方式更贴近这个排查过程。
这里容易产生一个误解:我没有用 Langfuse 替换 OpenTelemetry。 OpenTelemetry 负责采集和传输,Langfuse 是接收、解释这些数据的后端之一。原来的问题在于 Workrun 当时提供的 LLM 语义和排查视图不足,不是 OpenTelemetry 不能记录它们。Langfuse OpenTelemetry 接入说明
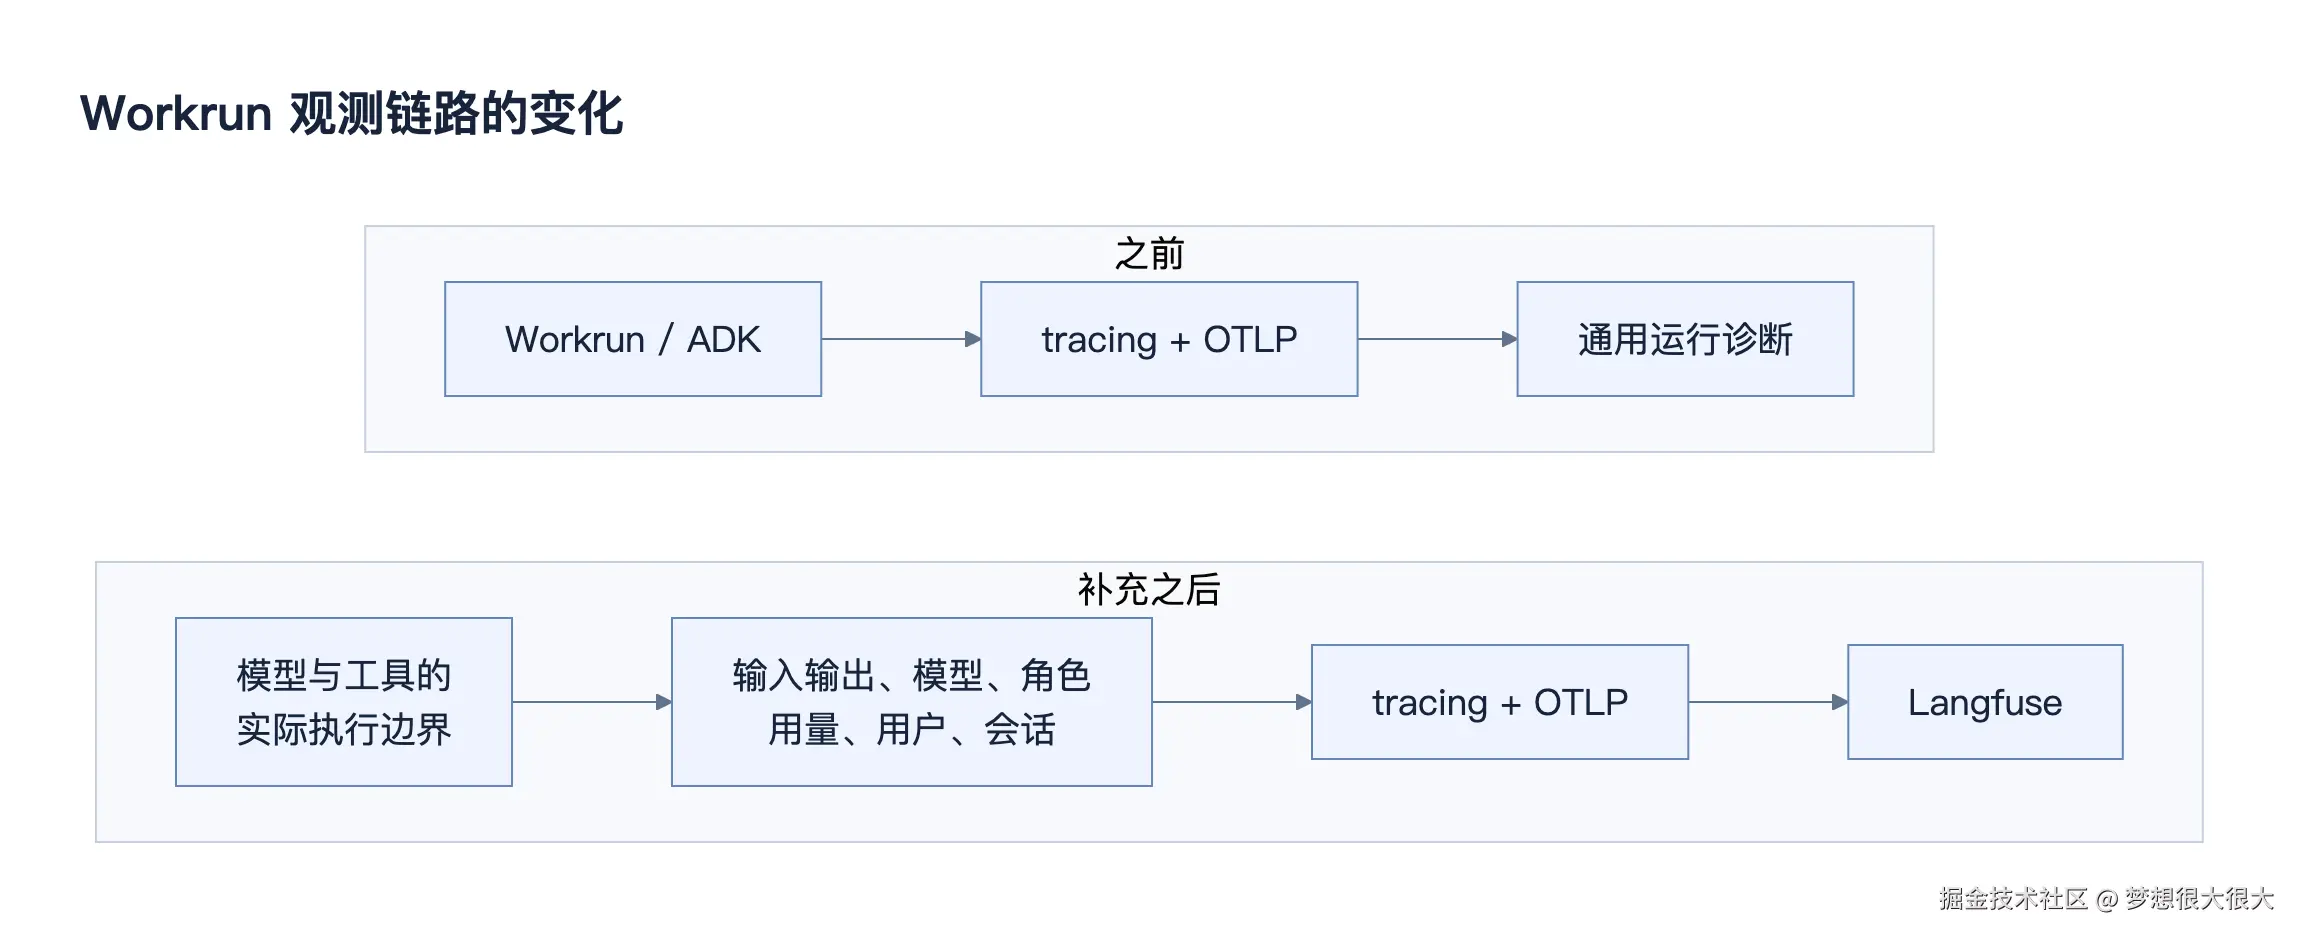
现在仍然复用 ADK 的 OTLP Layer,另外增加 NativeAdapter,把模型调用映射为 Generation,并补上角色、会话等信息。用于排查的输入来自实际模型请求:
rust
json!({
    "messages": request.contents.iter().map(content).collect::<Vec<_>>(),
    "tools": request.tools,
    "config": request.config
})
正文采集受开关控制。工具调用则在原生执行边界记录参数和结果。
之所以强调"实际边界",是因为后面真的踩过坑:保存成功后提前结束 SDK 调用,业务完成了,外层观测却没来得及记下工具返回。后来把记录放到工具真正执行的地方,先记结果,再结束流程。
这让我认识到,观测也需要验证。否则拿着不完整的 Trace 优化,很容易改错地方。
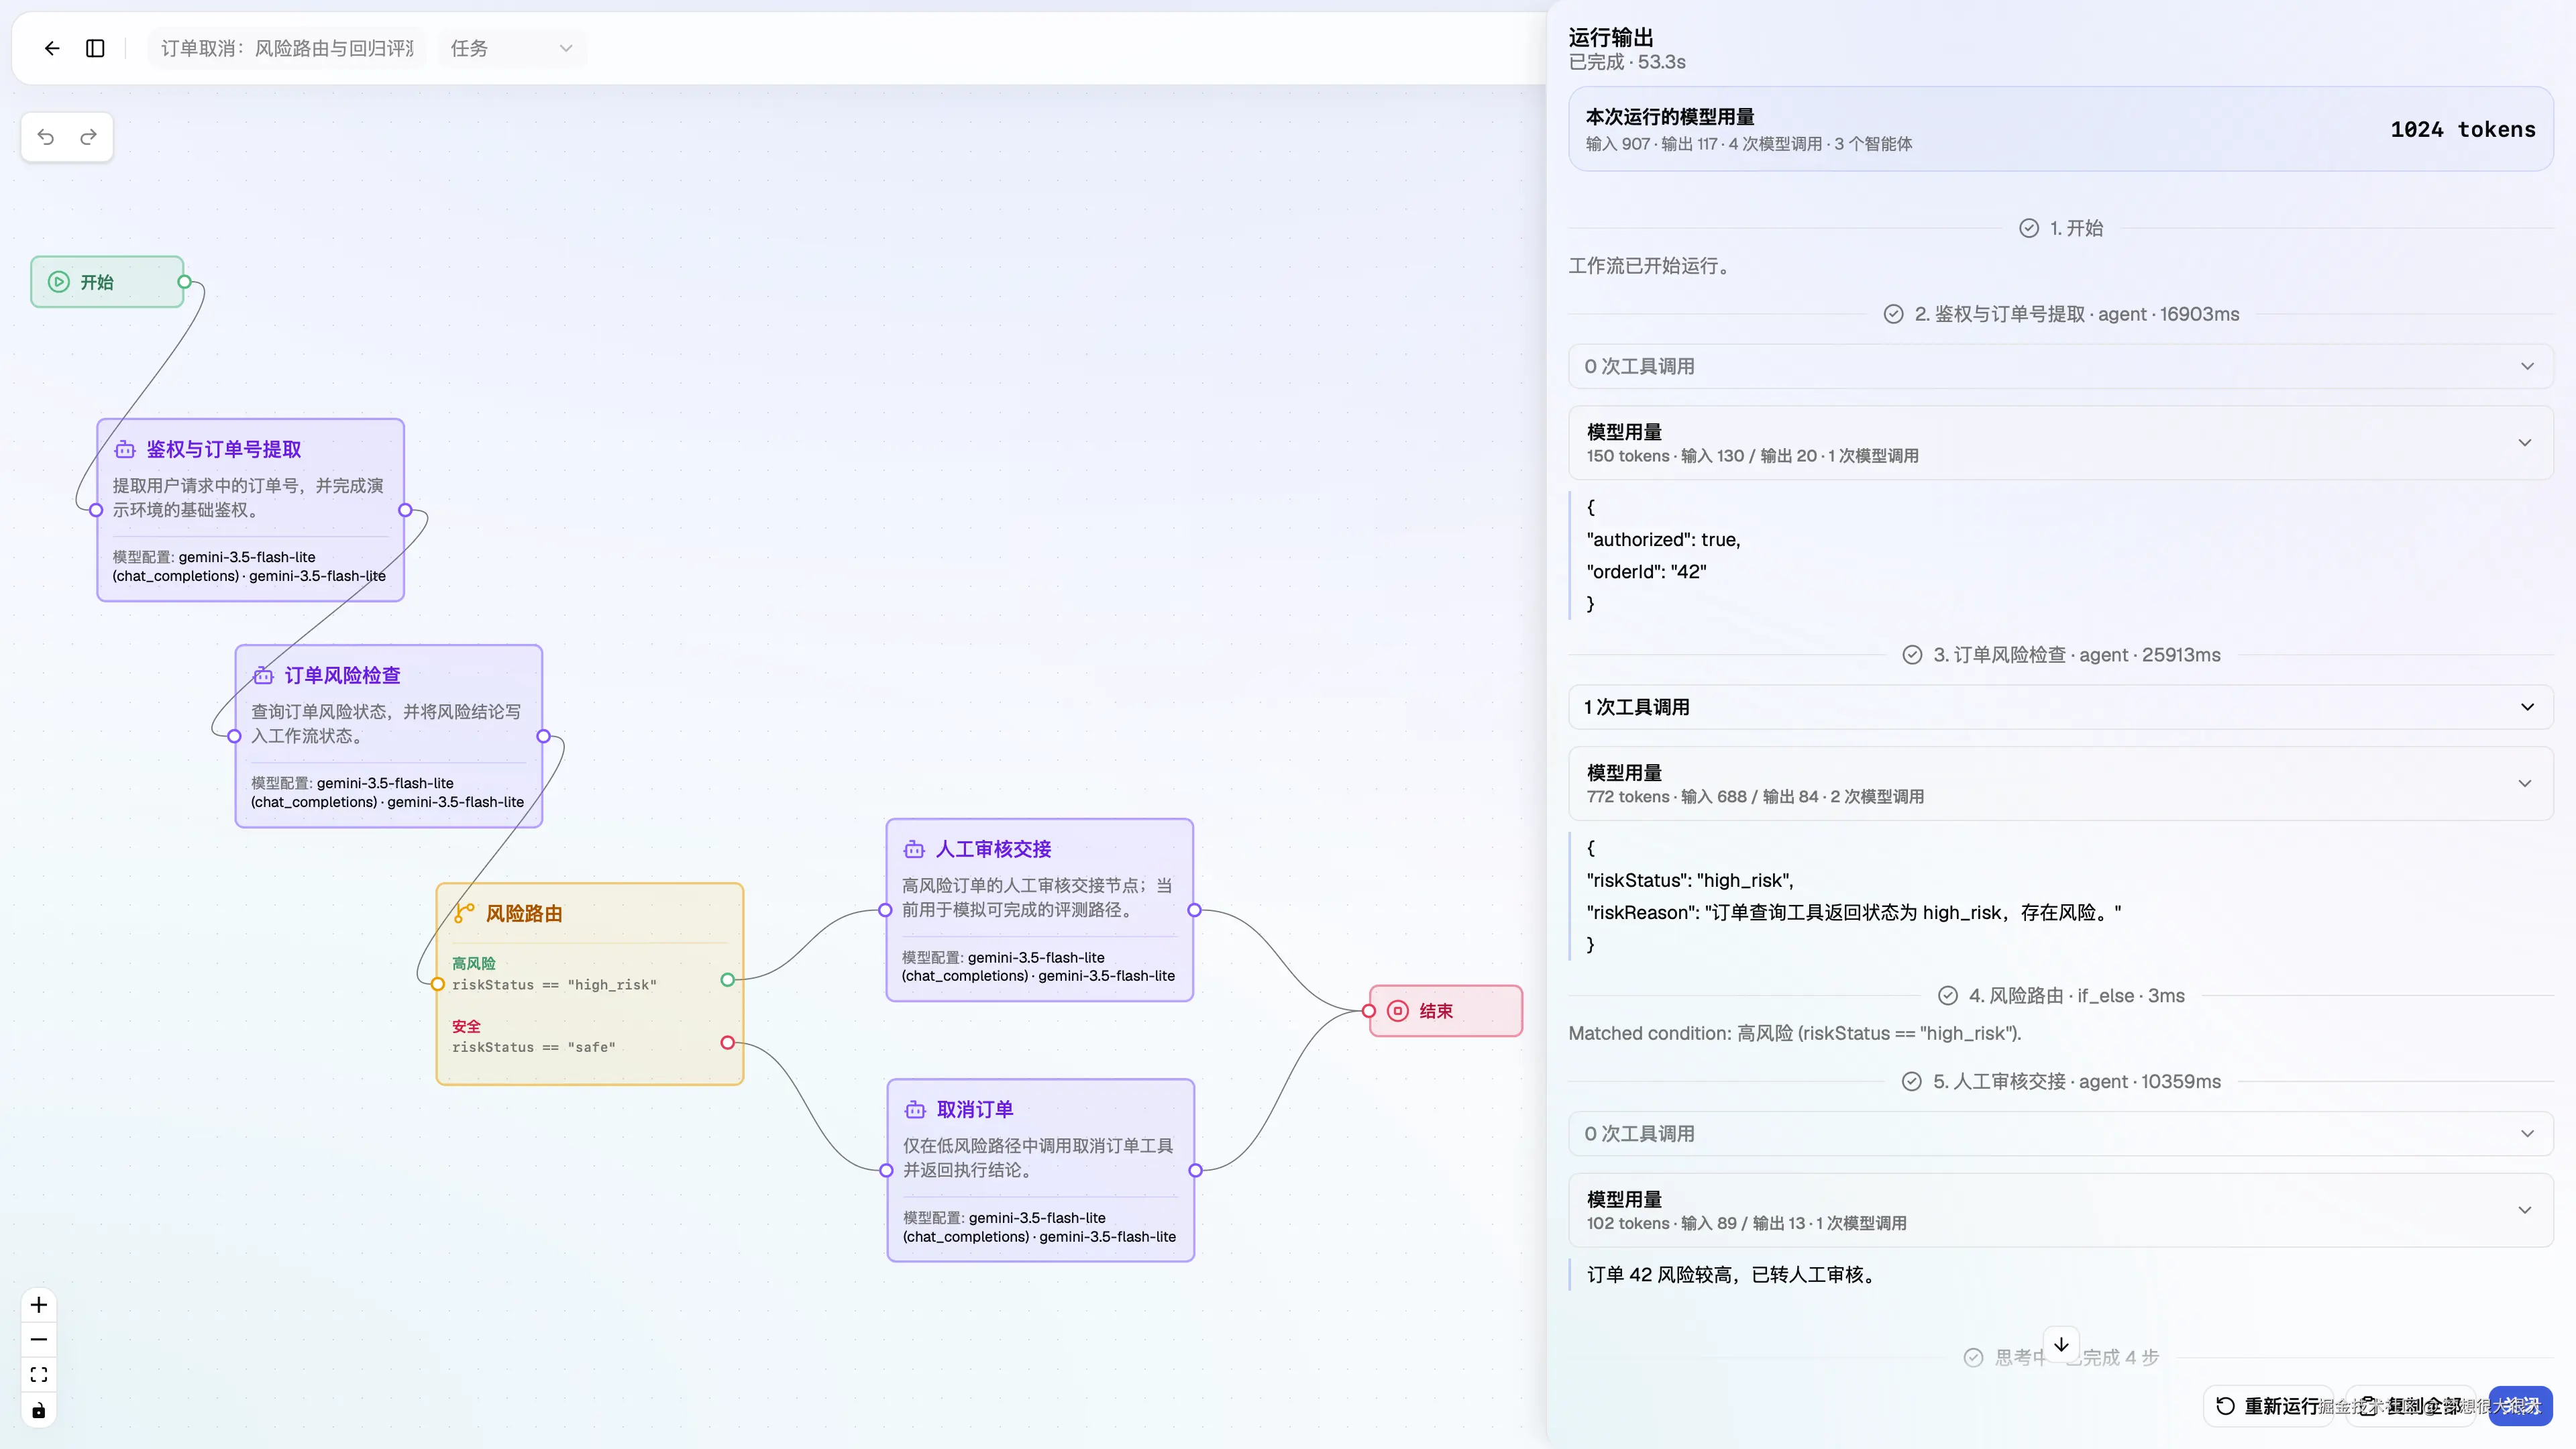
接入之后,我用 「订单取消:风险路由与回归评测」 Workflow 做实际运行对比。一边看 Workrun 中的流程定义和运行结果,一边在 Langfuse 中展开同一次运行的 Trace,通过采集到的埋点检查执行顺序、风险路由结果,以及相关调用的输入输出、耗时和 Token 用量。
「订单取消:风险路由与回归评测」Workflow 画布及运行结果
同一次运行在 Langfuse 中的 Trace,展开关键路由与调用详情
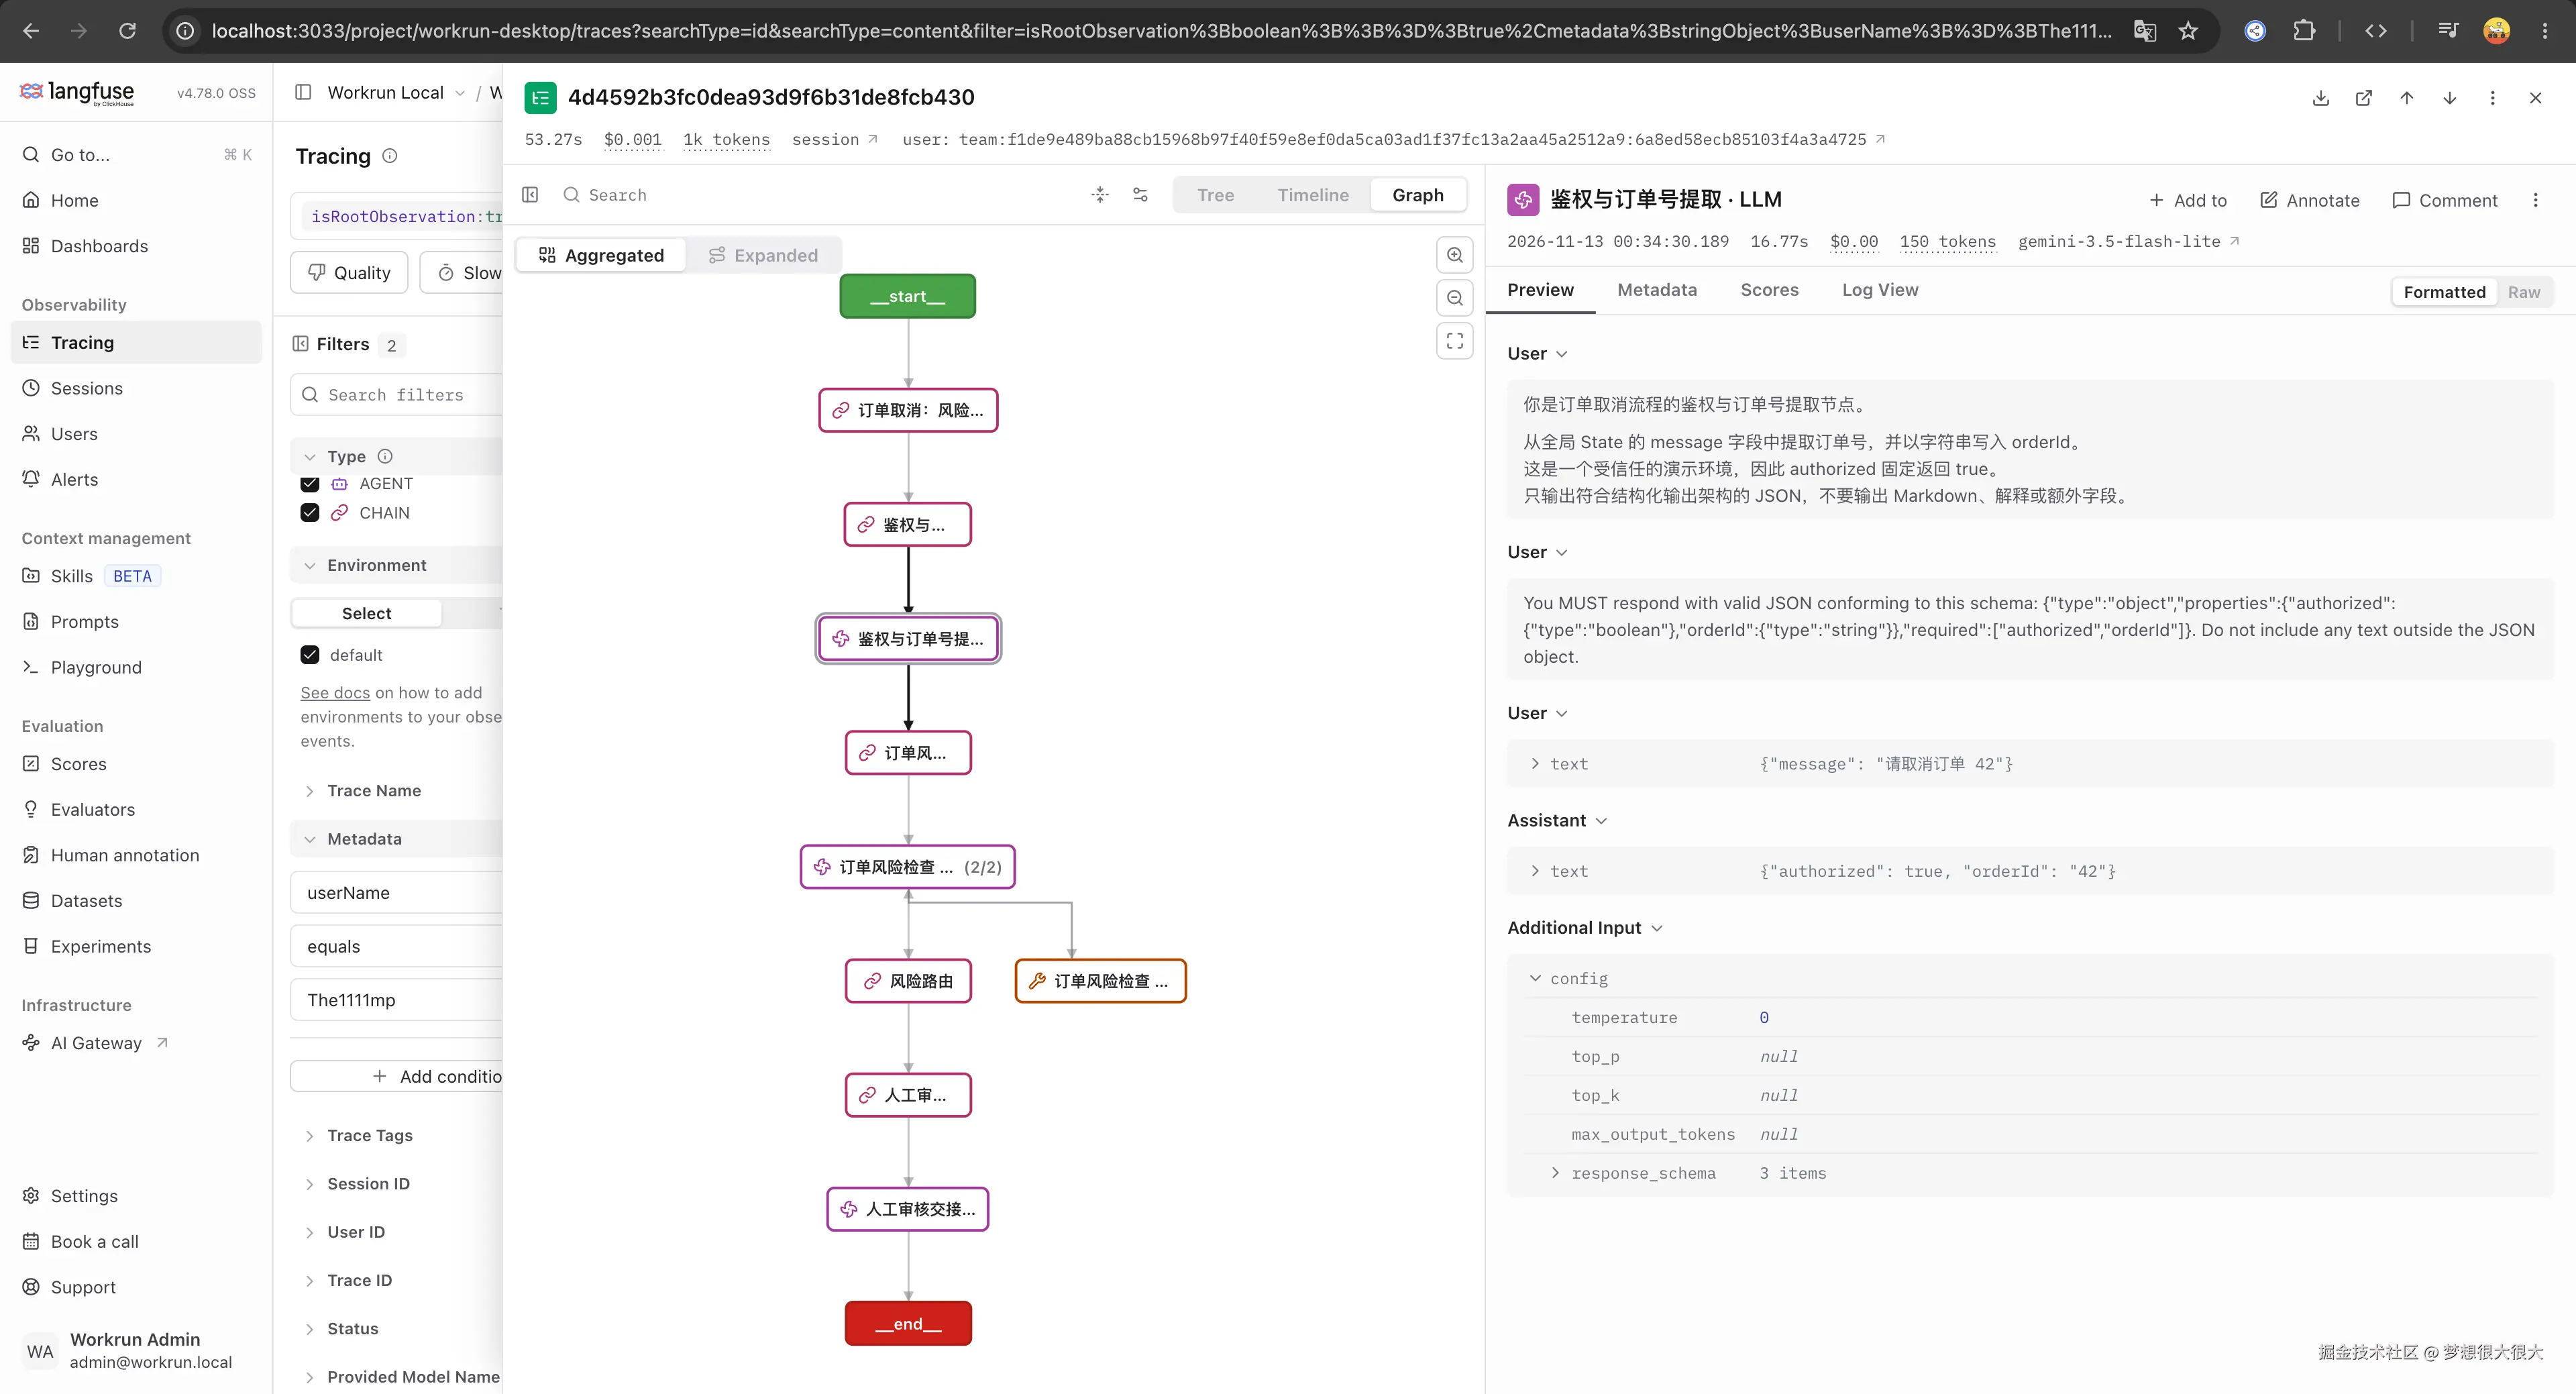
这里的"还原"是查看已经记录的执行过程,不是在 Langfuse 中重新运行 Workflow。画布展示流程如何定义,Trace 展示这次实际执行了什么;能看到多少细节,取决于对应执行边界是否被完整采集。
这些信息让我能继续追问:一次输入实际走了哪条路径,某个步骤为什么调用模型,工具结果如何进入后续上下文。后面的调整也需要结合实际结果和回归评测判断,不能只看总用量有没有下降。
一个"能干的入口",为什么开始变贵
Workrun 原来的主 Agent 同时承担对话、任务处理、请求范围判断和专家委派。代码里的模块注释就能说明这一点:
rust
//! Main agent: conversation, direct work,
//! turn grants and specialist delegation.
按职责画出来,是这样的:
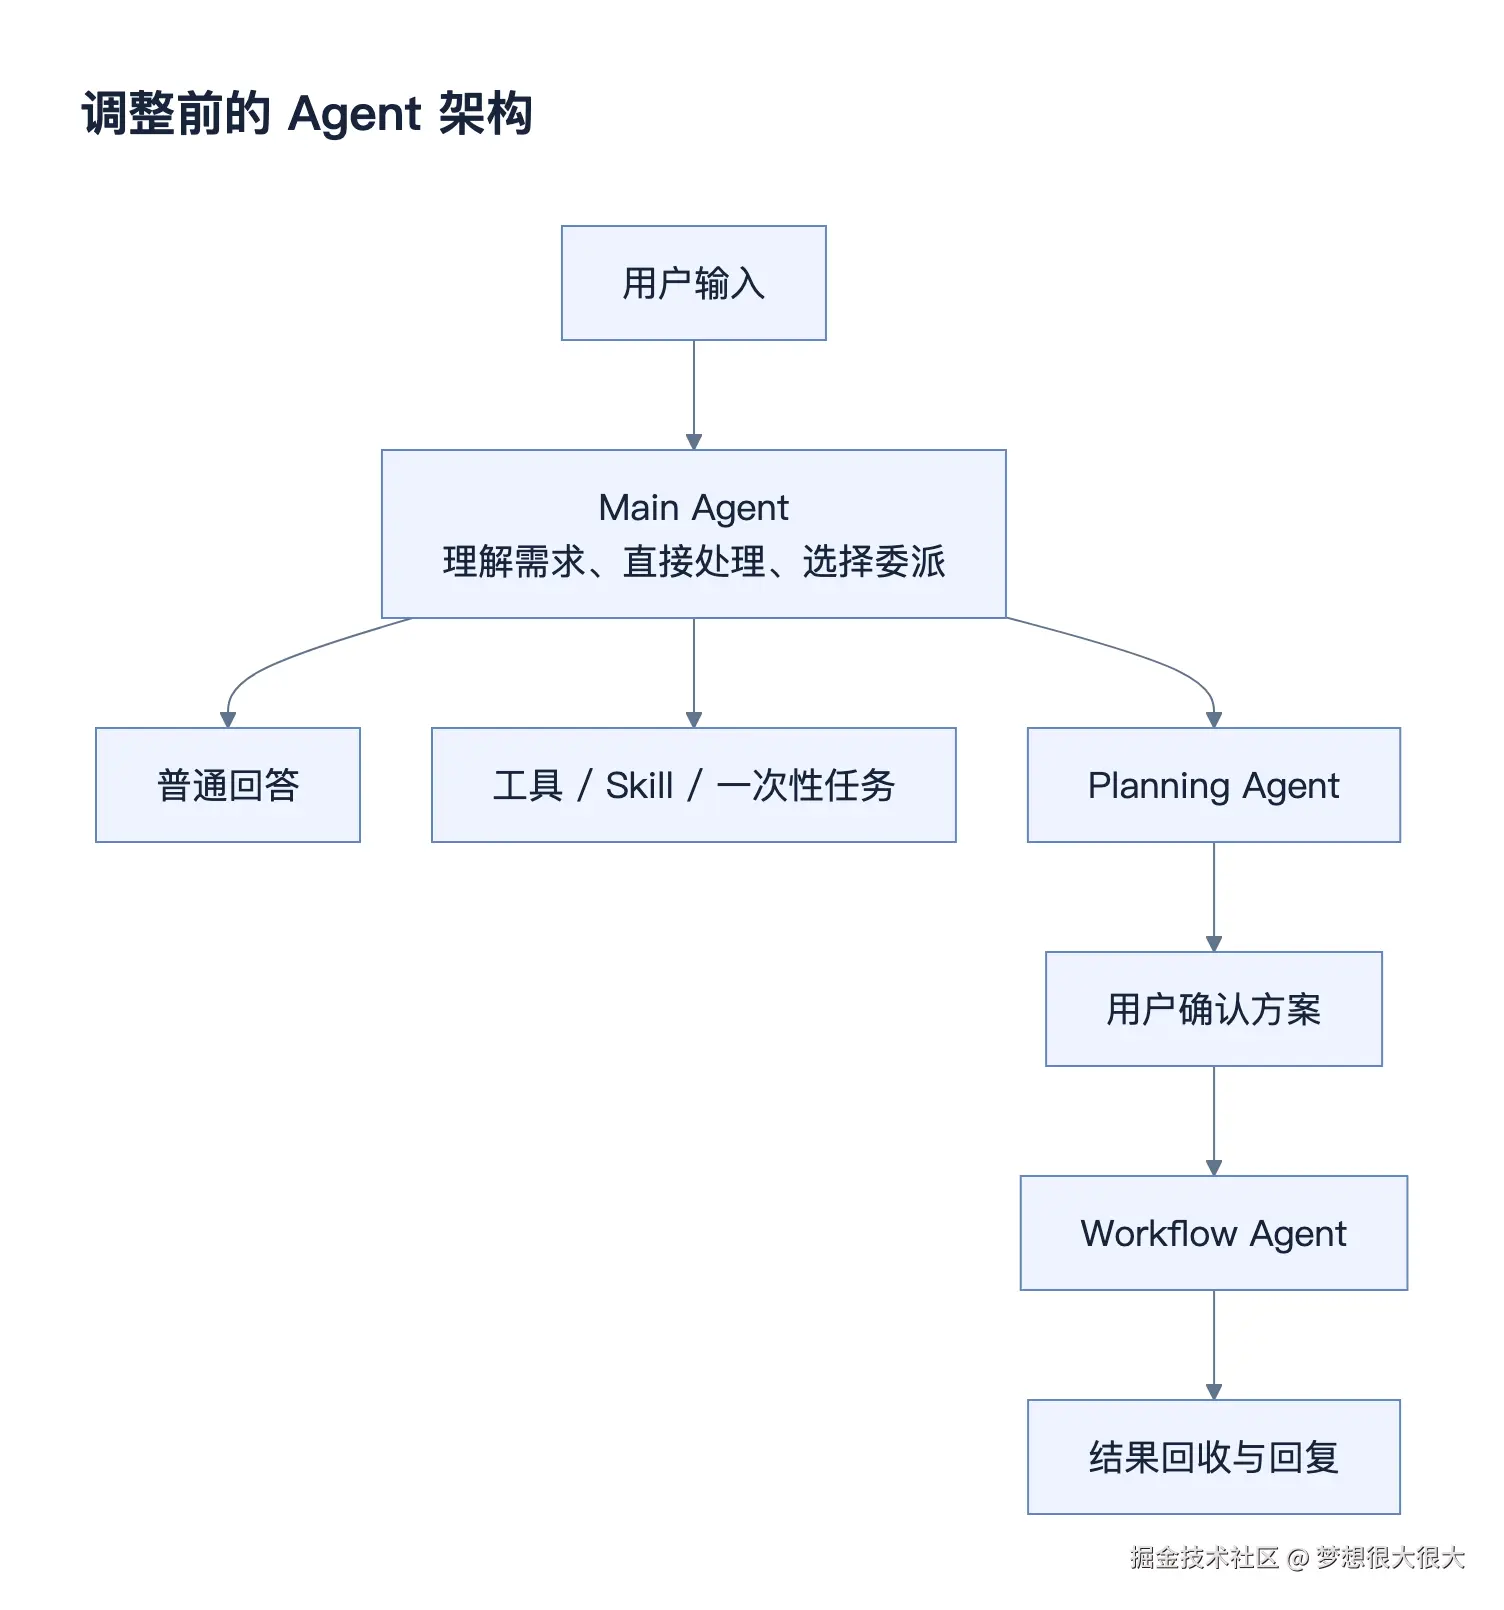
这不是说每次都走完这条链路。问题是,为了决定走哪条路,入口逐渐需要了解越来越多东西。
当时我并不打算再加一个路由 Agent。已经有主 Agent 判断了,再加一层,是不是把简单事情复杂化?我甚至一度希望保留原来的结构,只把提示词压短。
但普通任务的能力不会停止增长。今天支持文件,明天增加工具,后天补充 Skill。只要入口还负责真正处理任务,它的上下文就会继续增加。
所以最后还是拆了。理由不是"多 Agent 更先进",而是入口的判断需求相对稳定,任务能力却会持续变化。这两种变化不该一直绑在一起。
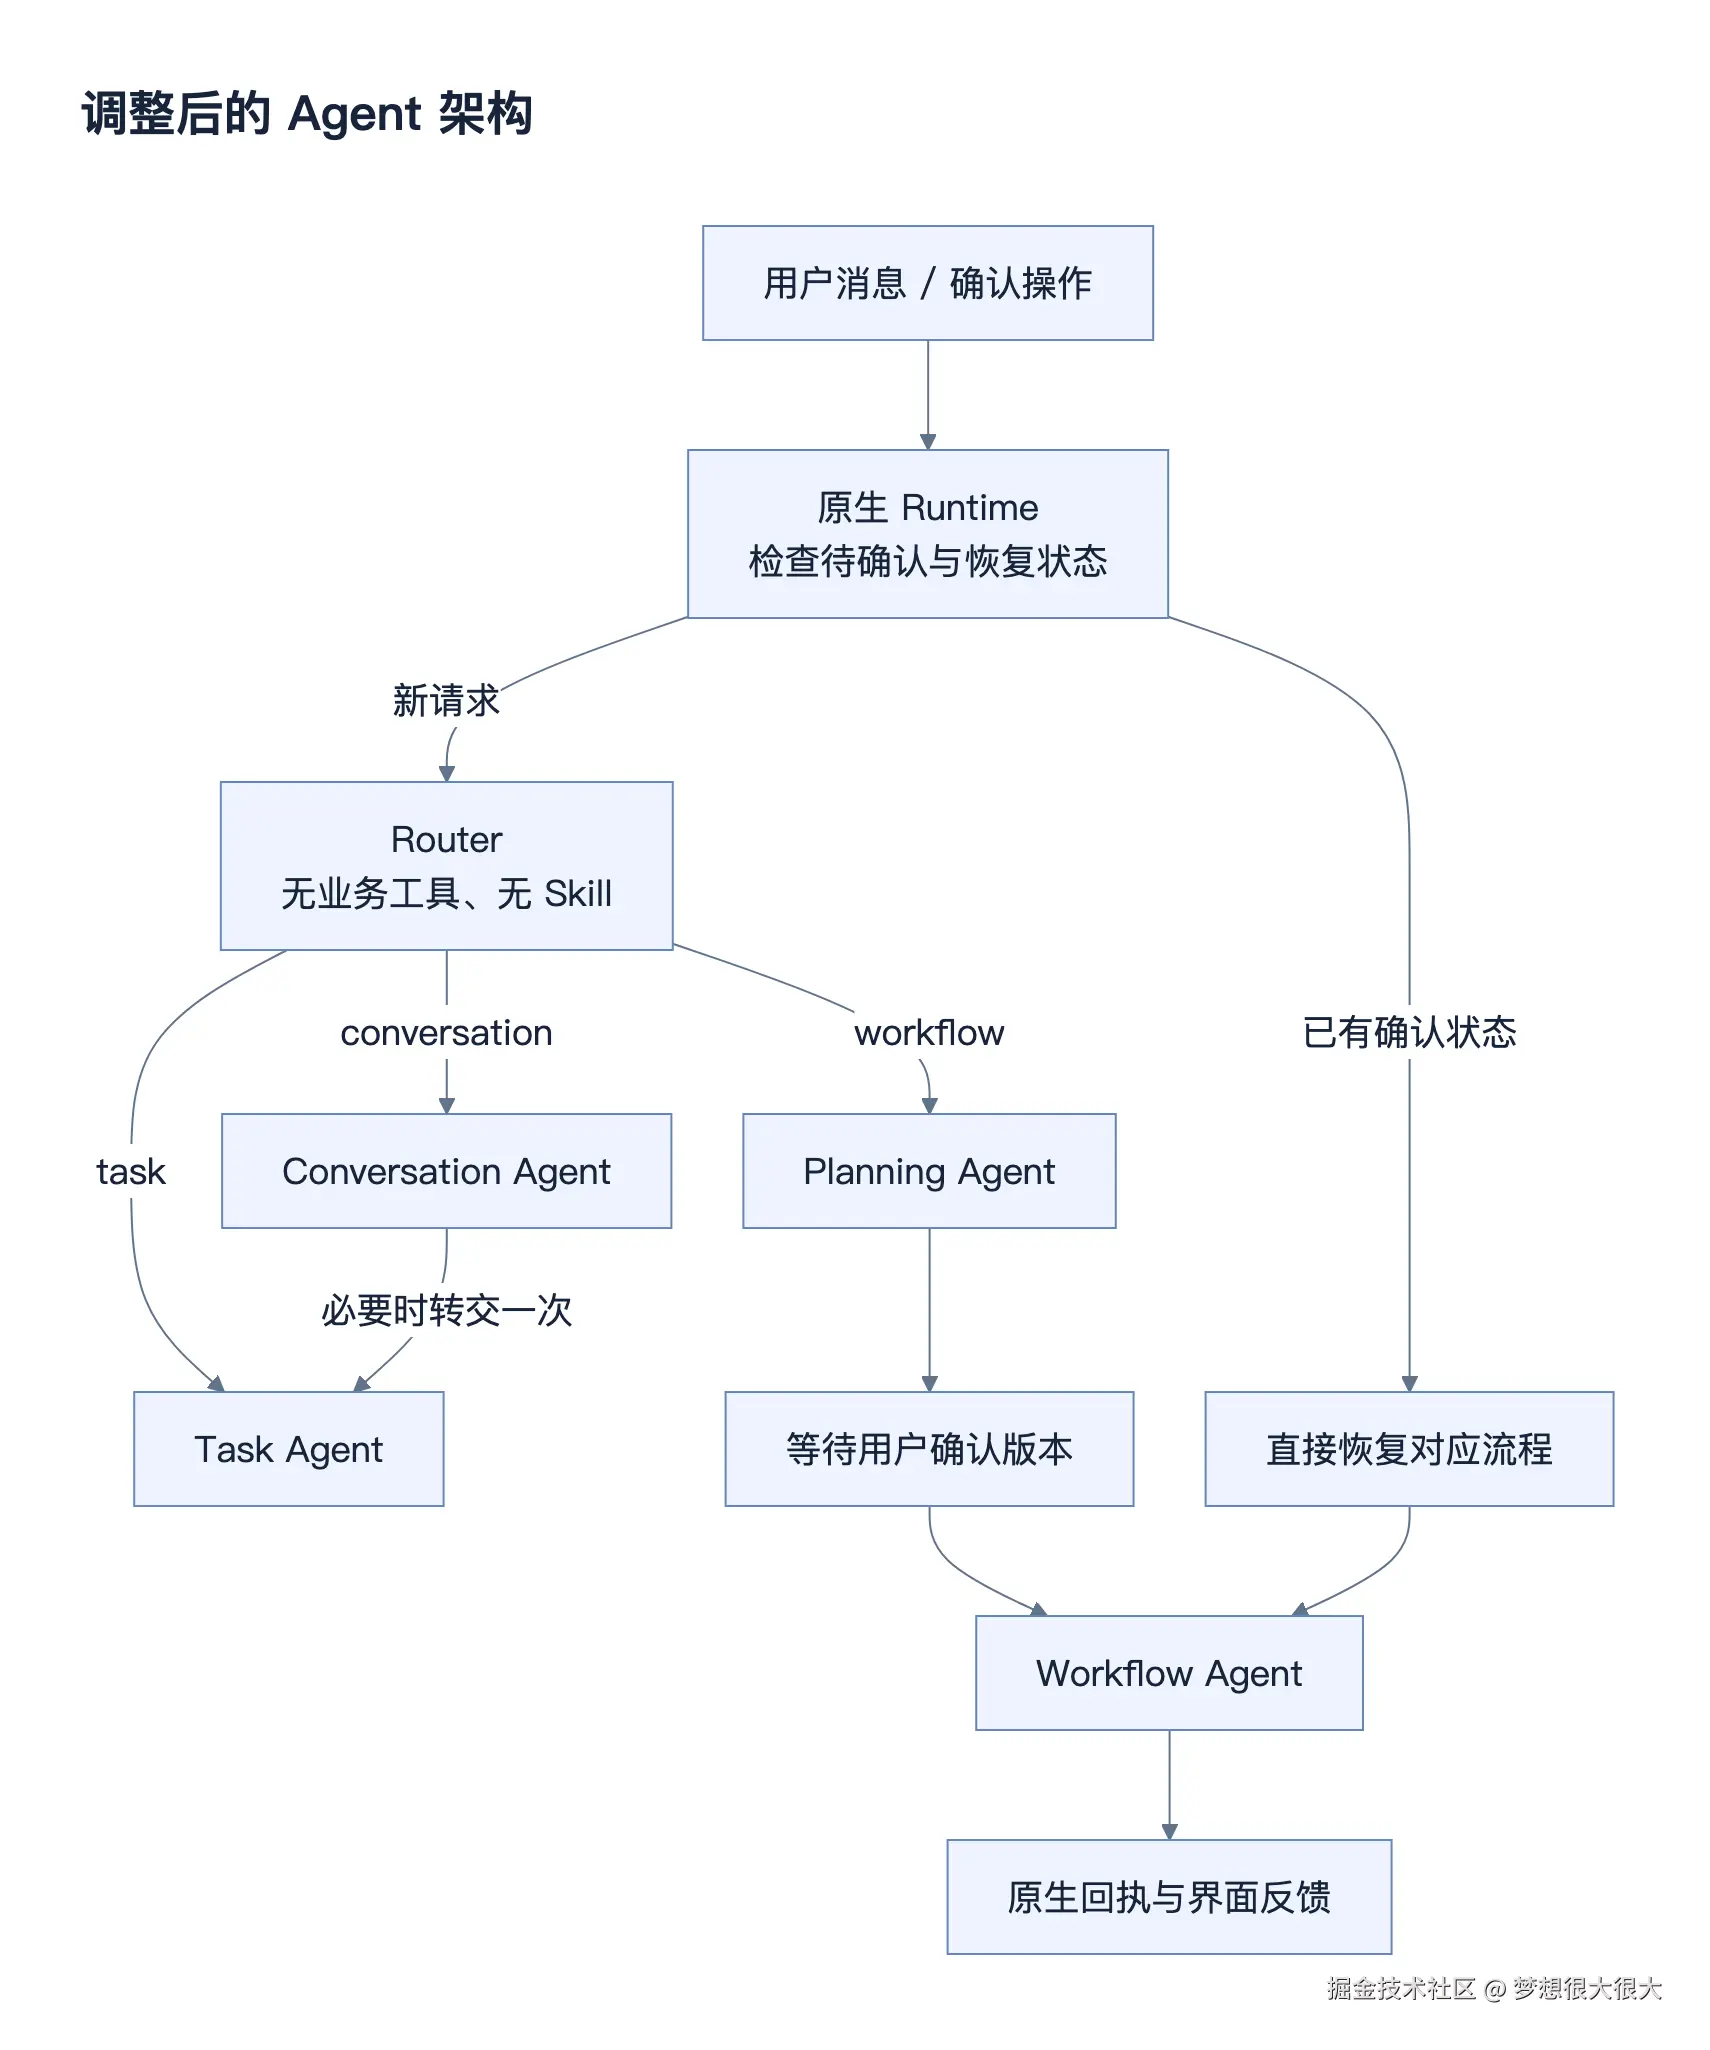
Router 只返回 conversation、task 或 workflow。它读取有限消息预览和状态摘要,不接收完整工具结果。真正处理请求的 Agent 仍然使用原始输入。
代价也很明确:普通对话通常变成两次调用,一次路由,一次回答。当前各角色仍然复用用户选定的模型,"轻量"指上下文和职责,不是另配了一个便宜模型。
所以不能只凭拆分就宣布省钱。这个选择先解决了能力增长时的边界问题,成本仍要把新增路由算进去,再看整体。
路由便宜没有用,走错路更贵
拆分中有一个真实错误,给我留下的印象比 Token 数字更深。
我输入:
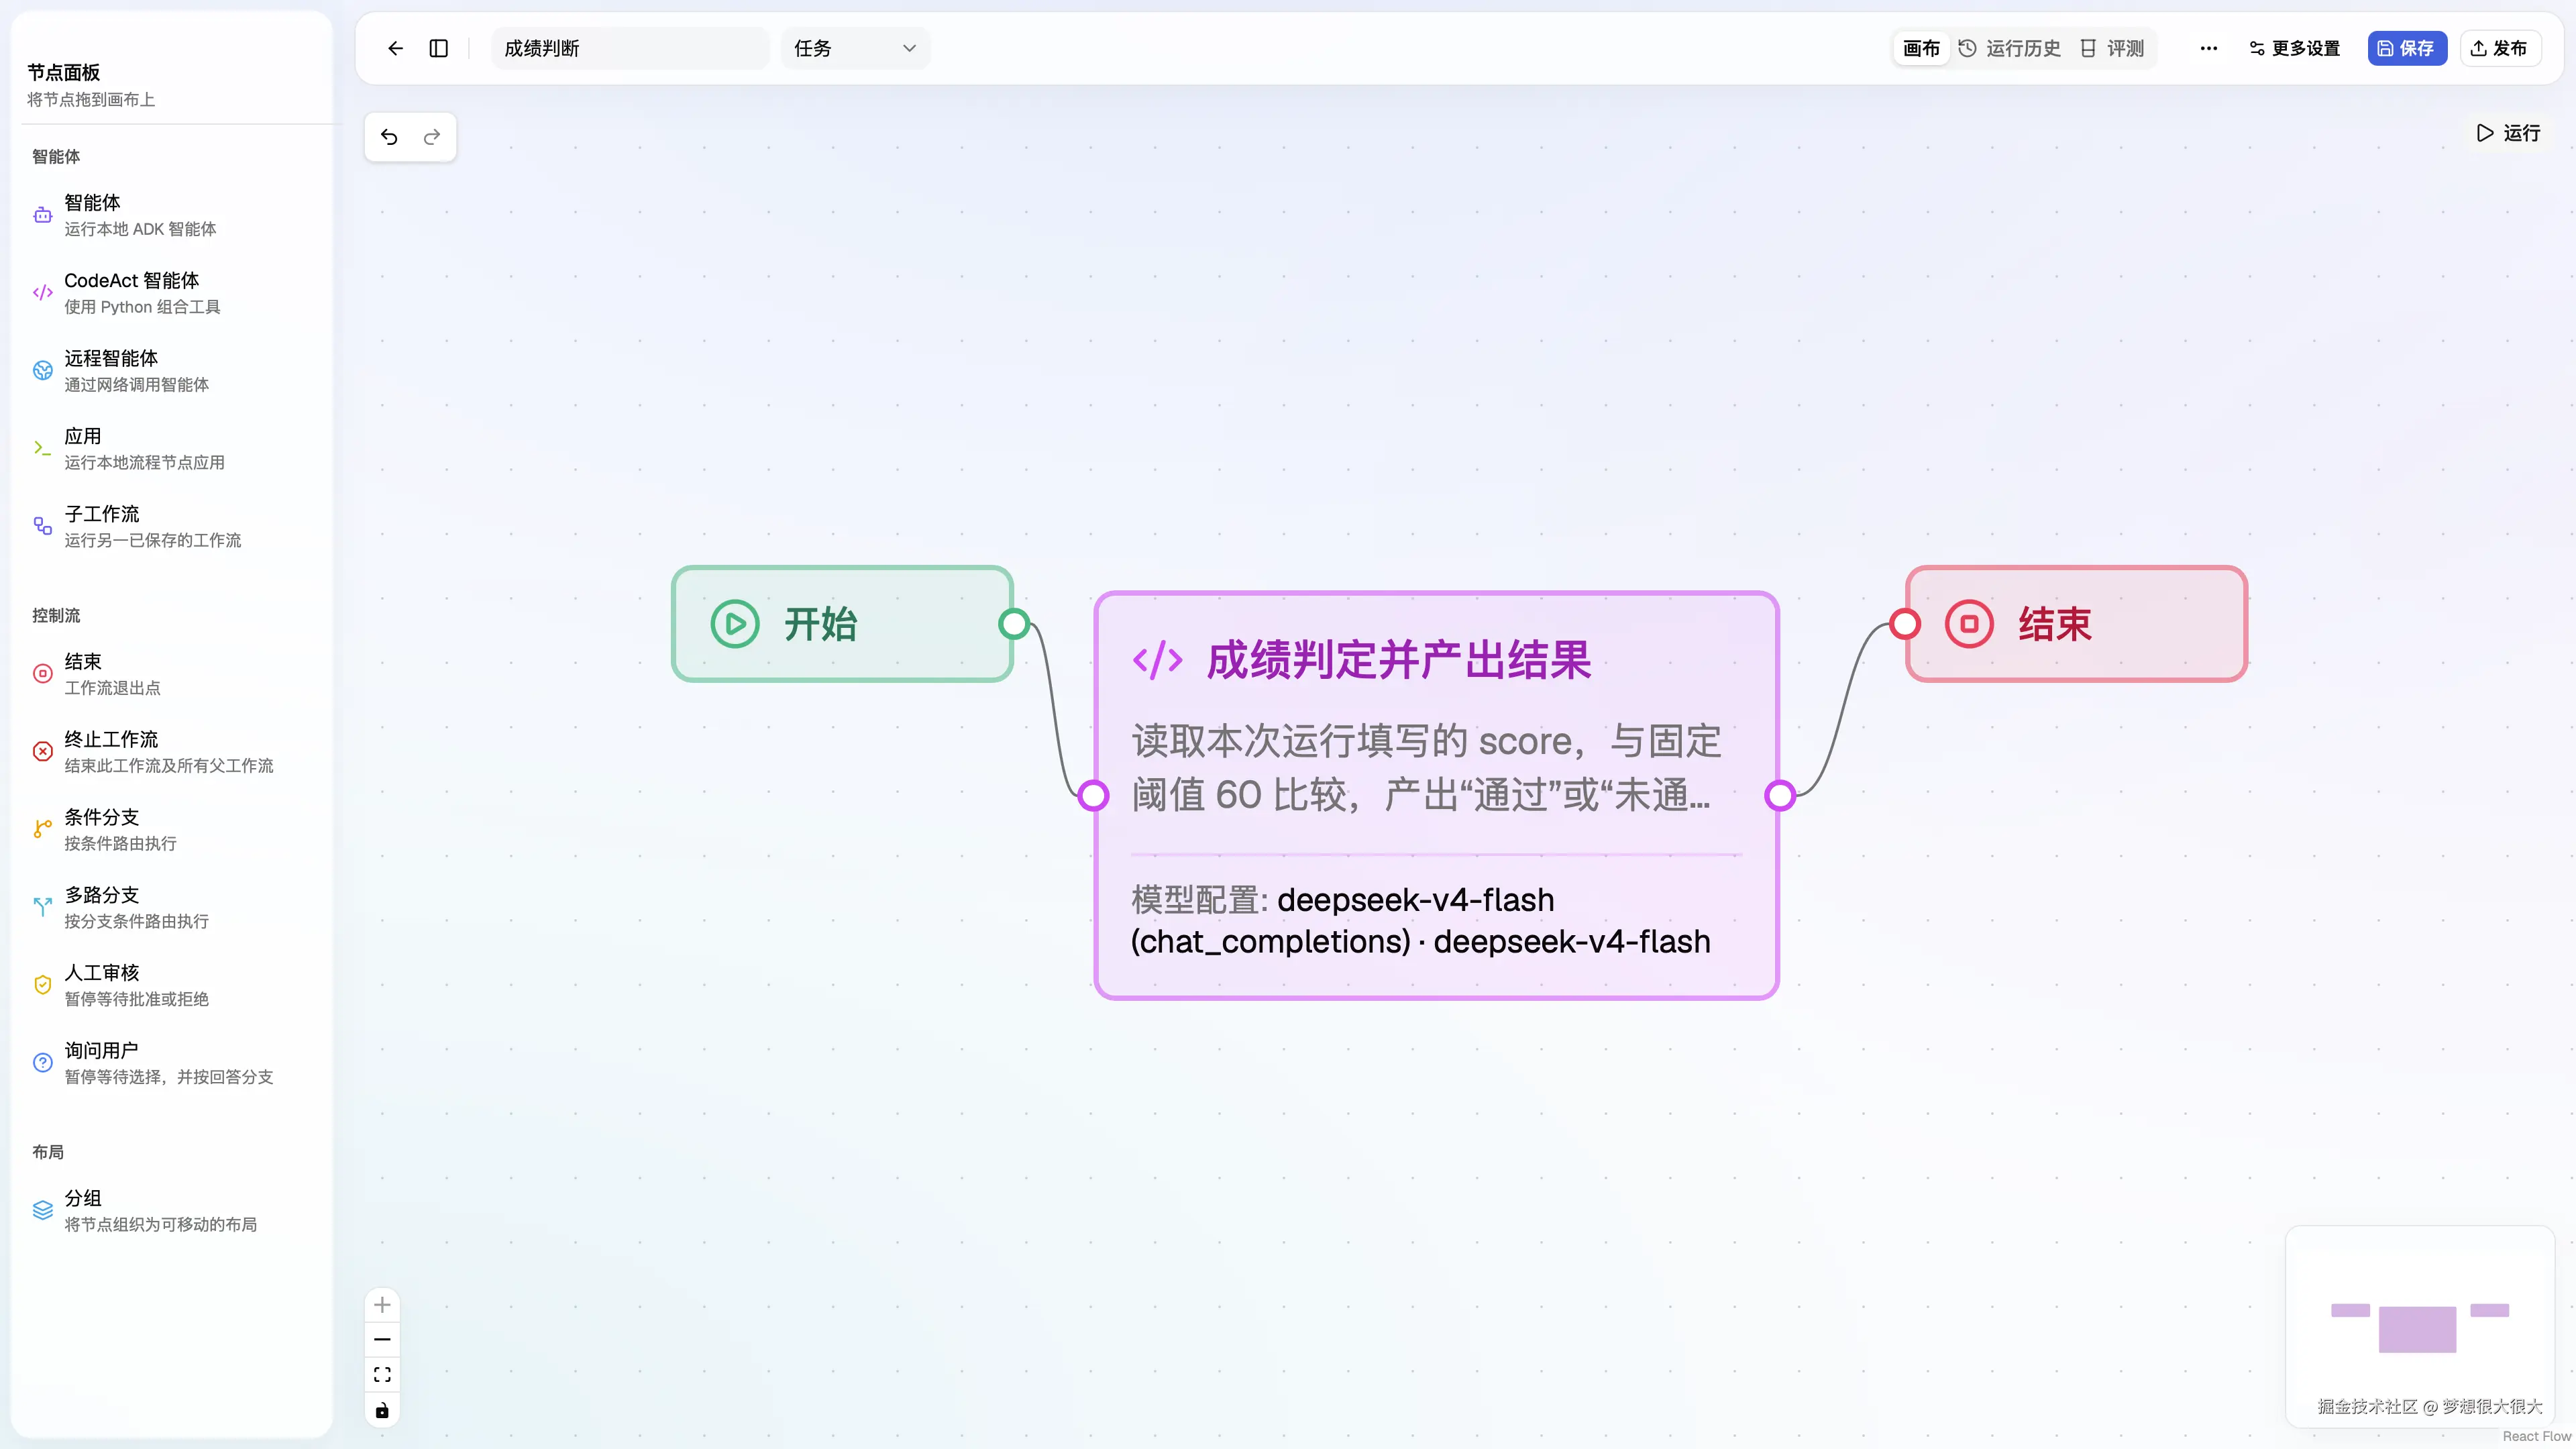
帮我创建一个成绩判断 Workflow:输入成绩 score,大于等于 60 输出"通过",否则输出"未通过"。输入成绩应当可以在每次运行时填写。先给我规划方案,不要创建或执行。
模型写了一篇方案,最后却问:
你用的是哪个 Workflow 平台?具体的输入节点、条件节点、输出节点叫什么,我这边看不到工作区。
它在 Workrun 里问我用什么平台。
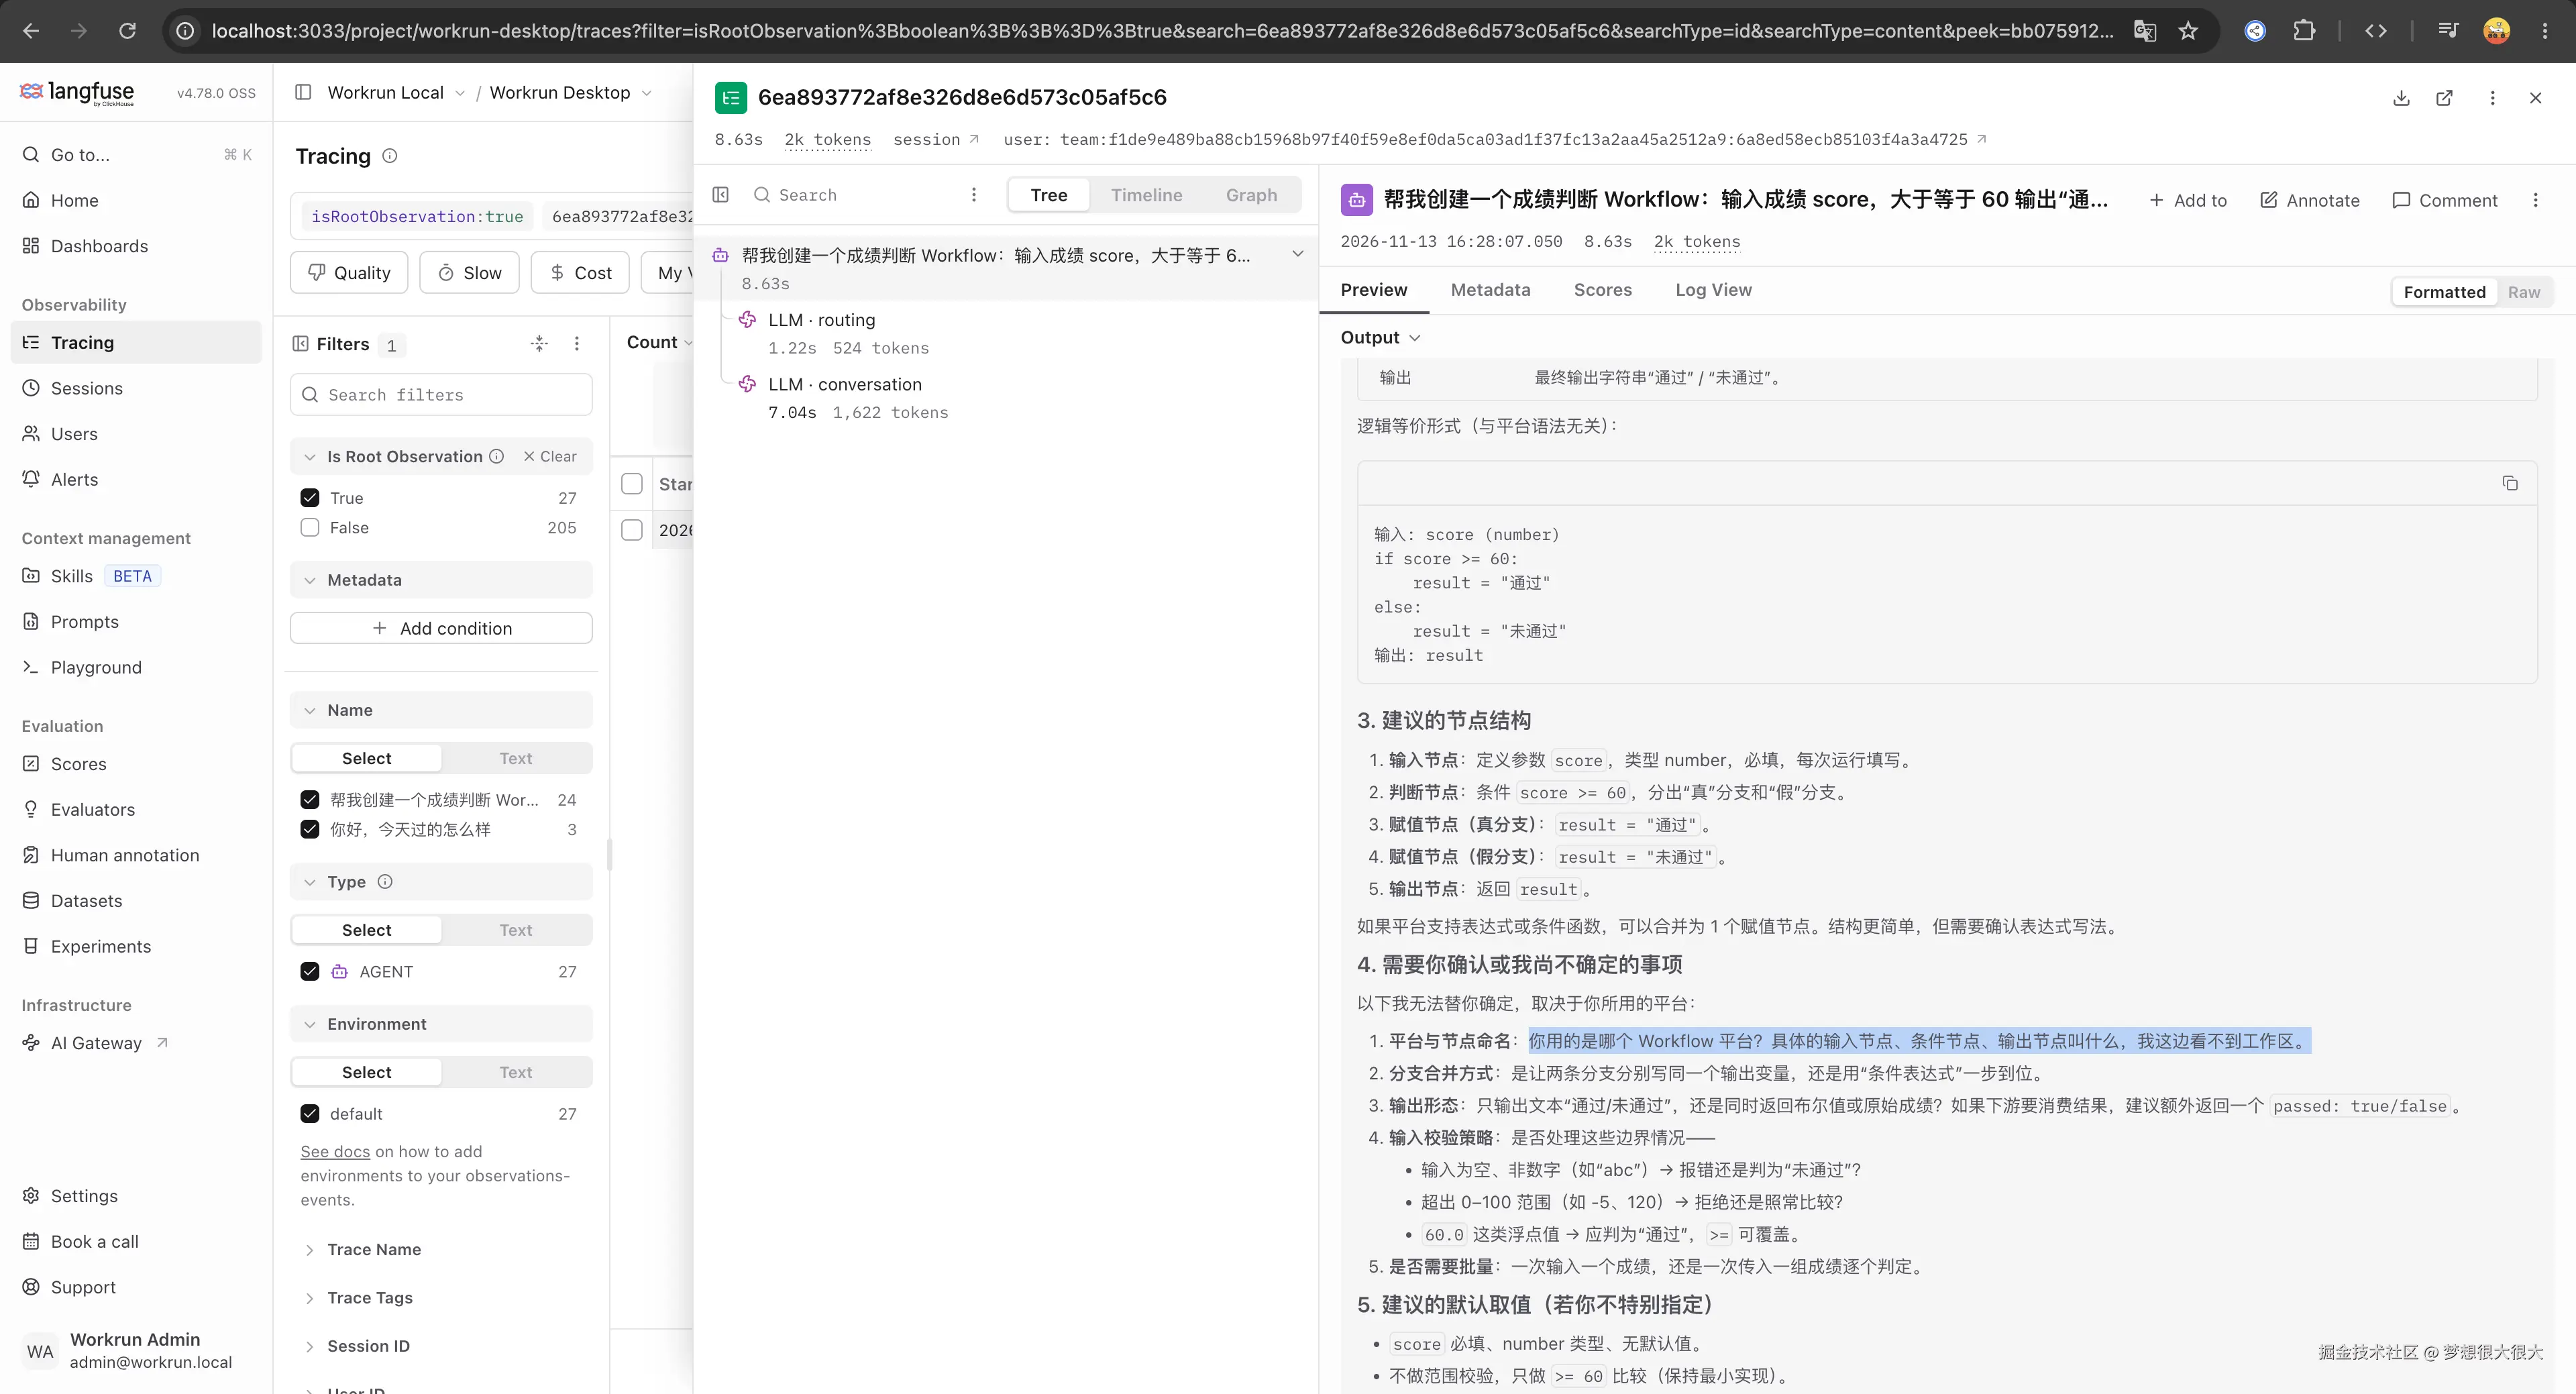
从用户结果看,这条路径已经错了:一个产品内部的规划请求,被当成通用咨询处理。
"先给方案"只是限制暂时不要创建,并没有把请求变成普通聊天。后来 Router 明确了这个边界:
text
"Plan first", "do not create yet" and "do not execute"
restrict later actions; they do not turn a Workflow
project request into general conversation.
修复后,同一请求才进入原生规划流程,生成待确认的方案卡片。
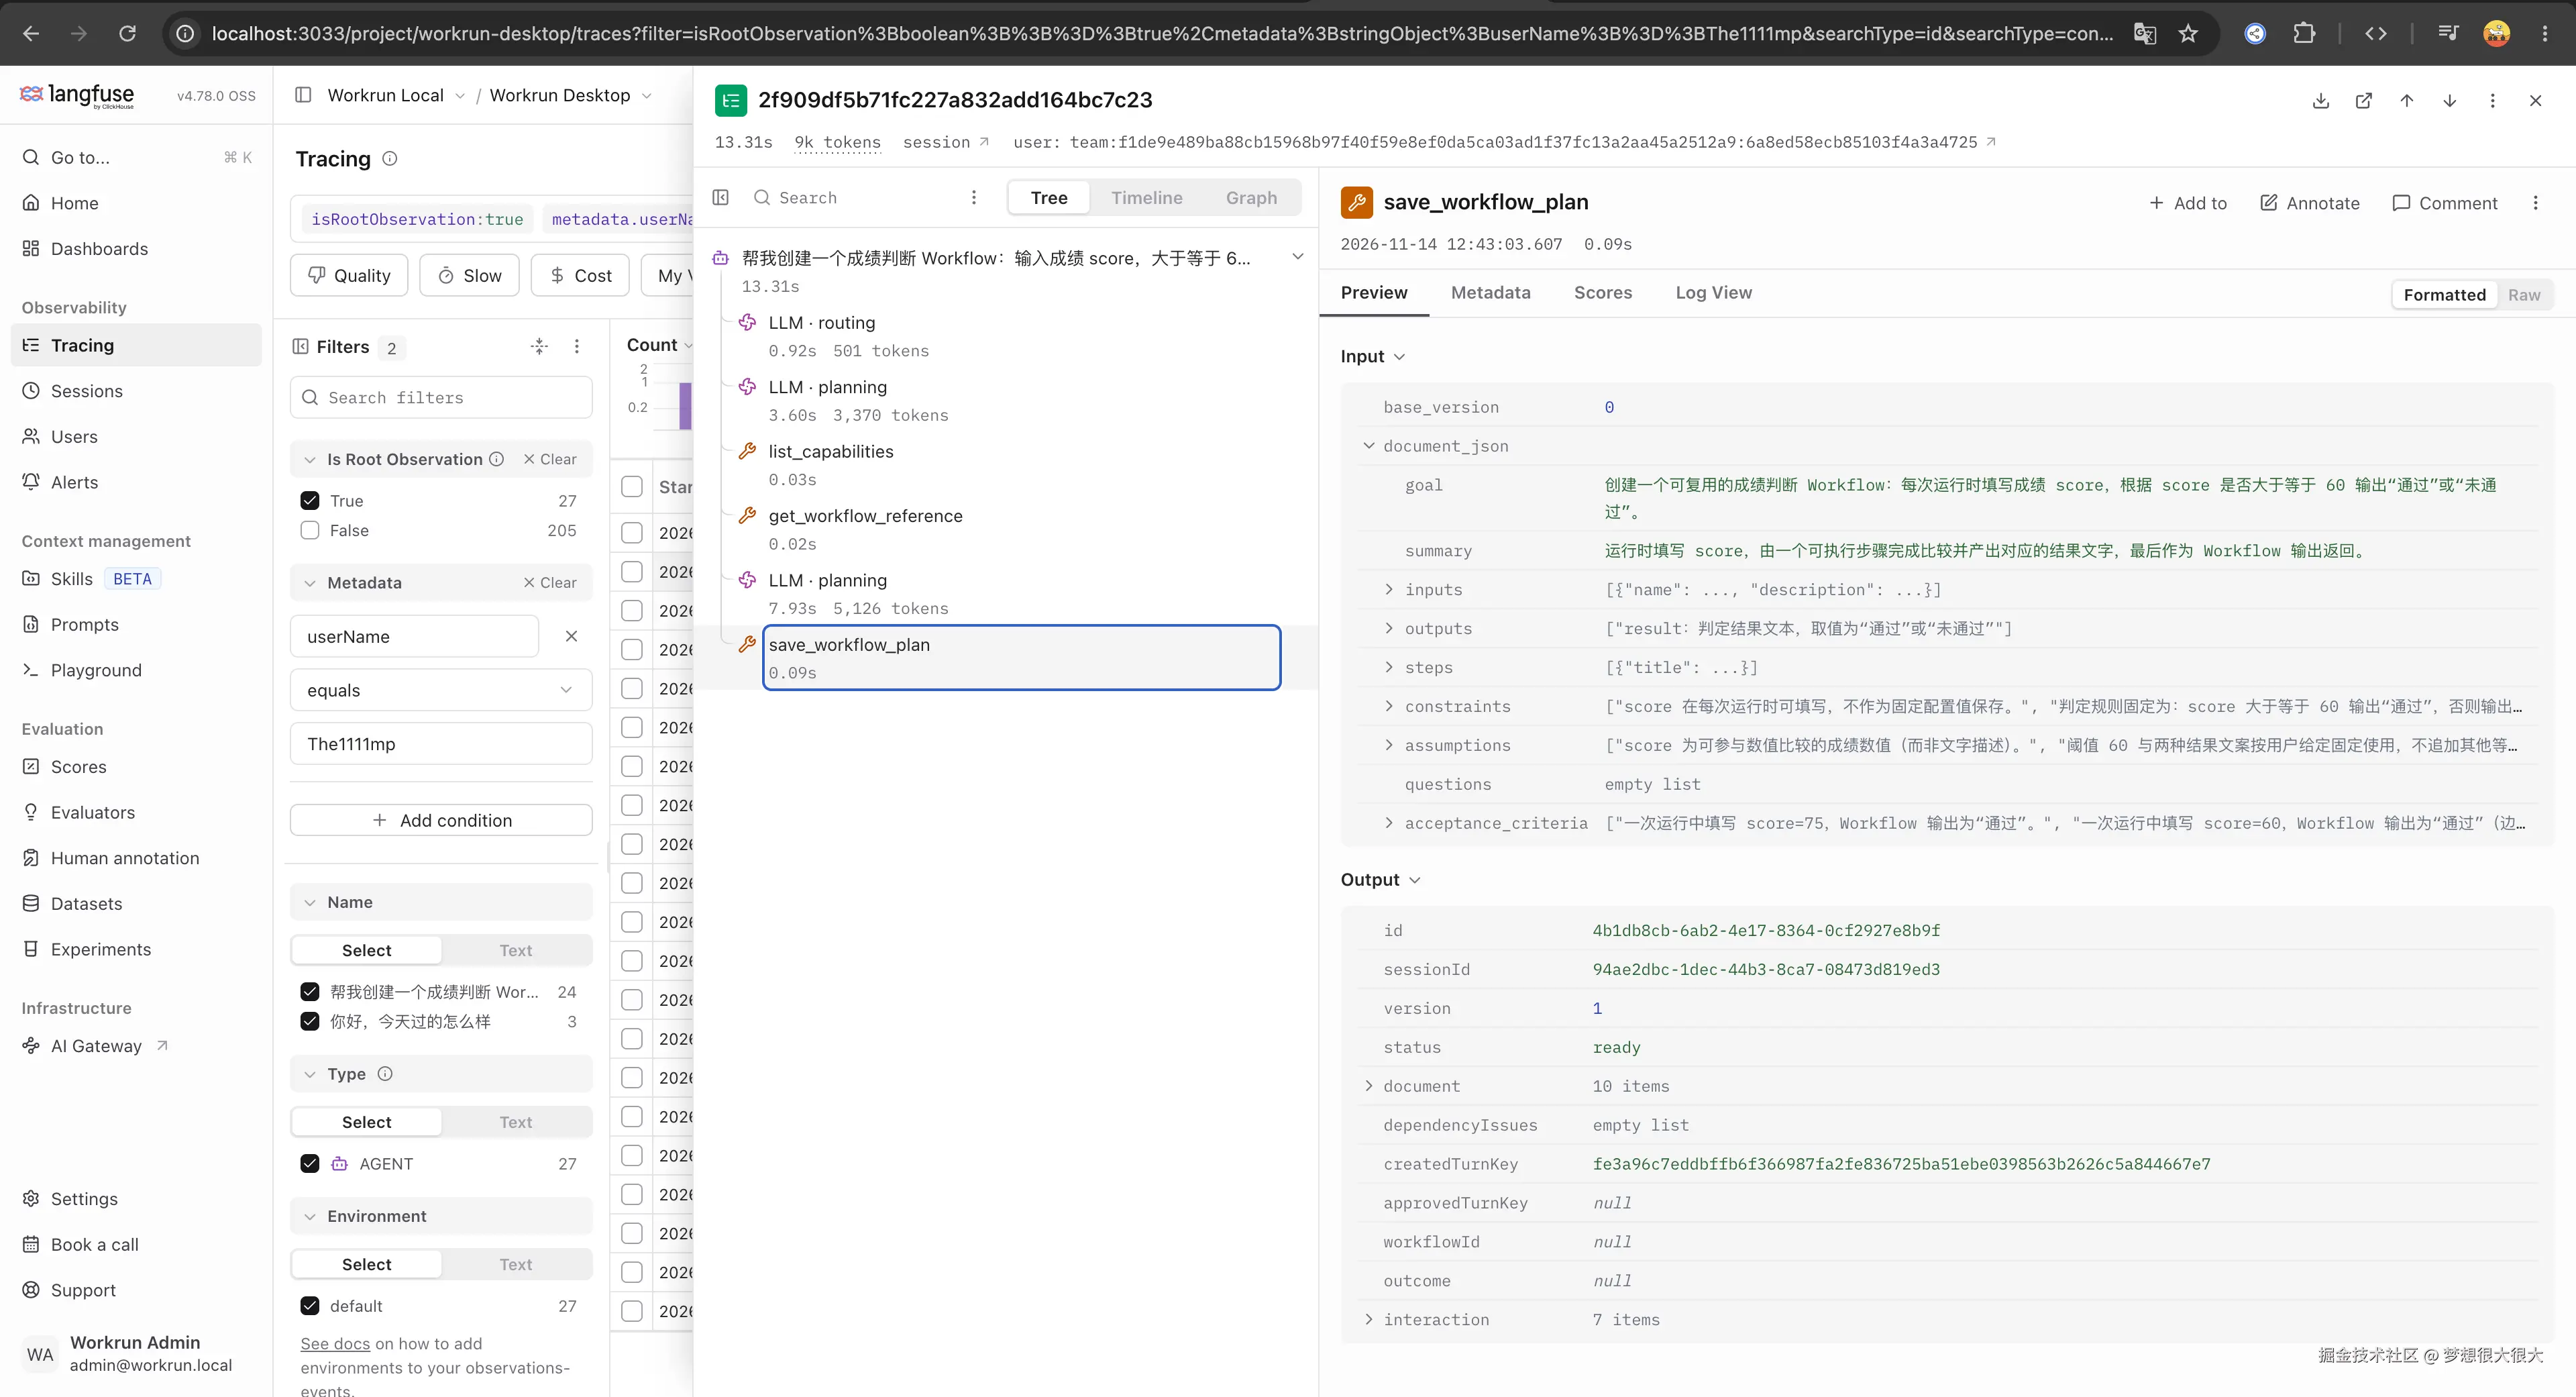
我用成绩判断做测试,不是因为系统只需要处理这种需求。它足够简单,能让我更容易分辨:这次复杂性到底来自用户,还是来自系统自己。
这也给后面的评估加了一个前提:先确认请求走对了、结果可用,再比较花了多少钱。走错流程得到一个低用量,没有意义。
预算与归属,是另外一笔账
Langfuse 让我能追问为什么花这些 Token。但团队模式还需要回答:谁可以调用哪些模型,一共能花多少,每个人分别花了多少?
这部分我接入了 LiteLLM Proxy。
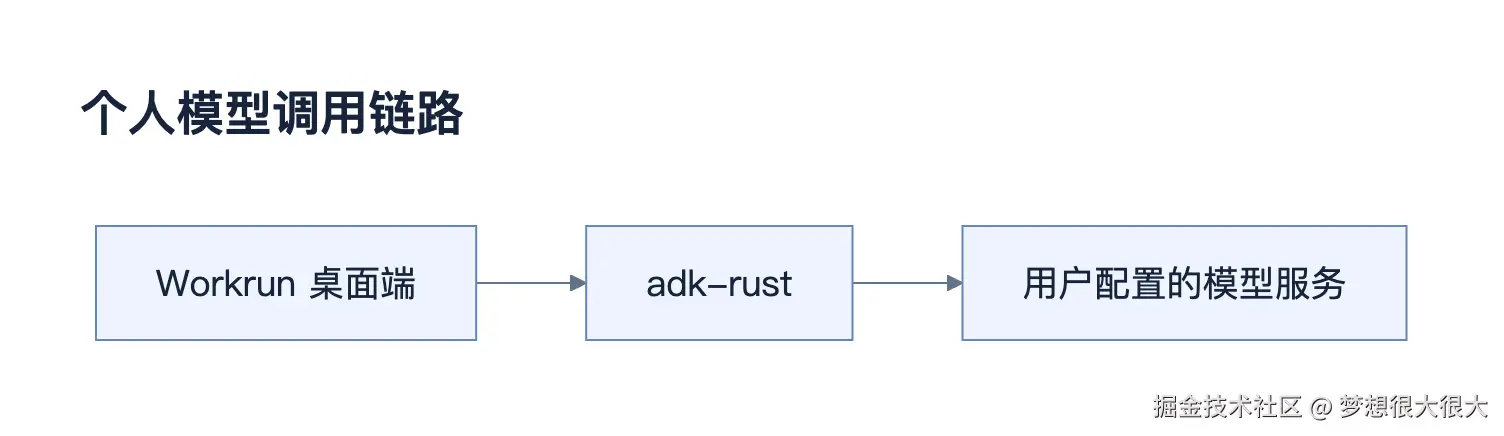
个人自行配置模型时,调用比较直接:
团队模型增加 Server 和网关:
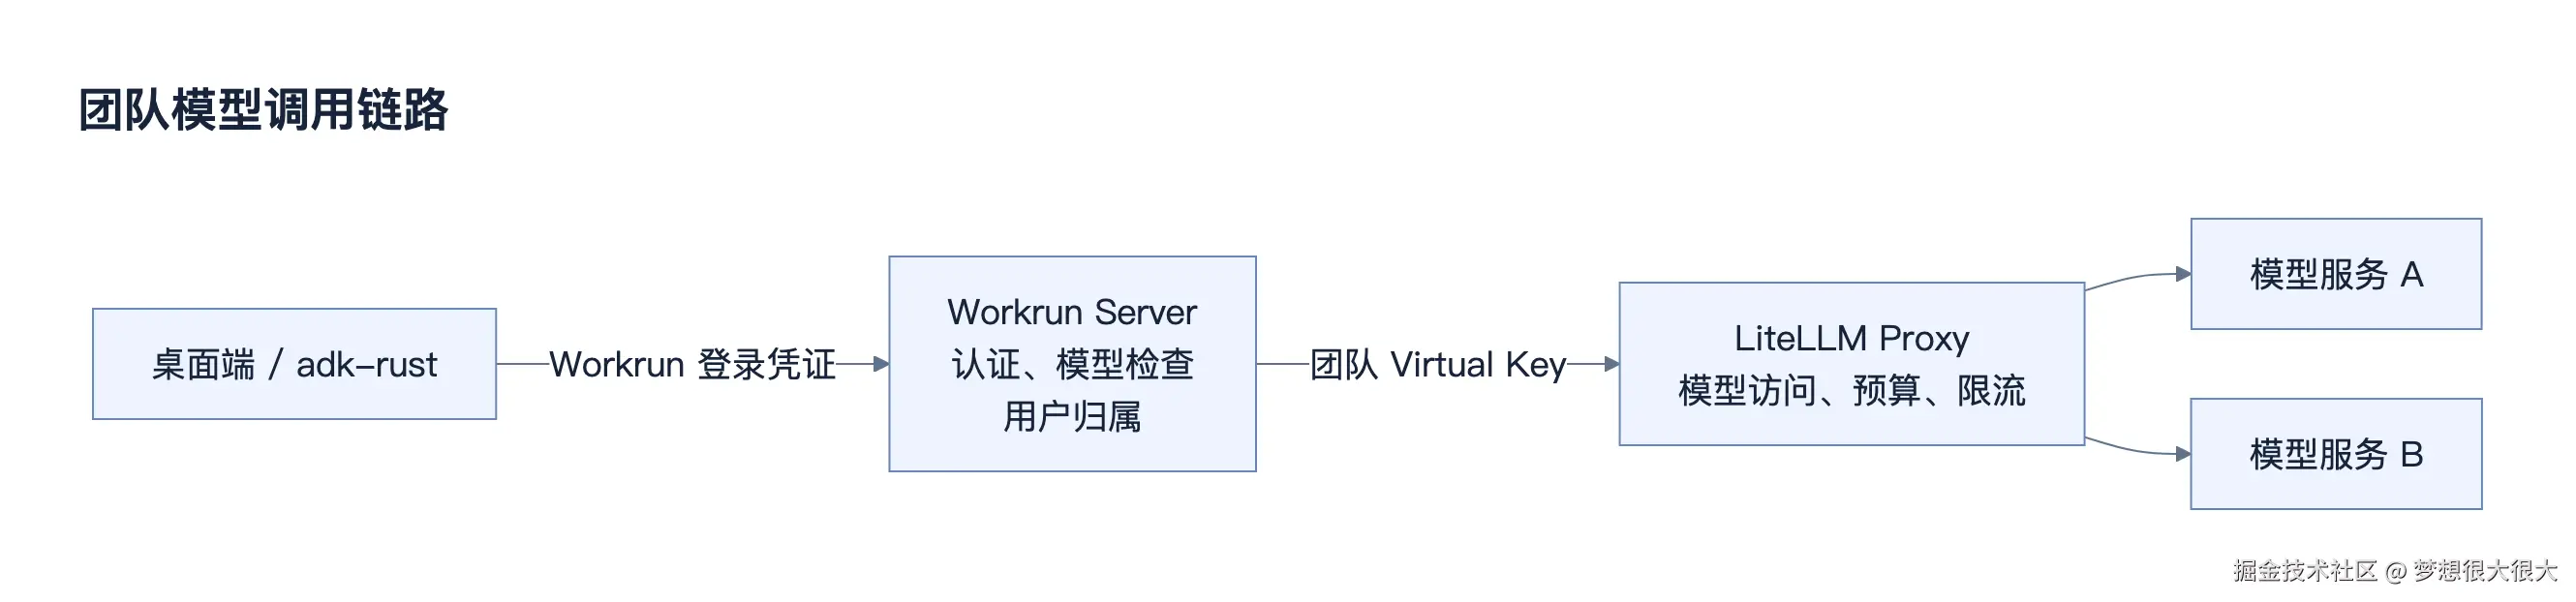
个人直连仍然存在。团队凭证留在服务端,预算与限流集中在网关,不再散落到各个客户端。LiteLLM 已经提供 Virtual Key 和相关控制能力,我没必要在 Workrun 里再写一套。Virtual Key、预算与限流
这里有个容易混淆的点:团队共用一把 Virtual Key,不等于团队成员只能合并统计。
Workrun 使用 End User 字段区分成员。Server 根据已认证用户生成稳定标识:
ts
const endUser = `workrun:${settings.deploymentId}:${encodeURIComponent(userId)}`;

const request = {
  ...adaptJsonOutput(parameters, configuredAliases),
  user: endUser,
  metadata: {
    workrun_request_id: requestId,
    workrun_team_id: settings.teamId,
  },
};
deploymentId 区分部署,userId 区分成员。最终可能是:
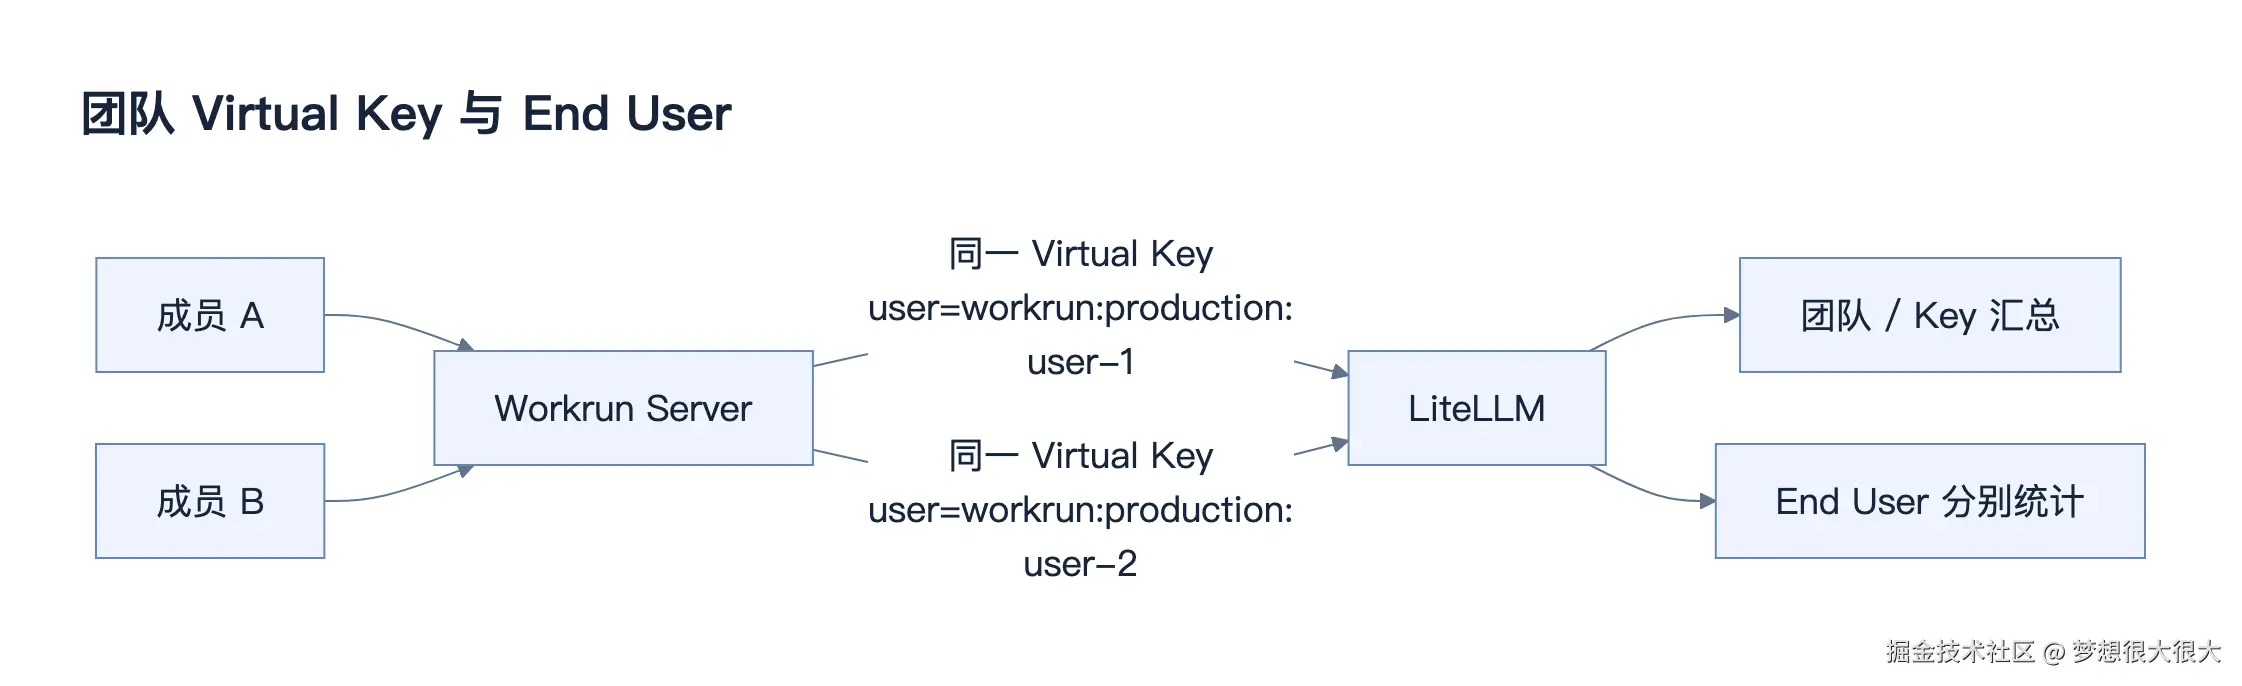
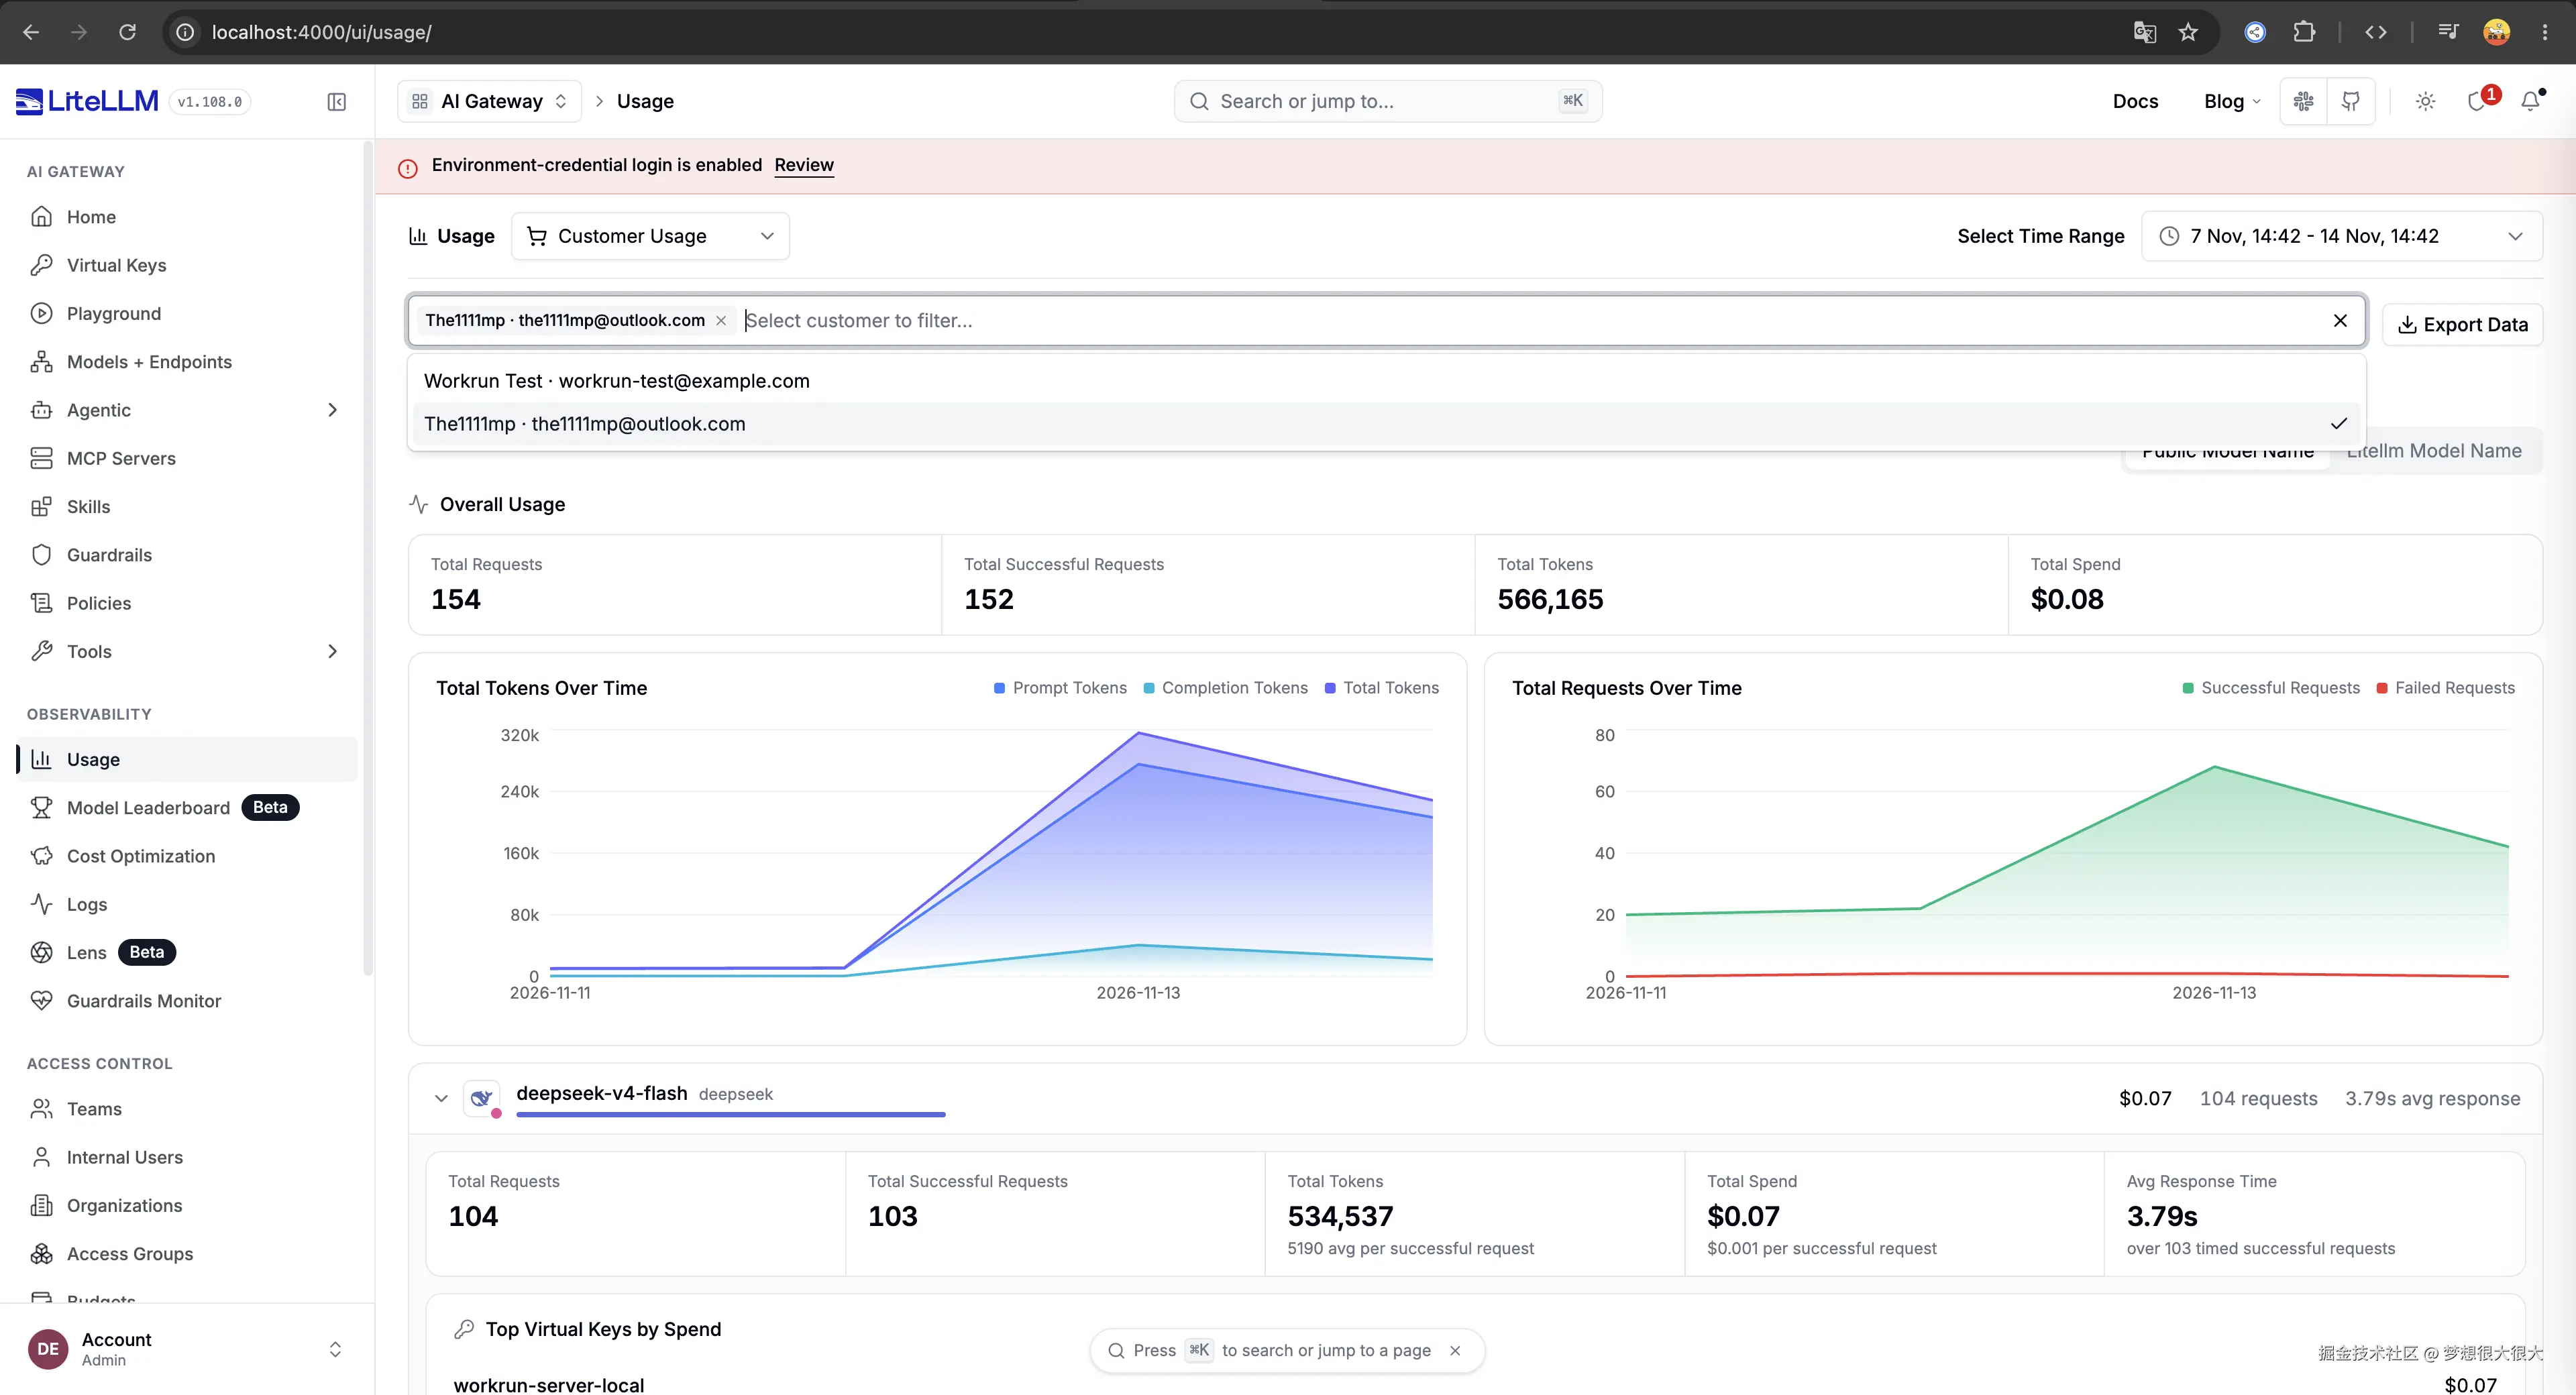
LiteLLM 支持根据请求中的 user 跟踪 End User 消耗。Customer Usage 文档
但这个身份不能让客户端随便填。Server 写入字段时会覆盖客户端声明,测试也验证了两个用户即使提交伪造身份,发出的仍然是各自的真实标识:
ts
expect(sent.map((request) => request.user)).toEqual([
  "workrun:deployment-a:user-1",
  "workrun:deployment-a:user-2",
]);
Responses 也写入相同的 user,另将其哈希用于 safety_identifier。后者是另一个协议字段,不替代统计归属。
Virtual Key 需要在网关侧绑定团队;workrun_team_id 只是业务元数据。传入 user 也不代表自动设好了个人额度,需要成员预算时,仍要另外配置 End User 限制。
这部分边界我希望保持简单:凭证负责团队访问,服务端认证决定用户身份,请求字段负责把身份传给网关。不要为了统计每位成员,再给产品增加一套 Key 的生命周期。
网关统一了入口,没有消除模型差异
接入 LiteLLM 后,切换到当时配置的 DeepSeek,直接遇到 400:
text
The model gateway rejected the request.

error.type: invalid_request_error
error.code: upstream_error
查到实际请求,问题是结构化输出。路由需要固定 JSON,原来的 json_schema 不能被当时这条模型路径直接接受。
最后通过配置声明需要适配的模型别名:
env
LITELLM_JSON_OBJECT_MODELS=deepseek-v4-flash命中后,将格式改为 json_object,Schema 放入指令。Chat Completions 的核心修改是:
ts
return {
  ...parameters,
  response_format: { type: "json_object" },
  messages: [
    ...parameters.messages,
    {
      role: "system",
      content: instruction(format.json_schema.schema),
    },
  ],
};
Responses 分别处理 text.format 和 instructions。代码集中在 apps/server/src/modules/llm/llm.output.ts。
JSON Mode 不能保证业务字段符合 Schema,应用侧解析和校验仍然保留。这项适配也只针对配置的模型路径,不据此推断所有 DeepSeek 部署的能力。
我没有顺手设计一套模型能力探测框架。当前需要的是一个能解释、能测试的兼容入口。做得更泛化,并不会帮助这次排查。
提示词短了,整轮消耗却可能更高
有一轮,用户还没确认方案,规划阶段就用了 31732 Token。
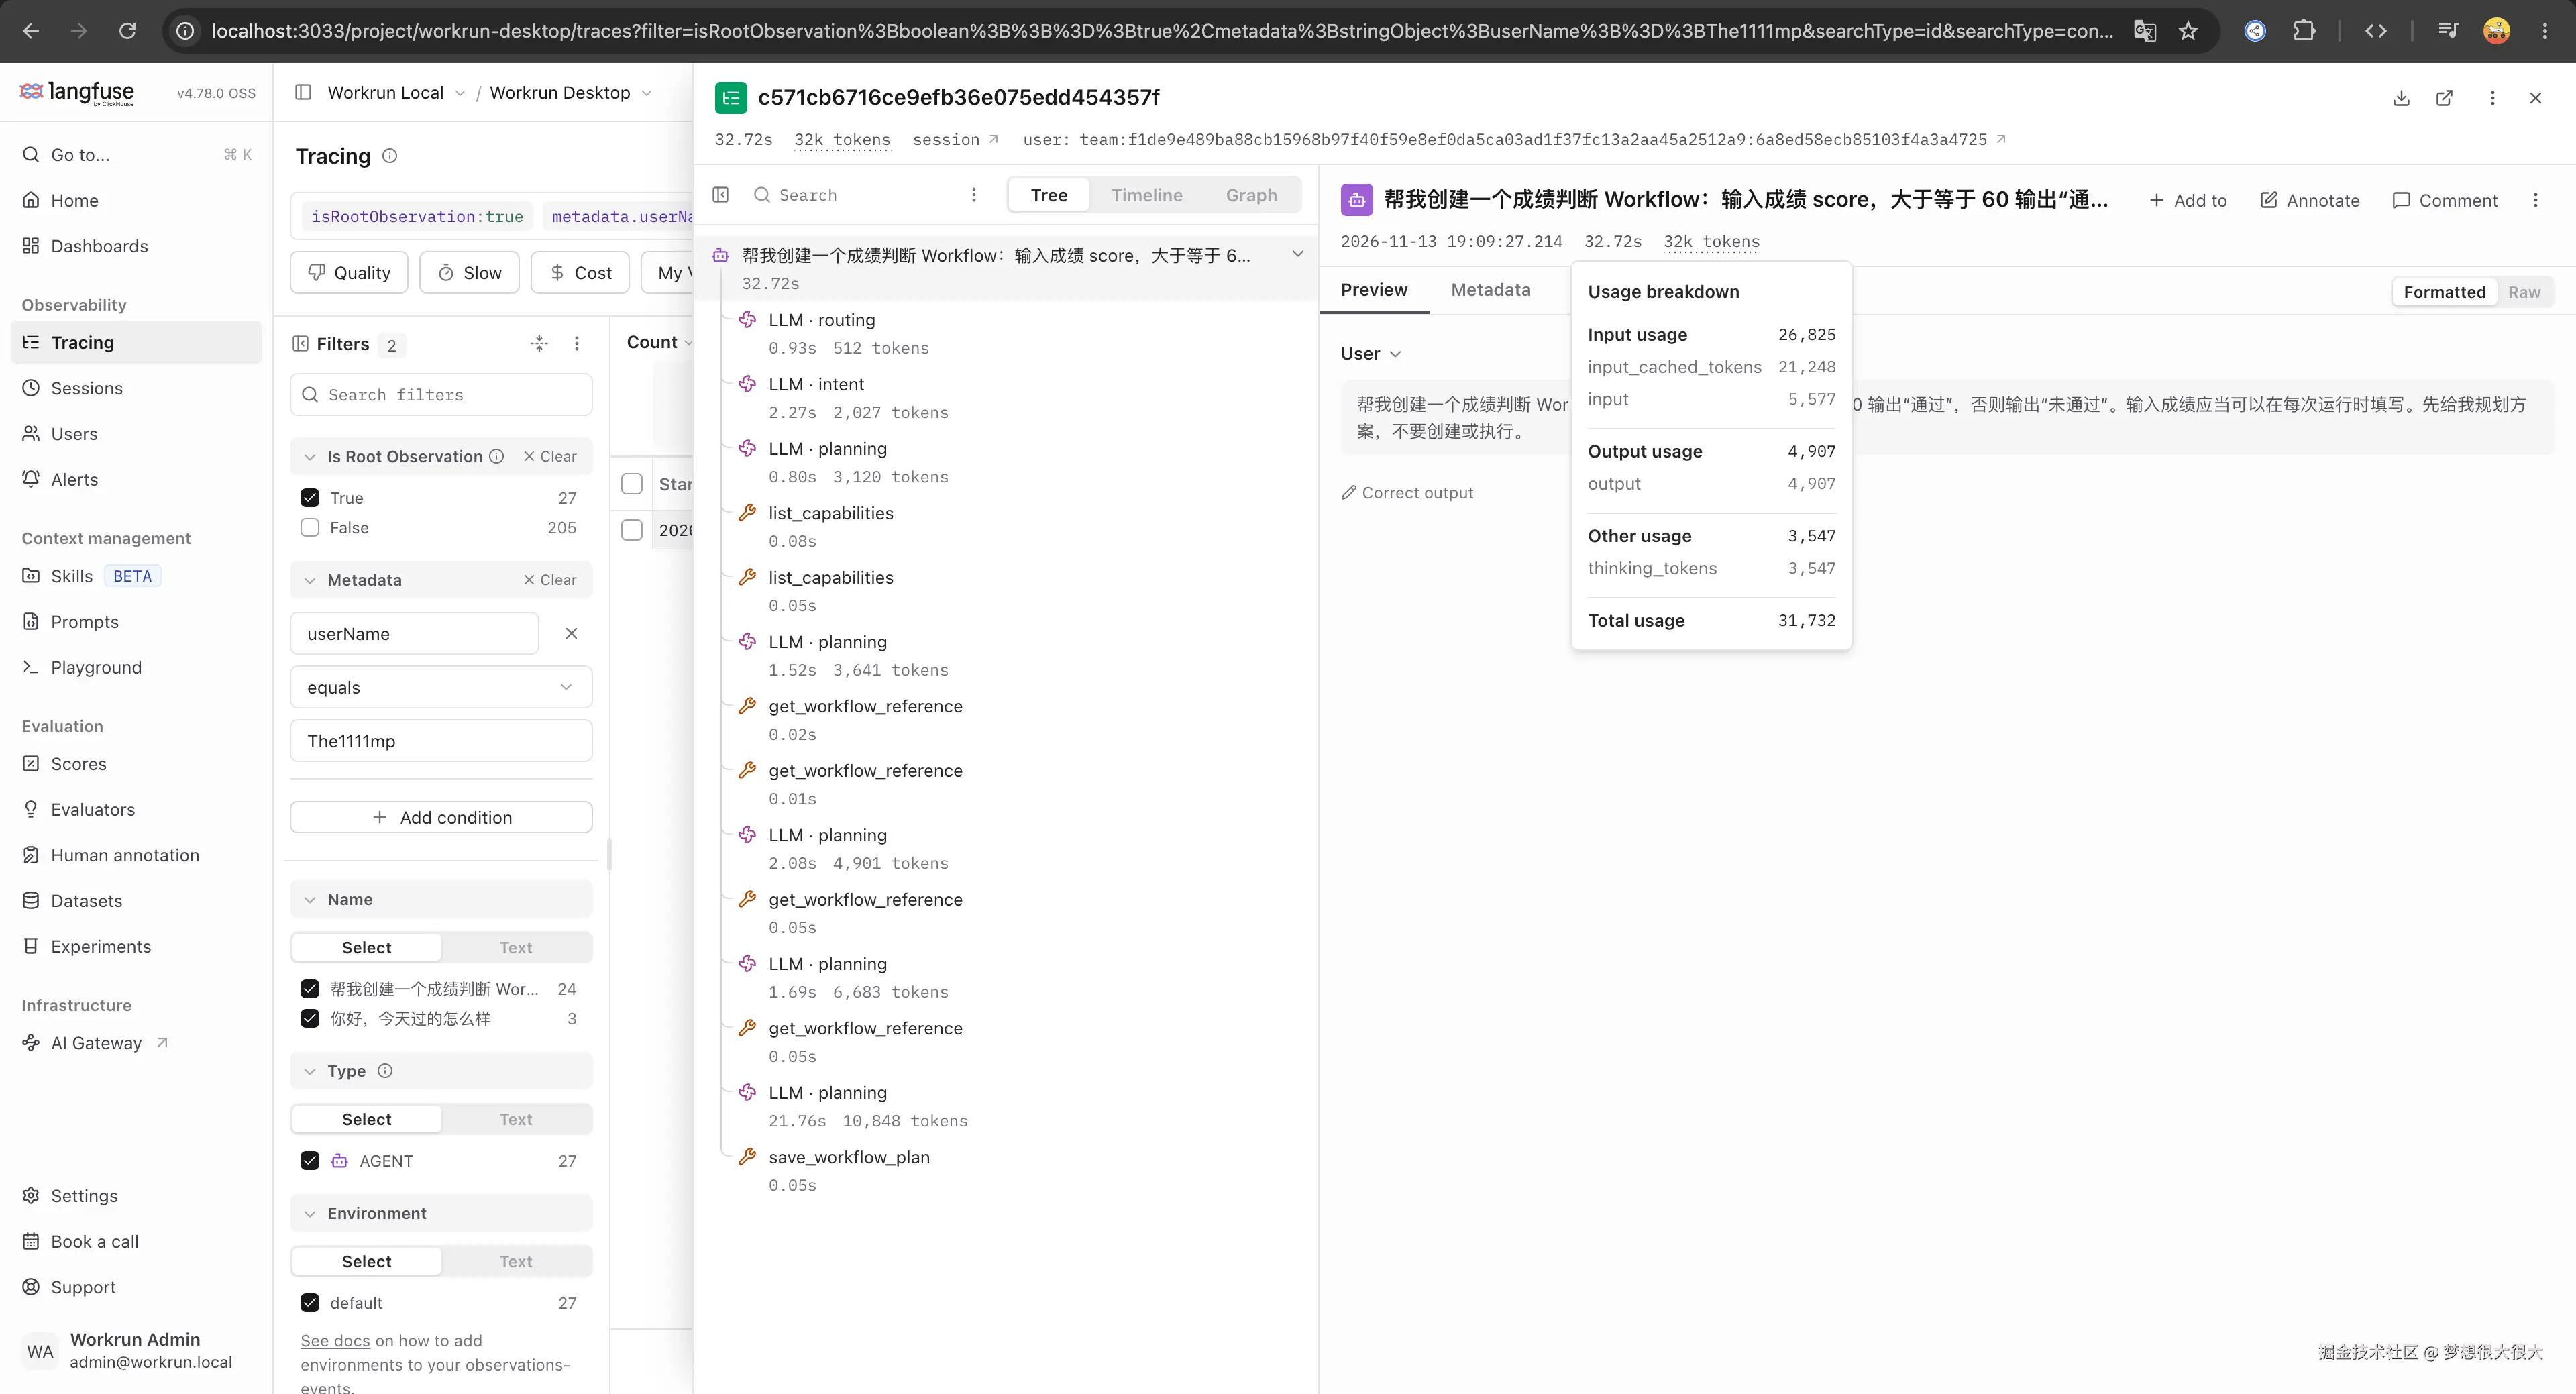
接下来几轮开始反复:删提示词、缩短参考内容、再测。某次降低了,下一轮又高了。
这段时间最容易做错的一件事,是把"输入说明更短"当作"任务成本更低"。
模型缺少配置知识,会去查工具。一次工具查询后,结果进入上下文,又发生下一轮调用。省下的那段说明,可能抵不过新增加的一轮请求。
所以我后来更关注信息在哪里出现,而不是一律少给。
规划时,先给节点能力概览,足够判断哪些执行方式可行。编排时,已经有确认过的方案,程序可以提前提供相关契约。context_contracts 收集 Start、End、方案建议节点和现有定义使用的节点,再读取它们的契约:
rust
reference(&json!({
    "topic": "nodes",
    "node_types": kinds,
    "detail": "summary"
}))
节点契约保留完整 dataSchema、语义和分支句柄。方案里的建议也不是硬限制,需要其他节点仍然可以查询。
另外修了一个很具体的问题:请求 detail=summary 时,指定节点的示例仍可能返回全文。现在摘要分支只返回索引:
rust
if kinds.is_empty() || args["detail"] == "summary" {
    json!({
        "id": example["id"],
        "node_type": example["node_type"],
        "summary": example["summary"]
    })
}
这些调整没有一句"让模型更聪明"的承诺,只是让它少找一遍已经知道的东西,也少读一些当前用不上的内容。
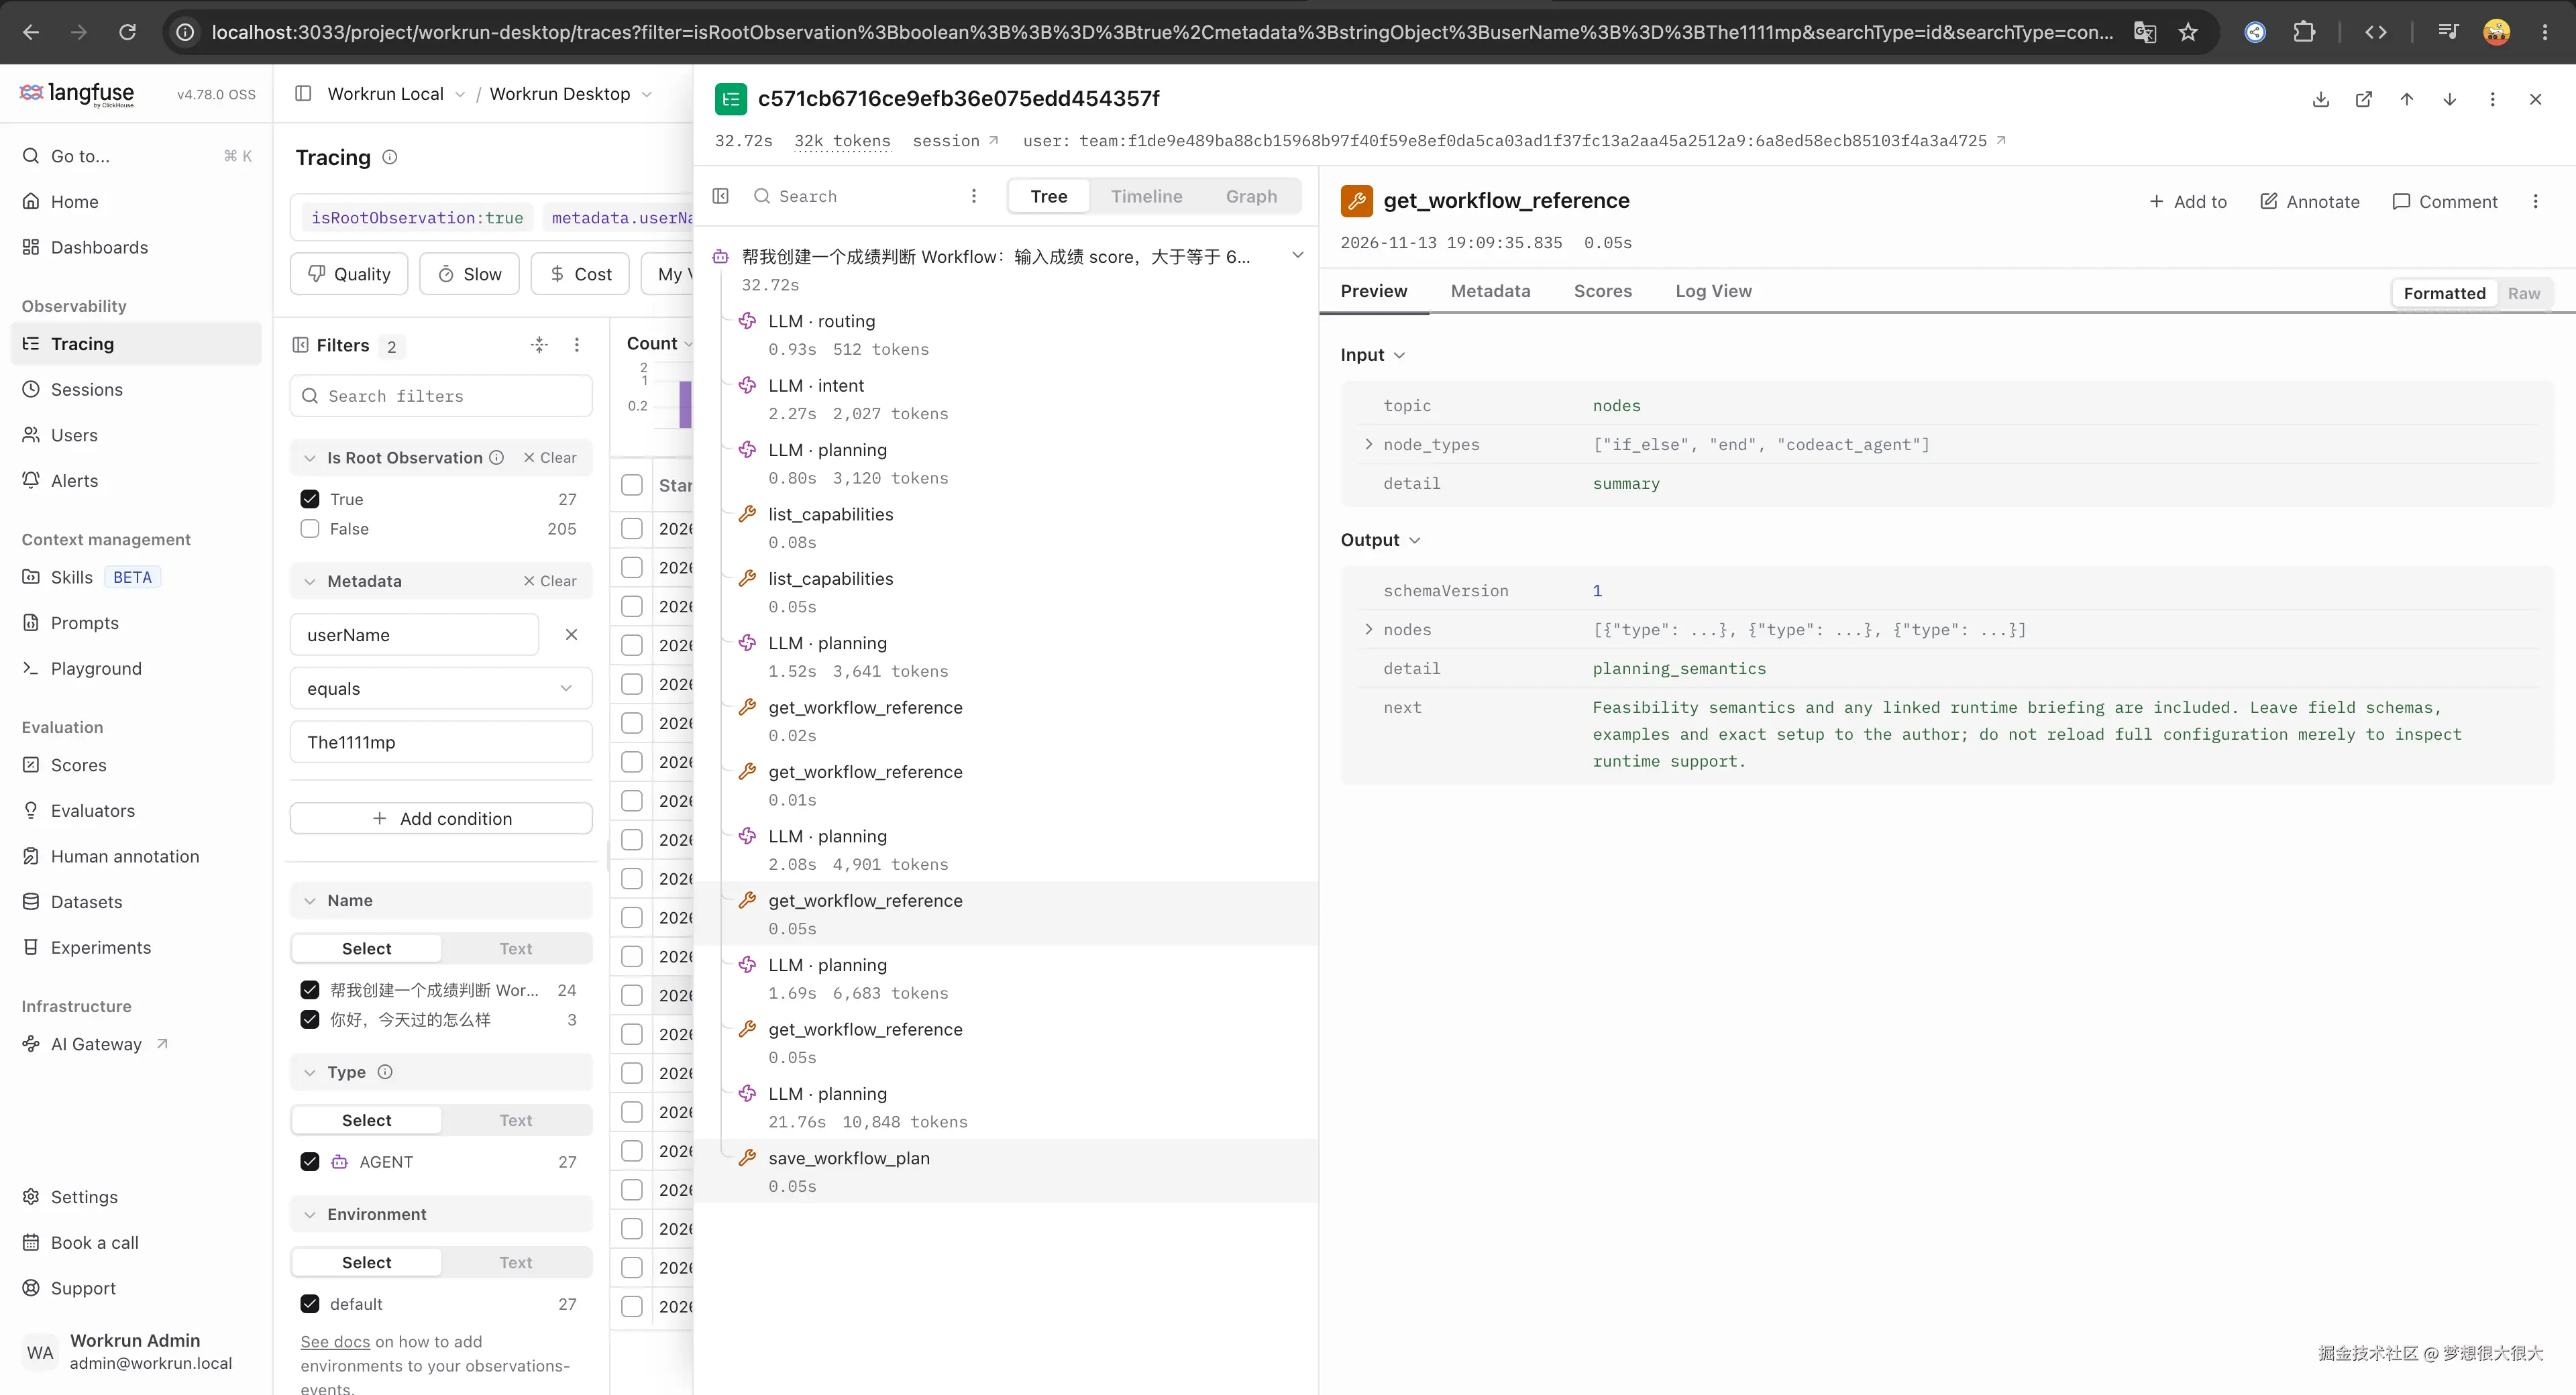
哪些事情,其实不必再问模型
优化到后面,我开始反过来检查:有些调用是不是根本不需要存在?
用户点击确认按钮时,程序已经知道方案 ID 和版本。还要让通用意图模型解释一次"确认第 1 版",没有增加多少信息,却多了消耗和误解机会。现在由原生状态直接恢复对应流程。
保存也是。编排 Agent 保存后总结,上层收到结果再总结,两次都要带上下文。只创建、不执行的请求,原生工具成功返回后就足以结束这一阶段。
实际停止条件仍然检查保存成功和执行范围:
rust
if result.is_ok()
    && agent == "workflow_author"
    && name == "save_workflow_draft"
    && state.saved.is_some()
    && !state.registry.execution_allowed
{
    // 记录原生回执,结束当前调用。
}
不过,第一次去掉总结后,界面只剩卡片。我想要的"创建好了"的正常回复也没了。
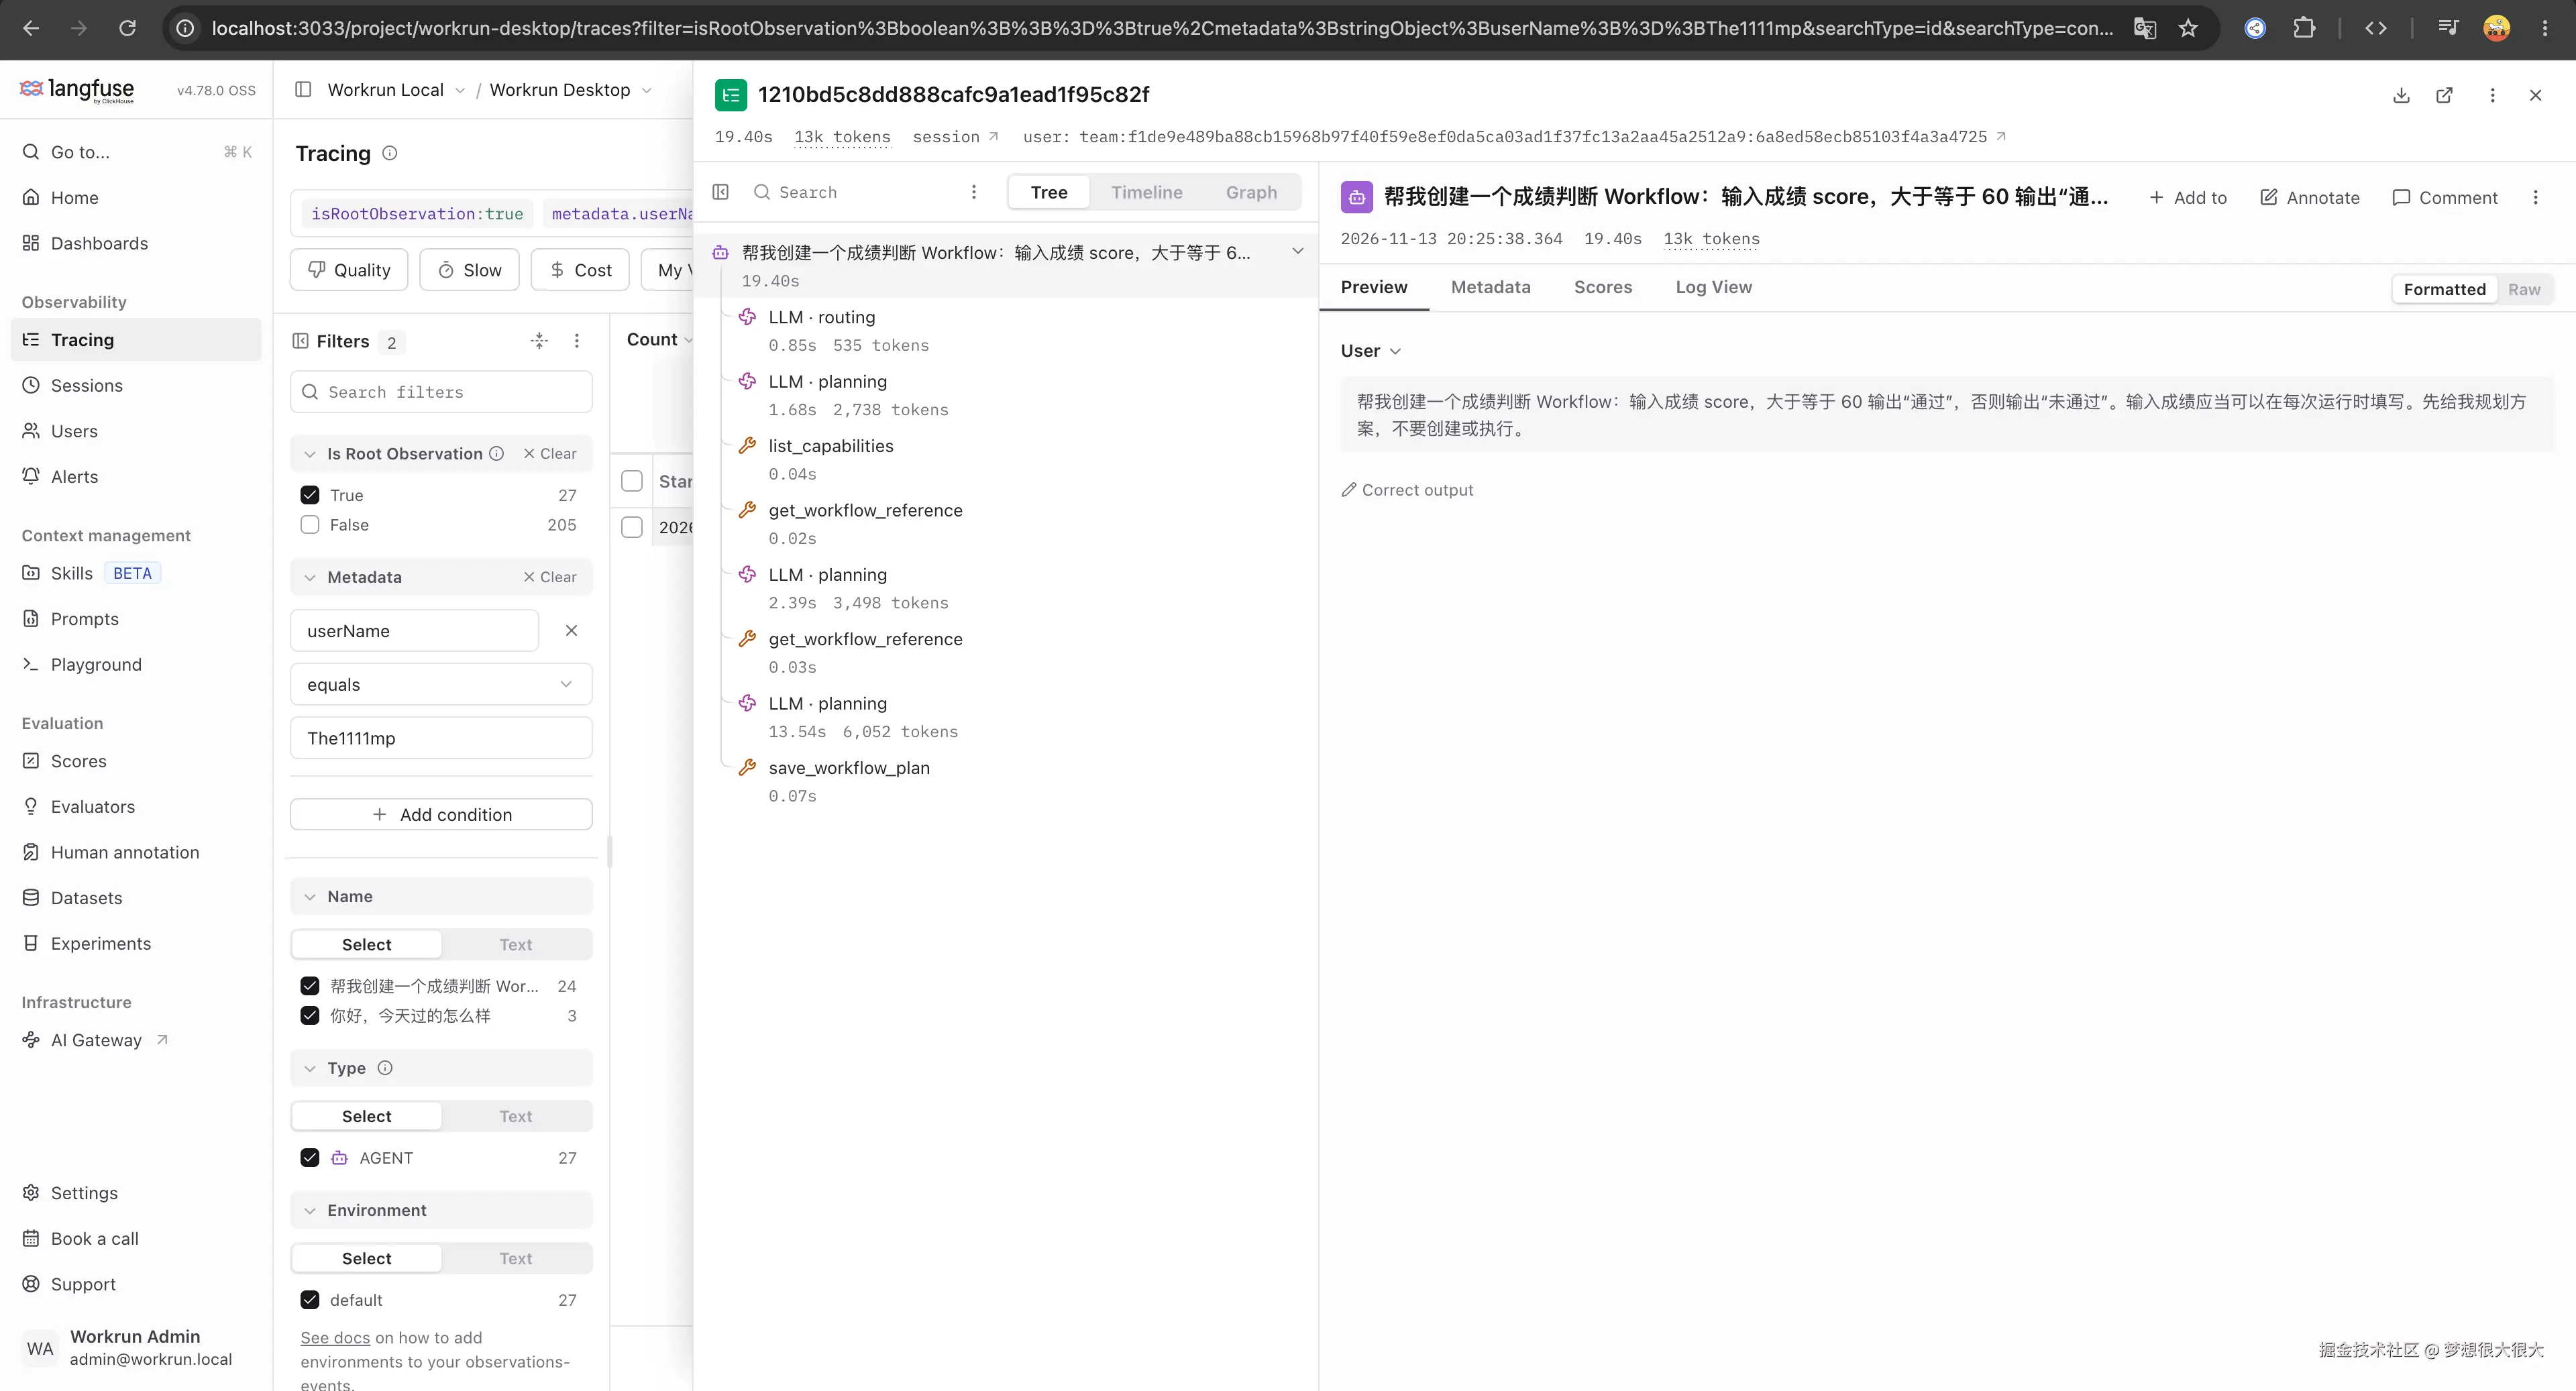
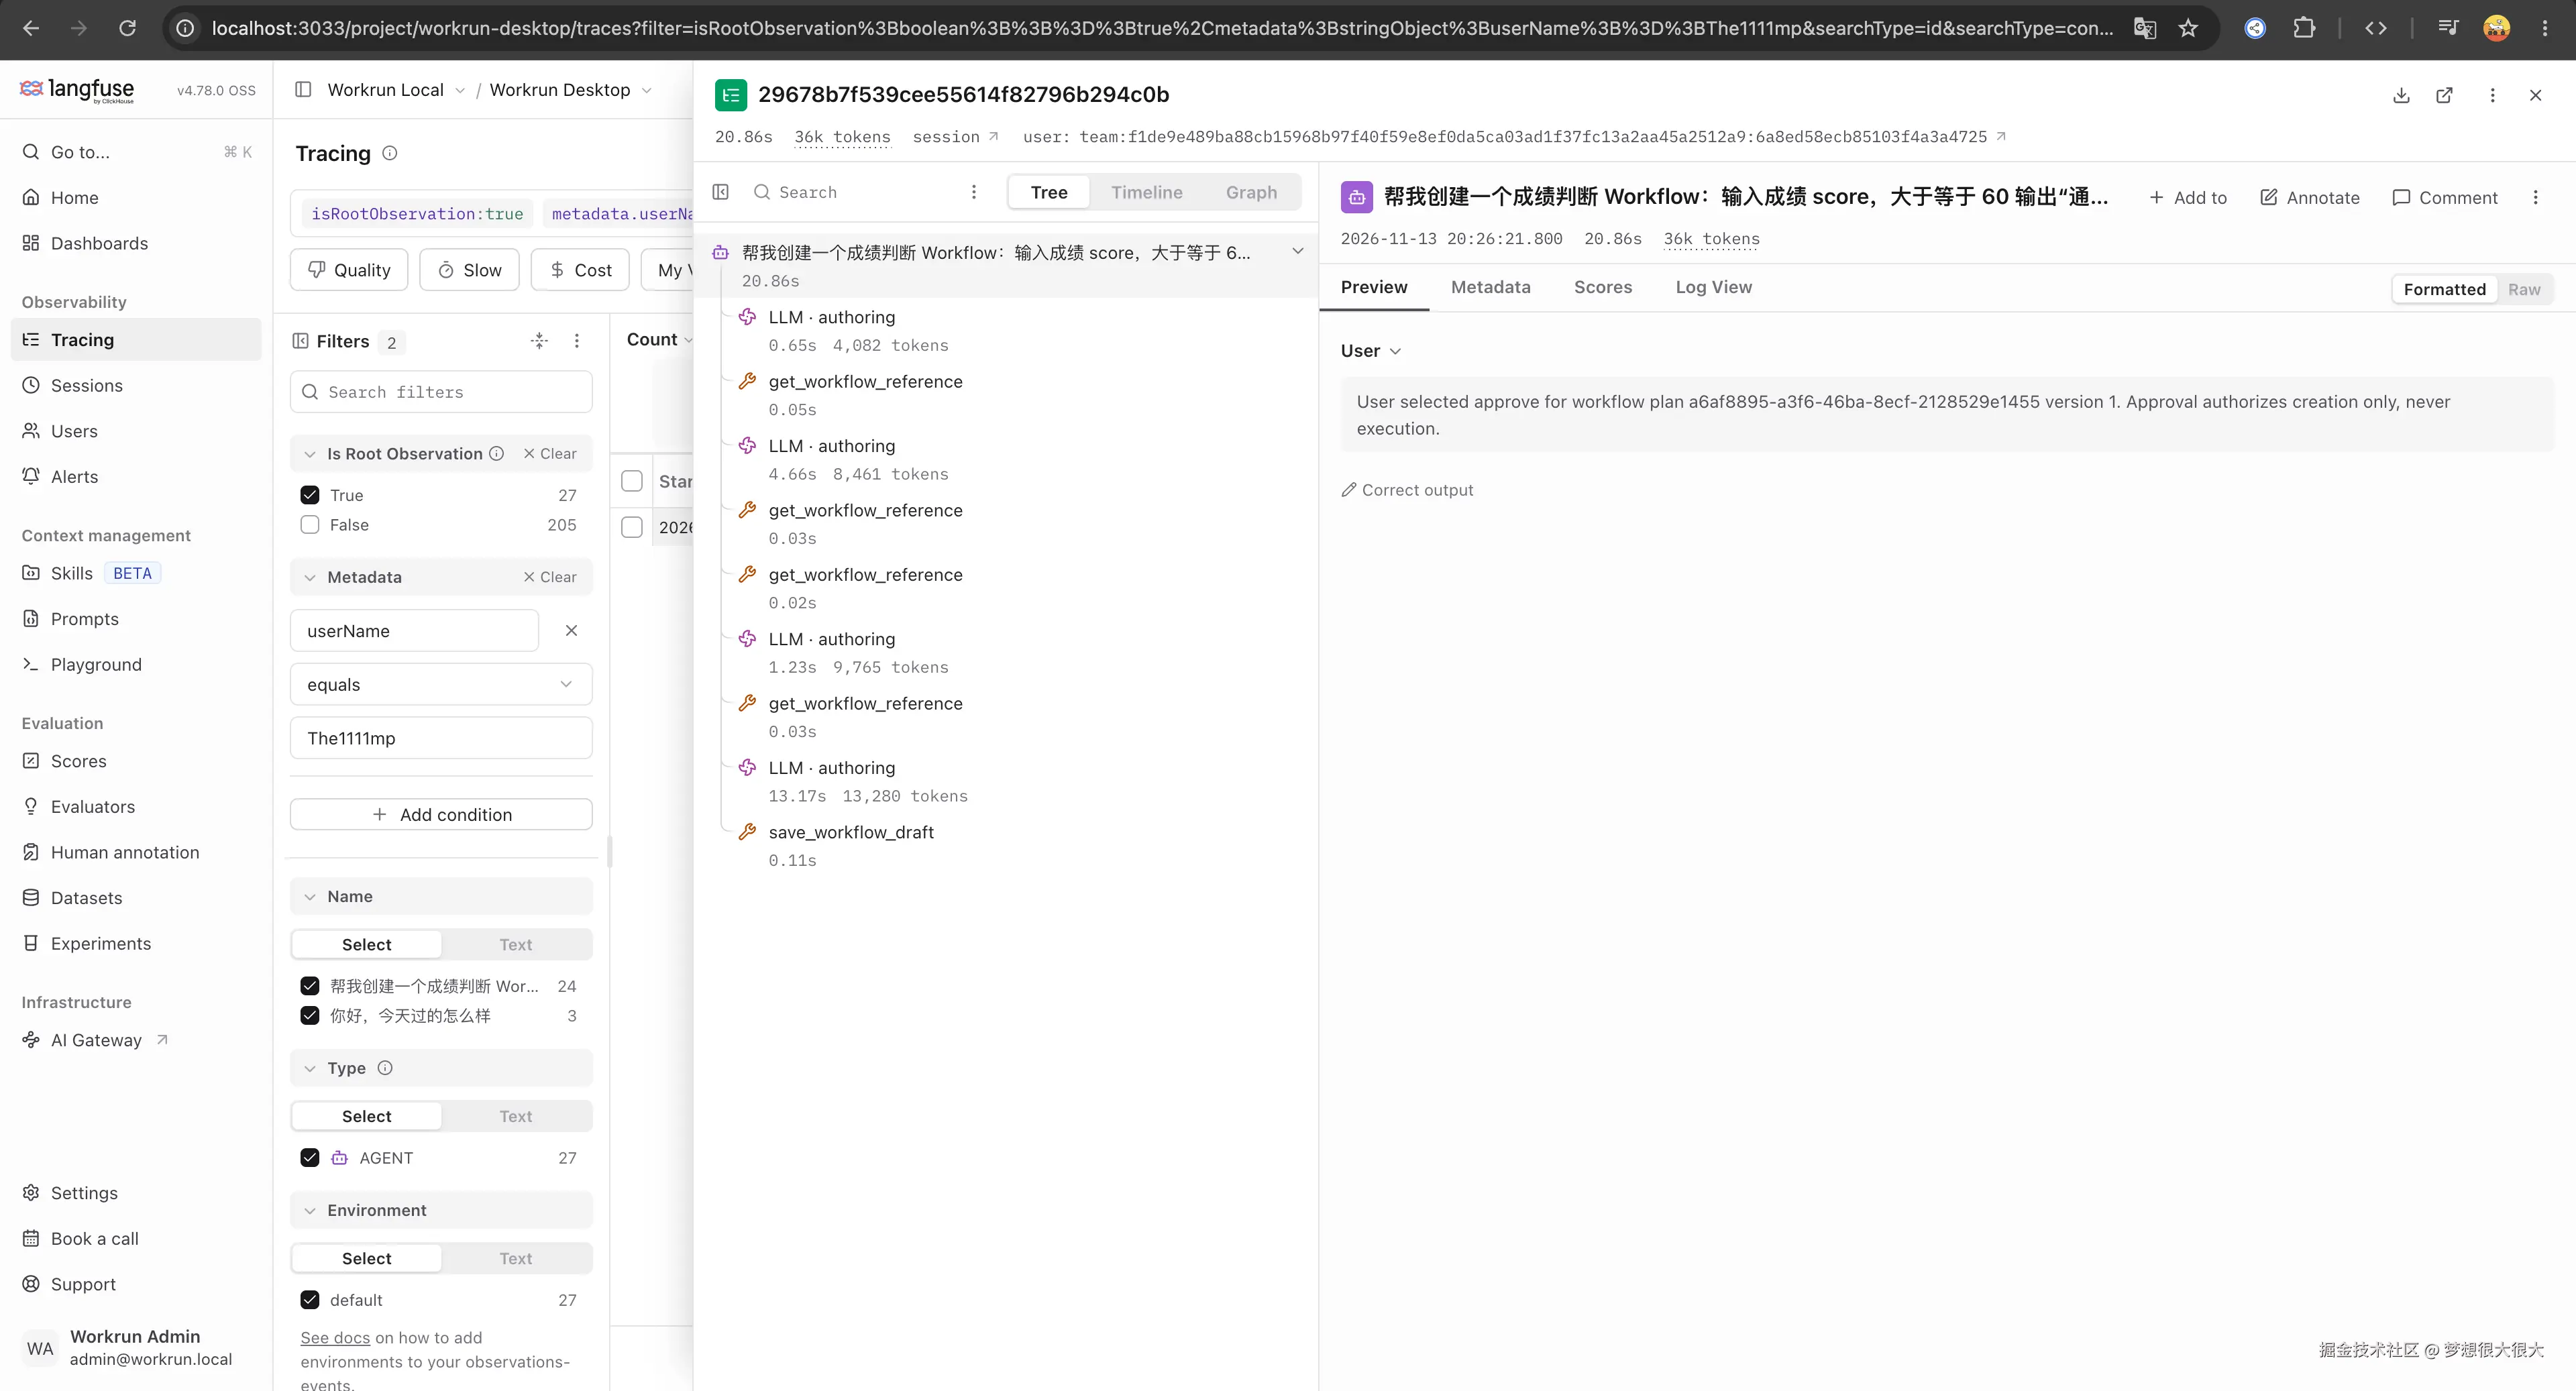
最后在卡片外补了基于原生回执的说明,明确保存、校验、发布、执行状态,不增加模型调用,也不往 Workflow 里增加文案节点。
这类省略不能只看调用树。删掉一个步骤,它原来承担的产品反馈还得接住。
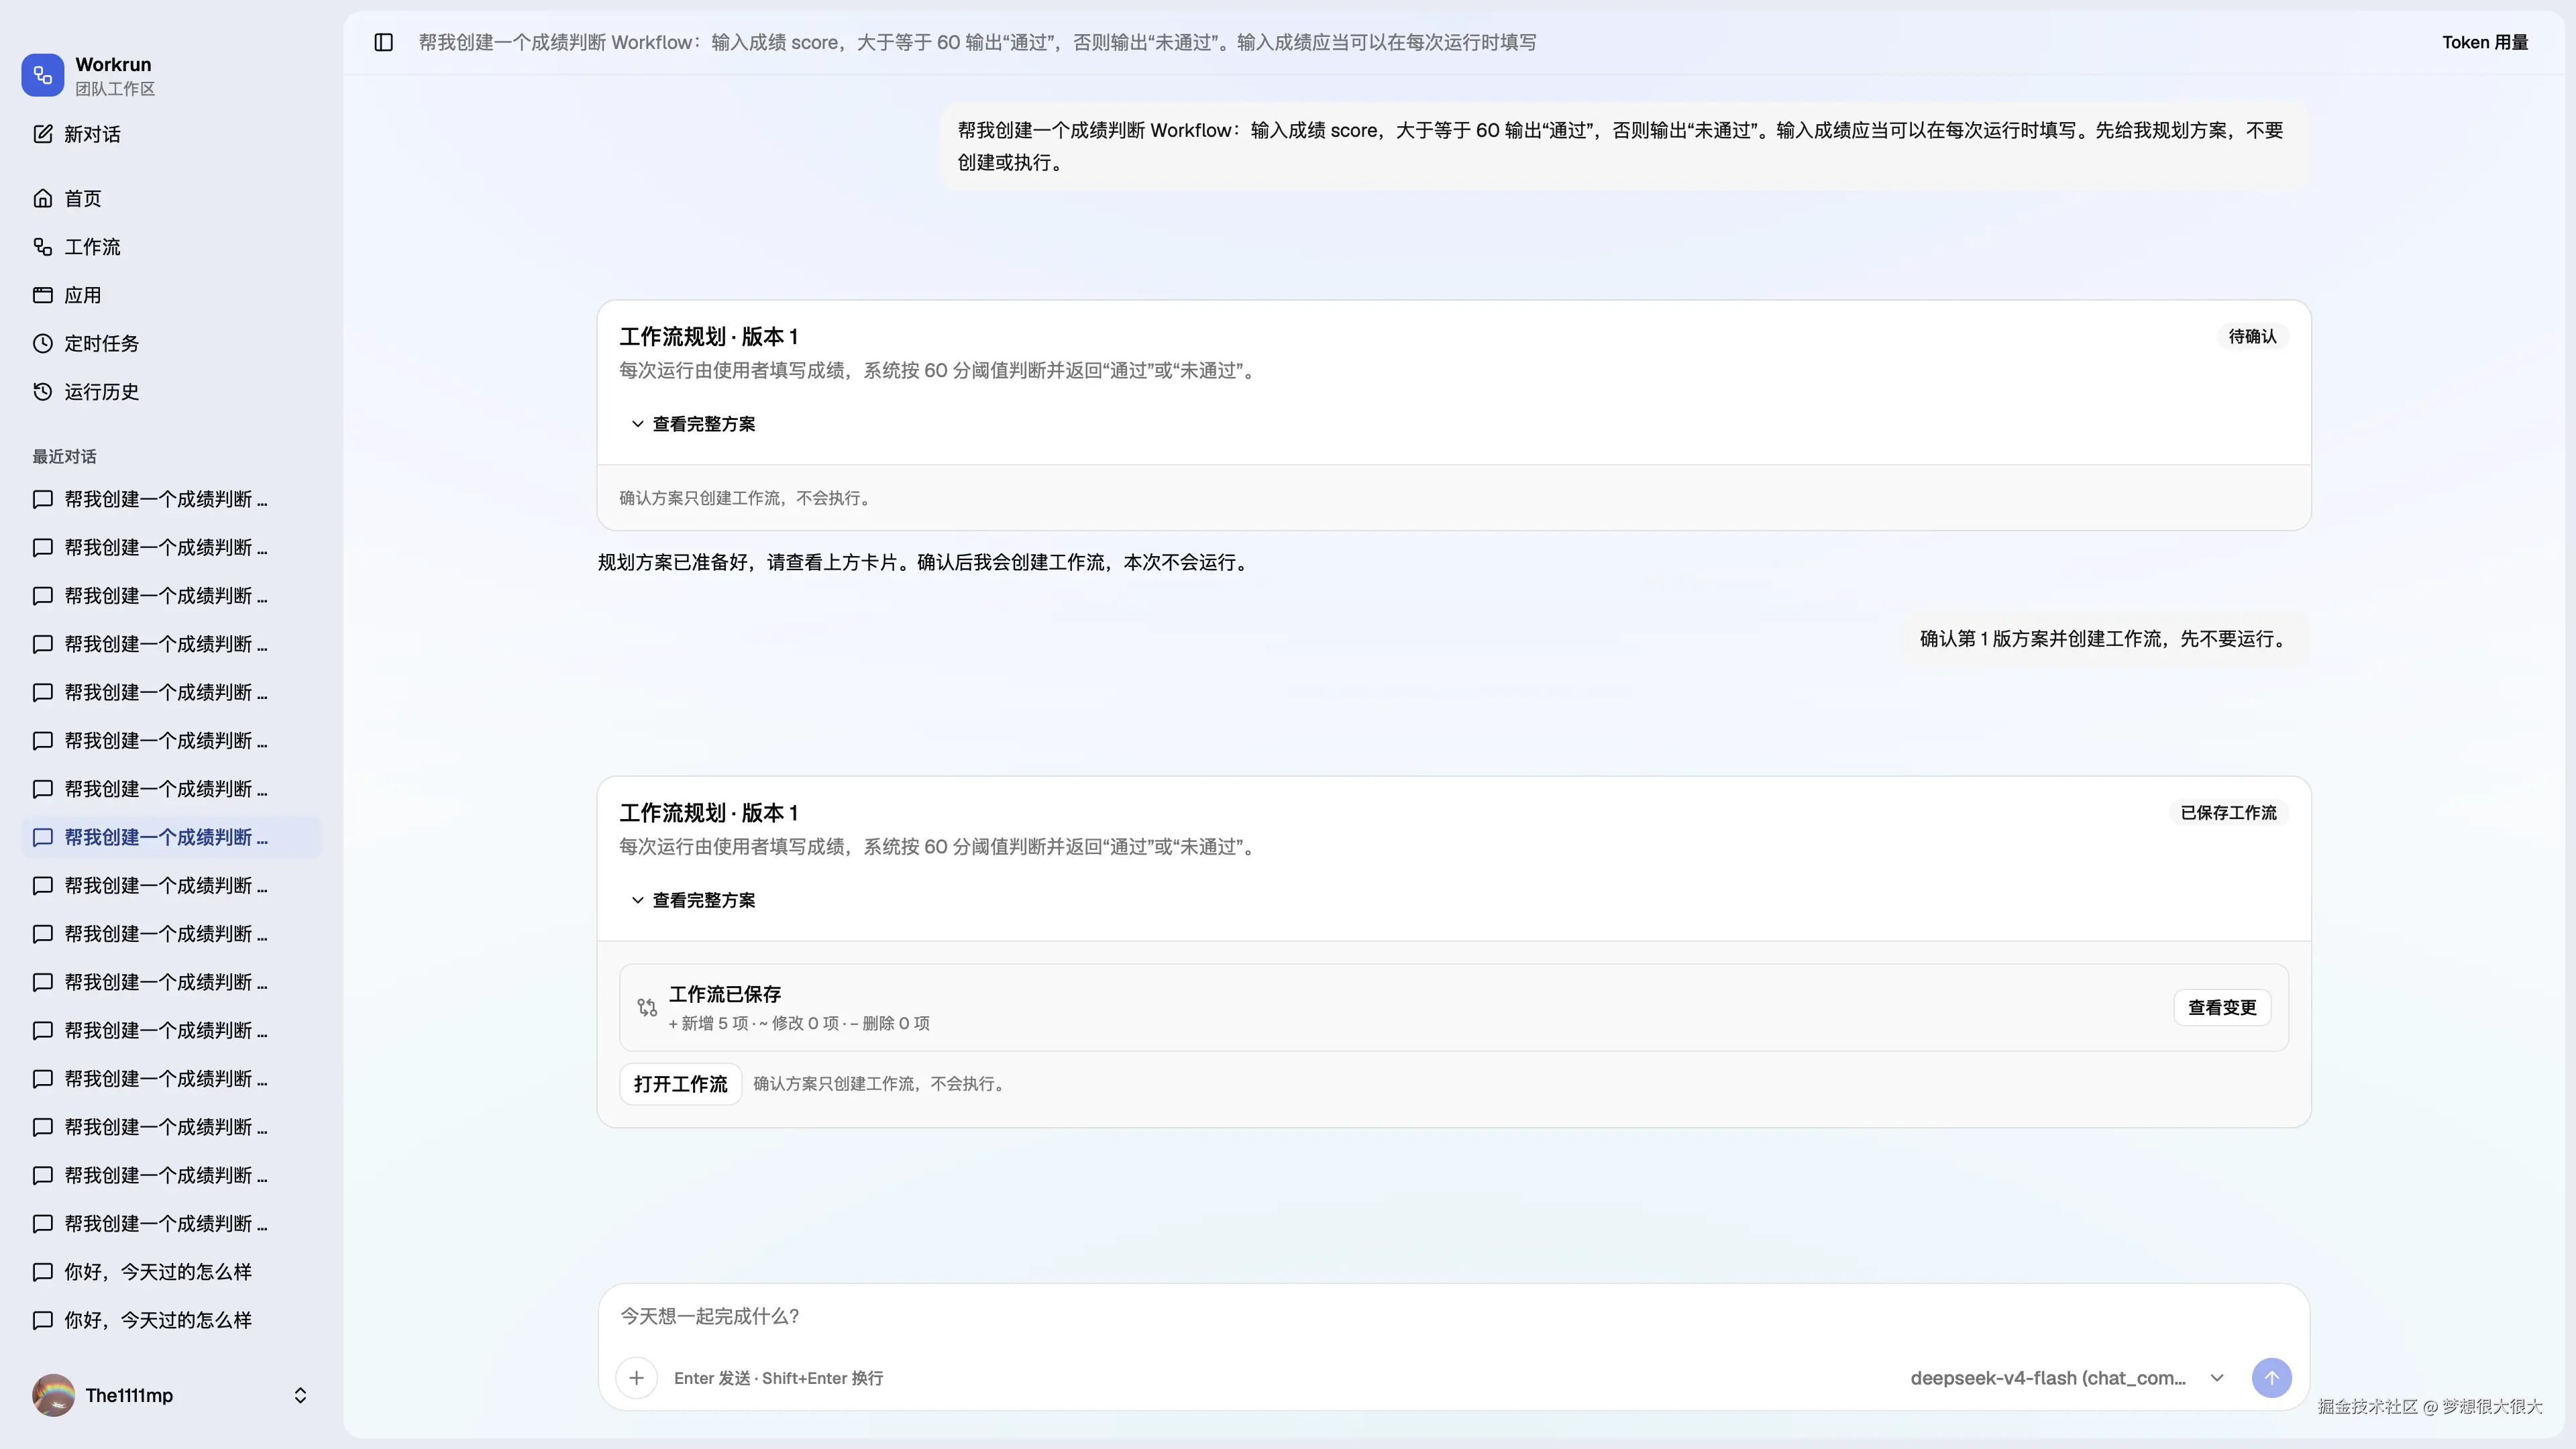
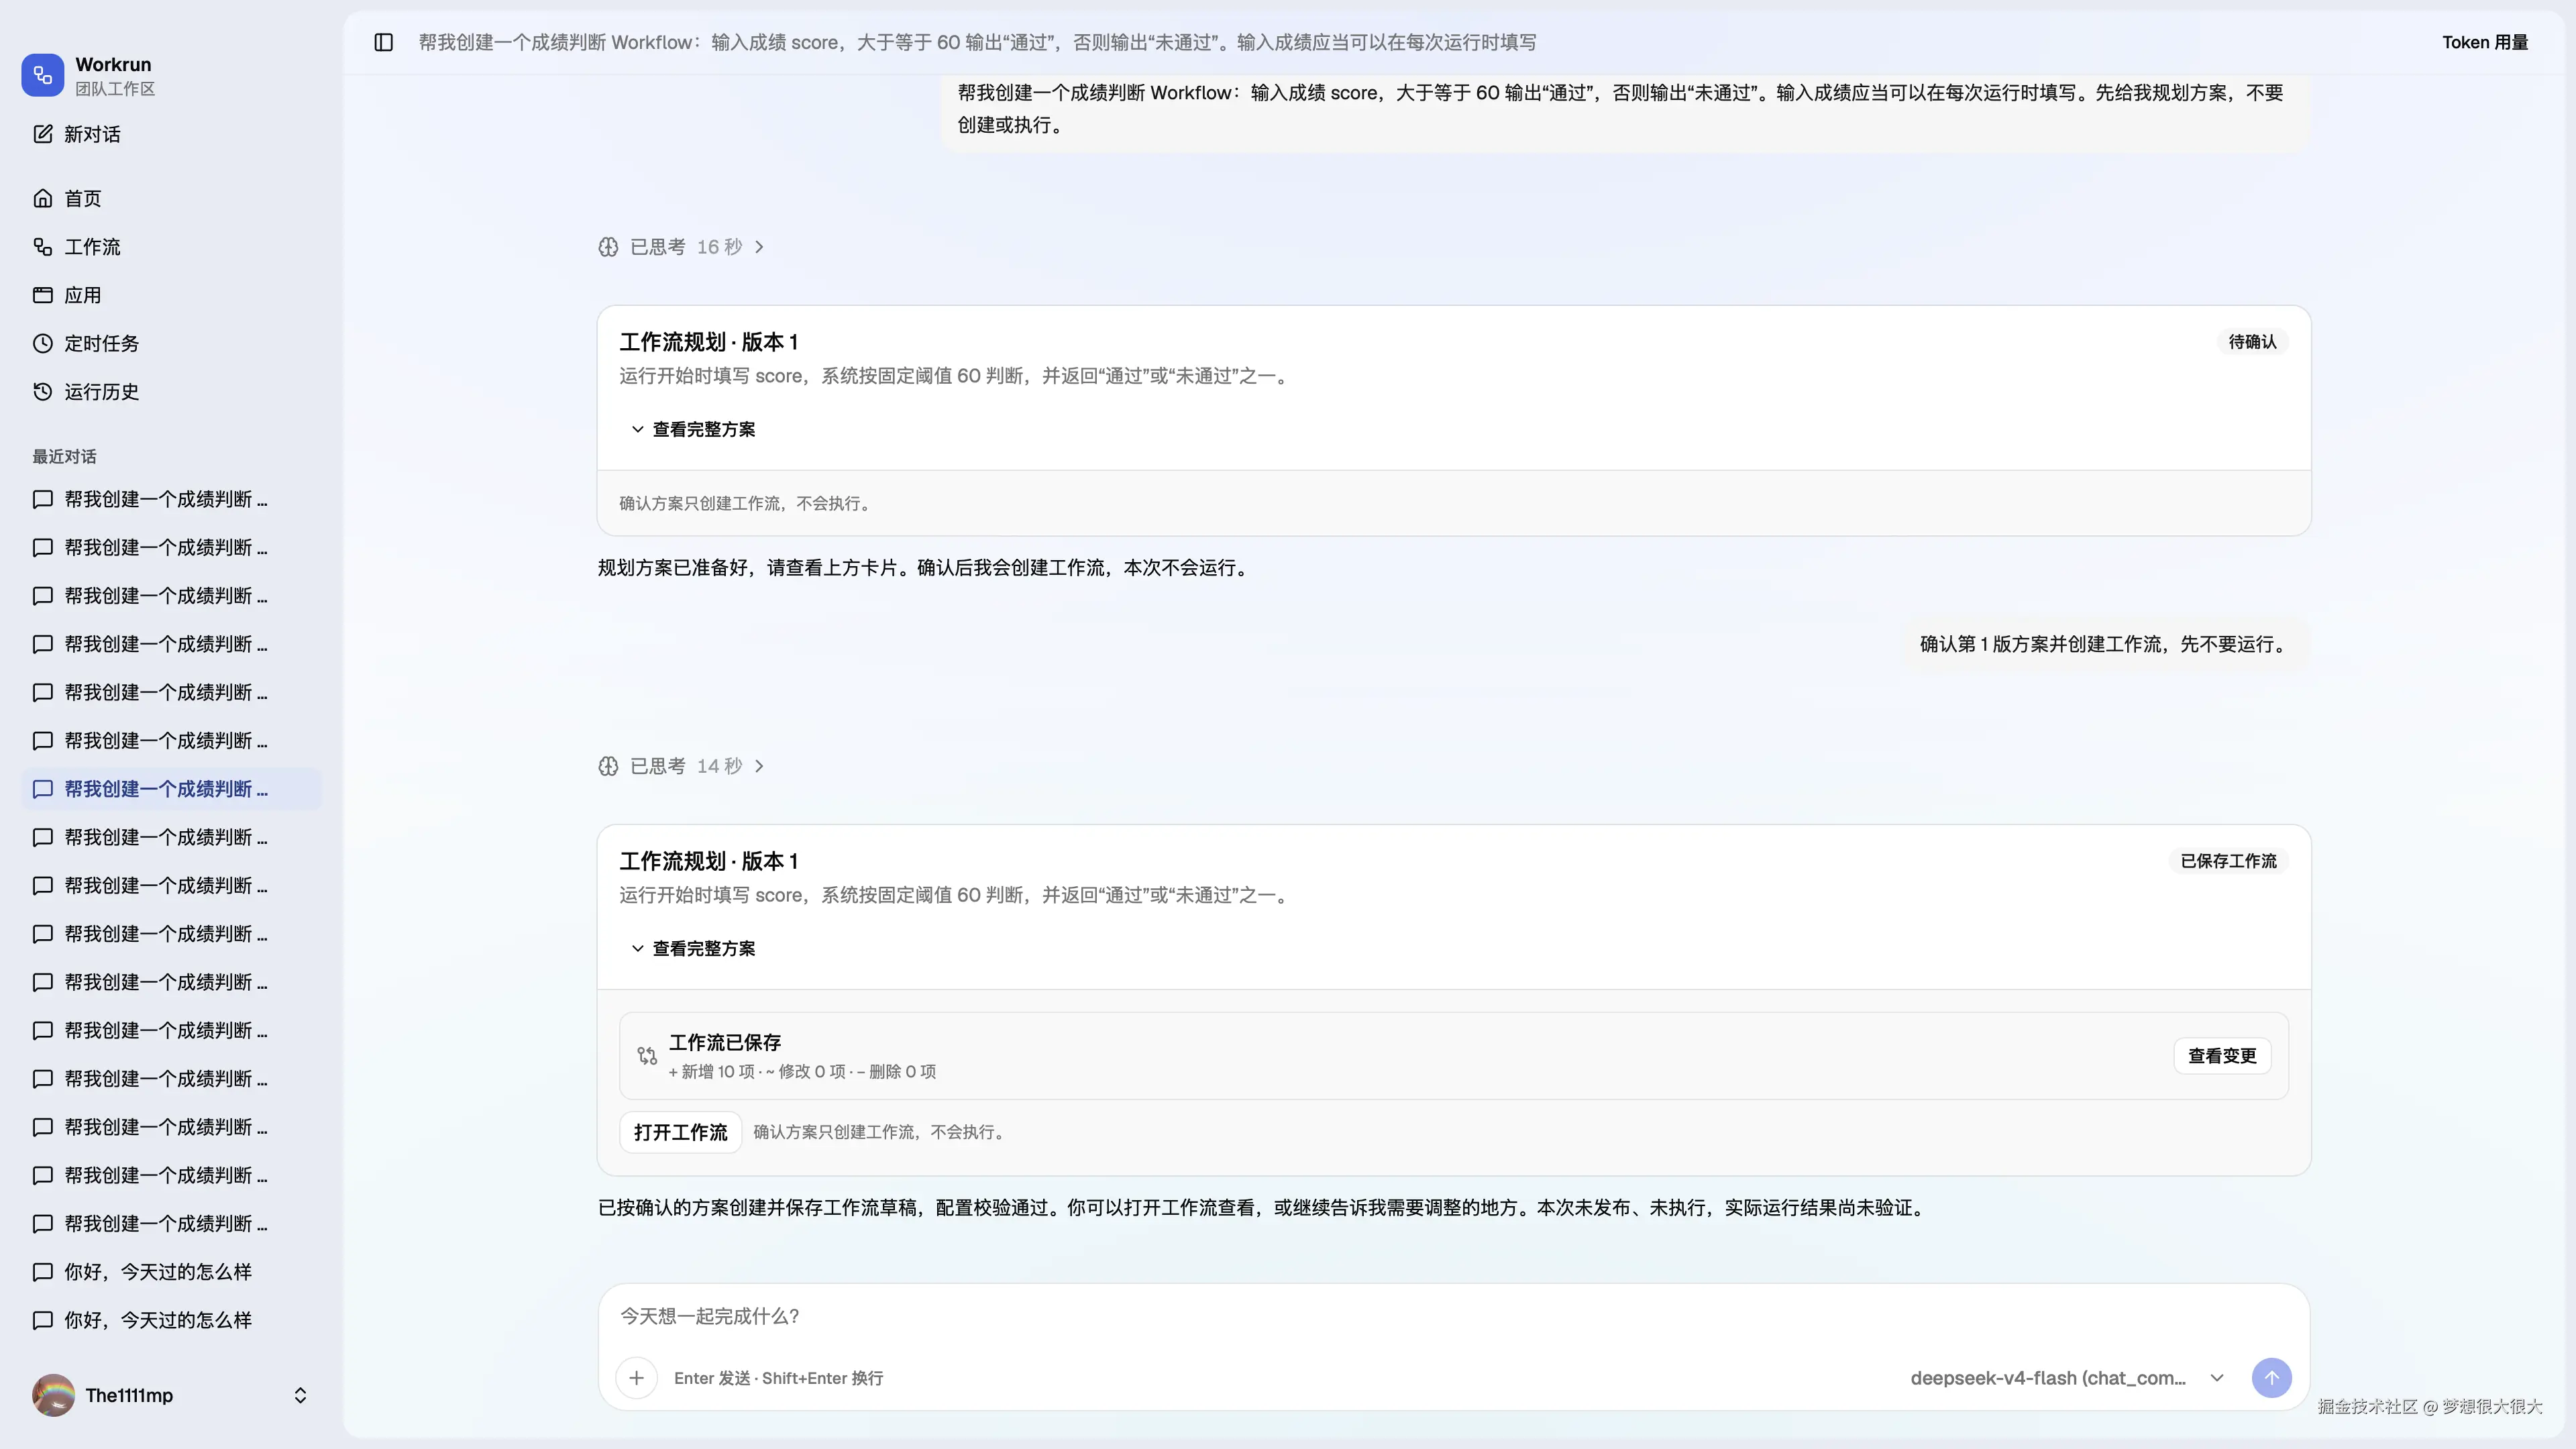
另一个更尴尬的问题是,某次回复和卡片都显示保存成功,打开却是 Not Found,列表也没有。
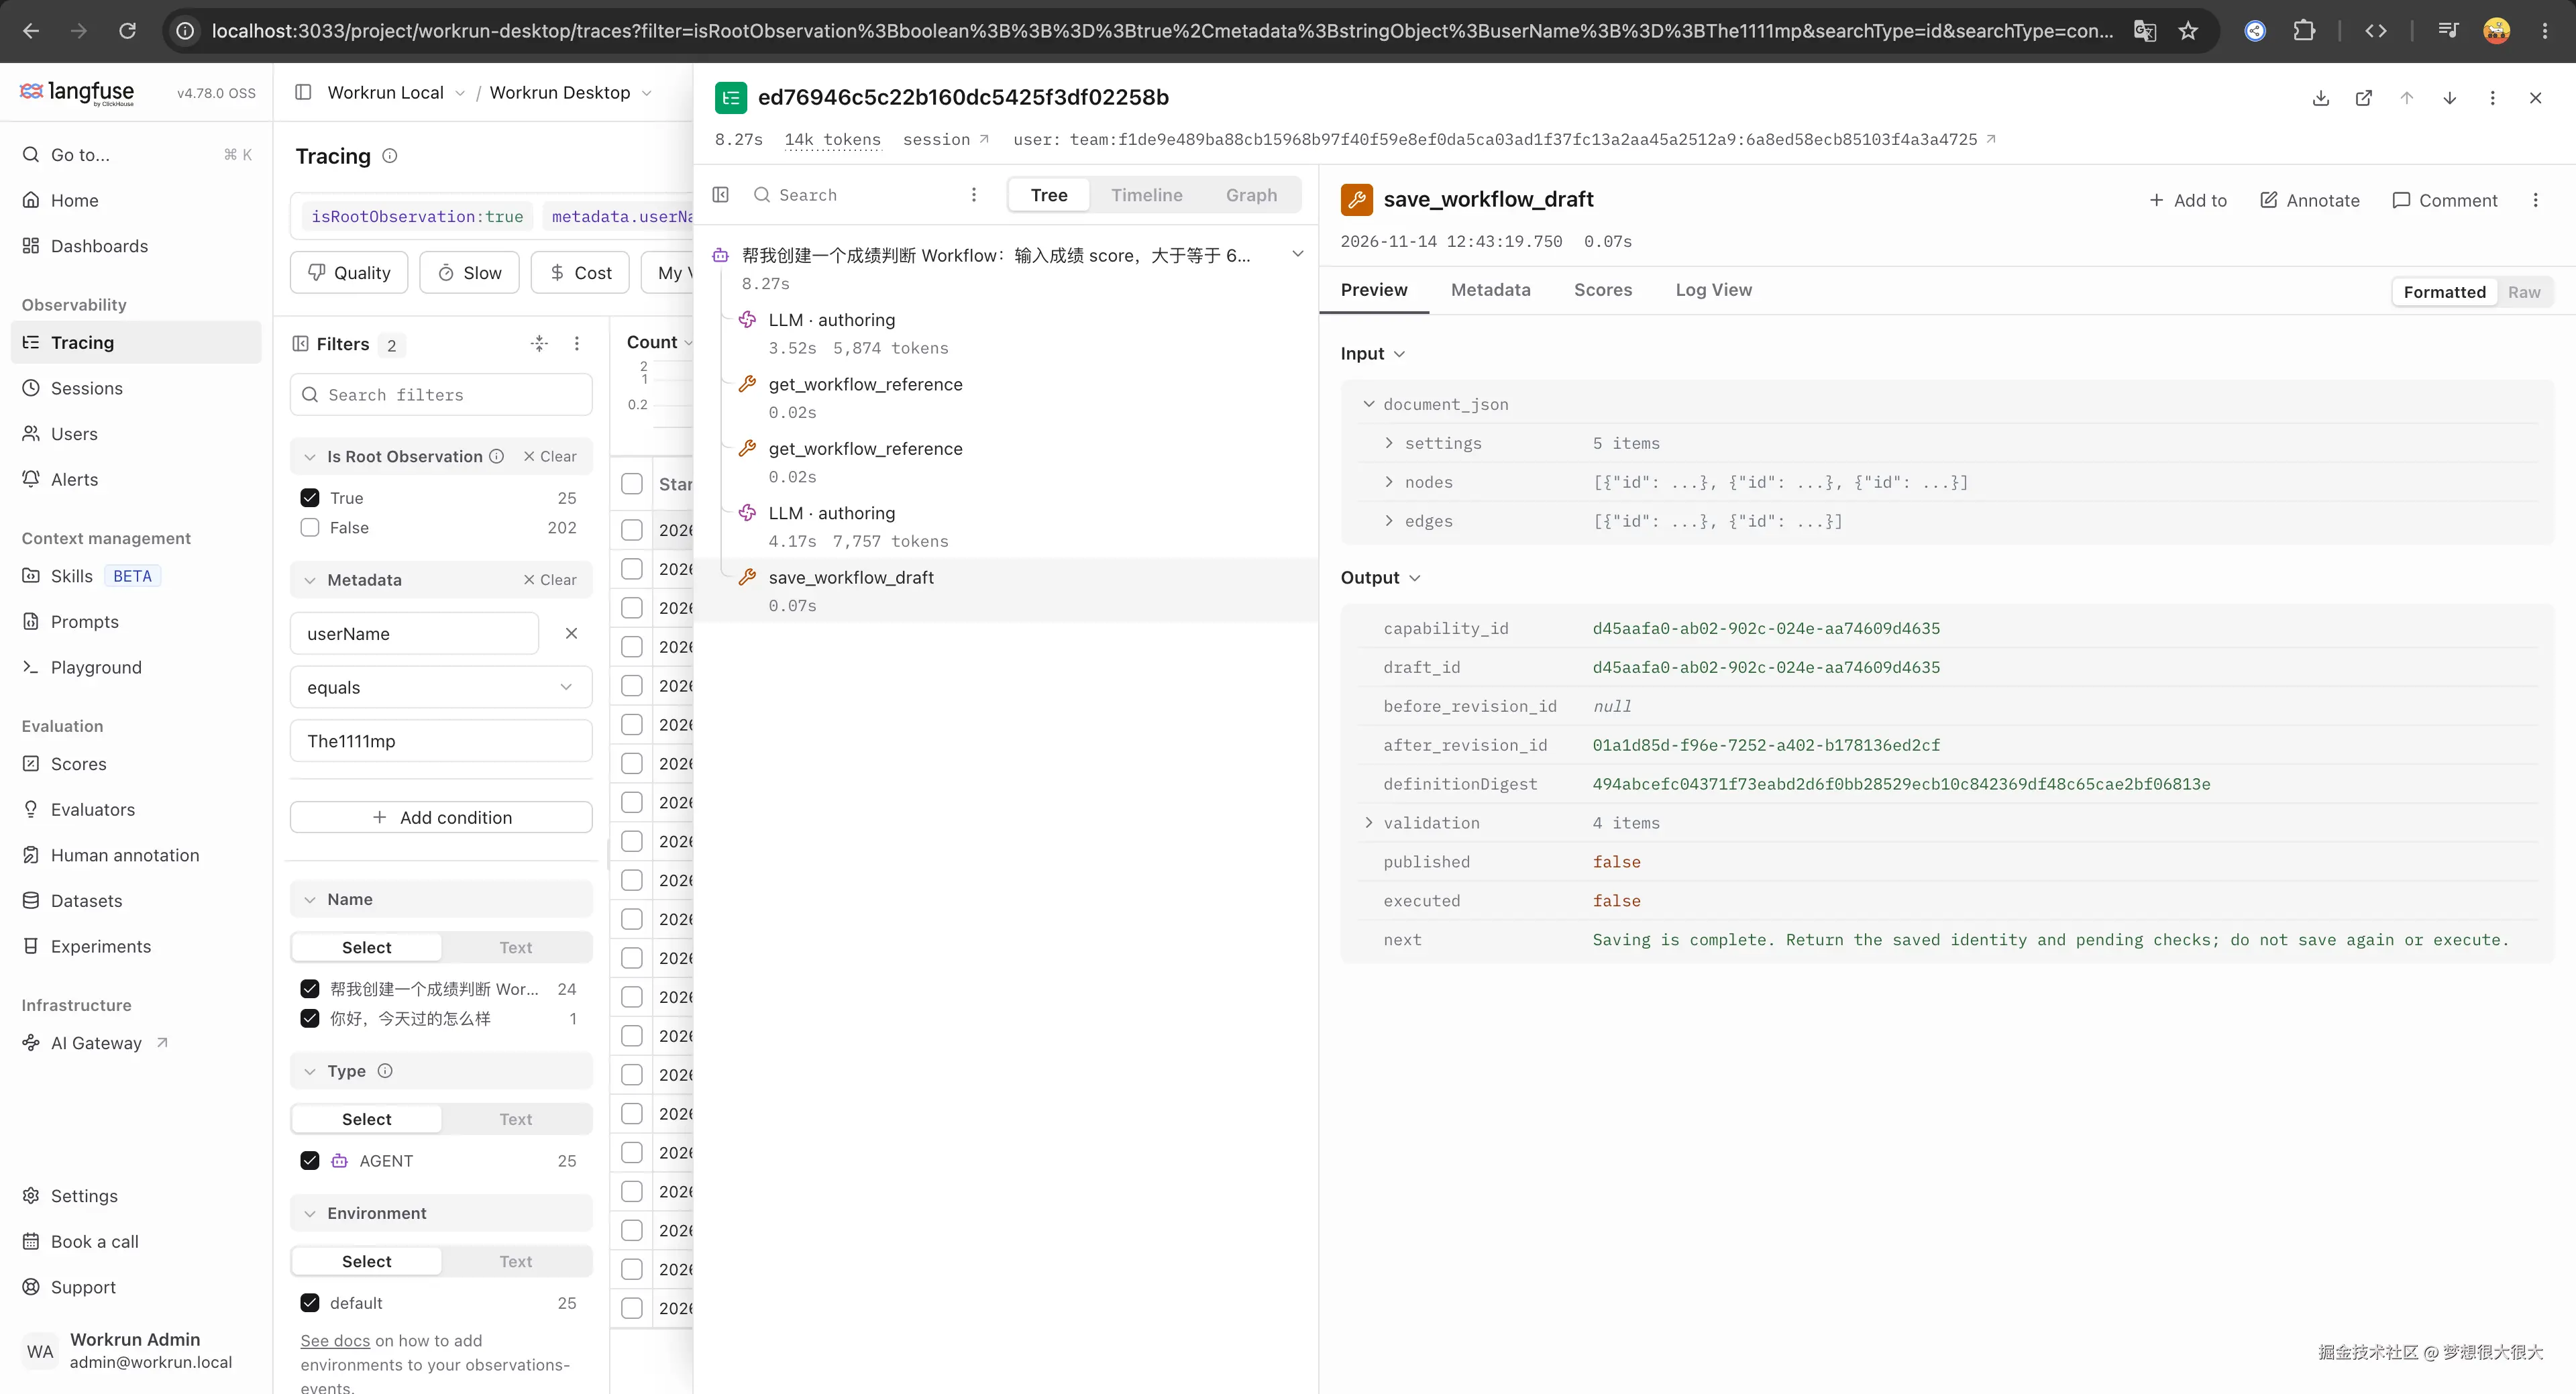
排查中一度想把团队草稿直接改为服务端存储,后来纠正了。Workrun 原来的约定是草稿在本地、发布后才上 Server,不能为了修一个读取问题改变产品语义。最终保留本地草稿,团队列表合并本地草稿与服务端已发布内容。
这让我更谨慎地使用"完成"这个词。模型生成了配置、工具保存成功、静态校验通过、用户能打开、实际运行正确,是不同的检查。我们这轮只创建不执行,就不能把静态校验写成运行验证成功。
先约定什么叫"编排成功",再讨论省了多少
前面还有一个问题没有说清楚:我们到底拿什么衡量一次编排对话?如果标准只是 Token 越少越好,让模型直接输出一份看起来像 Workflow 的 JSON,可能最便宜,但我不敢用。
Workrun 的节点是产品自己定义的。模型知道什么是条件分支,不代表它知道 Workrun 的分支句柄叫什么、字段怎样填写、上一个节点的结果怎样传给下一个节点。这些不能靠通用知识补出来。
所以,我现在会用下面这套标准检查一次编排。它未必是最终答案,但至少让优化有一个共同前提。
首先,模型得有依据地编排。 它需要先了解当前 Workrun 的文档结构、连线与状态规则,以及现有节点能做什么。选定某种节点后,必须先读取该节点的实际用法和配置契约,再生成配置。字段、输入输出和执行限制,都应该能在平台提供的说明里找到依据。
这里的"读取"不限定必须调用一次工具。如果完整契约已经由原生上下文提供,模型就可以直接使用;没提供的,必须查询。不能用一段节点简介替代配置文档,也不能因为模型见过其他 Workflow 产品,就默认它会配置 Workrun。
其次,产物要对应用户的需求。 用户要求每次运行填写的输入,就不能写死在定义里;要求确定性判断,就需要有明确的比较和输出逻辑。节点能够连起来,只是结构成立,还要检查输入从哪里来、结果由谁产生、最终如何返回。没有被要求的功能,也不应该为了显得完整而顺手加进去。
最后,完成到哪一步,就验证到哪一步。 只要求规划,就产出可审核的方案,不创建;确认创建后,检查配置校验、实际保存以及能否重新打开;授权运行后,再用输入和预期输出验证行为。静态校验通过不等于运行成功,没执行过就明确说尚未运行验证。用户也应该能从对话里知道当前状态,而不是猜一张卡片代表什么。
放到一次完整交互里,我期望看到的依据大致是:
text
理解需求与操作范围
    ↓
读取 Workrun 编排规则和节点能力
    ↓
形成方案,等待用户确认
    ↓
读取所选节点的用法与完整配置契约
    ↓
生成配置,校验并保存
    ↓
确认产物可访问,说明保存与执行状态
    ↓
如获授权运行,再检查实际结果
这是一条检查思路,不要求每个框都对应一次模型或工具调用。相关说明可以提前提供,同一份有效契约也可以复用,但不能把这些依据省掉。
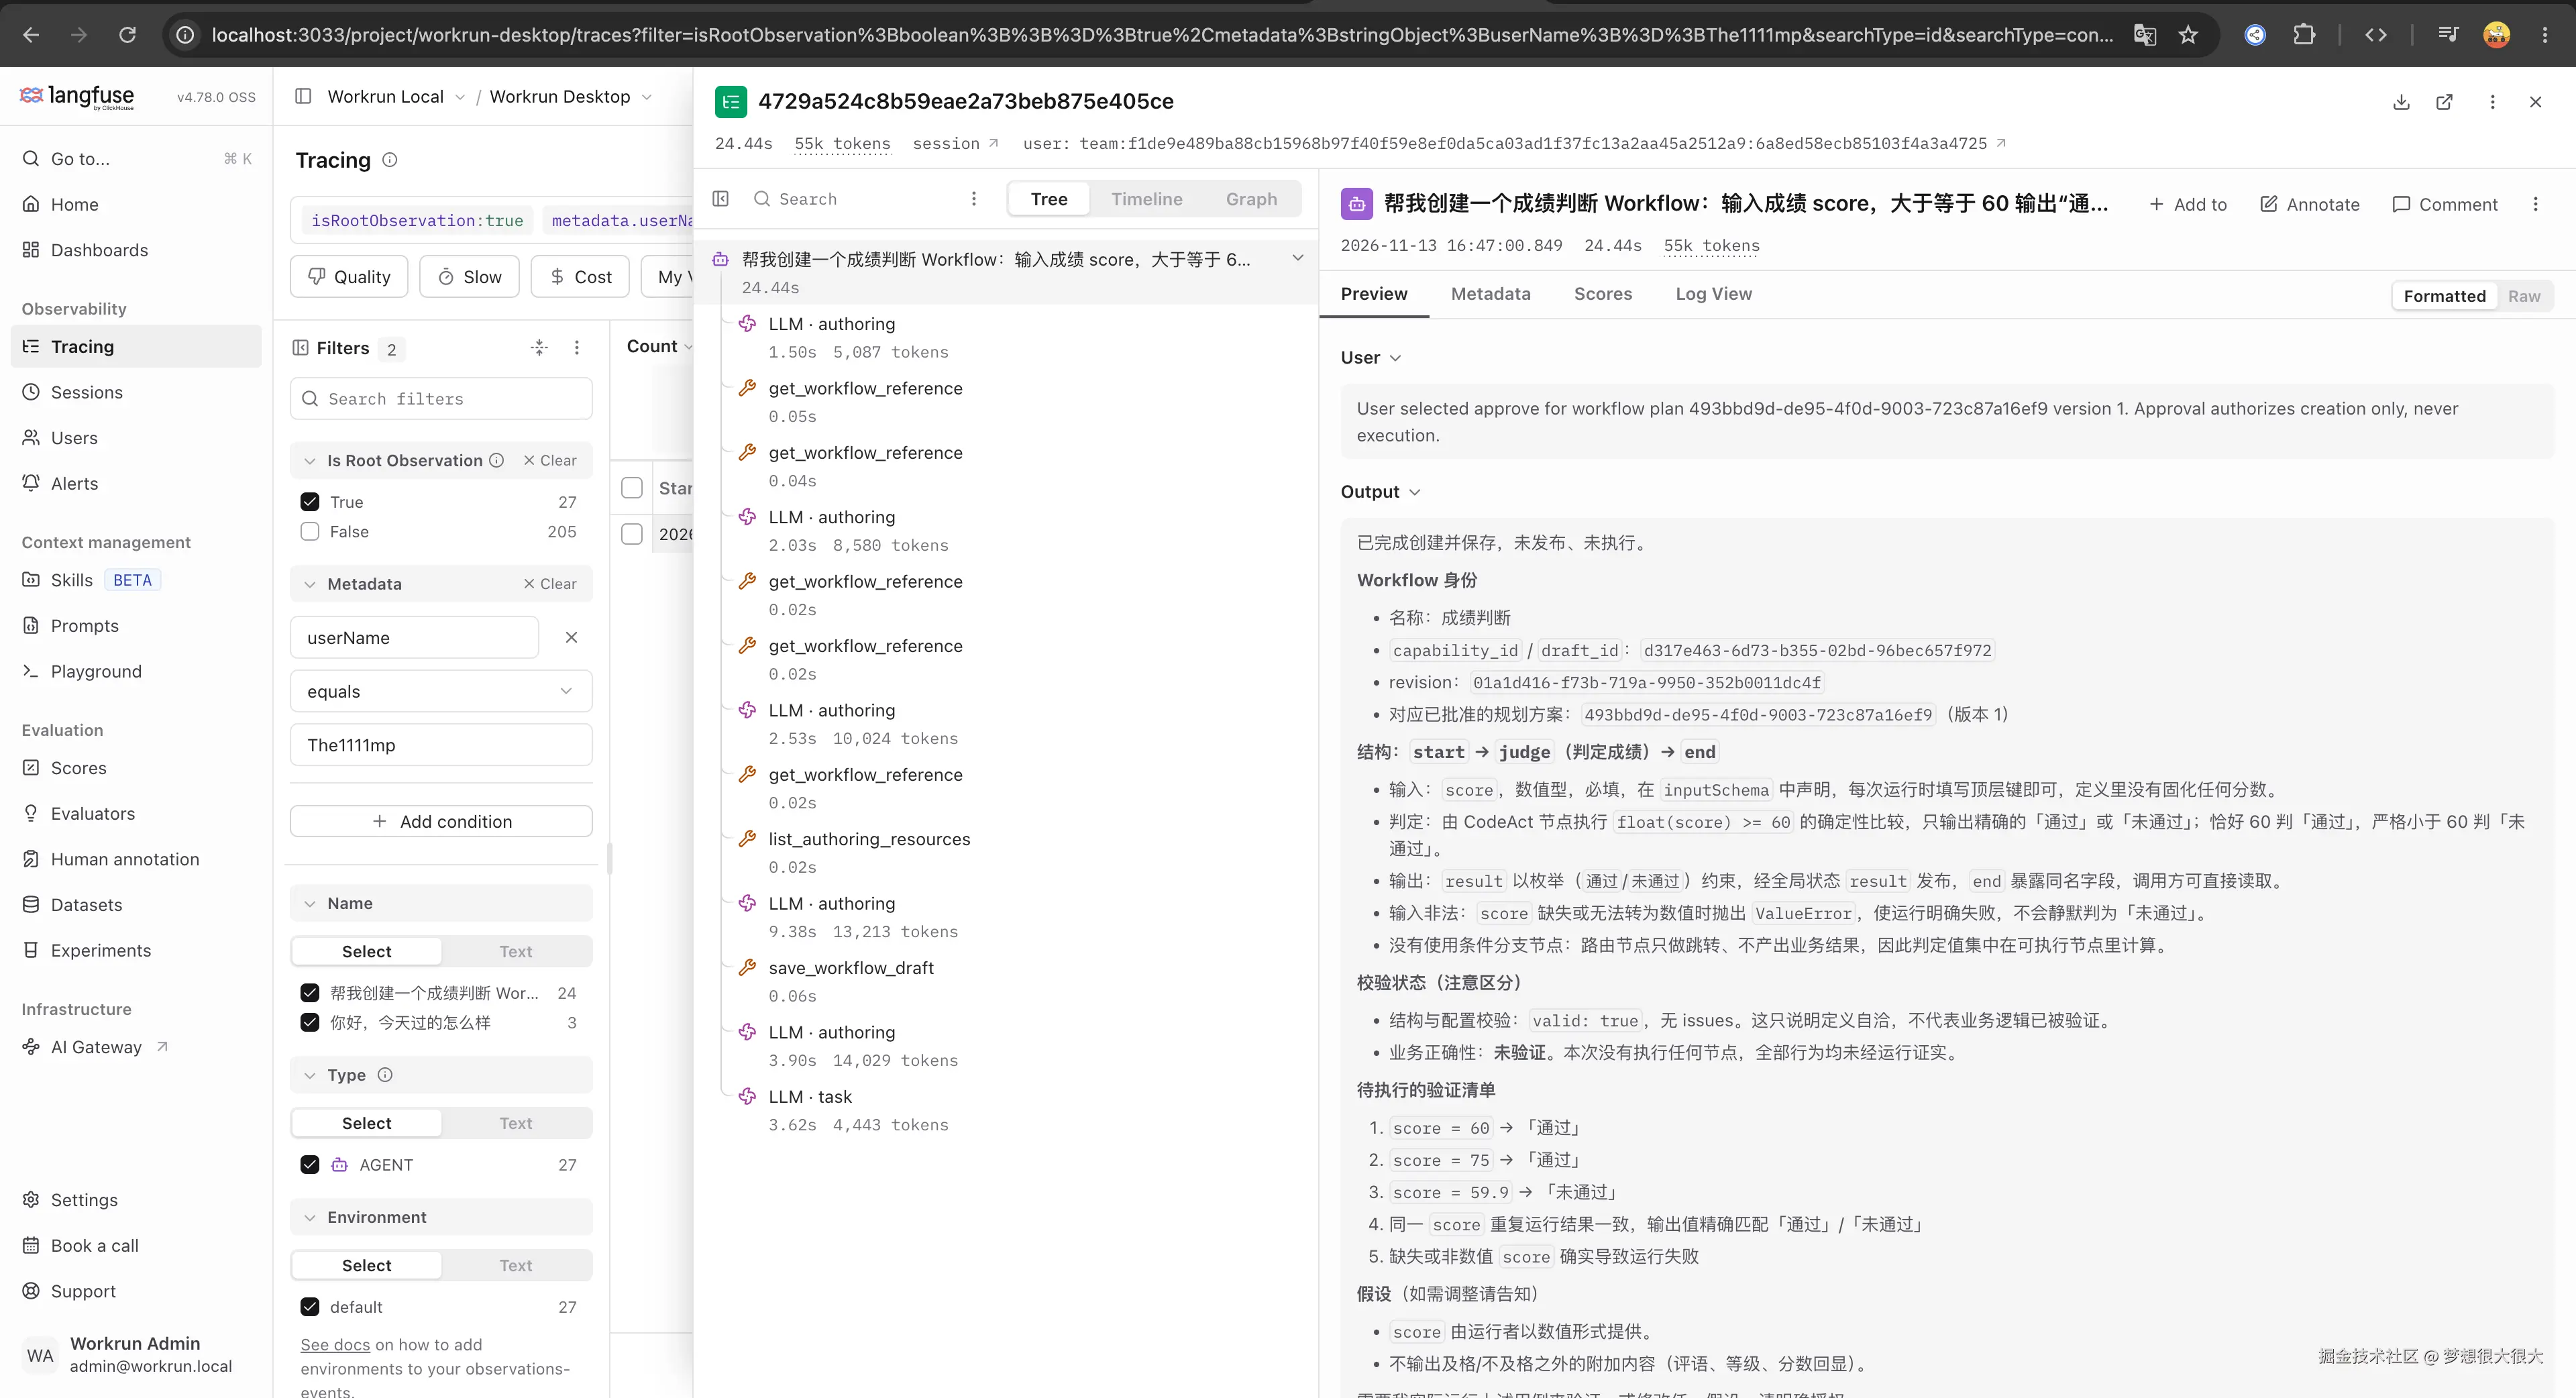
有了这个标准,再打开 Langfuse,我就不会把所有参考查询都当成浪费。第一次读取所选节点的配置说明,是必要成本;完整契约已经在上下文里,又反复读取相同手册,才值得排查。为了压缩输入删掉关键语义,导致后面猜字段、校验失败、再修复,也不能算优化成功。
后续比较就有了顺序:先看这套标准有没有满足,再在同模型、同任务和同阶段下比较用量、耗时与修复次数。一次请求便宜了一点,但更容易配错、需要用户反复纠正,我不会把它当成有效改进。
最后停下来的原因
我后来没有继续追着每一条更高的 Trace 修改。
前面一段时间已经接近循环:新数据高了就改,下一条低了就觉得有效,再高了又推翻。中间还换过模型,不固定条件,很多判断经不起比较。
后来固定输入和条件,把规划与创建分开评估。没测出改善的调整,就保留基线。也不拿最初问候的 5671 和某次完整创建的用量计算"节省比例"------它们根本不是同一件事。
如果要总结这次对我影响最大的变化,是我开始把 Token 当成系统行为的线索。高消耗可能来自必要工作,也可能说明职责放错了位置,或者一件事被反复确认、反复解释。
Langfuse 让我能检查这些判断,LiteLLM 给团队调用提供了统一的管理入口。它们都没有替我决定 Agent 应该怎样工作。
有了前面这套标准,再问"这一步为什么存在"才有意义。模型第一次读取节点用法,是在补齐编排依据;反复读取已有契约、重新解释已确认的状态,则可能是在重复工作。我想减少的是后面这些消耗,同时保住前面那些让结果可信的步骤。
以后给 Workrun 增加能力时,我会先问这些问题。总比功能加完以后,再从一句"你好"开始查账要好。