已提交的事务,未释放的锁:一次 Seata 上游修复 Backport 到生产发布的全流程实战
我们的 Seata TC(2.4.0 内部 fork)以单副本 file 存储模式跑在 K8s 上,长期偶发一类诡异现象:AT 模式全局事务明明已提交,全局锁却不释放,其他事务触碰同一批数据时锁超时。我把问题提给了 Seata 官方(issue #8197),官方在 PR #8201 修复并排入 2.8.0------但 2.8.0 遥遥无期,线上等不起。本文记录从读懂上游修复、语义级 backport、无 Docker 环境用 jib 构建镜像、test 十天验证,到最终零事故发布生产的完整过程------以及途中三次真踩坑(jib 三连坑、console 账号 401、两次滚动)和一次意外的收获:发布顺带清掉了 3595 把陈年锁残留,连另一个"锁不释放"的病也跟着好了。
S --- Situation:一个存在了很久的隐患
先讲清楚 Seata TC 在 AT 模式下怎么管理全局锁。业务应用(TM/RM)发起全局事务后,TC 为每个分支事务登记行级全局锁;全局提交走二阶段时,锁的释放挂在会话的移除上 ------GlobalSession 从内存移除时,其名下所有全局锁一并释放。file 存储模式下这一切都在单个 JVM 内存里完成,链路很短,短到容易让人忽略其中的一处并发缝隙。
我们的故障正发生在这条链路上:Seata 2.4、AT 模式、lock/session/store 全 file,生产持续提示获取锁超时 ;顺着 console 和 server 日志查下去,得到一个矛盾事实------锁被一个全局事务持有,而该事务早就提交了 。会话已消失、锁还在,console 甚至查不到持锁者,只剩其他事务的锁冲突日志在刷。我把现象、环境信息连同日志佐证一起提给了 Seata 官方(issue #8197)------官方确认并在 PR #8201 中修复的,正是这个问题。本文的主线,就是把这个修复从上游带回到我们的 2.4.0 fork 并发布生产。
根因定位:把全量日志喂给 ChatGPT
官方修复的前提是把根因说清楚,而这步定位值得单独一提。file 模式全部状态都在单个 JVM 内存里,没有"存储不一致"可甩锅;手翻日志如大海捞针,于是换了个思路:把现象、环境(Seata 2.4,AT 模式,lock/store/session 全 file)连同生产全量日志一起交给 ChatGPT 分析。
AI 从日志里拎出的不是泛泛的"可能有并发问题",而是一条精确到异常和字段的 9 步失效链:
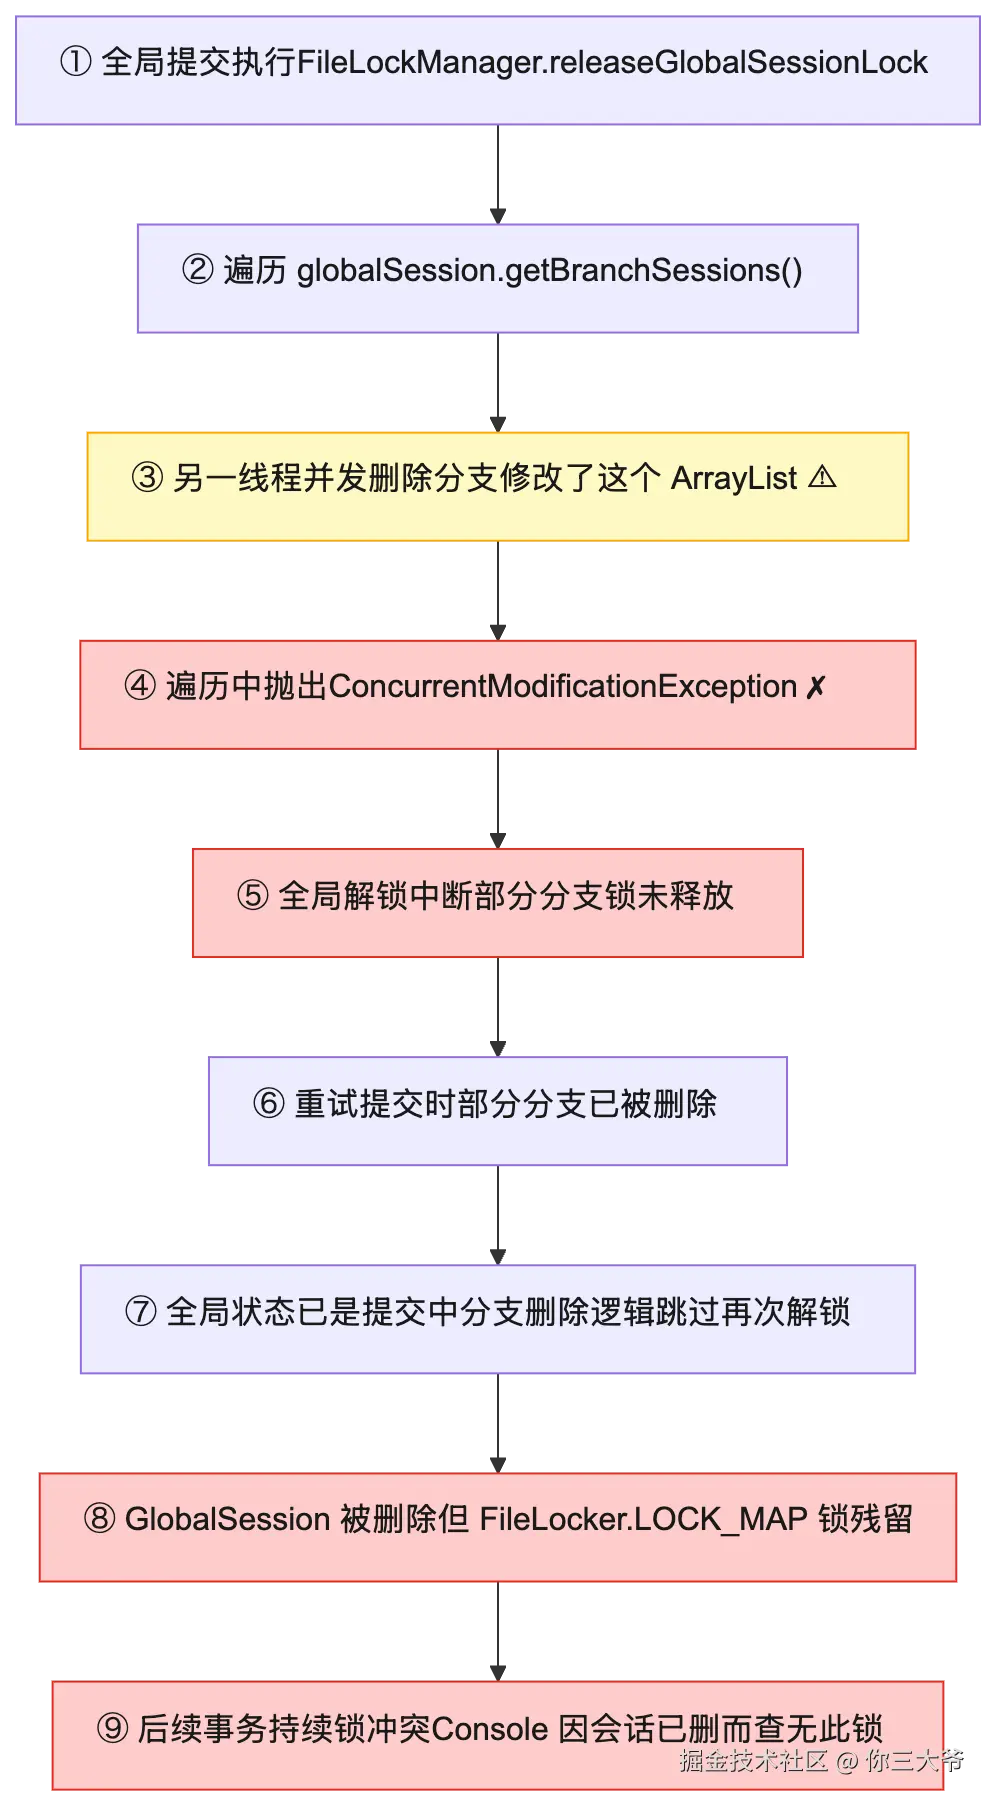
对照本地源码验证,这条链每一环都成立:releaseGlobalSessionLock 的 for-each 直接遍历 getBranchSessions() 返回的 ArrayList,与"另一线程删分支"之间没有任何同步;异常抛出后解锁半途而废,而会话生命周期走到了终态,FileLocker.LOCK_MAP 里的残留锁从此无人认领------连 console 都查不到它们(会话已删),只剩锁冲突日志在报。
这段分析被原样附进了提交给 Seata 官方的 issue------也就是说,官方维护者拿到的根因分析,最初来自我们自己用 ChatGPT 从日志里挖出的结论 ,他们据此定位并合入修复(PR #8201)。人负责提出正确的问题("为什么已提交的事务还持着锁"),AI 负责在几万行日志里还原出人眼难以捕捉的线程交错时序------对这类偶发并发问题,这是一条被验证有效的排查路径。
竞态的机理用一张时序图说清楚:
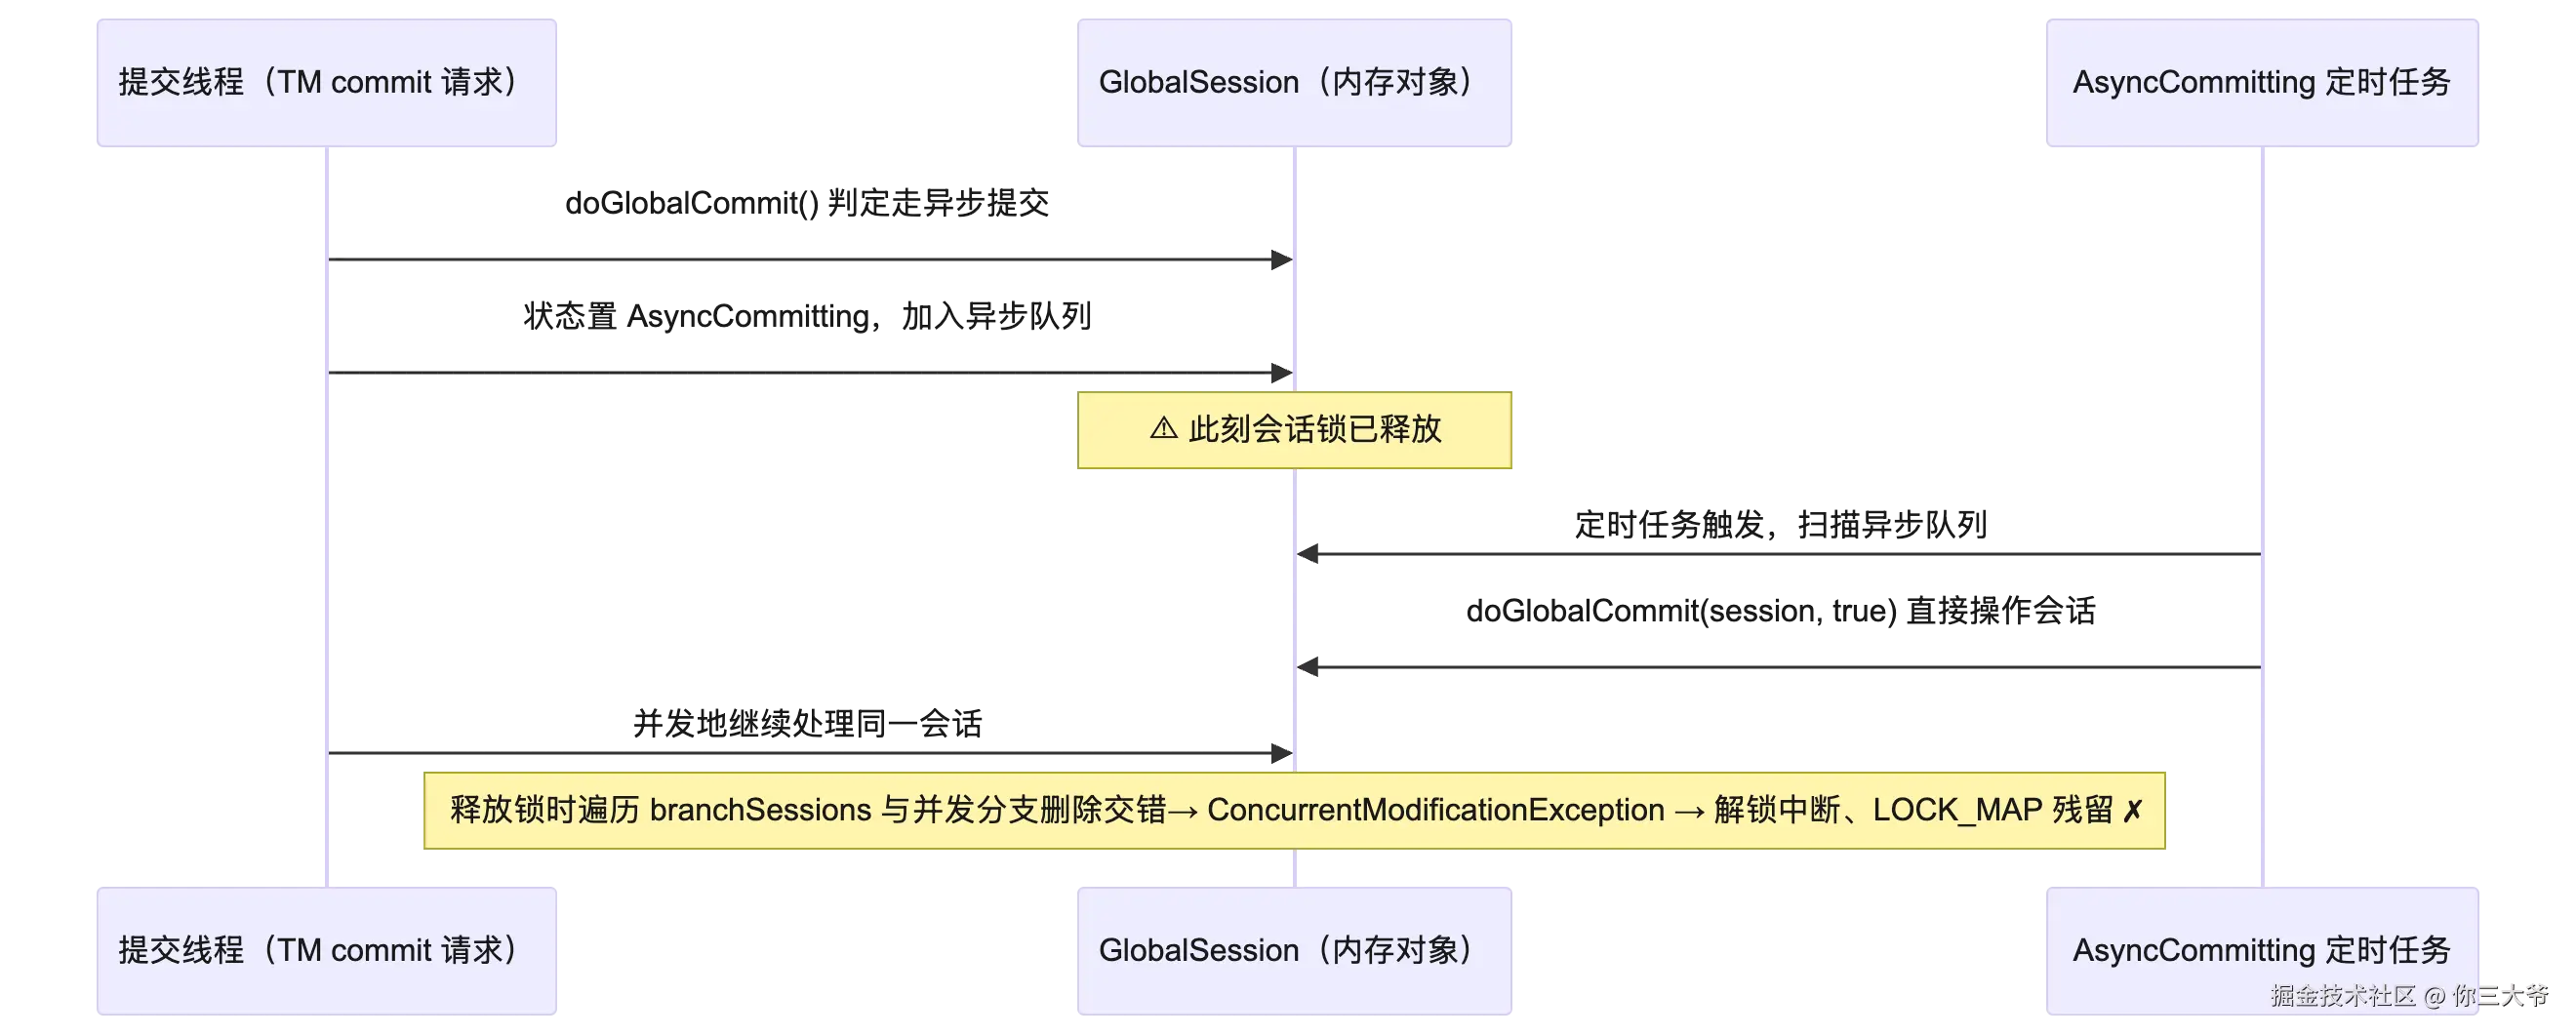
修复方式一句话:把定时任务对会话的操作包进 SessionHolder.lockAndExecute(session, ...)------持会话锁执行,串行化两条路径,掐断 9 步链的第 ③ 步:遍历与删除不再交错。就这几行。
支线:同一症状,后来才发现的另一个病因
主线到此已经清楚,但有个后文要用到的事实需要提前交代:"锁不释放"其实不止一个病因。在发布前的例行检查中,我们在生产上发现了另一批症状相同、机理完全不同的锁残留------发布决策时,区分这两个病因起了关键作用:
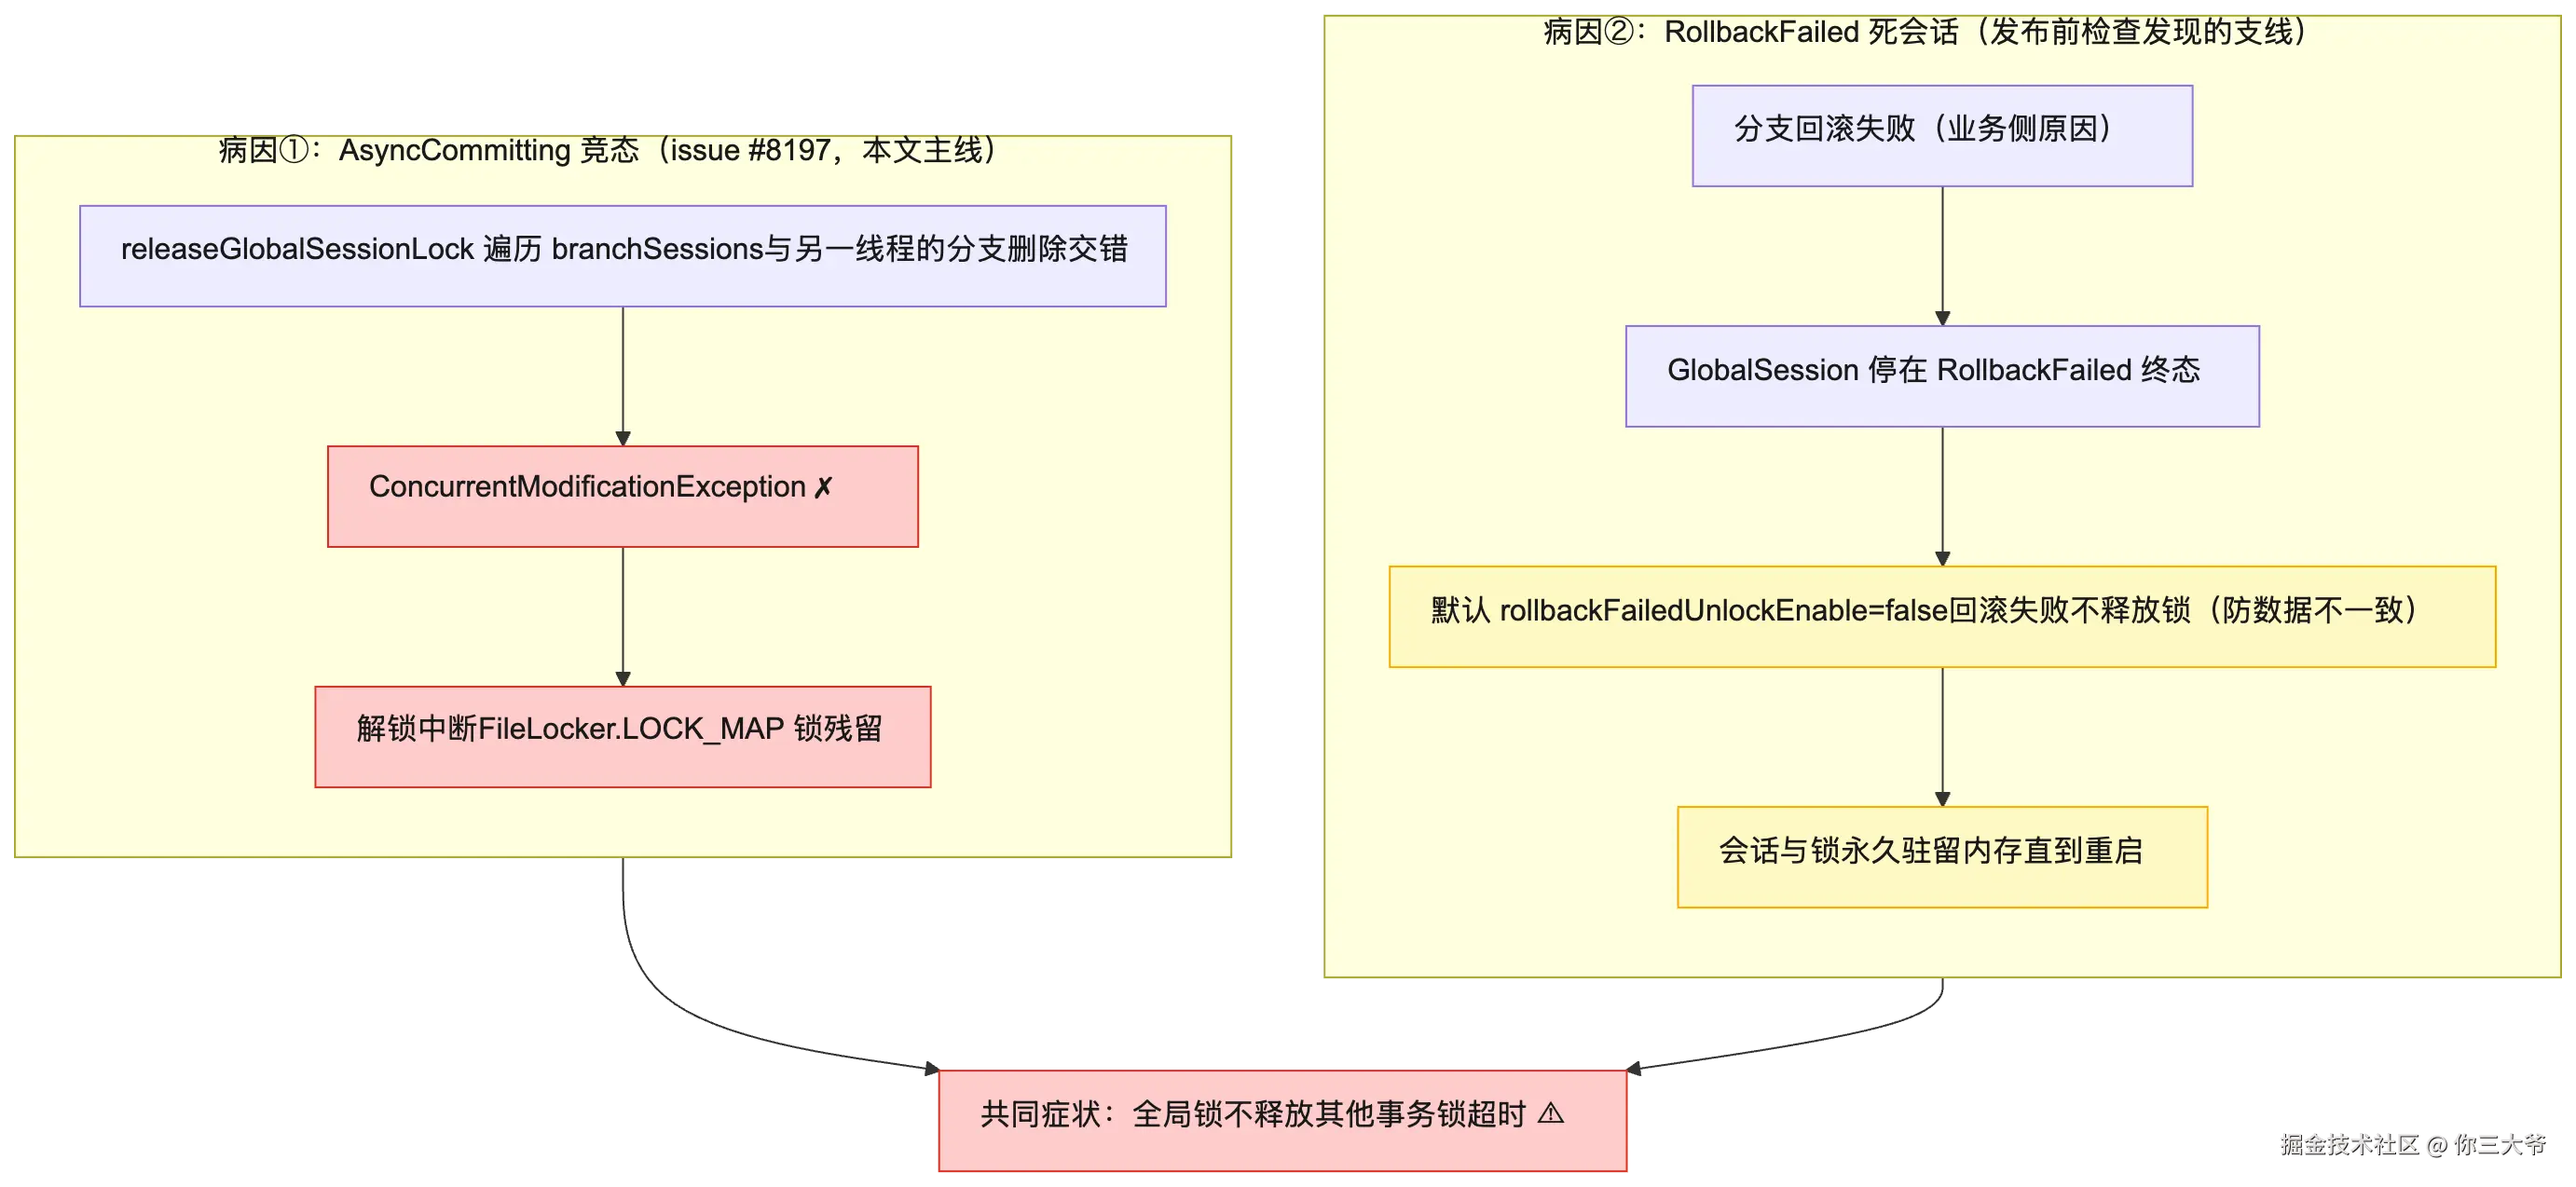
病因①是 bug,就是上面 ChatGPT 分析、随 issue 附给官方、由 PR #8201 修复的那个;病因②则是设计内的保守行为(宁持锁不留数据不一致)------我们发布前在生产上看到的 14 个死会话、3595 把锁残留,属于后者,重启即清。排查和处置时如果只看"锁不释放"这个症状就下结论,很容易误诊。
T --- Task:三个目标,三个约束
- 最小化 backport :把 PR #8201 的修复语义移植到内部 2.4.0 fork,并跑通其回归测试;
- 无 Docker 构建链路:本机没有 Docker 环境,要打通"源码 → 私有 Registry 镜像"的构建推送链路,且 base 镜像与线上完全一致;
- 零事故发布:test 环境验证后发布生产,单副本 file 存储无持久卷,发布不能引入新问题。
约束:① 这是上游 fork,改动必须与上游 diff 最小化,为将来整体升级降低成本;② 生产 imagePullPolicy: IfNotPresent,镜像 tag 复用等于没发版(节点不会重新拉取);③ 生产重启会丢失在途事务会话,发布必须选低峰窗口。
A --- Action:一次语义 Backport、三连坑、一次发布方式的修正
第一步:读 diff 要读"语义",不是读"行数"
拉取 PR #8201 的 diff 后第一个发现:700+ 行的改动里,真正的修复只有几行 。其余全是 checkstyle 引发的常量重命名(PER_FILE_BLOCK_SIZE 之类的风格化重排)。如果无脑 git apply,这些噪音会永久污染 fork 与上游的可比性。
| diff 构成 | 行数占比 | backport 决策 |
|---|---|---|
修复本体:lockAndExecute 包裹异步提交 |
~1% | ✅ 语义移植 |
回归测试 handleAsyncCommittingWaitsForGlobalSessionLockTest |
~5% | ✅ 一并移植 |
| checkstyle 常量重命名 | ~90%+ | ❌ 不跟随,保留本地命名 |
java
// backport 的全部本体(脱敏示意):
SessionHelper.forEach(asyncCommittingSessions, asyncCommittingSession -> {
    try {
        SessionHolder.lockAndExecute(
                asyncCommittingSession, () -> core.doGlobalCommit(asyncCommittingSession, true));
    } catch (TransactionException ex) {
        // ...
改动小到可以背下来,但它的回归测试必须原样移植------并发竞态类 bug 没有"看起来对了"这回事。
本地跑通移植来的测试(6 个用例全绿,3 个 skip 是 JDK 版本限定)后,才允许进入构建环节。
⚠️ 踩坑一:jib 构建三连坑,坑坑不一样
本机无 Docker,但 server 模块的 pom 里藏着 jib-maven-plugin------不需要 Docker daemon,Maven 直接构建并推送镜像到 Registry。这条路通了,但连踩三坑:
- git labels 空值 :jib 把 git 属性写成镜像 label,而工程没启用 git-commit-id 插件,所有
${git.commit.id}都是 null,构建直接报 "labels map contains null values"。解法:命令行逐个补-Dgit.commit.id=...等全部属性; - base 镜像拉取超时:jib 默认 base 镜像在 Docker Hub,本机连不上。必须显式指定私有 Registry 里与线上镜像逐层一致的 JDK17 base 镜像------逐层比对过 digest,前 6 层完全相同,保证运行环境零漂移;
- 多平台 vs 单架构 :pom 默认构建 amd64+arm64 双平台 manifest,而私有 base 镜像是单架构的,报 "cannot build for multiple platforms since the base image is not a manifest list"。解法:
-Djib.from.platforms=linux/amd64收敛为单平台。
三个坑的共同教训:换一条构建链路,等于换掉一整套隐式约定------原来 Dockerfile 构建流程里"理所当然"的 git 信息注入、base 来源、平台目标,在 jib 链路里全部要显式重述一遍。
⚠️ 踩坑二:镜像构建成功 ≠ 镜像可用------藏在 application.yml 里的账号
镜像推上去了,test 发布后发现 console 登录 401。排查到根因花了些功夫:
- jib 直接把
src/main/resources/application.yml打进镜像,不走 distribution 分发包的配置替换流程; - 镜像里内置的是上游默认 console 账号
nbl/nbl,而线上一直用的是自己的账号; - 解法:deployment 上加环境变量,借 Spring Boot 的 relaxed binding 覆盖
console.user.username/password。
这个坑的隐蔽性在于:镜像能启动、RPC 端口正常、业务应用全部接入成功------只有 console 登录这一个入口是坏的,而它恰恰是发布后人工验证的第一站。
⚠️ 踩坑三:set image 两次滚动 vs apply -f 一次到位
修 401 时我用 kubectl set env 单独补环境变量,导致 test 环境滚动了两次(一次镜像、一次 env)。复盘时意识到:历史上所有发布 SOP 都是 kubectl apply -f,我却选了 set image------当时图"最小变更",但发布实际涉及镜像+env 两个字段,最小变更的优势在多字段场景下不成立,反而多付了一次滚动重启的代价。
prod 发布前先做了 YAML 与线上 spec 的语义 diff(逐字段核对,确认实质差异只有镜像 tag 和新增 env 两处),然后 apply -f 一次滚动到位。发布方式要跟着"变更字段数"选:单字段 set,多字段 apply。
插曲:test 上的两个"假警报",以及一次意外的发布收益
test 观察期遇到两个看起来吓人的现象,都靠读源码定性、没有恐慌:
- root.data 从 420B 涨到 52MB(4.7 天) :读
FileTransactionStoreManager源码确认 file 模式是只追加的 WAL------每次会话状态变更追加一条记录,已结束的会话记录不删除。~11MB/天属正常水位,唯一要纳入巡检的是节点磁盘; - 每分钟 96 次 Connection reset:来源 IP 全是 Pod 所在节点------kubelet 的 tcpSocket 探测(readiness 12 次/分 + liveness 6 次/分)加 ELB 健康检查,连接即建即断。两环境固有噪音,与镜像版本无关。
真正的惊喜来自 prod 发布前的例行检查。当时发现生产上有 14 个死会话持有 3595 把全局锁:一个财务系统的巨型会话(3216 个分支,超时回滚失败后已挂 5.5 天)+ 13 个订单系统的 RollbackFailed 会话。这正是前面 S 节说的病因②。发布决策因此从"找个低峰"升级为"等一个零在途事务的窗口"------清晨确认仅剩 2 个秒级在途事务后执行发布:
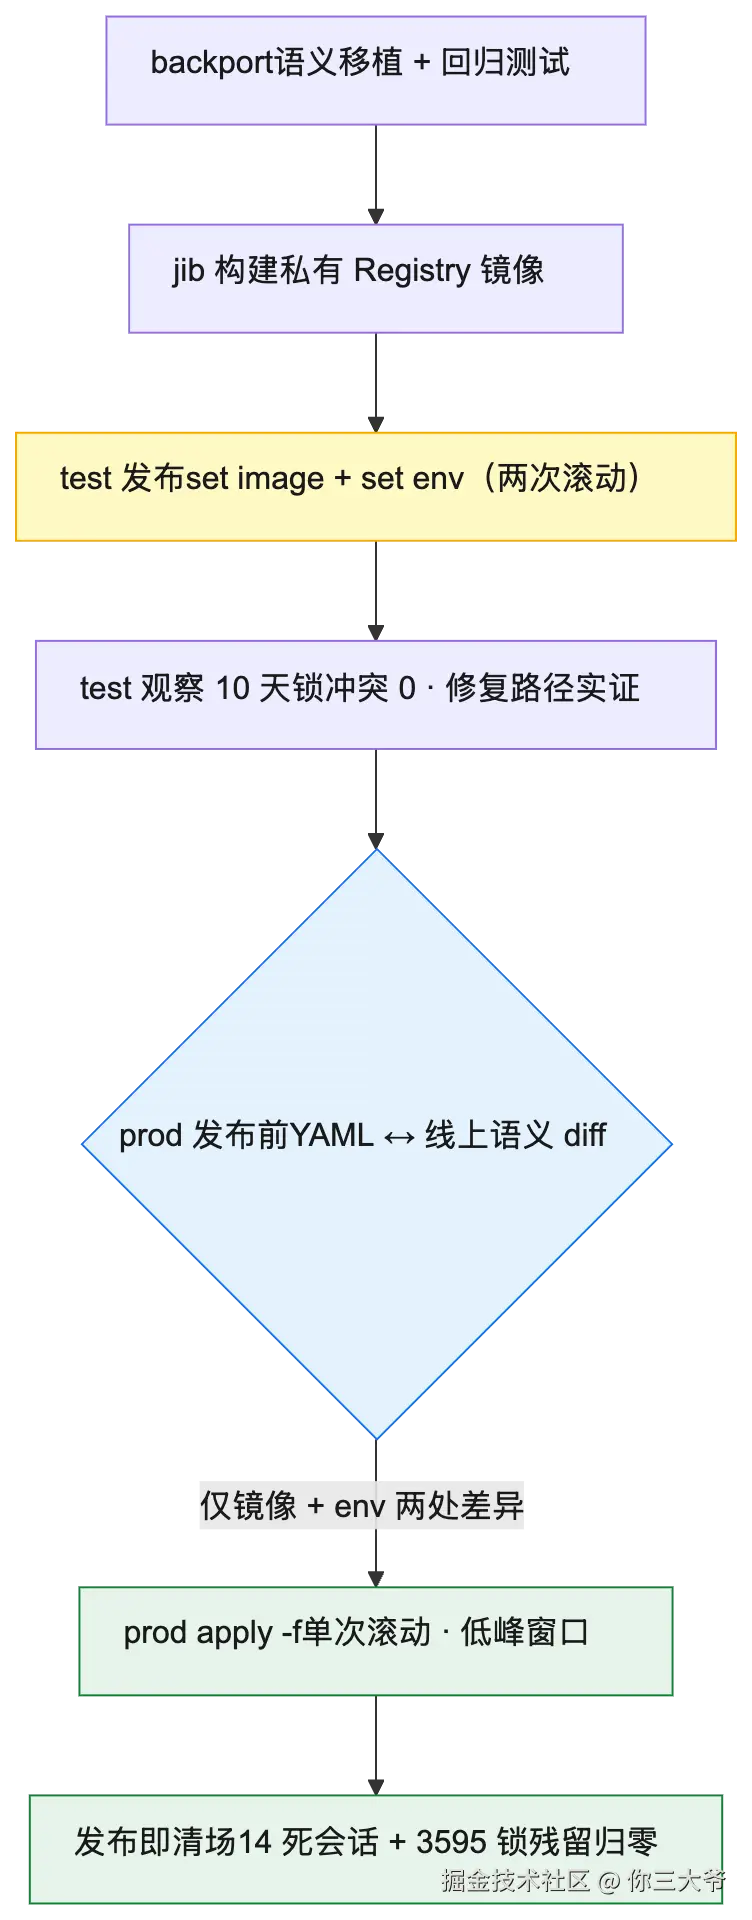
发布窗口内全局锁残留随旧 Pod 一起消失------对单副本 file 存储的 TC 来说,一次计划内重启就是一次免费的垃圾回收,前提是窗口内零在途事务。
R --- Result:两段验证,全绿收官
test 与 prod 两段验证的关键指标:
| 验证项 | test(10 天) | prod(发布后持续观察) |
|---|---|---|
| Pod 稳定性 | 10 天 0 重启 ✅ | 10 天 0 重启,内存平稳 ✅ |
| 锁冲突(#8197 核心症状) | 0 ✅ | 0 ✅ |
| 异步提交流转 | 实证样本:AsyncCommitting→Committed 同毫秒完成 ✅ | 发布 3 分钟内 2465 个事务成功流转;高峰 130 并发事务 45 秒内全部消化 ✅ |
| 死会话/锁残留 | 0 ✅ | 发布清掉 14 个死会话 3595 把锁,此后零新增 ✅ |
| console / 业务接入 | 正常 ✅ | 全量应用 1 分钟内重新注册 ✅ |
特别值得记录的后续:发布后 RollbackFailed 零新增。发布前订单系统几乎每天都在产生 RollbackFailed 会话,发布后十天完全绝迹------初步印证那批回滚失败与旧 TC 的锁泄漏状态存在关联,研发侧排查优先级得以下调。
复盘沉淀的三条原则
- backport 读语义,不读行数:上游 PR 的 diff 里 90% 可能是风格噪音,真正要移植的是"竞态被会话锁串行化"这一个动作。fork 的生命线是与上游 diff 最小化,每一次无脑 apply 都是在给未来的整体升级埋雷;
- "锁不释放"是一类症状,不是一种病:本次至少存在三个病因(AsyncCommitting 竞态、RollbackFailed 设计内持锁、以及重启即清的残留累积),症状相同、处置完全不同。先分类,再动手;
- 换构建链路 = 换掉一整套隐式契约:从 Dockerfile 切到 jib,git 信息、base 镜像、平台目标、甚至配置文件里的默认账号,全部要重新显式约定。新链路打通后,把这些坑写进构建文档比记住它们更重要。
遗留事项
- 官方 2.8.0 发布该修复后,用官方版本替代自研 tag(tag 里带 PR 编号
fix-8201就是为这一刻准备的); - 业务数据库
undo_log表中旧死会话 XID 的残留记录需业务研发人工确认清理(TC 侧已清,DB 侧不会自动消失); - 长期项:为 TC deployment 补 resources 限制(曾因 request=0 被节点驱逐过)。
本文涉及的敏感信息(公司名、业务系统名、私有镜像仓库地址、集群信息)已脱敏,代码片段为脱敏后的示意实现;Seata 为 Apache 开源项目,issue #8197 与 PR #8201 为公开链接,予以保留。