19 位雪花 id 用数字形态过 JSON,在 JS 消费端 173 条真实 id 全部静默失真,无一幸免。本文用台账里的真实数据实测了失真边界、量化规律、reviver 为什么救不回来,以及两条可落地的修法。
问题从哪来
我们的发布台账里躺着两类长 id:掘金 pushData 的文章 id 是 16 位(如 1794708857909320),抖音回填的 aweme_id 是 19 位(如 7679375766852734223)。这些 id 在 Python 侧一直是字符串或任意精度整数处理,从未出过事------Python 的 int 没有位数上限。
风险在另一侧。这套流水线的消费端不止 Python:Electron 渲染进程要读 metrics.json,页内脚本要处理接口响应,排查问题时随手 node -e 里 JSON.parse 一把也是常态。JS 的 Number 是 IEEE 754 双精度浮点,整数只有 53 位尾数安全区,超过 2^53 - 1 = 9007199254740991 的整数会被静默量化------不报错、不警告,值悄悄变掉。
这条线到底在哪、我们的真实数据有多少已经越界、失真长什么样,光背结论不够,下面全部实测。
边界实测 2 的 53 次方那一格
直接在 node 里过 JSON.parse:
js
JSON.parse('9007199254740991')  // 9007199254740991  边界内,无损
JSON.parse('9007199254740992')  // 9007199254740992  恰好可表示,无损
JSON.parse('9007199254740993')  // 9007199254740992  奇数被吞,静默 -1
JSON.parse('9007199254740994') // 9007199254740994 偶数又无损了注意第三个:2^53 + 1 是第一个牺牲品,而它只差 1。紧接着的偶数却完好无损------量化不是「超过就崩」,而是把整数吸附到最近的浮点可表示格点上,格点间距从这一格开始变成 2,再往上翻倍。偶数 id 侥幸无损、奇数 id 被吞 1,这种「有的对有的错」比全错更危险,因为它能骗过抽测。
对照我们自己的数据:掘金 pushData 的 16 位 id 约 1.79e15,距 9.0e15 的安全边界还有 5 倍余量,实测三条近期真实 id 全部无损。而 19 位那一档(抖音 aweme_id、创作者中心里的掘金文章雪花 id)在 7.7e18 量级,早已越界约 850 倍。
台账普查 173 条无一幸免
把台账里回填的 173 条真实 19 位 aweme_id 全部倒出来,用 Python 写成数字形态的 JSON(不带引号,模拟接口返回),交给 node 的 JSON.parse,再逐条与真值比对:
python
# Python 侧:真实 id → 数字形态 JSON
import json
payload = {'ids': [7679375766852734223, ...]}
open('in.json', 'w').write(json.dumps(payload, separators=(',', ':')))
js
// node 侧:JSON.parse 后逐条比对
const truth = raw.match(/"ids":\[(.*?)\]/)[1].split(',').map(BigInt);
const parsed = JSON.parse(raw).ids;            // 这里已经失真
for (let i = 0; i < truth.length; i++) {
  const delta = BigInt(Math.trunc(parsed[i])) - truth[i];
  if (delta !== 0n) rows.push(delta.toString());
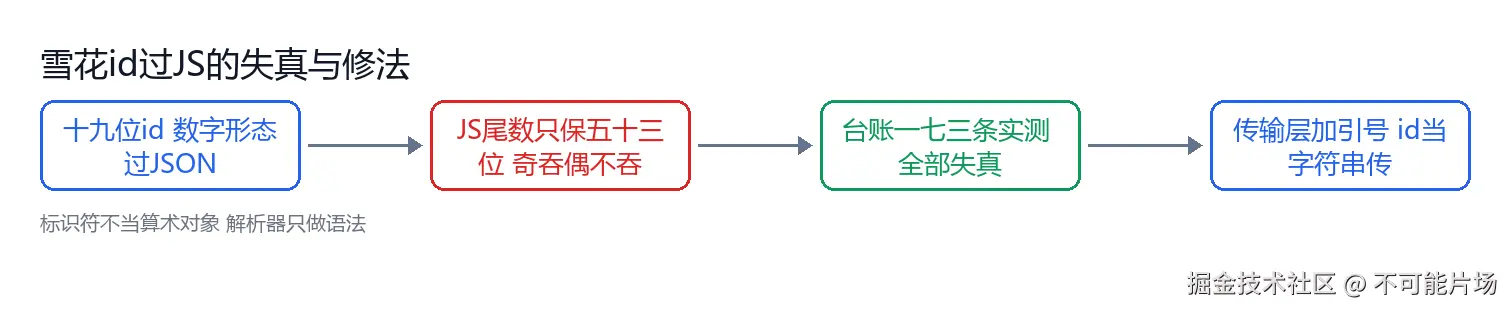
}结果:173 条全部失真,0 条幸免 。量化差分布在 -319 到 +224 之间,132 条偏低、41 条偏高。格点间距是 1024(这一量级的 double 间隔),所以误差被夹在 ±512 内------差得不算离谱,但 id 是标识符不是度量,差 1 就已经不是同一条作品。
有一个样例值得单独看:7679493766410997002 打印出来只差 2(变成 ...7000),看起来「几乎没变」;但它内存里的 double 实际是 7679493766410996736,真差是 266。表面差 2、内里差 266,这是 toString 最短渲染又叠了一层失真------你以为你在看那个数,其实你看到的是它又一个「最像的替身」。
reviver 救不回来
很多文章教你用 reviver 兜底:
js
JSON.parse(raw, (k, v) => v) // 「用 reviver 处理大数」------救不回来实测泼冷水:reviver 收到的 v 已经是失真后的 Number,任何在回调里做的事都太晚了。失真发生在语法分析阶段,reviver 在那之后才被调用:
js
JSON.parse('{"id":7679375766852734223}', (k, v) => v).id
// 7679375766852734000 ------ 回调拿到的就已经是坏值
JSON.parse('{"id":9007199254740993}', (k, v) => v).id
// 9007199254740992 ------ 同样救不回想救只有两条路:别让数字以数字形态到达解析器 ,或者换一个不丢精度的解析器(如 lossless-json、json-bigint,本质都是把长整数先拦成字符串或 BigInt)。
修法与三条落地
修法一(首选):传输层当字符串。 id 是标识符,天生不是算术对象。生成方序列化时带引号,消费方拿到即无损:
js
JSON.parse('{"id":"7679375766852734223"}').id === '7679375766852734223' // true,无损修法二(抢救存量):正则预引号化。 接口改不了、id 是 16 位以上纯数字时,解析前先把长数字包上引号:
js
const fixed = raw.replace(/"id":(\d{16,})/g, '"id":"$1"');
JSON.parse(fixed).id  // 字符串,无损
阈值取 16 是留了余量:2^53 是 16 位数(9.007e15),16 位起就可能有奇数被吞。
三条落地:
- 判界别抽测。 量化失真是「奇吞偶不吞」,抽一条正常就以为没事,是这类问题最典型的漏检姿势。要么全量比对,要么默认全部失真。
- 分清哪侧安全哪侧危险。 Python 侧 int 任意精度永远安全;凡是 JSON 文本要流经 JS/Electron/浏览器/Node 的链路,id 一律按字符串设计。我们台账里 173 条 aweme_id 就是现成的风险清单------它们将来要在删除接口里当
item_id用,错一位就是删错对象。 - 别信打印值。 toString 有最短渲染这一层,表面差 2 不代表内里差 2。要验证就转 BigInt 比对,别用肉眼看字符串。
结语
这条坑的讨厌之处在于三层「静默」:解析不报错、偶数还蒙混过关、打印值又隔了一层纱。我们 16 位的掘金 id 还有 5 倍余量,纯属侥幸------它只是还没长到那条线上。而 19 位的世界(抖音、掘金创作者中心、几乎所有现代雪花 id)早已全部越界。规则一句话:id 过 JS,一律当字符串传。