开发中的资源管理,难点往往藏在细节里。文件需要关闭,数据库事务需要提交或回滚,连接池里的连接需要归还,后台任务需要停止并等待,缓存则需要控制体积。它们都叫资源,处理方式却各有讲究。
一个实用的思路是,用统一的规则管理资源的生命周期,再为不同资源安排合适的释放策略。 在 Python 中,with、contextlib、async with 和 asyncio.TaskGroup 可以构成这套管理体系的骨架。
下面从资源分类、同步管理、异步管理和工程落地四个方面展开。示例以 Python 3.11 及以上版本为基础,第三方库会单独说明。
一、先弄清资源的责任边界
拿到一种资源时,别急着寻找它的 close() 方法。更有价值的问题是,谁拥有它、它应该活多久、退出时要完成什么动作。
资源需要按行为分类
不同资源可以放进同一张管理清单,但清单里的退出动作必须有所区别。
| 资源类型 | 主要风险 | 退出或回收动作 | 常用管理方式 |
|---|---|---|---|
| 文件、套接字 | 句柄泄漏、缓冲数据未处理 | 关闭句柄,按需求刷新缓冲区 | with、closing |
| 数据库连接、连接池 | 连接耗尽、连接状态污染 | 关闭连接或归还连接池 | 驱动或框架的上下文管理器 |
| 数据库事务 | 部分修改残留、锁占用过久 | 成功提交,失败回滚 | 事务上下文 |
| 锁、信号量 | 死锁、其他任务长期等待 | 释放锁或许可 | with、async with |
| 临时文件、临时目录 | 磁盘空间持续增长 | 关闭句柄并按约定删除 | tempfile、清理回调 |
| 异步任务、子进程 | 后台工作失控、退出不完整 | 等待完成,必要时取消或终止,再等待退出 | TaskGroup、进程生命周期管理 |
| 缓存、大对象、GPU 内存 | 内存持续上涨、显存耗尽 | 淘汰对象、解除引用、调用框架专用接口 | 容量预算、流式处理、框架管理机制 |
这张表提醒我们,关闭、归还、回滚、删除、取消和等待,是不同的操作。 比如 SQLAlchemy 的连接归还池后,底层连接通常仍然存在,以便继续复用;销毁连接池又是另一个生命周期层面的动作。
所有权决定谁来收尾
比较稳妥的默认约定是:
- 创建者负责释放。 函数自己打开文件,就在函数内部关闭。
- 借用者不擅自释放。 函数接收调用方传入的文件对象,通常只使用它。
- 转移所有权必须明确。 如果函数把新建连接返回给调用方,文档和接口需要说明调用方的释放责任。
- 共享资源交给更外层管理。 应用级连接池由应用生命周期管理,单次请求管理自己借到的连接。
看看下面两种接口,责任边界就很清楚。
python
from pathlib import Path
from typing import TextIO


def count_lines_from_path(path: Path) -> int:
    # 本函数创建并拥有文件对象。
    with path.open(encoding="utf-8") as stream:
        return sum(1 for _ in stream)


def count_lines_from_stream(stream: TextIO) -> int:
    # 本函数借用文件对象,不负责关闭。
    return sum(1 for _ in stream)
第二个函数会改变文件的读取位置。这也属于资源使用契约,应当让调用方知道。资源管理既要说明谁负责释放,也要说明使用后会留下什么状态。
生命周期要形成清晰的嵌套
资源通常有依赖关系。使用数据库连接的任务,应当先结束;承载连接的连接池,随后才能关闭。
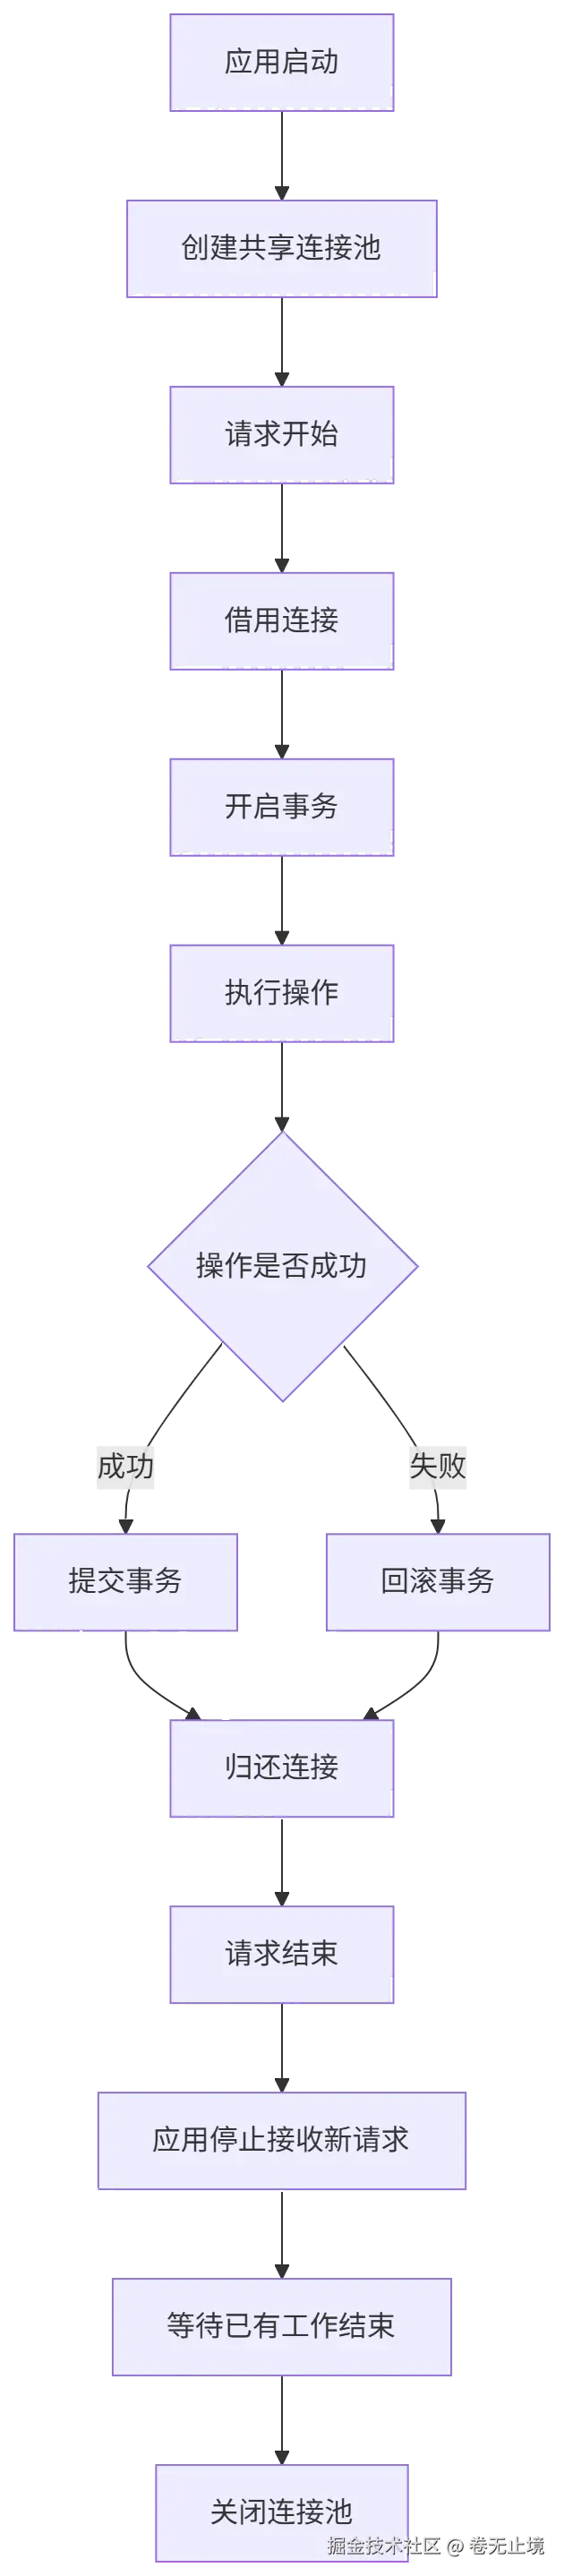
一个好记的原则是,依赖先建立,使用者后建立;使用者先退出,依赖后退出。 这也是上下文管理器嵌套和清理栈非常实用的原因。
二、同步资源管理:让退出动作跟着作用域走
Python 的上下文管理器可以把资源的使用范围和清理动作绑定起来。读代码时,只看缩进边界,就能知道资源何时退出。
with 管作用域,但退出语义由资源决定
典型的文件管理很直接。
python
with open("input.txt", encoding="utf-8") as stream:
    for line in stream:
process(line)只要已经成功进入上下文,正常执行结束、return 或异常传播,都会触发对应的退出逻辑。
这里需要理解两个边界。
- 进入失败时,资源实现需要自己处理部分初始化。 如果
__enter__()在申请了部分资源后抛出异常,Python 不会自动调用该对象的__exit__()。 - 退出代码无法抵抗所有外部故障。 进程被强制杀死、机器断电等情况,可能没有机会执行 Python 清理逻辑。
因此,with 提供的是正常运行及异常传播过程中的确定性退出机制。涉及断电恢复、跨进程一致性时,还需要事务、日志或恢复协议。
用 ExitStack 组合数量不固定的资源
固定两个文件,可以直接嵌套 with。文件数量由运行时决定,就适合使用 ExitStack。
python
from contextlib import ExitStack
from pathlib import Path


def count_lines(paths: list[Path]) -> int:
    with ExitStack() as stack:
        streams = [
            stack.enter_context(path.open(encoding="utf-8"))
            for path in paths
        ]

        return sum(
            1
            for stream in streams
            for _ in stream
        )
这段代码具有几个重要性质。
- 打开后面的文件失败时,前面已经成功进入上下文的文件会被关闭。
- 处理中途发生异常,退出栈仍然会执行清理。
- 清理按注册的逆序进行,适合表达资源依赖关系。
对于没有上下文协议的资源,也可以在成功获取后立即注册回调。
python
with ExitStack() as stack:
    resource = acquire_resource()
    stack.callback(release_resource, resource)

use_resource(resource)其中三个函数由业务或第三方库提供。核心习惯是,获取成功后马上登记清理,中间尽量不插入可能失败的操作。
还有一个容量上的提醒。前面的多文件示例会同时打开全部文件,适合数量有限、确实需要同时访问的场景。处理几万个文件时,更适合逐个打开、逐个关闭。能可靠清理,并不代表可以无限持有。
把事务退出和连接退出分开理解
数据库是最容易暴露资源差异的地方。
Python 标准库的 sqlite3.Connection 可以用作上下文管理器,但这个上下文主要处理事务提交和回滚,不会顺便关闭连接,也不会自动替你开启事务。
下面显式开启一个简单事务,并分别管理事务与连接。
python
import sqlite3
from contextlib import closing


def save_message(database: str, message: str) -> None:
    with closing(sqlite3.connect(database)) as connection:
        with connection:
            connection.execute("BEGIN")

            connection.execute(
                """
                CREATE TABLE IF NOT EXISTS messages (
                    id INTEGER PRIMARY KEY,
                    content TEXT NOT NULL
                )
                """
            )

            connection.execute(
                "INSERT INTO messages(content) VALUES (?)",
                (message,),
            )
退出顺序很清楚。
- 内层事务上下文根据执行结果提交或回滚。
- 外层
closing调用连接的close()。
实际项目还应根据 Python 版本和驱动配置统一事务模式,避免混用显式事务与框架自动事务。第三方数据库库的 with 语义也要分别查阅,不能根据 SQLite 的行为直接推断。
为特殊资源编写小而明确的适配器
如果资源只有一对获取和释放函数,可以通过 contextmanager 包装。
python
from contextlib import contextmanager


@contextmanager
def managed_resource(acquire, release):
    resource = acquire()
    try:
        yield resource
    finally:
        release(resource)
调用时把资源自己的策略传进去。
python
with managed_resource(acquire_resource, release_resource) as resource:
    use_resource(resource)
这个适配器只统一生命周期,不猜测业务语义。数据库回滚、设备停机、连接归还等动作,应当由具体的 release 或专用上下文管理器实现。
如果获取过程本身包含多个步骤,acquire() 还必须保证中途失败时回收已经取得的部分资源。外层包装器无法释放一个尚未成功返回的对象。
三、异步资源管理:把任务、取消和容量一起纳入设计
异步系统里,连接可能已经关闭,使用连接的后台任务却还没结束。这类生命周期错位,比漏写一个 close() 更难排查。
解决思路是,资源有作用域,任务也有作用域,而且两者的退出顺序必须匹配。
用 async with 管资源,用 TaskGroup 管任务
下面使用第三方库 aiohttp,同时管理 HTTP 会话、响应对象和一组并发任务。
python
import asyncio
import aiohttp


async def fetch_lengths(urls: list[str]) -> list[int]:
    timeout = aiohttp.ClientTimeout(total=15)
    connector = aiohttp.TCPConnector(
        limit=20,
        limit_per_host=5,
    )
    slots = asyncio.Semaphore(20)

    async with aiohttp.ClientSession(
        timeout=timeout,
        connector=connector,
    ) as session:

        async def fetch_one(url: str) -> int:
            async with slots:
                async with session.get(url) as response:
                    response.raise_for_status()

                    total = 0
                    async for chunk in response.content.iter_chunked(65536):
                        total += len(chunk)

                    return total

        async with asyncio.TaskGroup() as group:
            tasks = [
                group.create_task(fetch_one(url))
                for url in urls
            ]

        return [task.result() for task in tasks]
这里有几层管理,各司其职。
- 会话作用域负责连接池等 HTTP 客户端资源。
- 响应作用域负责当前响应的退出处理。
- 任务组作用域负责等待任务,并按规则处理任务失败。
- 信号量限制同时进入请求处理区的任务数。
- 连接器限制约束总体连接数和单个站点的连接数。
- 流式读取避免一次性把完整响应内容放进内存。
TaskGroup 在 Python 3.11 引入。组内任务发生普通异常时,它会取消剩余任务,等待它们结束,再传播相关异常。由于任务组位于会话作用域内部,任务会先收尾,会话随后退出。
不过,这个示例仍会为每个 URL 创建一个任务。输入达到几十万条时,即使请求并发受到限制,等待中的任务也可能占用大量内存。生产环境通常应改成有限大小的队列加固定数量的工作任务,让输入端在队列满时等待。
取消是清理必须面对的执行路径
异步任务收到取消请求后,通常会在可取消的等待点抛出 CancelledError。清理代码应当放进 finally,或者交给异步上下文管理器。
python
async def worker(resource):
    try:
        await resource.run()
    finally:
await resource.aclose()这段代码还依赖资源库的具体契约。aclose() 是否允许重复调用、是否可能阻塞、是否支持取消,都需要确认。
工程上可以遵循这些原则。
- 捕获
CancelledError做局部收尾后,通常应重新抛出。 - 清理阶段需要明确的时间预算。
- 对必须完成的关键清理,可以考虑库提供的取消保护机制。
- 使用
asyncio.shield()时,仍要管理被保护任务的引用和最终等待;调用方收到取消,不代表内部工作已经结束。 - 避免没有生命周期归属的后台任务。
取消请求更像一张停止通知,任务仍然需要执行退出流程。对于线程和子进程,停止方式又不同,尤其是运行中的线程任务,通常无法通过取消对应的异步等待来强制终止。
设置上限,也要明确等待多久
连接池大小、任务并发数、队列长度和请求超时,解决的是不同问题。
| 控制项 | 主要约束 | 缺失时的典型后果 |
|---|---|---|
| 连接池上限 | 同时持有的连接数量 | 数据库或远端服务承压 |
| 并发上限 | 同时执行的业务操作数量 | CPU、内存或服务容量被耗尽 |
| 队列上限 | 尚未处理的积压数量 | 请求排队占满内存 |
| 超时预算 | 等待资源或操作完成的时间 | 长时间占用槽位 |
| 重试预算 | 失败后的额外工作量 | 故障期间请求量继续放大 |
这些限制应当相互配合。队列满时,让上游等待、降速或拒绝请求,就是背压。系统在容量不足时及时表达边界,往往比无限接收请求更可靠。
四、工程落地:让资源管理可检查、可恢复、可观测
上下文管理器解决了大量局部问题。要在一个完整项目中管好资源,还需要把所有权、容量和故障处理写进设计与测试。
建立资源契约,少做过度统一
每一种重要资源,至少应说明下面几项。
- 获取方式及获取失败时的行为。
- 所有者及是否允许转移所有权。
- 有效作用域,例如函数、请求、任务组或应用。
- 退出语义,例如关闭、归还、提交、回滚或终止。
- 重复释放行为及是否允许并发使用。
- 容量上限与等待超时。
- 清理失败的处理方式。
可以统一接口和管理规则,但别为了形式整齐,把所有资源硬塞进一个只有 close() 的巨大管理器。更稳妥的组合是,资源适配器表达差异,上下文和清理栈组织生命周期,业务代码表达使用顺序。
不依赖垃圾回收安排关键收尾
Python 的垃圾回收主要面向对象内存。外部资源还涉及操作系统、数据库和远端服务的状态。
几个容易混淆的地方需要分开看。
del删除的是一个引用,对象可能仍被其他地方引用。- CPython 中部分对象可能因引用计数归零而很快销毁,但关键释放逻辑不应依赖这个时机。
__del__()不适合作为唯一的关键清理机制。weakref.finalize()可以提供兜底清理,但无法代替明确的生命周期管理。- 弱引用缓存可以避免缓存独自延长对象寿命,却不等于按业务需求管理容量和命中率。
对于内存和显存,还需要额外观察强引用、缓存策略和框架的内存分配机制。对象释放后,进程常驻内存或 GPU 已预留内存未必立即下降,判断泄漏时应看持续趋势及框架指标。
测试失败路径,尤其是清理本身失败
资源管理测试应覆盖正常路径,也要主动制造故障。
| 测试场景 | 应验证的结果 |
|---|---|
| 获取第二个资源时失败 | 第一个资源已经释放 |
| 使用过程中发生异常 | 清理执行,业务异常保持可诊断 |
| 事务内操作失败 | 修改按约定回滚 |
| 异步任务被取消 | 子任务完成收尾,资源不再被使用 |
| 某项清理失败 | 其他清理仍按设计尝试执行 |
| 重复调用释放操作 | 行为符合接口契约 |
| 资源达到容量上限 | 等待、超时或拒绝策略有效 |
| 应用关闭 | 停止接收工作,再结束任务,随后释放共享资源 |
清理异常还可能掩盖原来的业务异常。重要系统应保留两者的诊断信息,并明确哪些清理失败需要报警、哪些需要补偿。对外部操作重试前,也要确认操作具有幂等性,避免重复删除、重复提交或重复扣费。
同时观察打开的文件句柄数、连接借出数、等待时间、队列深度、存活任务数和清理失败次数。压测结束后,这些指标应回到合理的基线。资源已经泄漏却毫无指标,排查起来就容易变成猜谜游戏。
把日常检查浓缩成五个问题
代码评审时,可以用这五个问题快速检查资源管理是否完整。
- 资源由谁拥有,谁负责释放?
- 它应该在哪个作用域结束?
- 获取失败、业务失败、超时和取消时,会发生什么?
- 同时持有的数量和等待时间,有没有上限?
- 释放失败或资源泄漏,能否通过测试和指标发现?
管好各类资源,靠的是清晰的责任边界、确定的退出顺序和符合资源特性的管理策略。 Python 的上下文管理器让这些规则落在代码里,容量控制与故障测试则让它们在真实负载下站得住。把这两部分一起做好,资源管理就能从零散的清理代码,变成可靠的工程机制。
参考资料
Python 官方文档 contextlib
docs.python.org/3/library/c...
Python 官方文档 Coroutines and Tasks
docs.python.org/3/library/a...
Python 官方文档 weakref
docs.python.org/3/library/w...
Python 官方文档 sqlite3
docs.python.org/3/library/s...
SQLAlchemy 官方文档 Session Basics
docs.sqlalchemy.org/en/latest/o...
aiohttp 官方文档 Client Reference