作者:林润骑(太业)
企业级 AI Coding 度量的两个前置条件:数据归一化与采集覆盖率
AI Coding 已经过了个人尝鲜的阶段:预算走年度审批,席位按人头采购,Token 成本按月结算,采纳率与 AI 生成代码占比也进入了组织转型的度量口径。既然是一笔明确的组织投入,就得回答投入换回了什么------而这三个问题往下追一层,多数团队答不上来:团队现在到底在用几个 AI Coding Agent?每天消耗多少 Token、折算多少成本?哪个工具真正带来了产出变化,哪个只是装了没用?
Claude Code、Cursor、Codex、Qwen Code、Qoder......工具在团队里自发生长,每个人的选择都不一样。三个问题的答案不在直觉里,在数据里。而这份数据是否可用,取决于两个相互独立的前置条件:
跨 Agent 的数据归一化,决定指标的可比性。 每个 Agent 的日志格式、Hook 机制、会话结构都不一样。把十几种工具的原生日志堆在一起,得到的是十几种互不兼容的格式,不是一张可聚合的报表。
采集覆盖率------采集器能否部署到每台开发机并持续运行,决定样本的代表性。 这一项常被当成推广问题,实际上是一个分发控制问题:安装包怎么按组织范围精确下发、配置变更怎么幂等收敛到每台机器、采集进程掉了谁来拉起、版本怎么灰度和回退。
两项都是必要条件,但形态不同。归一化是数据建模问题 ,解法在采集器内部,做对一次之后所有 Agent、所有团队都受益。覆盖率是分发与配置管理问题,解法不在采集器内部,而在下发通道上;而且它不会一次性收敛------下周有人重装系统,下个月来了新同学,下个季度要改一次上报配置,没有下发通道兜着,覆盖率立刻回落。
所以真正卡住绝大多数团队的是覆盖率。只要方案依赖"请大家手动执行一条安装命令",就会遇到四个卡点:
| 卡点 | 具体表现 |
|---|---|
| 通知没看到 | 通知发出去了,但总有人没看到、没来得及、忘了 |
| 装不上 | 有人 Node 版本不对,有人用了 nvm,有人装完环境冲突干脆卸了 |
| 装了没在跑 | "装过"不等于"在跑",机器重启、进程被杀,采集静默中断且无人发现 |
| 配置一改就得重来 | 脱敏策略要调、上报参数要改,每改一次配置就得再发一轮全员通知 |
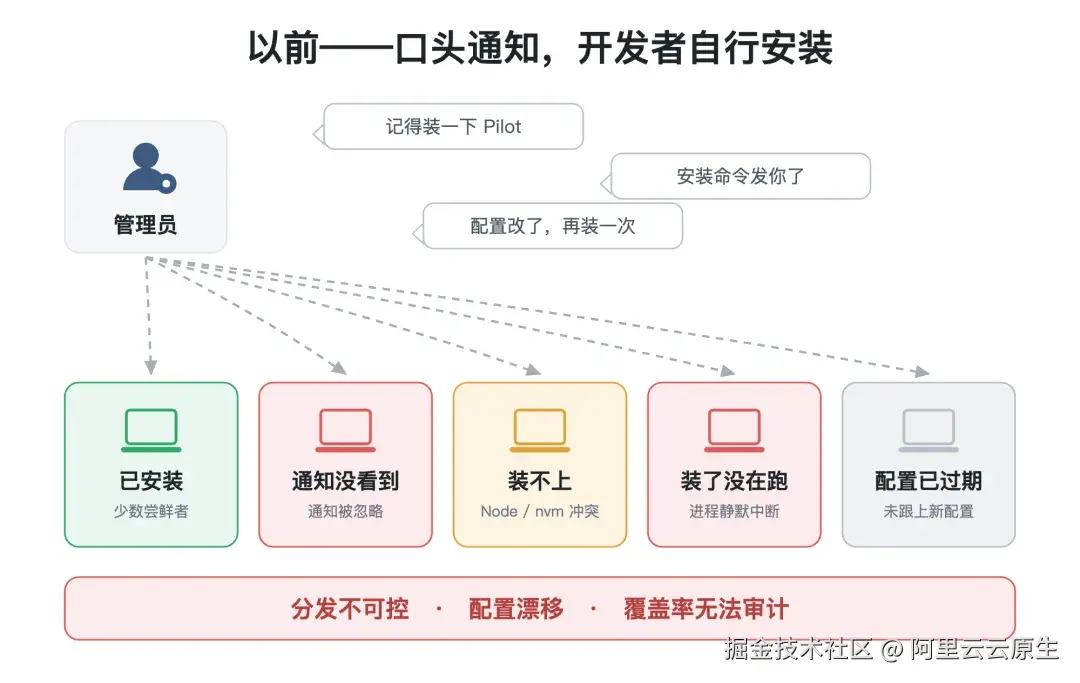
四个卡点叠加下来,覆盖率会稳定收敛在早期尝鲜者这一小部分样本上------归一化做得再完备,也只是把一份有偏抽样算得更精确。
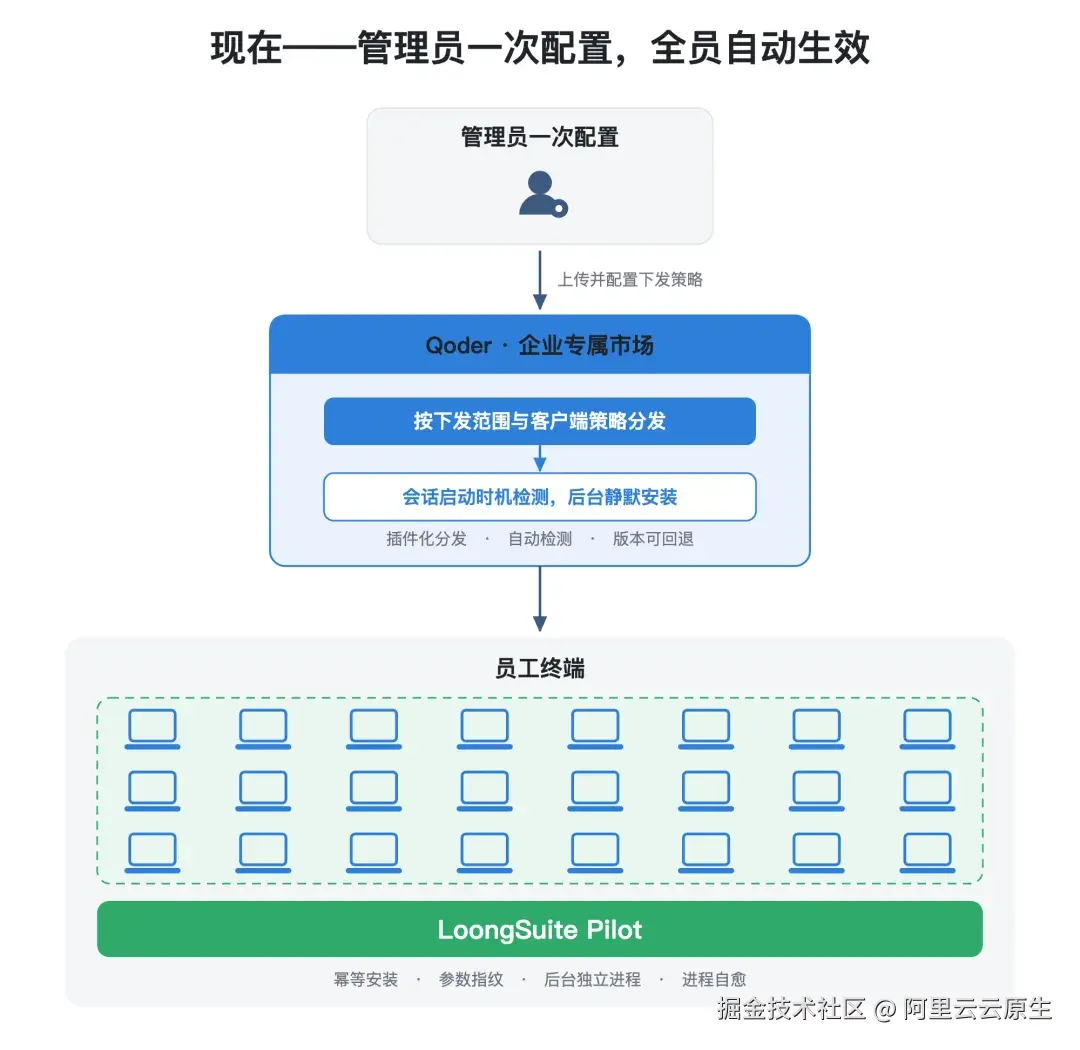
本文介绍我们如何用 LoongSuite Pilot 解决归一化,再用它的 Qoder 插件加上 Qoder 企业专属市场把覆盖率推到接近全量,把三者接成一条链路:管理员一次配置,全员自动生效。
采集底座------LoongSuite Pilot 的多 Agent 事件归一化
LoongSuite Pilot 是一个运行在开发者本机的 AI Coding Agent 遥测采集器。 它做四件事:发现本机已安装的 Agent,部署所需的 Hook 或插件,把不同 Agent 的活动数据归一化为统一的 GenAI 事件 Schema,再上报到可观测后端。
▍自动发现与采集能力部署------按 Agent 机制适配接入
Pilot 通过本地路径和命令自动检测机器上装了哪些支持的 Agent,不需要用户申报,再针对每种 Agent 各自的机制自动完成接入。
不同 Agent 的接入方式差异极大,这部分复杂度全部由 Pilot 内部消化:
| 接入方式 | 代表 Agent |
|---|---|
| Hook | Claude Code、Codex、Cursor、Qwen Code CLI、Qoder 系列 |
| 插件注入 | OpenCode、OpenClaw、MiMo Code |
| 原生插件 / Extension | Hermes Agent、Pi Coding Agent |
| YAML patch + 本地 JSONL 轮询 | DeepSeek Harness |
| Hook 唤醒 + transcript 监听兜底 | WorkBuddy |
| CLI API 轮询 | Wukong |
当前支持矩阵覆盖 20 种主流 Agent,含 Qoder 全系列(IDE / CN / JetBrains / CLI / Work)、Cursor 与 Cursor CLI、Kiro CLI 等。Agent 定义以声明式配置放在仓库 agents.d/ 目录下,接入一个新 Agent 不需要改动采集器主干代码。
▍统一事件 Schema------对齐 GenAI 语义约定的字段归一化
这一层是归一化的正面答案,也是 Pilot 最核心的价值。
Pilot 把各 Agent 的原生事件归一化为一套 GenAI 事件字段,对齐 GenAI audit-event 语义约定,核心事件只有几类:
event.name |
含义 |
|---|---|
llm.request |
一次 LLM 请求,含用户输入、上下文增量、请求模型 |
llm.response |
一次 LLM 响应,含文本、reasoning、tool-call 意图、finish reason、Token 用量与费用 |
tool.call / tool.result |
工具的一次实际执行与返回 |
skill.use |
技能、扩展能力或 Agent 能力调用 |
tool.approve |
用户批准工具执行 |
关键在字段的完整度。归一化之后拿到的不只是"谁在什么时候调了模型",而是一套能直接支撑成本与效率分析的结构化数据:
- 三级会话结构 :
gen_ai.session.id(会话)、gen_ai.turn.id(一次用户请求到最终响应的轮次)、gen_ai.step.id(一次 ReAct 循环),让"一次需求耗了多少轮、每轮几步"变得可算。 - Token 分级 :输入、输出、总量之外,单独记录
cache_read与cache_creation的输入 Token。缓存命中率直接决定实际开销,合并统计会严重高估成本。 - 成本字段:有价格信息时直接给出输入、输出、缓存读写以及总成本(USD),下游不需要再维护一份价目表。
- 性能字段 :
gen_ai.response.time_to_first_token记录首 Token 延迟(纳秒),这是开发者对工具"快不快"的体感里最关键的一项。 - Provider 归一 :
gen_ai.provider.name统一到anthropic、openai、qwen、deepseek、gcp.vertex_ai、aws.bedrock等标准取值,同一个模型经不同网关调用也能归到一起。 - 内容与去重 :完整输入输出消息属于 Opt-In 字段,同时提供
messages_delta(相比上一条请求的增量)和messages_hash(完整上下文 hash),在不落全文的前提下也能做去重和上下文膨胀分析。
一条归一化之后的事件大致长这样(字段节选,取值为示意):
json
{
  "event.name": "llm.response",
  "user.id": "12345",
  "gen_ai.agent.type": "claude-code",
  "gen_ai.provider.name": "anthropic",
  "gen_ai.session.id": "sess-a1b2",
  "gen_ai.turn.id": "turn-7",
  "gen_ai.response.model": "claude-opus-5",
  "gen_ai.usage.input_tokens": 18420,
  "gen_ai.usage.cache_read.input_tokens": 16800,
  "gen_ai.usage.output_tokens": 612,
  "gen_ai.usage.total_cost": 0.0431,
  "gen_ai.response.time_to_first_token": 843000000,
  "gen_ai.response.finish_reasons": ["stop"]
}
同样一条记录,换成 Cursor、Codex、Qoder,字段名和结构完全一致。这意味着不同工具可以进入同一张报表横向对比,不需要为每个 Agent 单独维护一套解析逻辑。组织度量真正的门槛从来不是有没有日志,而是不同工具的日志能否归一到同一套字段语义上。
▍隐私控制------采集范围与输出前脱敏两层独立
对外推行时这一环几乎必然被问到。Pilot 把控制点分成两层,都能在生成安装包时固化下来,随安装包一起下发到每台机器。
第一层,采集范围 。--agents 按 Agent 白名单开启采集,未列入的 Agent 即使装在机器上也不采;--all-agents 则是全量开启。这一层决定"哪些工具进入采集范围"。
第二层,输出前脱敏 。--mask-mode 支持 none / all / custom 三种模式,custom 下再用 --mask-types 指定类型,可选 apiKey、idCard、phone、email、ipAddress、bankCard。脱敏在输出前扫描字段并替换仍然存在的高置信敏感信息,落到配置里就是 mask.mode 与 mask.types:
css
{
  "mask": { "mode": "custom", "types": ["apiKey", "idCard", "phone"] },
  "agents": {
    "claude-code": { "enabled": true },
    "cursor":      { "enabled": true }
  }
}
采什么、不采什么,决定权始终在组织自己手里,而且是在下发时就定好的,不依赖开发者本机的自觉。
▍本地运维------命令行管理、配置回滚与本机 Dashboard
日常运维是一组直观的命令,配置支持回滚,出问题一键复原:
sql
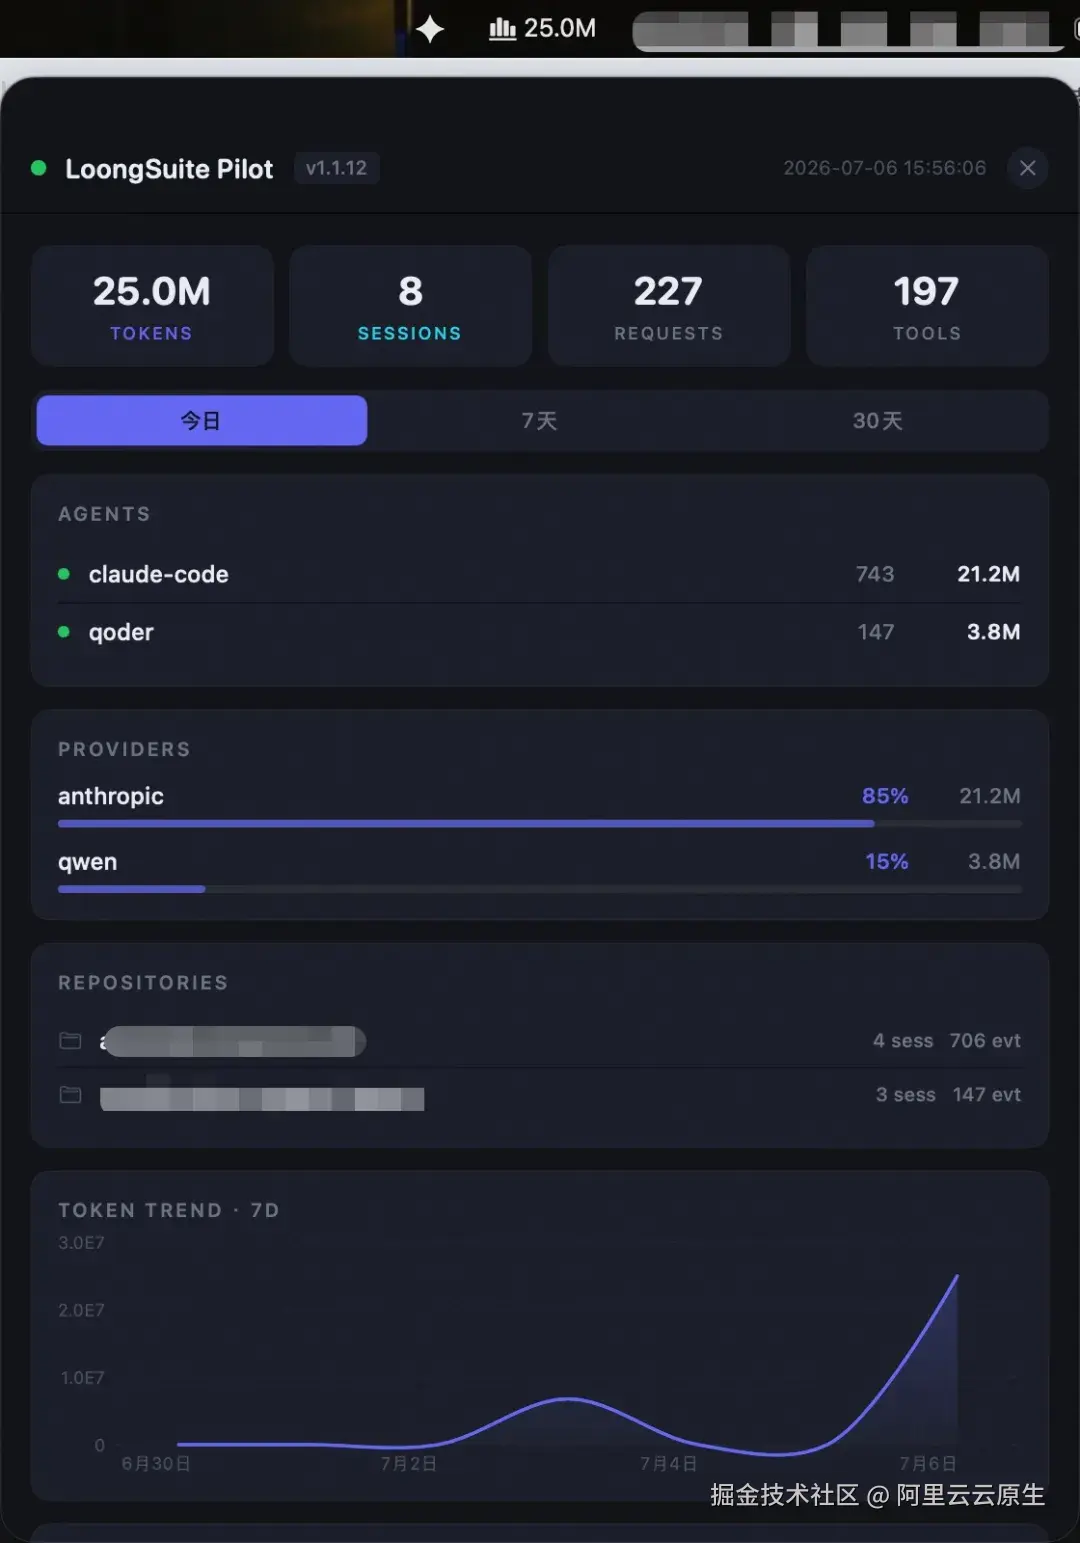
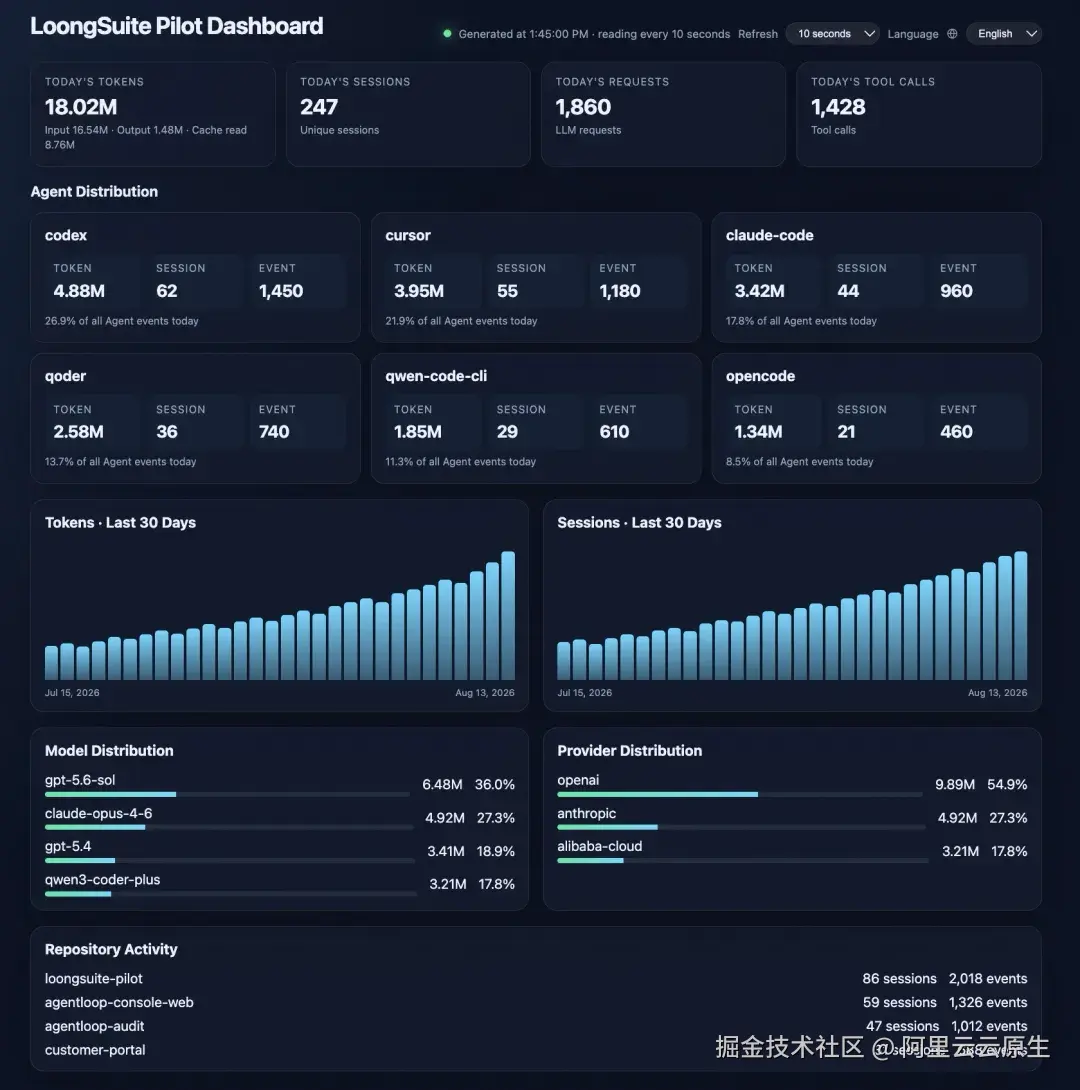
loongsuite-pilot start / stop / restart / status / info / token-usage / rollback采集服务启动后本地 Dashboard 随之就绪(默认端口 8765),浏览器打开 http://127.0.0.1:8765/ 即可实时查看自己的 Token 用量、会话数、请求与工具调用分布,以及按 Agent、Provider、仓库的活动情况,不需要额外命令。macOS 上 Pilot 安装后还会自动常驻菜单栏,不打开 Dashboard 也能随时掌握活动状态。
自动触达------Qoder 插件的静默安装、自愈与自动更新
采集底座足够扎实之后,剩下的是覆盖率。这一节讲的就是分发控制的具体实现。
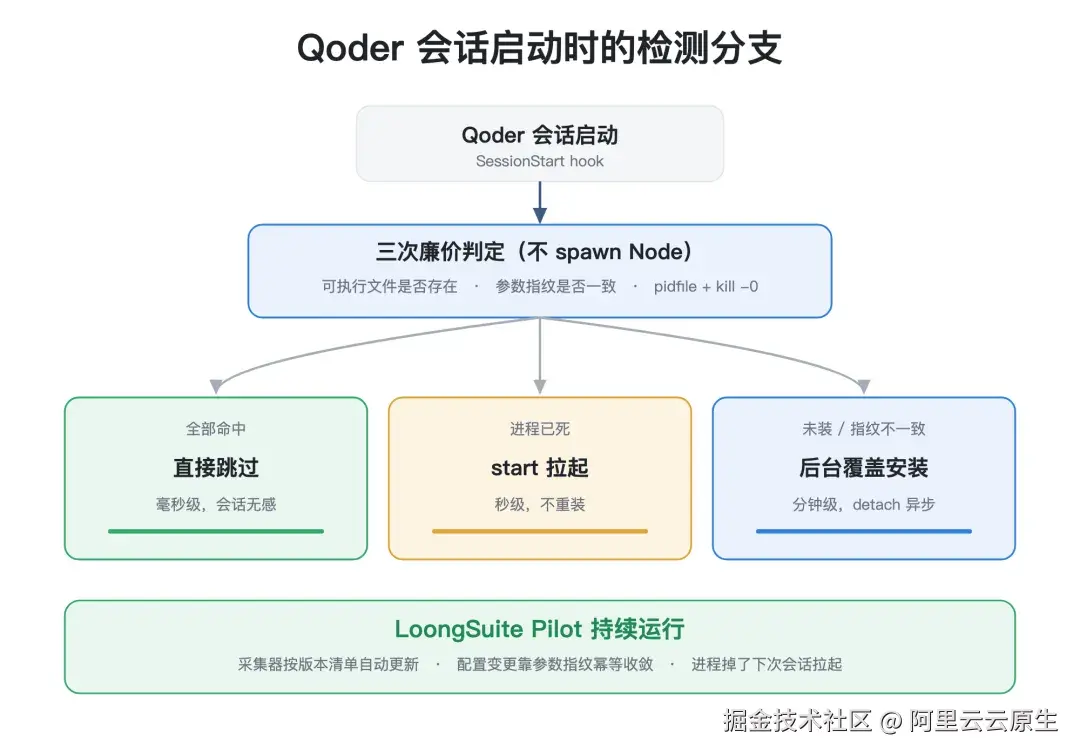
loongsuite-pilot-installer 是一个 Qoder 插件,把安装动作挂在 SessionStart 这个会话启动时机上。开发者不需要知道 Pilot 是什么,更不需要执行任何命令,只要打开 Qoder 开始写代码,插件就会自动判断该做什么:
| 本机状态 | 插件动作 | 耗时量级 |
|---|---|---|
| 已安装 + 配置未变 + 进程存活 | 直接跳过 | 毫秒级 |
| 已安装 + 配置未变 + 进程已死 | start 拉起,不重装 |
秒级 |
| 未安装 / 配置已变更 | 后台安装或覆盖安装 | 分钟级,异步 |
三条分支的判定逻辑对应下面三个设计,正好覆盖背景里的四个卡点。
▍判定与执行分离------毫秒级检测,重活丢到后台
Hook 里只做三次廉价判定:可执行文件是否存在、参数指纹是否一致、读 pidfile 加 kill -0 探测进程存活。三次判定都不 spawn Node 进程,所以日常命中快路径时开销可以忽略,会话不会因为它慢一拍。
真正的安装是重活,可能要几分钟。插件把它 detach 成一个脱离 CLI 进程树的后台进程:hook 立即返回并提示"正在后台安装",会话照常进行,开发者关掉窗口也不会把安装打断。多个会话同时启动时,靠一把带 PID 判活的目录锁保证只有一个实例在装------判活而不是单纯按时间过期,是因为慢装进程还活着时按 TTL 误回收会拉起第二个 install 并发抢写配置文件。
▍自带 Node.js 运行时------与开发者本机环境相互隔离
安装器默认下载一份托管的 Node.js v22 运行时,校验后固定在 Pilot 自己的数据目录里(平台不支持或下载失败时才回退系统 Node)。采集运行不依赖开发者本机装了什么版本的 Node,也不依赖 nvm------开发者升级、切换甚至删除自己的 Node,采集都不受影响;反过来,采集器也绝不污染开发者的开发环境。这一条直接消掉"装不上"这个卡点里最常见的一类原因。
▍参数指纹------配置变更的幂等覆盖安装
指纹是安装器地址加全部安装参数的 SHA-256,写在数据目录里。管理员改完参数、递增插件版本号重新下发,用户下一次会话指纹不一致,后台按新配置覆盖安装,然后写入新指纹;此后每次会话指纹命中,回到毫秒级跳过。
覆盖安装对配置文件是合并语义,未传的参数保留旧值,本地日志和采集位点都不动。首次下发时如果机器上已有手动安装的 Pilot(没有指纹记录),会被当作配置不一致重装覆盖------保证最终配置以管理员下发的为准,而不是以谁先装的为准。
▍自动更新------版本清单比对与就地重启
配置变更靠指纹,版本升级则由采集器自己完成,不需要管理员再下发一次插件。安装时会把更新通道写进配置,采集器定期拉取通道下的版本清单(默认约一分钟一次),与本地 VERSION 比对:清单版本更高就下载新包,校验 SHA-256 后解压到独立的版本目录,确认入口文件与依赖就绪,再原地重启采集进程切到新版本。清单里还带一个 hotfix 版本位,用于紧急修复的灰度下发。
对开发者来说,这一层完全无感;对管理员来说,采集器的版本收敛不占用插件下发的节奏------插件版本只在参数变更时才需要动。
▍用户标识------数据能归属到人
组织度量要有"按人分析"的维度,事件就必须带用户标识。插件在会话启动时从 Qoder 的运行时上下文里取当前 Qoder 登录用户的 uid,写入采集配置,最终落到事件的 user.id 字段上。
这条链路对管理员完全可控:可以用环境变量 LOONGSUITE_PILOT_USER_ID 覆盖成组织自己的标识体系;不传时采集器回退到主机名,即数据只能归属到机器、不归属到人。
组织下发------安装包生成与按范围分发
管理员的全部工作在两个控制台里完成:先在接入中心按参数生成安装包,再到 Qoder 企业专属市场上传、下发。全程不需要写配置文件,也不需要联系任何一位开发者。
▍第一步:在接入中心生成安装包
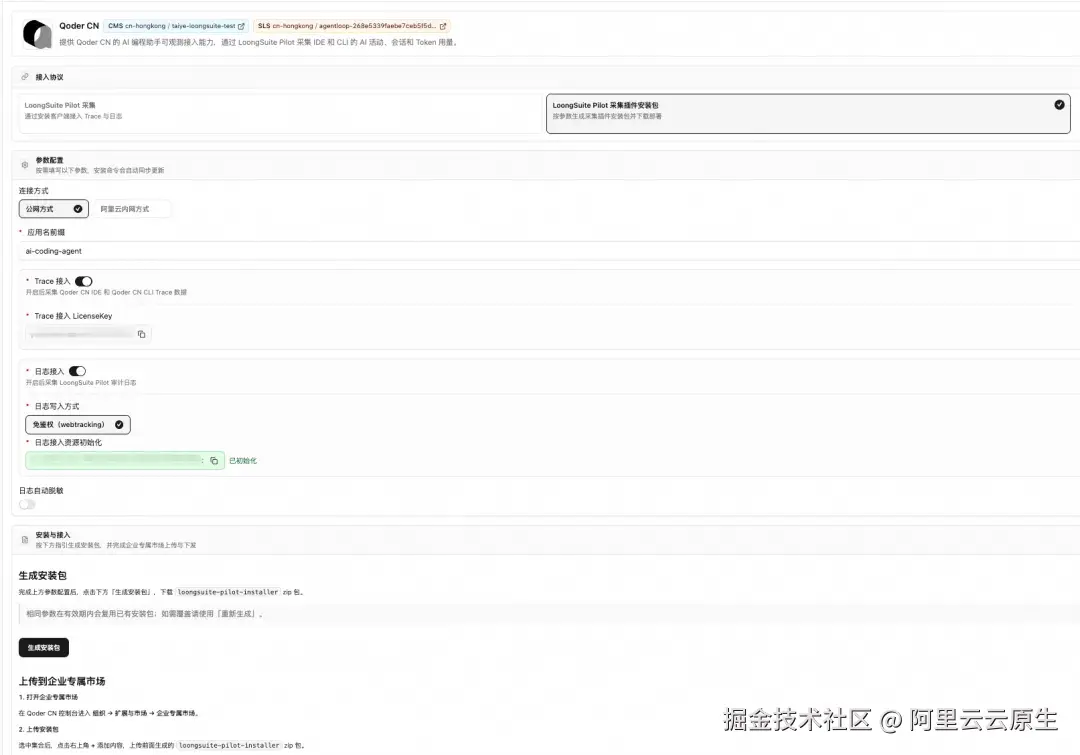
进入接入中心,Agent 选择 Qoder 或 Qoder CN,接入协议选择「LoongSuite Pilot 采集插件安装包」------按填写的参数生成采集插件安装包并下载部署。
要填的参数正是前面讲过的那几项采集能力:
| 参数 | 说明 |
|---|---|
| 连接方式 | 公网或阿里云内网 |
| 应用名前缀 | 上报数据的应用名前缀,例如 ai-coding-agent |
| Trace 接入 | 开启后填入 Trace 接入 LicenseKey |
| 日志接入 | 开启后选择日志写入方式(如免鉴权 WebTracking),并完成日志接入资源初始化 |
| 日志自动脱敏 | 对应 Pilot 的输出前脱敏能力,敏感环境建议开启 |
点击「生成安装包」即可下载 loongsuite-pilot-installer 压缩包。相同参数在有效期内会复用已有安装包,需要覆盖时用「重新生成」------这就是前面那套参数指纹机制在控制台一侧的样子:参数没变,包也不变,机器上自然不会有多余的重装动作。
▍第二步:上传到企业专属市场
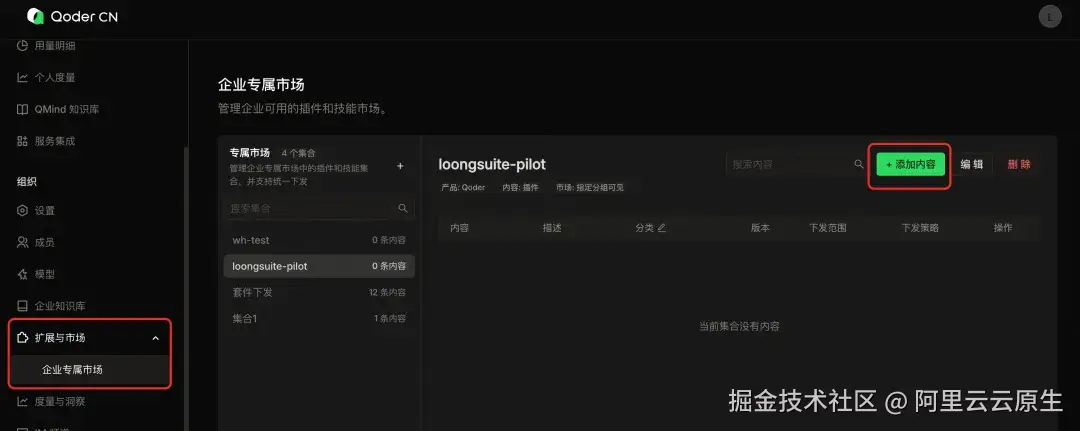
- 打开企业专属市场。 在 Qoder CN 控制台进入「组织 → 扩展与市场 → 企业专属市场」。
-
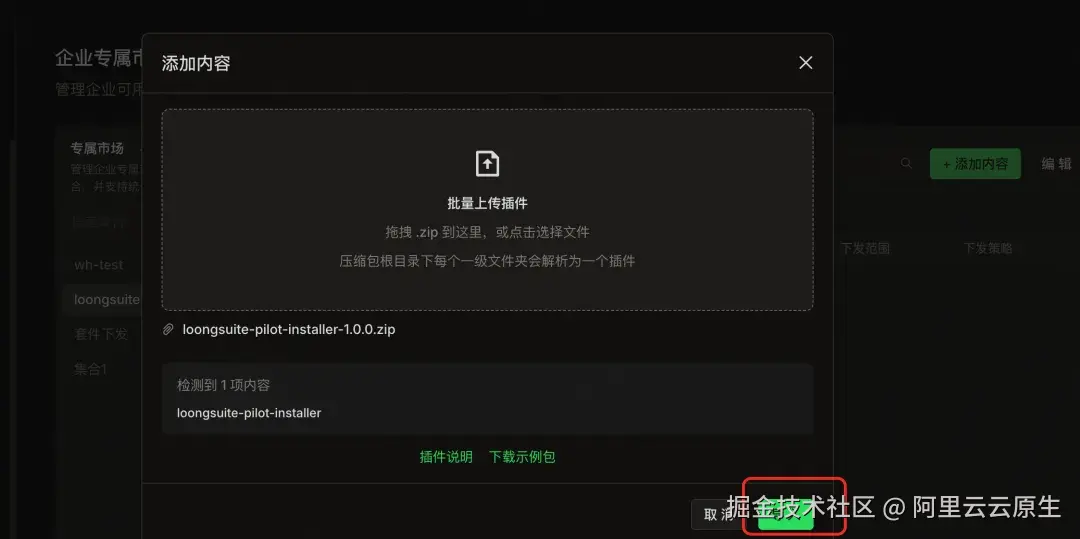
上传安装包。 选中集合后,点击右上角「+ 添加内容」,把前面生成的
loongsuite-pilot-installerzip 包拖进上传区------压缩包根目录下的每个一级文件夹会被解析为一个插件,控制台会先列出解析结果,确认无误后点击「导入」。 -
确认上传结果。 保存后内容会出现在右侧表格中,即完成上传插件操作。
▍第三步:配置下发策略
刚导入的内容默认是「未下发」,不会推给任何人------这一步之前不用担心误触达。在内容表格中点击「操作 → 配置」,打开「配置下发策略」,选择下发范围与客户端策略,完成下发操作。
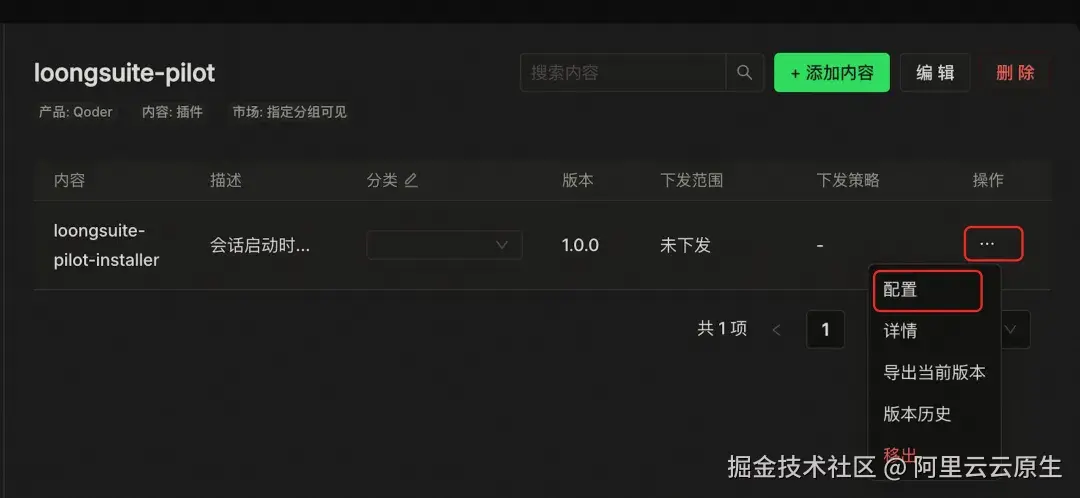
下发范围决定"推给谁",客户端策略决定"成员感知到什么程度"。两个维度组合起来,正好对应一次完整的推广节奏:
| 推广阶段 | 下发范围 | 客户端策略 | 效果 |
|---|---|---|---|
| 自助期 | 未下发 | --- | 内容只在市场可见,种子用户自助安装,先跑通链路 |
| 试点期 | 分组下发 | 客户端可配置 | 推送给选中的分组,客户端支持时成员可自行关闭 |
| 扩量期 | 全员下发 | 强制开启 | 推送给所有用户,分发后强制开启,用户不可关闭 |
| 基线期 | 全员下发 | 静默启用 | 客户端不展示,后台强制启用,成为组织基础设施 |
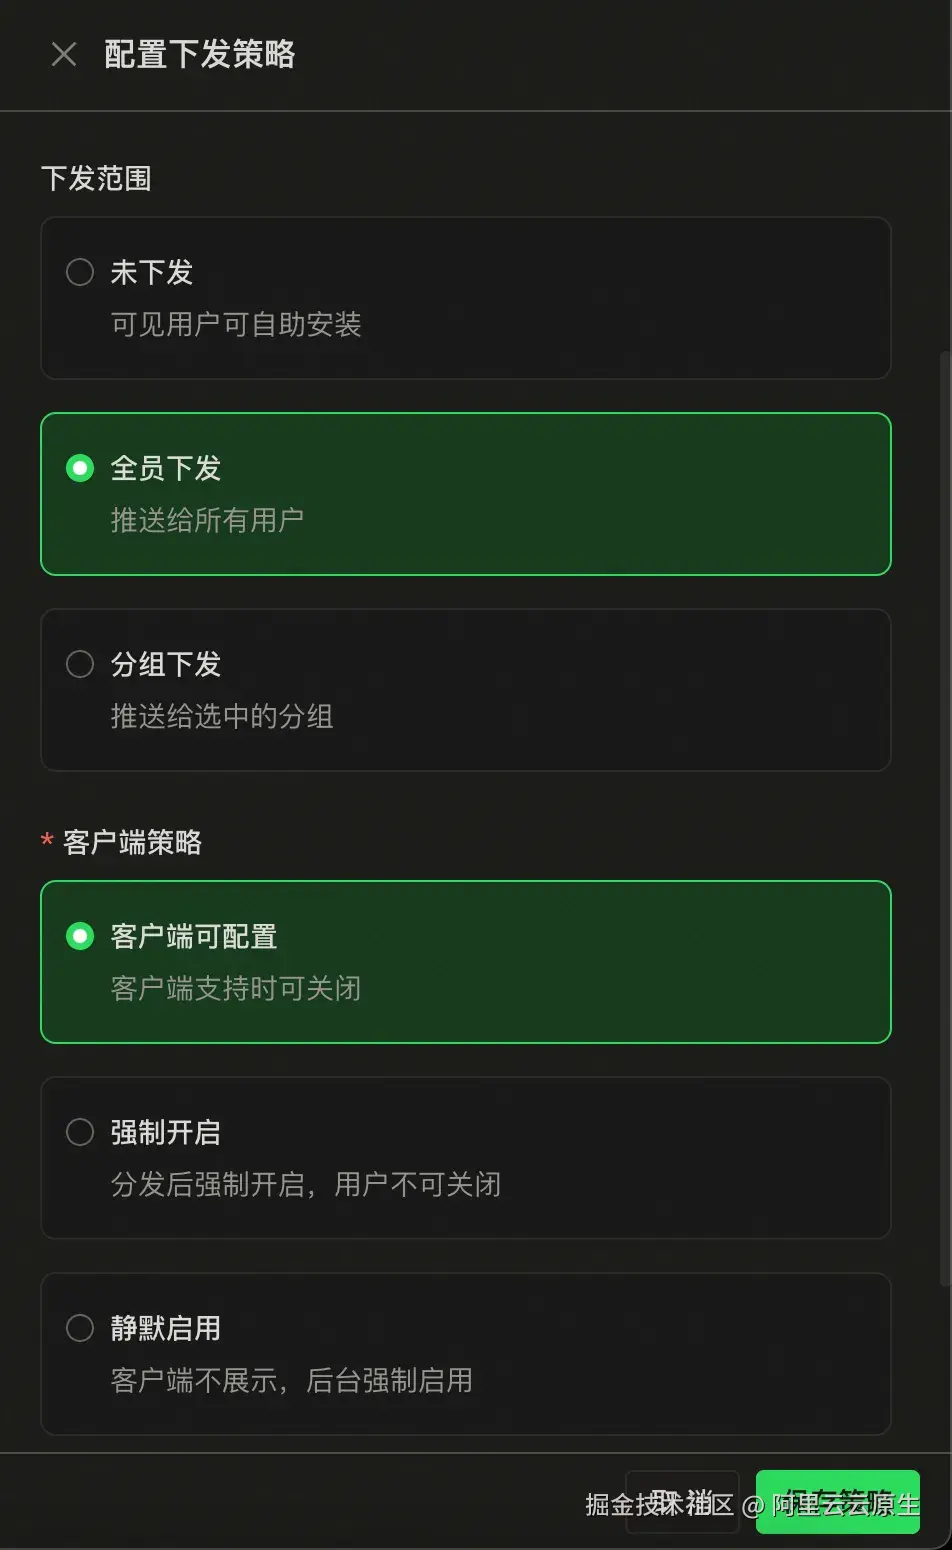
从自助到灰度、全量,再到沉为基线,每一步都可控。插件带版本号,内容操作里保留「版本历史」和「导出当前版本」,需要回退时直接切版本,不用惊动任何一位开发者。
一个实用提示:市场可见范围(集合级)与下发范围(内容级)是两个独立开关,配置时注意保持一致,避免成员收到了内容却在市场里搜不到。
▍第四步:验证安装
成员侧无需任何操作,下一次 Qoder 会话启动即自动安装。需要确认时,在成员机器上执行 loongsuite-pilot status 查看运行状态,或直接让数据在上报后端说话。
总结与展望
开头那两个前置条件,分别由链路上的两个组件承接。
数据归一化由 LoongSuite Pilot 完成。 它自动发现本机的 Agent,按各自的 Hook、插件或轮询机制完成接入,再把 20 种 Agent 的原生活动统一为一套对齐 GenAI 语义约定的事件 Schema------三级会话结构、分级 Token 与成本、首 Token 延迟、归一后的 Provider 取值,同一套字段语义支撑跨工具聚合。内容采集开关与输出前脱敏两层独立可控,采什么由组织自己定。
采集覆盖率由 loongsuite-pilot-installer 加 Qoder 企业专属市场完成。 插件在会话启动时做毫秒级检测,需要安装时在后台静默完成,自带 Node.js 运行时不碰开发者环境,靠存活探测保持进程运行,靠参数指纹把配置变更做成幂等覆盖安装。管理员在接入中心生成安装包、在市场配置一次下发范围与客户端策略,此后不需要任何一位开发者参与。
采集底座、自动触达、组织下发三层各解决一个问题,串联起来就是"管理员一次配置,全员自动生效","企业级的 AI Coding 用得怎么样"第一次可以用数据回答。
往后看,下发这件事不该被绑在某一个平台上。让它可迁移的是安装器本身------installer.sh 支持完全非交互式的带参安装,采集范围、脱敏策略、用户标识、上报地址都能在一条命令里固化。只要通道能把这条命令送到开发机上执行,就有希望成为下发通道。我们正在探索两个方向:
-
工具自带的企业级扩展分发。 本文的 Qoder 企业专属市场属于这一类,同类还有 Cursor、Trae 等 VS Code 系工具的企业版扩展分发、JetBrains 系的 IDE Services,以及 Claude Code、Codex CLI 的托管配置加 Hook。管理员不接触终端,但受限于工具方是否开放通道。
-
企业已有的命令下发通道。 云壳这类终端管理平台、MDM、Ansible / SaltStack 等配置管理工具,能力都是把一条命令下发到指定范围的机器上执行,把上面那条带参命令配成一次下发任务即可。不依赖工具方,也不挑 Agent,机器在管控范围内就能覆盖。
参考资料:
1 LoongSuite Pilot 项目仓库
2 输出事件 Schema
3 Agent 配置与内容采集策略
4 数据脱敏
5 新 Agent 接入指南
6 阿里云 AI 应用接入:AI Coding Agent
help.aliyun.com/zh/document...
7 AI Coding 审计概述
help.aliyun.com/zh/document...
8 Qoder 企业专属市场文档