2026-10-06·上下文工程·压缩策略
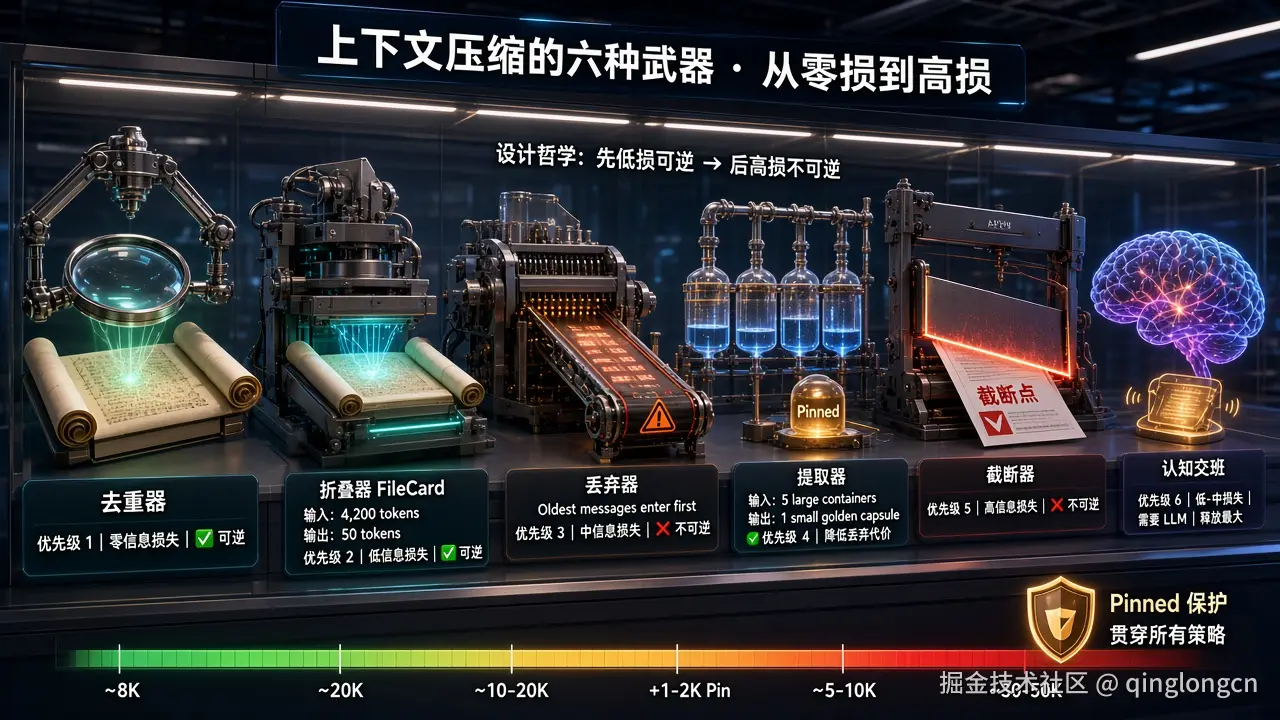
上下文满了需要压缩------但'压缩'不是一个动作,是六种不同策略按优先级执行。去重→折叠→按龄丢弃→截断------每种的信息损失不同、可逆性不同。这篇按'从低损到高损'的顺序详解每种策略,以及贯穿所有策略的 Pinned 保护机制。
"压缩"不是一个动作
你可能以为上下文压缩是"把旧消息摘要成一段话"------像 Claude Code 的 autocompact 或 Anthropic API 的 server-side compaction 那样。
但在一个真实的 Agent 引擎中,"压缩"是六种不同策略按优先级执行的管线。每种策略的信息损失、可逆性、触发条件完全不同。
从信息损失最低到最高排列:
| 优先级 | 策略 | 信息损失 | 可逆性 | 需要 LLM? |
|---|---|---|---|---|
| 1 | 工具结果去重 | 零 | ✅ | 否 |
| 2 | FileCard 折叠 | 低 | ✅ | 否 |
| 3 | 按年龄丢弃 | 中 | ❌ | 否 |
| 4 | 工具证据提取 | ---(降低丢弃代价) | --- | 否 |
| 5 | 内联截断 | 高 | ❌ | 否 |
| 6 | 认知交班 | 低-中(取决于模型质量) | ⚠️ | 是 |
设计哲学:先做低损可逆的操作,再做高损不可逆的操作。 去重和折叠就能释放足够空间时------不需要丢弃任何消息。
策略一:工具结果去重------零信息损失
问题
Agent 在重构任务中读了 auth.go 三次:第 10 轮读了一次(分析阶段)、第 25 轮读了一次(修改前确认)、第 38 轮读了一次(验证修改后的内容)。
三次 read 的结果都在上下文中------占用 ~12K token(3 × ~4K)。
解决
工具结果去重器扫描上下文中的所有 tool_result,如果同一个工具对同一个目标(同一文件/同一查询)有多次结果------只保留最新的那次。
bash
轮次 10: read("auth.go") → 350行完整代码    ~4,200 token  ← 被替换为引用
轮次 25: read("auth.go") → 350行完整代码    ~4,200 token  ← 被替换为引用
轮次 38: read("auth.go") → 352行完整代码    ~4,250 token  ← 保留(最新)
释放 ~8,400 token------零信息损失。 因为最新的读取结果包含了文件的当前状态,旧的读取结果的信息已经过时了。
关键约束
- Pinned 消息跳过------如果某次 read 结果被 Pin 保护了(比如上一轮结论引用了它),去重器不碰它
- 不同参数不算重复 ------
read("auth.go")和read("config.go")是两个不同的目标,不去重 - 整个 tool_use + tool_result 原子对一起处理------不会只删结果不删调用(否则模型看到"调了工具但没结果")
策略二:FileCard 折叠------可重生资源的核心概念
问题
去重后仍然有很多旧的工具结果------文件内容、搜索匹配、命令输出。它们不重复,但很多已经不是当前关注的焦点了。
解决
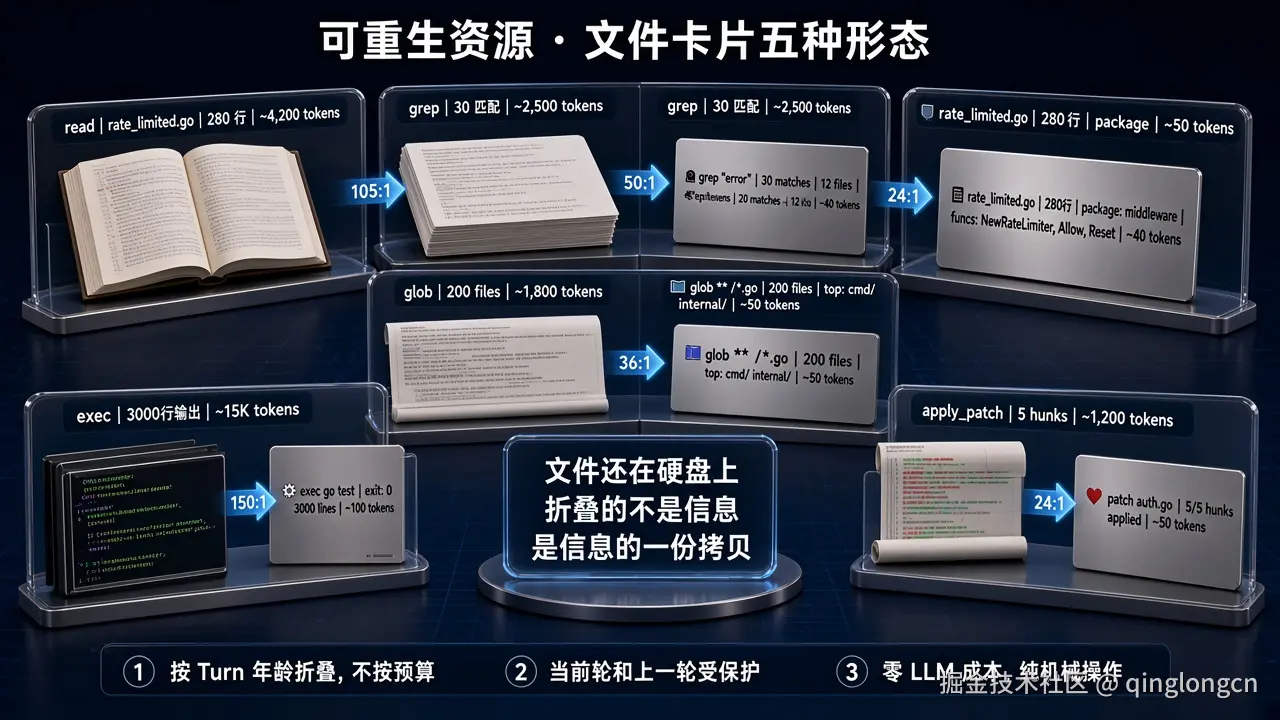
旧的工具结果从完整内容折叠为元数据卡片------保留"是什么",丢弃"具体内容":
bash
# 折叠前:完整 read 结果(~4,200 token)

tool_result: {
  tool: "read",
  path: "middleware/rate_limiter.go",
  content: "package middleware\n\nimport (\n  \"sync\"\n  \"time\"\n)\n\n
    type RateLimiter struct {\n  mu sync.Mutex\n  ..."  // 280 行完整代码
}

# 折叠后:文件卡片(~40 token)

tool_result: {
  tool: "read",
  path: "middleware/rate_limiter.go",
  content: "[file_card] rate_limiter.go | 280 lines | package: middleware |
    funcs: NewRateLimiter, Allow, Reset, Cleanup |
    imports: sync, time, net/http |
    last_read: 12 turns ago"
}
释放 ~4,160 token。 模型看到卡片后知道"我读过这个文件,它是一个限流器,有这些函数"。如果需要详细内容------用 read 工具重新读取。
"可重生资源"------设计出发点及其局限
FileCard 的最初设计出发点是:文件内容是可重生资源------文件还在磁盘上,随时可以重新读取。
这个出发点在一个前提下成立:折叠掉的内容模型不再需要了。 折叠丢掉的是一份拷贝,原始文件仍然在磁盘上。卡片只是一张"名片"------提醒模型"我见过这个人(文件),他的名字和职业(函数列表)是 X"。需要深度交流(查看具体代码)时重新读取。
但这个概念有一个隐含的轴错误------"可重生"回答的是 I/O 问题(磁盘上还有这份字节),而折叠要回答的是认知问题(模型正在用这份字节当知识)。
考虑这样一个场景:Agent 在审查合同,读了 5 份参考文件(每份 ~10KB)------写作指南、模板、法规、先例、术语表。这 5 份文件从第 1 轮用到第 85 轮,是贯穿整个任务的知识基础。按当前折叠规则,它们在几轮之后就会被折叠成卡片------模型必须不断重读,而重读又会把其他文件挤出去。
"磁盘上还在"不等于"可以安全折叠"。 这是一个仍在演进中的设计领域------后续的"工作集困境"章节会深入讨论。
五种卡片类型
| 原始工具 | 卡片类型 | 保留什么 | 丢弃什么 |
|---|---|---|---|
read |
file_card | 路径、行数、函数列表、包名 | 完整代码 |
grep |
grep_card | 查询词、匹配数、命中文件列表 | 完整匹配行 |
glob |
glob_card | 模式、文件数、截断的文件列表 | 完整文件路径列表 |
exec(长输出) |
exec_card | 命令、退出码、输出行数 | 完整 stdout/stderr |
apply_patch |
patch_card | 文件路径、应用/拒绝的 hunk 数 | diff 详情 |
结构索引------卡片不应只剩路径和行数
最初的 FileCard 设计有一个明显的信息缺口:代码文件折叠后保留了函数名列表(funcs: RunChat, buildRunRequest),但非代码文件折叠后除了路径和行数什么都没有。
想象一份 300 行的合同被折叠成卡片------模型只知道"合同.pdf,300 行"。它不知道里面有哪些条款,无法判断该不该重读、该读哪一段。
解决方案是在卡片中增加结构索引------介于全文和纯寻址信息之间的一层"目录":
| 文件类型 | 结构索引示例 | 不允许出现的内容 |
|---|---|---|
| Markdown | outline: # Overview / ## API / ## Testing |
正文段落 |
| 合同/法律 | outline: 第1条 定义 / 第3条 违约责任 / 第8条 保密 |
金额、日期、利率 |
| YAML/TOML | top_keys: name, version, dependencies(12) |
配置项的值 |
| JSON | top_keys: data, metadata, pagination |
字段值 |
| 代码 | 已有的 funcs: ...(无需额外处理) |
函数体 |
| 无结构文档 | 空(不猜测) | 任何内容 |
关键约束:结构索引 ≠ 内容摘要。
区分标准很简单------卡片上的任何文字,如果模型拿去当事实引用到输出里时可能是错的(因为是截断、节选、启发式提取),那就是"内容残体",不允许出现。标题行不会被误引为事实,金额会。 结构索引告诉模型"这里面有什么章节",让它决定该不该重读、重读哪一段------而不是给它"内容是什么"的虚假信息让它以为不用重读。
三条路径------文件读取结果(read/grep/glob)、命令输出(exec)、知识库搜索结果(kb_search/kb_open)------共享同一个结构索引提取函数。零 LLM 成本(纯正则/行扫描),对卡片的 token 开销增加约 20-40 token。
折叠规则
- 按 Turn 年龄折叠,不按预算------当前轮和上一轮的读取结果保持完整(模型可能还在引用它们),更旧的才折叠
- 当前 Turn 受保护------正在使用的工具结果不能被折叠
- 零 LLM 成本------折叠是纯机械操作(提取元数据 + 格式化 + 结构索引),不需要 LLM 调用
- 不写回存储------折叠只影响当前 LLM 调用的输入,不修改持久化的消息历史。下次加载时仍然是完整内容
策略三:按年龄丢弃------开始不可逆
问题
去重和折叠做完了,上下文仍然超限。剩下的都是"真正的对话历史"------用户的消息、Agent 的回复、关键的工具结果。
解决
按消息年龄从旧到新丢弃------最旧的非 Pinned 消息最先被删除。
bash
消息列表(时间从旧到新):
  msg-1: user "帮我分析这个模块"           ← 可丢弃(最旧)
  msg-2: assistant "我来看看..."           ← 可丢弃
  msg-3: tool_result(read auth.go)         ← 可丢弃(已有 FileCard)
  msg-4: assistant "分析结果是..."         ← 可丢弃
  ...
  msg-45: assistant "上一轮的结论"         ← Pinned ❌ 不能丢
  msg-46: user "继续"                      ← 当前轮 ❌ 不能丢
  msg-47: tool_result(exec go build)       ← 当前轮 ❌ 不能丢
丢弃顺序:从 msg-1 开始,逐条删除,直到上下文降到预算以内。 Pinned 消息和当前轮消息被跳过。
信息损失
按年龄丢弃是不可逆的------被删除的对话历史无法恢复。
模型在后续轮次中不知道第 1-4 轮讨论了什么------只知道"有一些较早的消息被省略了"(因为引擎插入了占位符)。
工作集困境------当"按年龄"的轴也是错的
按年龄丢弃的隐含假设是"旧的不如新的重要"。这在大部分对话中成立------但在知识密集型任务中,这个假设会系统性地失败。
场景:Agent 审查 5 份参考文件(写作指南、法规、模板、先例、术语表),每轮依次读取。文件折叠的名额是最近 3 个包含文件读取的轮次------
bash
轮次 1: read(写作指南)        ← 第 4 轮时被折叠成卡片
轮次 2: read(法规)             ← 第 5 轮时被折叠
轮次 3: read(模板)             ← 第 6 轮时被折叠
轮次 4: read(先例)             ← 此时写作指南已经不在上下文了
轮次 5: read(术语表)           ← 此时法规也不在了
轮次 6: Agent 开始写作------发现写作指南没了,重新读
轮次 7: 写作指南回来了------但先例被挤出去了
...
这个循环在工作集(需要同时参考的文件数 N)大于折叠名额时数学上不可能收敛。模型不断重读文件 A,把文件 B 挤出去;下一轮需要 B,重读 B 又把 A 挤出去。
这不是循环检测器能解决的问题------因为每次重读的参数都不同(交替读 A、B),检测器看到的是"有进展"。它也不是"调大名额"能解决的------那只是把阈值推迟,轴没变。
根本问题是:"可重生"回答的是"能不能再读到",而折叠要回答的是"这份知识模型还需要吗"。 前者恒为真(磁盘上还在),后者取决于任务------写作指南从第 1 轮用到第 85 轮。用一个恒为真的条件做折叠判据,等于无条件折叠。
这是一个仍在演进的设计问题。可能的方向包括:让模型主动"沉淀"知识(把关键理解写进记忆,折叠时用理解替代全文)、区分"可变源码"和"只读知识"两种文件类别,或者在预算允许时干脆不折叠知识文件。
策略四:工具证据提取------降低丢弃的代价
问题
按年龄丢弃会丢掉关键信息------"我编辑了 auth.go 的第 45 行""测试 TestLogin 通过了"。这些是"Agent 做过什么"的事实记录。
解决
丢弃前从即将被删除的消息中提取"已完成操作摘要",作为 Pinned 消息保留:
bash
即将被丢弃的 5 条消息:
  edit(auth.go, line 45-60)
  exec(go build) → success
  exec(go test ./auth/...) → PASS (3 tests)
  read(config.go)
  edit(config.go, line 12)

提取的工具证据(Pinned,~200 token):
  "[tool_evidence] 已完成操作:
   - 编辑了 auth.go 第 45-60 行
   - 编译通过
   - auth 包 3 个测试全部通过
   - 编辑了 config.go 第 12 行"
5 条消息(~6K token)被丢弃,但"做过什么"的事实以 200 token 的形式保留。 模型在后续轮次中知道"我改过 auth.go 和 config.go,测试通过了"------虽然不知道改了什么具体代码。
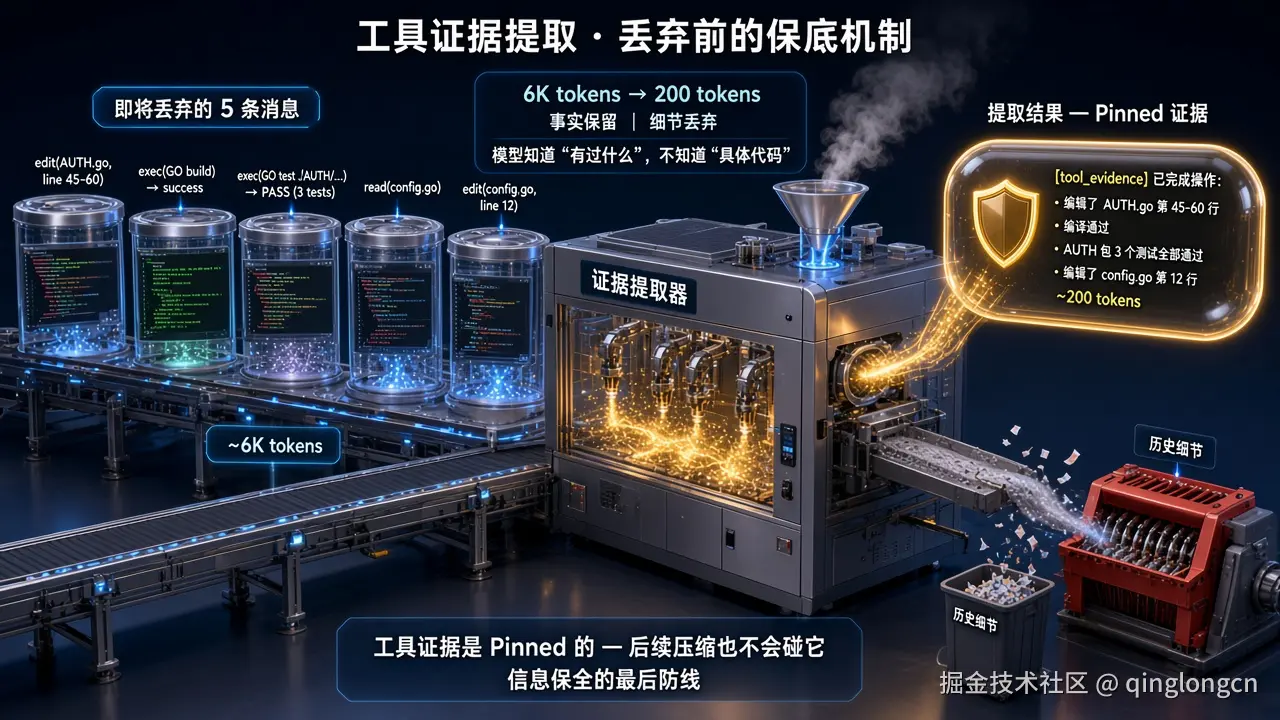
工具证据是 Pinned 的------后续的压缩也不会碰它。它是"信息保全的最后防线"。
策略五:内联截断------最后手段
问题
丢弃了旧消息、提取了工具证据------上下文仍然超限。通常是因为某条消息本身就特别长(用户粘贴了一段 50K 的代码、exec 输出了一段巨长的日志)。
解决
把超长消息的内容截断到上限------保留前 N 个字符,丢弃剩余部分,追加 [truncated: 原始 X 字符,保留 Y 字符] 标记。
bash
# 截断前(~15K token)

tool_result: {
  tool: "exec",
  content: "=== RUN   TestAll\n--- PASS: TestLogin (0.01s)\n
    --- PASS: TestLogout (0.02s)\n..."  // 3000 行测试输出
}

# 截断后(~2K token)

tool_result: {
  tool: "exec",
  content: "=== RUN   TestAll\n--- PASS: TestLogin (0.01s)\n
    --- PASS: TestLogout (0.02s)\n... [truncated: 原始 15,234 tokens,保留 2,000 tokens]"
}内联截断是最后手段------信息永久丢失且不可恢复。Pinned 消息不被截断。
策略六:认知交班------用 LLM 做信息精炼
与前五种的本质区别
前五种策略都是机械操作------去重用 hash 比较、折叠用元数据提取、丢弃按年龄排序、截断按字符计数。它们不理解内容的语义------不知道"这条消息对任务是否重要"。
认知交班(MidRunHandoff)是唯一使用 LLM 的压缩策略------让主对话模型对完整历史产出一个工作记忆快照。
工作方式
bash
输入:完整的对话历史(可能 60-80K token)
操作:一次 LLM 调用(主对话模型,30 秒超时,无重试)
输出:工作记忆快照(~1-2K token,Pinned)

快照内容(概念描述):
  "当前任务:重构 auth 模块的认证逻辑
   已完成:
   - 分析了 15 个 DAO 文件,发现 12 个有 SQL 注入风险
   - 设计了 Repository 接口(选了 Repository 模式因为已有 BaseDAO)
   - 迁移了 UserDAO 和 OrderDAO
   关键决策:
   - SQL 注入修复纳入各 DAO 迁移步骤
   下一步:
   - 迁移 CacheDAO(注意它有自定义连接池)"

交班后上下文:
  [系统提示 ~12K] + [快照 ~1.5K (Pinned)] + [最近 5 轮 ~15K]
  总计 ~28K(从 80K 压到 28K,释放 ~52K)
为什么交班排在最高优先级
虽然交班按"信息损失"排第六------但在管线中它的触发优先级最高(70% Pressure 就触发,早于机械压缩的 85%)。
原因:一次成功的交班释放的空间远超所有机械策略的总和。 52K 的释放量 vs 去重(~8K)+ 折叠(~20K)+ 丢弃(~10-20K)。而且交班产出的快照是语义层面的精炼------不是机械地丢信息,是把"60K 的过程细节"浓缩成"1.5K 的关键结论"。
交班失败的降级
交班可能失败:模型超时(30 秒)、返回格式错误、当前在 cooldown 期间(上一次交班刚完成不久)。
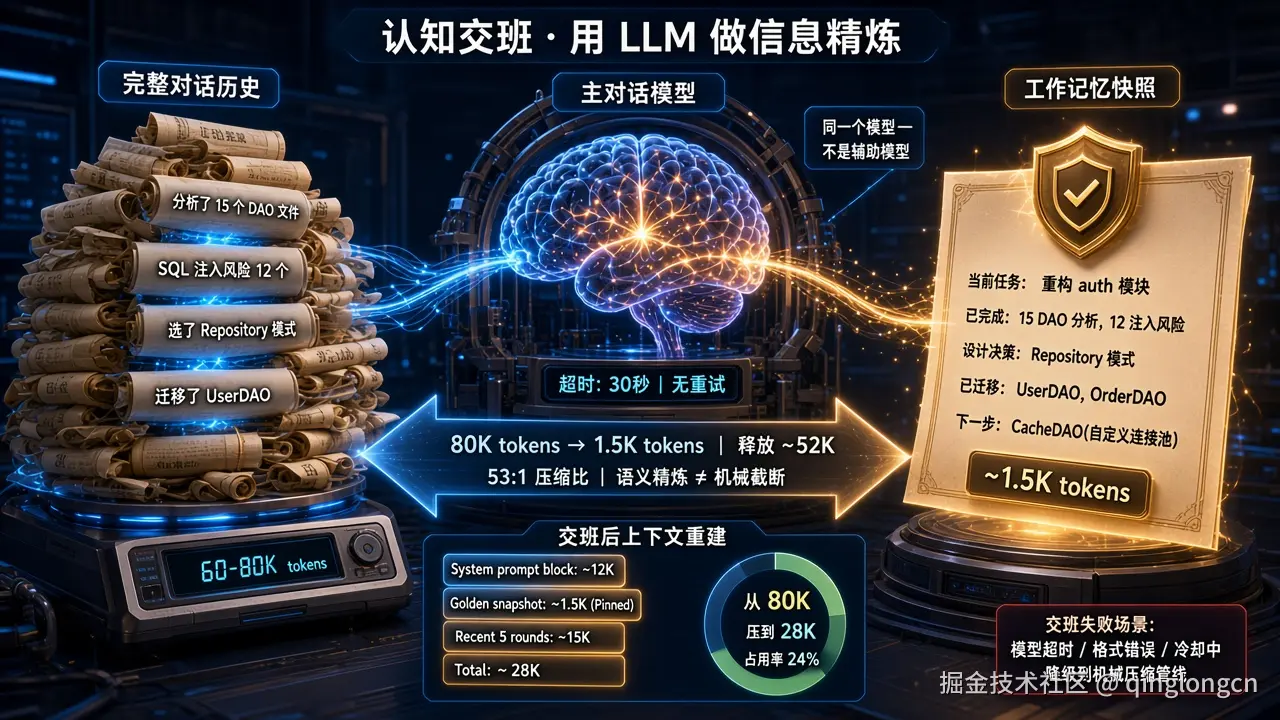
失败后降级到机械压缩管线------从策略一(去重)开始,按优先级依次执行,直到上下文降到预算以内。
贯穿所有策略的保护机制:Pinned
Pinned 是什么
Pinned=true 标记的消息不参与任何压缩策略------无论是去重、折叠、丢弃还是截断,Pinned 消息始终完整保留。
什么消息会被 Pin
| 来源 | Pin 时机 | 内容 |
|---|---|---|
| 上一轮结论 | Stage 3 窗口修剪前 | Agent 的上一轮最终回复 |
| 工具证据 | 策略四丢弃前 | "已完成操作"的事实摘要 |
| 认知交班快照 | 策略六交班完成后 | 工作记忆快照 |
| 手动 Pin | 应用层显式标记 | 应用认为重要的消息 |
Pin 保护的审计
所有 12 种压缩相关操作都必须检查 Pinned 标记------包括主管线中的 6 种策略、Safety-net 预压缩、Emergency 紧急裁剪、Loop 内的工具结果精简等。
每种操作的 Pinned 检查机制:
bash
FileCardStrategy:         if msg.Pinned { 跳过,保留完整内容 }
AgeBasedCompact:          if msg.Pinned { continue }
DropOldestStrategy:       Pinned 归入不可丢弃组
InlineTruncateStrategy:   if msg.Pinned { continue }
ToolResultDeduplicator:   Phase 1 收集时 if msg.Pinned { continue }
EmergencyStrategy:        Pinned 归入不可丢弃组
Safety-net 预压缩:        内部使用 AgeBased + DropOldest(均尊重 Pinned)
Loop emergencyPrune:      Pinned group 整体保留
一种操作漏了 Pinned 检查------上一轮结论就可能被压缩掉。 Agent 在新一轮不知道自己上次说了什么。这不是"体验变差"------是"功能错误"。
行业对比
| 维度 | Anthropic compaction | Claude Code | 我们的管线 |
|---|---|---|---|
| 策略数 | 1(摘要) | 1(autocompact) + hooks | 6(分级管线) |
| 排序 | --- | --- | 低损→高损 |
| FileCard | 无 | 无 | ✅ 结构索引卡片 |
| Pinned 保护 | 无显式 | 无显式 | ✅ 12 操作全审计 |
| 工具证据保底 | 无 | 无 | ✅ 丢弃前提取 |
| 认知交班 | 摘要 ≈ 交班 | autocompact ≈ 摘要 | ✅ 独立于机械管线 |
| 需要 LLM | 是(摘要) | 是(autocompact) | 5/6 策略不需要 |
大多数框架把压缩等同于"LLM 摘要"。 我们把 LLM 摘要(认知交班)作为最后一环------前五种纯机械策略已经能处理大部分场景,零 LLM 成本。只有机械策略不够时才动用 LLM。
你现在能做什么
1. 压缩前先去重。 检查上下文中有没有同一文件被读了多次------只保留最新的。这是零损失的释放,没有理由不做。
2. 旧的工具结果折叠为元数据卡片。 保留文件名、函数列表、结构索引------丢弃完整代码。但注意折叠时机的判断:"可重生"不等于"可安全折叠"------模型正在持续引用的知识文件不应该仅因为"年龄旧"就被折叠。
3. 丢弃消息前先提取"做过什么"的事实。 一段 200 token 的"已完成操作摘要"比 6K 的对话细节便宜得多------但信息保全效果差距不大。
4. 所有压缩操作都要检查 Pin 保护。 上一轮结论是 Pin 的------永远不碰。如果你在实现压缩------加一行 if msg.Pinned { continue }。漏了这一行的代价是"Agent 忘了上次说什么"。
5. LLM 摘要是最后手段,不是默认操作。 机械策略(去重 + 折叠 + 丢弃)能处理 80% 的压缩需求,零 LLM 成本。只有前五种都不够时才用 LLM 做认知交班。
引用来源
- Anthropic Claude Cookbook, "Context engineering: memory, compaction, and tool clearing" --- server-side compaction
- Claude Code 官方文档 --- autocompact + PreCompact/PostCompact hooks
- IBM Granite Agent Cookbook, "Context Management" --- Pruning + Note-Taking 策略
- Cursor Blog, "Training Composer for longer horizons" (Mar 2026) --- lossy compression + RL 训练