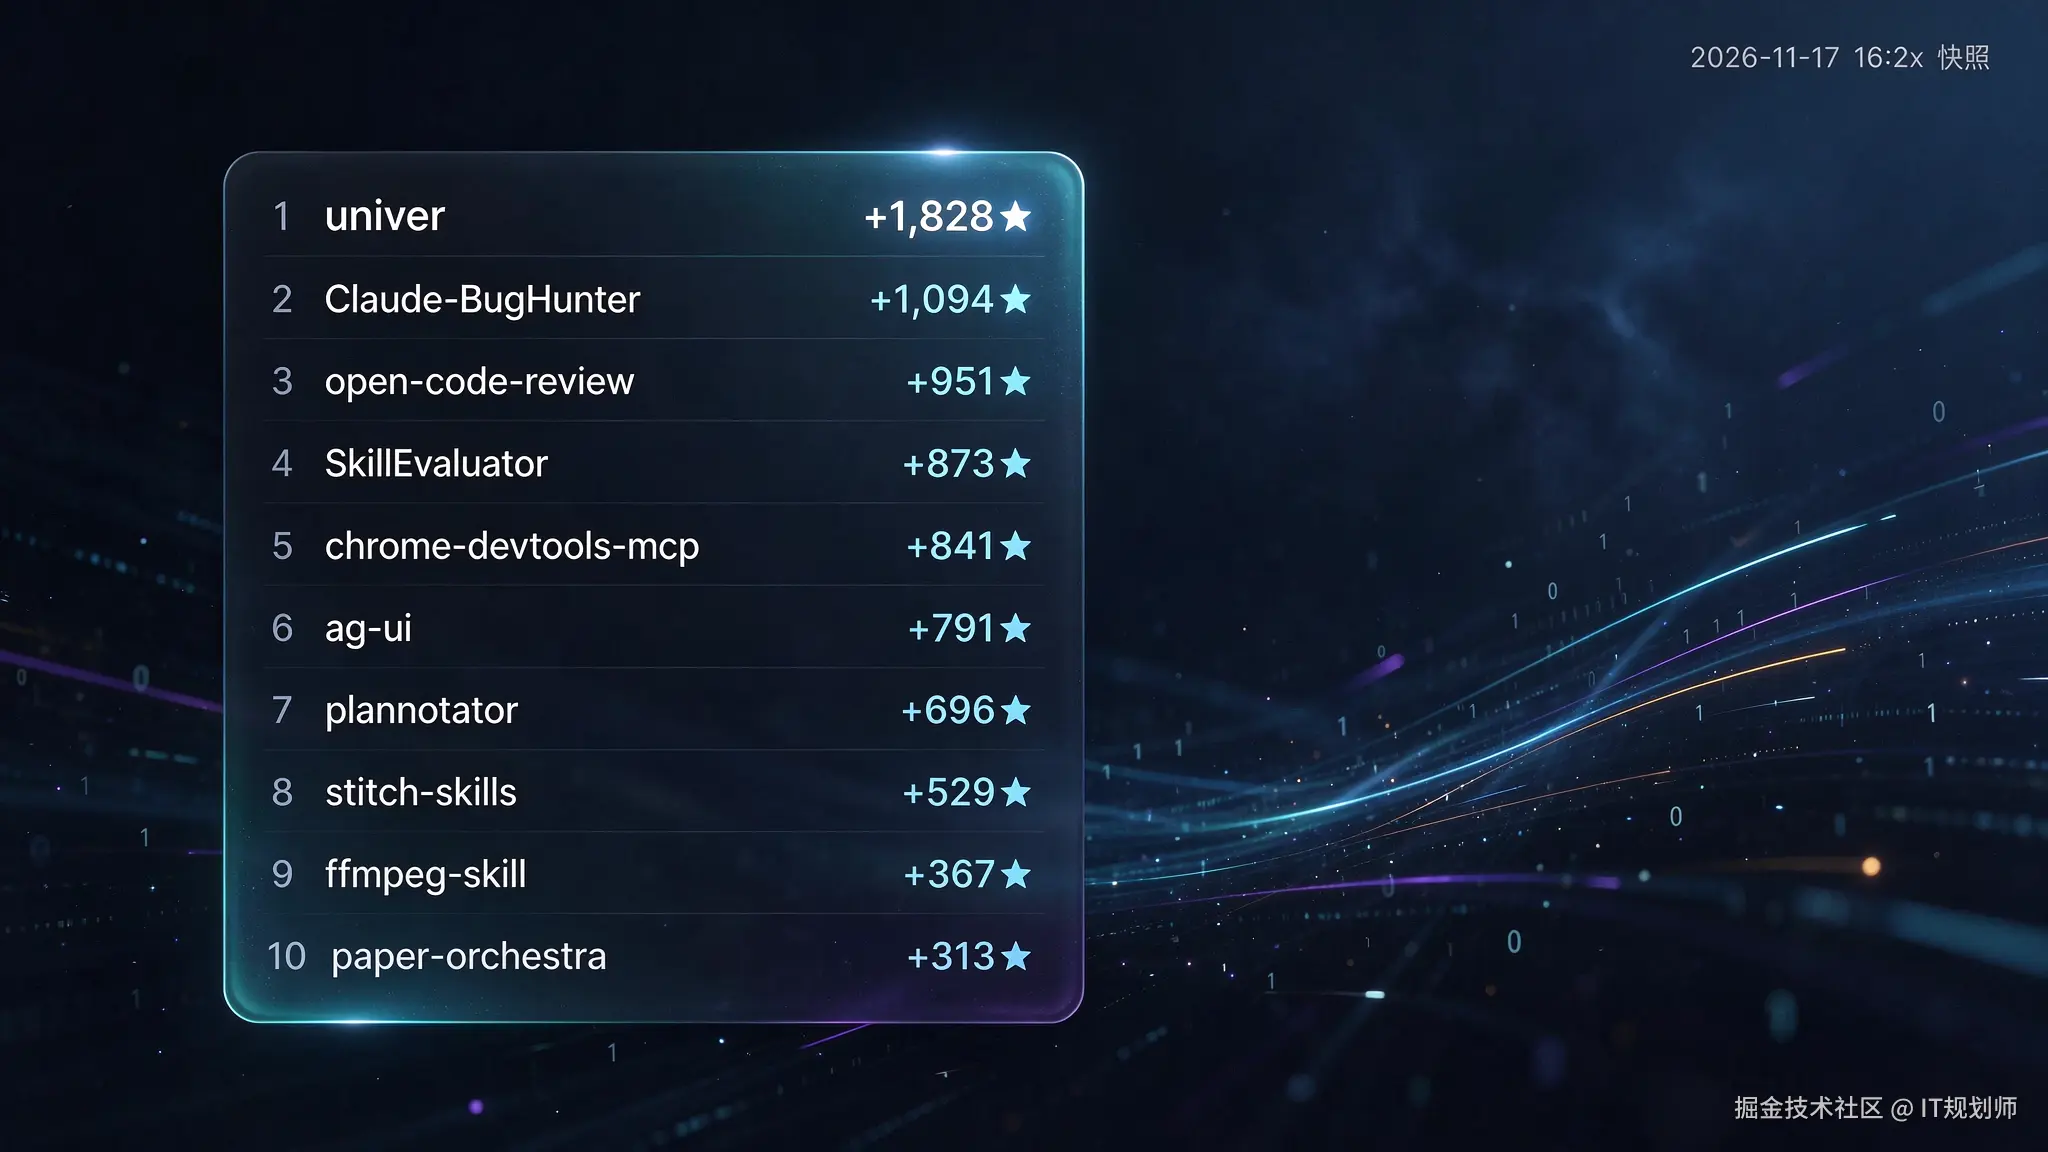
2026-11-17 的 GitHub Trending 当日榜,快照时间是下午 16:2x。当天增速最前的十个项目,新增 star 合计 8,283★(按各条当日增量逐条相加)。
排在最前面的是 dream-num/univer,一个 AI Office SDK,当日 +1,828★。
紧随其后的三个都冲着 Agent 去。Claude-BugHunter +1,094★、open-code-review +951★、SkillEvaluator +873★。
其余六项里,有五条直接冲着 Agent、skills、MCP 这几个词去,只有一条是工具层。
这份榜来自官方页实时抓取,硬指标是当日 star 增量
素材取自 GitHub Trending 官方页的实时抓取,不是二手转述,视图是 daily。当天榜里唯一能量化的硬指标,就是各项目的当日 star 增量。
素材给出的热度评分是 94/100,拆开是时效 30、权威 25、契合 25、互动 14。这是素材自己的口径,不是 GitHub 官方评级,引用时别混。
所以对你意味着:想判断一个项目「现在火不火」,看 star 增量。想判断它「解决了什么」,只能回仓库看 README。
十项增速里,藏着一个共同方向
素材给出的主线是:「给 Agent 提供可复用技能、可审查工作区与可量化质量评估」。
我的读法更直白一点:Agent 的下一个战场不是更强的模型,是产出怎么验。
一条条对得上。Claude-BugHunter 把经验做成可复用的技能包,SkillEvaluator 给技能包配评估尺。plannotator 提供可批注的审阅台。
三件事指向同一处:Agent 干完活之后,谁来验、验得准不准、上次那份经验下次还在不在。
所以对你意味着:挑 Agent 工具时,关注点可以从「它会不会做」挪到「它做完你验不验得动」。
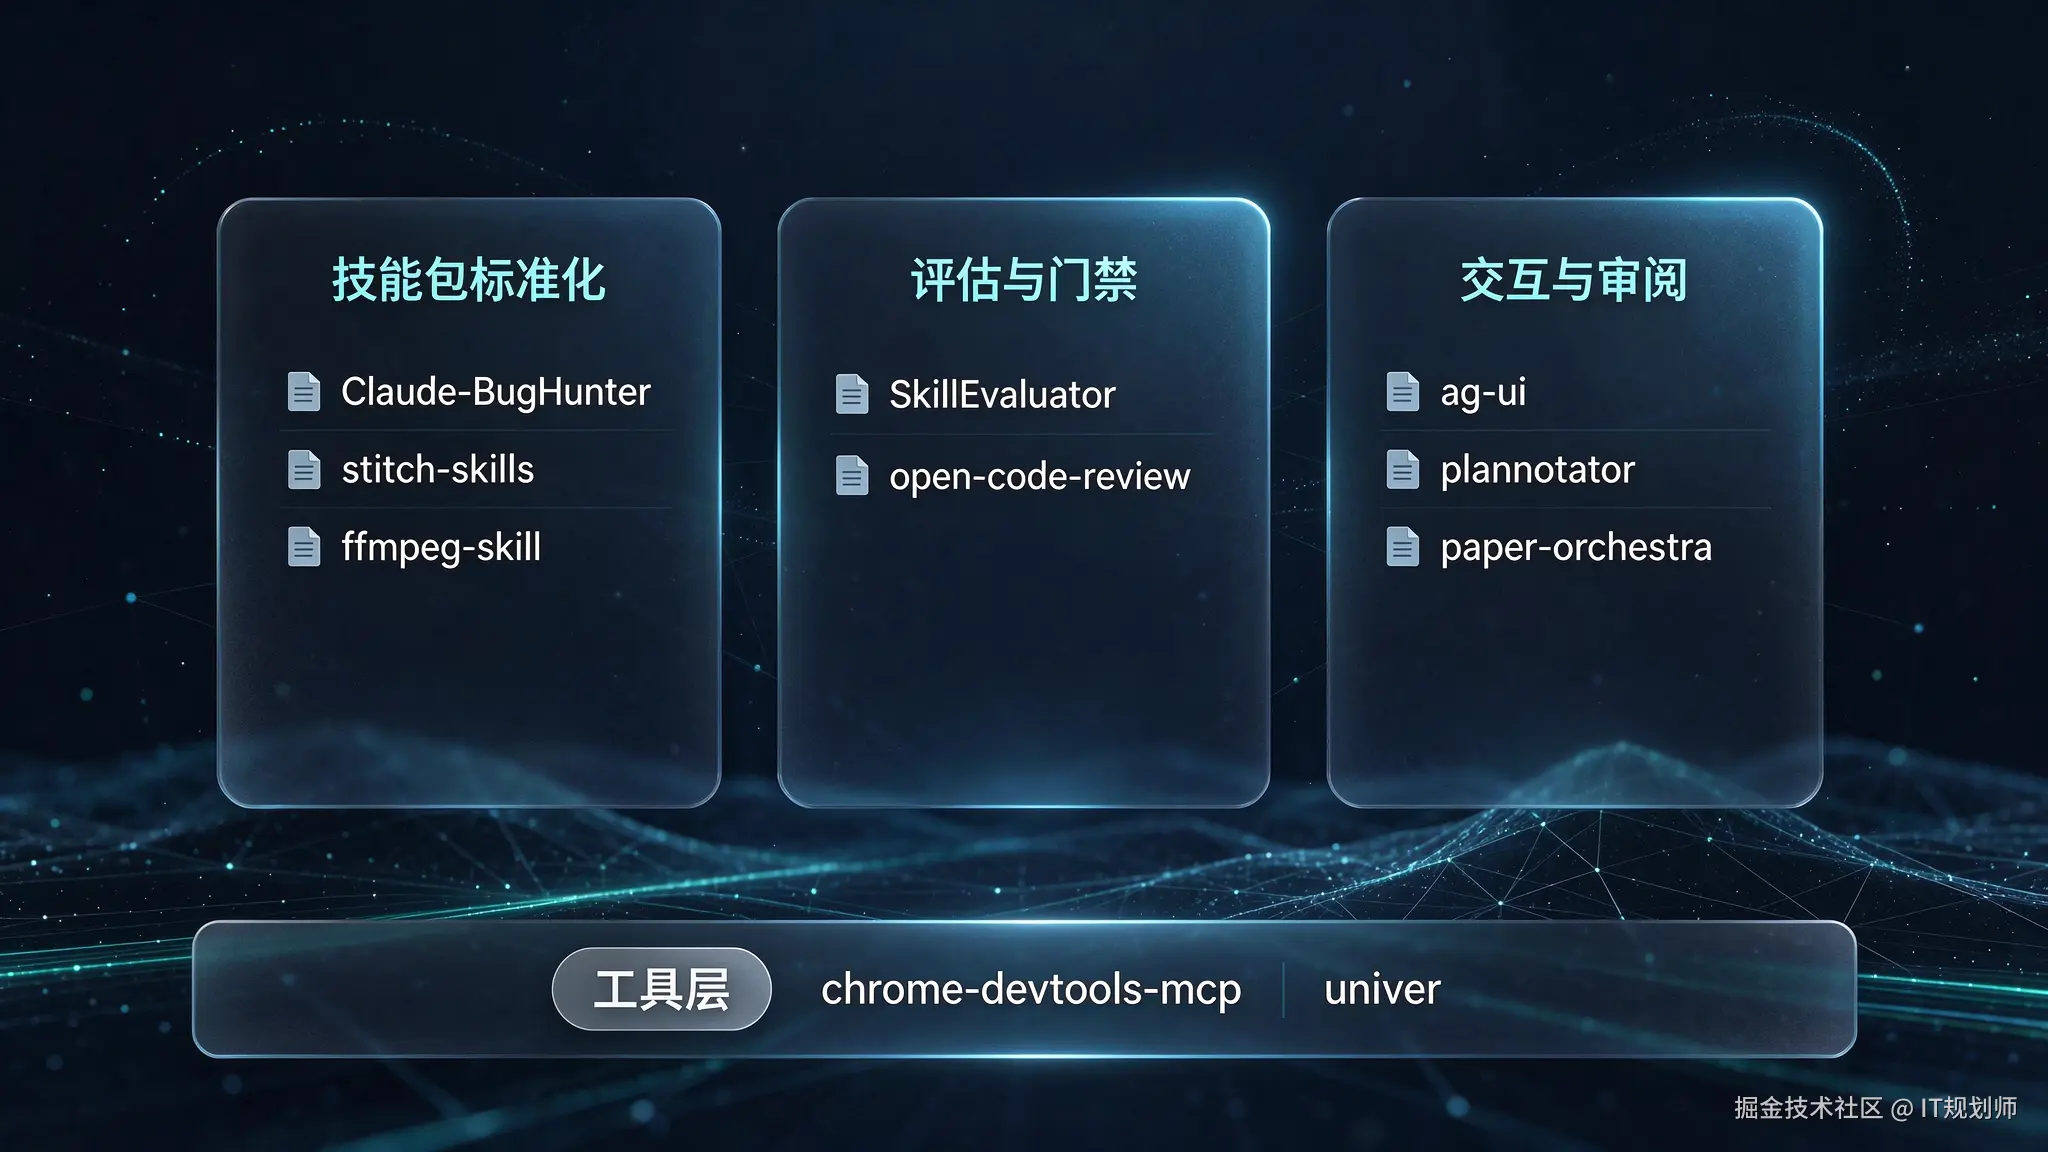
三条线拆开看,各自补的是哪一环
第一条,技能包标准化。 Claude-BugHunter(+1,094★)把 82 个 skills、15 条 slash command 装进一个包,覆盖 24 类漏洞模式。
stitch-skills(+529★)走的是 Agent Skills 开放标准。ffmpeg-skill(+367★)是本地 FFmpeg 工具契约加 MCP。
三者的共同点,是把一次性的经验固化成能反复加载的单元。
第二条,评估与门禁。 SkillEvaluator(+873★)做多层级 Agent 技能评估与质量门禁。open-code-review(+951★)把确定性流水线和 LLM Agent 混在一起做代码审查。
从定位上看,一个管技能本身合不合格,一个管这次改动合不合格。
第三条,交互与审阅。 ag-ui(+791★)是 Agent-User 交互协议。plannotator(+696★)是可批注的 Agent 审阅台。paper-orchestra(+313★)是多 Agent 协作写论文。
这三项解决的是人和 Agent 怎么对齐。
三条线加起来是十条里的八条。剩下两项在工具层。chrome-devtools-mcp(+841★),素材只给了仓库名和增量,没附说明。榜首 univer 也不直接落在三条线上。
这里的「验收」是广义的:产出能复用、能审查、能评估。这两项服务的是同一条链的前半段:Agent 先得能动手,才谈得上干完被验。
所以对你意味着:榜上看着杂,其实只有三种位置------给 Agent 装工具、给 Agent 装验收、给人和 Agent 装接口。卡住你的一般是第二种。
榜首是套 Office SDK,这个反差值得停一下
univer 以 1,828★ 排第一,身份是 AI Office SDK,比所有 Agent 基础设施条目都高。
榜单的叙事是 Agent 工具链,增量第一的却是一家做文档与表格的项目。
从定位上看,落地最实的地方是有明确产出物、别人一分钟能验完的场景------一份表、一页文档,好坏当场看得见。
这是个判断,可以被反驳:如果 Agent 的价值主要在「帮着想一想」,那 Office SDK 不该排第一。可它排了。
所以对你意味着:如果你正在给团队搭 Agent 工具链,先问一句------我的产出物,别人能一分钟验完吗?验不完就先解决验收。
三个值得今天点开的项目
elementalsouls/Claude-BugHunter(+1,094★):把漏洞排查经验做成技能包。 素材给的说明是 82 个 skills、15 条 slash command、24 类漏洞模式。
数字都在这,真正要看的是怎么切分:通用规则,还是绑定了具体语言和目录。
可执行动作:挑其中一个 skills,看它能不能直接放进你自己项目的 Agent 上下文里用。
NVIDIA/SkillEvaluator(+873★):给技能包装一把尺子。 定位是多层级 Agent 技能评估与质量门禁。只要你有了技能包,就一定有「哪个更好」的问题,多层级评估对应的就是不同粒度下的合格线。
可执行动作:如果你已经在维护自己的 skills,先把「合格」用什么指标定义写下来。这是装评估器之前就得想清楚的事。
alibaba/open-code-review(+951★):确定性流水线和 LLM Agent 混用做代码审查。 从定位上看,让确定性的部分和 Agent 的部分出现在同一条流程里,是这个项目最值得看的地方。
可执行动作:翻一次团队真实的人工 review 记录,标出哪几步是每次都必须做的。那几步就是流水线的位置。
所以对你意味着:这三个项目都在回答同一个问题的不同侧面------你的 Agent 做得对不对,凭什么说了算。
不装它们,也能先做的三件事
以下是建议的验证路径,不是这些项目的官方步骤。
-
列出你每次都要给 Agent 重讲一遍的规则,标上哪些每次都要、哪些偶尔才用。这一步不需要任何仓库,就能看出你要的是 skills 还是一份普通文档。
-
给上一批 Agent 产出的改动人工打分,哪怕只有三项:漏了什么、改错了什么、能不能读懂。这三项定义了「合格」,也就定义了你之后需要的评估器长什么样。
-
挑一条你现在重复最烦的检查,写成一条命令加一份说明。这是 skill 的最小形态,也是最容易被验证的形态。
所以对你意味着:上面三条都不依赖任何仓库,今天就能做完。
谁该看,谁别看
该看:你在给团队搭 Agent 工具链,或者已经在维护 skills 和 Agent 配置,正被「怎么判断这套东西好不好用」卡住的人。
别看两种情况。一种是想找个现成插件装上的。这十个项目解决的是流程问题,装完插件不会自动把流程理顺。
另一种是打算按 star 数挑项目的。单日增量测的是曝光,不是质量。
素材没提供仓库清单、安装方式和 benchmark,细节以各仓库 README 为准。
如果今天只点开一个,我选 open-code-review(+951★)。理由是审查这一环现在就能接进已有流程,不必等技能标准落地。
所以对你意味着:这份榜的价值不在推荐谁,而在它列出了一个共同方向------可复用、可审查、可评估。这三个词基本是眼下 Agent 工程化里最吵的三件事。
你给 Agent 定的「合格」,是用什么指标写的?
信息卡
- 榜单:GitHub Trending(daily 视图),2026-11-17 当日榜,16:2x 快照
- 链接:github.com/trending?si...
- 入榜项目(当日 star 增量):dream-num/univer +1,828★、elementalsouls/Claude-BugHunter +1,094★、alibaba/open-code-review +951★、NVIDIA/SkillEvaluator +873★、ChromeDevTools/chrome-devtools-mcp +841★、ag-ui-protocol/ag-ui +791★、backnotprop/plannotator +696★、google-labs-code/stitch-skills +529★、kajisho5/ffmpeg-skill +367★、google-research/paper-orchestra +313★
- 素材热度评分:94/100(素材口径:时效 30 + 权威 25 + 契合 25 + 互动 14)
- 标签:#GitHub #开源 #Agent #Skills #Agent工程化