关于 AI 原生大数据服务
AI 原生大数据服务致力于将智能体(Agent)技术与大数据、AI 引擎深度融合,为企业提供新一代数据生产力平台。通过自然语言交互,ADA 帮助企业高效完成复杂的大数据任务,加速数据决策。
在 ADA 中,MaxCompute、Hologres、Flink、EMR、DataWorks 等底层引擎的 Agent 能力可实现多智能体协同。平台提供对话式数据分析、智能体管理、知识管理、自动化任务等核心功能,全面释放企业数据价值。
核心架构与三大特性
-
多智能体协同编排:以 Ada 作为主智能体(Master Agent),负责意图理解、任务路由与自动协同,无缝调度底层各引擎的专业 Agent,完成跨引擎的复杂数据交付。
-
企业级知识引擎:内置与 DataWorks 同源的语义图谱能力,将企业的数据资产、业务语义与分析经验沉淀为统一的认知中枢。
-
高自由度自定义 Agent:支持低代码与高代码双模式,企业可灵活接入主流 Agent 引擎,构建契合自身业务场景的专属智能体。
业务场景说明
典型业务场景 运营团队常需解答此类问题:"最近 7 天各区域的订单量及环比变化如何?哪个区域波动最大?可能原因是什么?"
传统痛点 运营提交取数需求 ➔ 数据团队排期、写 SQL、导数据 ➔ 结论返回时往往错过最佳决策时机;若想增加分析维度,需重新提需,沟通与时间成本极高。
解决方案 本教程将以此场景贯穿全流程。为快速验证,我们采用"最简路径"------直接上传一份订单明细表格(无需前置接入)。完成后,您将在同一会话中获得订单明细、环比对比与归因线索,且每一步的计算逻辑与中间结果均可展开核对。整个主线操作约 10 分钟即可跑通。
方案架构
核心操作分为两个并列入口:
-
门户控制台:负责服务开通、版本订阅与用量管理。
-
AdaWorks 工作台:负责数据接入、对话执行与结果查看。
注:数据接入方式在工作台内灵活切换,不影响后续对话步骤。
实施步骤
主线分为五步:确认服务可用 ➔ 接入数据 ➔ 发起分析并核对 ➔ 追问定位问题 ➔ 固化为每日报告。每步均设有"完成标志",助您判断是否可进入下一环节。
步骤一:确认服务可用
目标:确认账号权限并选定操作地域。
-
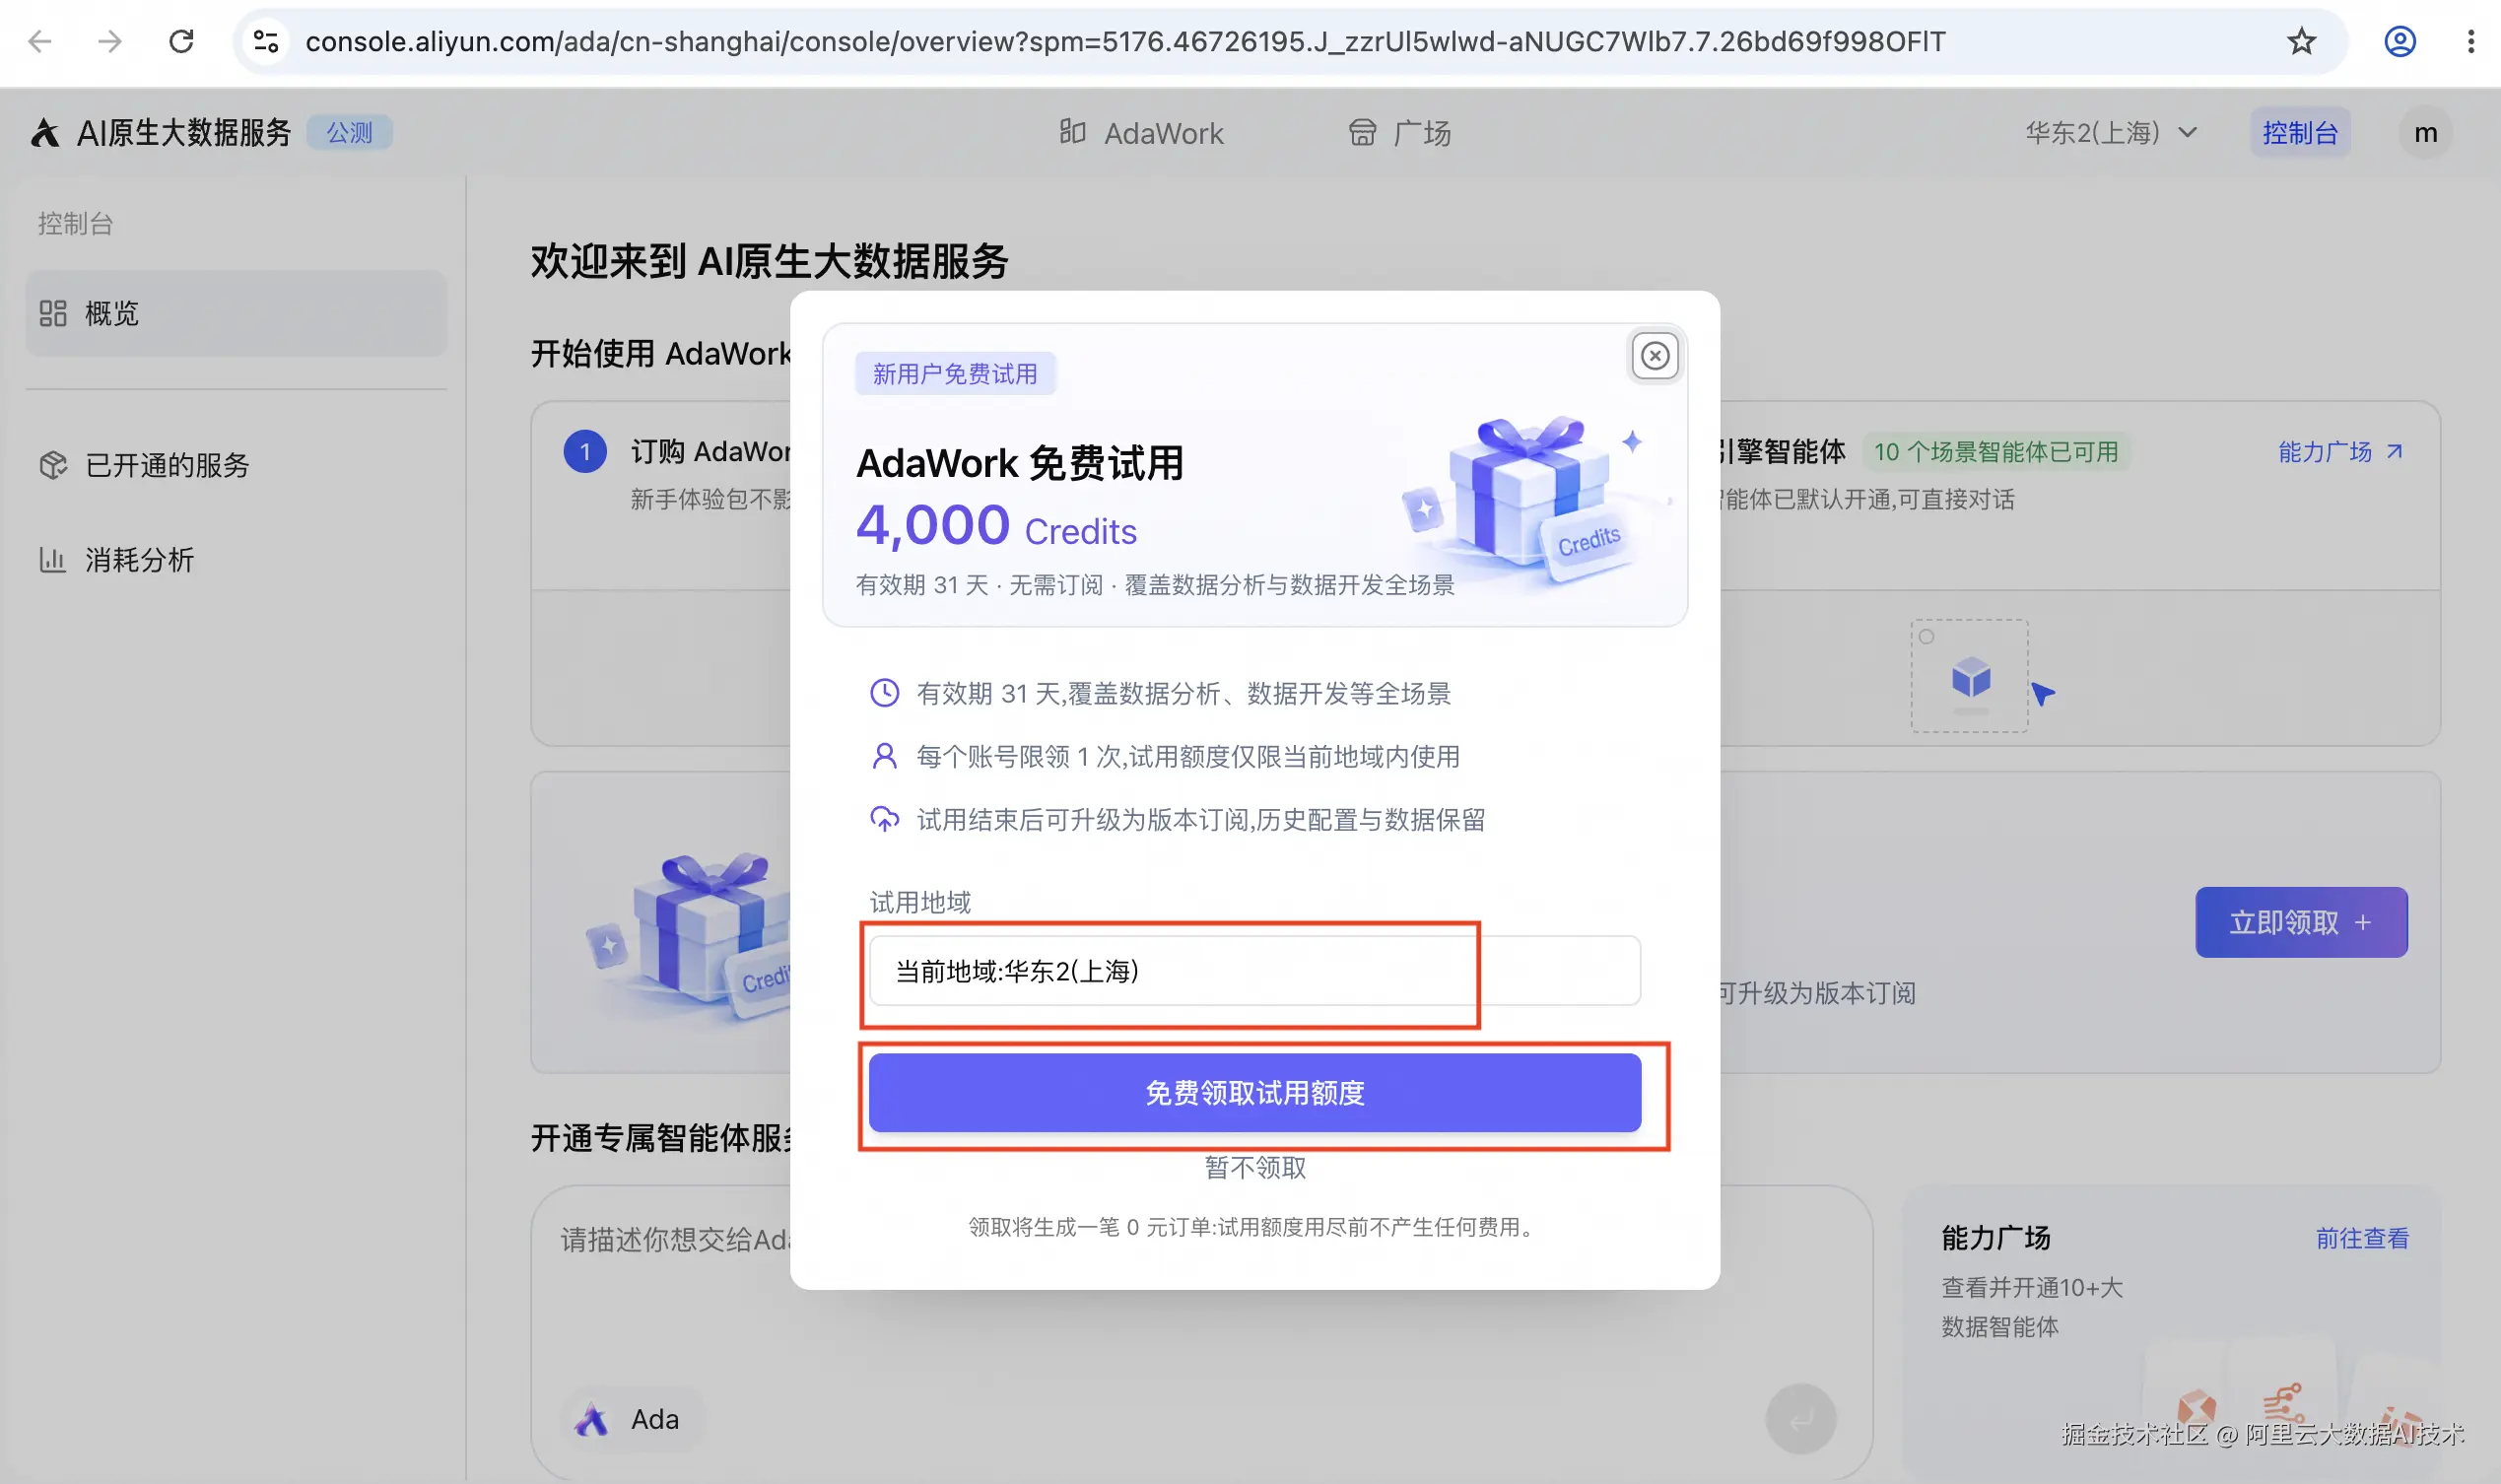
登录阿里云控制台,进入 AI 原生大数据服务(ADA) 控制台,在地域选择器中选择目标地域。地域需与后续要接入的引擎实例一致,因为实例列表只加载当前地域的实例;可用地域以选择器中的实际选项为准。新用户可在此领取免费试用额度。
-
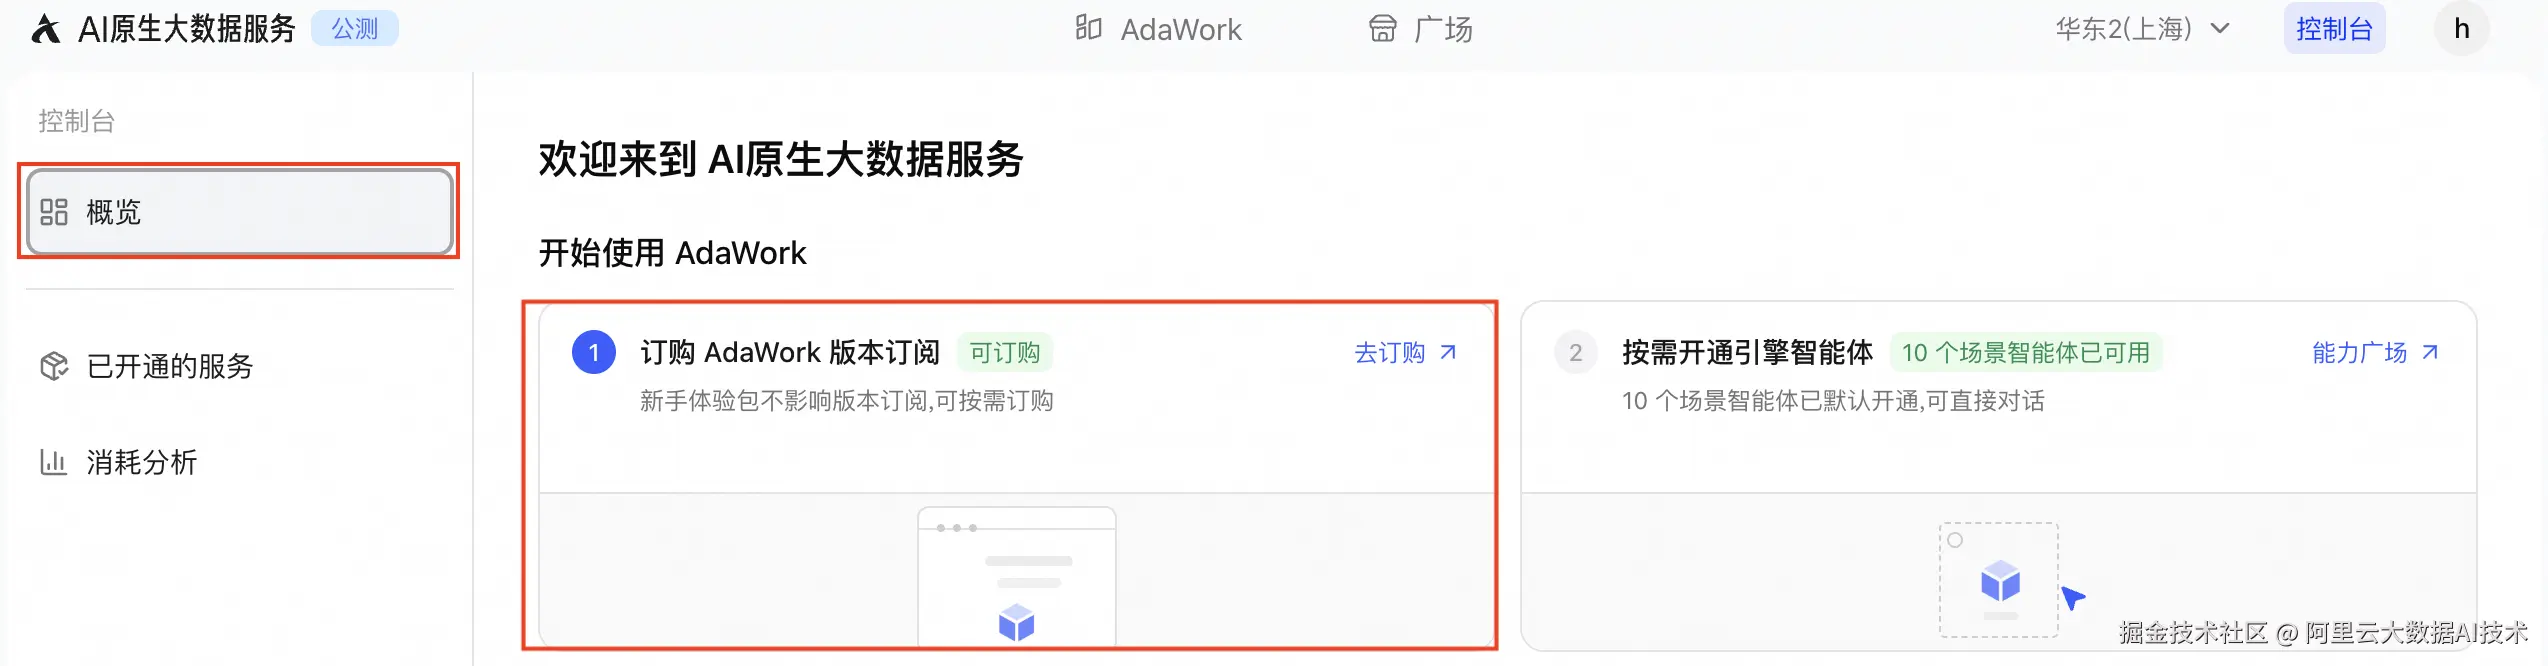
进入门户概览 页,从 AdaWork版本订阅 卡开始按卡片指向完成订阅。新用户体验包期间可无需订阅。
-
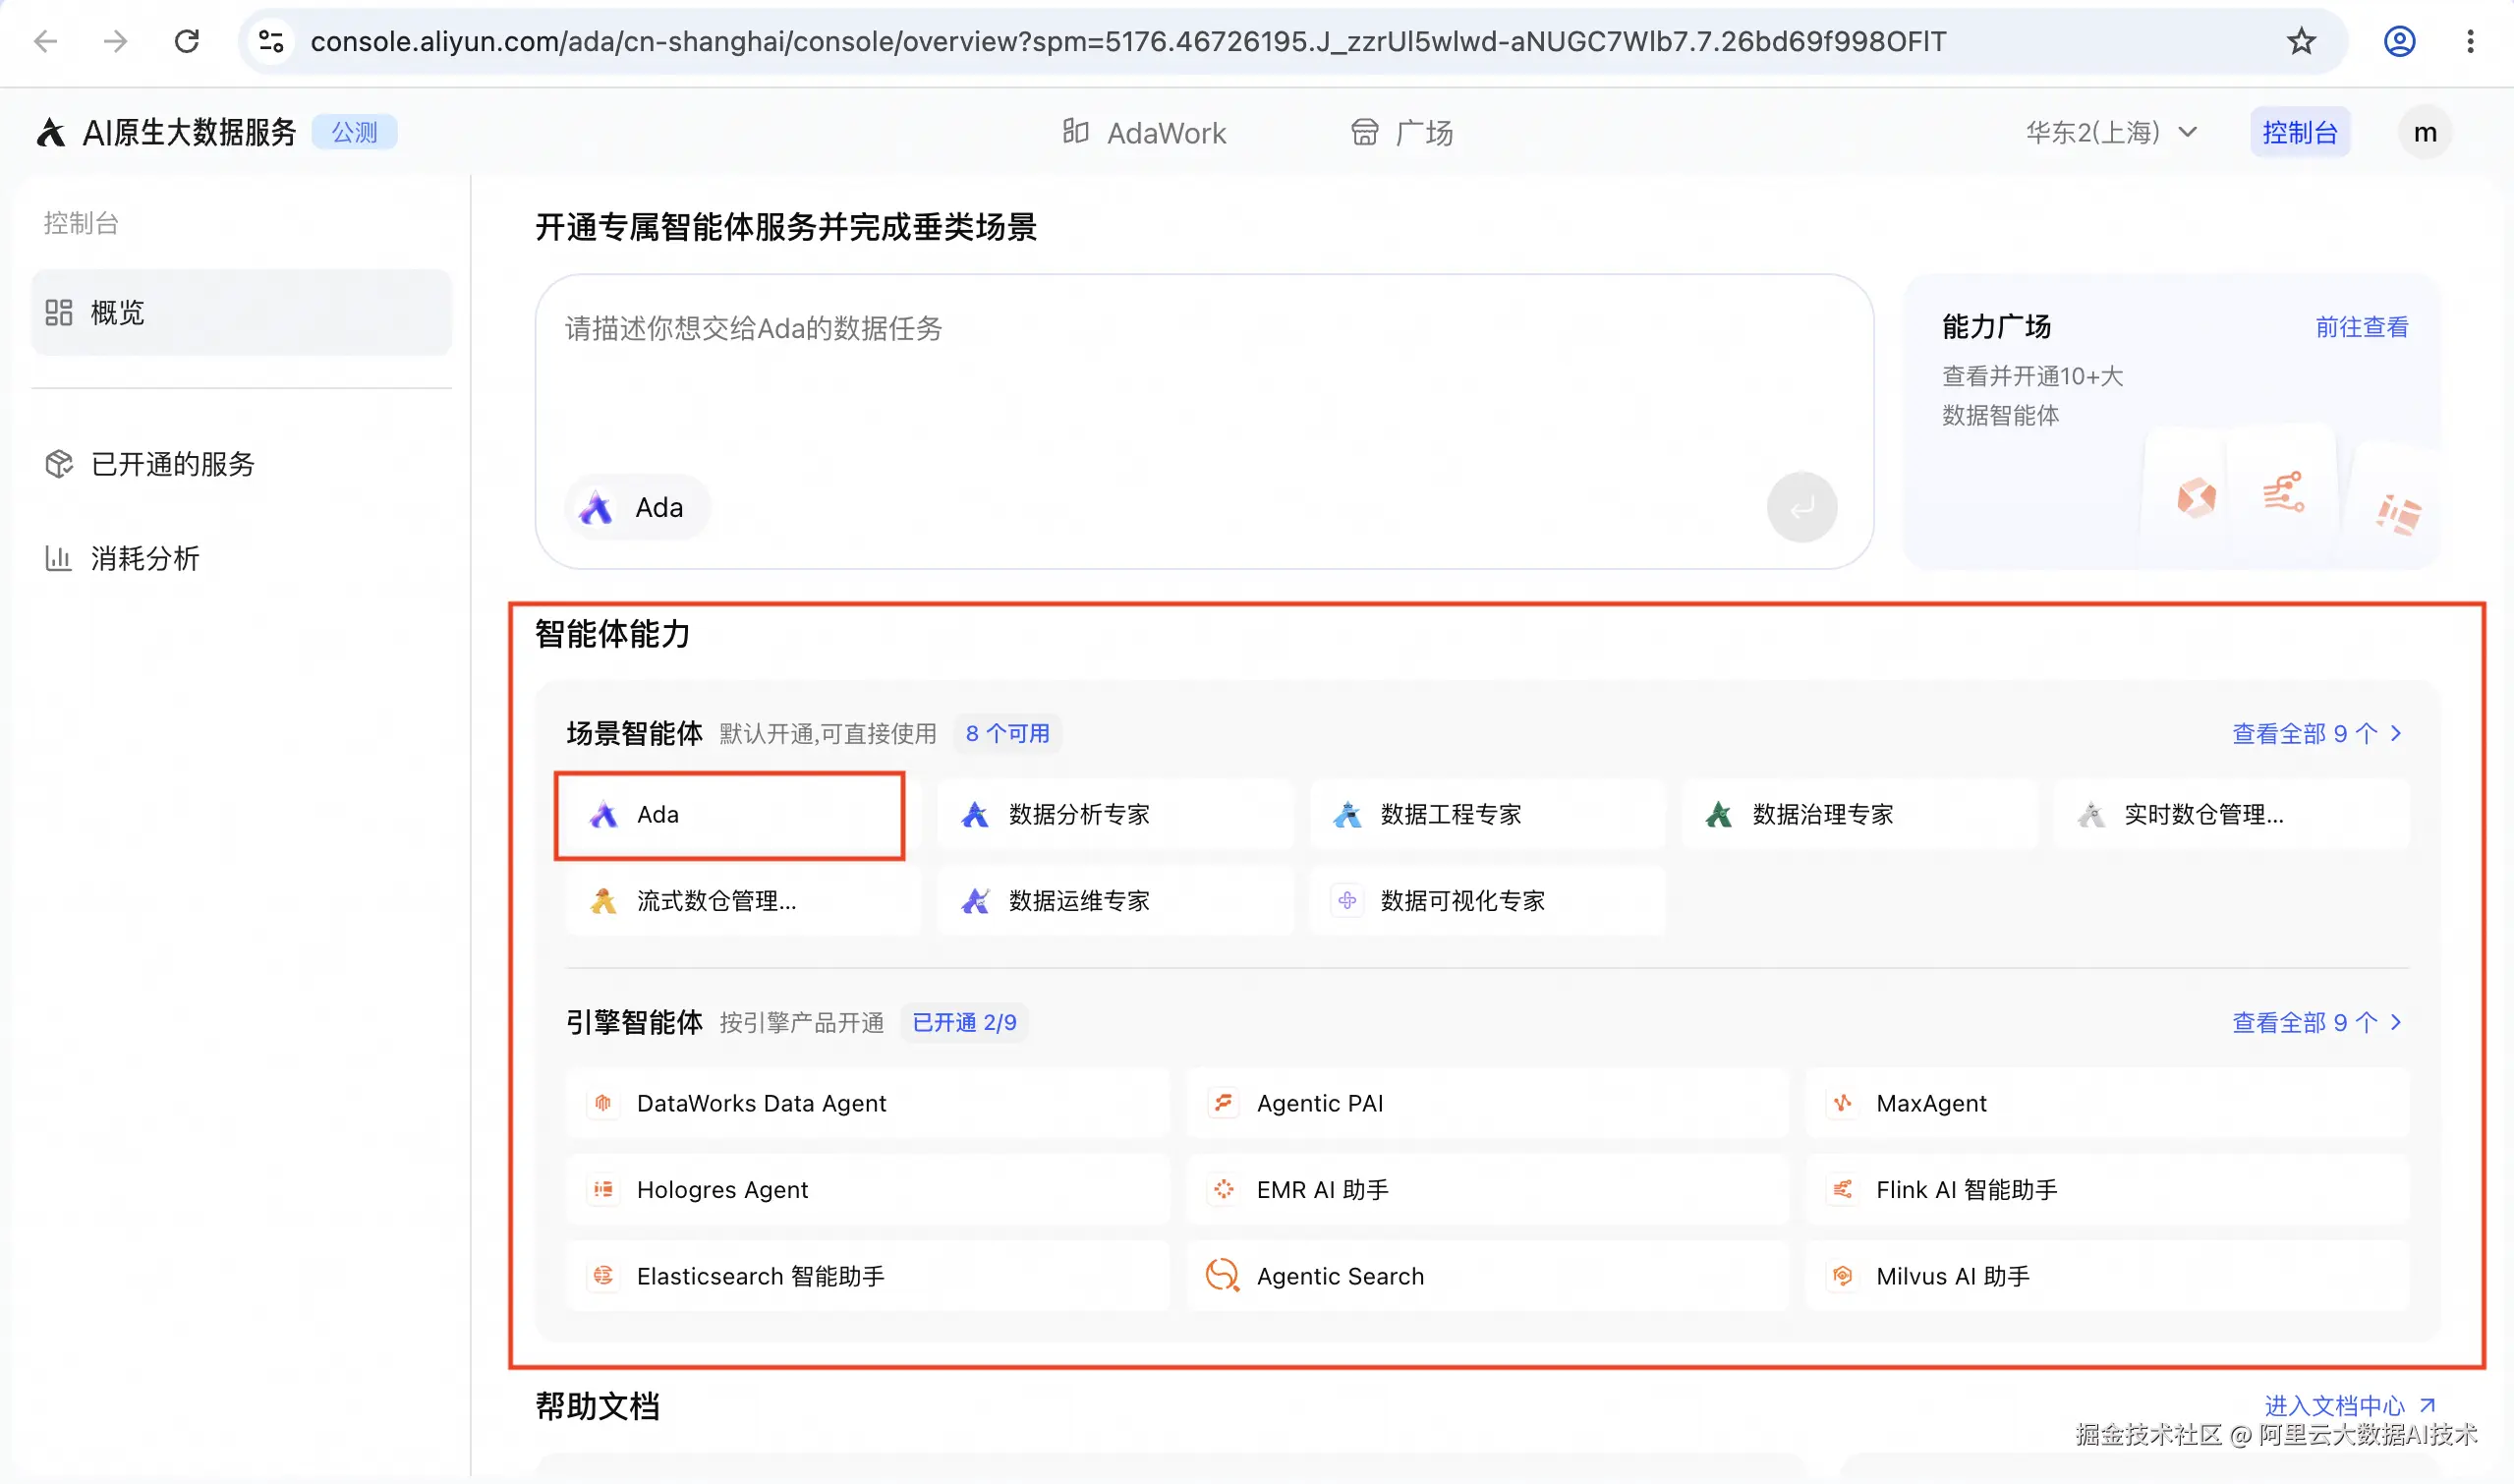
在智能体能力 中选择合适的 Agent 开始对话,此次直接与 Ada 对话即可
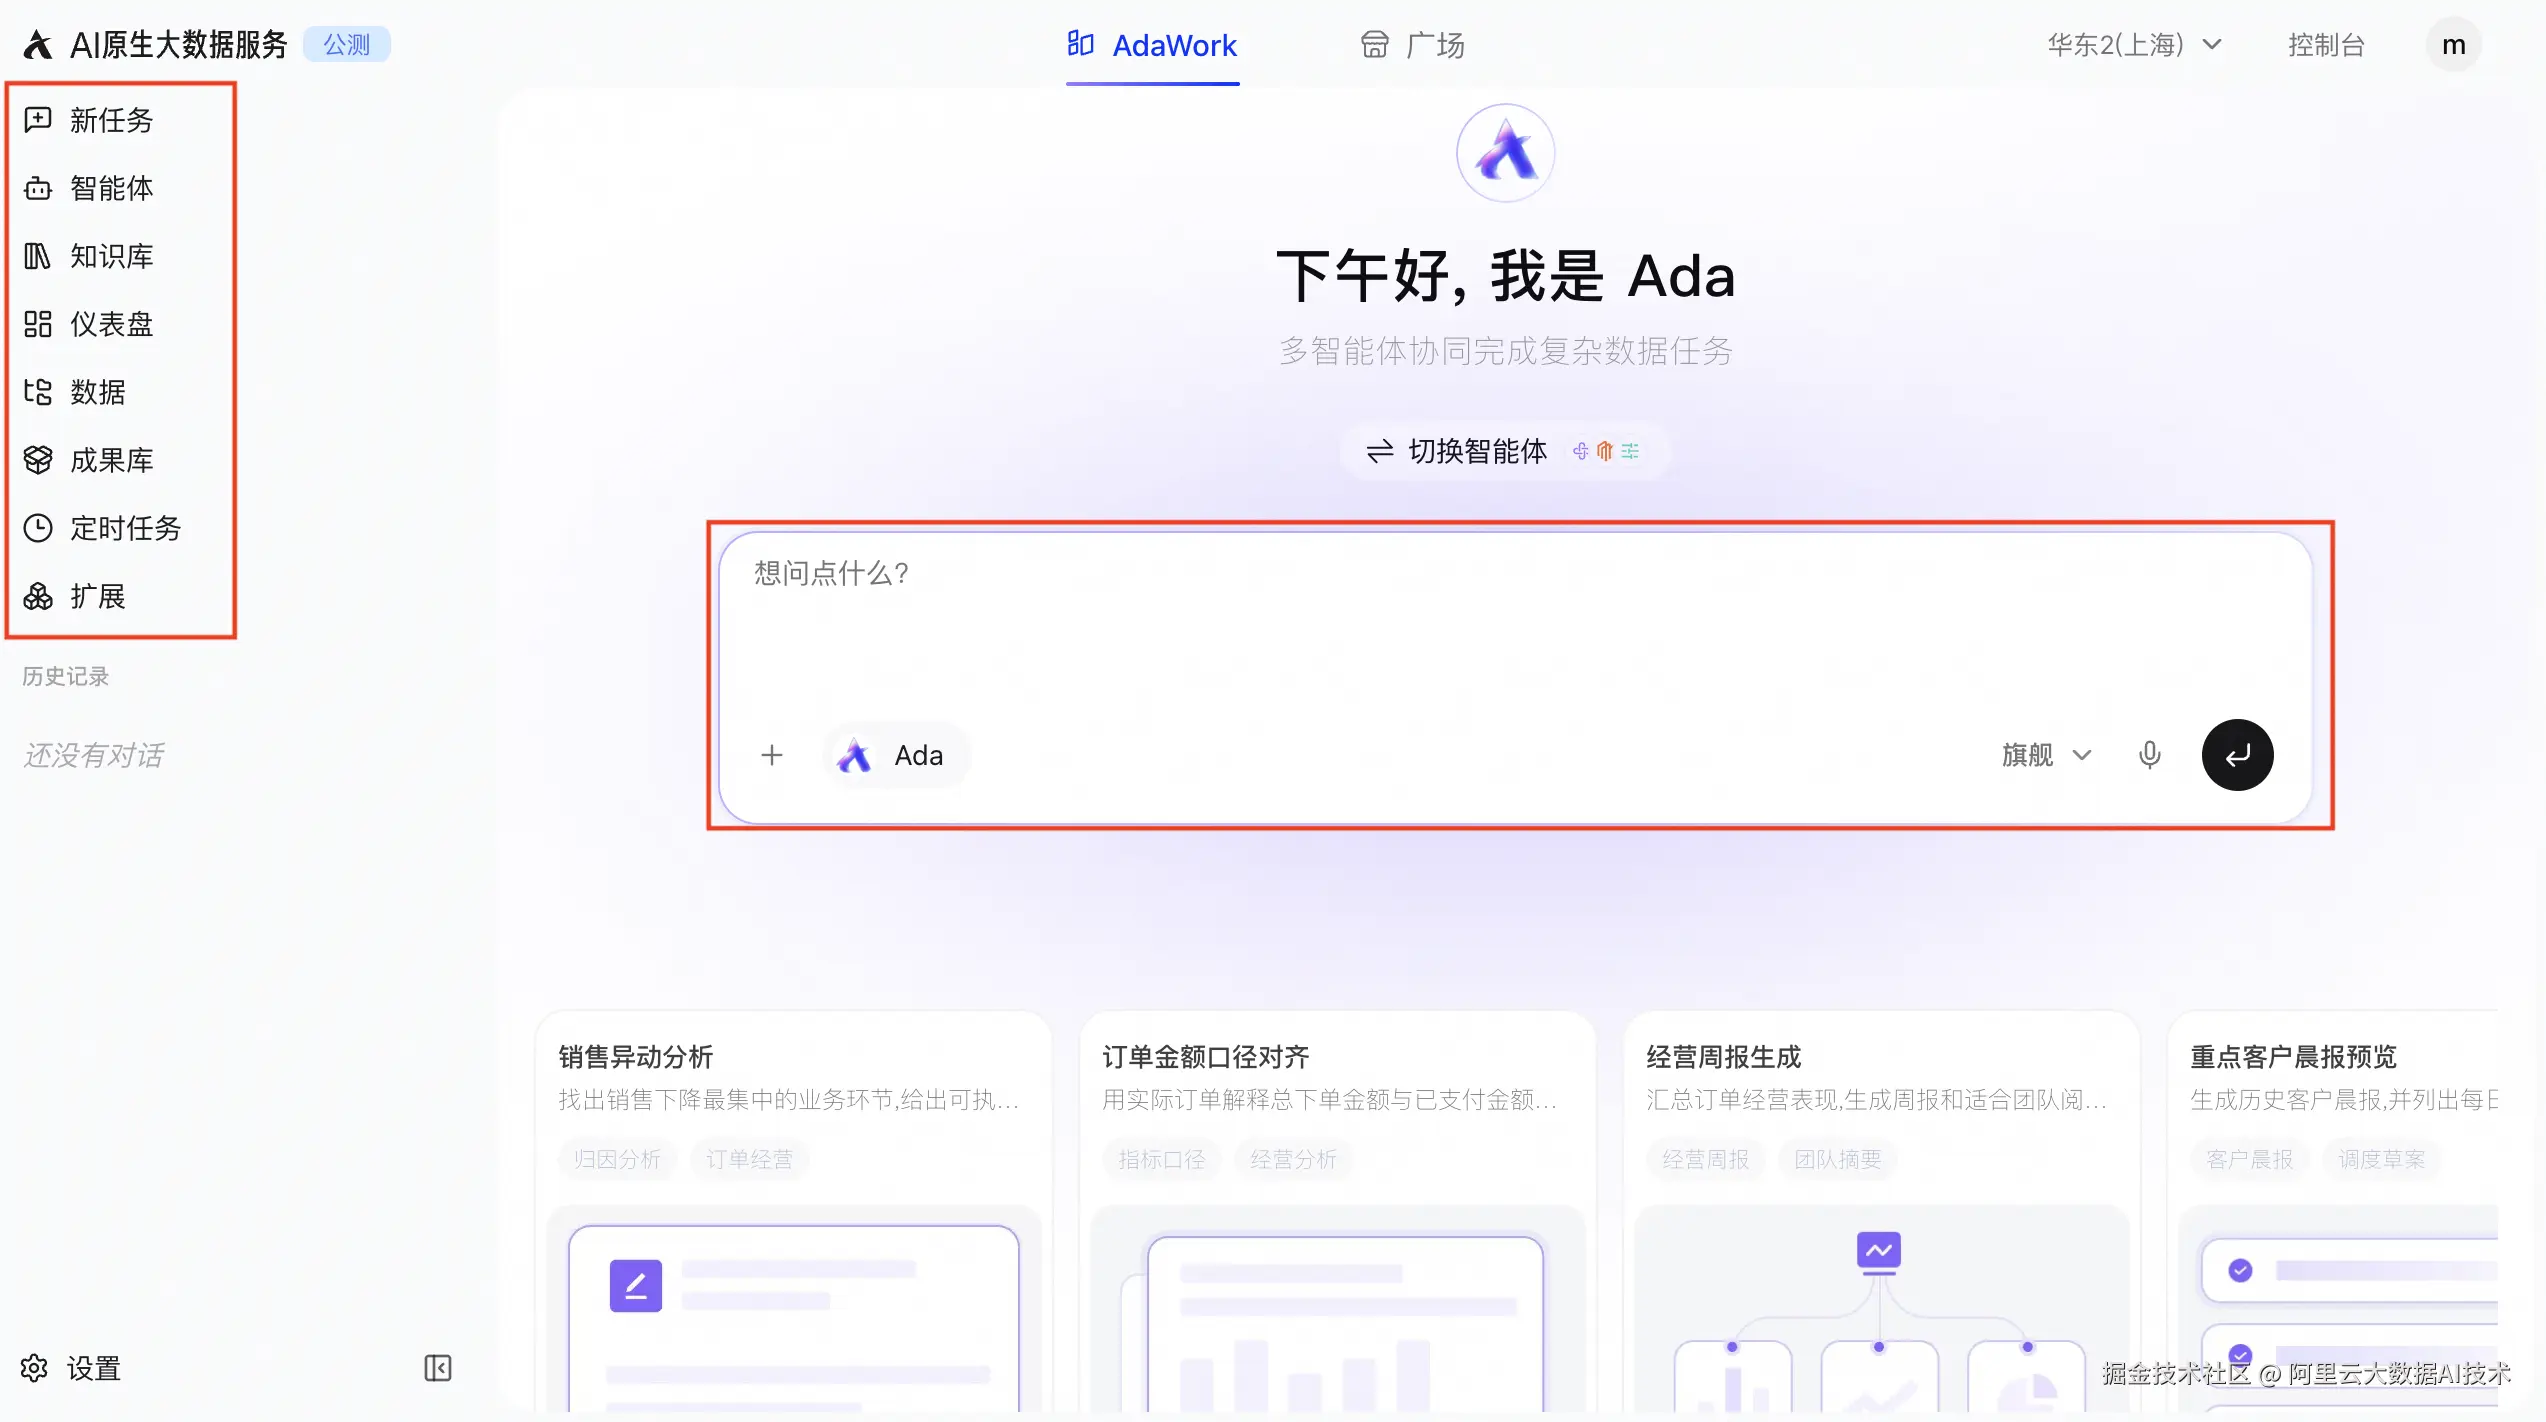
✅ 完成标志:成功进入对话界面,服务状态为可用。
步骤二:把数据带入对话
目标:让智能体获取可分析的数据。
-
打开 AdaWorks 工作台 ,在侧边栏点击 新任务。
-
在输入框左侧点击 添加内容 ,选择 本地文件,上传订单明细表格。
数据要求 :表格需包含下单时间、区域、城市、渠道、金额等字段;日期列需为标准格式(如 2026-09-06),且至少覆盖两个完整周期以计算环比。 示例数据 :若无现成数据,可下载附件 示例数据-区域订单明细.xlsx(覆盖 14 天、4 个区域与 5 个渠道,格式已标准化),直接上传即可。
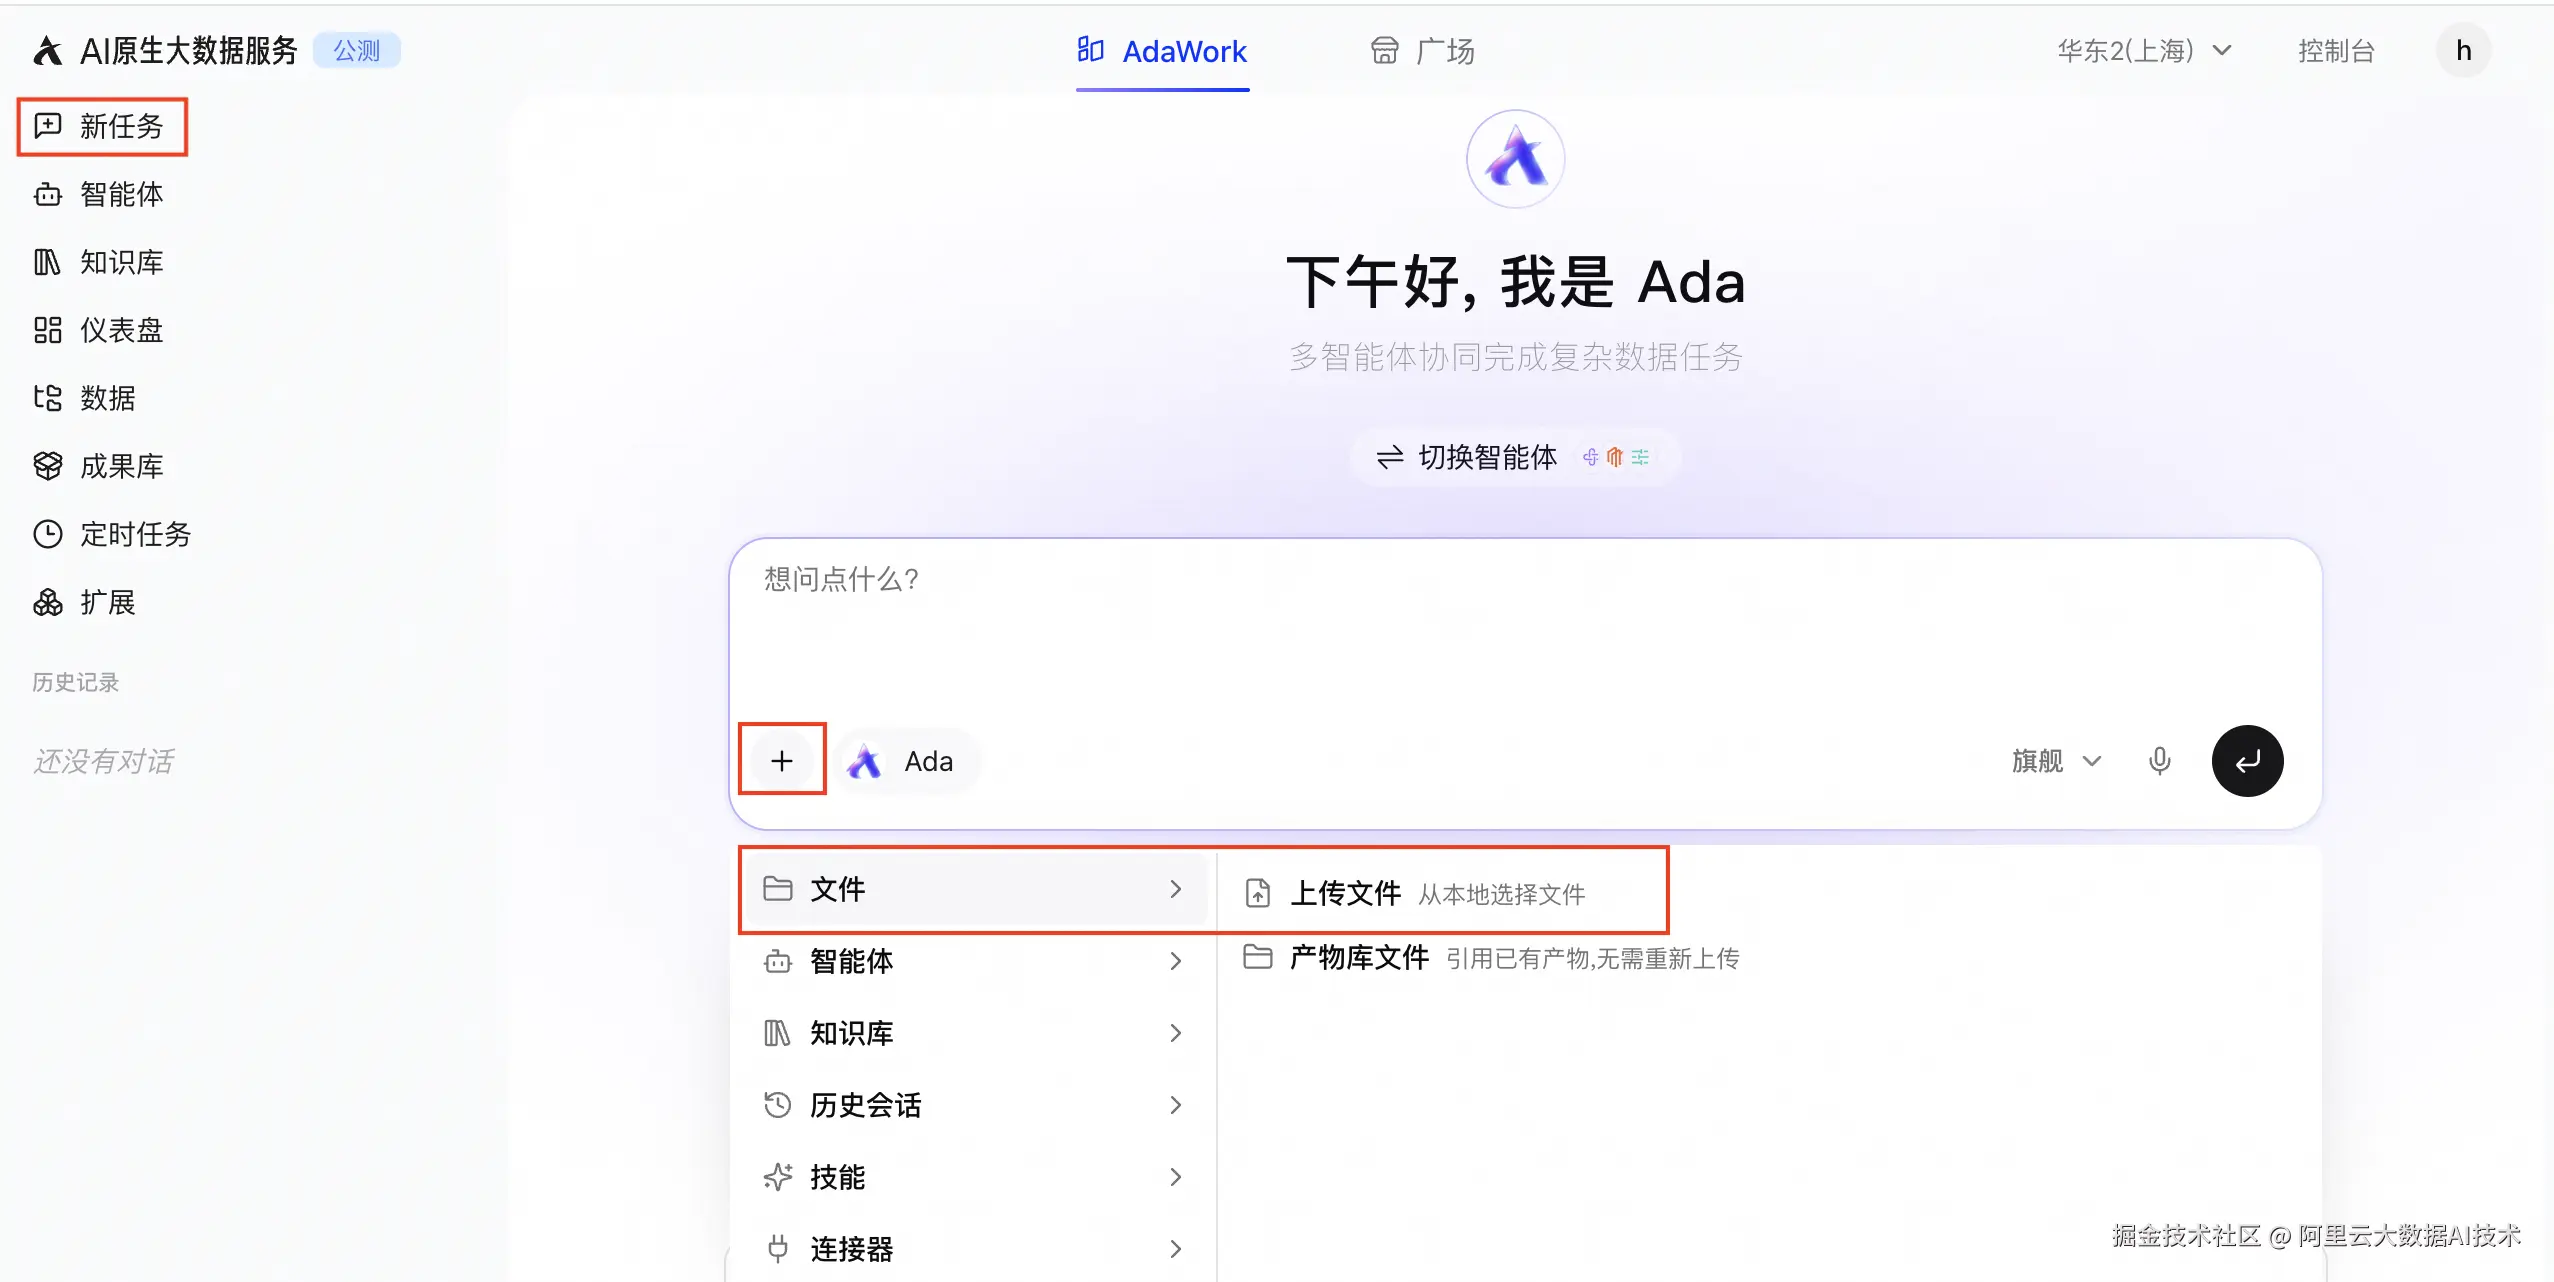
✅ 完成标志:文件上传成功,并在输入框中显示为已添加内容。
步骤三:发起分析并核对过程
目标:找出问题所在,并验证执行路径与计算过程,而不仅仅是获取一个数字。
这一步先把"问题出在哪里"找出来,同时验证执行路径与计算过程,而不只是拿到一个数字。
-
输入问题:用自然语言描述需求,无需预先设计维度。例如:
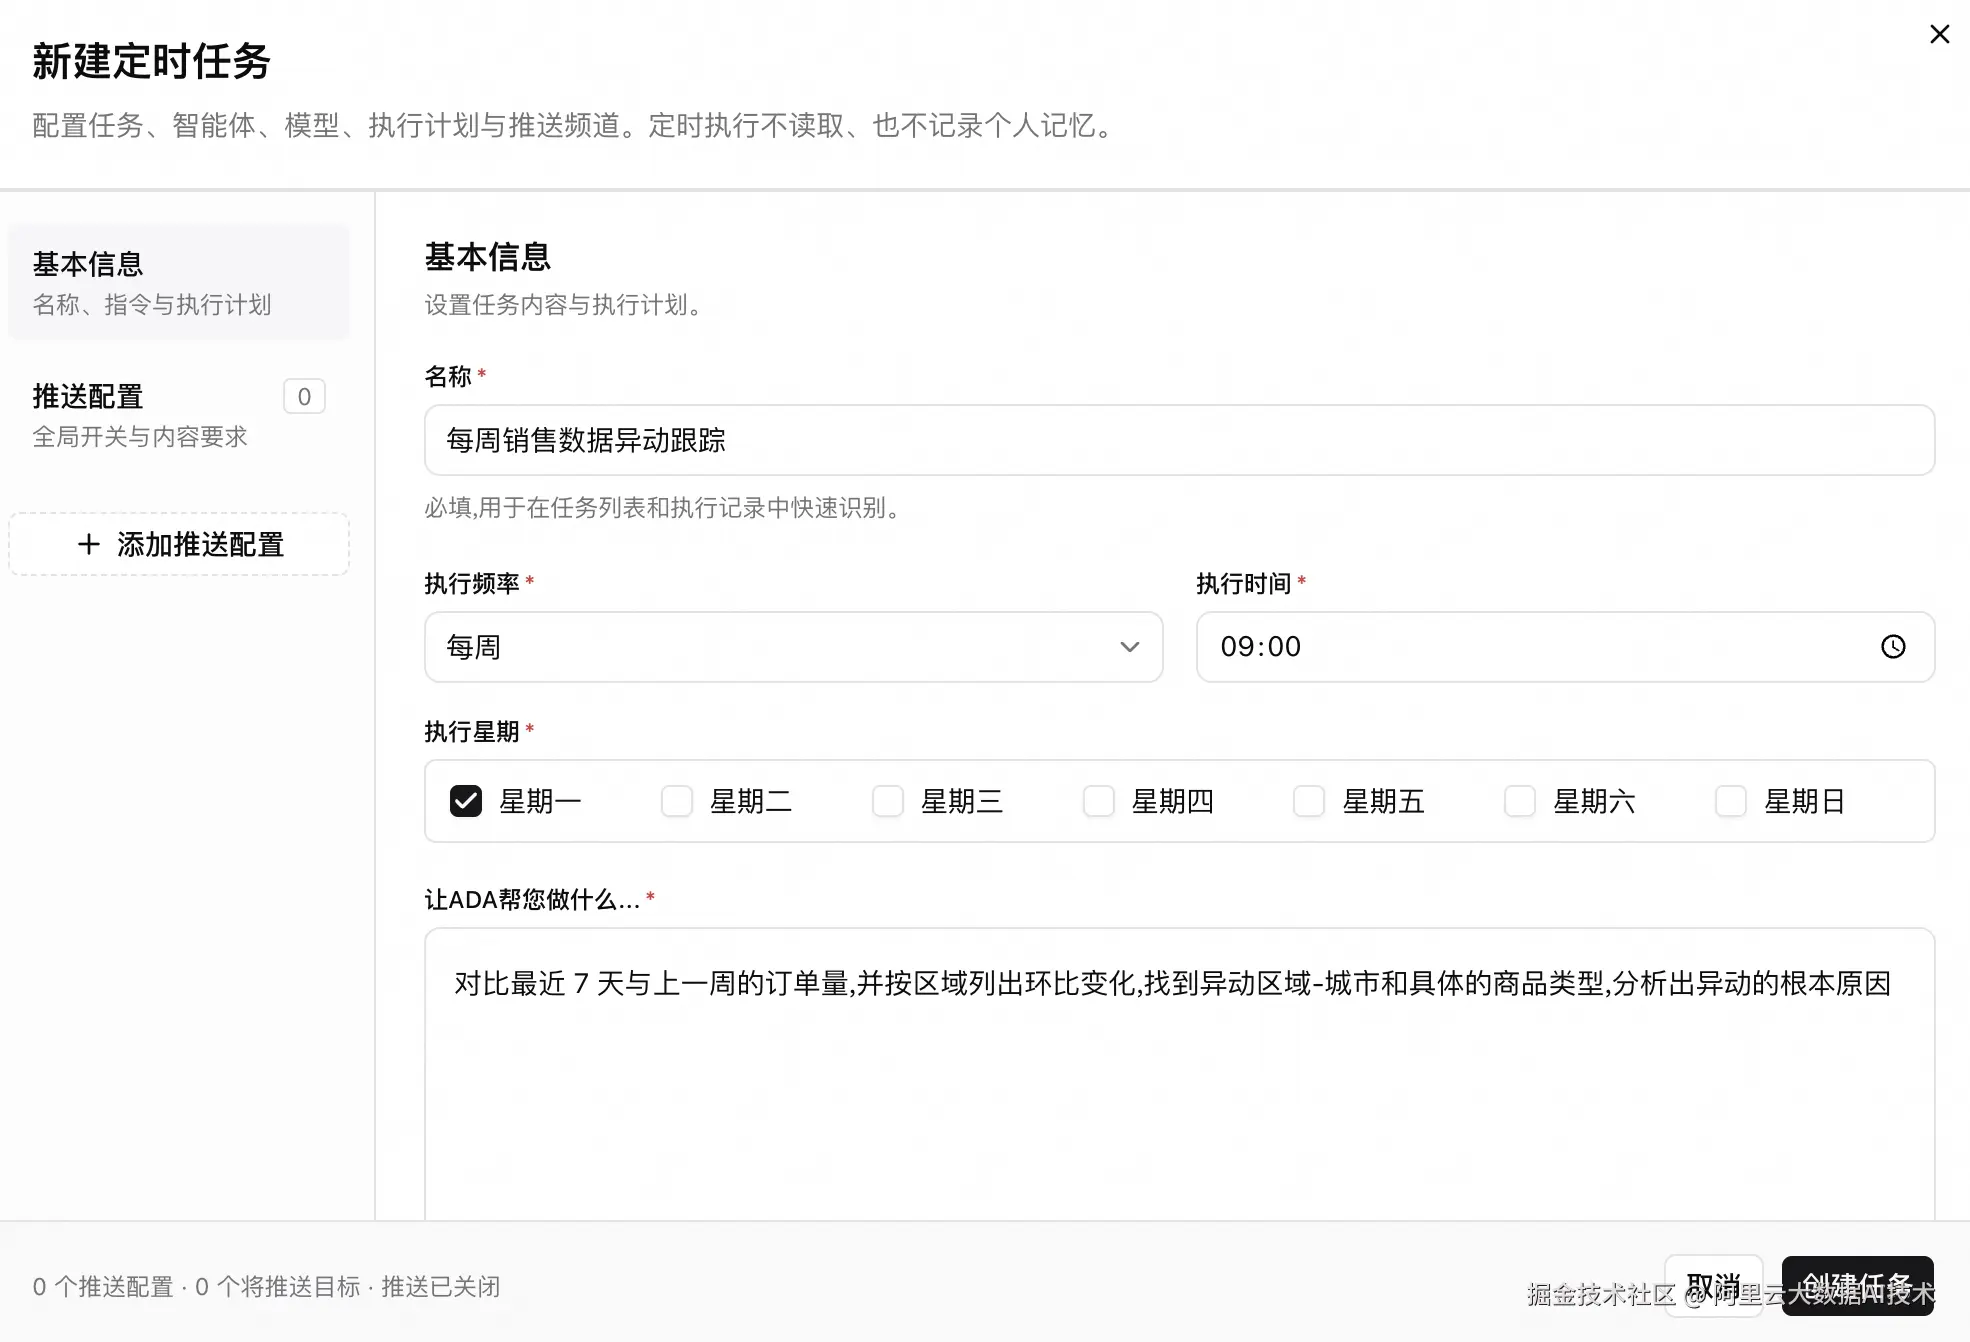
对比最近 7 天与上一周的订单量,并按区域列出环比变化。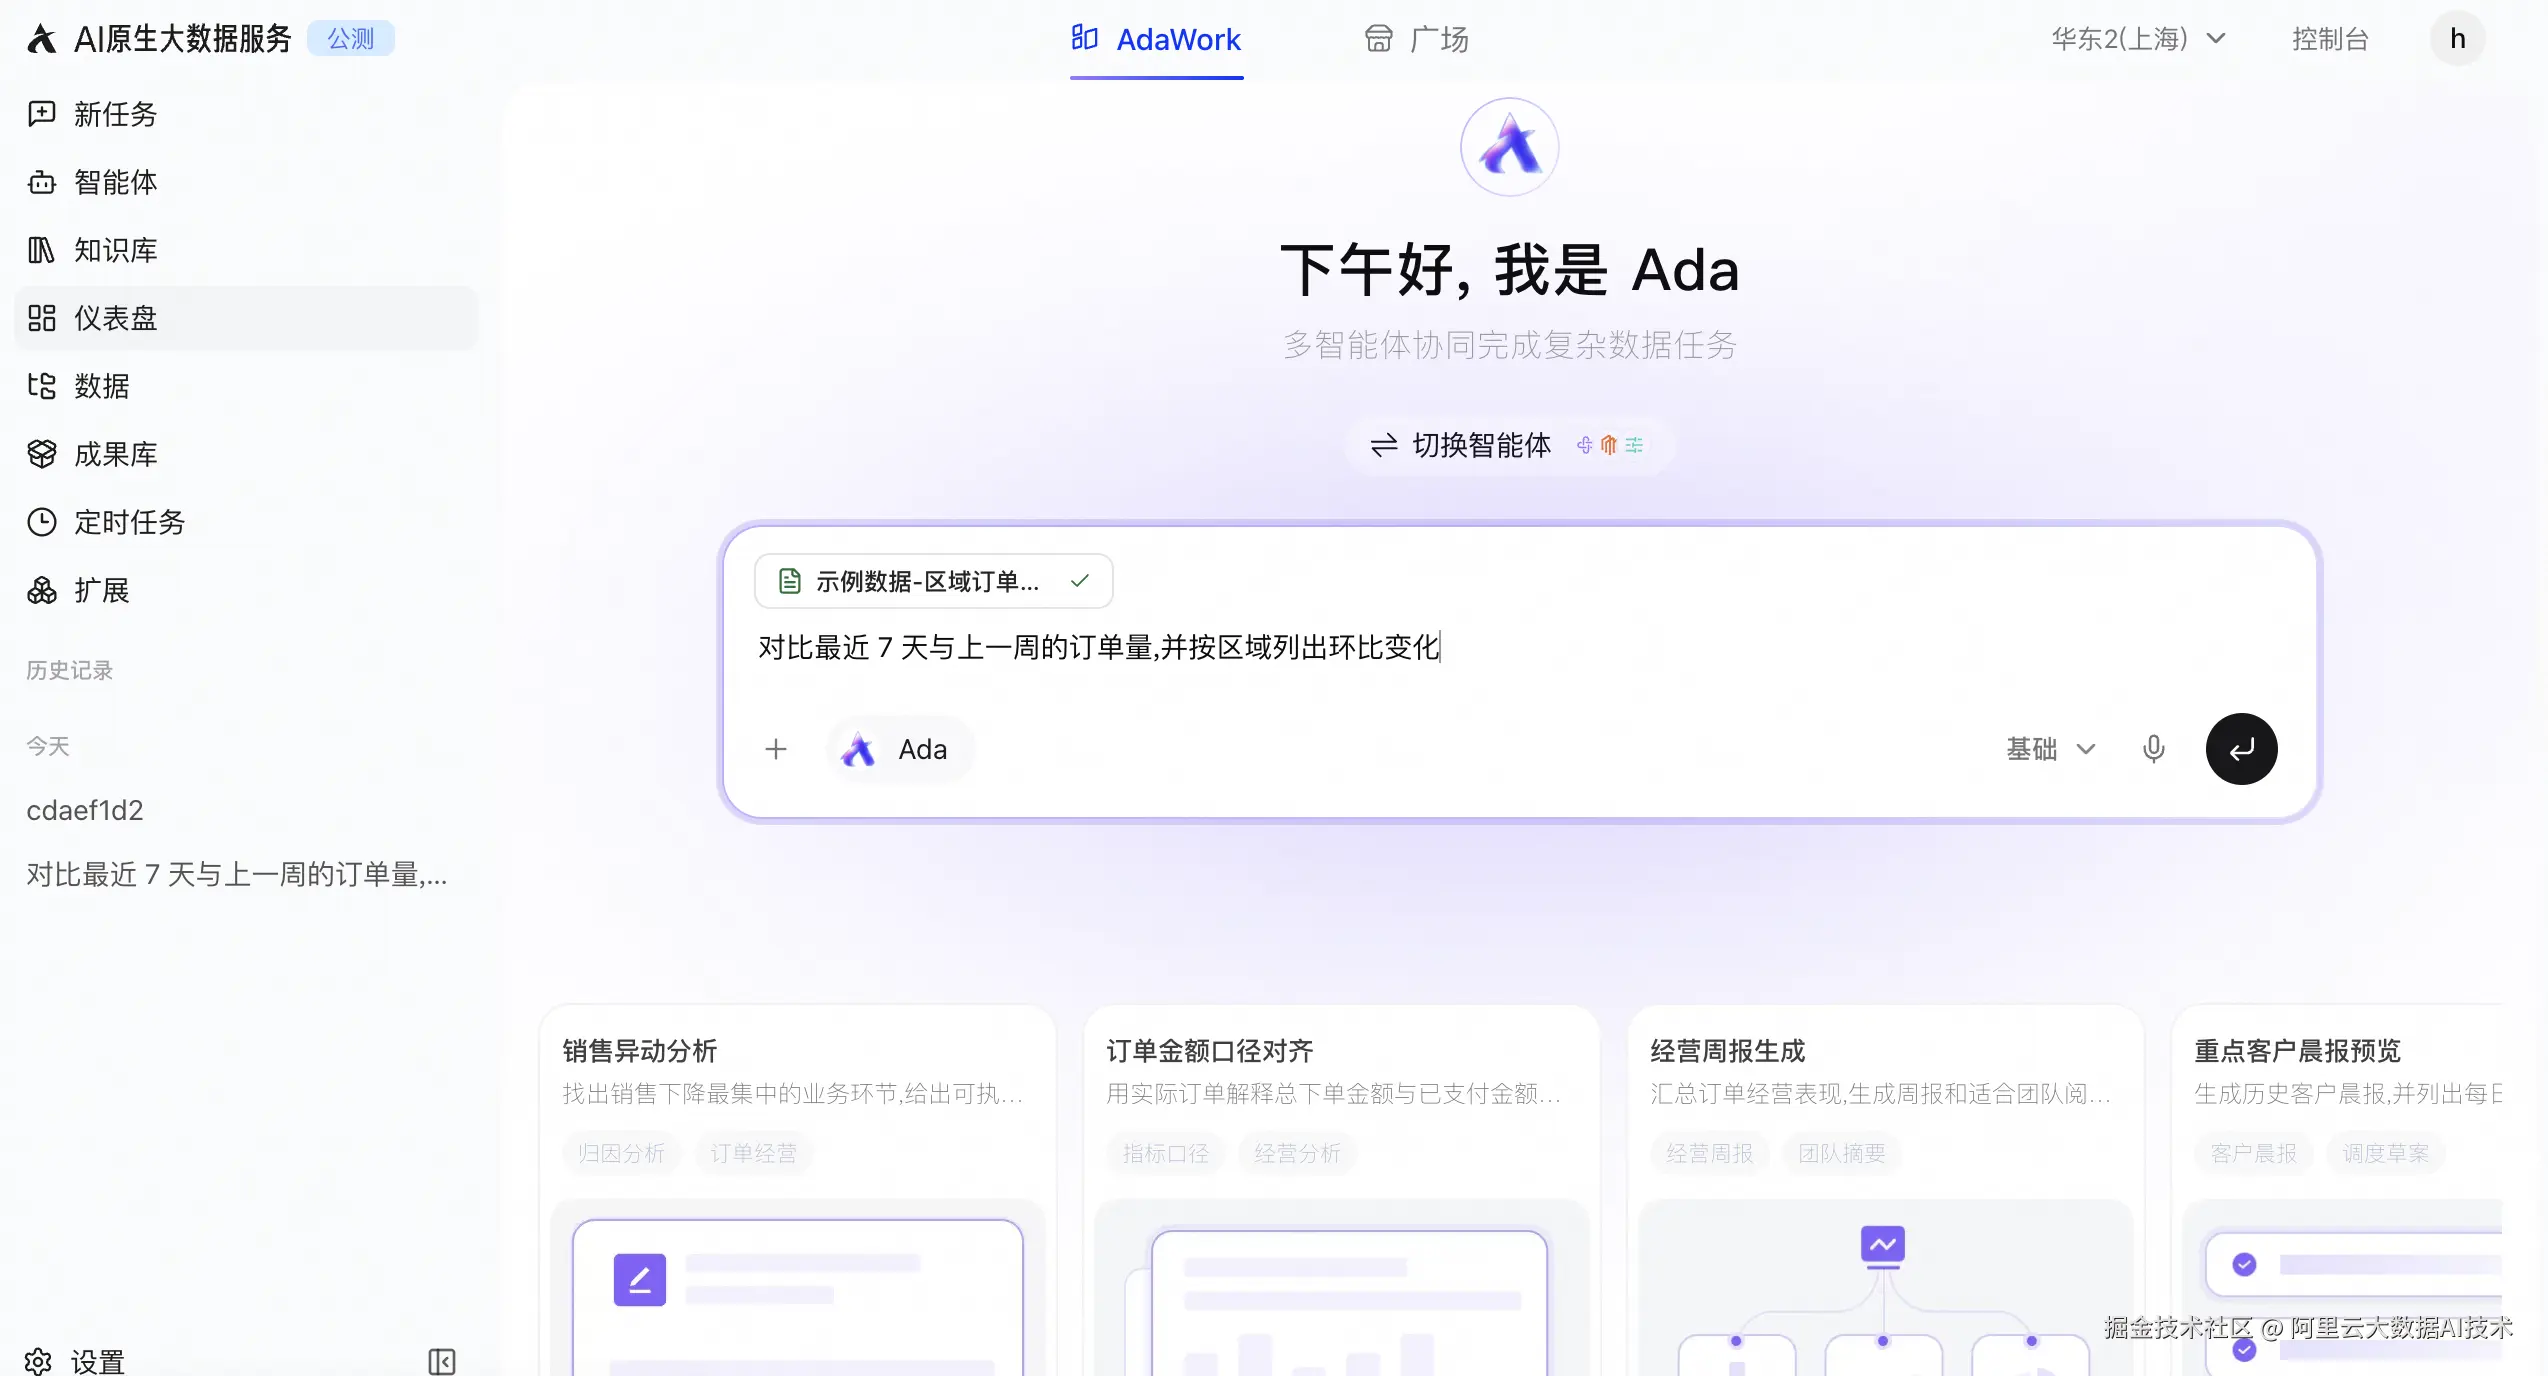
-
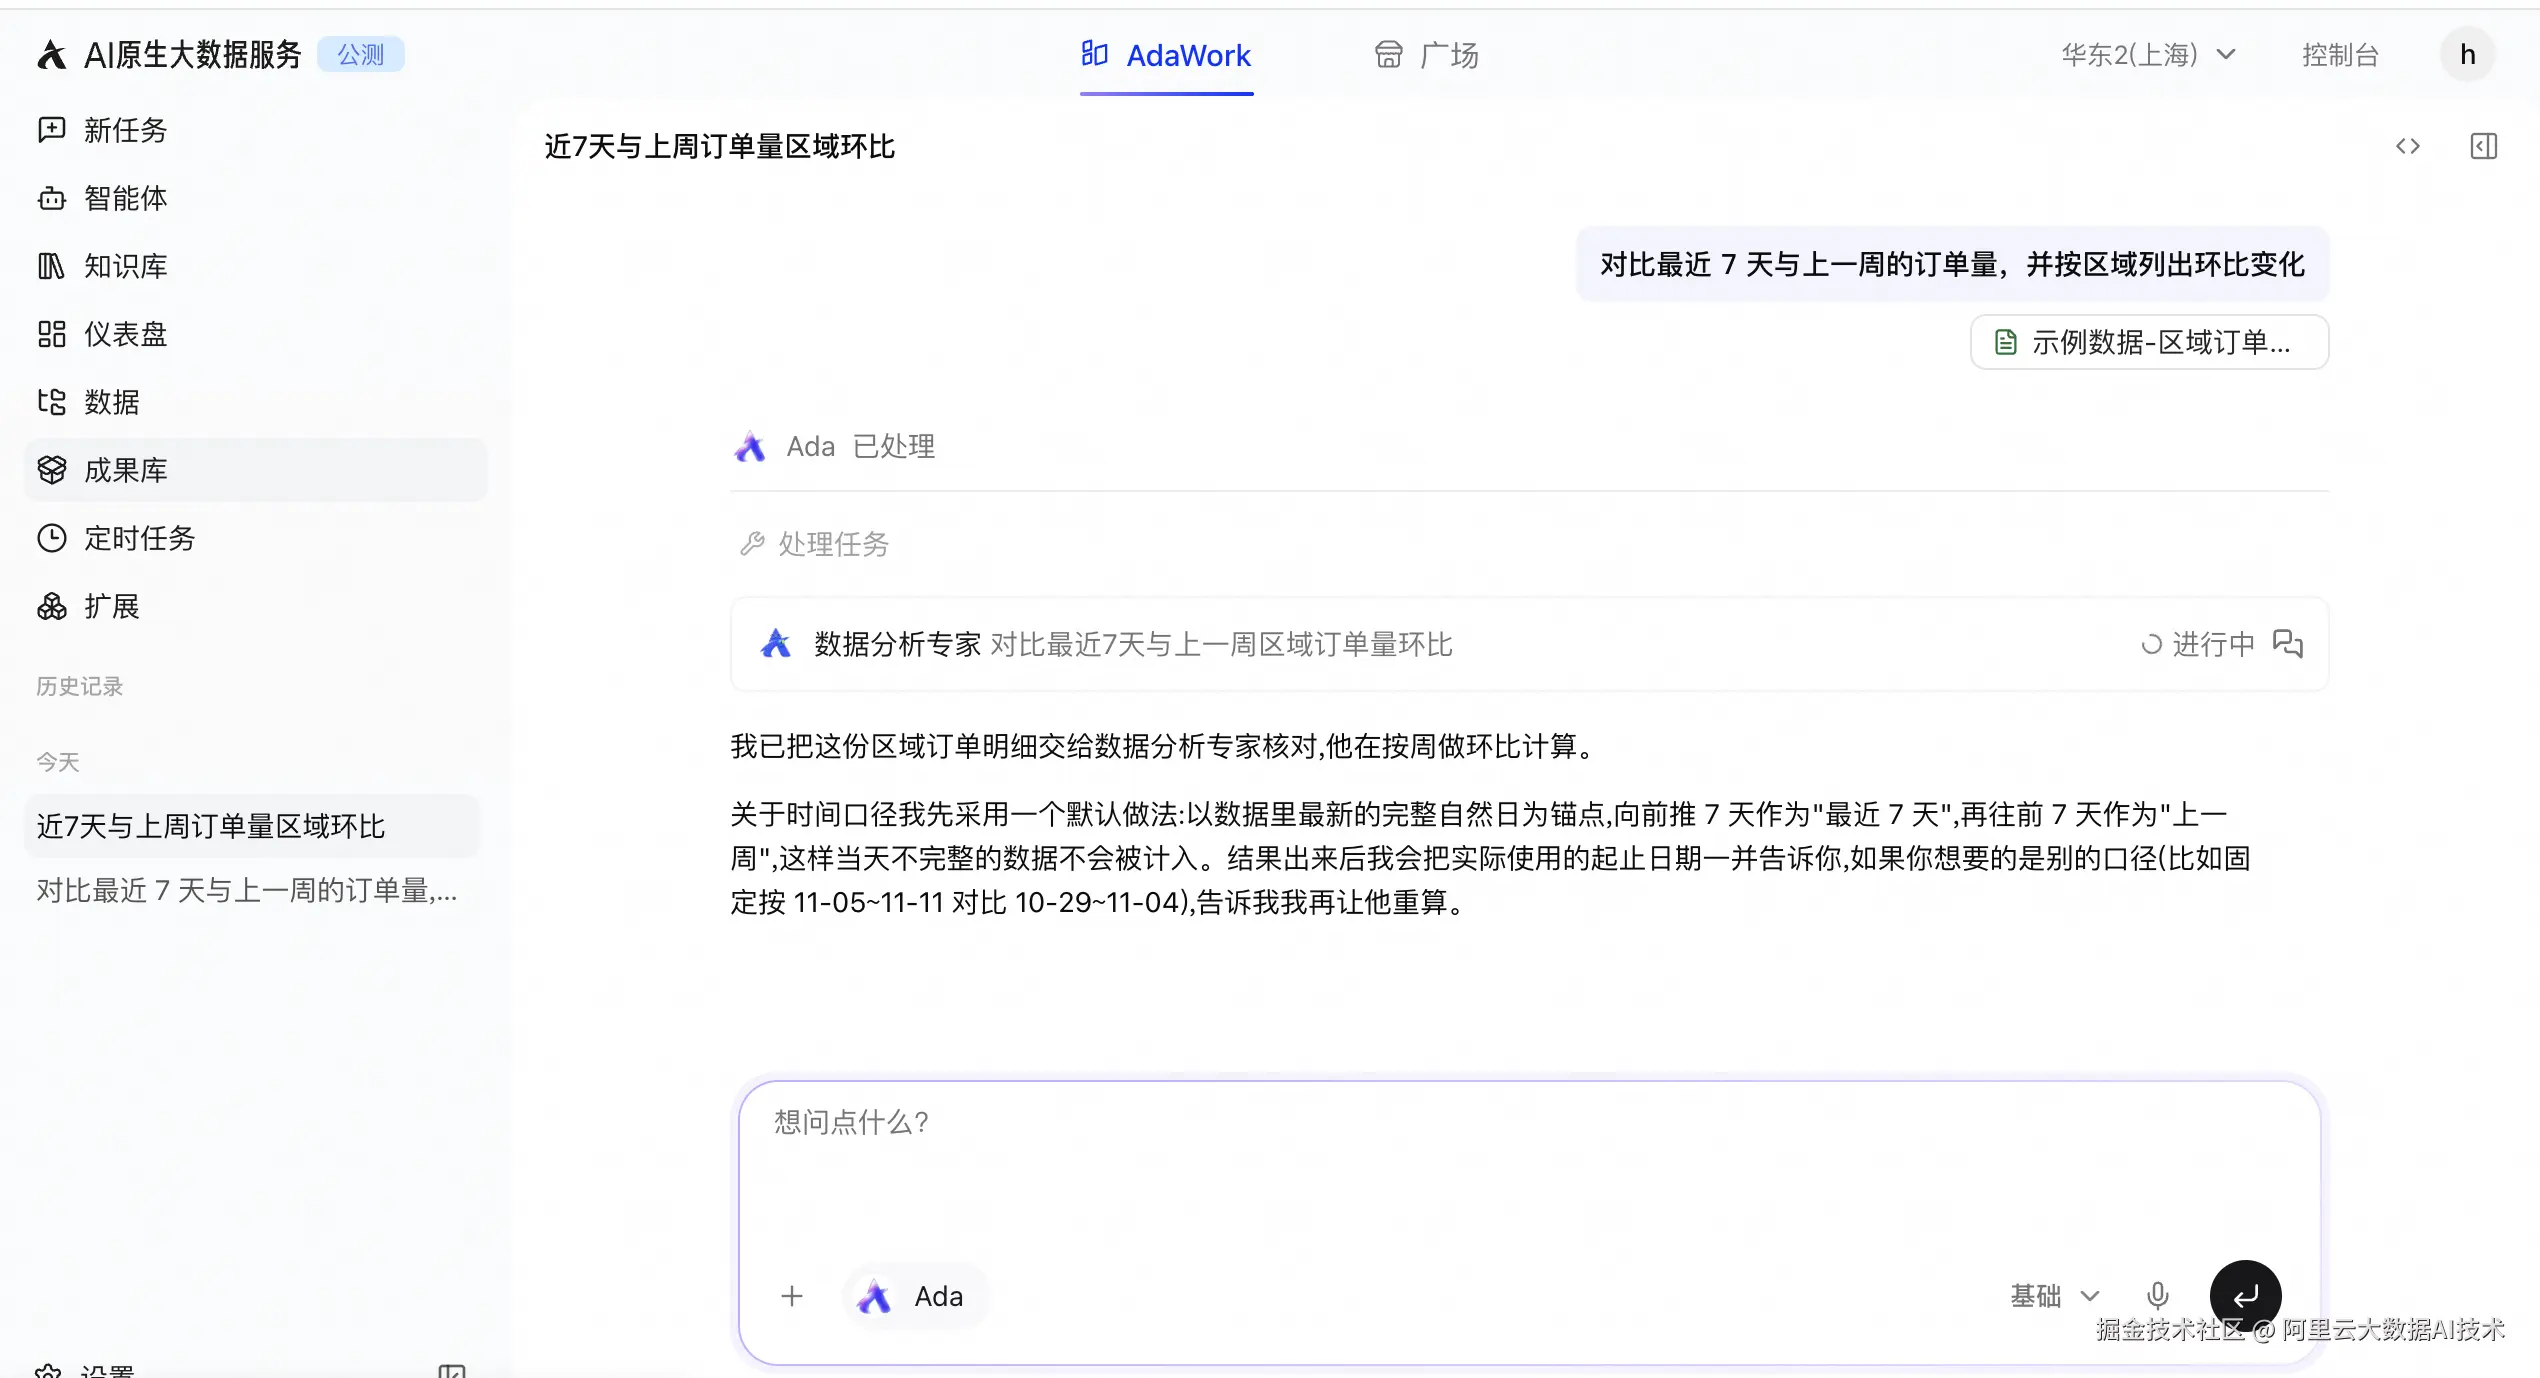
核对执行计划:发送后,Ada 会生成执行计划。请核对数据范围与拆解维度,确认无误后点击继续。若计划与预期不符,可直接在对话中补充约束,无需重启会话。
-
核对执行过程:执行期间,回复上方会显示折叠区(处理中/已处理)。展开可查看实际执行的代码与中间结果。若涉及数据访问,会弹出权限确认卡片(提供本次/持续 允许/拒绝 四种选项),首次执行建议选择"本次允许"。
-
核对计算逻辑 :回复生成后,将结论中的关键数值与执行过程中的计算步骤进行比对,确认统计口径与时间范围符合预期。
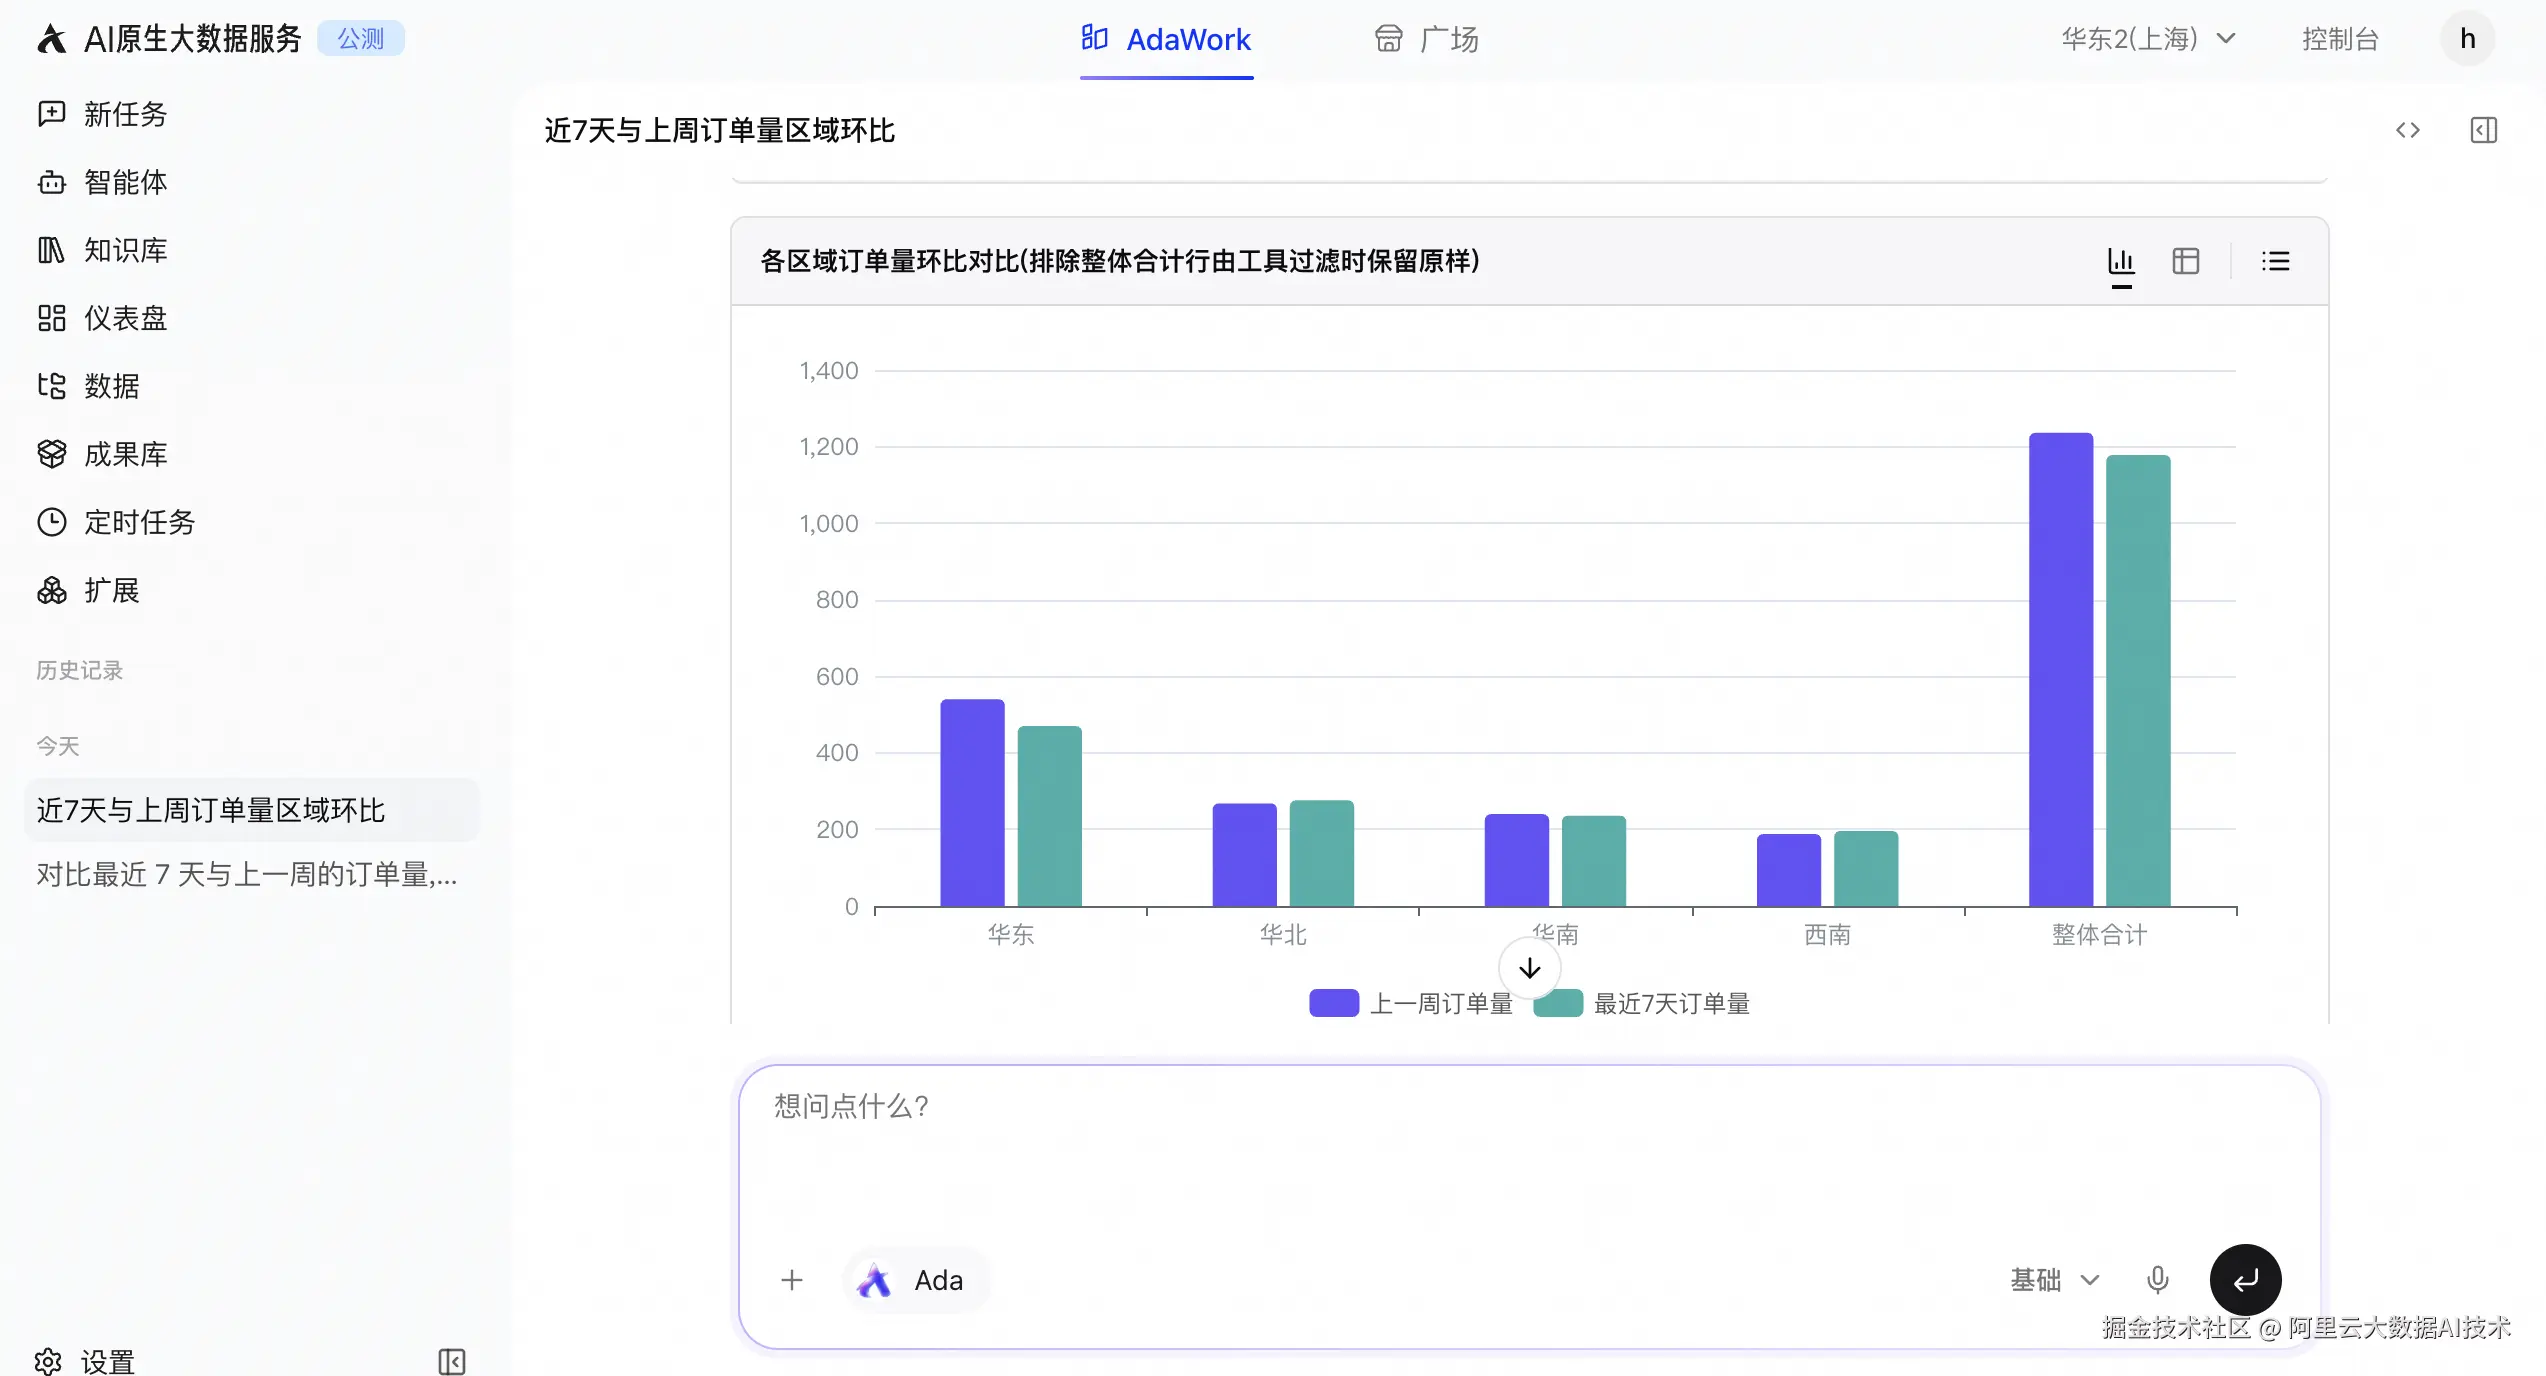
✅ 完成标志:会话中生成包含数据表格与分析结论的回复,且工具调用卡片可展开核对。
参考结论(使用示例数据):总量环比下跌约 5%。拆解到区域后发现,华东区跌幅超 10%(唯一明显下降区域),其余三区基本持平。这印证了"总量往往会掩盖结构性问题"。
步骤四:追问定位问题
目标:将宏观问题拆解至可落地的微观粒度。
上一步已锁定"华东区下跌",现在需进一步下钻。在同一会话中继续提问(Ada 会自动继承上下文,无需重述背景): 拆解华东订单量下滑的原因,按城市和商品类目分别列出环比变化
参考结论:跌幅集中在杭州(上海、苏州持平),且杭州的跌幅几乎全部来自"家电"类目。结论可能提及"小程序渠道跌幅最大",但这只是表象(杭州家电多从小程序下单),核心问题在于"家电类目下滑"。
定位到具体商品后,需进一步确认是需求萎缩还是供给异常: 杭州的家电是下单量减少,还是订单取消增加?
参考结论:下单量减少与订单取消增加同时出现,且取消率显著高于其他商品。两者叠加指向"该类目缺货",而非单纯的需求下降。
✅ 完成标志:回复将跌幅精准指向具体的城市与商品,并给出初步归因。
提示 :会话中的表格与报告卡片支持在线预览与下载。若需长期留存或跨团队分享,可将其转为"产物"(参见 产物管理)。
步骤五:固化为每日报告
目标:将单次手动分析转化为每日自动执行的任务。
-
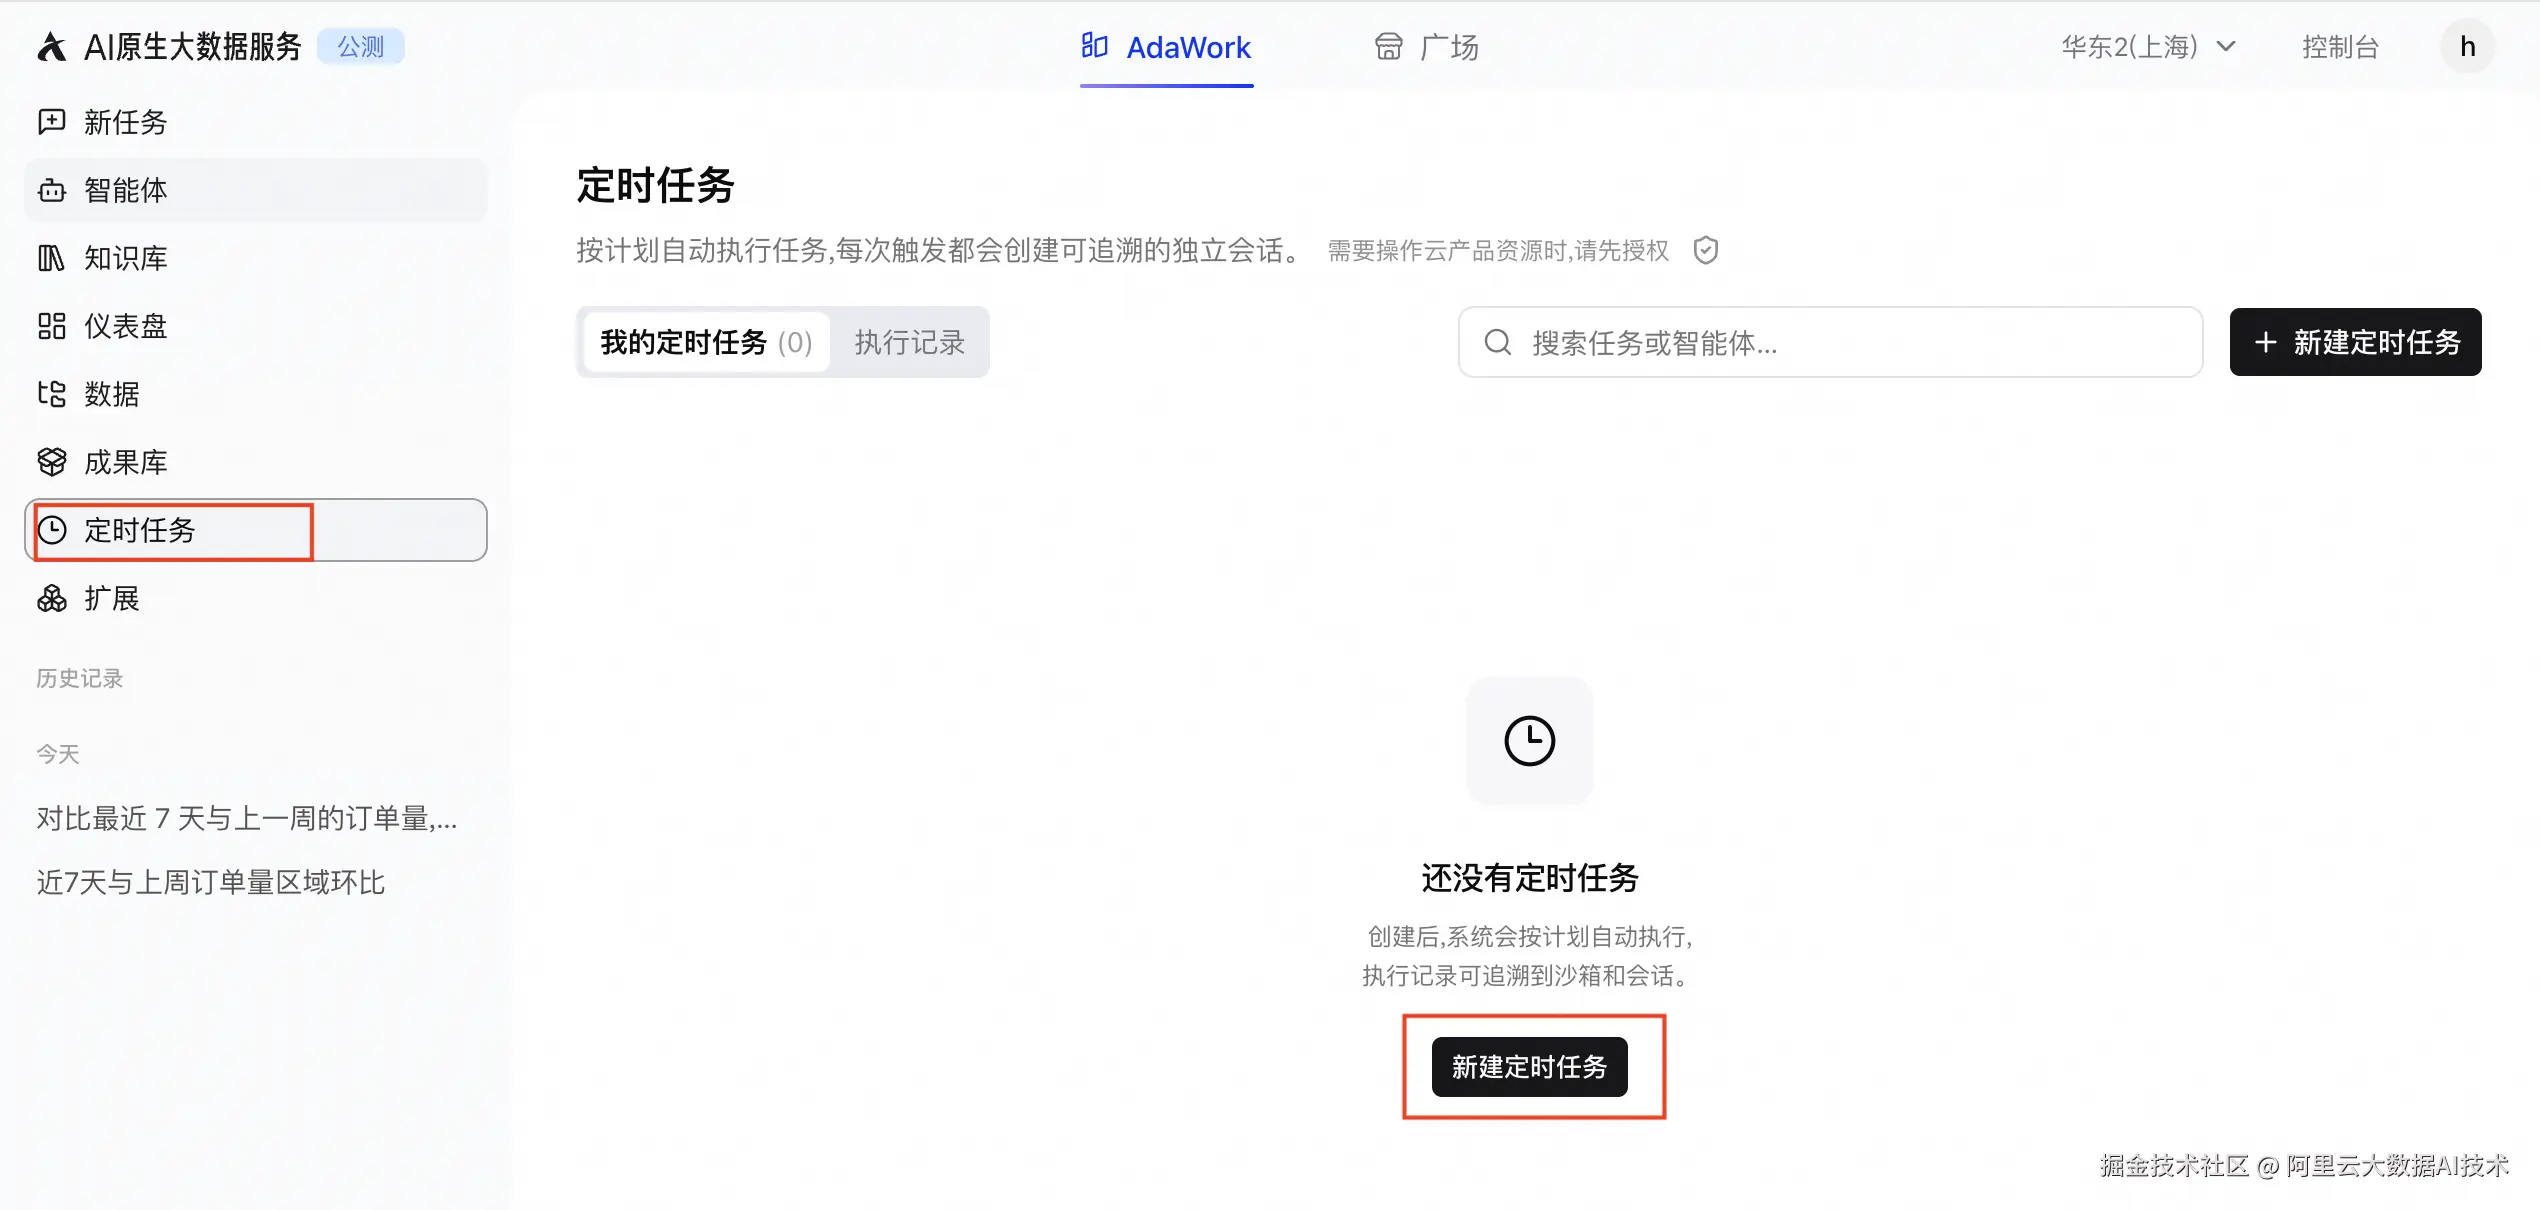
在工作台左侧菜单进入 定时任务 ,点击 新建定时任务 ,将上述验证过的分析逻辑配置为周期性任务。
-
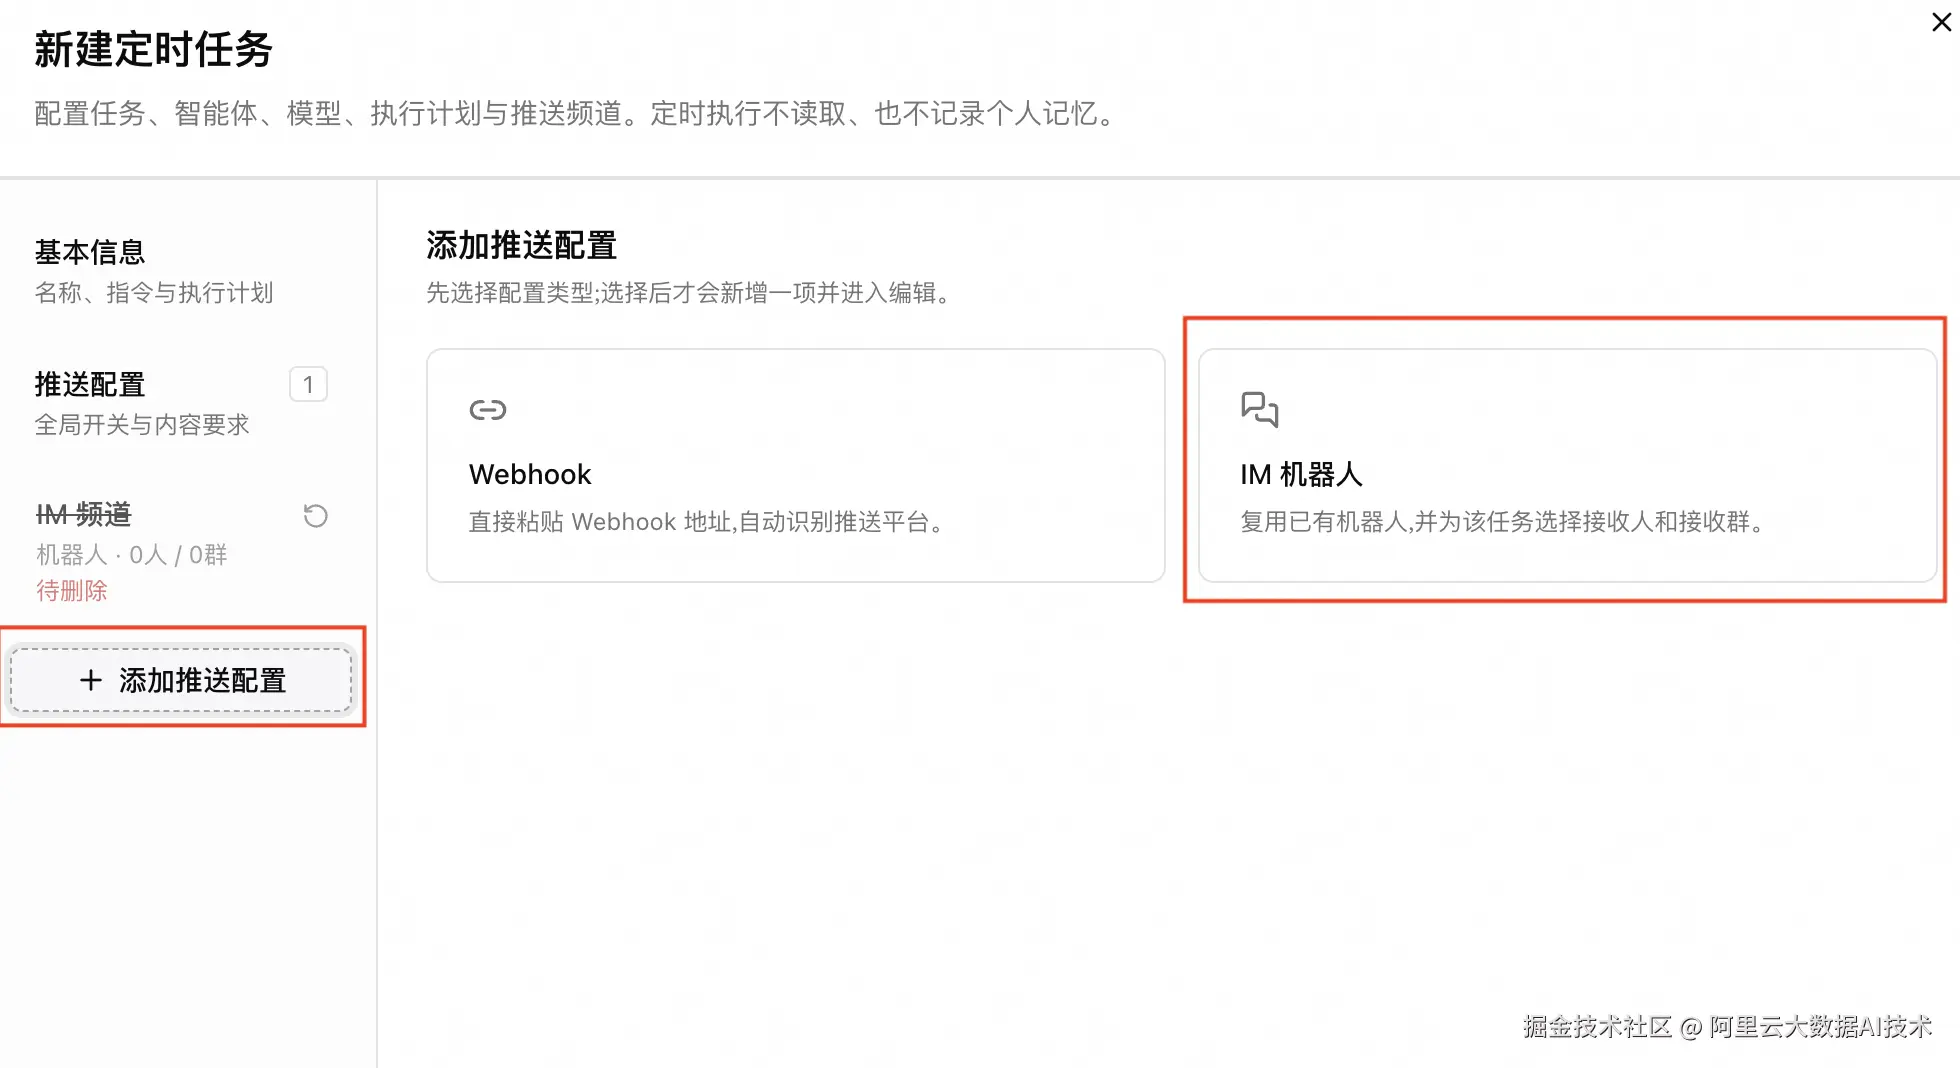
配置消息触达 :报告自动运行后,需让结论主动触达团队。为任务配置群机器人的 Webhook 地址(支持钉钉、飞书、企业微信,由地址决定),或选择 IM 机器人指定接收人/群。团队在日常沟通工具中即可接收异常预警。
✅ 完成标志:定时任务出现在"我的定时任务"中,状态为"运行中"并显示下次执行时间。若未按时触发,可前往"执行记录"查看状态与报错信息。
其他数据接入方式(替换步骤二)
若您的数据已存在于数仓或指标口径已沉淀,可采用以下进阶方式替换步骤二,步骤三及后续操作完全一致。
场景 A:数据已在 MaxCompute、Hologres 等引擎实例中
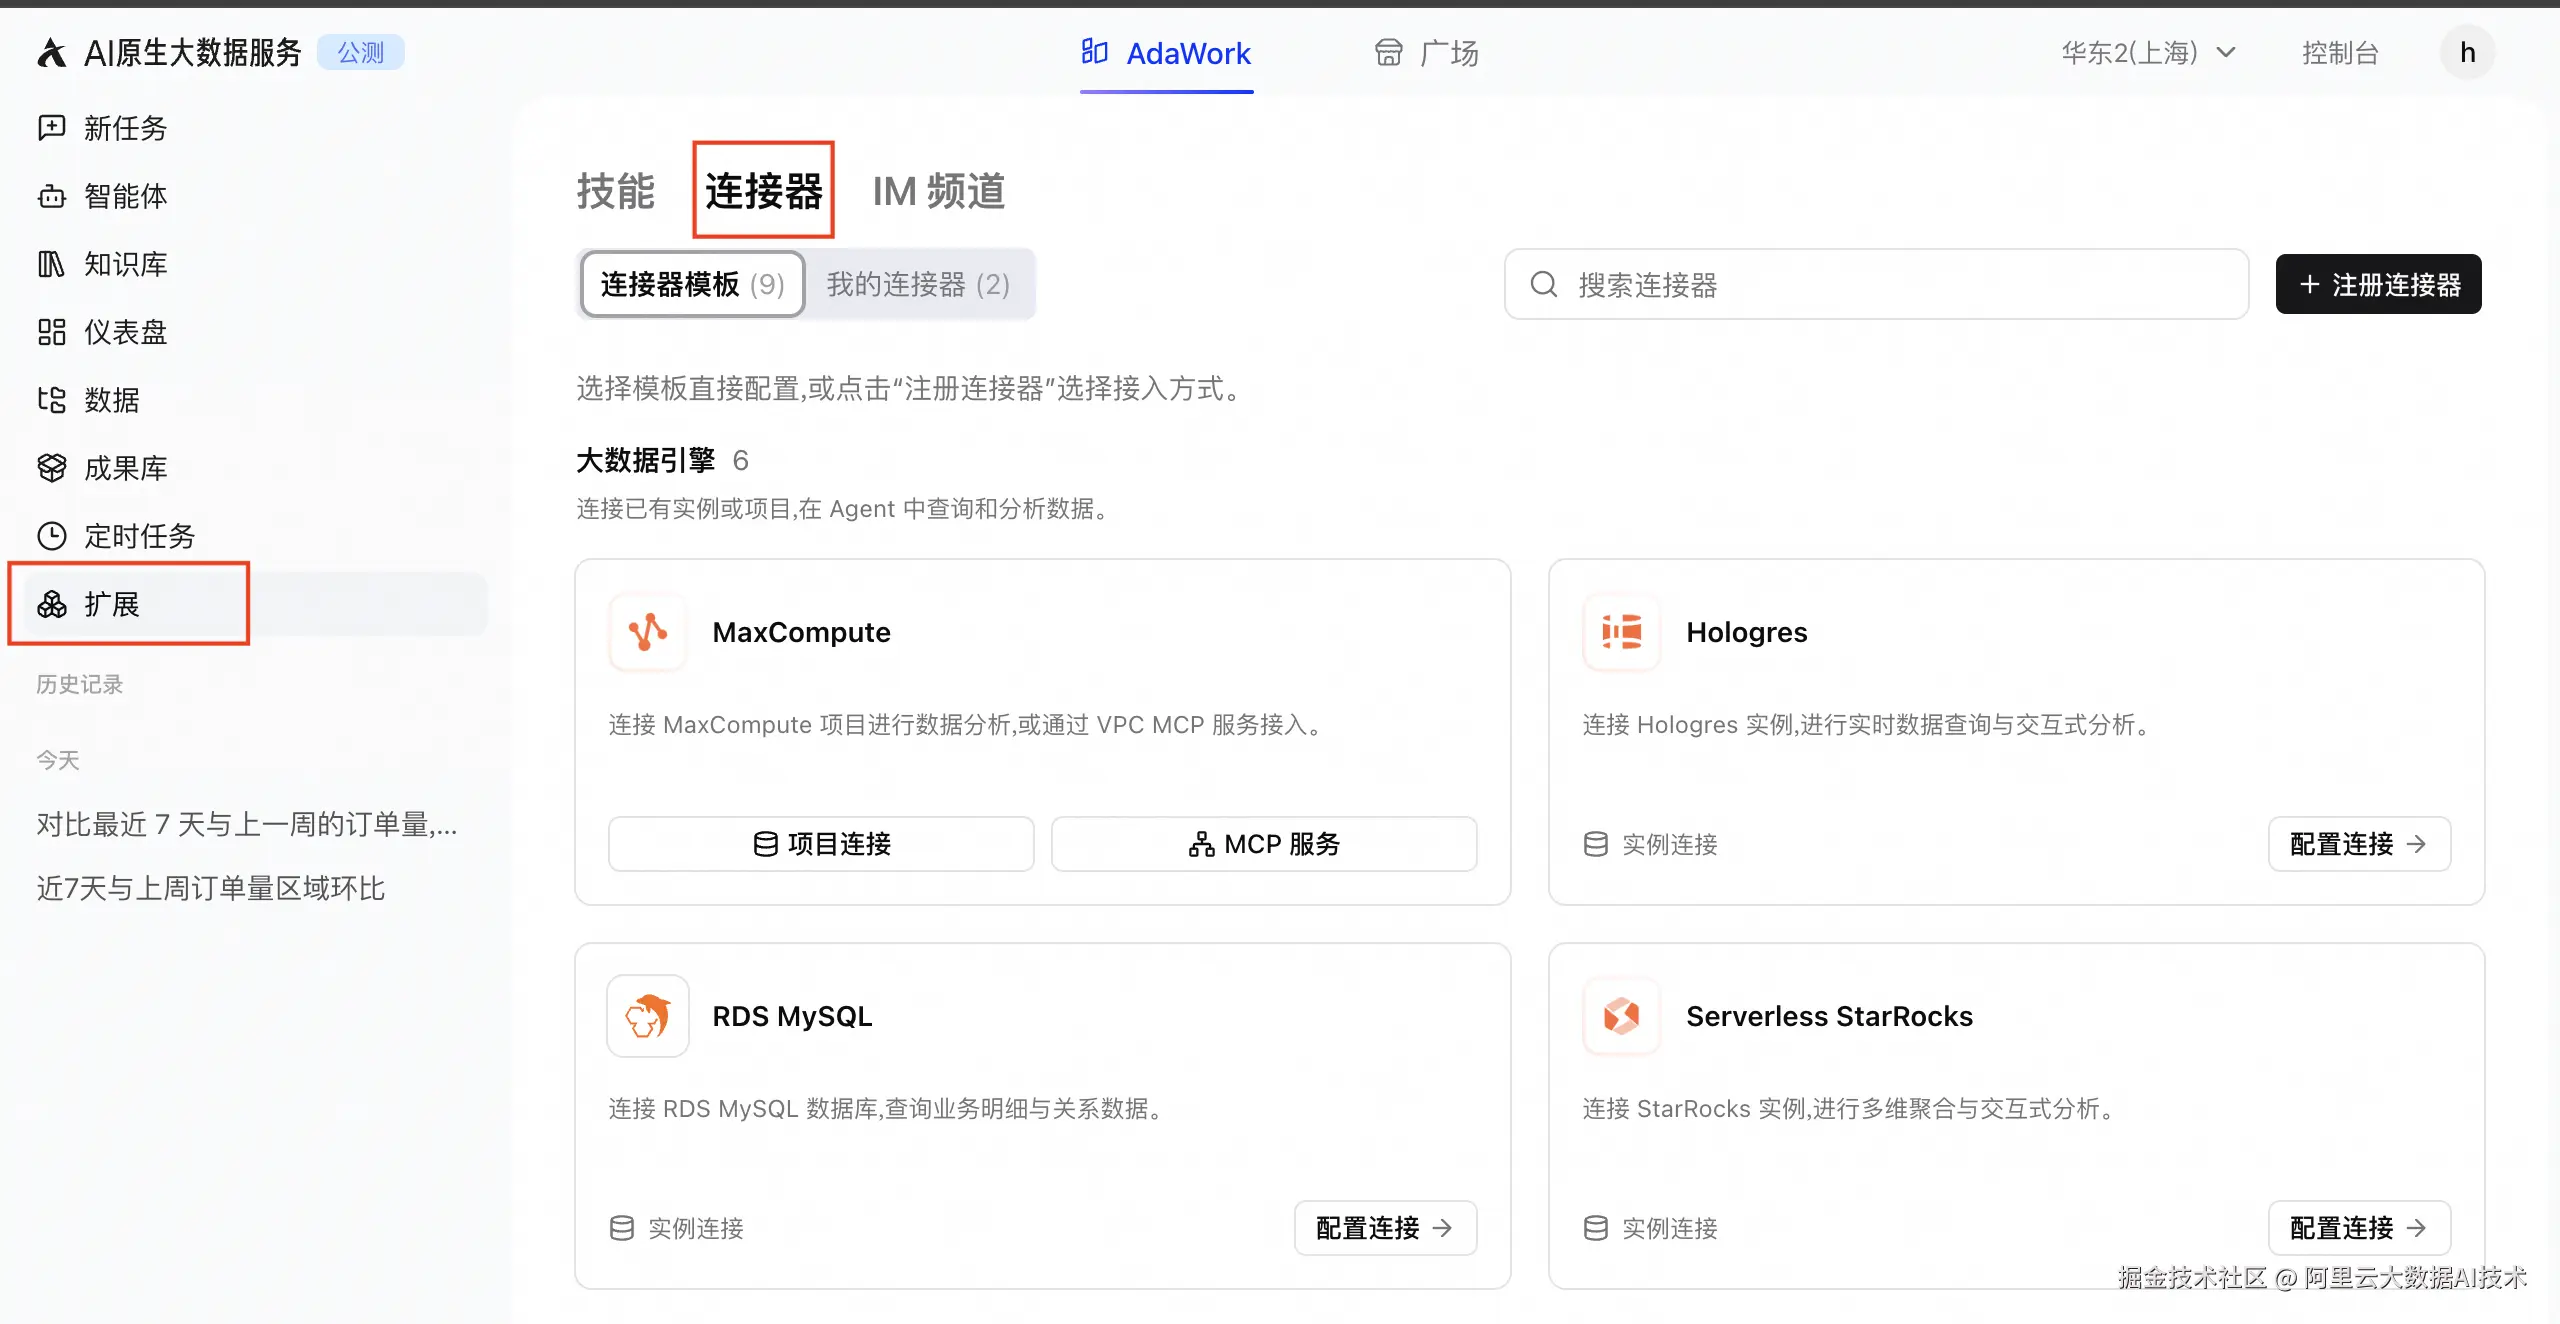
通过"连接器"直连取数。连接器是 ADA 与引擎实例间的接入配置,注册一次可长期复用。
-
操作路径 :侧边栏 扩展 -> 连接器 -> 注册连接器。服务类型选择"大数据引擎",确认地域并选中实例,填写数据位置与访问凭据。
-
关键提示:
-
描述必填且精准:如"电商运营组订单明细,用于区域订单分析"。智能体依赖此描述判断调用时机,描述过泛会导致误选。
-
地域一致性:若实例列表为空,请核对控制台当前选择的地域。
-
保存后,在"新任务"的"添加内容"中挂载该连接器即可。(详见 新建数据连接)
-
场景 B:指标口径分散在业务文档中
建立"知识库"统一口径,适用于"活跃用户"等同一指标在不同部门定义不同的情况。
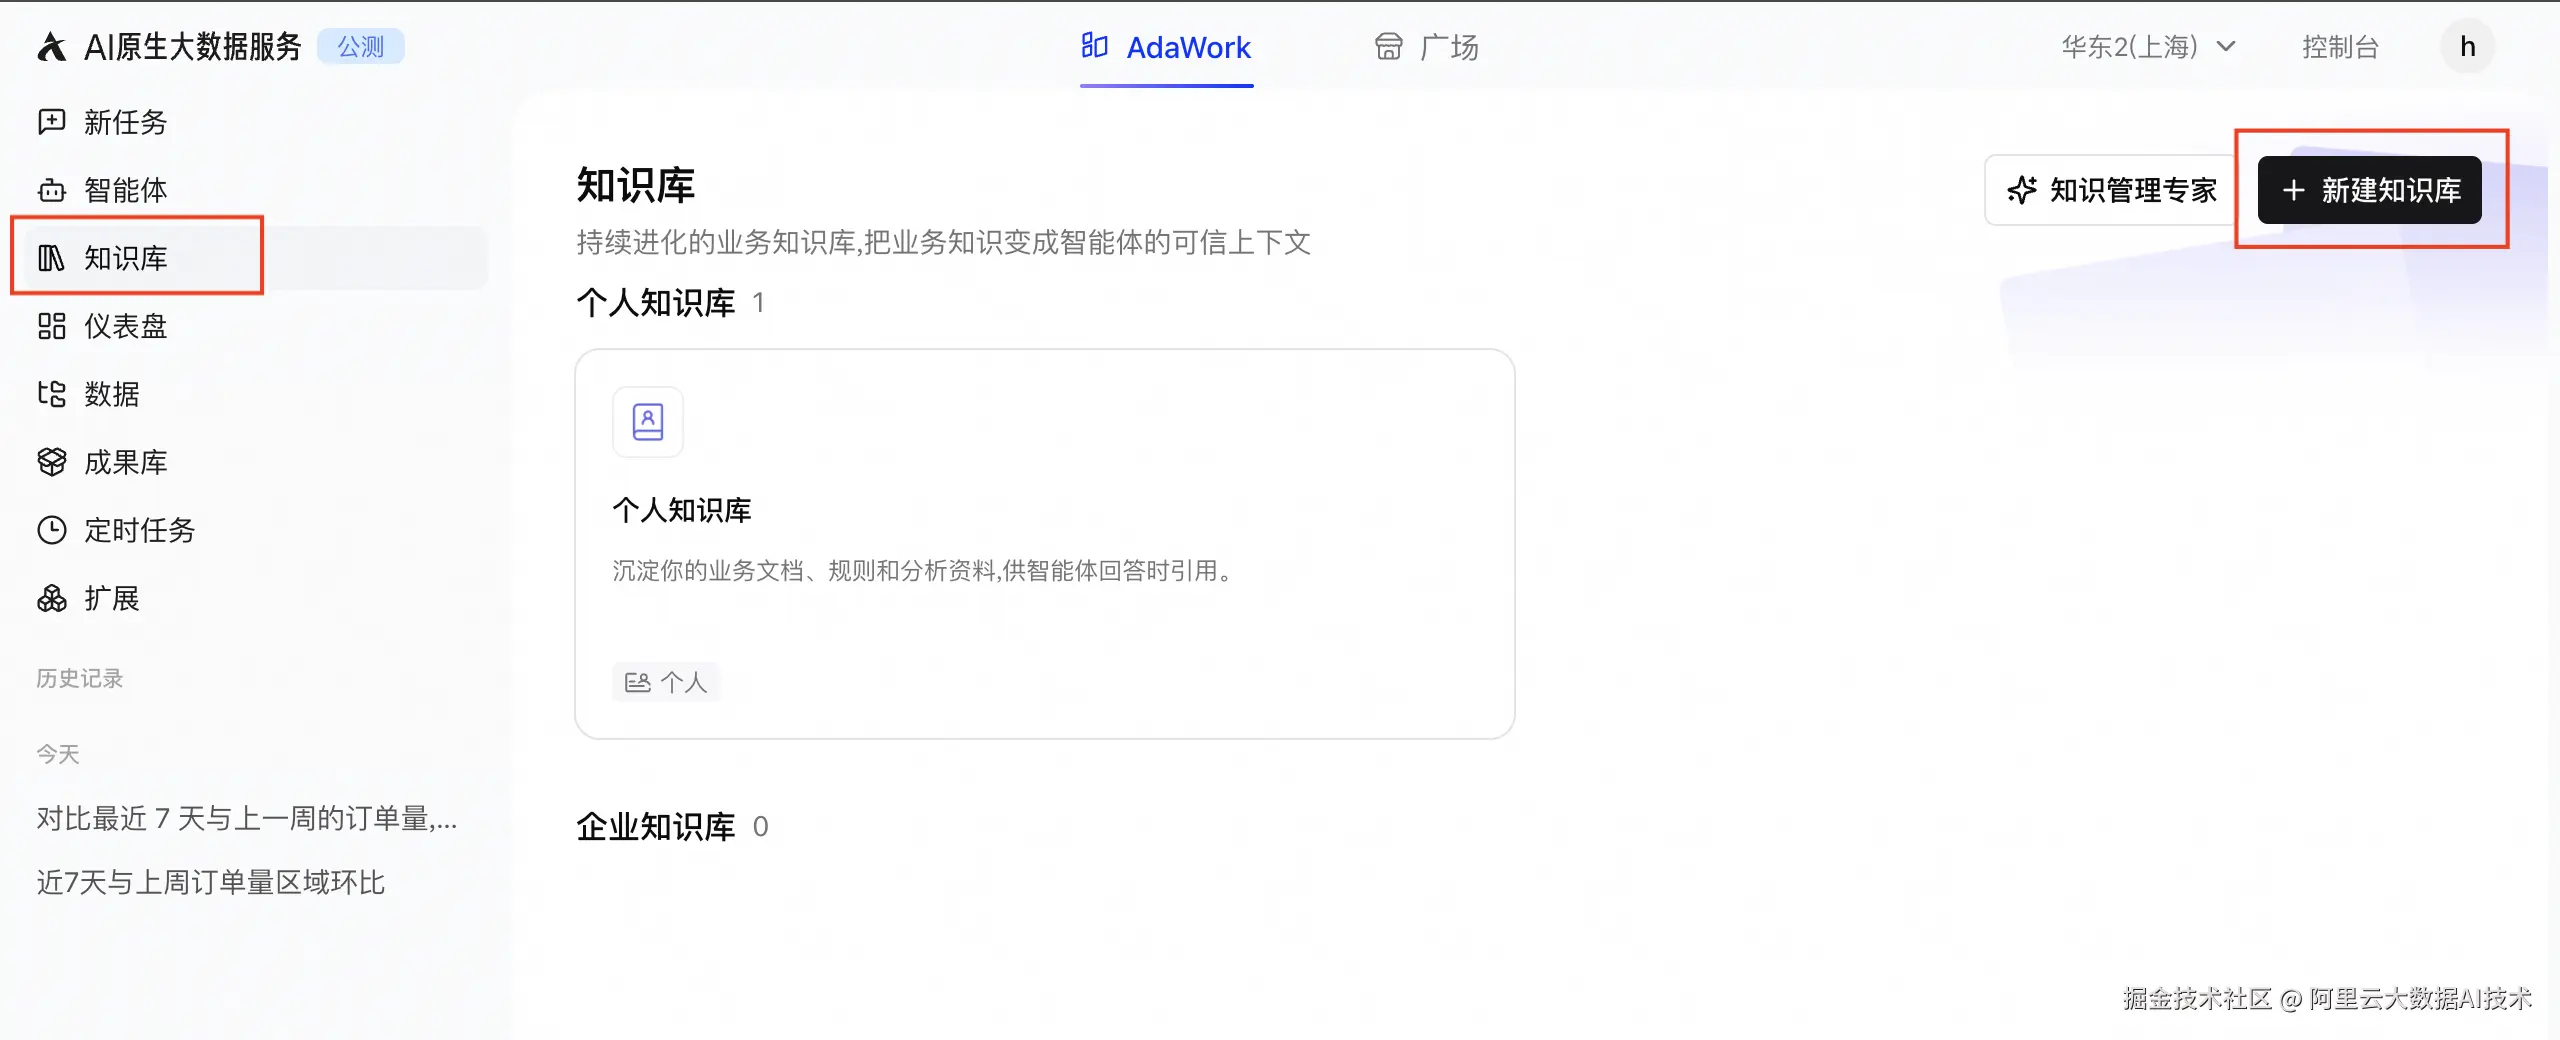
-
操作路径 :侧边栏 知识库 -> 新建知识库,上传指标定义、区域划分规则等文档。等待 Wiki 构建完成后,在"添加内容"中绑定。
-
关键提示:
-
绑定知识库后,Ada 的回复会带上 Wiki 引用(可展开查看引用的具体口径定义),而仅上传表格时不会出现此引用。
-
知识库提供的是"口径"而非"业务数据",因此需与"上传表格"或"连接器"搭配使用,并在提问时明确要求"按知识库中的口径统计"。
-
总结与下一步
至此,您已完成数据接入、对话式分析、逐层追问与自动化固化四大环节,跑通了从"业务问题"到"过程可核对结论"的完整闭环。
注:直接上传表格适合快速验证流程,但指标口径的准确性依赖知识资产的完整度。在复杂指标场景下,仅靠表结构推断可能出现偏差,且结论不会带口径引用。
接下来,建议您根据业务重心选择以下方向继续探索:
-
规范指标口径:将高频指标定义录入知识库,让分析结论自带口径引用,提升准确性。
-
直连企业数仓:将本次分析的本地表格替换为引擎实例直连,实现海量数据实时分析。
-
扩展智能体能力:按业务场景订阅对应引擎的官方专业 Agent。
-
管控成本与权限:了解计费规则,配置企业级安全与合规策略。