专栏 :S3|Redis 核心机制与高级特性 · 第 3 篇|难度 ⭐⭐⭐⭐
版本基线 :Redis 8.10.3(Windows x64 portable),文中「实测」都是在这个版本上跑出来的
代码基线:.NET 10(10.0.300)+ StackExchange.Redis 2.10.1
先说一个我自己被绕进去的现场。一台 2GB 的实例,跑的是 noeviction,大促前谁也不敢动它。后来业务方说「别再写失败了」,我把策略改成 allkeys-lru:CONFIG SET 是返回 OK 的,可下一秒 evicted_keys 直接跳了 3400 多,used_memory 掉下去、命中率跟着掉一截,值班同学第一反应是「是不是刚才那条命令把缓存清了」。命令没删数据,是策略一换,超限状态下那一轮大规模淘汰立刻开跑。那次之后我改了两个习惯:切策略只挑低峰、内存明显低于上限时切,切完盯半小时再走。
这类判断这篇一次讲清。数据能不能丢,决定候选池是 allkeys-*、volatile-* 还是 noeviction;冷热分布决定算法用 lru、lfu 还是 random;延迟预算决定 maxmemory-samples、maxmemory-eviction-tenacity 和 lazyfree-lazy-eviction 怎么设。范围先划清:这里只讲「内存到顶淘汰谁」,maxmemory 容量规划在 S6-1,命中率治理在 S11-8,删除动作怎么执行(DEL / UNLINK / lazyfree)在 S3-4。
一、四个现象:淘汰的四种面孔
结论可信不可信,先看数据是怎么灌进去的:
- 用
EVAL批量写是错的:脚本里的写不受maxmemory拒绝,脚本执行期也不淘汰,一条脚本能把 2MB 限额打到 6MB; - 用
redis-benchmark或--pipe做容量对照也不对:客户端缓冲同样计入used_memory,只会把淘汰推得更狠。同一份数据,逐条写活了 1267 个,benchmark 灌完只剩 434; - 我最后用的是「命令文件 + stdin」:一条连接、逐条发送,最接近真实业务写入。本文所有实验都是这个写法。
powershell
# 生成 5000 条 SET,每条 value 为 1024 个字符(约 1KB)
$v = 'x' * 1024
$lines = 1..5000 | ForEach-Object { "SET k:$_ $v" }
# 写 UTF-8 无 BOM、LF 结尾:BOM 会被当成第一条命令的一部分
$out = Join-Path $PWD 'sets.txt'
[IO.File]::WriteAllText($out, (($lines -join "`n") + "`n"), (New-Object Text.UTF8Encoding $false))
bash
# -p 指定端口;-a 传密码(生产改用 REDISCLI_AUTH,避免进 shell history)
# 不加 --pipe:批量输入会让客户端缓冲计入 used_memory,实验失真
redis-cli -p 6379 < sets.txt
# PowerShell 等价写法(Get-Content 会剥离行尾终止符,不会把 \r 混进 value)
# Get-Content -LiteralPath .\sets.txt | redis-cli -p 6379现象一:allkeys-lru 的静默淘汰
bash
# 2mb = 2,097,152 字节(与 2m = 2,000,000 不同)
redis-cli CONFIG SET maxmemory 2mb
# 候选池为全部键,按近似 LRU 淘汰
redis-cli CONFIG SET maxmemory-policy allkeys-lru
# 让 evicted_keys 从 0 起算(只清计数器,不清数据)
redis-cli CONFIG RESETSTAT
# 逐条灌入 5000 个 1KB 的 key
redis-cli < sets.txt
# 存活量、淘汰量、内存占用
redis-cli DBSIZE
redis-cli INFO stats | grep '^evicted_keys:'
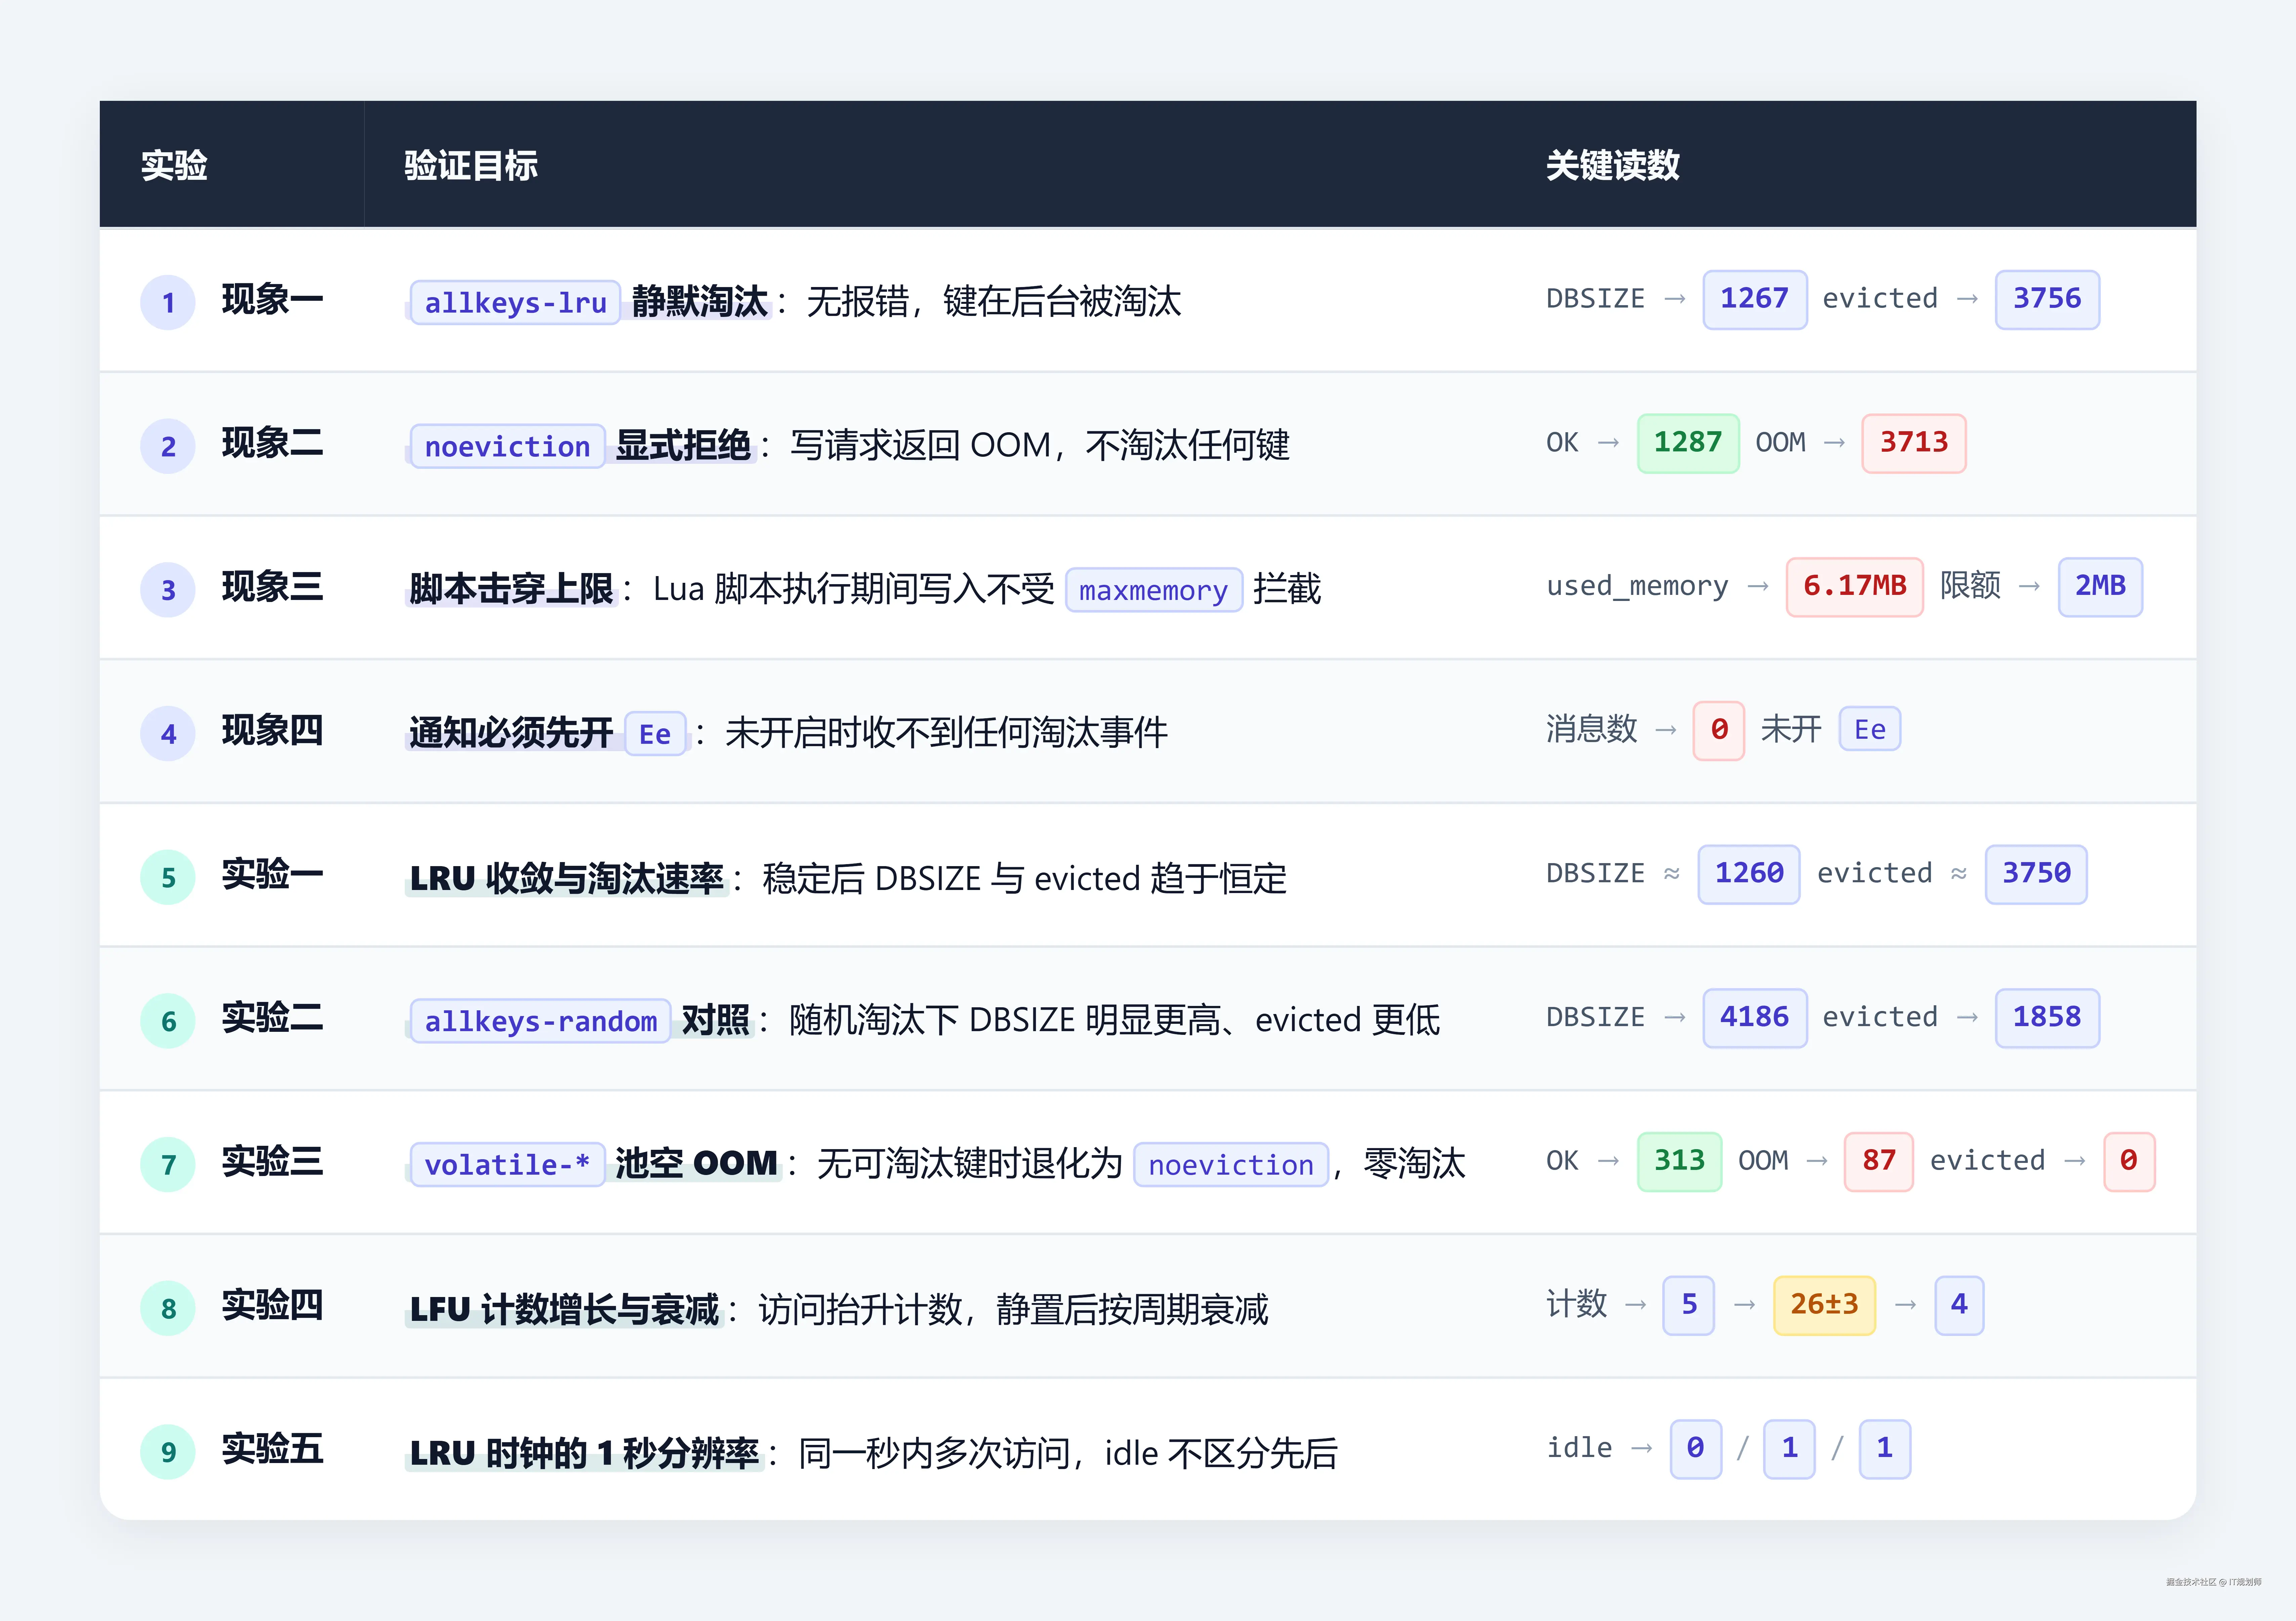
redis-cli INFO memory | grep -E '^(used_memory|maxmemory):'实测:DBSIZE 1267、evicted_keys 3756、used_memory 2096456。写 5000 个只剩 1267,没有报错、没有日志,业务侧完全无感------这就是静默丢数据。5000 - 3756 = 1244,与 1267 差 23 个,不是哪里错乱:两个读数取自不同时刻,所以我的习惯是看「区间 + 收敛后复测」,不拿两个时刻做精确加减。
同一组读数,性质还要看场景。纯缓存里「丢掉了可重建的数据」是设计内的正常行为;如果这套库里放的是队列、归档或协调元数据,同样的读数就是事故。读数本身不分好坏,先看这份数据丢不丢得起。
现象二:noeviction 的显式拒绝
bash
# 只改策略,上限不动,保证前后可比
redis-cli CONFIG SET maxmemory-policy noeviction
redis-cli CONFIG RESETSTAT
# 同一份数据再灌一遍,把每条回复落盘
redis-cli < sets.txt > replies.txt
# 统计成功与被拒(grep 由 shell 执行,不在 redis-cli 内)
grep -c '^OK' replies.txt
grep -c 'OOM' replies.txt实测:OK 1287、OOM 3713、DBSIZE 1287、evicted_keys 0,被拒的返回 OOM command not allowed when used memory > 'maxmemory'.。同一份数据两种故障形态:前者静默丢数据、上游无感,后者显式失败、数据完好。选型第一步其实是问自己更能接受哪一种。
现象三:一条脚本击穿内存(本篇最重要的例外)
bash
# noeviction + 2mb,脚本内一次写 5000 个 1KB 的 key
redis-cli EVAL "for i=1,5000 do redis.call('SET','s:'..i,string.rep('x',1024)) end return 'done'" 0
# 脚本不检查 maxmemory:看内存被推到多少
redis-cli INFO memory | grep -E '^(used_memory|maxmemory):'
redis-cli DBSIZE
# 脚本之外的一条普通写命令才会被拒
redis-cli SET probe v
实测:EVAL 返回 done,used_memory 6,173,874,上限只有 2,097,152,将近 3 倍。这个数我跑了两遍,第二遍是 6,271,363,差 1.6%,属于分配器波动,所以对外我只报「约 6MB、近 3 倍」这种量级,不报个位。DBSIZE 5000,随后 SET probe 报 OOM。
这件事有三个后果:别拿 Lua 灌数据做容量压测;OOM 只在脚本之外生效,脚本里怎么写都不会被拦;脚本真能把内存打到 OS 层,到那一步进程可能被 OOM Killer 杀掉,而且不可逆。
现象四:订阅淘汰事件需先开门
bash
# E = 键事件总线,e = 淘汰事件,两个字符缺一不可(默认空 = 全关)
redis-cli CONFIG SET notify-keyspace-events Ee
# 订阅会占用当前会话,进入订阅模式后不能再发别的命令
redis-cli SUBSCRIBE __keyevent@0__:evicted
# 另开会话制造淘汰:压上限并灌数据,订阅端才会收到消息
redis-cli CONFIG SET maxmemory 2mb
redis-cli < sets.txt
这里的失效条件很隐蔽:没开 Ee 时订阅照样建立成功,只是消息永远为空。我第一次试的时候盯着屏幕等了两分钟,差点得出「通知不可用」的结论。
真到线上,我一般按这个顺序看:evicted_keys 在涨,先看 maxmemory_policy 是不是被人改回去了,再看命中率;如果报的是 OOM 而策略又是 volatile-*,八成是没有带 TTL 的键可淘汰------池空了,它当场就是个 noeviction;命中率低、淘汰又高,说明策略在误杀;突发热点(最近热、但并不频繁)只能靠 LFU 兜,LRU 保不住;最后一条别忘了,任何 volatile-* 的前提都是键上真有 TTL。
二、机制:谁触发、在哪跑、哪儿不跑
淘汰这件事有明确的保证边界。保证的是:maxmemory > 0、策略非 noeviction、且当前是「可能增大内存」的写命令时,服务端会在执行该命令前尝试腾一点空间。不保证的是:淘汰的是全局最优解(LRU/LFU 都是采样近似),也不保证命中率不下降。
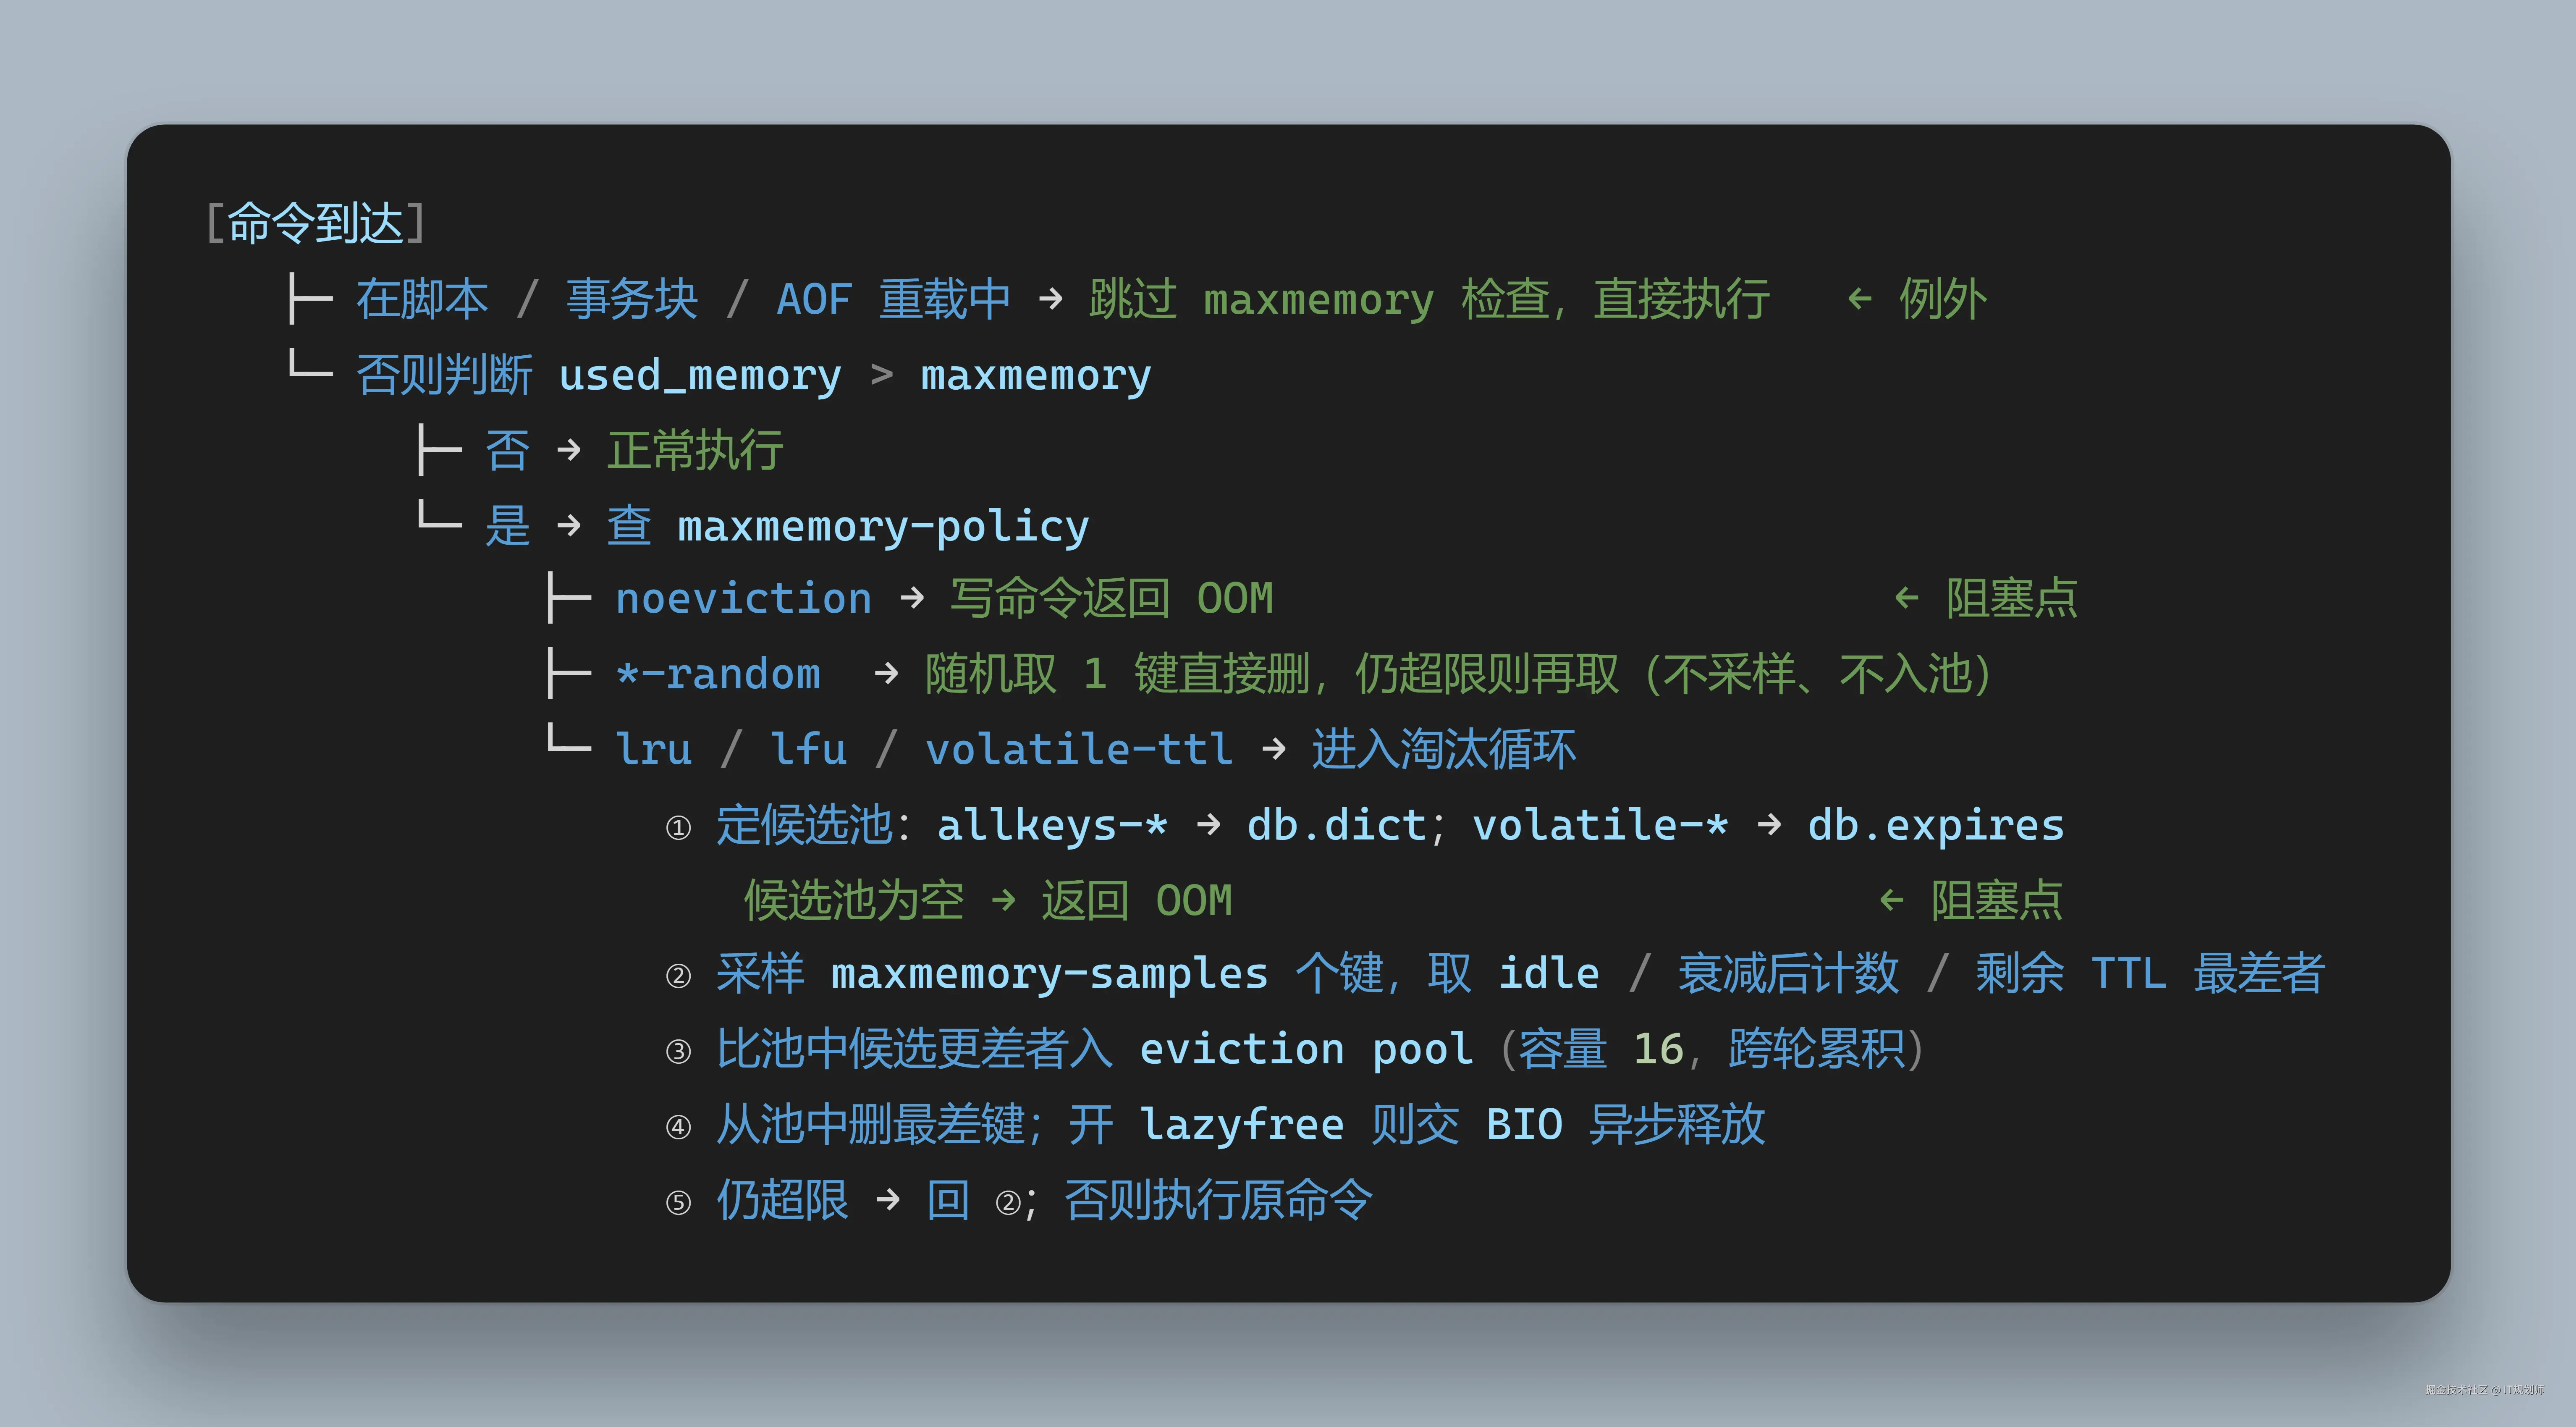
触发时机的准确说法是:写命令必查,读命令实测不查。我把 2MB 限额用脚本灌到 5.25MB,然后连发两条 GET,evicted_keys 前后都是 0,内存随后才回落------回收不止「命令执行前」这一条路径,具体时机属待用 redis-cli 验证。所以「每条命令前都会腾空间」说得太宽,「空闲时绝不淘汰」也不成立:超限内存最终会被回收,只是不保证在哪一刻回收完。顺带一句,maxmemory 0(默认值)表示不限制,这时候策略形同虚设,配了也不生效。
key 消失有三条路径:主动删除(DEL / UNLINK,S3-4)、过期回收(S3-2)、内存淘汰(本篇)。淘汰不看过期时间,所以「没设 TTL 的 key 永远不会被删」这句话是错的。
三条例外路径(最该记住的一节)
① Lua 脚本 (EVAL / EVALSHA / FCALL):执行期间既不拒绝也不淘汰(实测近 3 倍),结束后由后续命令压回------这解释了「脚本刚跑完 DBSIZE 很大、过一会儿变小」。这么设计是为了保住脚本的原子性,代价由调用方守:脚本内循环写的条数要有上限(单 key 大小 × 条数 ≤ 剩余内存)、禁止拿脚本灌数据压测、用 used_memory_peak 看历史峰值。
② 事务块 (MULTI / EXEC):检查落在 EXEC 这一条命令上,块内逐条不再各查,超大事务能一次越过上限;区别是事务无回滚,某条报错不影响其余命令。
③ AOF 重载 / RDB 载入 :载入期以尽快读回数据为目标,不淘汰。所以「重启后内存瞬间高于 maxmemory、随后被压回」是正常现象,不是内存泄漏。
所以别把 maxmemory 当成铁门槛。它是稳态线:脚本、事务、重启载入这三条路都能临时越过去,也都有官方理由------脚本要原子、事务要成组、载入要快。真正把你顶死的通常不是这三条,而是客户端缓冲和一次手滑的 CONFIG SET。
三、配置与观测
默认值别信文档、也别信我这张表,一律用 CONFIG GET 复核------社区版、云厂商、发行版都动过它:
它们全部可热改、即时生效,这也意味着热改 maxmemory 要先评估水位:一次调低很多会立刻触发大规模淘汰,主线程被连续占用,表现就是秒级毛刺。
8 个合法值按「候选集 × 算法」记,比死记名字管用:
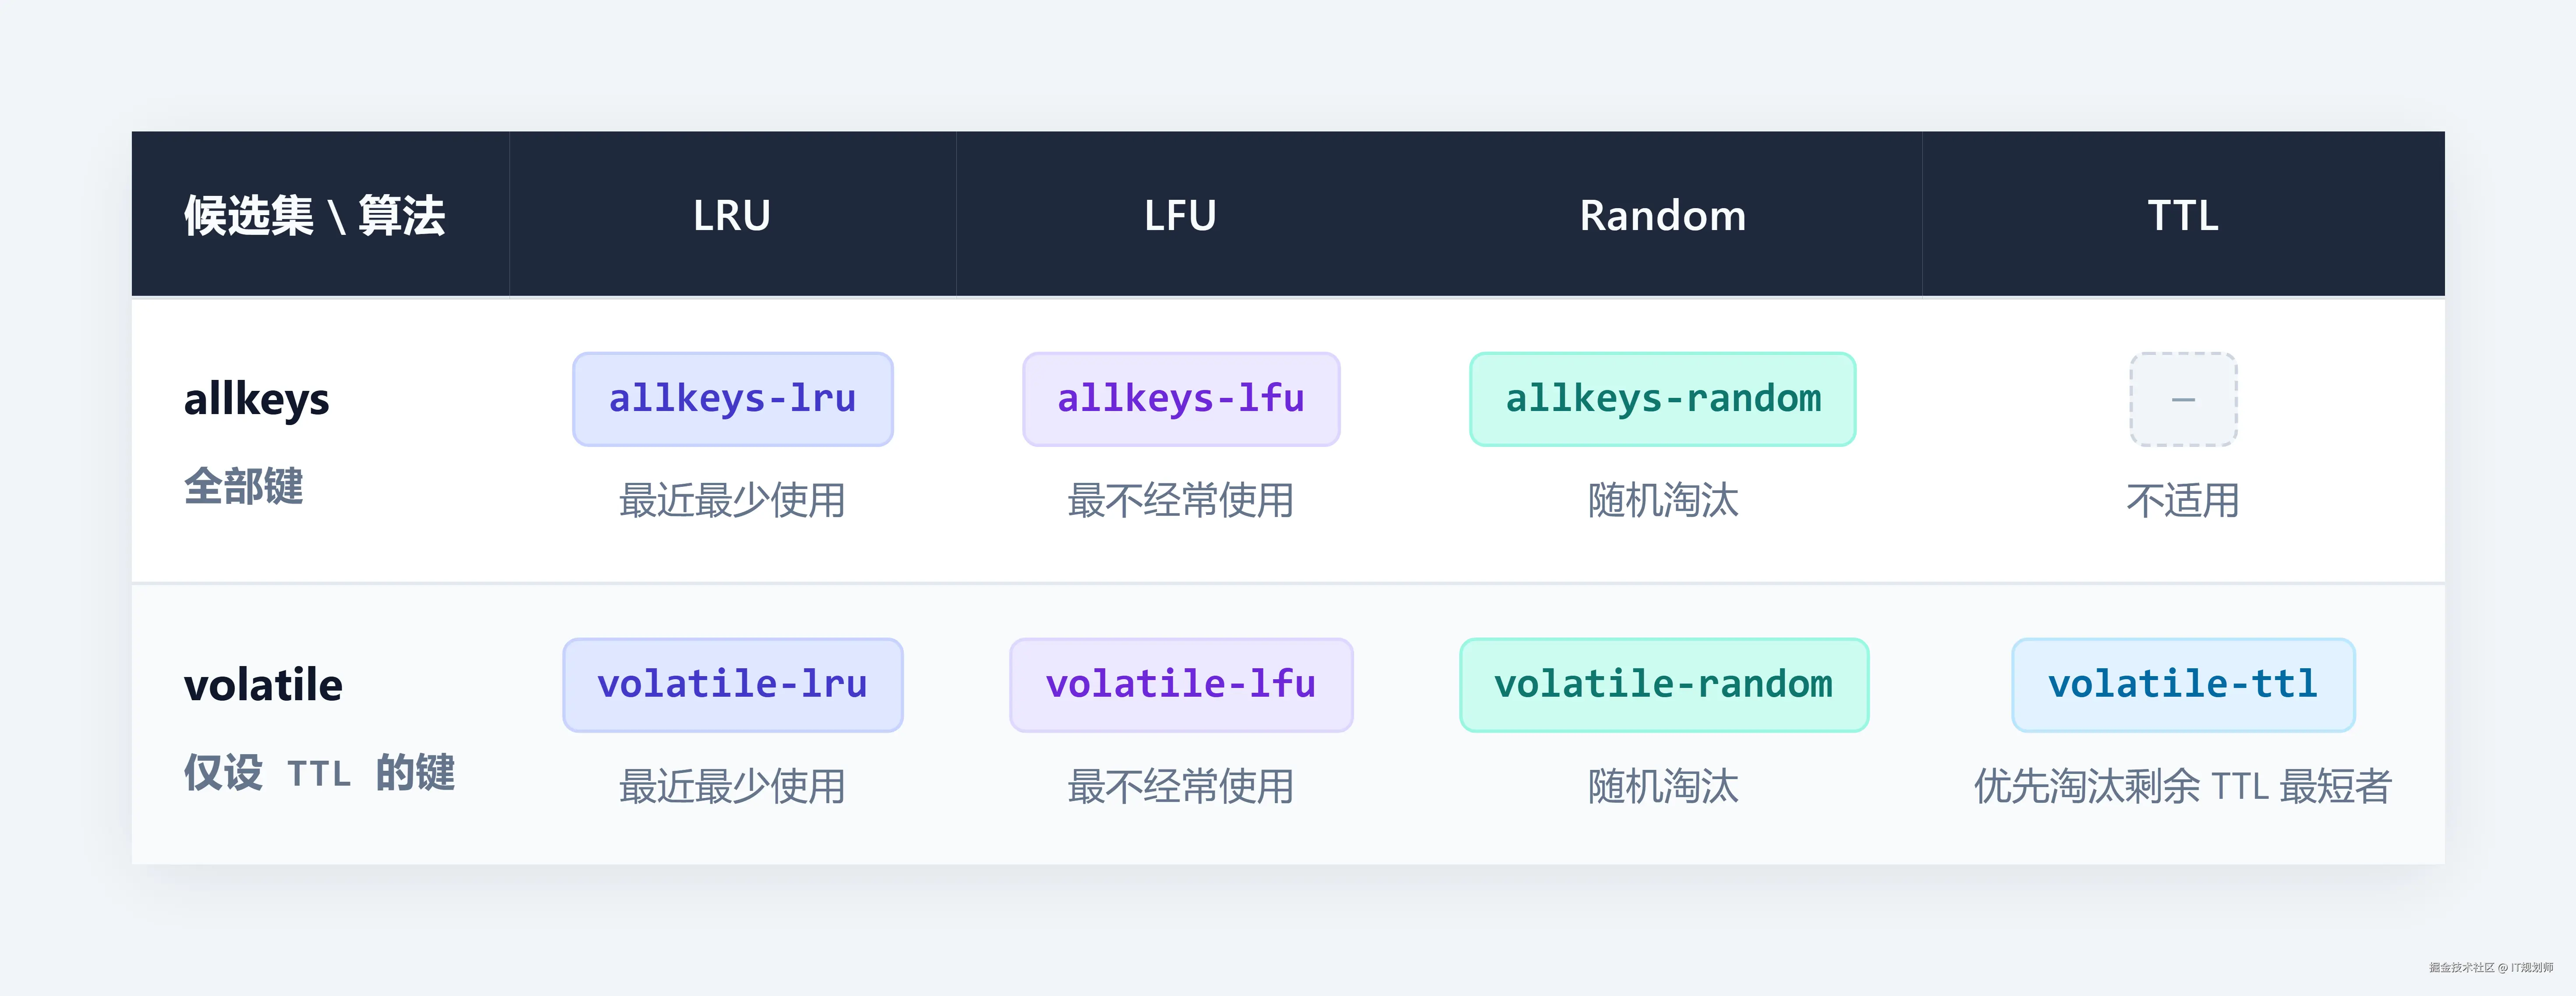
加上 noeviction 一共 8 种。几个容易记混的点:allkeys-* 的候选是全部键(含无 TTL 的),所以它能淘汰一切,包括你不该让它碰的锁;volatile-* 只碰带 TTL 的键,不设 TTL 的配置类数据确实安全------好处和坏处是同一件事,缓存键一旦漏设 TTL,候选池就被饿死,写不进去还删不掉,第 6.2 节和坑 1 讲的是同一个病;*-random CPU 最省、命中率最不可控;volatile-ttl 完全不看热度。
先看观测该看什么:
bash
# memory 段:used_memory 会略低于上限,不会刚好等于
redis-cli INFO memory | grep -E '^(used_memory|used_memory_peak|used_memory_human|maxmemory|maxmemory_policy):'
# stats 段:evicted_keys 是自启动以来的累计值;两个 exceeded_time 是 7.0+ 字段,单位毫秒
redis-cli INFO stats | grep -E '^(evicted_keys|keyspace_hits|keyspace_misses|total_eviction_exceeded_time|current_eviction_exceeded_time):'
# OBJECT 与当前策略绑定:策略不匹配就直接报错,不给无意义的值
redis-cli OBJECT IDLETIME k:1
redis-cli OBJECT FREQ k:1
# 辅助工具:--lru-test 模拟命中率;--hotkeys 求热点(需 LFU);--latency 看毛刺
redis-cli --lru-test 100000
redis-cli --hotkeys
redis-cli --latency -i 1关键读数就两个:used_memory:2096456 / maxmemory:2097152。它略低于上限,不会与 maxmemory 完全相等------淘汰是「每次先腾再写」,写进去的那条命令本身也要占空间,所以内存停在略低于上限的位置是必然结果,不是什么泄漏。
OBJECT 的两句报错原文,比任何文档都好用:
- LFU 策略下查空闲时间 →
ERR An LFU maxmemory policy is selected, idle time not tracked. Please note that when switching between policies at runtime LRU and LFU data will take some time to adjust. - 非 LFU 策略下查访问频率 →
ERR An LFU maxmemory policy is not selected, access frequency not tracked. Please note that when switching between policies at runtime LRU and LFU data will take some time to adjust.
这两句同时说明了一件容易被忽略的事:切策略不重置已有对象的元数据,旧字段会被按新语义解释------我实测切到 LFU 后,旧键 OBJECT FREQ 立刻返回 0。第八节讲热切换,依据就在这里。
四个参数最容易被混淆,逐个说:
maxmemory-samples是「每轮采几个」,不是「总共淘汰几个」;对*-random完全无效。lfu-log-factor越大越难涨、饱和越慢。官方redis.conf注释给了 factor=10 的对照:100 次访问≈10、1000 次≈18、10 万次≈142、100 万次=255。这张小表直接决定「预热值不值」------后文 6.3 算预热成本时用的就是它。lfu-decay-time是衰减周期(分钟),0表示永不衰减。实测计数为 5 的键静置 65 秒后变 4。volatile-ttl比的是剩余 TTL,而不是「谁更早被淘汰」:TTL 剩 1 小时的冷键会排在剩 1 分钟的热键之前被淘汰。它和 LRU/LFU 共用evictionPoolPopulate的同一条采样池,是近似、不是精确。
参数该怎么设,我整理了张表:
落到动作上就一句:先钉 maxmemory 和策略,samples 保持 5,等命中率真证明了精度不足再动 8~10。超过 15 之后收益边际递减、毛刺反而上涨,我网上看到的「调到 20 更准」的说法,实测代价不值。
四、亲手验证:五组实测
测量条件先说清:8.10.3、单机、无持久化无复制、value 为 1KB 或 512B 字符串、逐条写(命令文件 + stdin)。数字是收敛后复测的,允许 ±5% 波动------这类实验受分配器和时刻影响,追求到个位没有意义。
实验一:LRU 的收敛与淘汰速率
bash
# 从干净状态开始;大库可用 FLUSHALL ASYNC(见 S3-4)
redis-cli FLUSHALL
# 钉住上限、策略与采样数,再清零统计
redis-cli CONFIG SET maxmemory 2mb
redis-cli CONFIG SET maxmemory-policy allkeys-lru
redis-cli CONFIG SET maxmemory-samples 5
redis-cli CONFIG RESETSTAT
# 灌 5000 条后取第一次 evicted_keys
redis-cli < sets.txt
redis-cli INFO stats | grep '^evicted_keys:'
# 再灌一轮维持压力,间隔 1 秒取第二次(PowerShell 用 Start-Sleep -Seconds 1)
redis-cli < sets.txt
sleep 1
redis-cli INFO stats | grep '^evicted_keys:'读数怎么读:绝对值不重要,淘汰是否持续发生才重要。写入停止后速率归零属稳态,不代表策略失效。数字不对只有三种可能,我按顺序排了:evicted_keys 为 0,说明根本没到顶(顺手核对单位,2m 与 2mb 差 4.8%,大小写倒是无所谓);DBSIZE 停在 5000,说明你是用 EVAL 灌的;DBSIZE 只有三百多,那是用 redis-benchmark 或 --pipe 灌的。
实验二:allkeys-random 对照
3mb + 6000 条 512B:DBSIZE 4186、evicted 1858、used_memory 3,145,376。均匀访问下 random 与 lru 的存活量接近(数据量除以单键开销就是理论上限),差别只在有热点时------lru/lfu 能把热键留下,random 不会。本实验不用设 maxmemory-samples,random 不采样。
实验三:volatile-* 候选池耗尽
两个小数据文件用同一条 PowerShell 思路生成,省得手敲键名敲错:
powershell
# sets400.txt:400 条不带 TTL 的 SET,用来打空 volatile-* 的候选池
$v = 'x' * 1024
$lines = 1..400 | ForEach-Object { "SET p:$_ $v" }
$out = Join-Path $PWD 'sets400.txt'
[IO.File]::WriteAllText($out, (($lines -join "`n") + "`n"), (New-Object Text.UTF8Encoding $false))
# gets.txt:2000 条 GET,键名必须与实验四 SET 的键完全一致,写错就得到一个「不涨」的假结果
$gets = 1..2000 | ForEach-Object { "GET lfu:t" }
$out2 = Join-Path $PWD 'gets.txt'
[IO.File]::WriteAllText($out2, (($gets -join "`n") + "`n"), (New-Object Text.UTF8Encoding $false))
# 自查行数:应为 400 与 2000
(Get-Content -LiteralPath $out | Measure-Object -Line).Lines
(Get-Content -LiteralPath $out2 | Measure-Object -Line).Lines
bash
# 1mb + volatile-lru,写入 400 个「不带 TTL」的 key
redis-cli FLUSHALL
redis-cli CONFIG SET maxmemory 1mb
redis-cli CONFIG SET maxmemory-policy volatile-lru
redis-cli CONFIG RESETSTAT
redis-cli < sets400.txt
# 先确认真的已超限,再写一条普通命令看是否被拒
redis-cli INFO memory | grep -E '^(used_memory|maxmemory):'
redis-cli SET probe v
# 复核淘汰计数:候选池为空时 evicted_keys 必须保持 0
redis-cli INFO stats | grep '^evicted_keys:'
读数:313 条 OK、87 条 OOM、evicted_keys 0、used_memory 1,070,338。这就是 volatile-lru 的边界:内存打满却没有带 TTL 的候选键,它直接拒写,不会去删无 TTL 的持久化 key。如果一条 OOM 都没出现,说明还没到顶,先看 INFO memory 两个值差多少,再改实验参数。
实验四:LFU 计数的增长与衰减
bash
# 解除上限(0 = 不限制),本实验只看计数器
redis-cli FLUSHALL
redis-cli CONFIG SET maxmemory 0
# 切到 LFU,并把因子与衰减周期钉成默认值,保证可复现
redis-cli CONFIG SET maxmemory-policy allkeys-lfu
redis-cli CONFIG SET lfu-log-factor 10
redis-cli CONFIG SET lfu-decay-time 1
# 写入后立刻看初始计数(实测 5,这是 LFU 新键的起步值)
redis-cli SET lfu:t v
redis-cli OBJECT FREQ lfu:t
# 用 2000 条 GET 把计数推上去(gets.txt 由同样的命令文件方式生成,键名必须是 lfu:t)
redis-cli < gets.txt
redis-cli OBJECT FREQ lfu:t
# 静置超过 1 分钟:衰减按分钟结算,必须真等够时间
sleep 65
# 不访问再看计数,应比上一次小,证明衰减生效
redis-cli OBJECT FREQ lfu:t
# 自查:decay-time 为 0 时永不衰减,读数不变不是 bug
redis-cli CONFIG GET lfu-decay-time
读数:写入后 5;2000 次 GET 后 26(同样脚本两次实测是 26 和 29,区间 24~29 都算正常);静置 65 秒后 4。所以结论要写区间,不要写死一个精确值------计数器是概率性递增的,越涨越难涨。另外 key 中途被 SET 覆盖会重建对象、计数归零,跑的时候中间别插写操作。
实验五:LRU 时钟的 1 秒分辨率
bash
# 2mb + LRU 策略:OBJECT IDLETIME 只在非 LFU 策略下可用
redis-cli FLUSHALL
redis-cli CONFIG SET maxmemory 2mb
redis-cli CONFIG SET maxmemory-policy allkeys-lru
# 三条命令要在同一秒内发完:连打三条 redis-cli 通常几十毫秒,天然同秒
redis-cli SET same:1 v
redis-cli SET same:500 v
redis-cli SET same:1000 v
# 立刻读空闲时间:单位是秒、且为整数,秒内精度就丢在这里
redis-cli OBJECT IDLETIME same:1
redis-cli OBJECT IDLETIME same:500
redis-cli OBJECT IDLETIME same:1000
读数 0 / 1 / 1:同一批写入的 key 分成两档,说明 LRU 时钟每秒才走一格,秒内的先后完全丢失。Redis 没法判断 same:500 和 same:1000 谁更新,淘汰时只能在样本里随便挑一个。这就是「批量写入的冷数据把热键挤出去」的物理根因(坑 2)。
实测总表(Redis 8.10.3)
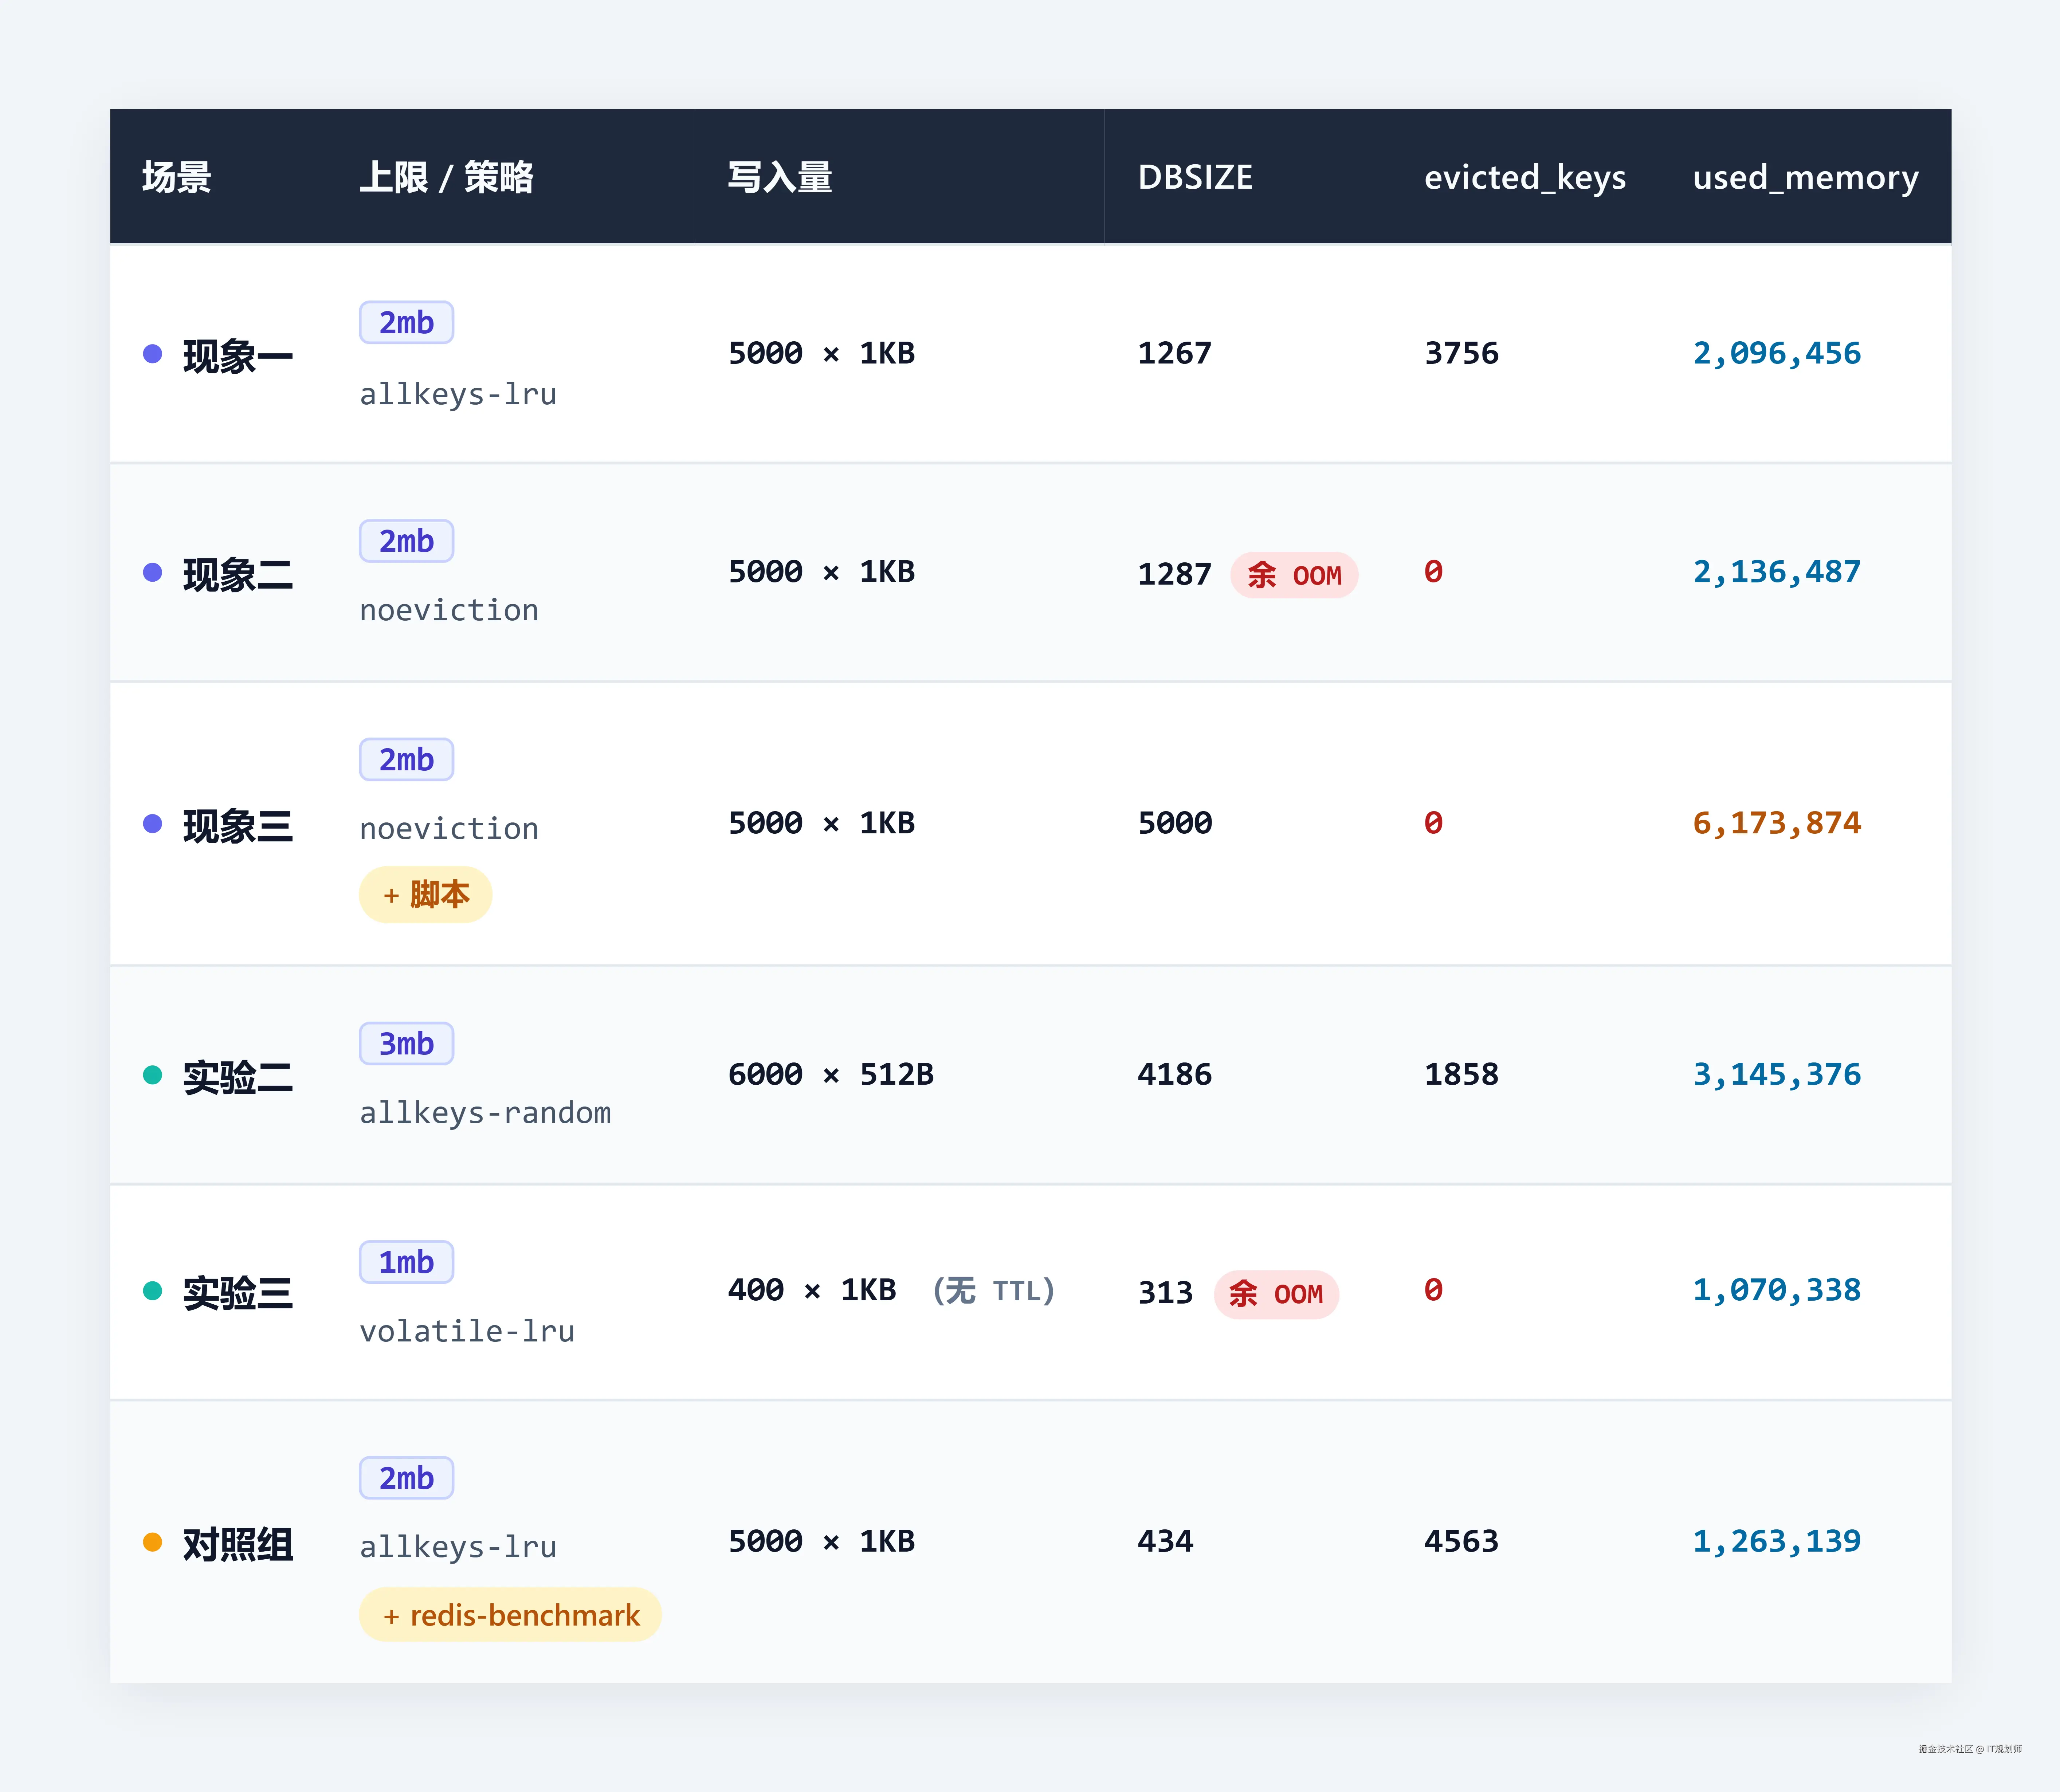
最后一行是我当时最不服气的一组。同样的数据量,用 benchmark 灌进去只剩 434 个 key,比逐条写少了三分之二。我第一次做这个对照以为样本写错了,同一个 sets.txt 重跑三遍才确认:变的不是算法,是客户端的输入/输出缓冲也算进 used_memory,上限被吃掉一大块。从那以后,任何批量工具的容量读数我都打折看。
五、选型矩阵:8 种策略怎么选
这张表是全文选型结论最完整的出处,后面各节只做引用,不再重复展开。
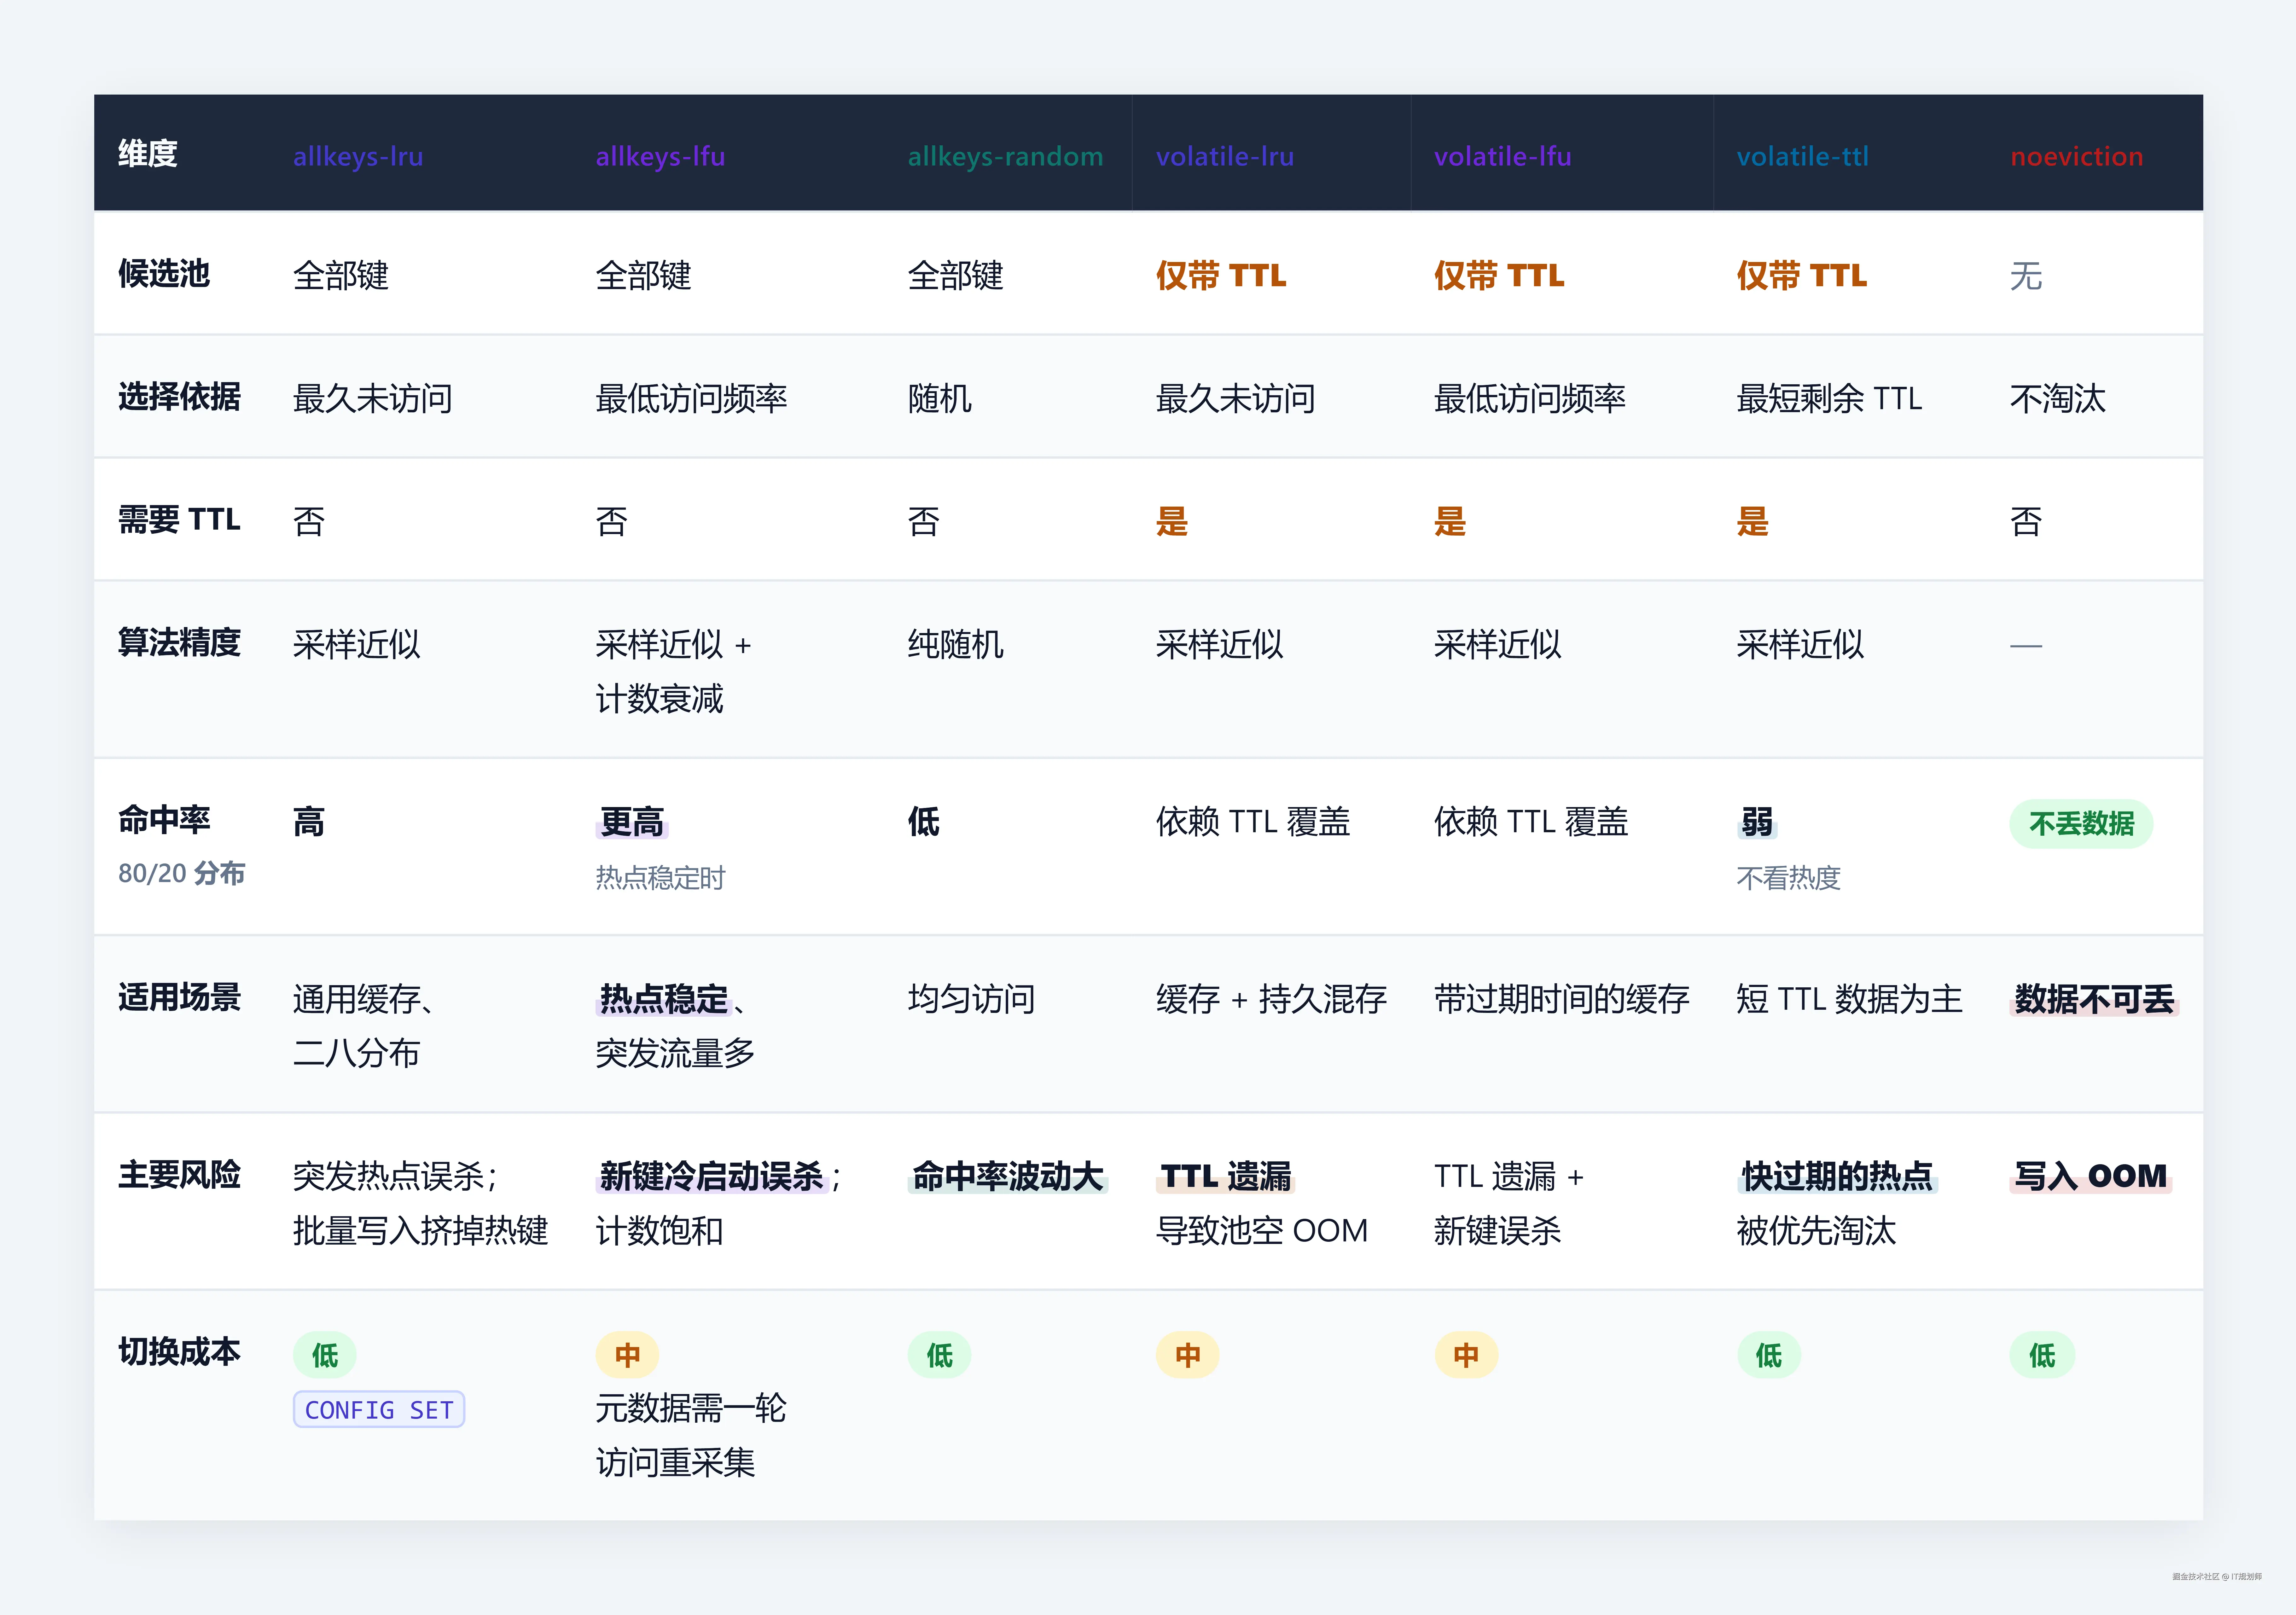
选型没什么玄学,我自己走的顺序是这样:纯缓存先上 allkeys-lru,跑两周看命中率和 evicted/s;有明确热点、且能确认那是「频繁」而不只是「最近」,再换 allkeys-lfu。混合存储我先劝人拆实例------volatile-lru 只有在你敢保证每个缓存键都带 TTL 时才成立,而大多数团队其实保证不了,包括我们早期也没保证住,坑 1 就是这么踩出来的。真不能丢的数据,noeviction 配告警,别指望淘汰帮你续命。日常要记的其实只有两个默认答案:allkeys-lru 与 allkeys-lfu。
还有两条裁决,常被问起:一是没有绝对好坏,取决于有没有 key 不能丢------全部可丢就 allkeys-lru(候选池更大、命中率更稳),有部分不能丢就拆实例,或者给它们不设 TTL 配 volatile-*;二是 LFU 不一定比 LRU 好,访问频率差异大时 LFU 更好,访问模式均匀或频繁变化时 LRU 更稳,笼统说「LFU 更先进」是不成立的。
六、生产落地:四个场景 + 两类边界
下面四个场景都配了可直接编译的 .NET 10 代码(StackExchange.Redis 2.10.1),注释写在行上方,照抄能跑。
6.1 纯缓存实例 → allkeys-lru
需求很典型:一个实例只做缓存,所有 key 都可丢弃,访问符合二八法则,期望命中率 85% 以上。
text
# 纯缓存实例的三行核心配置
# 上限:按节点规格的 70%~75%(不开持久化时)
maxmemory 4gb
# 策略:不确定时的通用起点,不要求 key 带 TTL
maxmemory-policy allkeys-lru
# 采样数:默认 5,先别动
maxmemory-samples 5
csharp
// IDatabase / IConnectionMultiplexer / RedisValue 都在此命名空间
using System;
using System.Threading.Tasks;
using StackExchange.Redis;

// 纯缓存写入器:不设 TTL,回收完全交给 allkeys-lru
public sealed class CacheWriter
{
    private readonly IDatabase _db;

    public CacheWriter(IConnectionMultiplexer muxer)
    {
        // 复用共享连接上的默认库(db 0)
        _db = muxer.GetDatabase();
    }

    public async Task<string> GetOrSetAsync(string key, Func<Task<string>> factory)
    {
        // 先读缓存,命中直接返回,避免不必要的回源
        RedisValue cached = await _db.StringGetAsync(key);
        if (cached.HasValue)
        {
            // 已确认有值,用 null-forgiving 消除可空告警
            return cached!;
        }

        // 未命中回源;并发场景需加 singleflight,否则会集中打库(见 S11-8)
        string fresh = await factory();

        // 回填且不设 TTL:无 TTL 的键同样会被 allkeys-lru 选中淘汰
        await _db.StringSetAsync(key, fresh);
        return fresh;
    }
}
什么时候这套会翻车:二八分布变成突发热点。某个此前冷门的 key 突然被大量请求,LRU 却因为它此前 idle 时间长而把它淘汰,刚热起来就 miss。这种模式频繁出现就别硬扛,换 allkeys-lfu,或者把 maxmemory-samples 提到 10。更致命的一条是整库只要混进一个删不得的 key(配置、锁),allkeys-lru 立即不适用------这不是概率问题,是必然。另外这段代码不保证 85% 命中率,命中率由容量与访问分布决定,策略只决定淘汰谁。
6.2 缓存与持久数据混布 → volatile-lru(慎用)
需求:一个实例既存缓存,也存一些不该丢的配置类数据;缓存 key 设 TTL,配置 key 不设。
text
# 混布场景的两行核心配置
# 上限:2gb;混布时别把上限压满,给配置类数据留空间
maxmemory 2gb
# 策略:只淘汰带 TTL 的键,无 TTL 的键永远安全(但候选池可能被掏空)
maxmemory-policy volatile-lru
csharp
// 异常判定需要 StringComparison,TTL 需要 TimeSpan
using System;
using System.Threading.Tasks;
using StackExchange.Redis;

// 混布写入器:缓存键带 TTL 进 volatile-* 候选池,配置键不带 TTL 保持「不可淘汰」
public sealed class MixedStore
{
    private readonly IDatabase _db;

    public MixedStore(IConnectionMultiplexer muxer)
    {
        _db = muxer.GetDatabase();
    }

    public Task SetCacheAsync(string key, string json)
    {
        // 必须带 TTL:没有 TTL 就不在候选池里,既不会被淘汰也失去缓存身份
        return _db.StringSetAsync(key, json, TimeSpan.FromMinutes(30));
    }

    public Task SetConfigAsync(string key, string json)
    {
        // 配置类数据不设 TTL,volatile-lru 不会选中它
        return _db.StringSetAsync(key, json);
    }

    public async Task<bool> TrySetCacheAsync(string key, string json, TimeSpan ttl)
    {
        try
        {
            await _db.StringSetAsync(key, json, ttl);
            return true;
        }
        catch (RedisServerException ex) when (IsOutOfMemory(ex))
        {
            // 候选池耗尽时返回 OOM:降级为 false,由调用方把数据直接透传给业务
            return false;
        }
    }

    private static bool IsOutOfMemory(RedisServerException ex)
    {
        // Redis 没有稳定错误码,只能匹配文案前缀与关键词;升级后需复核文案
        return ex.Message.StartsWith("OOM", StringComparison.OrdinalIgnoreCase)
            && ex.Message.Contains("maxmemory", StringComparison.OrdinalIgnoreCase);
    }
}调用侧必须闭环。TrySetCacheAsync 返回 false 只表示「这次回填被拒」,读路径本身还是要走完「先读缓存 → miss 回源 → 回填 → 失败记日志」:
csharp
// 读路径需要同时拿到 IDatabase(读缓存)与 MixedStore(写缓存 + OOM 兜底)
using System;
using System.Threading.Tasks;
using StackExchange.Redis;

// 缓存读服务:命中直接返回,miss 回源后回填;回填失败不影响业务返回
public sealed class CacheService
{
    private readonly IDatabase _db;
    private readonly MixedStore _store;

    public CacheService(IConnectionMultiplexer muxer)
    {
        // 读走 IDatabase,写与 OOM 判定封装在 MixedStore
        _db = muxer.GetDatabase();
        _store = new MixedStore(muxer);
    }

    public async Task<string> GetUserJsonAsync(string id)
    {
        string cacheKey = $"cache:user:{id}";

        // 先走缓存读路径,命中直接返回,避免每次都打库
        RedisValue cached = await _db.StringGetAsync(cacheKey);
        if (cached.HasValue)
        {
            // 已确认有值,用 null-forgiving 消除可空告警
            return cached!;
        }

        // 未命中:回源取数
        string json = await LoadFromDbAsync(id);

        // 回填缓存;写失败只意味着「这次没焐热」,不影响业务结果
        bool ok = await _store.TrySetCacheAsync(cacheKey, json, TimeSpan.FromMinutes(30));
        if (!ok)
        {
            // 降级路径:记一条可观测日志,便于统计池空频率;本次仍返回库里的数据
            Console.WriteLine($"cache fill rejected by maxmemory, key={cacheKey}");
        }

        return json;
    }

    private Task<string> LoadFromDbAsync(string id)
    {
        // 占位方法:真实实现替换为你的数据访问层(含超时与异常兜底)
        throw new NotImplementedException($"替换为真实的数据访问实现,id={id}");
    }
}
漏处理这个返回值,等于让「没焐热」退化成无人知晓的静默丢写,日志里什么都看不到。
我不推荐单实例混跑,原因就一条:你没法用代码保证所有可丢弃数据都带 TTL。某个缓存 key 因为 bug 漏设了,它会混进「永不淘汰」的集合,长期挤占内存;带 TTL 的键集中过期或耗尽时,volatile-lru 候选池为空,后续写入直接报 OOM command not allowed------这正是坑 1 的来源。条件允许就用两个独立实例(缓存 allkeys-lru + 持久 noeviction),混跑只在过渡期用。
6.3 冷热差异极大 → allkeys-lfu
拿一个资讯类应用的量级做算例(热点 key 峰值 100 万次/小时、长尾 100 次/小时上下,这是照客户监控抄的粒度,不是精确数字):希望优先淘汰低频 key,而不是只看最后访问时间。
text
# 热点集中场景
# 上限:20gb;容量要撑得住热点集合,否则 LFU 只能保护「有幸没被采到」的热键
maxmemory 20gb
# 策略:按访问频率淘汰
maxmemory-policy allkeys-lfu
# 采样数:热点集中时略调到 10,降低「热键没被采到」的概率
maxmemory-samples 10
# lfu-log-factor / lfu-decay-time 先保持默认 10 与 1,有证据再微调
csharp
// ExecuteAsync 返回 RedisResult,判定需要 ResultType 与 IsNull
using System;
using System.Threading.Tasks;
using StackExchange.Redis;

// 热点预热器:LFU 下新键起步计数只有 5,必须主动制造访问
public sealed class HotKeyWarmer
{
    private readonly IDatabase _db;

    public HotKeyWarmer(IConnectionMultiplexer muxer)
    {
        _db = muxer.GetDatabase();
    }

    public async Task WarmUpAsync(string key, string value, int warmReads)
    {
        // 写入后计数为 5;随后用读操作把计数推上去,成本等于访问次数
        await _db.StringSetAsync(key, value);
        for (int i = 0; i < warmReads; i++)
        {
            // 这里的读既涨计数,也刷新该键的时间戳位置
            await _db.StringGetAsync(key);
        }
    }

    public async Task<long?> GetFreqAsync(string key)
    {
        // OBJECT FREQ 只在 LFU 策略下可用,否则服务端报错、SER 抛 RedisServerException
        RedisResult freq = await _db.ExecuteAsync("OBJECT", "FREQ", key);

        // 键不存在时返回 nil,这与「计数为 0」是两种不同情况
        if (freq.IsNull || freq.Resp2Type != ResultType.Integer)
        {
            return null;
        }

        // 计数器范围 0~255,用 long 承接
        return (long)freq;
    }
}
这套方案的天花板在新键上:新写入的热点 key 初始计数只有 5,而 LFU 比的正是频次,进池比较时天然输给老键。WarmUpAsync 能缓解,但成本等于访问次数------按 factor=10 的对照,推到 18 要约 1000 次读,推到 142 要约 10 万次。所以预热只配给真正的高价值 key,别想着全量套一遍。另一个天花板是饱和:计数器上限 255,长期热点会变成「永不被淘汰」,业务热点整体迁移时必须把 lfu-decay-time 配好,否则新热点争不过老热点。如果业务以一次性短期热点为主,LFU 未必优于 LRU,切换前拿 INFO stats 的命中率做个前后对照,别凭直觉。
6.4 数据绝对不能丢 → noeviction
需求:存的是不可重建的数据(队列、锁、协调元数据),宁可写入失败让上游感知,也不能静默丢数据。
text
# 数据不可丢场景
# 上限:8gb;必须配合 used_memory/maxmemory 告警(> 80% 预警)
maxmemory 8gb
# 策略:到顶就拒绝写入,让上游显式感知失败
maxmemory-policy noeviction
csharp
// 关键写入器:把服务端 OOM 转成明确的业务异常,交由上层告警与扩容
using System;
using System.Threading.Tasks;
using StackExchange.Redis;

// noeviction 场景:宁可写失败,也不静默丢数据
public sealed class StrictStore
{
    private readonly IDatabase _db;

    public StrictStore(IConnectionMultiplexer muxer)
    {
        _db = muxer.GetDatabase();
    }

    public async Task WriteCriticalAsync(string key, string value)
    {
        try
        {
            await _db.StringSetAsync(key, value);
        }
        catch (RedisServerException ex) when (IsOutOfMemory(ex))
        {
            // 只把「内存超限」转成业务异常,其它错误仍按原样抛出
            throw new RedisWriteRejectedException(
                $"写入 {key} 被 Redis 拒绝:内存超限且策略为 noeviction", ex);
        }
    }

    private static bool IsOutOfMemory(RedisServerException ex)
    {
        // 匹配 "OOM ... maxmemory" 这一组合,避免把其它以 OOM 开头的错误误判
        return ex.Message.StartsWith("OOM", StringComparison.OrdinalIgnoreCase)
            && ex.Message.Contains("maxmemory", StringComparison.OrdinalIgnoreCase);
    }
}

// 业务专用异常:调用方按类型捕获,便于接入统一告警与降级流程
public sealed class RedisWriteRejectedException : Exception
{
    public RedisWriteRejectedException(string message, Exception innerException)
        : base(message, innerException)
    {
    }
}到顶那天怎么办:noeviction 打满后所有写命令都报错,所以别等到报警才知道------used_memory / maxmemory 过 80% 就该预警,扩容预案提前准备好。既想保数据又要缓存,单实例做不到,回到 6.2 拆实例。
6.5 两类边界:不该用淘汰的场合与集群
有几种情况根本不该指望淘汰策略:Redis 是唯一存储(队列、去重集合、排行榜源数据)时必须 noeviction,靠告警和扩容保命;访问模式完全均匀(周期性轮询固定 key)时 allkeys-random 的命中率与 allkeys-lru 相当,还省掉采样开销,前提是你接受命中率不可控;候选集几乎为空时别用 volatile-*,它当场退化成 noeviction,等于白配;锁与缓存混用一个实例时,锁 key 被 allkeys-* 淘汰会造成并发问题,而且锁 key 即使设了 TTL 也会被 volatile-* 选中------隔离才是正解,指望配置规避没用。
上了 Cluster,有三件事会变。maxmemory 是每节点上限,不是集群总量,3 主 3 从、每节点 8GB,集群容量是 24GB;淘汰按节点独立发生,slot 分布不均或大 key 集中在少数 slot 时,会出现「某节点先 OOM、其他节点还很空」,表现是部分写失败、部分正常,极易被误判成「Redis 抖动」------我见过一次被当成网络问题的,排查两天才发现是 slot 倾斜;所以倾斜要量化,CLUSTER COUNTKEYSINSLOT <slot> 统计键数、CLUSTER NODES 看 slot 分配、逐节点对比 INFO memory,倾斜超 20% 先考虑重新分片,而不是简单调大单节点内存。从库不主动淘汰、只等主库传播 DEL,细节见坑 10 与 S7。
七、开销、观测与监控
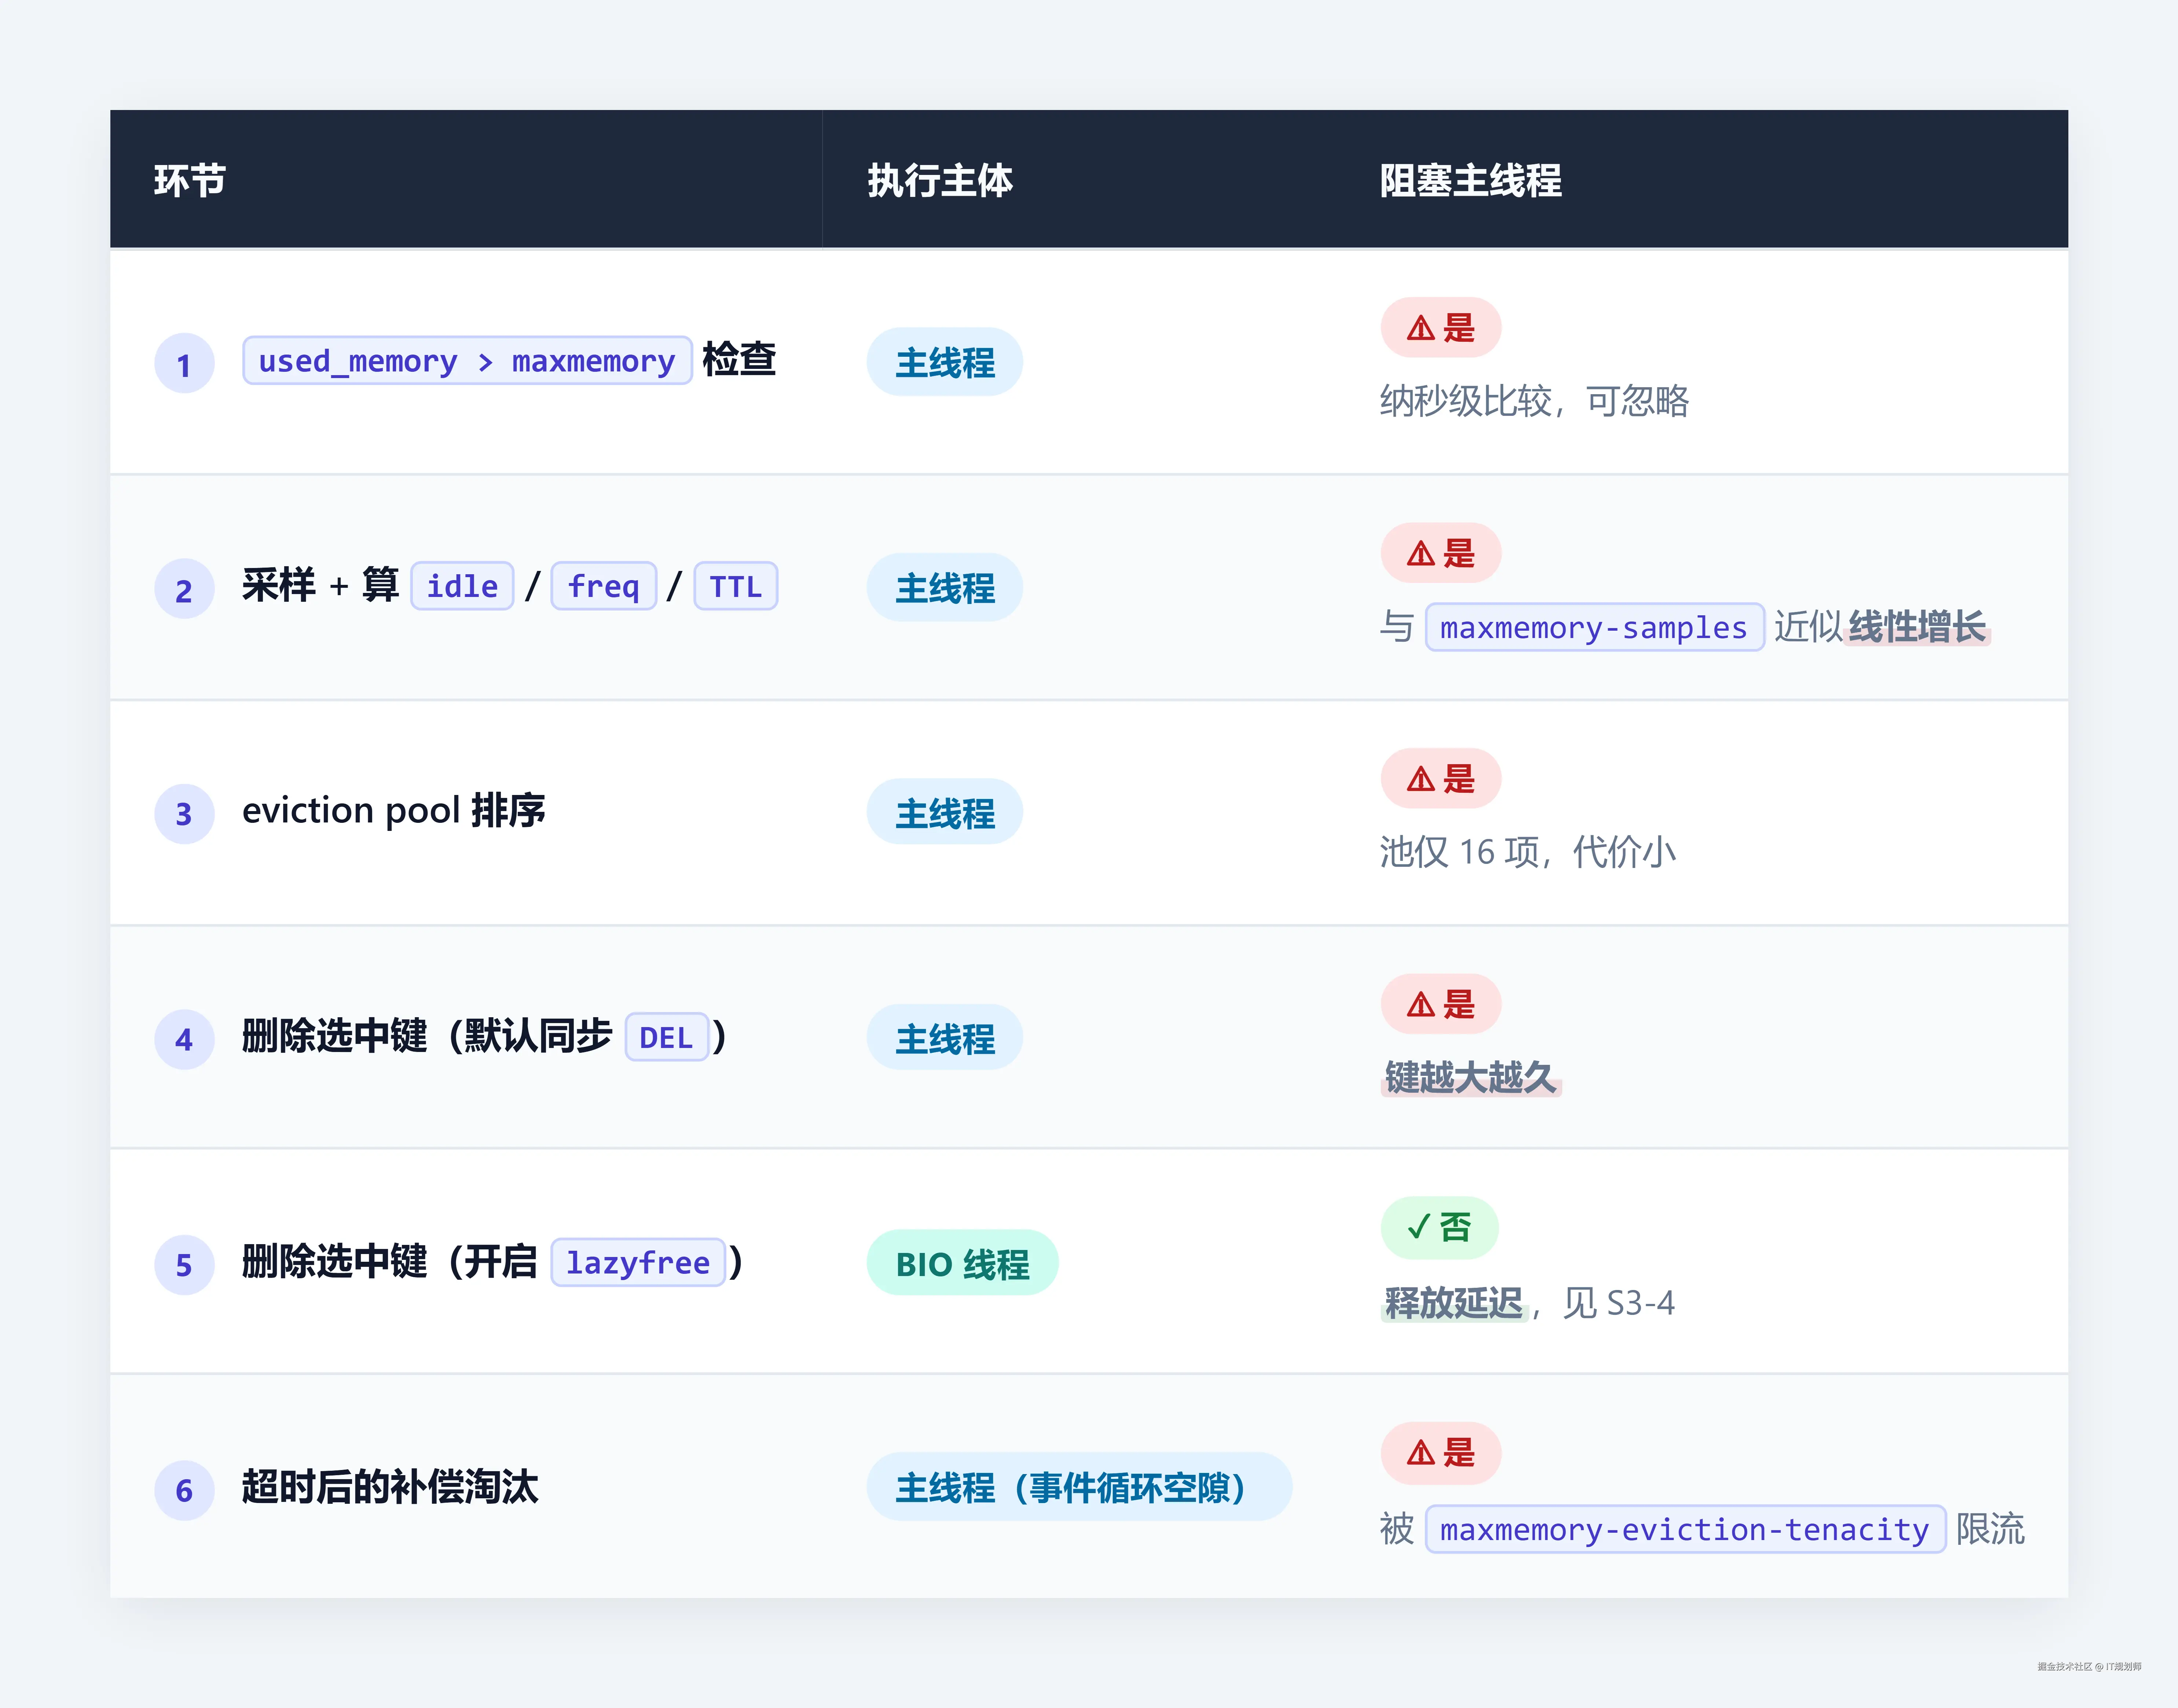
淘汰的钱花在主线程上:每轮采样遍历 maxmemory-samples 个键、读 idle 或计数、再对 16 项淘汰池排序,开销随采样数近似线性增长(5 → 10 实测约 1.9 倍,不是严格翻倍)。内存侧几乎零成本------池固定 16 项,robj 的时间戳和计数跟对象长在一起,与键数量无关。
延迟侧有两个来源。一个是毛刺:淘汰循环在命令执行前跑,一次要淘汰大量键时(一次性调低 maxmemory、批量灌数据)主线程被连续占用,期间所有命令排队。另一个是时间预算:7.0+ 的 maxmemory-eviction-tenacity(实测默认 10,范围 0~100)给「单次淘汰花多久」定档位,超预算就把剩余回收留给后续,也就是补偿淘汰。这解释了三个现象:内存会短暂高于上限;total_eviction_exceeded_time 会往上涨;极端情况下淘汰速度追不上写入,内存长期贴着上限不下来。另外开了 lazyfree-lazy-eviction yes 之后 used_memory 不会立刻降(释放走 BIO,见 S3-4),淘汰循环可能多跑几轮,但最终会降。
观测的要点是看速率,不是看累计值------evicted_keys 是累计数,两次采样做差才是速率:
bash
# 第一次采样:只取需要的行,避免 INFO 全量刷屏
redis-cli INFO stats | grep '^evicted_keys:'
# 间隔 1 秒(PowerShell 用 Start-Sleep -Seconds 1)
sleep 1
# 第二次采样:与上一次相减,就是这一秒的淘汰量
redis-cli INFO stats | grep '^evicted_keys:'
# 同期写入量,用来算「淘汰数 / 写入命令数」这个占比
redis-cli INFO stats | grep -E '^(total_commands_processed|keyspace_hits|keyspace_misses):'
# 「淘汰是否来得及」:current_* 持续增长说明淘汰被反复截断
redis-cli INFO stats | grep -E '^(total_eviction_exceeded_time|current_eviction_exceeded_time):'
# 配合内存读数:贴着上限不下来才是真病态
redis-cli INFO memory | grep -E '^(used_memory|maxmemory):'
怎么判:命中率是 keyspace_hits / (keyspace_hits + keyspace_misses)。如果你认为热数据占 20% 该贡献 80% 命中,实际却远低于 80%,就回头查 evicted_keys 是不是太高------高淘汰率通常意味着策略在误杀。total_eviction_exceeded_time 缓慢增长算正常;current_*(当前这段超限已经持续多久)一直往上走、同时 used_memory 贴着上限不下来,那就是「淘汰追不上写入」,该扩容或者调大 tenacity。
压测对照我是这么做的:固定同一数据集和同一个 maxmemory,只改 maxmemory-samples(5/10/15),记录 redis-cli --lru-test 的模拟命中率和 INFO cpu 的占用变化。造内存压力必须用第一节那个「命令文件 + stdin」,redis-benchmark 只适合测吞吐,客户端缓冲会失真:
bash
# 造写入压力,仅用于测吞吐
# -t set 只跑 SET;-n 总请求数;-d value 字节数;-r 随机 key 上限
redis-benchmark -p 6379 -t set -n 1000000 -d 1024 -r 1000000
# 同时看延迟毛刺:-i 1 表示每秒输出一次采样(Ctrl-C 结束)
redis-cli -p 6379 --latency -i 1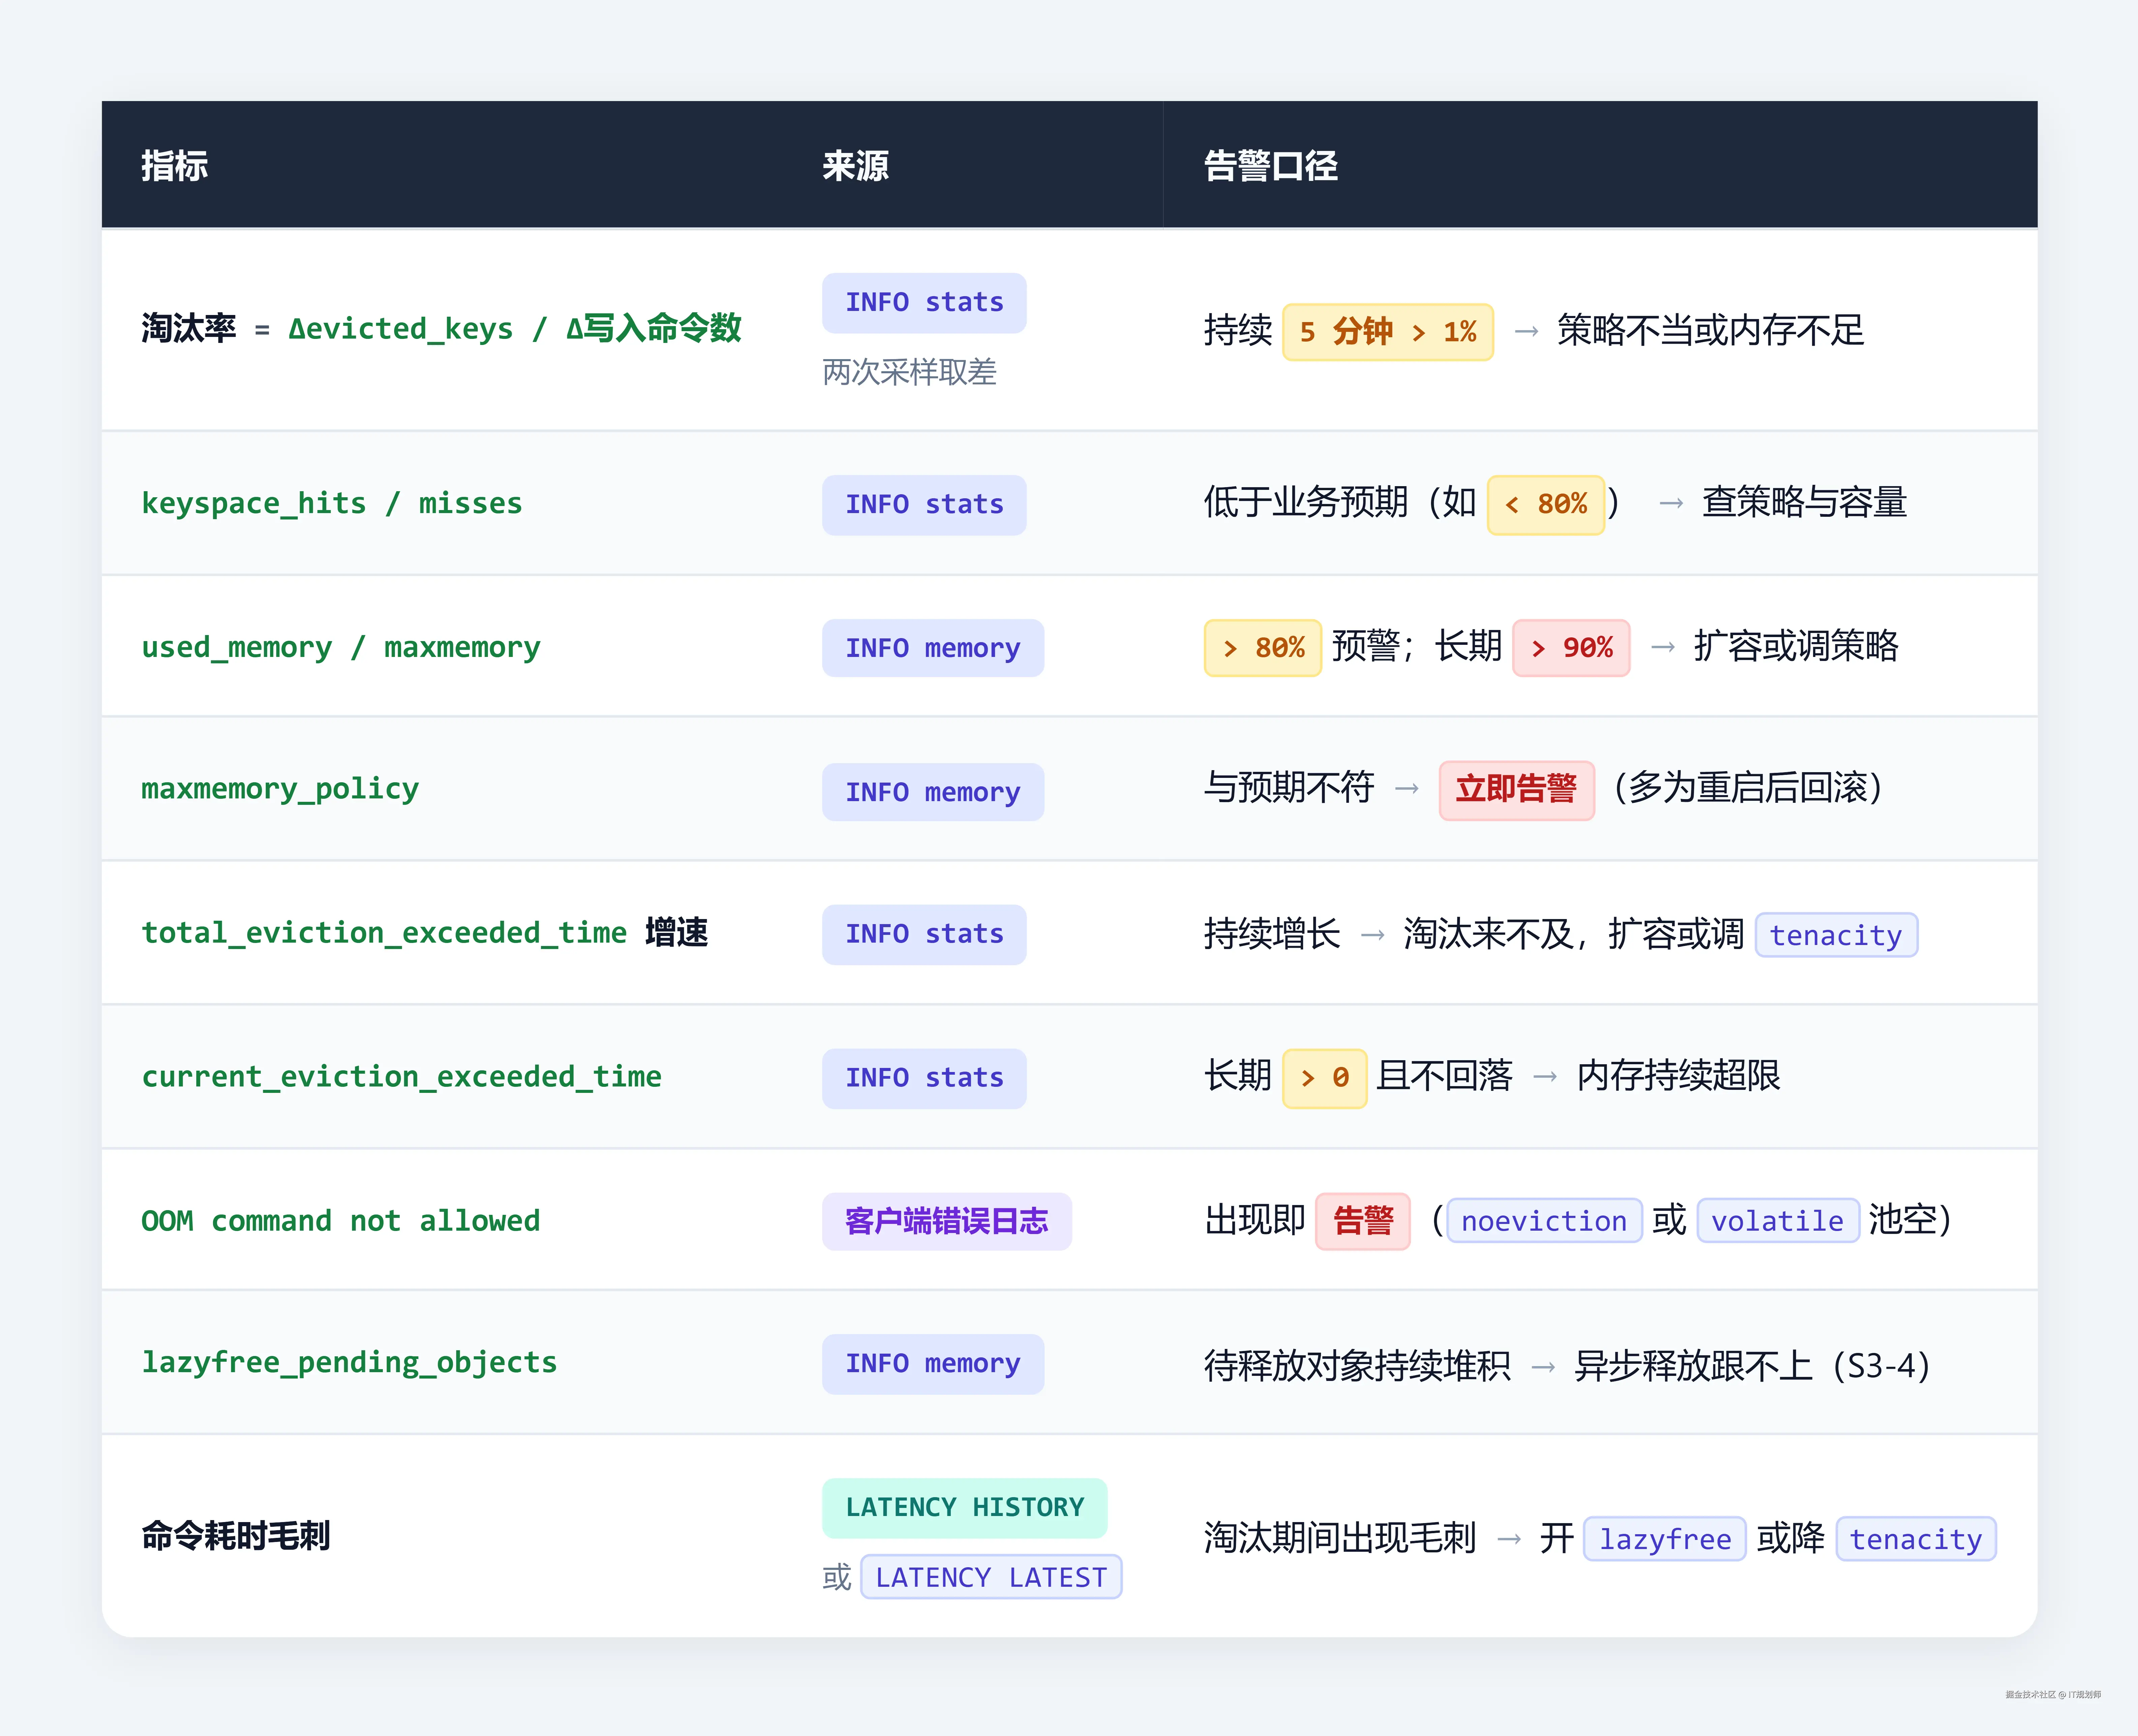
代码侧取数(.NET 10 + StackExchange.Redis)有个坑值得先说:不设置 AllowAdmin = true,INFO 会被拒绝,运行时抛 RedisCommandException: This operation is not available unless admin mode is enabled: INFO。我第一次上线这段监控就撞在上面,本地调试一切正常,一上预发环境全空,查了半小时才发现是连接选项的问题:
csharp
// ConfigurationOptions 用于开启管理员模式,INFO 命令在只读模式下会被拒绝
using System;
using System.Linq;
using System.Threading.Tasks;
using StackExchange.Redis;

// 淘汰监控器:每秒采样一次淘汰速率与命中率,供日志/指标系统消费
public sealed class EvictionMonitor
{
    private readonly IDatabase _db;

    public EvictionMonitor(IConnectionMultiplexer muxer)
    {
        _db = muxer.GetDatabase();
    }

    // 建立连接时必须在配置里打开 AllowAdmin,否则 INFO 直接报错
    public static ConfigurationOptions BuildOptions(string host, int port)
    {
        ConfigurationOptions options = new ConfigurationOptions
        {
            EndPoints = { { host, port } },
            // INFO / CONFIG 等管理命令的前提
            AllowAdmin = true,
            // 取数不应无限等待,避免监控线程被拖死
            ConnectTimeout = 5000,
            SyncTimeout = 5000
        };
        return options;
    }

    public async Task<double> GetEvictionsPerSecondAsync(TimeSpan sampleWindow)
    {
        // 取第一次累计值
        long before = await GetStatAsync("evicted_keys");
        await Task.Delay(sampleWindow);
        // 取第二次累计值,差值除以窗口秒数即为速率
        long after = await GetStatAsync("evicted_keys");
        return (after - before) / sampleWindow.TotalSeconds;
    }

    public async Task<double> GetHitRateAsync()
    {
        long hits = await GetStatAsync("keyspace_hits");
        long misses = await GetStatAsync("keyspace_misses");
        long total = hits + misses;
        // 无请求时返回 0,避免除零
        return total == 0 ? 0.0 : (double)hits / total;
    }

    private async Task<long> GetStatAsync(string field)
    {
        // INFO stats 返回多行文本,先取回 RedisResult,再转字符串解析
        RedisResult result = await _db.ExecuteAsync("INFO", "stats");
        string info = result.ToString();
        // FirstOrDefault 可能返回 null,故用可空 string 承接
        string? line = info.Split('\n')
            .Select(l => l.Trim())
            .FirstOrDefault(l => l.StartsWith(field + ":", StringComparison.Ordinal));

        // 字段缺失或格式异常必须显式抛错,不能静默返回 0(会把故障伪装成健康)
        if (line == null)
        {
            throw new InvalidOperationException($"INFO stats 中找不到字段 {field}");
        }

        string raw = line.Substring(field.Length + 1).Trim();
        if (!long.TryParse(raw, out long value))
        {
            throw new InvalidOperationException($"字段 {field} 的值无法解析:{raw}");
        }

        return value;
    }
}
evicted_keys > 0 本身不代表故障,缓存业务本来就允许淘汰。判断是否病态看的是淘汰率相对写入量的占比:10 万 QPS 的实例每秒淘汰 100 个属正常,1 千 QPS 的实例每秒淘汰 100 个就是灾难。说到底这是笔交易------用主线程的采样开销换内存有界,采样数越大精度越高但毛刺越明显,代价是命中率下降和偶发延迟,而且偏差会随数据规模与访问分布一起放大。
八、版本演进与热切换
这张表只列本机制相关的版本变化:
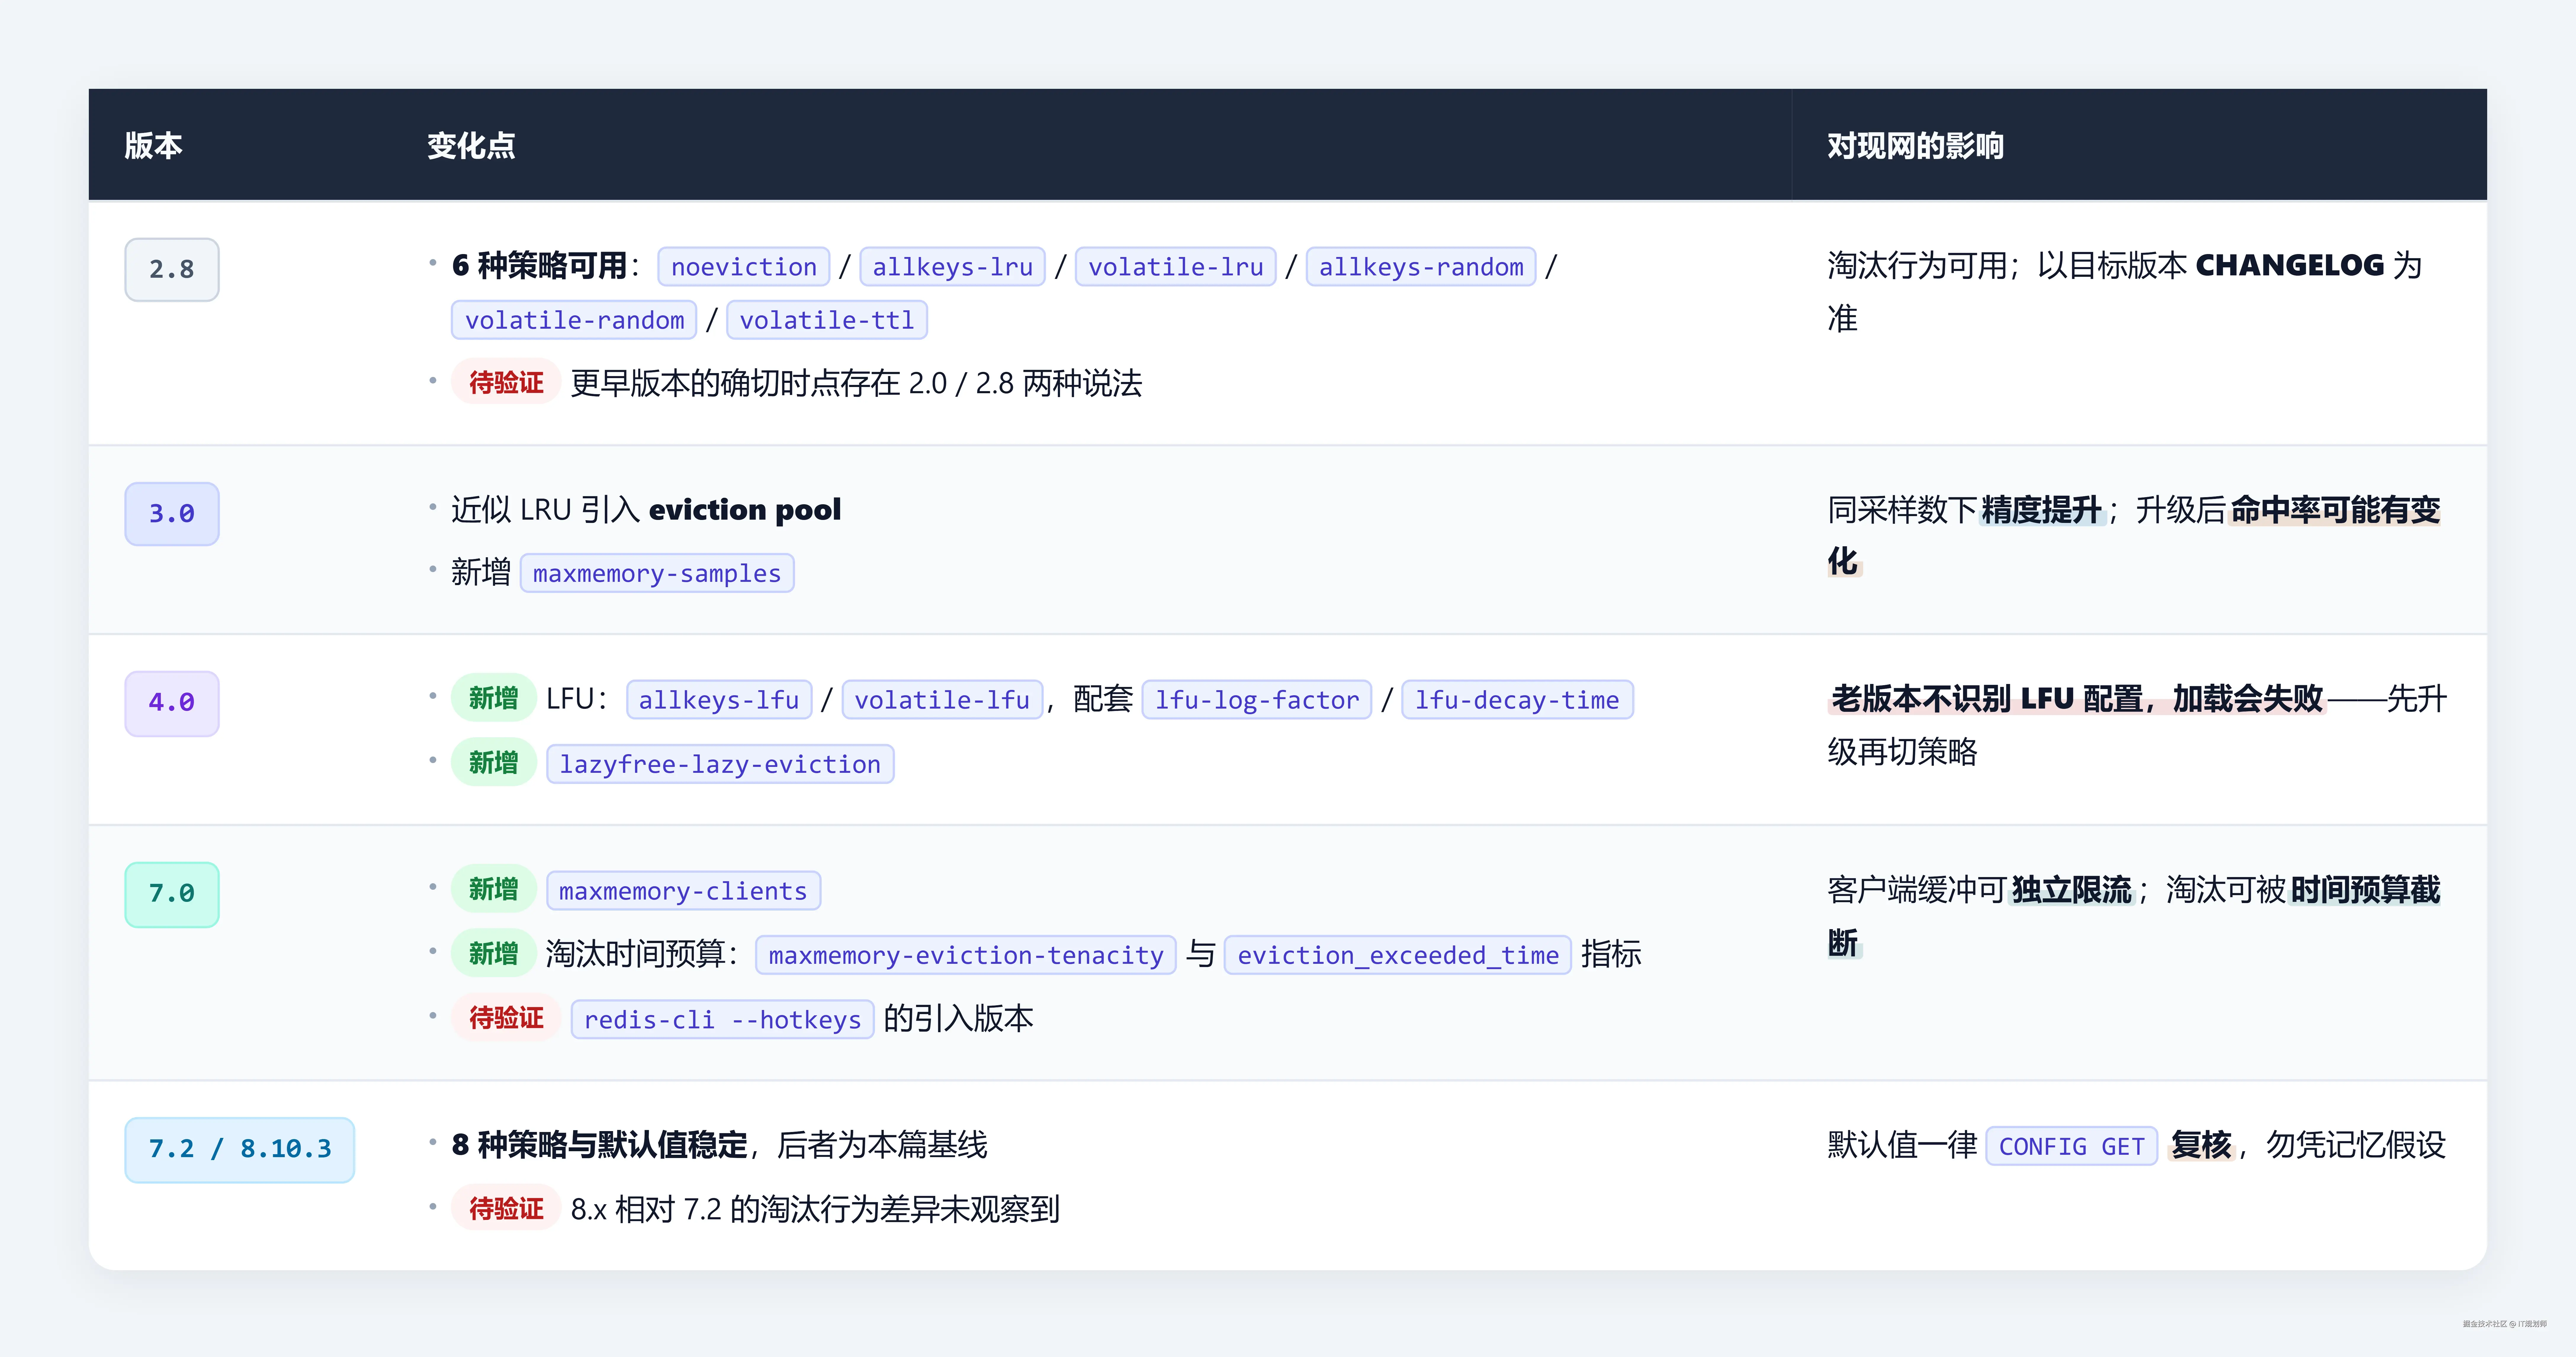
有两个点我没敢写死:redis-cli --hotkeys 到底是随 4.0 的 LFU 一起来,还是 7.0 才补上;以及 8.x 相对 7.2 有没有新增或删掉淘汰相关的统计字段------后者比对一下 INFO stats 的字段集合就能确认,留给你顺手验。
热切换 CONFIG SET maxmemory-policy 时,有三件事同时发生。第一,立即生效,新命令立刻按新策略选人,不用重启。第二,元数据不重置,已有对象的旧字段会被按新语义解释(第三节那两句 OBJECT 报错就是官方提示),直到这些键被访问、元数据被重新写入。第三,旧策略的排他性立刻消失------把已超限的实例从 noeviction 切成 allkeys-lru,马上触发一轮大规模淘汰,我开头那次 evicted_keys 一跳 3400 多就是这么来的。
所以切换本身就是个可能造成毛刺的动作,我按这个顺序做:切换前先采基线,24 小时的命中率、evicted/s、used_memory/maxmemory 峰值都记下来;只动一个变量,maxmemory-samples 保持不变,否则出了问题无法归因;挑业务低峰、内存明显低于上限的时刻切;多分片或多实例的场景先切 1 个分片或从库,观察 30 分钟;命中率掉超 5 个百分点、或者 evicted/s 相对基线翻倍,就回滚------CONFIG SET 回滚成本几乎为零,这是淘汰策略最值得利用的一点;稳定之后别忘 CONFIG REWRITE 落盘,否则下次重启被 redis.conf 覆盖回去,前功尽弃。
九、口径裁决与 12 个高频坑
先说六条常被争的口径。
- 默认值不可信。社区版默认
noeviction,部分云服务默认volatile-lru,上线前必须显式设置,并以CONFIG GET的实际返回为准。 - 不必追求精确 LRU。候选集可能极大,逐 key 比较 idle 的成本不可接受;Redis 用采样加 16 项淘汰池逼近,加大
maxmemory-samples能把偏差收敛到可接受范围。追求精确的 CPU 代价远高于收益,这是取舍不是妥协。 volatile-ttl不是「精确」。TTL 与 LRU/LFU 共用同一条采样与淘汰池路径(evict.c的evictionPoolPopulate对三类统一填池),只在样本内比较剩余 TTL。- LFU 同样复用淘汰池。「LFU 淘汰没有池、只看当前采样窗口」的说法不成立:LRU、LFU、
volatile-ttl共用同一个 16 项池,差别只在池内排序依据,只有*-random不走池。 maxmemory设多大有口径。不开持久化取节点规格的 70%~75%;开 RDB/AOF 重写时降到 45%~60%,为 fork COW 峰值、复制输出缓冲与碎片留余量。为什么不建议超过 75%:fork 瞬间的 COW 可能让实际占用短时翻倍,一旦超过物理内存就会被 OS OOM Killer 杀掉,不可逆。最终以你自己实例的实测 fork 开销为准。maxmemory不是硬上限。它是稳态上限,瞬时突破的合法通道是脚本、事务块与数据载入------这一条必须写进容量评估前提,否则所有「内存不会超过 X」的承诺都是假的。
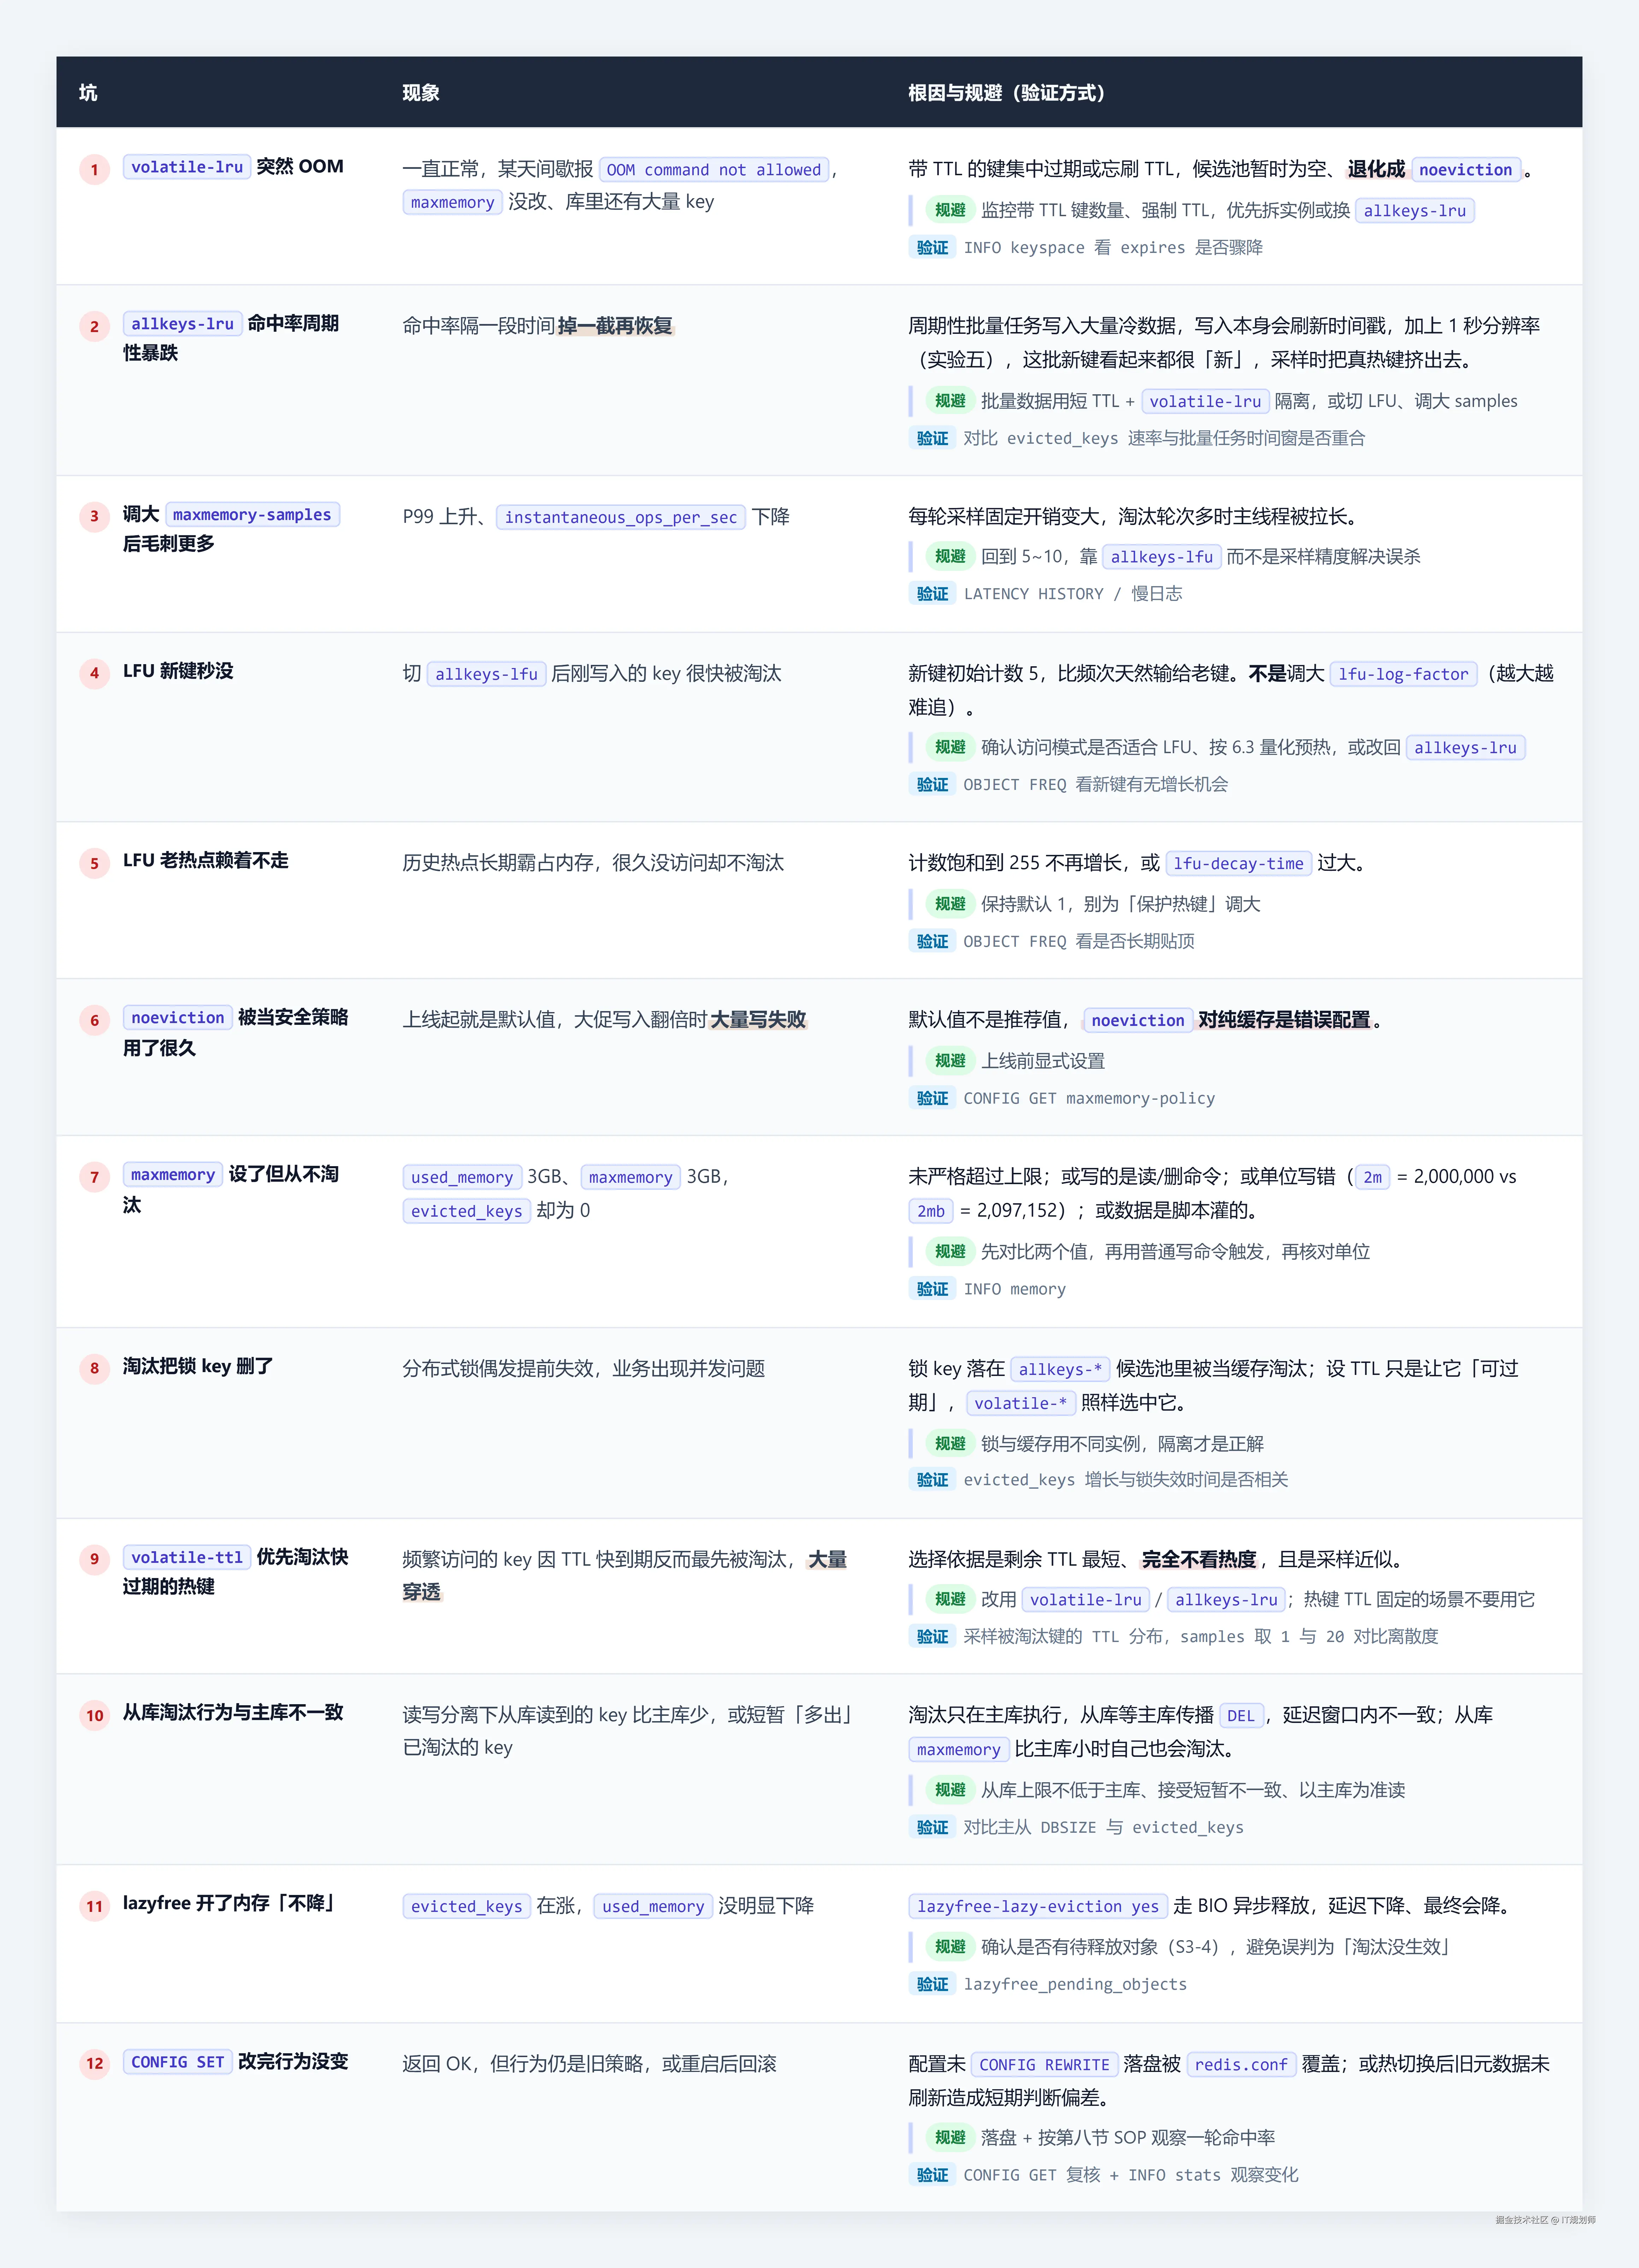
12 个坑我压成一张表,现象、根因、规避和验证方式都在里面:
十、小结与下一篇
8 种策略其实可以拆成两个问题:从哪些键里选(allkeys / volatile),按什么依据选(lru / lfu / random / ttl)。noeviction 不参与选择,它直接拒绝写入。
淘汰发生在命令执行前的主线程,但有三条例外:脚本、事务块与数据载入期不做 maxmemory 拒绝,也不做淘汰。一条 EVAL 就能把 2MB 限额打到 6MB,这是容量压测最容易踩的坑。触发时机也要说准:写命令必查,读命令实测不触发;超限内存最终会回收,只是不保证在哪一刻回收完。LRU、LFU、volatile-ttl 共用「采样 + 16 项淘汰池」这条路径,只有 *-random 例外------每轮随机取 1 个键直接删,不采样、不进池。
LRU 是采样近似,而且时钟只有 1 秒分辨率(同一秒写三个 key,idle 会分成 0 和 1 两档)。maxmemory-samples 默认 5 够用,8~10 是敏感场景的平衡点,不建议超过 15。LFU 的计数会衰减(实测 5 → 静置 65 秒 → 4)也会饱和(上限 255);新键起步 5、2000 次访问只到 26 上下,还带着概率性递增的抖动(两次实测 26 和 29),所以预热是有成本的,不是免费操作。最后还是那句:淘汰是静默丢数据,判断策略合不合适,看淘汰率相对写入量的占比与命中率的搭配,而不是某个固定绝对值。
篇幅内的边界我再复述一次:本篇只讲淘汰谁------删除动作怎么执行(同步 DEL / 异步 UNLINK / lazyfree)见 S3-4,容量规划与水位设定见 S6-1,命中率治理与缓存架构见 S11-8。
这套结论有边界。访问模式要是既不是二八也不是均匀(比如严格 FIFO 或强周期同步),LRU/LFU 的适用性得重新推;云厂商兼容版改过淘汰逻辑的,以厂商文档和你的实测为准;若某版本真引入了精确 LRU 或改了淘汰池容量,「近似精度」这类结论要重估;我这批数字全部来自单机、无持久化、无复制,开了 RDB/AOF、上了主从或集群之后不能直接套。集群那节我更多是从现场经验来的,完整的分片倾斜实验还没做完,等做完了单独补一篇。
下一篇写删除那一侧:DEL 一个大 key 为什么能让线上抖一下,UNLINK 和 lazyfree 到底省了谁的力气。预告一句就够------本篇决定淘汰谁,那一篇决定删得有多疼。
速查卡
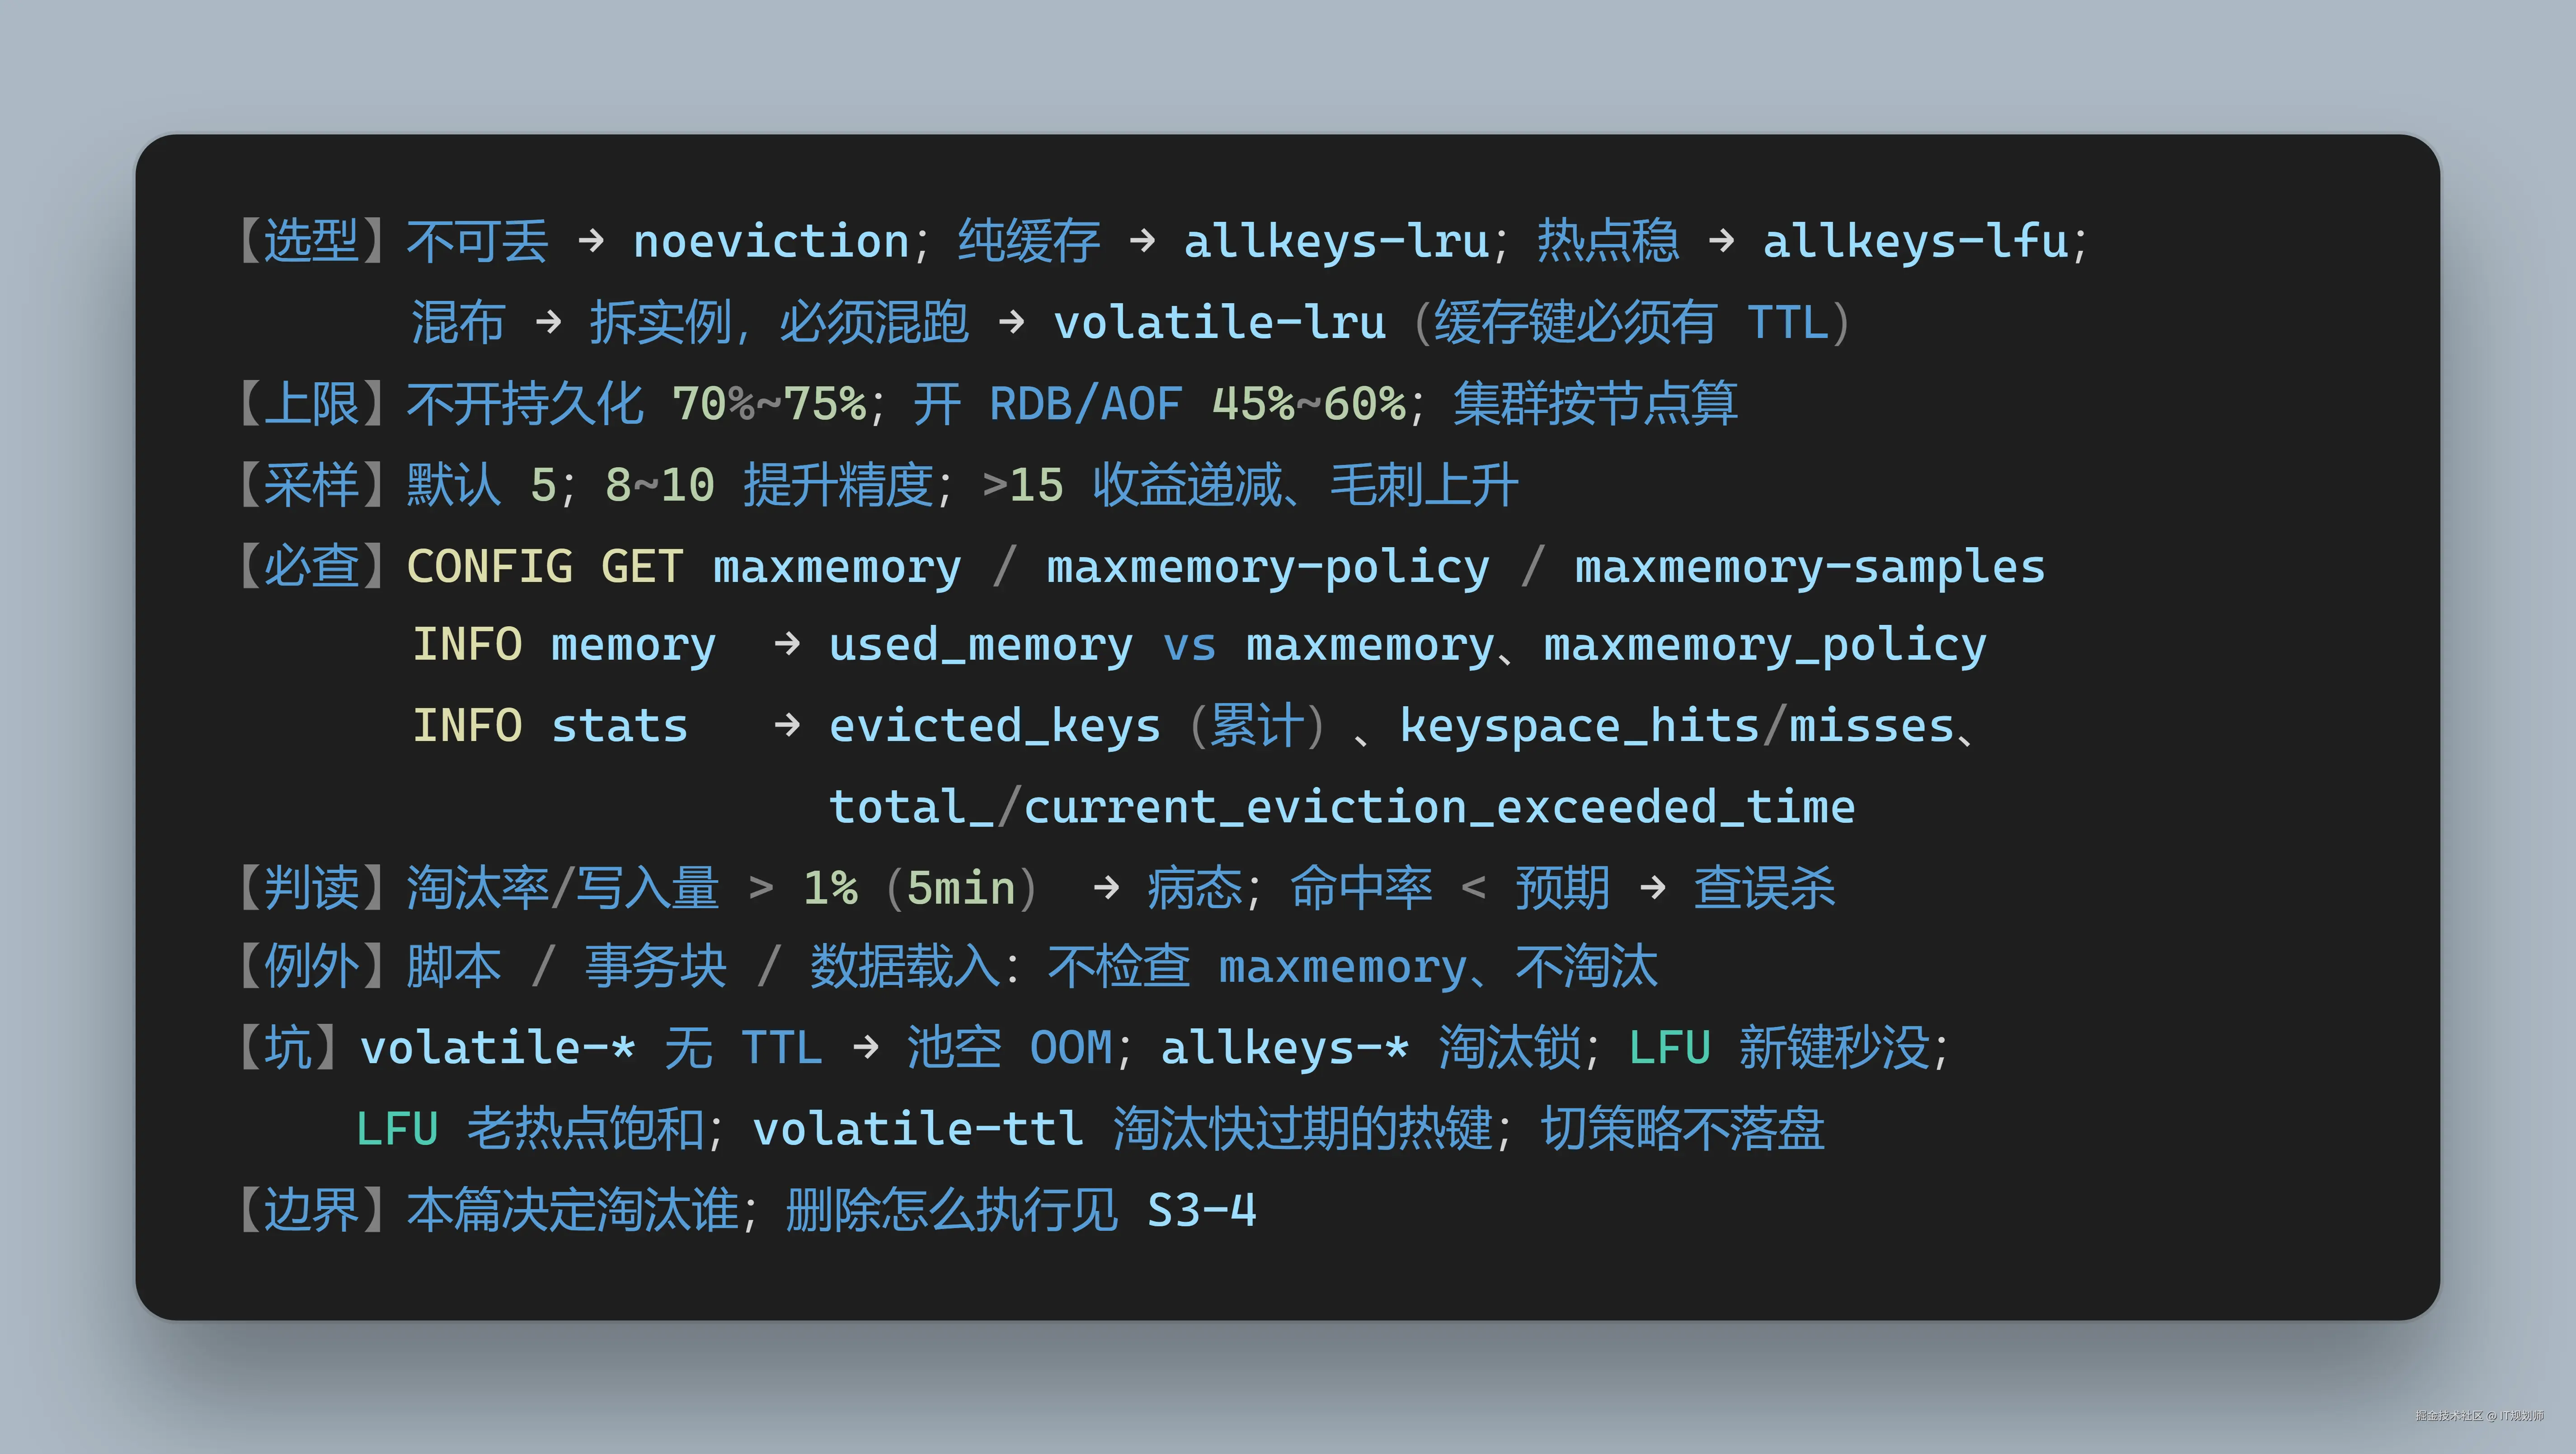
选型那张决策树我画成图片了,公众号后台回「淘汰策略」自取,不用转发。