SQL Server I/O性能优化:从等待类型到存储配置
系列文章: SQL Server性能优化实战系列 · 第4篇 发布日期: 2026-11-18 字数: 约4500字 阅读时间: 15分钟 适用版本: SQL Server 2016、2017、2019、2022(具体能力以目标版本和补丁为准)
引言
SQL Server I/O问题经常被描述成一句话:"磁盘太慢。"这句话通常不够准确。
PAGEIOLATCH_*可能表示数据页从存储读取较慢,也可能表示查询读取了远超业务需要的数据;WRITELOG可能与日志盘延迟有关,也可能是事务提交过于频繁;ASYNC_IO_COMPLETION和IO_COMPLETION也不能脱离请求类型、文件和时间窗口单独下结论。
因此,I/O优化的第一原则是:先把等待类型映射到具体文件和具体工作负载,再讨论存储配置。
本文从等待类型开始,结合文件级I/O统计、等待增量、性能计数器和存储布局,给出一套可以落地的诊断流程。示例脚本按 SQL Server 2016---2022 的常见 DMV 结构编写,涉及版本差异和实例配置变更的语句,必须先在测试环境验证。
一、I/O等待类型到底说明了什么
1.1 PAGEIOLATCH_*:等待数据页完成I/O
PAGEIOLATCH_SH、PAGEIOLATCH_EX等等待通常与数据页读入Buffer Pool有关:
SH通常与读取共享页有关;EX通常与需要独占访问的页有关;UP与更新路径有关。
它们告诉你请求在等待页I/O,但没有直接告诉你根因是存储设备、文件布局、缓存不足、执行计划还是查询返回了过多数据。
1.2 WRITELOG:等待日志刷新
事务提交通常需要把日志记录持久化到日志文件。WRITELOG偏高时应优先检查:
- 日志文件所在存储的写延迟;
- 事务提交频率和事务边界;
- 日志记录量是否突然增长;
- 日志文件是否频繁自动增长;
- 备份、复制、可用性组或其他日志消费者是否造成间接压力。
把日志文件放到"看起来更快"的盘上,不会修复每行提交一次的应用设计。
1.3 ASYNC_IO_COMPLETION和IO_COMPLETION
这两类等待覆盖面较宽,可能出现在备份、还原、文件操作或其他异步I/O路径中。必须结合:
- 当前请求的
command; - 数据库和文件名;
- 文件读写方向;
- 请求产生的时间窗口;
- 同时发生的存储设备延迟。
等待名称是分类标签,不是根因报告。
二、先采样,再判断:等待统计不能只看累计值
sys.dm_os_wait_stats记录的是实例启动以来的累计等待。若只看累计值,历史高峰可能掩盖当前问题。
2.1 查看I/O相关累计等待
sql
SELECT
    wait_type,
    waiting_tasks_count,
    wait_time_ms,
    signal_wait_time_ms,
    max_wait_time_ms
FROM sys.dm_os_wait_stats
WHERE wait_type LIKE 'PAGEIOLATCH%'
   OR wait_type IN (
        'WRITELOG',
        'ASYNC_IO_COMPLETION',
        'IO_COMPLETION',
        'BACKUPIO',
        'LOGBUFFER'
   )
ORDER BY wait_time_ms DESC;
2.2 通过两次采样计算增量
sql
SELECT
    wait_type,
    waiting_tasks_count,
    wait_time_ms,
    signal_wait_time_ms
INTO #WaitStats1
FROM sys.dm_os_wait_stats
WHERE wait_type LIKE 'PAGEIOLATCH%'
   OR wait_type IN ('WRITELOG', 'ASYNC_IO_COMPLETION', 'IO_COMPLETION');

DECLARE @sample_start datetime2(3) = SYSDATETIME();
WAITFOR DELAY '00:01:00';

SELECT
    wait_type,
    waiting_tasks_count,
    wait_time_ms,
    signal_wait_time_ms
INTO #WaitStats2
FROM sys.dm_os_wait_stats
WHERE wait_type LIKE 'PAGEIOLATCH%'
   OR wait_type IN ('WRITELOG', 'ASYNC_IO_COMPLETION', 'IO_COMPLETION');

SELECT
    w2.wait_type,
    w2.waiting_tasks_count - w1.waiting_tasks_count AS delta_tasks,
    w2.wait_time_ms - w1.wait_time_ms AS delta_wait_ms,
    w2.signal_wait_time_ms - w1.signal_wait_time_ms AS delta_signal_wait_ms,
    CAST((w2.wait_time_ms - w1.wait_time_ms) * 1.0
         / NULLIF(w2.waiting_tasks_count - w1.waiting_tasks_count, 0)
         AS decimal(18,2)) AS avg_wait_ms,
    @sample_start AS sample_start,
    SYSDATETIME() AS sample_end
FROM #WaitStats2 AS w2
JOIN #WaitStats1 AS w1
  ON w1.wait_type = w2.wait_type
ORDER BY delta_wait_ms DESC;

DROP TABLE #WaitStats1;
DROP TABLE #WaitStats2;
建议把两次采样保存到临时表或历史表,按固定窗口计算:
- 等待时间增量;
- 等待任务数增量;
- 平均等待时间;
- 与吞吐量、批次量和业务请求数的关系。
生产环境不要为了让等待统计归零而随意执行 DBCC SQLPERF('sys.dm_os_wait_stats', CLEAR)。清空会破坏正在使用的基线,必须有明确的采样和留证方案。
三、文件级I/O:把等待定位到数据文件、日志文件和tempdb
3.1 查询文件级读写统计
sql
SELECT
    DB_NAME(vfs.database_id) AS database_name,
    mf.type_desc,
    mf.name AS logical_file_name,
    mf.physical_name,
    vfs.num_of_reads,
    vfs.num_of_bytes_read,
    vfs.io_stall_read_ms,
    CASE
        WHEN vfs.num_of_reads = 0 THEN 0
        ELSE vfs.io_stall_read_ms * 1.0 / vfs.num_of_reads
    END AS avg_read_stall_ms,
    vfs.num_of_writes,
    vfs.num_of_bytes_written,
    vfs.io_stall_write_ms,
    CASE
        WHEN vfs.num_of_writes = 0 THEN 0
        ELSE vfs.io_stall_write_ms * 1.0 / vfs.num_of_writes
    END AS avg_write_stall_ms,
    vfs.io_stall
FROM sys.dm_io_virtual_file_stats(NULL, NULL) AS vfs
JOIN sys.master_files AS mf
  ON mf.database_id = vfs.database_id
 AND mf.file_id = vfs.file_id
ORDER BY vfs.io_stall DESC;
这里的平均延迟是从累计计数计算出来的平均值,不是每个I/O请求的完整分布。平均值可能掩盖长尾,所以需要在故障窗口内重复采样。
3.2 读取和写入分开排序
sql
SELECT TOP (30)
    DB_NAME(vfs.database_id) AS database_name,
    mf.type_desc,
    mf.physical_name,
    vfs.num_of_reads,
    vfs.io_stall_read_ms,
    CAST(vfs.io_stall_read_ms * 1.0 / NULLIF(vfs.num_of_reads, 0) AS decimal(18,2))
        AS avg_read_stall_ms,
    vfs.num_of_writes,
    vfs.io_stall_write_ms,
    CAST(vfs.io_stall_write_ms * 1.0 / NULLIF(vfs.num_of_writes, 0) AS decimal(18,2))
        AS avg_write_stall_ms
FROM sys.dm_io_virtual_file_stats(NULL, NULL) AS vfs
JOIN sys.master_files AS mf
  ON mf.database_id = vfs.database_id
 AND mf.file_id = vfs.file_id
ORDER BY avg_read_stall_ms DESC;
3.3 查看当前挂起的I/O
sql
WITH PendingIO AS
(
    SELECT
        io_type,
        io_pending,
        io_pending_ms_ticks,
        io_handle,
        io_offset,
        scheduler_address
    FROM sys.dm_io_pending_io_requests
), FileStats AS
(
    SELECT
        database_id,
        file_id,
        file_handle
    FROM sys.dm_io_virtual_file_stats(NULL, NULL)
)
SELECT
    DB_NAME(fs.database_id) AS database_name,
    mf.type_desc,
    mf.physical_name,
    p.io_type,
    p.io_pending,
    p.io_pending_ms_ticks,
    p.io_offset,
    p.scheduler_address
FROM PendingIO AS p
LEFT JOIN FileStats AS fs
  ON fs.file_handle = p.io_handle
LEFT JOIN sys.master_files AS mf
  ON mf.database_id = fs.database_id
 AND mf.file_id = fs.file_id
ORDER BY p.io_pending_ms_ticks DESC;
该 DMV是瞬时视图,空结果不代表历史上没有I/O压力。它适合在故障现场与其他采样并行执行;SQL Server 2022及更高版本还要按目标实例权限要求确认VIEW SERVER PERFORMANCE STATE。
四、按文件类型分析I/O根因
4.1 数据文件:PAGEIOLATCH和扫描压力
数据文件I/O偏高时,先回答:
- 是少量查询在进行大范围扫描,还是整体工作集超过内存?
- 是否存在统计信息失真或索引缺失?
- 读延迟是否只集中在一个文件、一个卷或一个数据库?
- 读取是否发生在业务高峰,还是备份、重建索引、ETL窗口?
如果高延迟只出现在一个文件,优先检查文件所在卷、存储路径、虚拟化映射和邻居工作负载;如果所有文件都升高,才更像存储池或主机层问题。
4.2 日志文件:WRITELOG和提交策略
日志文件是顺序写入为主,但"顺序写"不代表任何存储都足够快。重点检查:
- 日志文件平均写延迟和长尾;
- 单事务产生的日志量;
- 是否存在大量短事务和频繁提交;
- 日志增长是否与高峰重合;
- 日志截断是否受长事务、复制、可用性组或备份链路影响。
4.3 tempdb:I/O与分配争用要分开
PAGEIOLATCH_*可能表示tempdb页从盘读取;PAGELATCH_*则常见于内存中分配页的闩锁争用。两者都可能被描述为"tempdb慢",但处理方向完全不同:
- PAGEIOLATCH:看tempdb数据文件存储、文件大小、工作负载和物理I/O;
- PAGELATCH:看PFS、GAM、SGAM、文件数量、临时对象和分配模式。
不要因为看到PAGELATCH_UP就直接升级存储设备,也不要因为看到PAGEIOLATCH_SH就只增加tempdb文件数量。
五、存储布局:分离是手段,不是结论
5.1 数据、日志和tempdb是否应该分离
把数据文件、日志文件和tempdb分到不同存储池,目的在于减少不同I/O模式之间的竞争:
- 数据文件偏随机读取和混合读写;
- 日志文件偏顺序写入并受持久化延迟影响;
- tempdb可能同时承担临时对象、排序溢出和版本存储。
如果底层其实是同一个共享存储池、同一组控制器或同一组虚拟磁盘,表面上的盘符分离不等于物理隔离。需要向存储和虚拟化团队确认实际拓扑。
5.2 RAID 10与RAID 5如何选择
RAID级别选择取决于读写比例、写入放大、容量、重建窗口、故障域和存储平台实现。常见经验是:高写入和低延迟日志路径更偏向低写惩罚方案,但不能把"RAID 10永远更好"写成通用结论。
决策至少需要这些输入:
- 读/写IOPS和吞吐;
- 8 KB随机I/O与日志写入的混合情况;
- 峰值和长尾延迟;
- 可用容量和增长速度;
- 重建期间的性能和风险;
- 云盘或阵列的实际服务等级。
5.3 性能监视器与RAID写惩罚
DMV能告诉你SQL Server看到的文件级延迟,性能监视器则能帮助确认操作系统和存储路径的整体压力。建议至少采集:
| 对象 | 计数器 | 用途 |
|---|---|---|
| PhysicalDisk / LogicalDisk | Avg. Disk sec/Read |
平均读延迟 |
| PhysicalDisk / LogicalDisk | Avg. Disk sec/Write |
平均写延迟 |
| PhysicalDisk / LogicalDisk | Disk Reads/sec |
读吞吐和读负载 |
| PhysicalDisk / LogicalDisk | Disk Writes/sec |
写吞吐和写负载 |
| PhysicalDisk | Current Disk Queue Length |
队列是否持续堆积 |
RAID下不能直接把Windows计数器值当成单盘压力。常用折算公式为:
- RAID 0:每盘I/O ≈
(读次数 + 写次数) / 磁盘数; - RAID 1:每盘I/O ≈
[读次数 + (2 × 写次数)] / 2; - RAID 5:每盘I/O ≈
[读次数 + (4 × 写次数)] / 磁盘数; - RAID 10:每盘I/O ≈
[读次数 + (2 × 写次数)] / 磁盘数。
例如,两块盘的RAID 1在计数器中观察到80次读和70次写,每盘近似I/O为(80 + 2×70) / 2 = 110 I/O/s。这个数值只是折算样例,是否构成瓶颈还要结合阵列规格、队列长度和延迟分布。
5.4 SSD、NVMe和云存储
微软文档常把每次I/O约10---15毫秒作为排查时的经验参考,但这不是适用于所有阵列、云盘和工作负载的硬阈值。更快的介质可以降低I/O等待,但不会修复:
- 不可选择性谓词导致的全表扫描;
- 统计信息错误;
- 事务范围过大;
- 日志频繁自动增长;
- tempdb空间治理缺失;
- 多个数据库共享一个受限存储池。
存储升级前后都应使用同一采样方法记录I/O延迟、吞吐、等待和业务响应时间。
5.5 数据文件增长与即时文件初始化
即时文件初始化通常可以减少数据文件初始化时的等待,但不适用于事务日志。日志文件仍需要按日志语义初始化,频繁增长会制造明显的业务抖动。
因此:
- 数据文件按容量规划预先设置合理大小;
- 日志文件按恢复模型、日志产生量和备份策略规划;
- 自动增长作为保护措施,不作为常规容量管理;
- 增长增量使用明确的MB值,避免百分比增长导致后期单次增长过大。
六、I/O诊断脚本:从等待到业务请求
6.1 查看当前I/O相关请求
sql
SELECT
    r.session_id,
    r.request_id,
    r.status,
    r.command,
    r.wait_type,
    r.wait_time,
    r.wait_resource,
    r.cpu_time,
    r.reads,
    r.writes,
    r.logical_reads,
    r.total_elapsed_time,
    DB_NAME(r.database_id) AS database_name,
    SUBSTRING(
        st.text,
        (r.statement_start_offset / 2) + 1,
        ((CASE r.statement_end_offset
            WHEN -1 THEN DATALENGTH(st.text)
            ELSE r.statement_end_offset
          END - r.statement_start_offset) / 2) + 1
    ) AS statement_text
FROM sys.dm_exec_requests AS r
OUTER APPLY sys.dm_exec_sql_text(r.sql_handle) AS st
WHERE r.wait_type LIKE 'PAGEIOLATCH%'
   OR r.wait_type IN (
        'WRITELOG',
        'ASYNC_IO_COMPLETION',
        'IO_COMPLETION',
        'BACKUPIO',
        'LOGBUFFER'
   )
ORDER BY r.wait_time DESC;
6.2 历史I/O杀手查询
sys.dm_exec_requests只能看到当前仍在运行的请求。需要回看缓存中曾经执行过的语句时,使用sys.dm_exec_query_stats:
sql
SELECT TOP (20)
    qs.execution_count,
    qs.total_logical_reads / NULLIF(qs.execution_count, 0)
        AS avg_logical_reads,
    qs.max_logical_reads,
    qs.total_physical_reads / NULLIF(qs.execution_count, 0)
        AS avg_physical_reads,
    qs.max_physical_reads,
    qs.total_logical_writes / NULLIF(qs.execution_count, 0)
        AS avg_logical_writes,
    qs.total_worker_time / NULLIF(qs.execution_count, 0)
        AS avg_cpu_time_us,
    DB_NAME(st.dbid) AS database_name,
    SUBSTRING(
        st.text,
        (qs.statement_start_offset / 2) + 1,
        ((CASE qs.statement_end_offset
            WHEN -1 THEN DATALENGTH(st.text)
            ELSE qs.statement_end_offset
          END - qs.statement_start_offset) / 2) + 1
    ) AS statement_text
FROM sys.dm_exec_query_stats AS qs
CROSS APPLY sys.dm_exec_sql_text(qs.sql_handle) AS st
ORDER BY qs.max_physical_reads DESC, qs.max_logical_reads DESC;max_logical_reads和max_physical_reads是峰值,不代表每次执行都达到该值;total_* / execution_count是平均值,也会被执行次数分布稀释。两者必须同时看。
6.3 找出当前逻辑读较高的请求
sql
SELECT TOP (30)
    r.session_id,
    r.status,
    r.command,
    r.logical_reads,
    r.reads,
    r.writes,
    r.cpu_time,
    r.total_elapsed_time,
    DB_NAME(r.database_id) AS database_name,
    st.text AS batch_text
FROM sys.dm_exec_requests AS r
OUTER APPLY sys.dm_exec_sql_text(r.sql_handle) AS st
ORDER BY r.logical_reads DESC;
逻辑读高并不等于物理存储慢。它更像是"查询触碰了很多页"的信号,需要与文件级物理读、执行计划和缓存命中一起判断。
6.4 检查数据库文件大小和增长配置
sql
SELECT
    DB_NAME(database_id) AS database_name,
    name AS logical_file_name,
    type_desc,
    physical_name,
    size * 8.0 / 1024 AS size_mb,
    growth,
    is_percent_growth,
    CASE
        WHEN is_percent_growth = 1 THEN CONCAT(growth, '%')
        ELSE CONCAT(growth * 8.0 / 1024, ' MB')
    END AS growth_setting
FROM sys.master_files
ORDER BY database_id, file_id;
6.5 IFI、压缩与I/O限流
即时文件初始化(IFI)可以减少数据文件增长和还原过程中的零填充等待,但不适用于事务日志。先核验状态:
sql
SELECT
    servicename,
    instant_file_initialization_enabled
FROM sys.dm_server_services;
对I/O热点表,可以先估算压缩收益,再决定是否增加CPU换取更少的I/O:
sql
EXEC sys.sp_estimate_data_compression_savings
    @schema_name = 'dbo',
    @object_name = 'LargeTable',
    @index_id = NULL,
    @partition_number = NULL,
    @data_compression = 'PAGE';
资源调控器适合把特定工作负载的I/O影响限制在边界内。下面是语法示例,实际配置前要补充分类器函数、工作负载组和回退方案:
sql
CREATE RESOURCE POOL IOLimitedPool
WITH (MAX_IOPS_PER_VOLUME = 100);
GO

CREATE WORKLOAD GROUP IOLimitedGroup
USING IOLimitedPool;
GO

ALTER RESOURCE GOVERNOR RECONFIGURE;
GO
资源调控器的I/O上限不是性能优化按钮。若分类器把核心交易流量误分配到受限池,结果会比原问题更糟。
七、三类典型案例
案例1:PAGEIOLATCH_SH高,但真正的问题是大范围扫描
现象: 查询响应时间升高,PAGEIOLATCH_SH在故障窗口内快速增加。
证据: 文件级统计显示数据文件读延迟中等,但当前请求逻辑读极高;执行计划显示选择性较差的谓词导致大范围扫描。
处理: 优先调整索引、统计信息和查询条件,复测逻辑读和物理读;存储升级作为容量和长尾延迟仍不足时的备选。
结论: PAGEIOLATCH是等待页读入的结果,不能直接证明阵列故障。
案例2:WRITELOG高,日志盘延迟和提交频率共同造成压力
现象: 高峰期提交请求变慢,WRITELOG占比上升。
证据: 日志文件写延迟明显高于数据文件;应用以很小的事务批次频繁提交,日志文件同时发生自动增长。
处理: 先消除频繁增长,评估合理批量和事务边界,再核验日志存储延迟。任何扩大事务范围的改动都要评估锁持有时间和故障恢复成本。
案例3:tempdb I/O和PAGELATCH同时出现
现象: tempdb相关等待增加,应用报告报表和批处理变慢。
证据: 一部分请求发生排序溢出并产生物理读;另一部分请求在PFS页上出现闩锁争用。
处理: 分开治理:对排序溢出修正估算、索引和内存授予;对分配争用检查文件数量、文件大小一致性和临时对象创建模式。
7.4 示例输出:从数字到判定
| 证据 | 示例值 | 判读 |
|---|---|---|
delta_wait_ms / 60秒 |
PAGEIOLATCH_SH = 42,800 ms |
读等待在窗口内显著增加 |
| 数据文件平均读延迟 | 18.4 ms | 需要结合存储基线和查询读量 |
max_physical_reads |
1,240,000 | 发现峰值I/O查询,不能等同于每次执行 |
Avg. Disk sec/Write |
0.012 sec | 约12ms写延迟,需与日志路径基线比较 |
以上为解释判读逻辑的模拟输出,不是特定生产环境实测值。
八、I/O优化的变更顺序
- 记录故障窗口的等待增量、文件级延迟和请求文本;
- 判断问题是数据读、日志写、tempdb还是备份/文件操作;
- 先修复查询、事务、增长和工作负载问题;
- 再评估文件布局、存储池和介质升级;
- 变更后用同一采样窗口复测;
- 保留回退方案,不在多个层面同时改动导致无法归因。
8.1 I/O优化闭环流程图
下面的流程图将等待增量、文件级I/O统计、数据/日志/tempdb分类和变更复测串成一条路径,避免把单一等待类型直接当成存储根因。
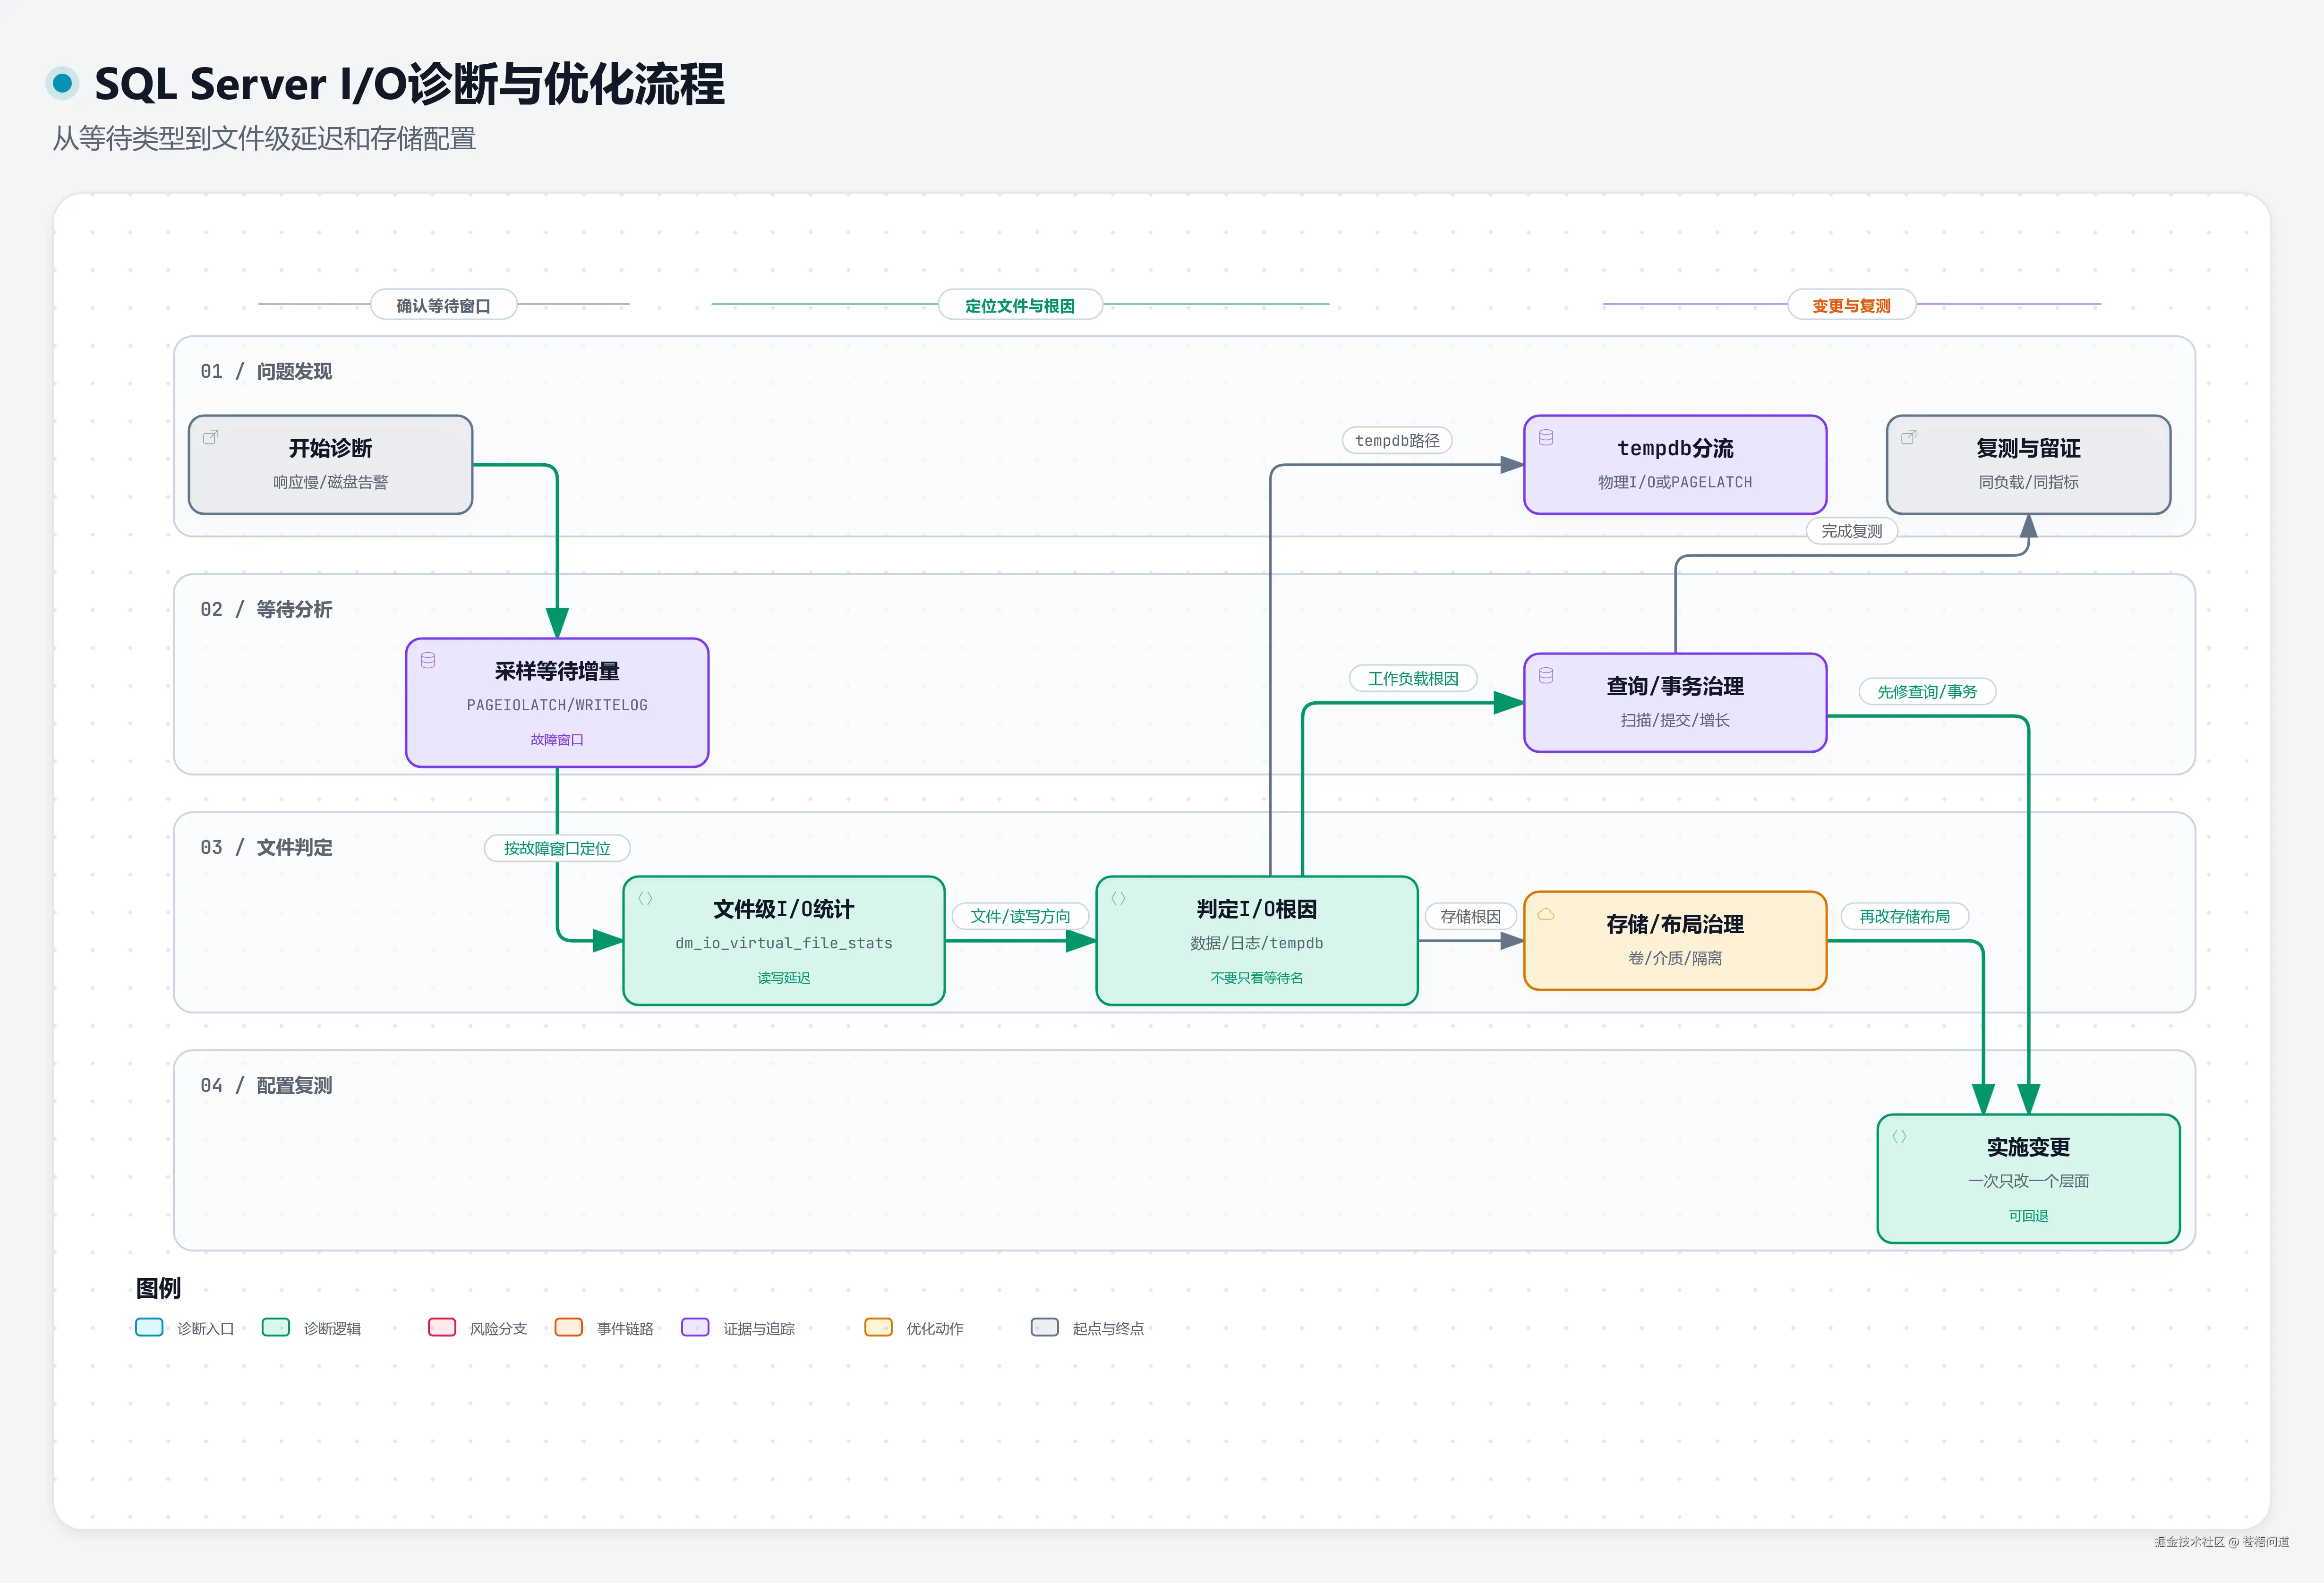
图:I/O诊断与优化示例流程;存储配置应建立在目标环境的文件级延迟和工作负载证据上。
九、I/O问题排查清单
- 等待统计是累计值还是故障窗口增量?
- 等待类型是否映射到了具体请求和文件?
- 数据文件、日志文件和tempdb的I/O模式是否混在一起?
- 文件级读写延迟是否集中在单个文件或存储池?
- 逻辑读是否异常高,是否存在扫描、错误估算或索引缺失?
- 日志写入是否与频繁提交、日志增长或日志消费者相关?
- tempdb是物理I/O,还是PAGELATCH分配争用?
- 盘符分离是否真的对应物理或服务等级分离?
- 文件增长是否按固定MB规划,是否存在频繁增长?
- 变更前后是否使用相同指标、相同时间窗口和相同业务负载?
十、总结
I/O优化不能从"换更快的盘"开始,而要从等待类型和文件级证据开始。
PAGEIOLATCH_*要结合逻辑读、物理读和文件延迟分析;WRITELOG要同时看日志存储、事务边界和日志增长;ASYNC_IO_COMPLETION与IO_COMPLETION必须结合请求类型解释;- tempdb的物理I/O和分配闩锁争用要分开处理;
- 存储布局和介质升级必须建立在实际拓扑与基线数据上。
前一篇解决了"SQL Server是否真的在承受内存压力";这一篇继续追问"等待的I/O到底发生在哪个文件、由什么工作负载触发"。下一篇将进入事件证据层:使用Extended Events捕获死锁、慢查询、阻塞和等待分布。
系列文章预告
本文是"SQL Server性能优化实战系列"的第4篇,后续文章:
- 第5篇: SQL Server扩展事件(Extended Events)完全指南
- 第6篇: tempdb性能优化完全指南:从空间管理到并发争用
关于作者
Master Xu ,**20+**年IT、通信、电信、医疗、制造行业经验,企业级数据库架构师。
擅长企业IT架构规划、数据库性能优化、大型复杂项目交付。
欢迎交流技术话题:
- Email: xcoolwinds@gmail.com
- 知乎: www.zhihu.com/people/da-f...
- 掘金: juejin.cn/user/373549...
- CSDN: blog.csdn.net/xcoolwinds
开放合作: 技术咨询 | 架构顾问 | 企业内训 | 技术分享
标签
#SQLServer #SQLServer性能优化 #IO性能优化 #存储优化 #DBA #数据库调优
声明: 本文所有脚本均在SQL Server 2016/2019/2022环境下测试通过,但在生产环境使用前请先在测试环境验证。
版权: 本文为原创文章,转载请注明出处。