曾经要做成一个项目的数字人,如今开始变成一次 API 调用。
一张人物图片,一段声音,就能生成一段人物对着镜头说话的视频。过去要稳定制作一个特定的数字分身,往往还要录制、建模、训练和调试。门槛降得这么快,难免让人兴奋,也容易让人误判。
但"一张照片会说话"早就不是新鲜事。几年前的 Talking Head 就能做到。为什么这一轮数字人又让人觉得,事情可能要变了?
答案藏在几个同时发生的变化里:人物开始像是在"表演",创建角色不再总要先做一套资产,生成速度也在逼近视频播放的速度。HeyGen Avatar IV、Synthesia 的 Avatar 产品,以及 fal 推出的 H3 Max Lip Sync,正从不同方向推动这件事。当一个数字人从制作项目变成随时可以调用的能力,它会先改变什么?
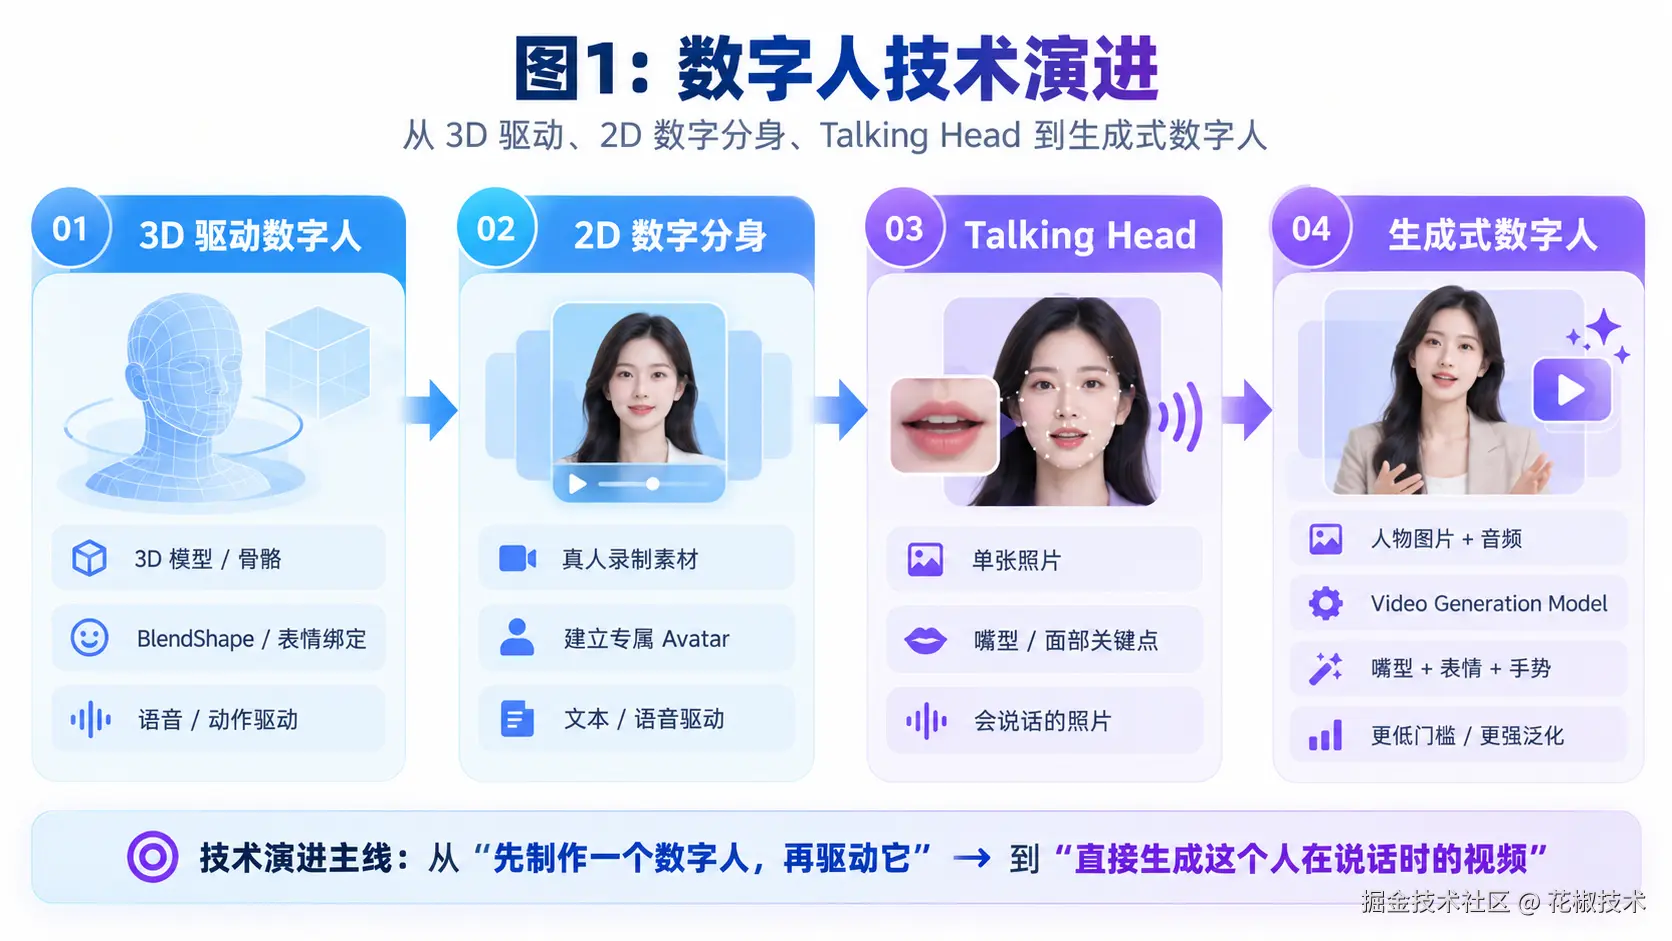
一、数字人的前世:先有一个"人",再想办法驱动它
早期数字人的基本思路其实非常直接:先制作一个数字角色,再想办法让它动起来。最典型的是 3D 数字人。
这种技术路线直到今天依然很重要,优势是稳定、实时和可控。嘴张多大、眼睛看哪里、手抬到什么位置,都可以由明确的参数描述。模型一旦建好,也能够长时间稳定运行,适合游戏角色、虚拟主播以及需要实时交互的场景。难的是角色的起点:换一个人,往往就得重新制作人脸、骨骼、表情和动作资产。
后来出现了更加轻量的 2D 数字人和数字分身方案。相比 3D 数字人,这类方案大幅降低了建模门槛,但本质逻辑并没有发生太大变化:仍然是先建立一个数字人资产,再通过新的输入去驱动它。
更早期的 Talking Head 则进一步降低了门槛,一张照片就可以开口讲话。但这些模型通常高度聚焦于脸部区域,主要解决音频与嘴型、面部关键点之间的映射关系。最终结果往往是嘴动了,眼神却没跟上;脸动了,身体仍然僵着。它会说话,却还不像一个人在表达。
二、真正的技术转折:从"驱动一个人"到"生成一个人"
Diffusion、Video Transformer 以及大规模视频生成模型的发展,开始改变数字人的技术定义。过去数字人研究的核心问题是:"已经有了这个数字人,如何让它按照声音动起来?"而现在,越来越多模型开始直接解决另一个问题:"这个人在说这句话的时候,画面应该是什么样?"
这两种思路背后的技术路线不同。传统方案更强调音频到音素、嘴型、关键点、BlendShape,再到最终渲染的映射过程;生成式数字人则把人物图片、音频以及上下文交给视频生成模型,由模型共同生成嘴型、表情、头部动作、手势乃至身体运动。
2025 年公布的 OmniHuman-1 就已经非常典型,它把人物动画作为一个完整的视频生成问题来训练,可以处理近景、半身甚至全身人物,同时支持说话、唱歌、复杂姿态以及人与物体交互。
到了 2026 年,这种能力已经快速进入商业产品。HeyGen Avatar IV 等产品,也开始呈现人物的语调、节奏、表情与肢体动作。
H3 Max Lip Sync 出现之前,生成式数字人的技术能力已经发展得相当远。它值得观察的地方,是能否让这些能力以更低的门槛进入开发流程。
三、为什么偏偏是现在?数字人跨过了多个临界点
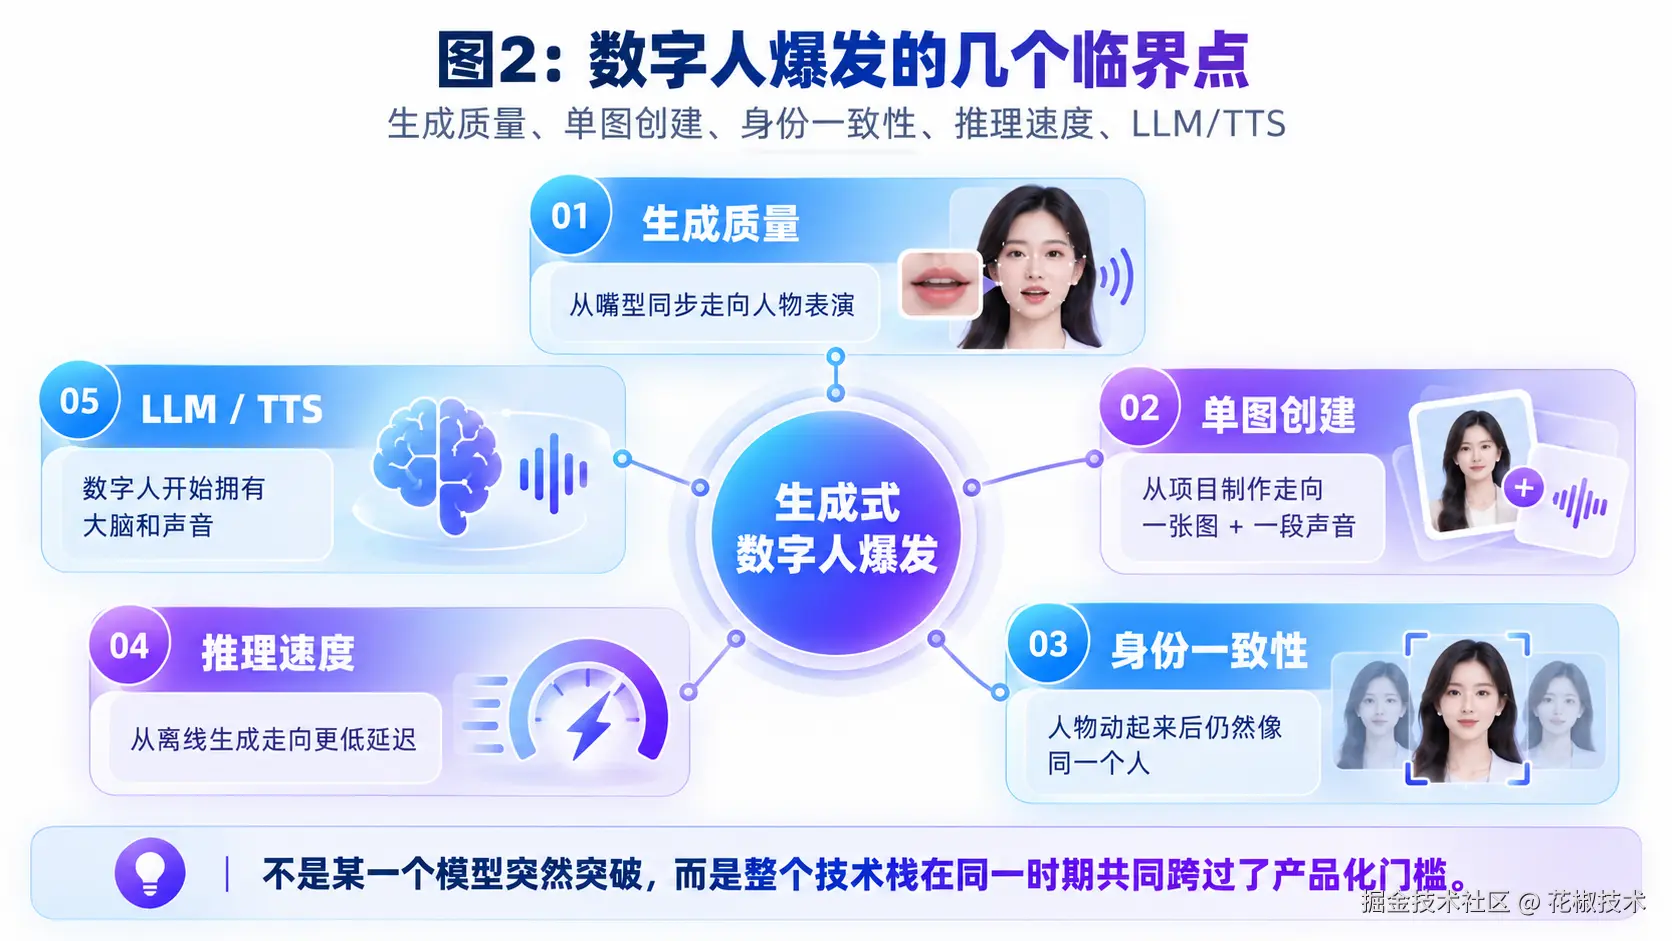
为什么是现在?因为让数字人"看起来能用"和"真的能被产品调用",是两道不同的门槛。几项长期发展的技术,正在相近的时间跨过后一道门槛。
第一个临界点,是人物终于不只会动嘴。真实的人说一句话,并不只是嘴巴运动,还包括眉毛变化、眼神、头部倾斜、停顿、身体重心变化以及手势。
第二个临界点,是换一个角色不必总从头制作。换一个人物,不一定意味着重新训练模型,很多时候只是换一张图片。当一个能力从"需要项目交付"下降到"调用一次接口",它能够覆盖的应用范围自然会迅速扩大。
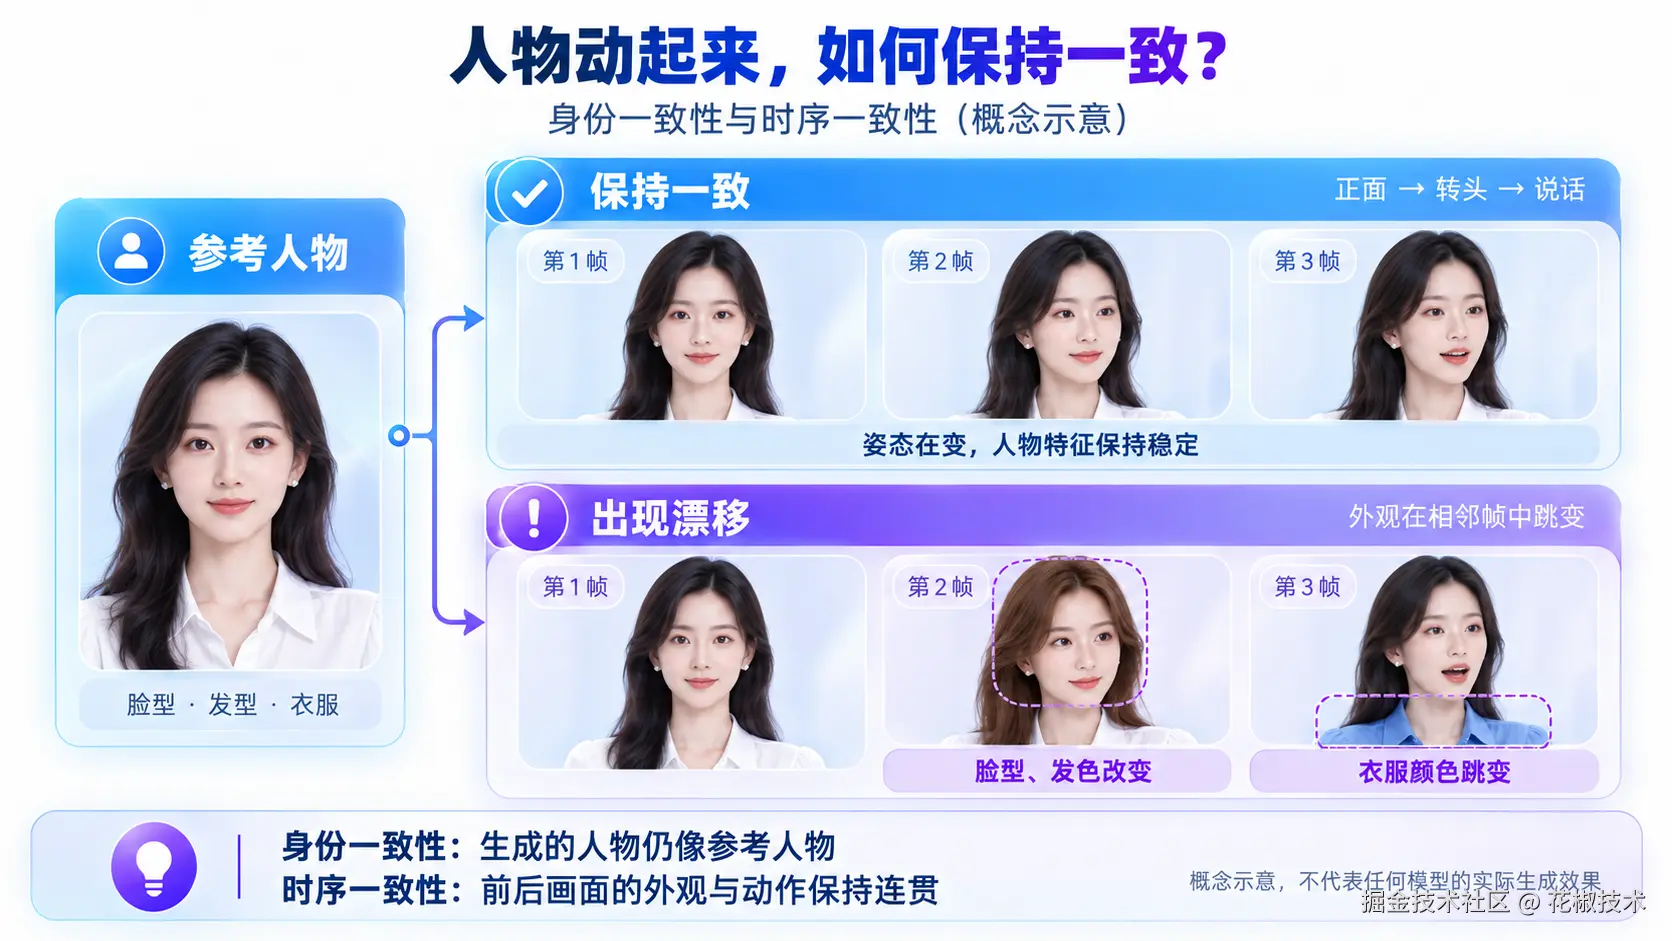
第三个临界点,是人物动起来以后还能不能"是这个人"。过去几年视频生成模型在身份一致性保持(Identity Preservation)和时序一致性(Temporal Consistency)上持续进步,通过参考图条件、身份特征和时序建模等方式,人物在运动过程中越来越能够保持稳定的身份和风格。这也是今天的单图数字人和几年前"照片说话"效果差异很大的原因之一。
第四个临界点,是等待时间。视频生成过去长期存在一个问题:慢。假如生成 10 秒视频需要等待几十秒甚至几分钟,即使质量很好,它依然更适合作为离线内容生产工具,可以用来制作广告、课程、短视频和营销素材,但很难进入实时客服、数字主播、游戏 NPC 或陪伴型 Agent 等交互场景,因为用户不可能问一句问题后等待很长时间才看到对方回答。
H3 Max 所代表的一个重要变化,是通用视频生成在特定条件下已经出现 faster-than-real-time 的结果:生成一段视频所需的时间,小于视频本身的播放时间。fal 发布的测试数据显示,H3 Max 生成一段 5 秒、768p 的视频用时约 2.78 秒。这个数字属于 H3 Max 的通用视频生成测试,不能直接当作 H3 Max Lip Sync 的响应时间。
第五个临界点在视频模型之外:大语言模型和语音技术开始接上这张"脸"。数字人因此开始具备成为 Agent 视觉界面的条件。单看其中任何一项,都难以解释这一轮热度;它们一起跨过门槛,才让数字人有机会走出 Demo。
四、H3 Max Lip Sync 到底推动了什么?
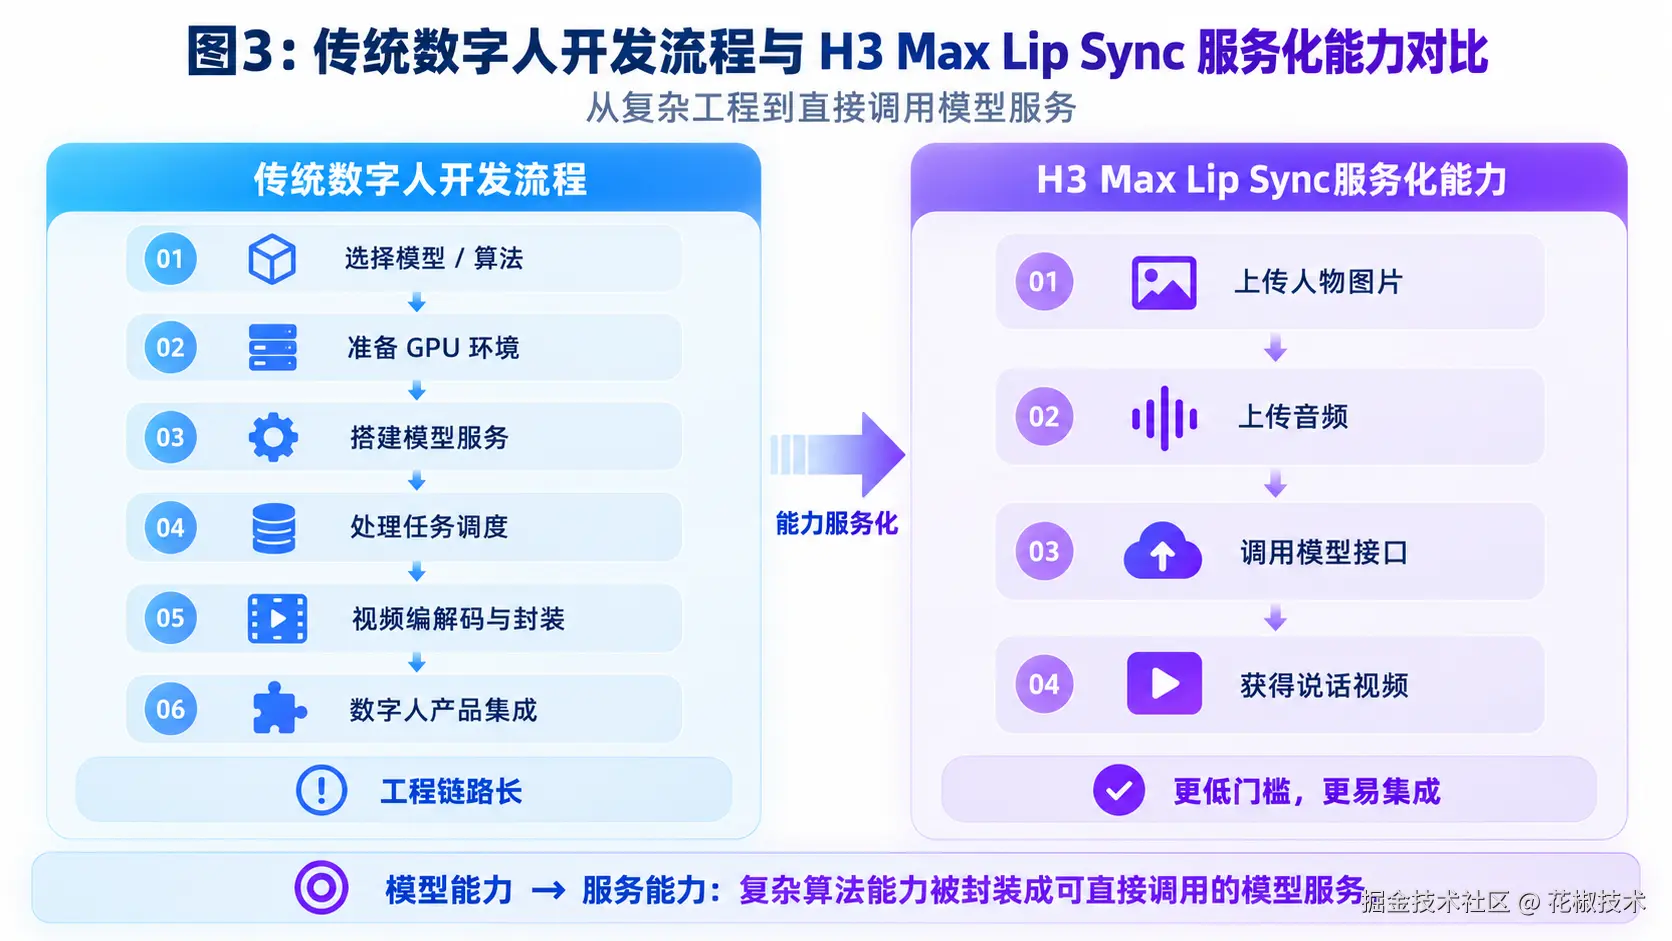
理解了前面的技术演进,再来看 H3 Max Lip Sync,就更容易判断它真正的价值。它并不是第一个让单张图片开口说话的模型,更重要的意义在于,把已经逐渐成熟的生成式数字人能力进一步封装成了一个标准化、可直接调用的模型服务。
H3 Max Lip Sync 的核心输入是人物图片和音频。按当前官方接口文档,音频支持 5 秒至 15 分钟,视频时长与输入音频一致;输出可选 480P、768P、1080P 和 2K,也可以选择是否用语音转写辅助口型同步。
想先看效果,可以打开 fal 的 H3 Max Lip Sync 官方演示。
一个模型能在论文或 Demo 中跑出来,和大量开发者能够低门槛调用,是两个完全不同的阶段。前者证明技术可行,后者才真正具备催生大量产品的条件。很多技术真正大规模扩散,并不是发生在第一个模型被提出的时候,而是在能力被标准化、服务化之后。
H3 Max Lip Sync 还体现了另一个趋势:数字人正在从一套相对独立的专用算法,逐渐变成通用视频生成模型的一项能力。过去的数字人技术栈强调嘴型、关键点和人脸重建;现在,它越来越依赖通用视频基础模型的身份保持、动作生成、时序一致性和视觉生成能力。数字人与视频生成之间的技术边界,正在变得越来越模糊。
五、H3 Max 真正改变的,是数字人的时间尺度
理解 H3 Max 价值时,可以做一个简单类比。假设有一台相机,照片质量很高,但每拍一张都要曝光一分钟。它可以拍静物,却很难拍下运动。后来曝光时间降到 1/30 秒,改变的不只是拍摄效率:连续画面开始成为可能。
生成式视频正在经历类似的变化。
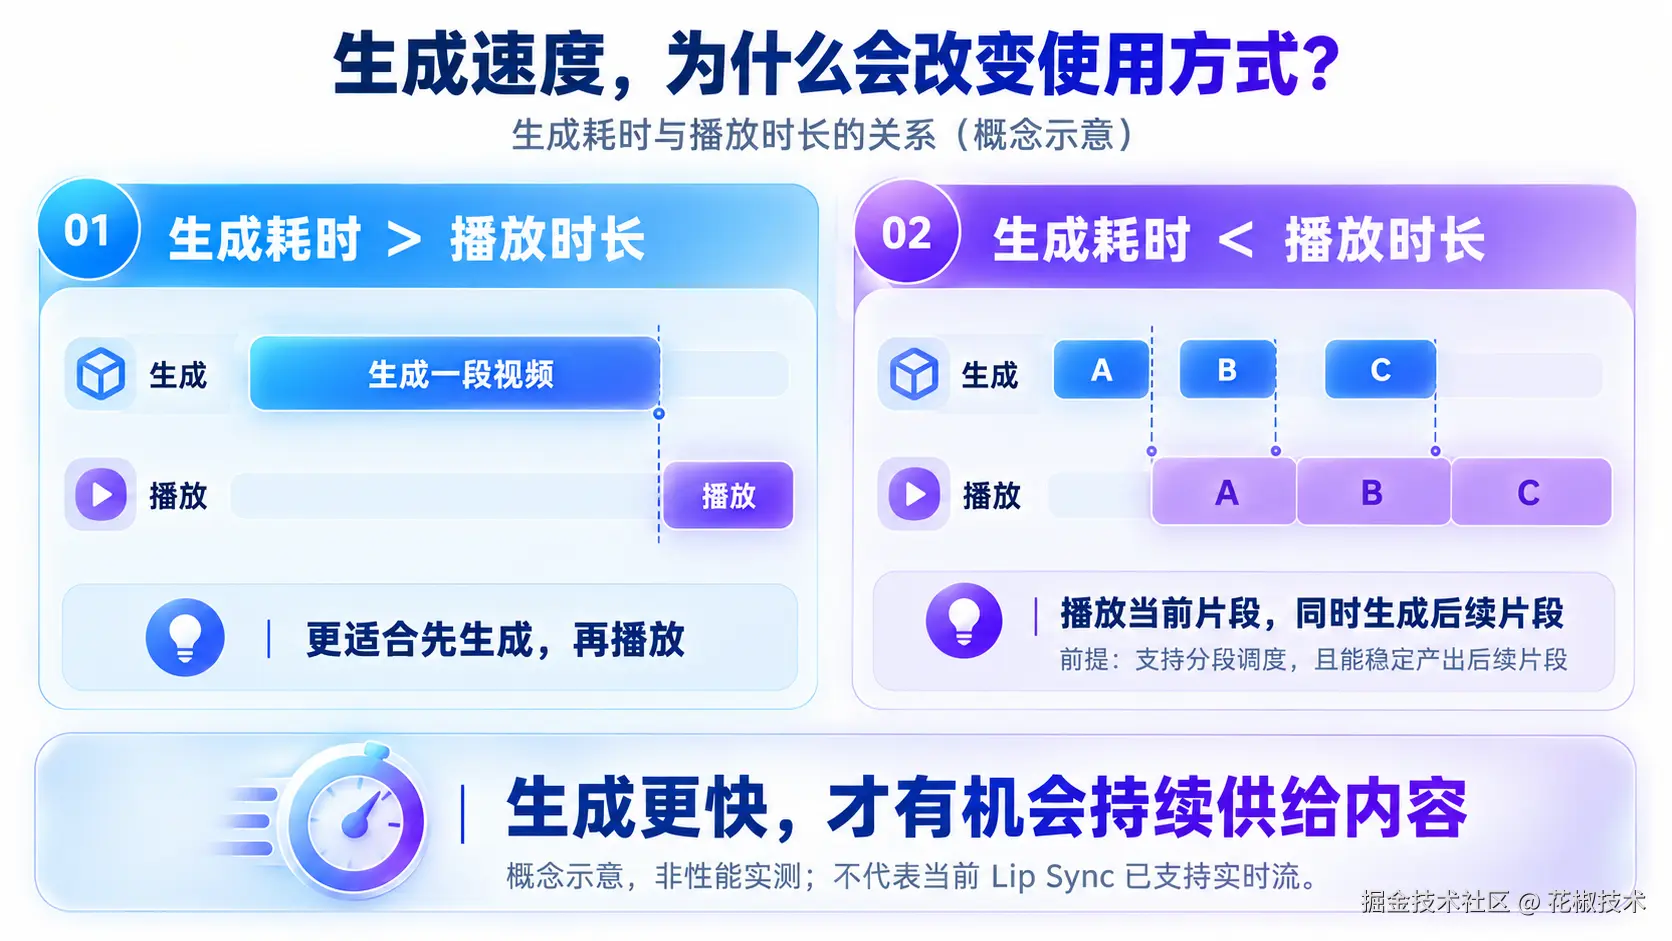
这里需要区分 H3 Max 通用视频生成能力和 H3 Max Lip Sync 这个具体产品。H3 Max Lip Sync 当前仍采用任务式生成方式,官方接口提供任务状态查询和回调,并不是持续输出实时视频流的数字人系统。但 H3 Max 所代表的视频生成加速,让"生成式数字人如何进一步进入实时链路"从遥远概念,变成值得认真研究的工程问题。
这也是为什么可以说,H3 Max 所带来的重要变化之一,是数字人的"时间尺度"。过去生成式数字人主要用于培训、营销、新闻口播、产品介绍等提前制作的内容;下一阶段,它开始有机会进入 AI 客服、AI 教师、数字主播、游戏 NPC、虚拟陪伴和实时主持人这些强交互场景。
六、下一代数字人,可能会变成 Agent 的"脸"
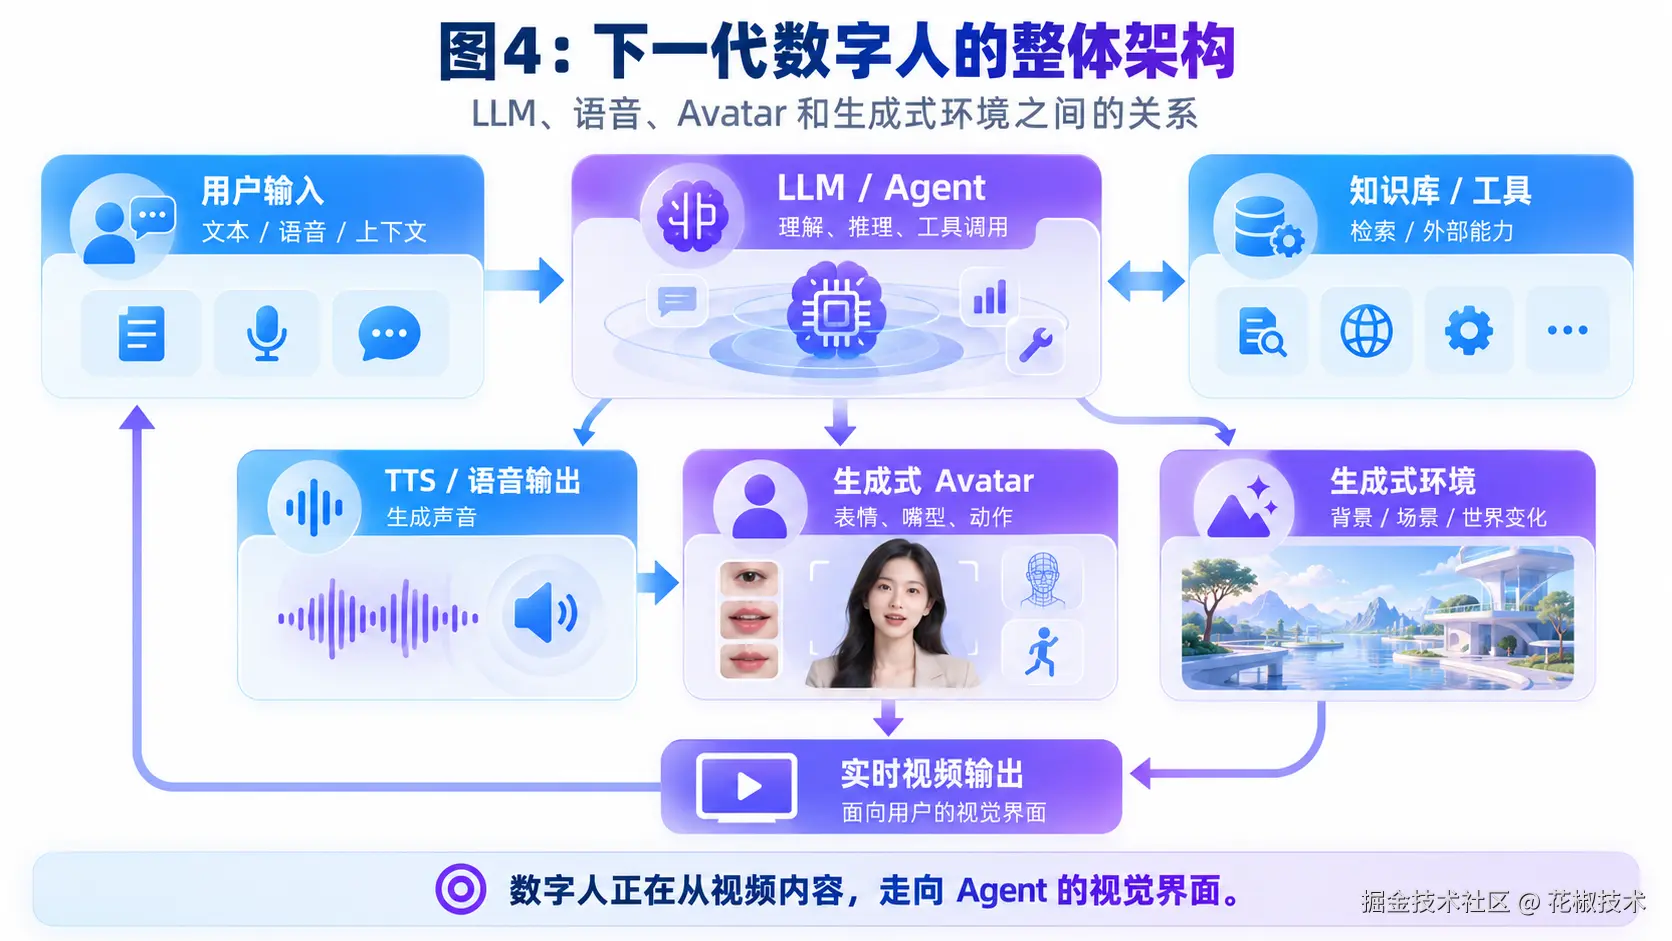
当生成式数字人继续向低延迟发展,数字人的角色也会发生变化。传统数字人主要负责把一句已经确定的话"演出来",而新的系统会先理解用户的输入,再由大模型进行推理、访问知识库或调用工具,最后生成回答,并通过语音和数字人表达出来。
在这种架构下,数字人不再是一个独立内容产品,而更像 Agent 的视觉界面。Synthesia 的 Interactive Avatars API 已提供实时对话中的数字人渲染能力;Avatar 开始成为交互系统里的一个组件。
直播提供了一个观察这种变化的窗口。观众不会只看数字人像不像真人;问题能不能及时得到回应,声音、表情和动作能不能接住对话,互动能不能持续下去,都会影响他们是否愿意继续看。花椒直播长期关注可能改变内容生产和互动方式的技术,生成式数字人是其中值得持续观察的方向。它距离成熟的直播互动还有工程问题要回答,但方向已经足够令人好奇。
再往前一步,数字人甚至可能不再局限于生成"一个人在固定背景前讲话"。随着 H3 Max Director、实时生成视频以及 World Model 类技术继续发展,人物所处的环境本身也可能变成动态生成内容。数字主播说"我们去海边看看",场景可能逐渐变化成海边;用户说"开始下雨",后续世界随之变化。到那个阶段,实时大语言模型、实时语音、生成式 Avatar 和生成式环境会逐渐融合,数字人与视频生成、Agent 甚至 World Model 之间的边界也会越来越模糊。
七、数字人这一次为什么可能真的不一样?
回看过去十年的数字人技术,大致可以看到三个阶段。第一阶段解决的是"怎么制作一个数字人",第二阶段解决的是"怎么让数字人越来越像真人",而现在这一轮生成式数字人正在解决一个新的问题:怎么让数字人本身从昂贵资产,变成一种随时可以生成和调用的能力。
所以,H3 Max Lip Sync 最值得关注的地方,并不是它第一次让照片开口说话,而是它所代表的这一轮生成式视频技术正在同时推动三件事情:更低的数字人创建门槛、更低的工程部署门槛,以及越来越接近实时交互的生成效率。
如果用一句话概括 H3 Max Lip Sync 所处的位置,可以这样说:
H3 Max 没有发明数字人,它正在改变数字人的时间尺度和工程门槛。
当生成一个会说、会动的人,逐渐像调用一次普通 API 那样容易时,数字人的大规模应用,或许才刚刚开始。