《手搓 Agent》系列第 4 篇,共 10 篇。系列导读与目录|上一篇:睁开眼睛------上下文是它看到的全部世界
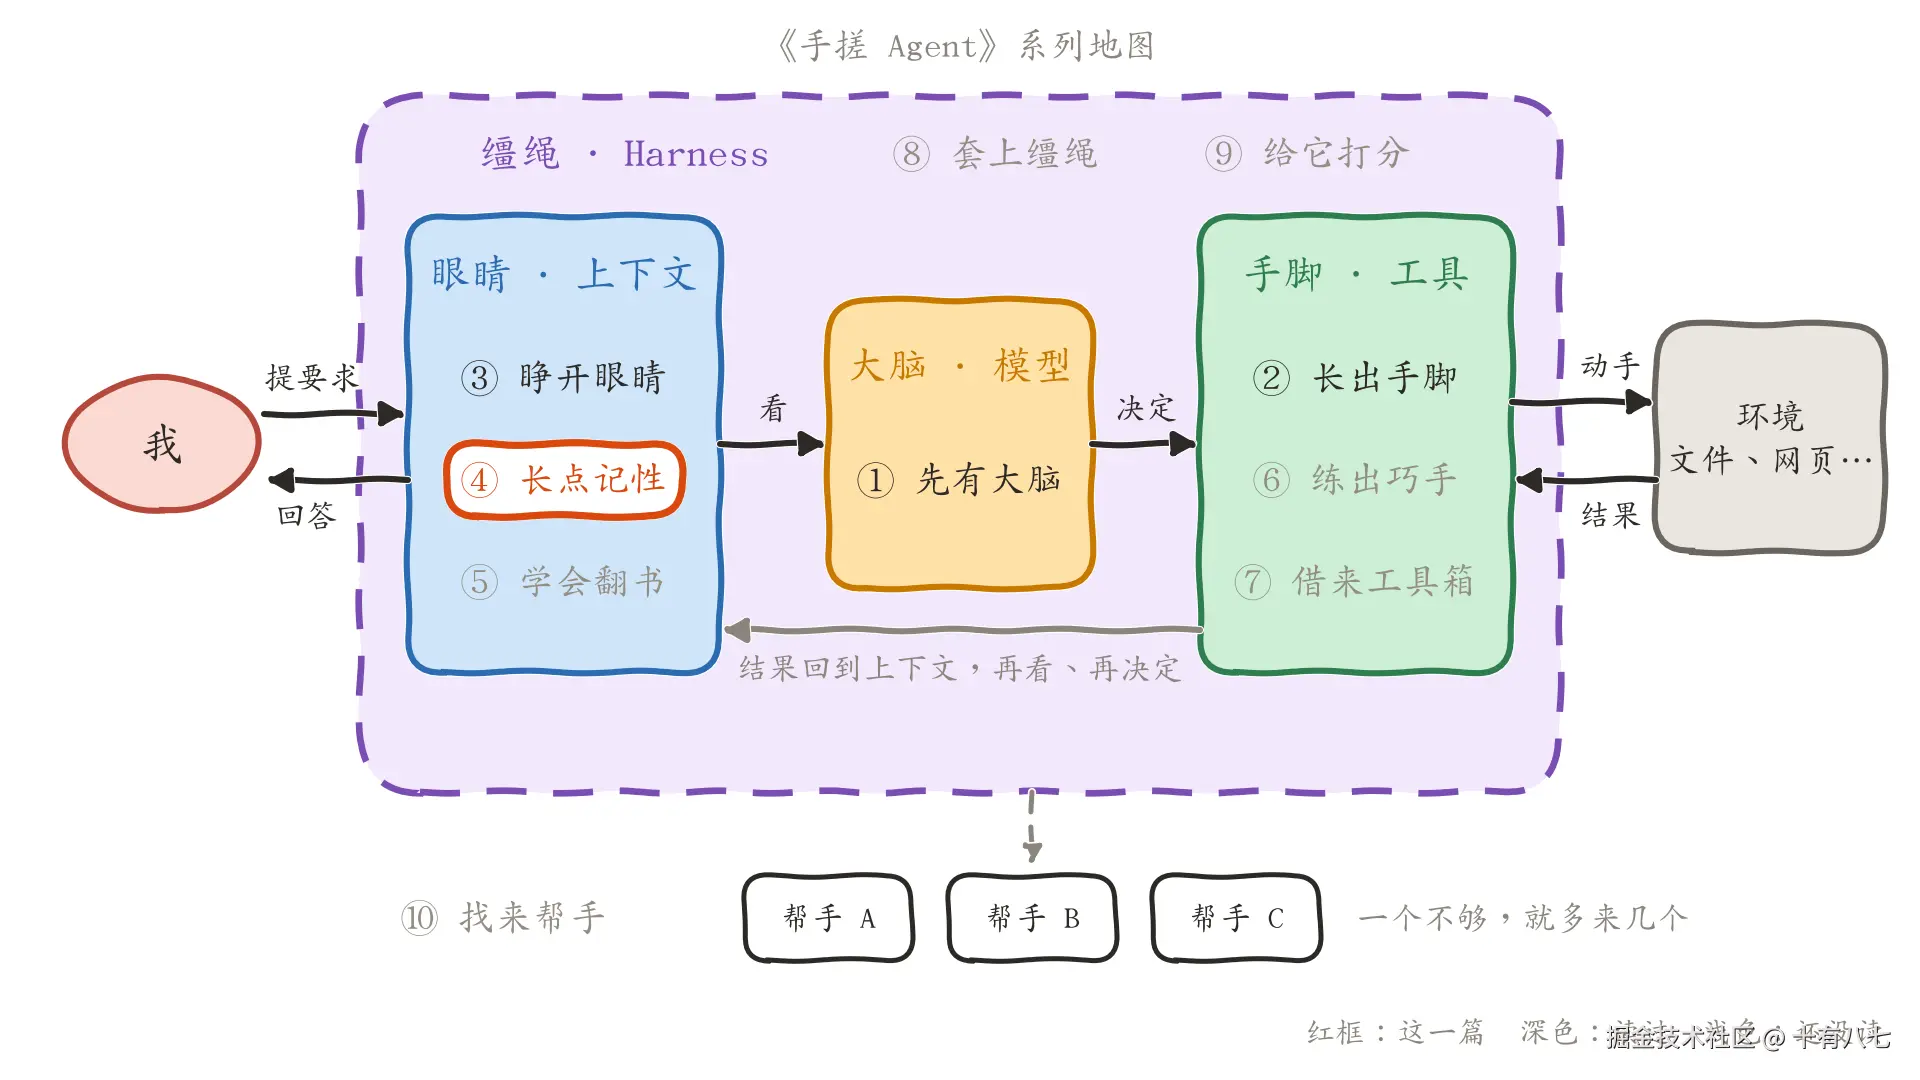
图 4-1 系列地图。这一篇还在蓝色的框里:眼睛。
前言
上一篇留下两个问题:轨迹只增不减,早晚装不下;程序一关,它什么都不记得。
这两个问题说的其实是同一件事:记性。我原来以为"记忆"是模型的一项功能,打开某个开关它就记住了。学到这里才明白,模型没有这项功能。第一篇讲过,它的参数训练完就固定了,每次请求对它都是全新的。所谓记性,全是在上下文上做文章。
- 这一次对话里它记得前面的事,是因为前面的内容还在上下文里。
- 下一次对话它还记得,是因为有人把东西存在了外面,下次又放回了上下文。
这一篇把这两种记性都做出来,小记升到 v0.4。
本篇要点:
- 上下文有上限,而且不等装满,模型就开始漏看重点。
- 轨迹太长有三条出路:裁剪、压缩、外置,各有代价。
- 跨会话的记忆就是一个文件:该记的写进去,下次启动时读回上下文。
一、窗口有限,而且不等装满就出问题
模型一次最多能看多少 token,有个上限,叫上下文窗口。不同的模型从几万到上百万不等。超过了,请求直接报错。
没超过也不保险。上下文里的内容越多,模型越容易漏掉其中某一条,夹在中间的尤其容易漏。这和人差不多:一口气读完一百页材料再回答问题,往往不如只读相关的三页答得好。这个现象有个名字,叫上下文腐化。
所以不能等到报错才处理。我的做法是给自己定一个比上限低不少的预算,轨迹一超过预算就动手。
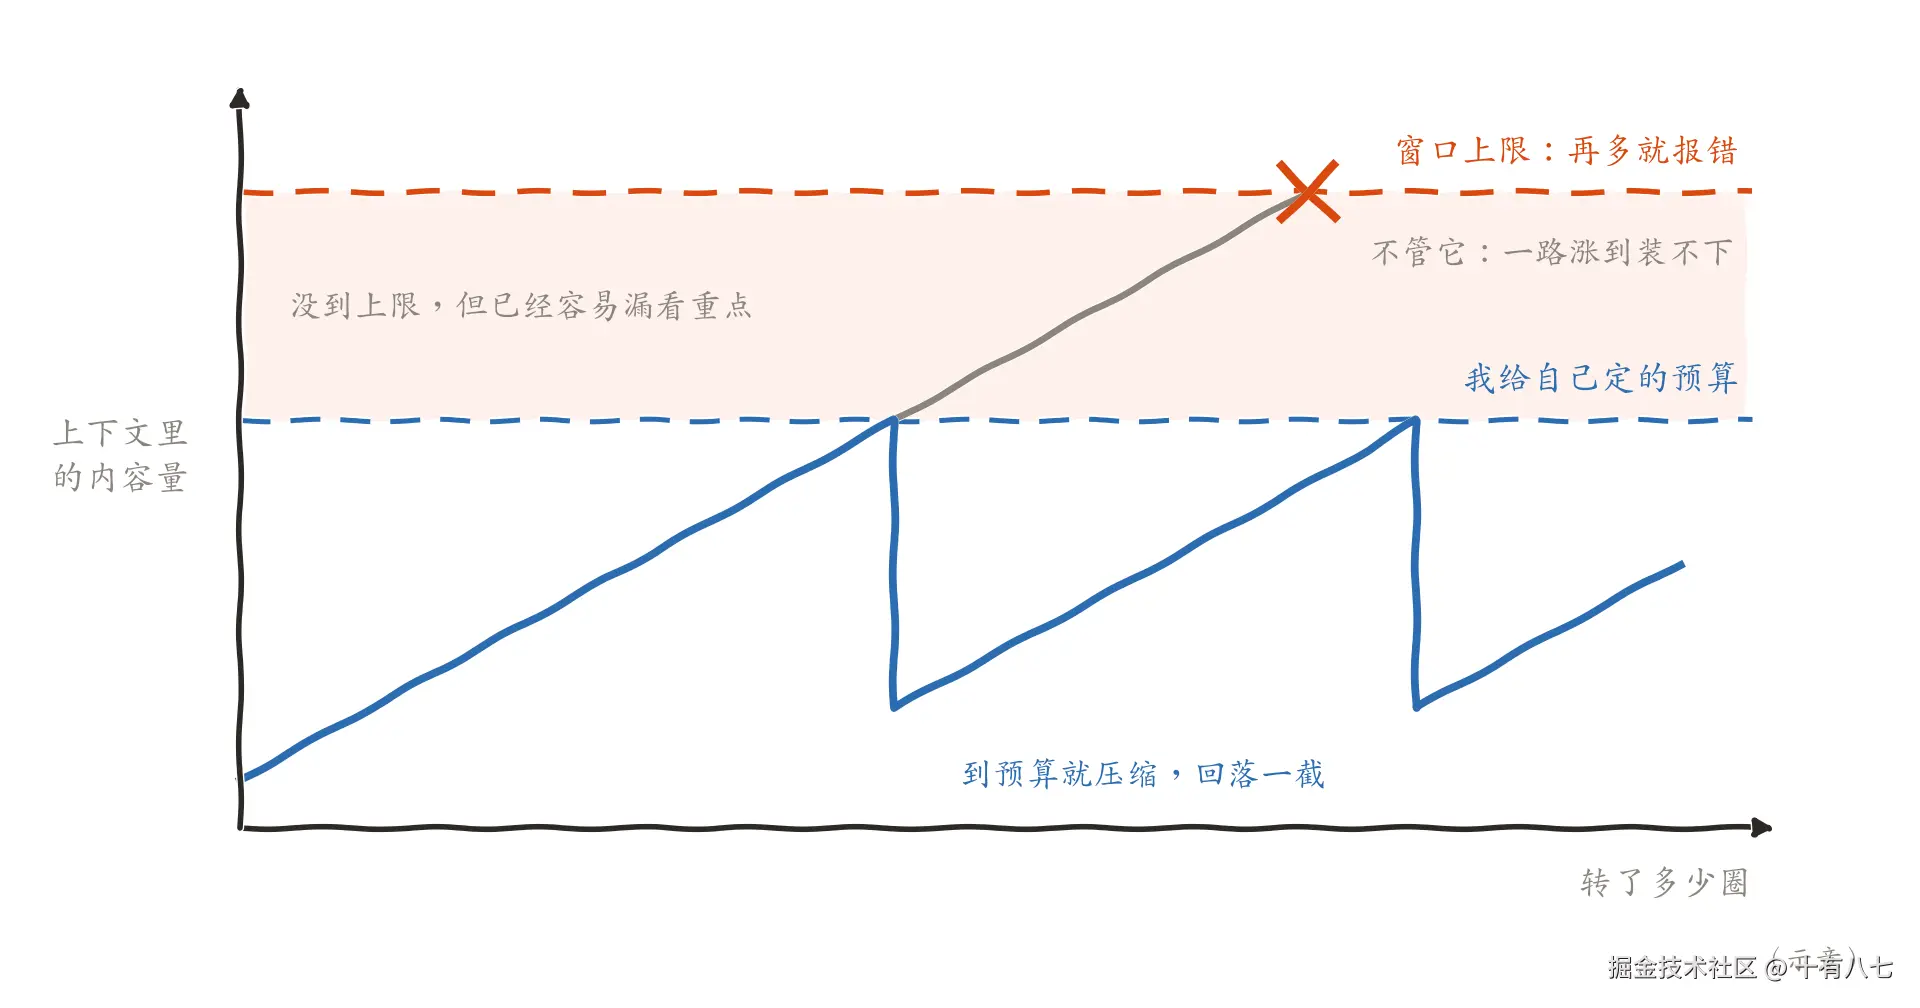
图 4-2 灰线不管它,一路涨到装不下。蓝线到预算就压缩一次,一直留在安全的范围里。
再加上一篇算过的账:上下文越长,每一圈越贵。控制上下文的长度,一是为了不报错,二是为了答得准,三是为了省钱。
二、三条出路
轨迹太长,能做的事情有三种。
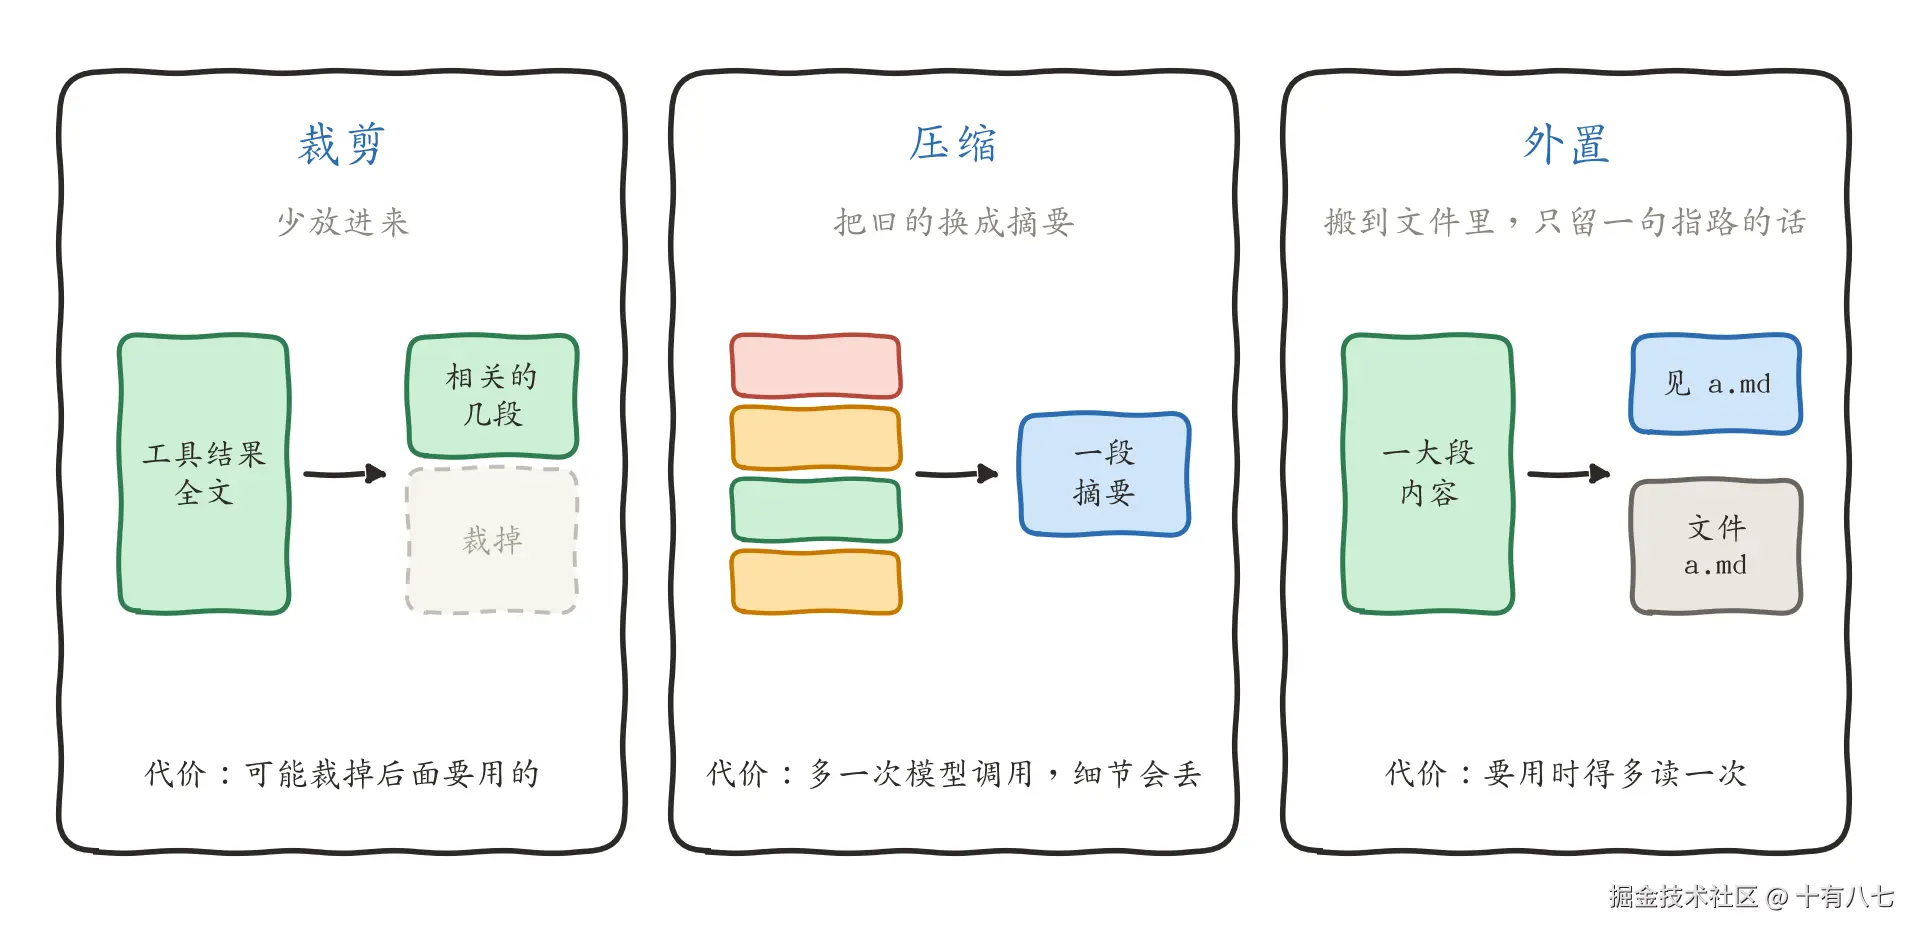
图 4-3 裁剪是少放进来,压缩是换成短的,外置是搬到别处。
2.1 裁剪:一开始就少放进来
上一篇称过重,上下文的大头是工具结果。最划算的办法,是工具一开始就别返回那么多。
- 读笔记的工具只返回前两千字,末尾注明"后面还有,需要的话再读下一段"。
- 搜索的工具只返回命中的那几行,不返回全文。
- 已经在轨迹里的旧工具结果,换成一句"内容已省略,需要时重新读取"。
代价是可能裁掉后面要用的东西。所以裁剪的时候要留一条退路,让它知道还能再取回来。
2.2 压缩:把旧的换成摘要
把较早的一大段轨迹交给模型,让它写一段摘要,然后用摘要替换原文。
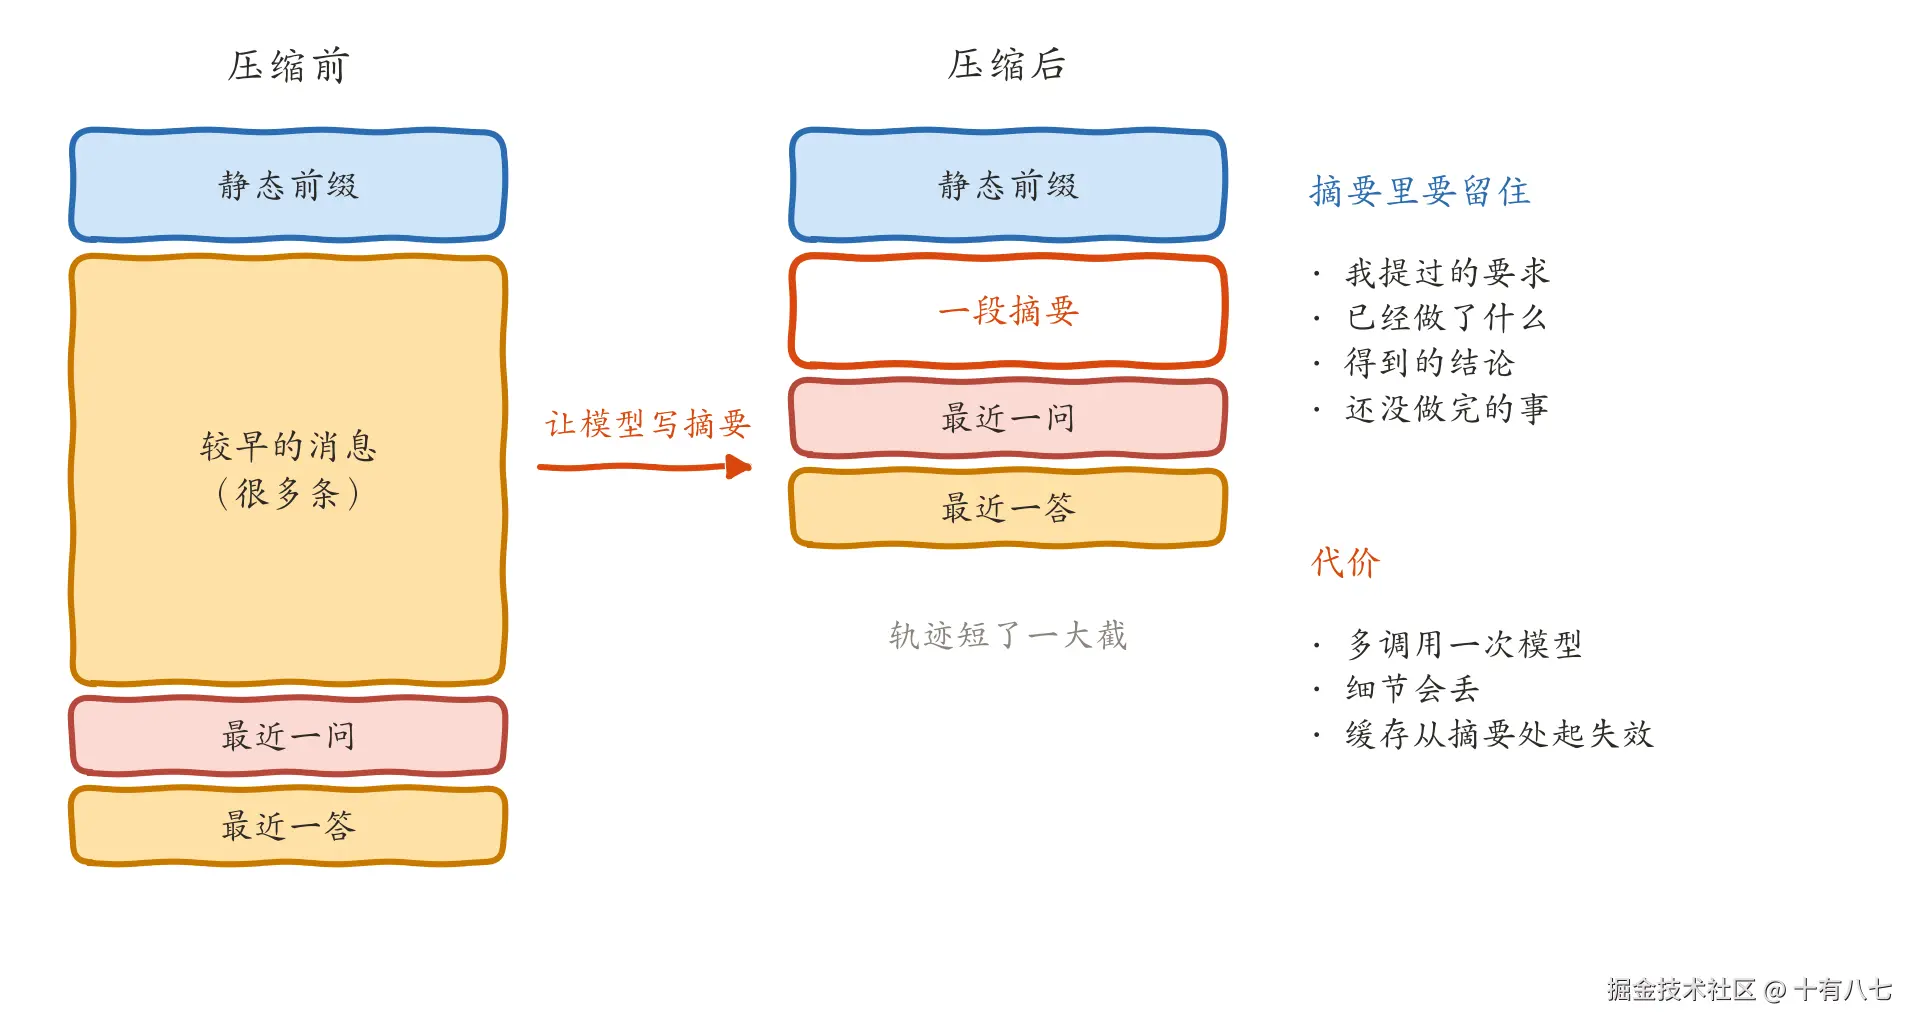
图 4-4 压缩之后轨迹短了一大截,但摘要里没写的东西,就真的没了。
摘要里至少要留住四样:我提过的要求,已经做了什么,得到的结论,还没做完的事。少了任何一样,它接下来都可能走偏。
压缩有三个代价。一是要多调用一次模型。二是细节一定会丢。三是和上一篇讲的缓存有冲突:压缩改动了前面的内容,从摘要那里开始,缓存全部失效。
因为第三条,压缩不能每圈做一点,那样每圈缓存都失效。要攒到预算再一次压掉一大截,图 4-2 的蓝线才是锯齿形的。
2.3 外置:搬到文件里
把内容搬到上下文之外,上下文里只留一句指路的话。
比如小记读完十篇笔记,写出了一份汇总。这份汇总不必留在轨迹里,可以写进 汇总.md,轨迹里只留一句"汇总已写入 汇总.md"。后面要用到细节,再去读这个文件。
文件几乎没有容量限制,这一点上下文比不了。长任务里让 Agent 一边做一边把进度和结论记到文件里,也是这个道理:就算后来轨迹被压缩了,文件里的东西还在。
三条出路可以一起用,放在一起比一比:
| 做法 | 代价 | |
|---|---|---|
| 裁剪 | 工具少返回,旧结果省略 | 可能裁掉后面要用的 |
| 压缩 | 旧轨迹换成摘要 | 多一次调用,丢细节,缓存失效 |
| 外置 | 内容写进文件,只留指路的话 | 要用时得多读一次 |
三、动手:超出预算就压缩
下面是压缩的代码。要看的是 compact 函数怎么把轨迹切成"较早的"和"最近的"两段。
python
import json, os, pathlib
from openai import OpenAI

client = OpenAI(base_url=os.environ["LLM_BASE_URL"], api_key=os.environ["LLM_API_KEY"])
MODEL = os.environ["LLM_MODEL"]
BUDGET = 600   # 轨迹的字符数预算。为了演示设得很小,实际要按模型的窗口大小来定

def as_dict(m):
    return m if isinstance(m, dict) else m.model_dump(exclude_none=True)

def compact(messages):
    """轨迹超出预算时,保留最近一轮问答,把更早的部分换成一段摘要。"""
    history = [as_dict(m) for m in messages[1:]]
    last_user = max((i for i, m in enumerate(history) if m["role"] == "user"), default=0)
    old, recent = history[:last_user], history[last_user:]
    if len(json.dumps(history, ensure_ascii=False)) <= BUDGET or not old:
        return messages
    ask = ("下面是一段较早的对话记录。请写一段简短的摘要,要保留:我提过的要求、已经做了什么、"
           "得到的结论、还没做完的事。\n\n" + json.dumps(old, ensure_ascii=False))
    summary = client.chat.completions.create(
        model=MODEL, messages=[{"role": "user", "content": ask}]).choices[0].message.content
    print(f"  [压缩] 把较早的 {len(old)} 条消息换成了一段摘要")
    return [messages[0], {"role": "user", "content": "【之前对话的摘要】\n" + summary}] + recent
几个要点:
- 切的位置选在最后一条
user消息。它之前的是"较早的",换成摘要;从它开始的是最近一轮问答,原样保留,因为最近的内容最可能马上用到。 - 写摘要用的是一次单独的模型调用,和主循环无关。给它的要求里写明了要保留哪四样。
- 返回的新列表是:系统提示词、摘要、最近一轮。系统提示词原封不动,所以静态前缀的缓存还在。
四、跨会话的记性:一个记忆文件
4.1 存在外面,下次放回来
压缩解决的是一次运行里装不下的问题。可轨迹只活在这一次运行里,程序一关就没了。要让它明天还记得,只能把东西存到程序之外。最简单的地方是一个文件。
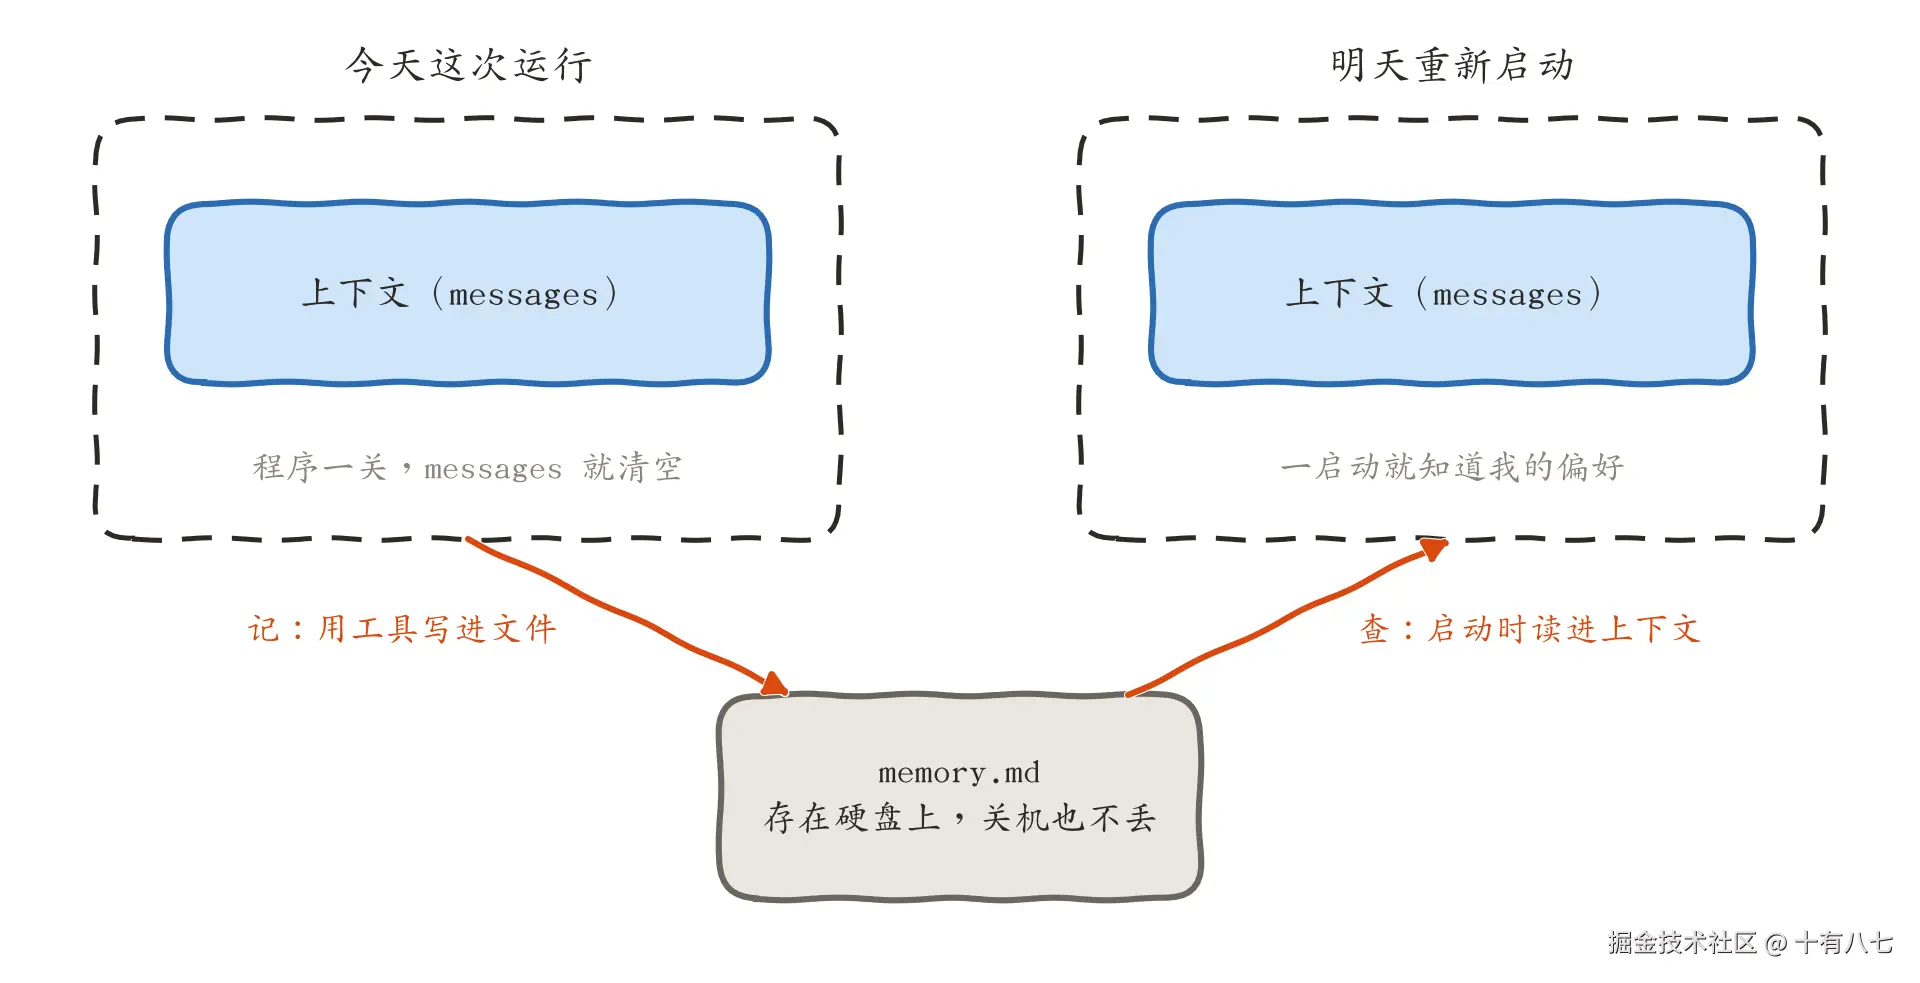
图 4-5 记忆文件在两次运行之间搭了一座桥。
整件事只有两个动作。
- 记:对话里出现了值得长期记住的事,模型用一个工具把它写进文件。
- 查:下次启动时,程序把文件内容读出来,放进上下文。
4.2 记忆工具和启动时的读取
下面这段代码做了这两件事。要看的是 remember 的描述怎么写,以及记忆被放在了上下文的什么位置。
python
MEMORY = pathlib.Path("memory.md")   # 跨会话的记忆就存在这个文件里

def remember(fact):
    """把一条值得长期记住的事追加到 memory.md。"""
    with MEMORY.open("a", encoding="utf-8") as f:
        f.write(f"- {fact}\n")
    return "记下了。"

TOOLS = [{"type": "function", "function": {
    "name": "remember",
    "description": "记下一条以后的对话也用得上的事,比如我的长期偏好、固定的习惯。只在这次对话里有用的事不要记。",
    "parameters": {"type": "object", "required": ["fact"],
                   "properties": {"fact": {"type": "string", "description": "一句话,写清楚是什么事"}}},
}}]

# 每次启动时,把记忆文件的内容接在系统提示词后面
memory_text = MEMORY.read_text(encoding="utf-8") if MEMORY.exists() else "(还没有)"
SYSTEM = "你是小记,帮我整理学习笔记的助手。回答尽量简短。\n\n【你对我的长期记忆】\n" + memory_text
messages = [{"role": "system", "content": SYSTEM}]- 什么该记、什么不该记,写在了工具的描述里。模型判断要不要调用
remember,靠的就是这句话。 - 记忆接在系统提示词后面。一次运行期间它不会变,属于静态前缀,不影响缓存。这次运行里新记下的事本来就在轨迹里,等下次启动才进入前缀。
- 这里的"查"用的是最笨的办法:把整个文件读进来。记忆只有几条的时候,这样最简单。
4.3 把循环接上,跑两次
最后是循环,和第二篇的几乎一样,只多了第一行:每次新问题进来之前,先看要不要压缩。
python
def run(question, max_steps=10):
    messages[:] = compact(messages)                     # 新问题进来之前,先看要不要压缩
    messages.append({"role": "user", "content": question})
    for step in range(1, max_steps + 1):
        resp = client.chat.completions.create(model=MODEL, messages=messages, tools=TOOLS)
        msg = resp.choices[0].message
        messages.append(msg)
        if not msg.tool_calls:
            return msg.content
        for call in msg.tool_calls:
            result = remember(**json.loads(call.function.arguments))
            print(f"  [第 {step} 圈] {call.function.name} {call.function.arguments}")
            messages.append({"role": "tool", "tool_call_id": call.id, "content": result})
    return "步数用完了,还没做完。"

while True:
    q = input("我:").strip()
    if q in ("exit", "quit", "q"):
        break
    print("小记:" + run(q))
压缩放在新问题进来的时候做,是因为这时上一轮问答是完整的,不会把一次工具申请和它的结果拆开。
把三段代码按顺序放进同一个文件,就是小记 v0.4。我跑了两次。第一次,先告诉它一个偏好,再聊几轮:
text
我:以后我的笔记标题统一用"日期-主题"的格式,比如 1118-上下文。
  [第 1 圈] remember {"fact": "用户要求笔记标题统一用"日期-主题"格式,例如 1118-上下文......"}
小记:好的,已记下:标题格式为「日期-主题」,如 1118-上下文。以后整理笔记都按这个来。
......(又聊了三轮)
  [压缩] 把较早的 4 条消息换成了一段摘要
退出,重新启动,再问:
text
我:帮我给今天这篇关于记忆的笔记起个标题。
小记:今天几号?给我月日(如 5 月 6 日 → 56),标题就写"56-记忆"。
重启之后它还记得标题的格式。顺带也能看到,它仍然不知道今天几号,第一篇说的短板还在。
不过我打开 memory.md 看了一眼,发现它记下的那条比我说的多了半句:"日期用月日四位数字,不加前导零"。我没说过这话,是它看了我举的例子自己推出来的,而且推错了。第二次运行里那个"56",就是照着这条错的记忆来的。
记忆是模型写的,它会记错,也会添上我没说过的话,而错的记忆会一直影响后面的每一次对话。所以我把记忆存成人能直接看懂的文本,隔一阵打开翻一翻,错了就手动改。
五、什么该记,什么不该记
| 该记 | 不该记 |
|---|---|
| 长期的偏好:笔记标题用"日期-主题" | 只和这一次有关的要求:这次回答短一点 |
| 稳定的事实:我在学 Agent,已经学完工具调用 | 临时的状态:我现在读到第三段 |
| 反复出现的纠正:别用英文缩写 | 任务的中间结果,那是外置文件的事 |
| 密码、证件号这类敏感信息 |
判断的办法是问一句:换一天、换一个任务,这条还用得上吗?用得上的才记。
记忆用久了会有三个麻烦,小记 v0.4 一个都没处理,这里只点到:
- 越记越多。 每次启动都全量读入,记忆多了会占掉大块上下文。需要定期合并整理。
- 会过时。 我半年前的偏好现在可能变了。记的时候带上日期,新的覆盖旧的。
- 会互相矛盾。 只追加不更新,文件里就会同时有"喜欢简短"和"喜欢详细"。写入的时候要先看有没有相近的旧条目,有就改它。
记忆这件事,难的不在存,在管。
常见误区
| 我原来以为 | 实际上 |
|---|---|
| 模型有记忆功能 | 模型本身不记事。记忆是存在外面的东西,需要时放回上下文 |
| 上下文没超上限就没问题 | 塞得越满越容易漏看,要给自己定一个更低的预算 |
| 压缩没有损失 | 摘要一定会丢细节,还要多花一次调用,缓存也会失效 |
| 记得越多越好 | 记多了会占上下文,还会过时、互相矛盾 |
| 记忆是它自己写的,所以靠得住 | 它会记错,也会添上我没说过的话,要能看、能改 |
小结
- 模型没有记忆功能。记性全是在上下文上做文章:要么内容还在上下文里,要么存在外面、需要时再放回来。
- 上下文不等装满就会出问题,要定一个比上限低的预算。
- 轨迹太长有三条出路:裁剪、压缩、外置。压缩会让缓存失效,所以要攒够了一次压一大截。
- 跨会话的记忆是一个文件加两个动作:记和查。
- 只记换一天还用得上的事。记忆要能让人看、让人改。
这一版的小记:
| 小记 v0.4 | |
|---|---|
| 比上一版多了什么 | 轨迹超出预算自动压缩;一个记忆文件和 remember 工具 |
| 能做什么 | 长对话不会撑爆上下文;重启之后还记得我的偏好 |
| 还有什么问题 | 记忆和笔记都只会整份读进来,东西一多就不行了 |
下一篇
小记现在找东西的办法只有一个:整份读进来。记忆文件是启动时全量读入,笔记是用 read_note 整篇读。
笔记到了两百篇,这个办法就不行了。它不可能全读一遍,只能看着文件名猜该读哪几篇。可如果我问的是"模型为什么会忘记前面说过的话",而笔记里写的是"上下文窗口溢出",文件名和问题一个字都对不上,它该怎么找?
怎么从一大堆资料里,只把相关的那几段找出来放进上下文?下一篇让它学会翻书。
下一篇:手搓 Agent(五):学会翻书------RAG,先查资料再回答(写完后在这里补链接)