《手搓 Agent》系列第 5 篇,共 10 篇。系列导读与目录|上一篇:长点记性------上下文满了怎么办,怎么记住上一次
图 5-1 系列地图。这一篇是蓝色框里的最后一篇:眼睛。
前言
上一篇结尾的问题是:笔记到了两百篇,小记不可能每次都全读一遍。而我问"它为什么会忘记前面说过的话",笔记里写的却是"窗口溢出",字面上对不上。
要做的事情其实只有一件:从一大堆资料里,把和问题相关的那几段找出来,放进上下文。找得准,模型就答得准;找不到,它要么说不知道,要么开始编。
这件事有个名字,叫 RAG(Retrieval-Augmented Generation,检索增强生成):先检索,再把检索到的内容放进上下文,让模型照着回答。我原来以为 RAG 是一套很重的东西,得先学向量数据库,再学一个框架。拆开看,里面真正新的只有一步:怎么判断"相关"。
这一篇把这一步讲清楚,小记升到 v0.5。
本篇要点:
- 嵌入模型把一段话变成一串数,意思相近的话,数也相近。靠它可以按意思找资料。
- 资料里有答案却答不上来,要分三关查:切、找、排。
- 把检索做成工具,让 Agent 自己决定查什么、查几次。
一、按字面找,换个说法就找不到
资料多了不能全读,原因前两篇都讲过:可能装不下;装得下也贵;就算不心疼钱,塞得越满它越容易漏看。所以只能挑相关的几段给它。
怎么挑?最容易想到的是按关键词找:把问题里的词拿去和笔记比,字面上有重合的就算相关。
这个办法在我的例子上直接失败。
| 我问的 | 笔记里写的 |
|---|---|
| 它为什么会忘记前面说过的话 | 对话太长,最早的消息会被挤出窗口,模型就看不到了 |
两句话说的是同一件事,却没有一个词相同。"忘记"对应"看不到","前面说过的话"对应"最早的消息"。人一眼能看出来,按字面比的程序看不出来。
关键词比的是字,我想要的是比意思。得有一种办法,能把"意思相近"算出来。
二、嵌入:把意思变成能算的数
2.1 一段话变成一个点
有一类专门的模型,叫嵌入模型 (embedding model)。它不回答问题,只做一件事:读一段话,输出一串固定长度的数,比如 512 个。这串数叫向量 ,这个过程叫嵌入。
它在训练时被要求做到一点:意思相近的两段话,输出的两串数也要相近;意思不相干的,要离得远。
可以把这串数想成地图上的坐标。每段话是地图上的一个点,讲同一件事的点会聚在一起。
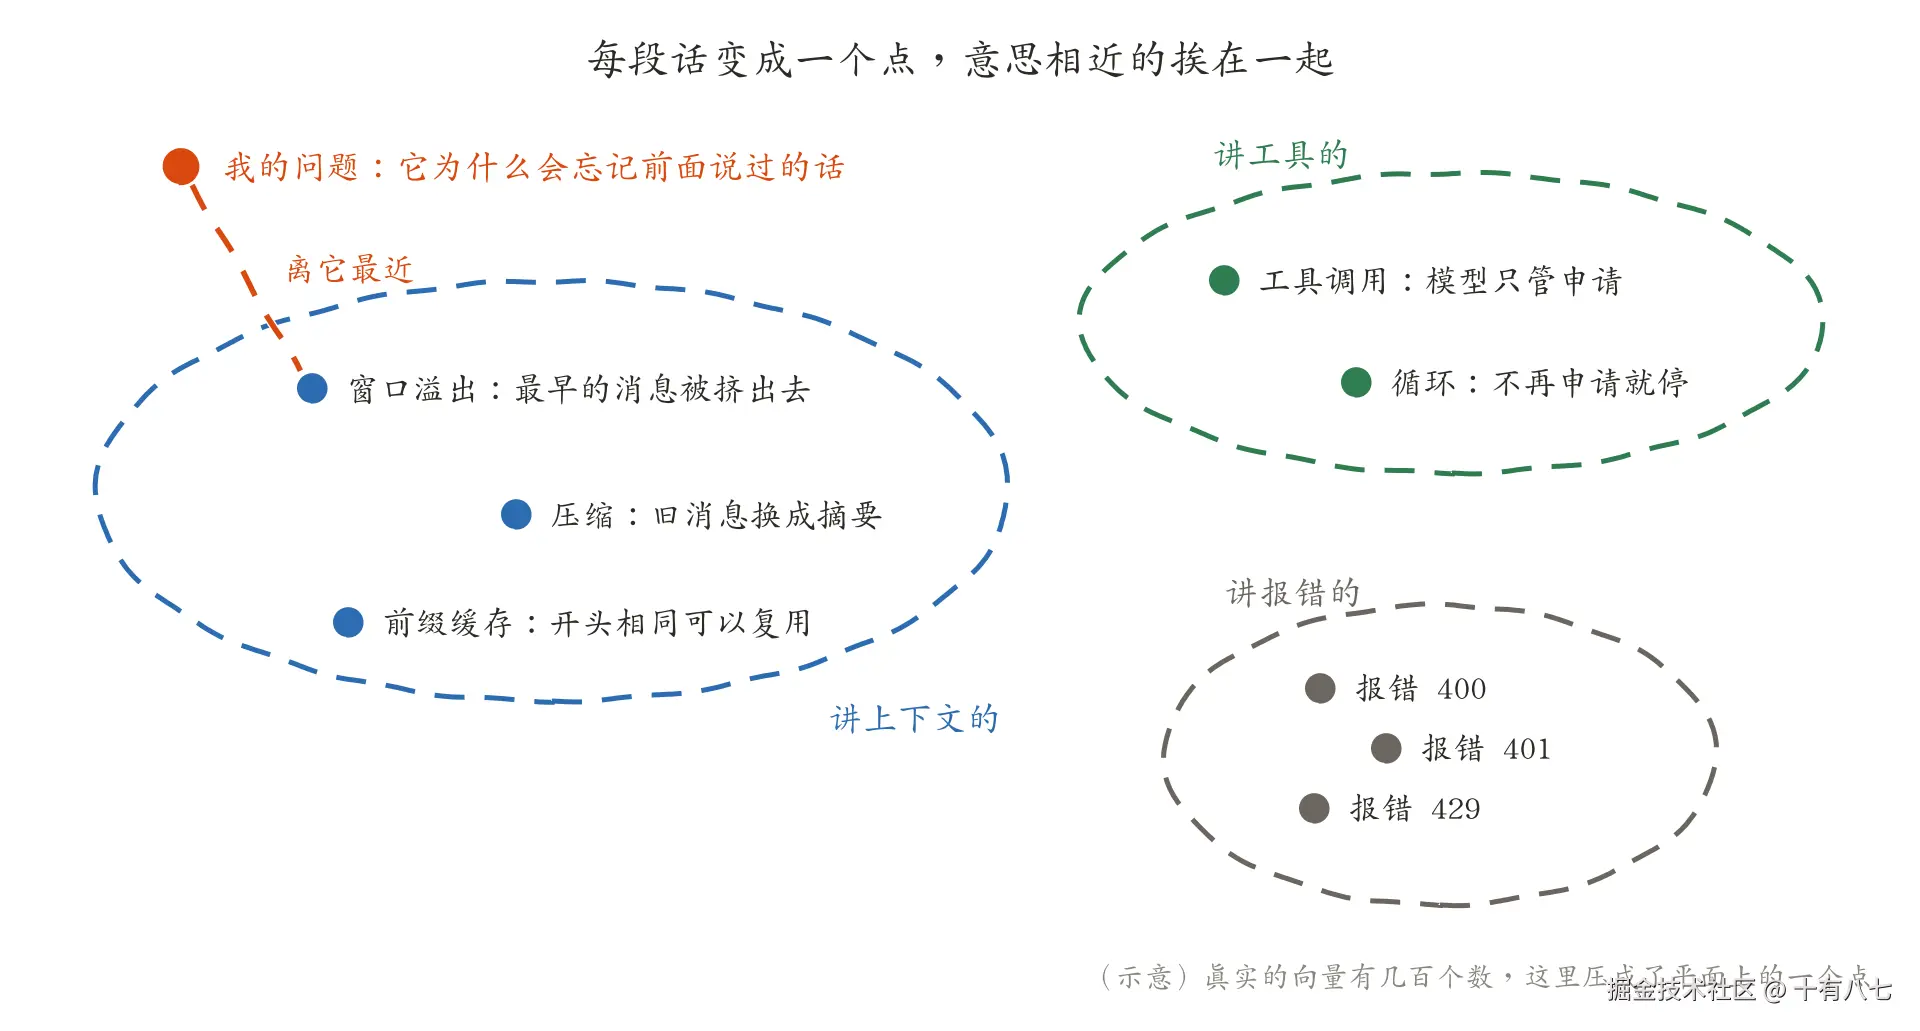
图 5-2 讲同一类事情的点聚在一起。我的问题落在"窗口溢出"那一块旁边,虽然它们没有一个词相同。
于是"找相关的资料"变成了一道算术题:把问题也变成一个点,看哪几块笔记离它最近。
"近"怎么算?最常用的是余弦相似度:看两个向量的方向有多一致,结果是一个数,越大越像。算法不用记,知道它给出一个"相似分"就够了。
2.2 它和大模型是两个模型
这里容易混。回答问题的大模型和嵌入模型是两个东西,都是读了大量文字训练出来的,但学的本事不一样。
| 大模型 | 嵌入模型 | |
|---|---|---|
| 学的是 | 接下来该写什么 | 哪两段话该挨在一起 |
| 输入 | 一整段上下文 | 一段话 |
| 输出 | 接着往下写的文字 | 一串数 |
| 个头 | 很大 | 通常小得多,普通电脑就能跑 |
| 在 RAG 里的分工 | 读找到的资料,写回答 | 判断哪些资料相关 |
提示 很多模型服务商提供嵌入接口,调用方式和聊天接口差不多。我用的 DeepSeek 没有,所以下面在本机跑一个开源的中文小模型 bge-small-zh-v1.5,九十多 MB,不需要显卡。
三、两条流水线:建库和查询
3.1 先看全貌
有了嵌入,整件事分成两条流水线。
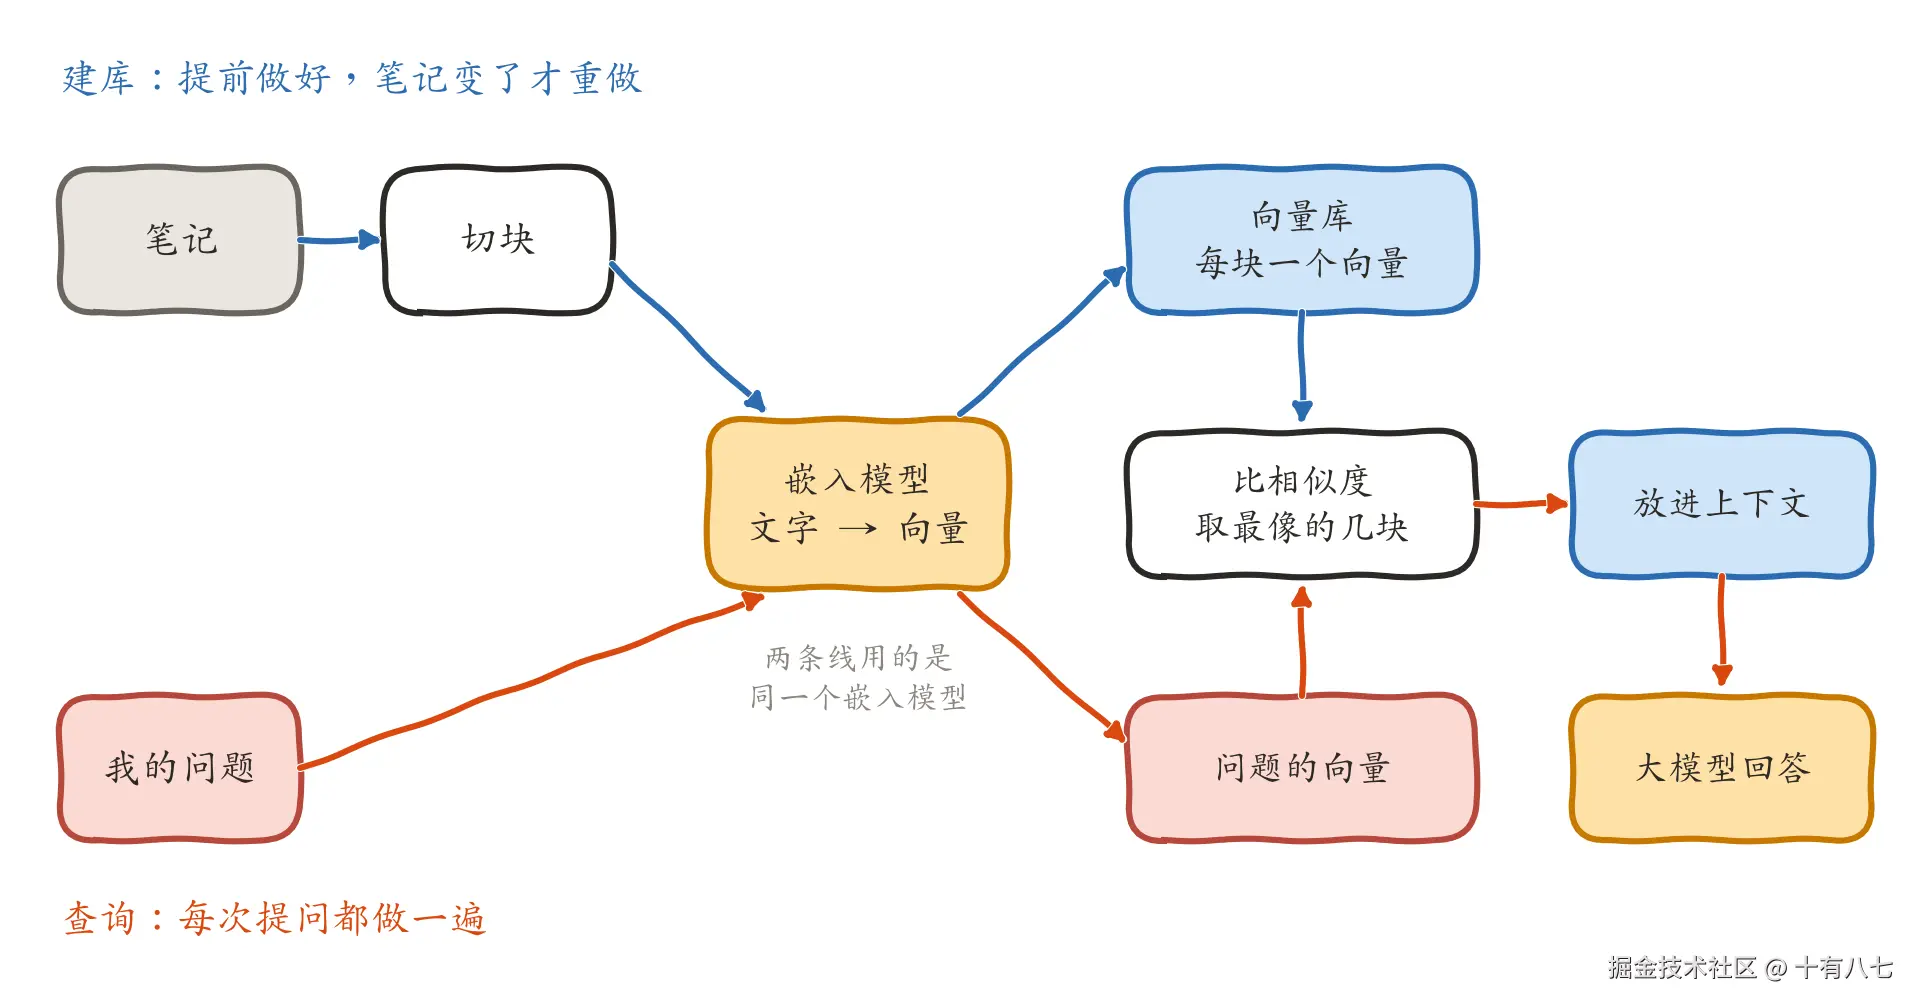
图 5-3 蓝色的线提前做好,红色的线每次提问都走一遍。两条线必须用同一个嵌入模型,不然两边的数没法比。
- 建库:把笔记切成小块,每一块算一个向量,存起来。笔记没变就不用重做。
- 查询:把问题算成向量,和库里每一块比相似度,取最像的几块放进上下文,再让大模型回答。
为什么要先切块,不能一篇笔记算一个向量?有两个原因。一篇笔记往往讲好几件事,压成一个向量,哪件事都不突出。另外,最后要放进上下文的是找到的内容,一块比一篇短得多,省地方。
3.2 准备笔记,切块
下面的代码先建三篇样例笔记,再切块。要看的是 split_notes:在哪里下刀,每一块里放了什么。
提示 这一篇要多装三个包:
pip install numpy onnxruntime tokenizers。模型接口的环境变量照旧,见导读的第六节。如果跑第二篇时已经建过 notes 文件夹,先给它改个名,这样才会生成这一篇的样例笔记。
python
import json, os, pathlib, re, urllib.request

NOTES = pathlib.Path("notes")
SAMPLES = {   # 三篇样例笔记,一行是一个小节
    "上下文.md": ["## 窗口溢出\n对话太长,最早的消息会被挤出窗口,模型就看不到了。",
                 "## 前缀缓存\n请求开头和上次一样的部分可以复用,又快又便宜。",
                 "## 压缩\n把较早的消息换成一段摘要,细节会丢。"],
    "工具.md": ["## 工具调用\n模型只输出想调用哪个工具,真正动手的是我的程序。",
               "## 循环\n模型不再申请工具就停。max_steps 是保险,防止它转个不停。"],
    "踩坑记录.md": ["## 报错 400\n多半是 tool 消息的 tool_call_id 和申请对不上。",
                  "## 报错 401\nKey 填错了,或者环境变量没生效。",
                  "## 报错 429\n请求太频繁,等几秒再试。"]}
if not NOTES.exists():   # 没有 notes 文件夹的话,先把样例笔记写进去
    NOTES.mkdir()
    for name, parts in SAMPLES.items():
        (NOTES / name).write_text("\n\n".join(parts), encoding="utf-8")

def split_notes():
    """切块:按二级标题切,一个小节一块,每块开头带上它出自哪篇笔记。"""
    chunks = []
    for path in sorted(NOTES.glob("*.md")):
        for part in re.split(r"\n(?=## )", path.read_text(encoding="utf-8")):
            chunks.append(f"《{path.name}》{part.strip()}")
    return chunks

CHUNKS = split_notes()- 下刀的位置选在每个二级标题前面,一个小节是一块。一个小节通常正好讲一件事。
- 每一块开头加了《文件名》。块被单独拿出来以后,还看得出它出自哪里。
- 三篇笔记一共切出 8 块。
3.3 建库和查询
接着是嵌入、建库、查询。要看的是最后两段:建库只有一行,查询只有两行。
python
import numpy as np, onnxruntime
from tokenizers import Tokenizer

if not pathlib.Path("bge").exists():   # 第一次运行时下载嵌入模型,九十多 MB
    os.mkdir("bge")
    base = "https://www.modelscope.cn/models/Xenova/bge-small-zh-v1.5/resolve/master/"
    for name in ("tokenizer.json", "onnx/model.onnx"):
        urllib.request.urlretrieve(base + name, "bge/" + name.split("/")[-1])
tokenizer = Tokenizer.from_file("bge/tokenizer.json")
tokenizer.enable_padding()
tokenizer.enable_truncation(max_length=512)
session = onnxruntime.InferenceSession("bge/model.onnx")

def embed(texts):
    """嵌入:把几段文字变成几个向量,每个向量是 512 个数。"""
    enc = tokenizer.encode_batch(texts)
    ids = np.array([e.ids for e in enc], dtype="int64")
    mask = np.array([e.attention_mask for e in enc], dtype="int64")
    out = session.run(None, {"input_ids": ids, "attention_mask": mask, "token_type_ids": np.zeros_like(ids)})[0]
    vecs = out[:, 0]                                           # 这个模型用开头那个位置的输出代表整段话
    return vecs / np.linalg.norm(vecs, axis=1, keepdims=True)   # 长度统一成 1,方便后面比较

VECS = embed(CHUNKS)   # 建库:每一块算一个向量,全部存在一个数组里

def vector_search(query):
    """查询:把问题也算成向量,和每一块比相似度,从高到低排。"""
    sims = VECS @ embed([query])[0]
return [(int(i), float(sims[i])) for i in np.argsort(-sims)]embed里的几行是这个模型的固定用法:把文字切成 token,送进模型,取出向量。换一个嵌入模型,只需要改这个函数。VECS就是"向量库":一个 8 行 512 列的数组。VECS @ ...一次算出问题和 8 块各自的相似分。向量的长度都统一成了 1,这样乘出来的正好是余弦相似度。- 模型文件是从魔搭(ModelScope)下载的。下载到一半断了的话,把 bge 文件夹删掉再运行。
拿前言里的问题试一下。vector_search("它为什么会忘记前面说过的话") 给出的前三名是:
text
0.466  《上下文.md》## 窗口溢出  对话太长,最早的消息会被挤出窗口,模型就看不到了。
0.418  《踩坑记录.md》## 报错 400  多半是 tool 消息的 tool_call_id 和申请对不上。
0.415  《踩坑记录.md》## 报错 401  Key 填错了,或者环境变量没生效。
第一名找对了,而它和问题没有一个词相同。
也要看到另一面:第二、三名和问题毫无关系,分数却也有 0.41。相似分没有一条"及格线",能用的只有排名。不管库里有没有答案,它总能给出"最像的三块"。
提示 我这里没用向量数据库。8 块笔记,一个数组就够了,几万块也还应付得来。到了上百万块,逐块比较开始吃力,还要考虑存盘、增删、按条件筛选,这时才需要向量数据库。它做的核心的事和这个数组一样:存向量,找出离得最近的几个。
四、找不准,问题出在哪
用起来以后,最常遇到的情况是:资料里明明有答案,它却答不上来。答案从笔记走到模型眼前,要过三关,哪一关丢了都到不了。
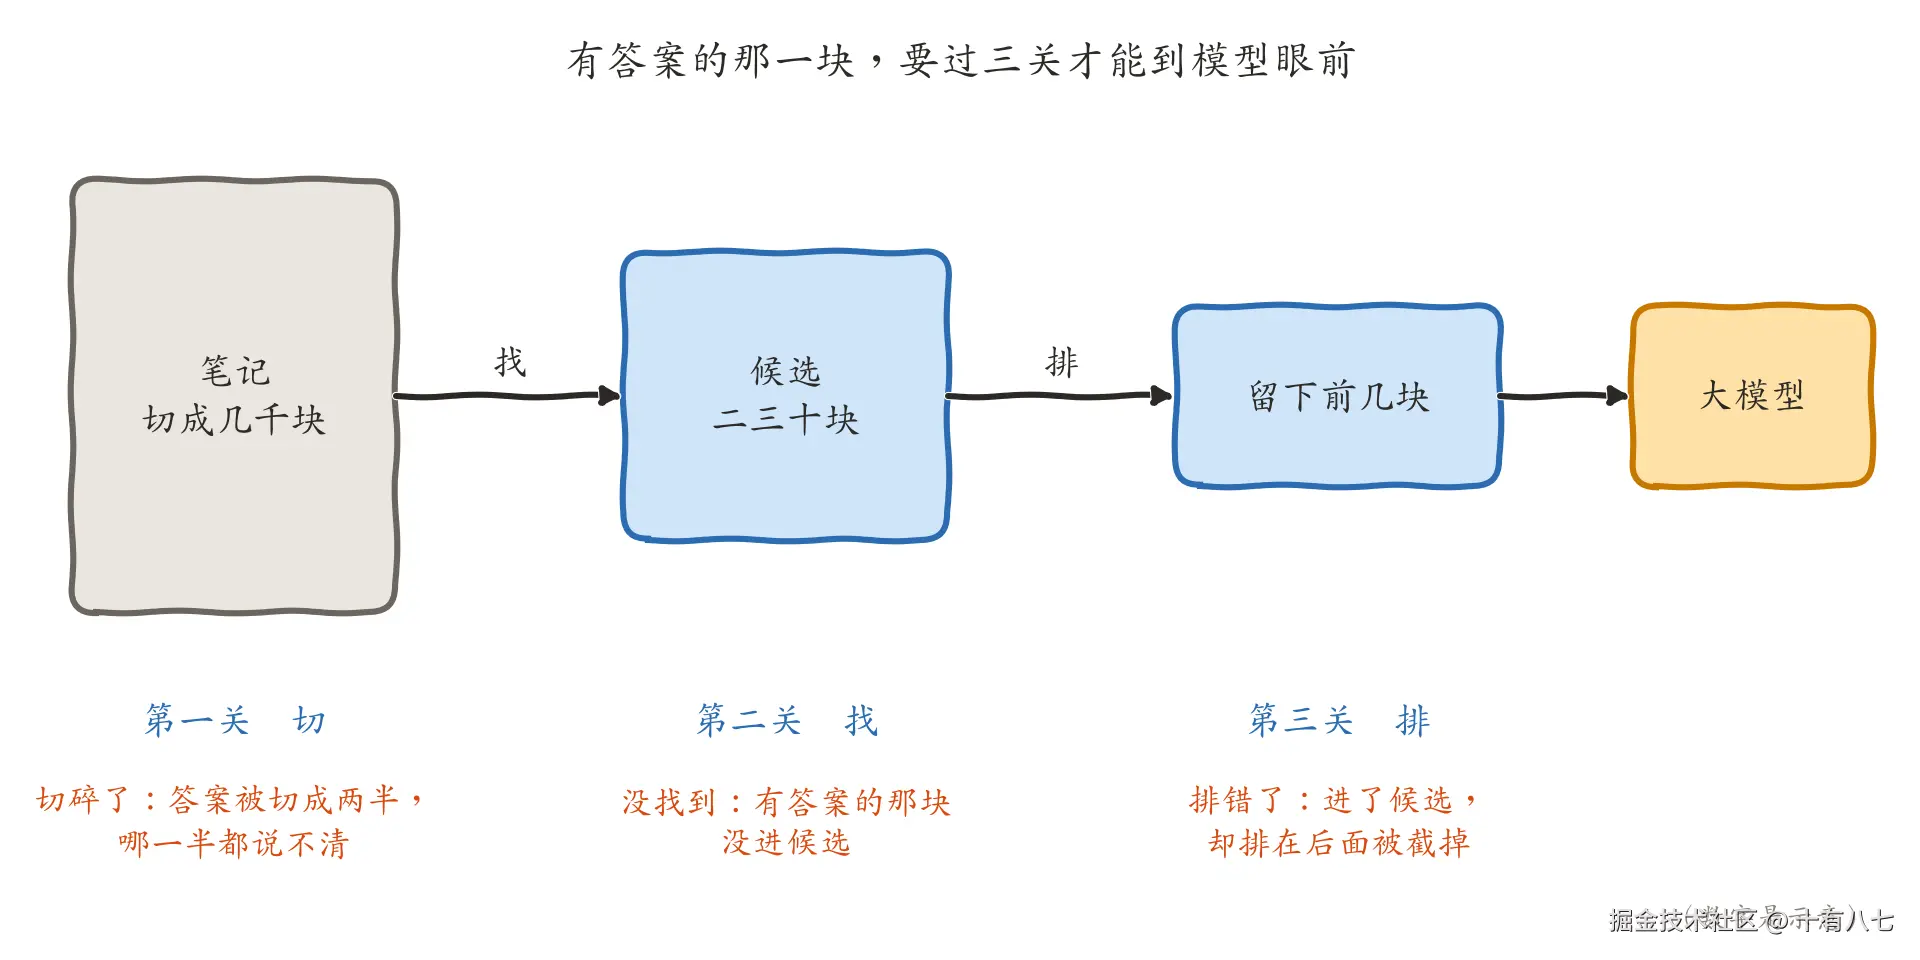
图 5-4 切、找、排,三关各有各的丢法。
4.1 切碎了
切块的办法不止一种。最省事的是按固定字数切,比如每两百字一块。它不看内容,一刀下去可能把一句话切成两半。
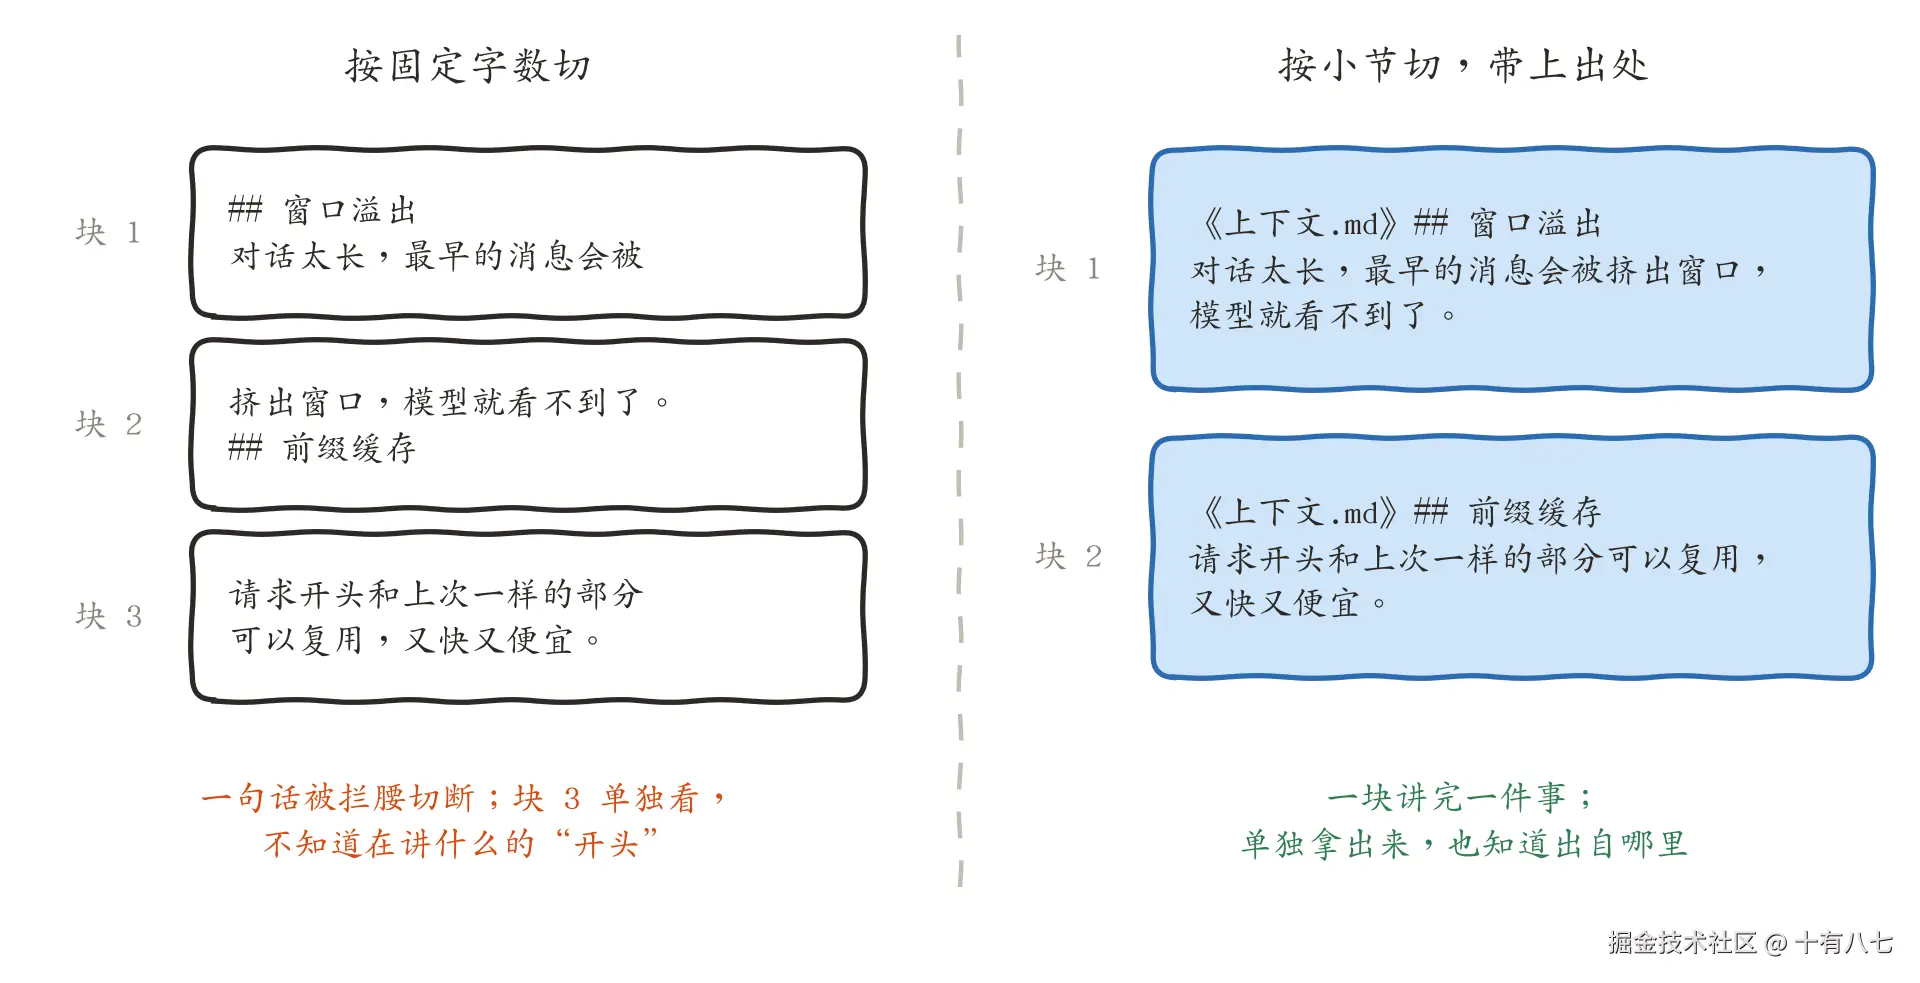
图 5-5 左边的块 3 单独拿出来,看不出在讲什么。右边每块都是完整的一件事。
块的大小也有讲究。太小,一块里只有半句话,前后文丢了,单独看不懂。太大,一块里混着好几件事,向量变得模糊,放进上下文也占地方。
常用的办法:
- 顺着文档本身的结构切,标题和段落都是现成的边界。
- 相邻两块重叠一小段,免得关键的一句正好落在刀口上。
- 给每一块带上出处,比如文件名和所在的小节标题。
4.2 没找到
有答案的那一块没有进入候选。常见的原因是问题和资料的说法差得太远,或者问题本身太短、太含糊,或者只取了前三块而它排在第五。
对应的办法:
- 先多取一些,比如取前二三十块,后面再筛。
- 把问题补完整再查。"那个怎么解决"这种问题,要先结合前面的对话说清楚"那个"是什么。
- 向量之外再加一路关键词检索,第五节讲。
4.3 排错了
答案进了候选,却排在后面,截取前几块的时候被截掉了。或者排在前面的是几块似是而非的内容,把模型带偏。
这一关的办法叫重排(rerank):先用向量粗选出二三十块,再用一个更准的模型,把问题和每一块放在一起逐对打分,重新排序,只留最前面几块。
为什么不一开始就用更准的模型?因为它要把问题和每一块配成一对,各读一遍,库里有十万块就得读十万遍,太慢。嵌入模型快,是因为每一块的向量建库时就算好了,查询时只需要算问题这一个。所以通常分两步:快的先筛一遍,准的再排一遍。
小记 v0.5 没有做重排,8 块笔记用不上。
提示 回答不对的时候,先别急着改提示词。把检索到的那几块打印出来看一眼:里面没有答案,是检索的问题,回到这三关去查;里面有答案它还答错,才是模型和提示词的问题。
五、关键词和向量,合起来用
5.1 各有各的短处
向量检索也有不擅长的。我问一句"遇到 401 怎么办",它给出的前三名是:
text
0.581  《踩坑记录.md》## 报错 401
0.578  《踩坑记录.md》## 报错 429
0.552  《踩坑记录.md》## 报错 400
第一名是对的,但只比第二名高 0.003。在嵌入模型看来,这三块几乎是同一个意思:都是一条关于报错的记录。401 和 429 的差别只在编号上,而编号恰恰没什么"意思"可言。笔记再多一些,这个顺序随时可能反过来。
关键词检索在这里反而干脆:只有一块里出现了"401"。
| 向量检索 | 关键词检索 | |
|---|---|---|
| 比的是 | 意思 | 字面 |
| 擅长 | 换了说法也能找到 | 编号、名字、代码里的标识符,一个字符都不差 |
| 不擅长 | 只差一个编号的内容分不清 | 换个说法就找不到 |
两种办法的短处正好错开,所以实际的系统通常两路都查,再把结果合起来。这叫混合检索。
5.2 按名次合并
怎么合?两边的分数不能直接相加:一边是相似分,一边是命中了几个词,不是一回事。常用的办法是只看名次:每一块在两边各排第几,名次越靠前加的分越多,两边加起来再排一次。
python
def terms(text):
    """关键词检索用的"词":连着的英文和数字算一个,汉字每两个字算一个。"""
    words = re.findall(r"[a-z0-9_.]+", text.lower())
    hanzi = re.findall(r"[一-鿿]+", text)
    return set(words) | {s[i:i + 2] for s in hanzi for i in range(len(s) - 1)}

def keyword_search(query):
    """数一数每一块里出现了问题中的几个词,一个都没有的不算。"""
    hits = [(i, len(terms(query) & terms(c))) for i, c in enumerate(CHUNKS)]
    return sorted([h for h in hits if h[1] > 0], key=lambda h: -h[1])

def search_notes(query, k=3):
    """混合检索:两种办法各排一次名,名次越靠前加分越多,取总分最高的 k 块。"""
    score = {}
    for ranking in (vector_search(query), keyword_search(query)):
        for pos, (i, _) in enumerate(ranking):
            score[i] = score.get(i, 0) + 1 / (60 + pos)
return "\n\n".join(CHUNKS[i] for i in sorted(score, key=score.get, reverse=True)[:k])terms是一个很粗的分词:汉字每两个字算一个词。正式的系统会用专门的分词工具,再配上 BM25 这样的算法,把"什么""怎么"这类到处都有的词的分量调低。1 / (60 + pos)就是"名次越靠前加分越多"。60 是这个办法惯用的常数,作用是让排在最前面的几名差距别太悬殊。这个合并办法叫 RRF(倒数排名融合)。- 一块内容在两边都排在前面,总分自然最高。
再问"遇到 401 怎么办",报错 401 那一块在两边都是第一,稳稳排在最前。问"它为什么会忘记前面说过的话",关键词那边一块都没命中,结果就由向量说了算。
六、把检索做成工具
6.1 固定流程和自己决定
到这里,检索的流程是固定的:来一个问题,查一次,把结果交给模型回答。很多问答类的应用就是这么做的。
它的毛病是死板。问题里说了两件事,查一次只能照顾到一件;第一次查偏了,没有第二次机会;我只是打个招呼,它也要去查一遍。
小记本来就有一个会转圈的循环。把检索做成一个工具交给它,查不查、用什么词查、查到的够不够、要不要换个说法再查,都由模型自己决定。
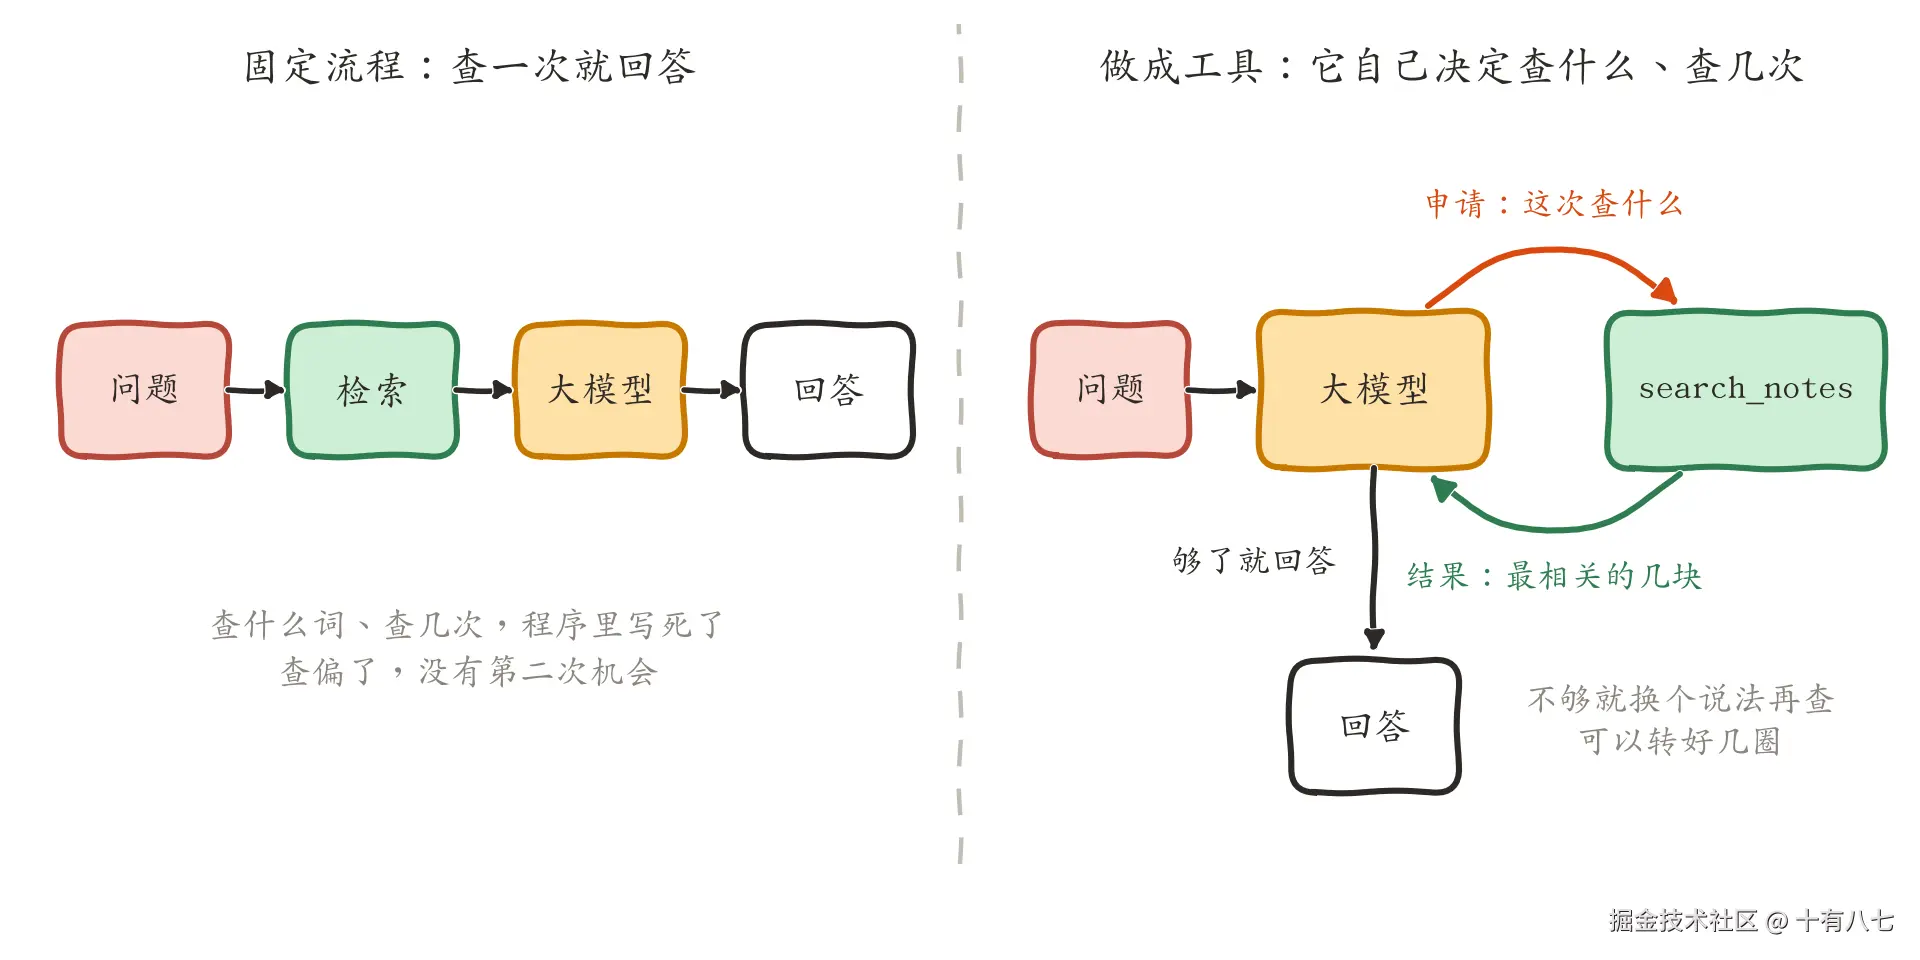
图 5-6 左边查一次就回答。右边是第二篇的那个循环,检索只是其中一个工具。
6.2 接进循环
下面这段和第二篇的循环几乎一样。要看的是工具描述里的后两句话。
python
from openai import OpenAI

client = OpenAI(base_url=os.environ["LLM_BASE_URL"], api_key=os.environ["LLM_API_KEY"])
MODEL = os.environ["LLM_MODEL"]
TOOLS = [{"type": "function", "function": {
    "name": "search_notes",
    "description": "在我的笔记里找和 query 最相关的三段。没找到想要的可以换个说法再找;问题涉及几件事就分开找。",
    "parameters": {"type": "object", "required": ["query"],
                   "properties": {"query": {"type": "string", "description": "要找什么,用一句完整的话说清楚"}}},
}}]
messages = [{"role": "system", "content": "你是小记,帮我整理学习笔记的助手。回答之前先用 search_notes 查笔记,只根据查到的内容回答,并注明出自哪篇;查不到就直说。"}]

def run(question, max_steps=6):
    messages.append({"role": "user", "content": question})
    for step in range(1, max_steps + 1):
        resp = client.chat.completions.create(model=MODEL, messages=messages, tools=TOOLS)
        msg = resp.choices[0].message
        messages.append(msg)
        if not msg.tool_calls:
            return msg.content
        for call in msg.tool_calls:
            print(f"  [第 {step} 圈] {call.function.name} {call.function.arguments}")
            result = search_notes(**json.loads(call.function.arguments))
            messages.append({"role": "tool", "tool_call_id": call.id, "content": result})
    return "步数用完了,还没做完。"

while True:   # 按 Ctrl+C 退出
print("小记:" + run(input("我:")))- 上一段代码里的
search_notes直接拿来当工具。它返回的是最相关的三块,不是整篇笔记。 - 描述里写了"可以换个说法再找""涉及几件事就分开找"。模型会不会多查几次,很大程度上看这两句。
- 系统提示词要求它只根据查到的内容回答,注明出处,查不到就直说。这样我能回头核对。
把四段代码按顺序放进同一个文件,就是小记 v0.5。我问了一个带两层意思的问题:
text
我:聊久了它就不记得开头的事,是怎么回事?有什么办法?
  [第 1 圈] search_notes {"query": "为什么对话聊久了模型就不记得开头说过的事情"}
  [第 1 圈] search_notes {"query": "上下文窗口长度限制"}
  [第 2 圈] search_notes {"query": "怎么解决记不住前面内容,有什么做法"}
  [第 2 圈] search_notes {"query": "把重要信息写在外面,外部记忆或者重新贴一遍"}
小记:原因:窗口溢出(出自《上下文.md》)
笔记里记的是:对话太长,最早的消息会被挤出窗口,模型就看不到了。......
能查到的相关做法只有一条:压缩(同样出自《上下文.md》)
把较早的消息换成一段摘要。不过笔记里也标了代价:细节会丢。
......(后面还有几句补充,略)
它查了四次。第一圈查原因,还自己把我的大白话换成了"上下文窗口长度限制"。看到结果之后,第二圈又去查办法。回答时注明了出处,也说了笔记里只有这一条办法。
再问一个笔记里没有的:"我的笔记里有没有讲怎么写系统提示词?"它换了四种说法各查一遍,然后告诉我没有,没有自己编一段出来。
这只是我这一次运行的结果。换一个模型,或者再跑一遍,它查的词和次数都可能不一样。
6.3 代价和要留心的地方
- 更慢,更贵。 多查一次就多转一圈。问题简单、资料规整的场合,固定流程查一次就够。
- 查到的内容是资料,不是命令。 笔记里要是写着一句"忽略前面的要求",模型有可能真的照做。第八篇专门讲这个问题。
- 记忆也可以这么查。 上一篇的 memory.md 是启动时整份读入。记忆多了以后,同样可以切块、建库,用到哪条查哪条。
常见误区
| 我原来以为 | 实际上 |
|---|---|
| 做 RAG 得先有向量数据库 | 核心是先找再答。资料不多时一个数组就够,量大了才需要数据库 |
| 嵌入模型就是大模型 | 是两个模型。嵌入模型只把话变成数,不会回答问题 |
| 有了向量检索,就不需要关键词了 | 各有短处。编号、名字这类要一字不差的,关键词更稳,通常两路一起用 |
| 块切得越小,找得越准 | 太小会丢前后文,单独拿出来看不懂 |
| 检索到了,模型就能答对 | 要过切、找、排三关。答错时先看检索到的那几块里有没有答案 |
| 模型的窗口越来越大,以后用不着检索 | 装得下不等于看得准,而且每一圈都按长度收费 |
小结
- RAG 就是先找资料,再让模型照着资料回答。真正新的只有一步:怎么判断相关。
- 嵌入模型把一段话变成一串数,意思相近的数也相近,于是可以按意思找。
- 流程是两条线:建库(切块、算向量、存起来)和查询(算向量、比相似度、取前几块)。
- 资料里有答案却答不上来,分三关查:切碎了,没找到,排错了。
- 向量比意思,关键词比字面,两路合起来用。
- 把检索做成工具,Agent 可以自己决定查什么、查几次,代价是更慢更贵。
这一版的小记:
| 小记 v0.5 | |
|---|---|
| 比上一版多了什么 | 笔记切块建库;search_notes 工具,向量和关键词混合检索 |
| 能做什么 | 换个说法也能找到相关的笔记;会自己换词多查几次;回答注明出处 |
| 还有什么问题 | 工具越攒越多,它开始用错 |
下一篇
数一数小记攒下的工具:list_notes、read_note、remember,现在又多了 search_notes。
工具一多,麻烦就来了。想找一段内容,它该用 search_notes 还是 read_note?我说"把这个记一下",它是调 remember,还是该往笔记里写?选对了工具,参数也可能填错。
这些错不全怪模型。工具的名字、描述、参数、返回值,都是写给模型看的,写得含糊,它就只能猜。工具该怎么设计,它才用得对?下一篇让它练出巧手。
下一篇:手搓 Agent(六):练出巧手------好工具长什么样,再给它一台电脑(写完后在这里补链接)