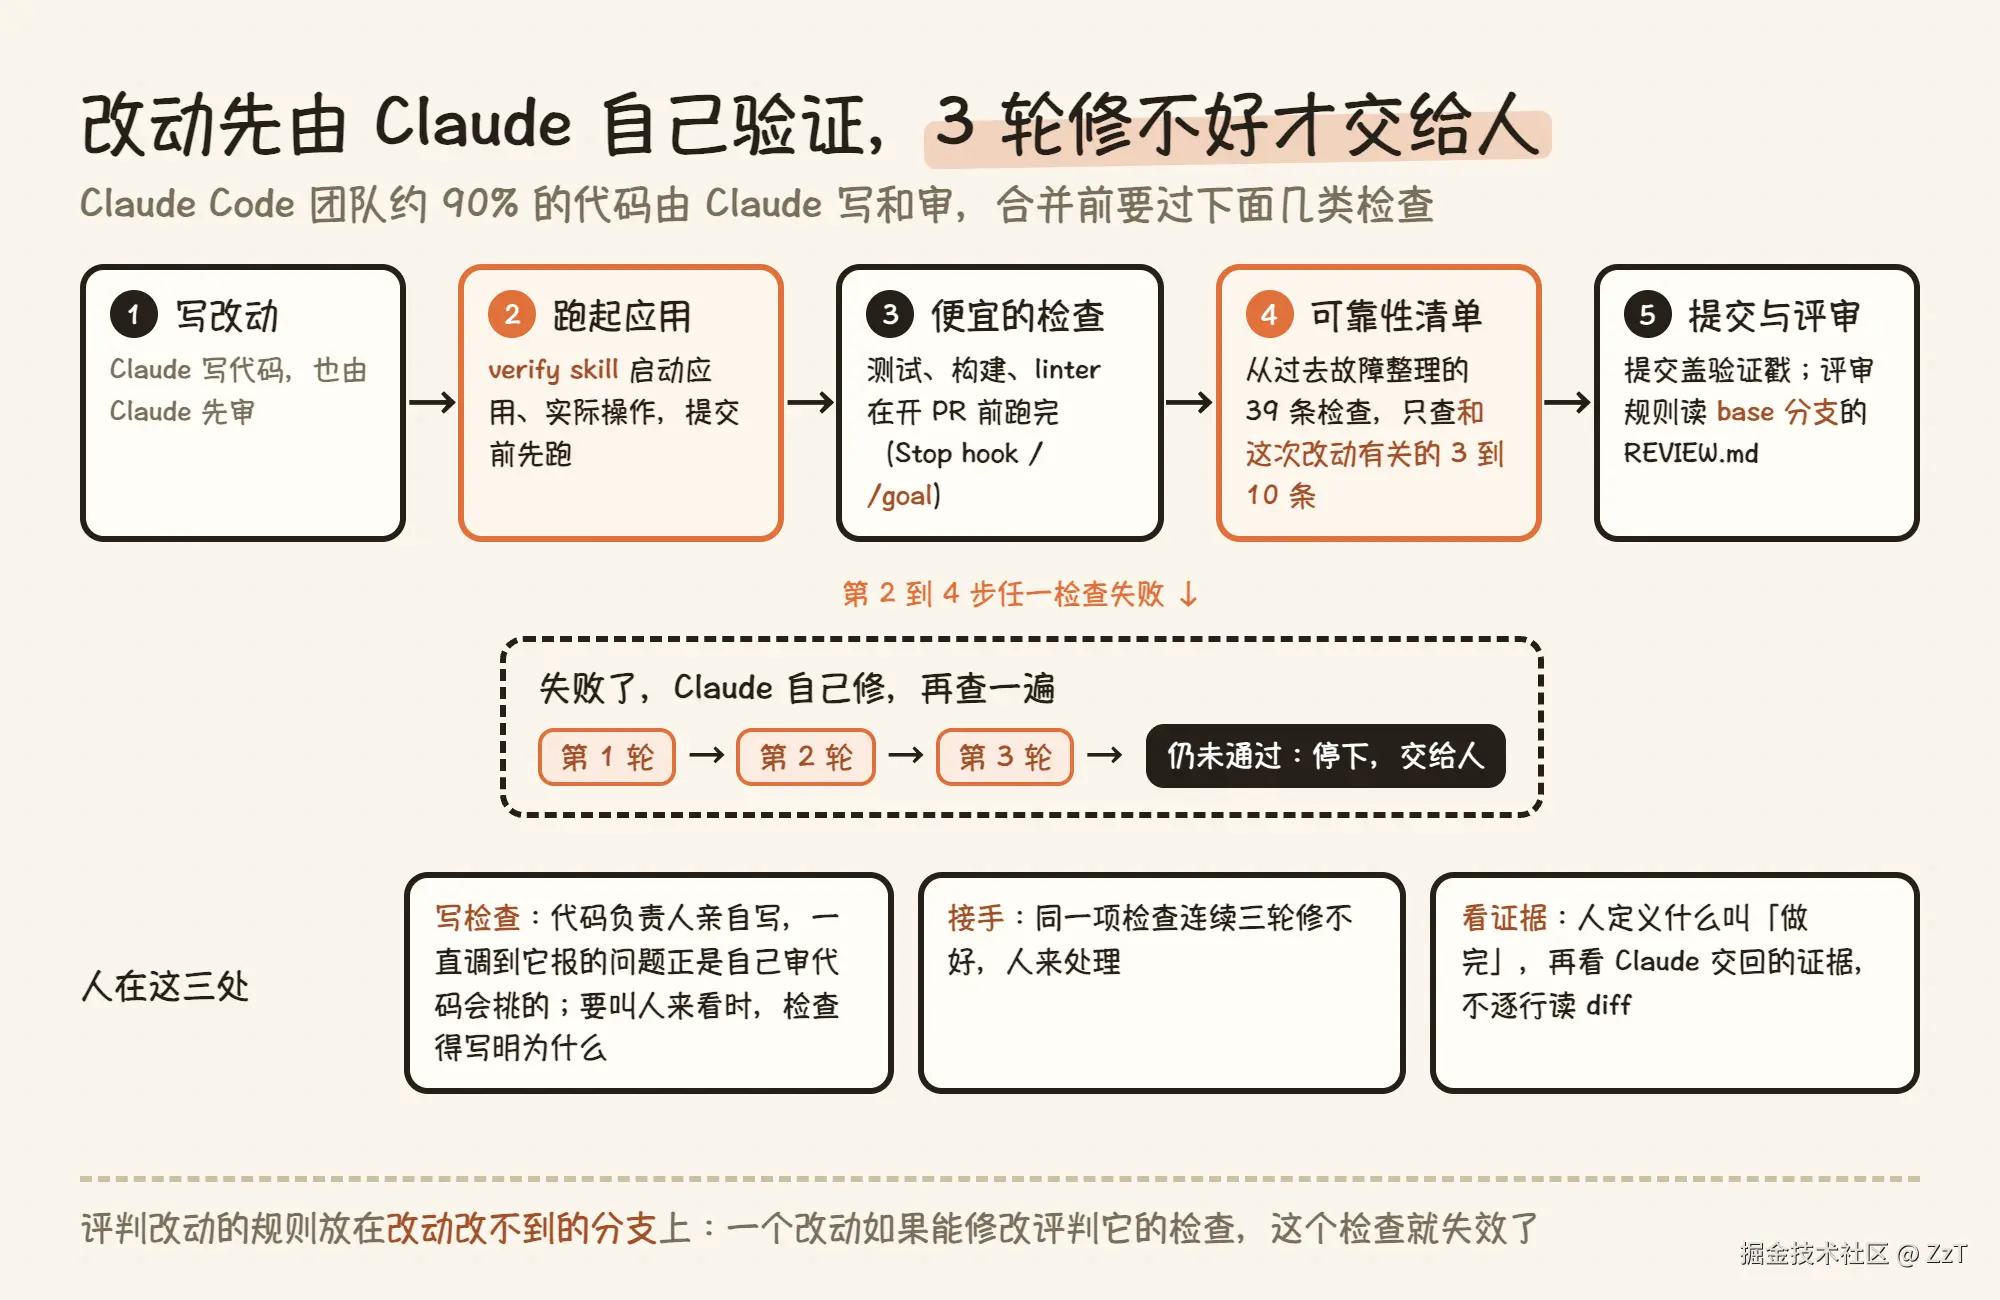
Anthropic 的 Addy Osmani 11 月 16 日在 claude.dev 博客发文,介绍 Claude Code 团队怎么验证 Claude 写出来的代码。这个团队约 90% 的代码由 Claude 写、也由 Claude 审,人的工作从逐行读 diff,转向定义什么叫「做完」、再检查证据。
文章前半部分是作者对测试投入的建议,推荐端到端、属性、差分三类测试。后半部分是团队自己的做法,可以归成四条:
- 改动要把应用真正跑起来验证。启动和操作应用的步骤写成名为 verify 的 skill,Claude 提交前先跑。
- 检查失败由 Claude 自己修,连续三轮修不好才交给人。该查哪些风险,由一份从过去故障里整理出的 39 条可靠性清单决定,每次只查和这次改动有关的几条。
- 评判改动的规则放在改动本身改不到的地方,评审结果只对一个提交有效。
- 评审器本身也要评估,漏掉的 bug 要写成新规则。
其中几项已经做进了 Claude Code:自带的 /verify、v2.1.286 起提交前先跑 verify skill 的指令、11 月 19 日 v2.1.328 对 /code-review 的调整。下文把原文的做法和对应的产品机制放在一起讲。
这套做法的重点不在多加几道评审,而在让检查本身可信:检查由代码负责人来写,放在改动碰不到的分支上,再用过去的事故回测。原文的副标题说的就是这件事,怎么让验证器保持诚实。需要先说明的是,原文只给了做法,没有给这些做法的效果数字。
验证决定能同时跑几个 Claude
原文的判断是:没有验证,一个人同时只能跑一两个 Claude,因为每样产出都得自己检查;有了验证,可以并行跑几十个甚至上百个。
Claude Code 的创建者 Boris Cherny 在 10 月那篇讲评审流程的文章里也说过,给 Claude 一个验证工作的方法,是拿到好结果最重要的一件事。他估计这能让最终结果好两到三倍,这是他个人的估计。
文中唯一的量化数字是「任务成功率最多高 10 个点」,引用时要看清出处。它链接到 4 月 Claude Managed Agents 的发布文章,是 Managed Agents 在结构化文件生成任务上的内部测试:让一个单独的评分 agent 按 rubric 检查结果,和普通的提示词循环对比,难题上提升最大。这不是 Claude Code 团队在自己代码库上测出来的数字。
验证的成本也比以前低。测试、基准、规格、端到端运行,现在都可以让 agent 生成,生成之后作为普通程序反复运行,不需要额外消耗多少 token。
如果 agent 反复栽在同一类检查上,原文的例子是「日志里有没有用户数据」,就加一个 hook,或在 CLAUDE.md 里写一条明确的规则。原文说这样基本能避免再犯。
端到端、属性、差分三类测试
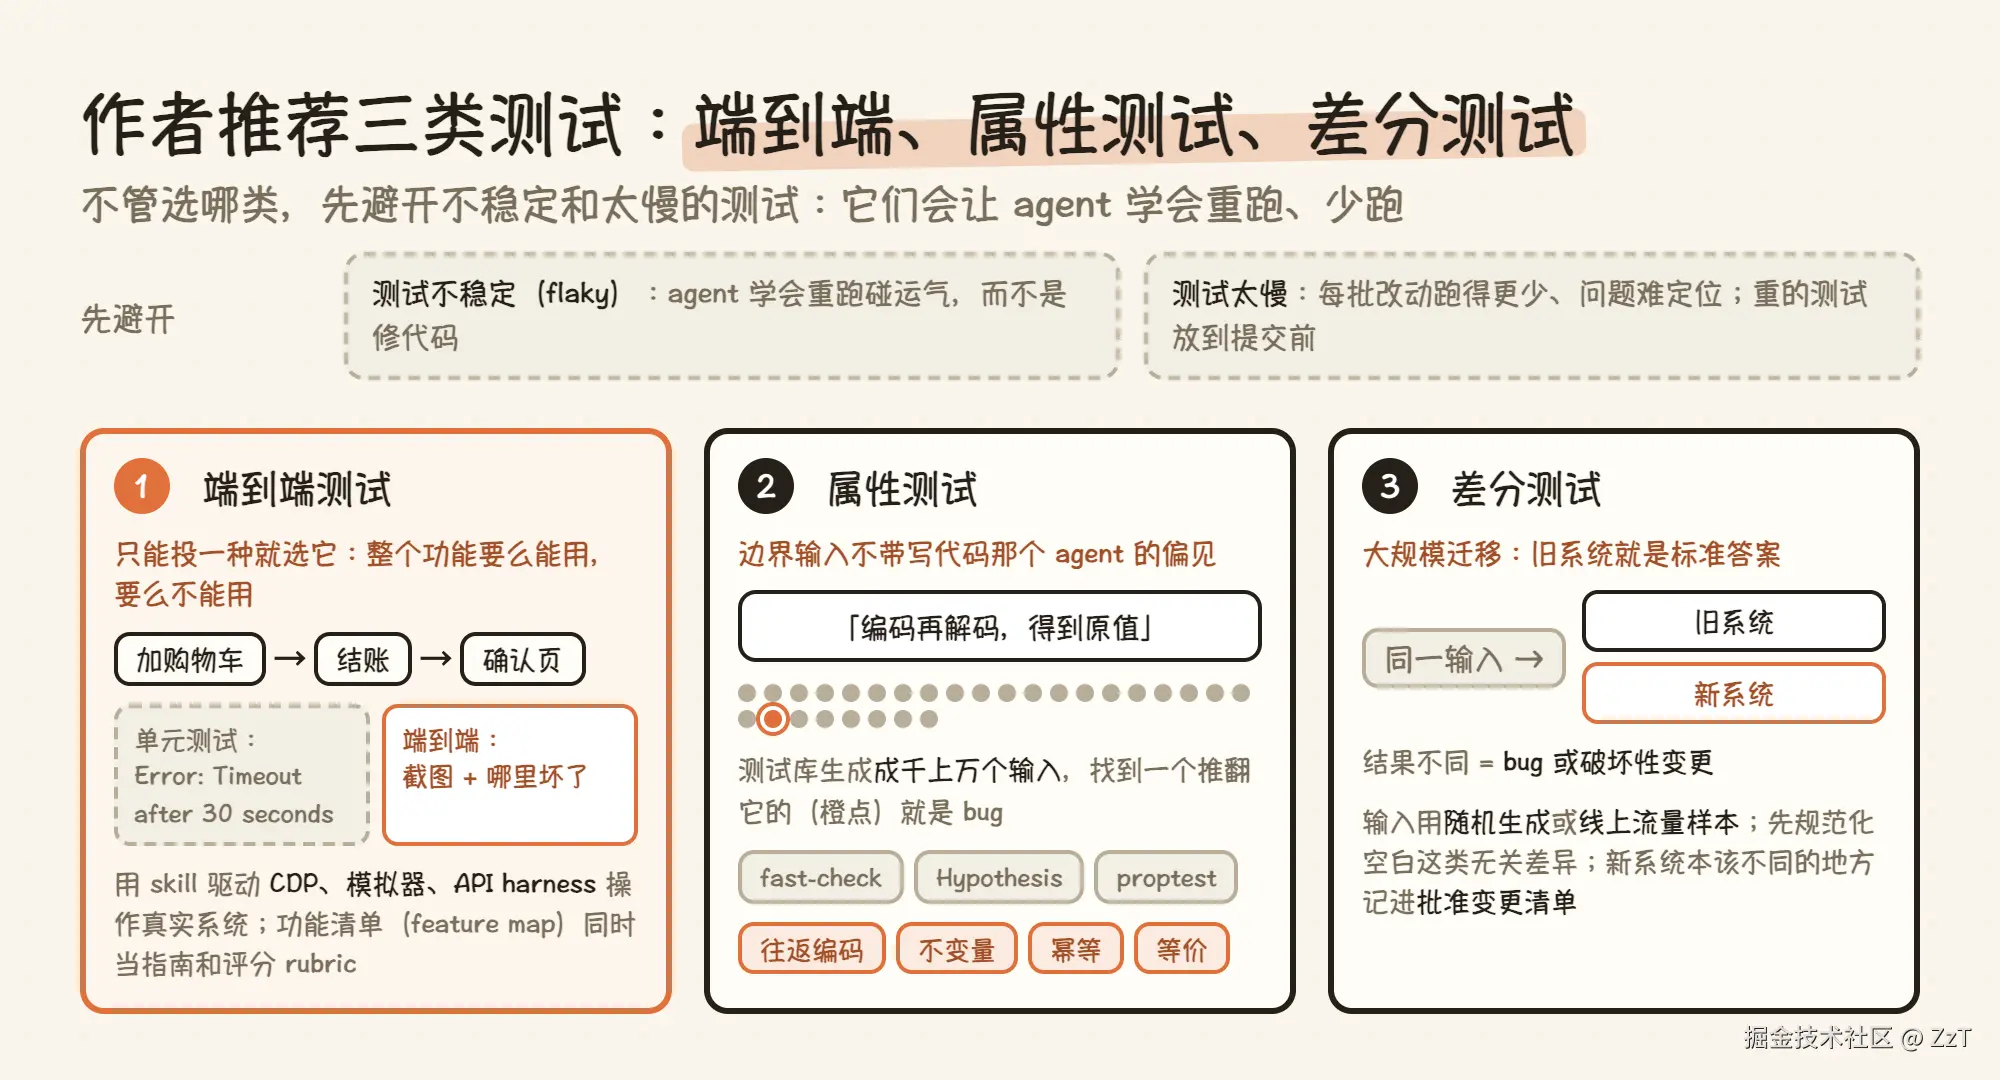
这一节是作者个人的建议。不管选哪类测试,先处理两种会把 agent 带偏的测试:
- 不稳定(flaky)的测试,会让 agent 学会重跑碰运气,而不是去修代码。
- 太慢的测试,会让 agent 在每批改动里少跑几次,问题更难定位。重的测试放在提交前跑。
端到端测试是作者的首选。它描述真实的用户流程,比如加购物车、结账、跳到确认页,功能要么走得通、要么走不通,agent 很难糊弄过去。
单元测试更快也更稳定,但可能全部通过、功能照样是坏的,因为 agent 和这些测试都不理解完整的任务。端到端测试失败时,能给出一张截图和具体哪里坏了,而不只是一句超时报错。
具体做法是用 skill 让 agent 通过 CDP、模拟器或 API harness 操作真实运行的系统。从用户视角整理的功能清单(feature map)写明路径、快捷键、选择器和预期结果,可以同时当 agent 的操作指南和评分 rubric。
属性测试专门找人容易漏掉的边界情况,而这正是 agent 常出错的地方。先写一句你认为不可能被推翻的陈述,再用 fast-check(JS/TS)、Hypothesis(Python)或 proptest(Rust)生成成千上万个输入去推翻它。
这些输入不带写代码那个 agent 的偏见。在规格已经和线上行为对不上、不能再拿来当验证依据的重写项目里,属性测试尤其有用。
差分测试适合功能不应改变的大规模迁移。同一组输入同时跑旧系统和新系统,结果不同就是 bug 或破坏性变更,旧系统就是标准答案。
输入用随机生成的数据或线上流量样本。比较前先把空白这类无关差异规范化;新系统本来就该不同的地方,记进一份批准变更清单。
提交前先跑的 verify skill
团队做法的第一条:验证就是把改动跑起来,这比跑测试更重要。原文的类比是,没人会不在模拟器里试一下就发布 iOS 改动,对 Claude 也一样。
所以团队让 Claude 像人或 QA 那样测整个应用:网页改动用 Claude 的 Chrome 扩展,移动端用 iOS 或 Android MCP,桌面应用用 computer use,后端就在本地把服务跑起来。原文说,Anthropic 几乎所有改动都这么测。
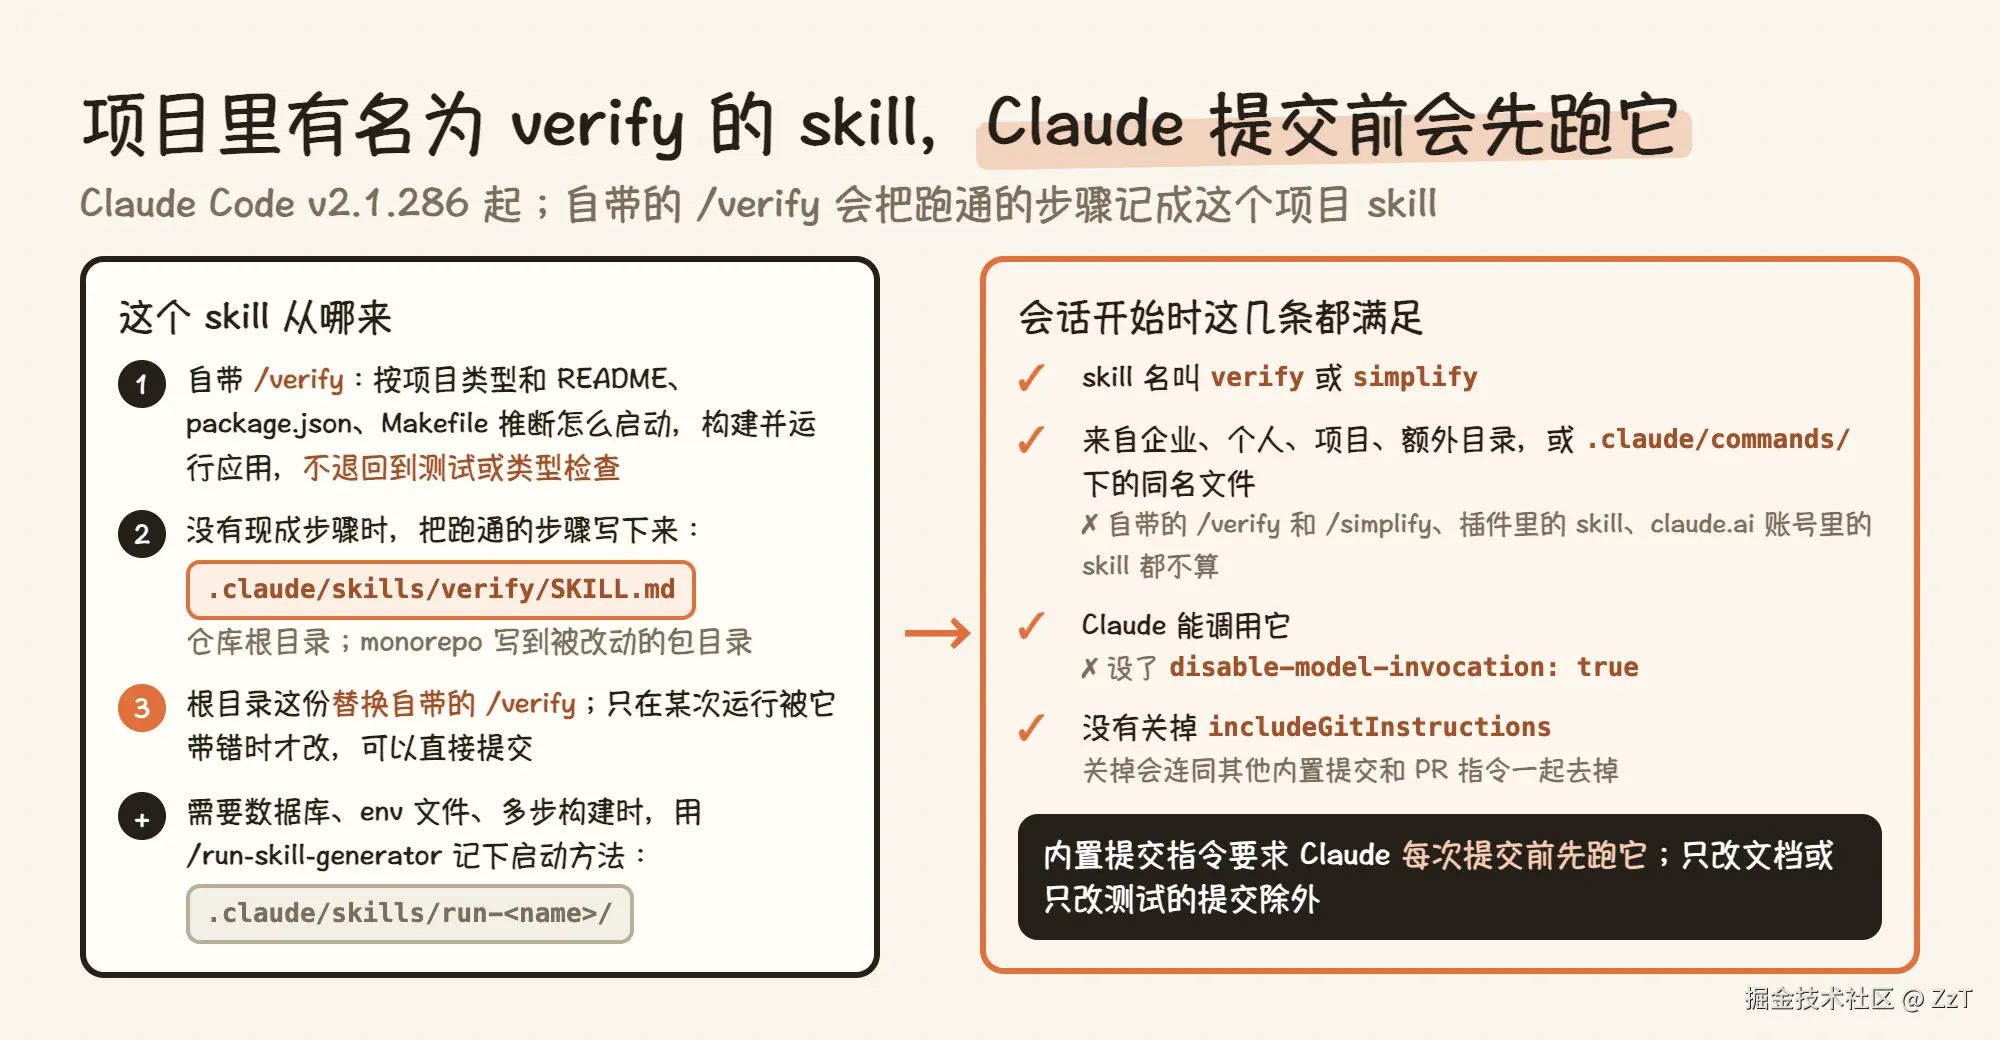
怎么启动模拟器、怎么跑应用,写成一个名为 verify 的 skill,放在仓库的 .claude/skills/ 下,尽量靠近相关代码,需要几个就放几个。Claude 会在提交前用它。
原文建议花力气把这个 skill 做得快而稳定,让 Claude 反复迭代、压测它,因为它就是项目的冒烟测试。
Claude Code 里和这条做法对应的机制有三处(文档 11 月 20 日读取):
- 自带的 /verify:不用配置,按项目类型和 README、package.json、Makefile 推断怎么启动,构建并运行应用来确认改动生效,不退回到测试或类型检查。项目需要数据库、env 文件、图形界面或多步构建时,推断就不可靠了,这时先跑 /run-skill-generator,它会从干净环境把应用跑起来,把有效的步骤记成项目 skill。
- 跑通的步骤会被记下来 :/verify 没有现成步骤时,会把跑通的步骤写进仓库根目录的
.claude/skills/verify/SKILL.md(monorepo 写到被改动的包目录),之后由这份文件替换自带的 /verify。Claude 只在这份文件把某次运行带错时才改它,所以可以直接提交进仓库。 - 提交前先跑:从 v2.1.286 起,会话开始时如果有名为 verify 或 simplify 的 skill,Claude Code 内置的提交指令会要求 Claude 每次提交前先跑它,只改文档或测试的提交除外。
原文那句「Claude 知道提交前要用 verify skill」,在 Claude Code 里对应的就是这条提交指令。它的生效条件见上图,最容易踩的是来源:自带的 /verify、插件里的 skill、claude.ai 账号里的 skill 都不算。
所以想让 Claude 提交前自动验证,最省事的做法是在项目里跑一次 /verify,把它记下的 SKILL.md 提交进仓库。Claude 是在会话开始时检查这个 skill 的,从下一个会话起生效。
三轮修不好交给人与 39 条可靠性清单
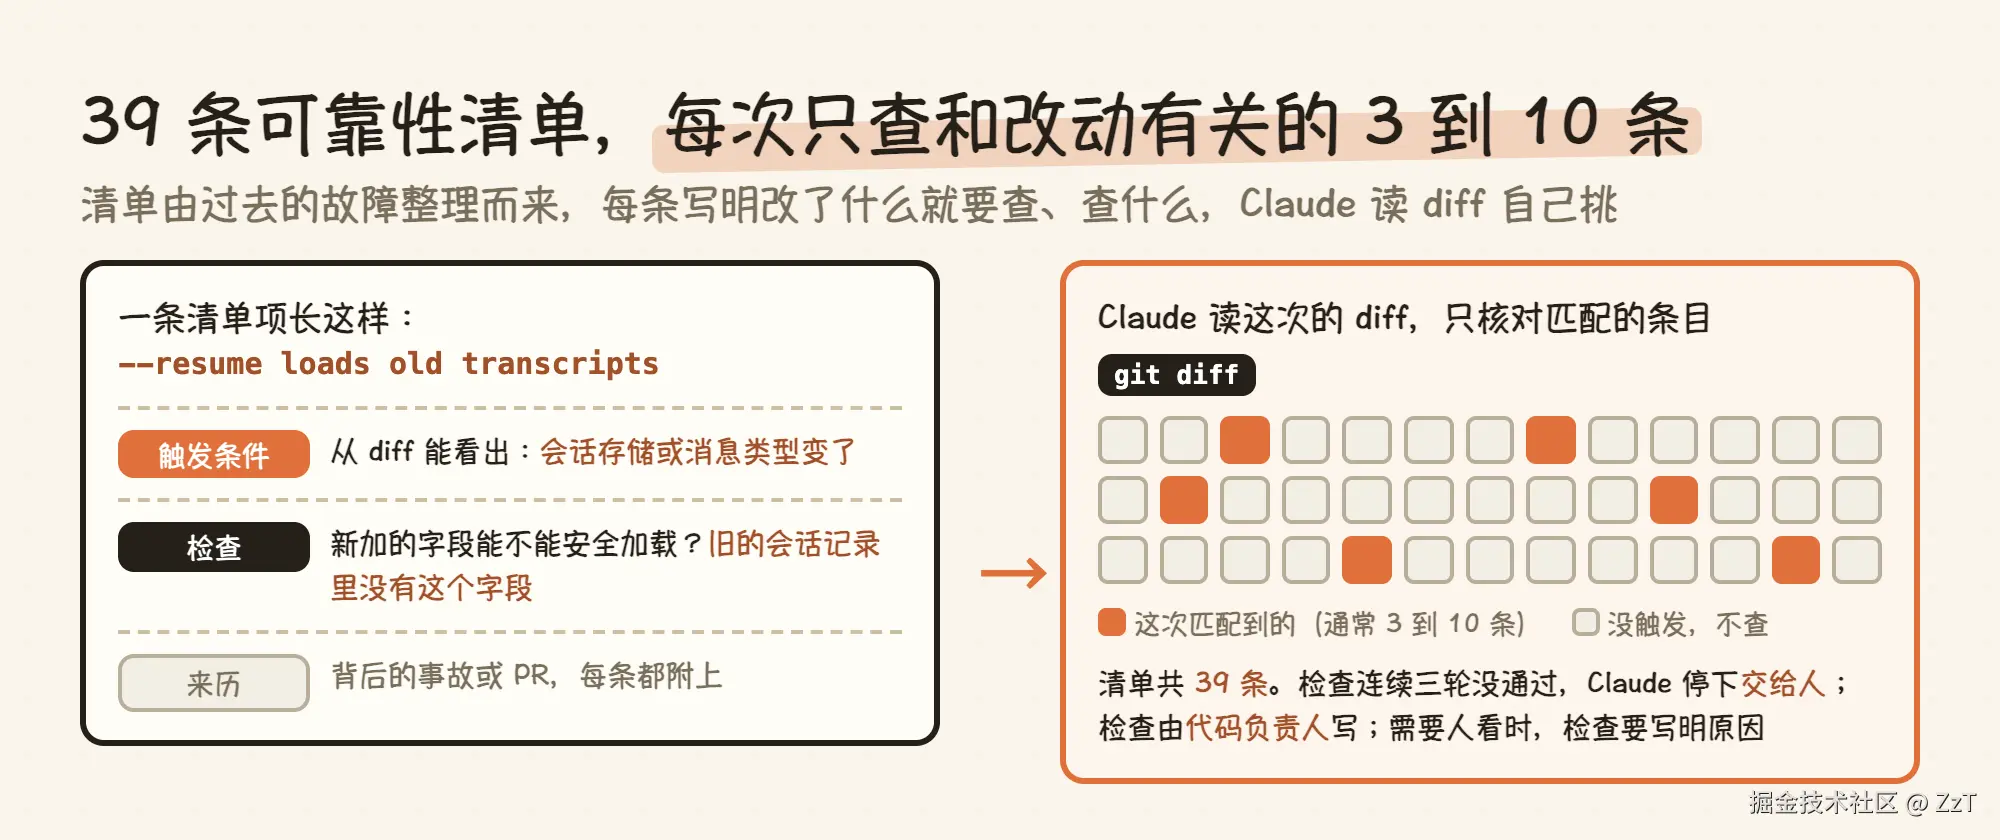
没人能读完所有改动,团队就用「失败」来决定哪些改动需要人看。Claude 跑检查,失败了自己修;同一项检查连续三轮还没通过,Claude 停下来,把人叫进来。
10 月那篇评审文章里有一条类似的上限:评审三轮之后,评审器会让作者退一步,重新考虑方案。
检查由负责这块代码的人来写,并反复调整,直到检查报出来的问题,就是负责人自己审代码时会挑出来的那些。检查需要把人叫进来时,要写明为什么,被叫来的人不用再去 diff 里自己找原因。
团队还把过去出过的故障整理成一份 39 条的可靠性清单。每一条由三部分组成:一个能从 diff 看出来的触发条件,一项检查,以及促成这一条的事故或 PR。
原文举的一条是「--resume 能加载旧的会话记录」:改了会话存储或消息类型,就要检查新加的字段能不能被安全加载,因为旧的会话记录里没有这个字段。
Claude 读 diff,只核对触发条件匹配的条目,通常是 3 到 10 条,没人需要记住过去出过哪些故障。这份清单最值得照搬的是格式:触发条件要写成能从 diff 判断的事实,检查才能按改动挑着做。
评审规则放在改动改不到的分支
团队不靠叠加评审器来提高评审质量。原文的判断是,在主评审之上再加一个更贵的评审,往往不如把主评审调好。调的办法是一份 REVIEW.md,写明这块代码评审时该关注什么。
多轮评审和验证要互相衔接:每一轮都带上前几轮和以往失败的上下文,而不是从头再查一遍。原文说这样更便宜,也找得更多。
这一节最重要的一条规则是:一个改动如果能修改评判它的检查,这个检查就失效了。落到做法上有三点:
- 规则从改动改不到的分支读。托管的 Code Review 服务只从 PR 的 base 分支或默认分支读 REVIEW.md,从不读 PR 自己的改动;要改评审行为,得先把 REVIEW.md 的修改合进去,文档同时建议保护默认分支。团队用来拦截改动的规则,也都放在改动本身改不到的分支上。本地的 /code-review 命令读的是 CLAUDE.md,不读 REVIEW.md。
- 评审结果只对一个提交有效。评审进行中有人推了新提交,这次评审就作废。原文的原话是:「A passing review on an out-of-date commit means nothing.」
- 便宜的检查先跑。agent 不在本地测试就推上去,花掉的是共享的评审和 CI 时间。团队里 Claude 在开 PR 前先跑测试、构建和 linter。强制的办法有两个:一个在 Claude 结束时跑测试的 hook,或者一个以测试全部通过为完成条件的 /goal。
这两个办法的区别,Claude Code 文档写得很清楚:
- Stop hook 写在设置文件里,对范围内所有会话生效,在 Claude 每次回复结束时触发,可以跑脚本做确定性检查。hook 返回
"decision": "block"或以退出码 2 结束,Claude 就会接着干活。连续续跑有上限:连续 8 次之后,第 9 次阻止会被忽略、回合结束;Claude 调用一次工具,计数清零;上限可以用环境变量CLAUDE_CODE_STOP_HOOK_BLOCK_CAP调高。 - /goal 是内置的、只在当前会话生效的 Stop hook。设一个完成条件后,每个回合结束由一个模型判断条件是否满足,没满足就开始下一个回合。
REVIEW.md 写什么、放在哪
REVIEW.md 是放在仓库根目录的一个 Markdown 文件,只给托管的 Code Review 服务(GitHub PR 自动评审)用,写法没有固定格式。它改变的是评审报什么、不报什么,不改变评审结果的格式。
项目的通用背景仍然写在 CLAUDE.md 里。本地的 /code-review 不读 REVIEW.md,想让本地评审也遵守的规则,要写进 CLAUDE.md。
Claude Code 文档建议按遇到的问题来写,常见的有五类:
- Important 标错了:重新定义这个仓库里什么算 Important、什么最多算 Nit。默认标准是按生产代码定的,文档仓库、配置仓库或原型项目可能需要窄得多的定义;也可以反过来升级,比如违反 CLAUDE.md 一律算 Important。
- Nit 太多:限制每次评审最多报几条 Nit,文档的例子是 5 条。
- 评论了生成文件或 CI 已经查过的东西 :列出要跳过的路径和问题类别,比如生成代码、lock 文件、vendor 进来的依赖,以及 CI 已经在查的 lint、拼写。只想轻度评审的目录可以提高门槛,例如
scripts/里只报几乎确定且严重的问题。 - 团队规则没人查:写上每个 PR 都要查的规则,例如新增的 API 路由必须有集成测试。
- 某类发现经常报错 :要求先给证据再报,例如对代码行为的判断必须引用
file:line,不能只凭命名推断。
10 月那篇评审文章补充了 Claude Code 团队自己的经验。REVIEW.md 由代码负责人来写,好的都很短:先写清这个仓库里「出问题」是什么样,文档仓库是内容写错,配置仓库是路由配错;再限 Nit 数量、列出跳过的路径、要求 file:line 证据;最后要求评审总结先给出问题数量,没有要修的就直接说没有。团队还会单独检查评审器有没有真的照 REVIEW.md 做。
按这五类写出来,大致是下面这样(示例,规则内容换成自己项目的):
markdown
# 评审说明

## 什么算 Important
只有会导致行为错误、数据泄露或无法回滚的问题算 Important。
命名、风格、重构建议最多算 Nit。

## Nit 上限
每次评审最多报 3 条 Nit。

## 不要报
- CI 已经检查的 lint、格式、类型错误
- src/generated/ 下的生成代码和 lock 文件

## 每次都要查
- 改了接口返回结构的,要同步更新接口文档
- 用户能看到的报错文案里不能出现内部错误码

## 证据要求
判断某段代码行为有问题时,要给出文件和行号,不能只凭函数名推断。

## 总结格式
先写发现了几个问题;没有需要修的,直接写没有。
写之前还要确认它放在哪、能不能生效:
- 评审读的是 PR 的 base 分支或默认分支上的 REVIEW.md,PR 里对它的修改要先合并才生效。
- 降低严重级别、排除路径、限制 Nit 数量这三类指令,只有在默认分支受保护时才会执行。
- 默认分支受保护时,子目录里也可以放 REVIEW.md,为这个目录下的改动追加检查;放在 tests、examples、generated、vendor 这类目录里的不生效。
- 规则多了可以拆成几个文件,在根目录的 REVIEW.md 里用单独一行
@文件名引入,被引入的文件放在根目录,最多 8 个,合计不超过 150,000 字节;也可以用@.claude/skills/<目录>/SKILL.md把一个 skill 的正文引进来。引入同样只在受保护的分支上生效。
提交闸门先记录、再拦截
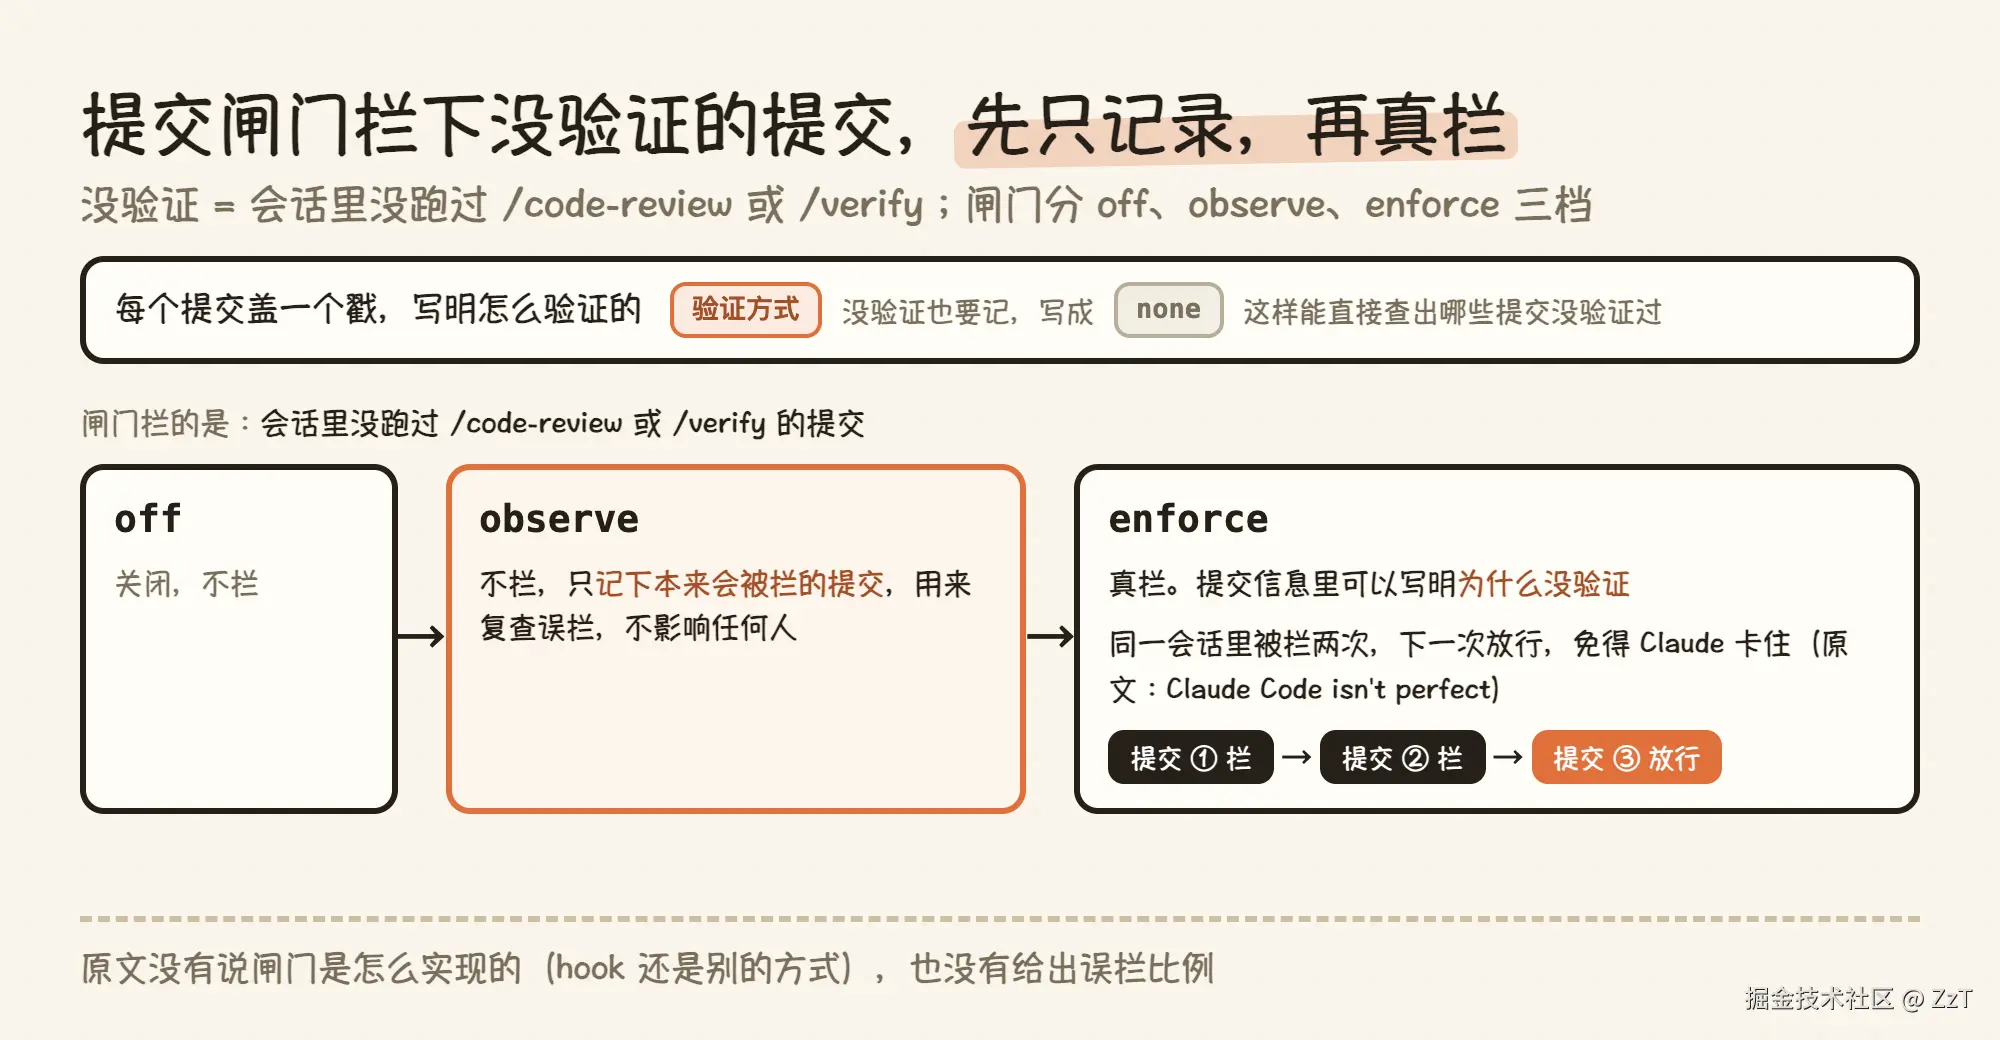
团队给自己仓库的每个提交盖一个戳,写明这个提交是怎么验证的。没验证也要写成 none,这样能直接查出哪些提交没验证过。
在此之上,团队做了一个提交闸门:会话里没跑过 /code-review 或 /verify,就拦下这次提交。闸门有 off、observe、enforce 三档:
- observe 只记录本来会被拦下的提交,不真拦,用来复查误拦,不影响任何人。
- enforce 真拦,但提交信息里可以写明为什么没有验证。同一个会话里被拦过两次,下一次就放行,免得 Claude 卡住,原文给的理由是 Claude Code 也不完美。
原文这一节的标题就是「新闸门先用 observe 模式」。但原文没有说闸门是怎么实现的,也没给 observe 期间的误拦比例。
评审器召回率按三个阶段分开算
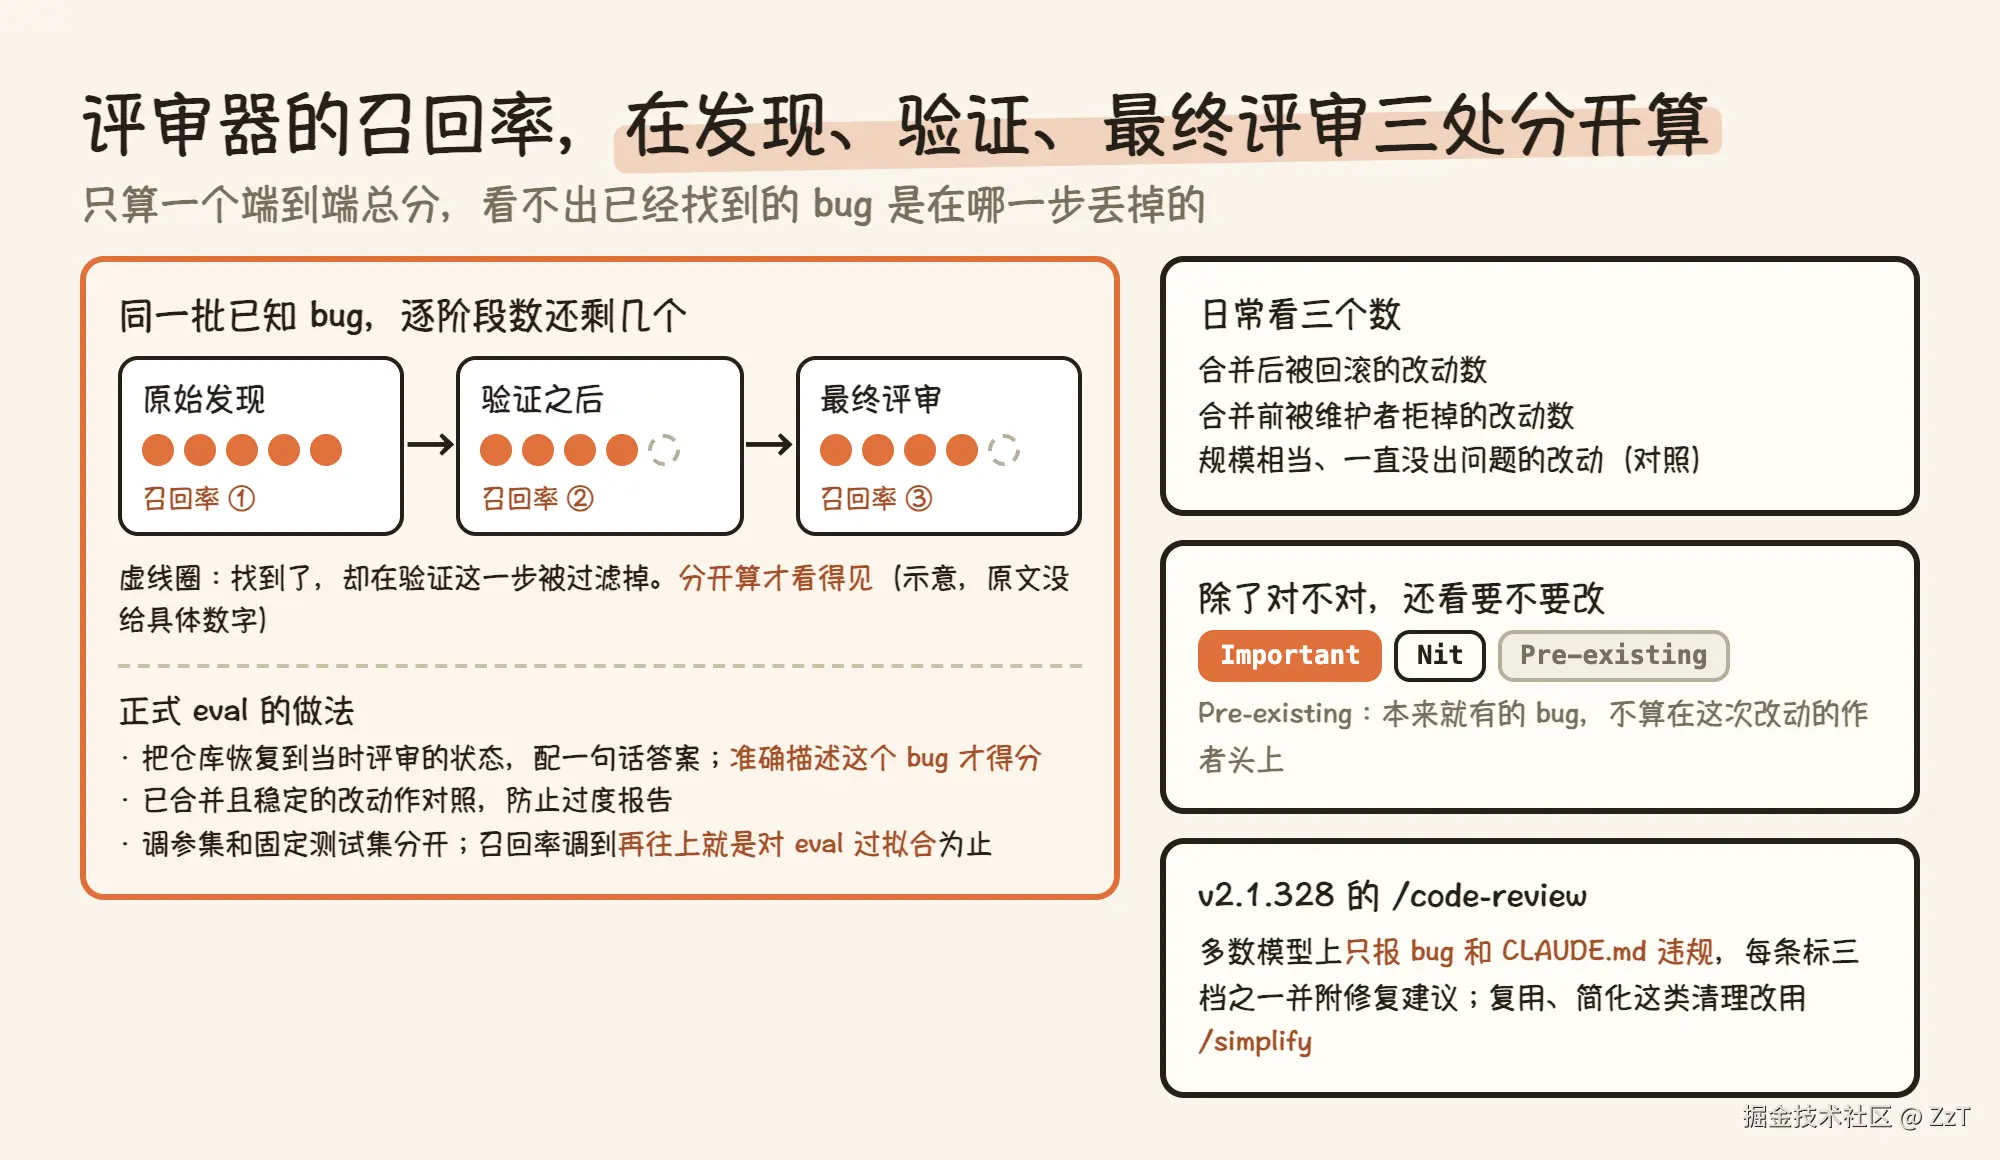
团队定期「评审评审器」,日常看三个数:合并后被回滚的改动数,合并前被维护者拒掉的改动数,以及一组规模相当、一直没出问题的改动作对照。
正式的评估沿用 10 月文章里 Code Review 团队的做法:
- 样本取自以往的事故和回滚。每个样本把仓库恢复到当时评审的状态,配一句话写明 bug 是什么,只有准确描述出这个 bug 的发现才得分。
- 用已合并且稳定的改动作对照,防止评审器过度报告。
- 调参用的样本和评估用的固定测试集分开。
召回率要分三个阶段算:原始发现、验证之后、最终评审。合成一个端到端总分,就看不出系统有没有把已经找到的 bug 在中途过滤掉。团队把召回率一直往上调,调到再往上就是在对 eval 过拟合、而不是在多抓 bug 为止。
除了对不对,还要看要不要改。Code Review 把每条发现标成 Important、Nit 或 Pre-existing;Pre-existing 表示这个 bug 本来就有,不算在这次改动的作者头上。
11 月 19 日的 v2.1.328 把本地的 /code-review 也往这个方向调了:在多数模型上只报 bug 和违反 CLAUDE.md 的地方,复用、简化、效率这类清理改由 /simplify 负责;每条发现标 Important、Pre-existing 或 Nit,总结末尾附修复建议。
把漏掉的 bug 写成规则
在 Claude Code 的仓库里,漏掉的问题有两种方式变成规则:
- 从人工评审评论和 PR 回滚里找模式。一个模式至少在两个 PR 里出现过、并且能从 diff 识别出来,才算候选规则;然后让三个 agent 试着推翻它,最后由人在 PR 里审批。
- 拿关联了已知事故的 PR 做重放,让三个找 bug 的 agent 去找。至少两个找到,就算可检测的 bug;如果在一个小 diff 上也漏掉了,就值得写进 REVIEW.md。
不稳定的测试同样严格处理:Claude 不能跳过它、不能加 sleep、不能一直重试到通过。找不到根因,就删掉这个测试,并写下原因。
规则也要定期清理。测试集、验证步骤和各种 .md 文件,不管它就只会越积越多。
原文的数据边界与照搬顺序
原文给的是做法,没有给效果。39 条清单、verify skill、REVIEW.md、提交闸门,都没有故障率、误拦率之类的数字,提交闸门的实现方式也没写。文中出现的两个数字,「最多高 10 个点」来自 Managed Agents 的结构化文件生成测试,「好两到三倍」是 Boris Cherny 的个人估计。
照搬时可以按投入从小到大排,下面只用原文和文档里已有的做法:
- 先让 Claude 能把应用跑起来 。修掉太慢和不稳定的测试;在项目里跑一次 /verify,把它记下的
.claude/skills/verify/SKILL.md提交进仓库,v2.1.286 起 Claude 每次提交前都会先跑它;再用 Stop hook 或 /goal 保证开 PR 前跑完测试、构建和 linter。 - 把规则放到改动改不到的地方。本地评审规则写进 CLAUDE.md;用托管 Code Review 的,REVIEW.md 放在默认分支并保护起来。定下三轮修不好就交给人;从自己的事故里,按「diff 触发条件、检查、来历」的格式积累可靠性清单。
- 最后上提交闸门和评审器评估。先给提交盖验证戳,包括 none;闸门用 observe 跑一段时间,看清误拦情况再切到 enforce,保留被拦两次就放行的退路;之后再做评审器的分阶段召回率评估和规则的定期清理。
原文最后的结论是:做到这些,人的工作就从读每一个 diff,变成定义什么叫「做完」、再检查证据,这也是能同时跑很多个 Claude 的前提。
参考链接
- How the Claude Code team thinks about verification(2026-11-16):claude.dev/blog/how-th...
- How the Claude Code team does code review(2026-10-15):claude.dev/blog/solvin...
- Claude Managed Agents 发布文章(2026-04-08):claude.com/blog/claude...
- Building verification loops in Claude Code with skills(2026-07-22):claude.com/blog/buildi...
- Claude Code 文档 Skills(Run and verify your app):code.claude.com/docs/en/ski...
- Claude Code 文档 Customize Code Review(REVIEW.md):code.claude.com/docs/en/cod...
- Claude Code 文档 Hooks(Stop):code.claude.com/docs/en/hoo...
- Claude Code 文档 /goal:code.claude.com/docs/en/goa...
- Claude Code CHANGELOG:github.com/anthropics/...