一串裸 uint64、五张表,和那个把账本写成文件的抄账员
你大概用 go tool pprof 打开过一份 cpu.pprof,火焰图一展开,函数名、行号、耗时都在上面。但很少有人反过来问:从 pprof.StartCPUProfile(f) 到 StopCPUProfile() 之间,那个文件是怎么一个字节一个字节攒出来的 ?runtime 交到这一层的,不是结构体,也不是文本,而是一串光秃秃的 uint64------第一格写长度、第二格是时间戳、第三格是样本数、后面跟一摞 PC 地址。要把这串数字变成 go tool pprof 认得的档案,中间得经过三层翻译。
这篇文章从 go1.24.0 的 proto.go(766 行)、map.go(90 行)与 protobuf.go(141 行)出发,顺着源码讲清这件事:一个叫 profileBuilder 的「抄账员」,怎么把 runtime 的裸记录流按「栈 + 标签」去重累加,把每个栈翻译成 Location / Function / Mapping 三张表,再用一百多行手写的 protobuf 编码器把字节灌进 gzip,最后封成 gzip(protobuf(Profile))。为什么不直接用现成的 protobuf 库、长度前缀为什么要先写到尾部再搬回头部、内联展开的一串伪 PC 怎么折回一个 Location------这些反直觉的写法,全都有它非这么写不可的理由。
读法上先说好三件事:代码块右侧的 // ← 是逐行注释,行号都是 go1.24.0 的实际行号;每一节先给一张数据流画面(一个能放电影的比喻),再上源码逐行,最后拆本节对应的难点;文中 §2.4 这类写法只是本文自己的小节号 (第 2 节第 4 小节),「难点 A~J」是本文给十个最容易卡住的问题起的代号,每一个都做成带问题标题的小节、挂在讲它的那一节末尾------按名字找就行,不需要对照任何别的资料。源码块一条注释都不省,白话只是帮你把画面立起来。
本文会讲什么
文章按源码从上往下走,但可以记成四条线索:
- 档案与抄账员 :一份
Profile的五张表、string_table为什么单独一张,以及profileBuilder身上挂了哪些状态(§1~§2) - 一笔账走完全程 :裸
uint64记录流 →addCPUData解析 →profMap去重 →build遍历封包(§3~§5、§9) - 栈到表的四道翻译 :
allFrames展开、pcDeck折叠内联、emitLocation写 Location / Function、parseProcSelfMaps找模块(§3、§6~§8) - 字节与收束 :
flush的刷盘边界、varint与三次 copy、gzip 收尾,再收成十条不变量、九个易错点和一张复述卡(§2、§10~§14)
卡住时可以直接查「黑话速查表」(§0.4),或按「行号对照表」(§0.5)跳到对应难点;想快速复习,直接翻「一页纸速查」(§12)和「五分钟复述卡」(§14)。
0 导读:先把画面立起来
0.1 先说结论:一句话、三句话、先给你半句答案
一句话
profileBuilder就是那个「抄账员」:它把 runtime 吐出的一串裸uint64记录,先按「栈 + 标签」去重累加,再把每个栈翻译成 Location / Function / Mapping 三张表,最后用一百多行手写的 protobuf 编码器把字节灌进 gzip,封成一份cpu.pprof。
拆成三句话:
- 输入不是文本,是流水账 :上游交来的是
[3+n]uint64这样的裸记录流,第一格写长度、第二格是时间戳、第三格是样本数、后面是栈;本文这一层是消费端,第一件事就是按约定把数字重新切回语义。 - 中间全是「去重」 :函数名只存一份(
string_table+stringIndex)、同栈样本即时合并(profMap)、内联展开的多个伪 PC 折回一个 Location(pcDeck)------三处去重,把「每秒上百条」压成一份能看的文件。 - 输出是手工字节,不是调用库 :
runtime/pprof不能依赖 protoc 生态,所以自己写了一个只「写」不「读」的编码器;长度前缀事后才知道,就用「尾部追加 + 三次 copy」把前缀挪到前面。
读到这里,你可能会冒出下面几个疑问。别急着弄懂------先把每问的半句答案摆在这儿,知道后面要解开什么就够了;每一问在后文都有同名的小标题,会把它拆开讲透。
| 你可能会问 | 先给你半句答案 |
|---|---|
| 一份 pprof 文件最外层是什么?Profile 里为什么要单独放一张 string_table? | 最外层是 gzip 包住的 protobuf(Profile);单独放 string_table,是因为函数名重复率极高,登记一次后处处只写页码。 |
| 手写 protobuf 编码为什么不直接用现成的库?它只实现了哪一半? | runtime/pprof 是标准库最里层之一,不能依赖带 reflect 的 protoc 生成链;这个编码器只「写」不「读」,解析交给 go tool pprof。 |
varint 和 field number 在字节里到底怎么摆? |
字节里没有字段名,先写「字段号左移 3 位按位或 wire_type」的 key;值用 varint 按 7 位一组拆,小数字只占 1 字节。 |
| 长度前缀明明写在头部,为什么源码先把它追加到尾部? | 长度是 varint、不定长,写完内容才知道占几字节,预留不是浪费就是放不下;所以先追加到尾部,再用三次 copy 搬回头部。 |
明明抓到的是「一长串 PC」,文件里怎么变成一个带 line[] 的 Location? |
pcDeck 把编译器给内联帧留的 NOP 伪 PC 按三条启发式折成一堆,emitLocation 定稿成一个 Location,line[] 里装内联链。 |
缓冲刷盘为什么非要等 nest == 0? |
nest 记录当前套在第几层消息里;不为 0 就有子消息写到一半、长度前缀还没回填,此时刷盘会把半截消息送进 gzip,文件就坏了。 |
| 首记录是样本吗?100Hz 换成多少纳秒?溢出记录怎么归账? | 首记录不是样本,是周期元数据,100Hz 换成 10,000,000 纳秒就消费掉;溢出记录以 count==0 且栈长 1 认出,伪栈归到 lostProfileEvent 名下。 |
同栈样本靠什么即时合并?为什么不直接用 map[string]? |
靠 profMap.lookup(stk, tag).count += count 对 []uint64 滚动哈希即时累加;用 map[string] 得先把栈序列化成字符串,每秒上百条光分配就吃不消。 |
| 新函数为什么要攒到 Location 写完才补写?缓存为什么要拷贝切片? | 子消息内容区不能再开子消息,Function 插进去会被算进 Location 长度,所以先记进 newFuncs 后补写;deck 复位会复用底层数组,缓存不拷贝就被覆写。 |
/proc/self/maps 里为什么只留可执行段?读不到怎么办? |
PC 只可能落在代码上,所以按权限位第 3 位是不是 x 来筛;maps 读不到就加一个 fake mapping 全收所有地址,保证文件照样能生成。 |
关于「难点 A~J」 :它们不是另附的习题,就是后文十个小节的标题,例如「难点 J|三次 copy 杂技:长度前缀为什么先追加到尾部」。上面每一问都能按标题直接找到;
§2.4也只是本文的小节号,翻到那一节即可。
0.2 站在流水线的哪一段:抄账员,以及为什么难
先用四个角色给整条 CPU 剖析流水线对号入座,看看本文的舞台在哪儿:
text
   ① 闹钟(内核定时器,每 10ms 一响)
           │
           ▼
   ② 被拍肩的工人(sigprof 抓下调用栈)
           │
           ▼
   ③ 环形账本 profBuf(无锁,写满就丢)
           │  read 借出 [3+n]uint64 记录流 + 平行的 tags
           ▼
   ┌───────────────────────────────────────────────┐
   │  ④ 抄账员 · profileBuilder(本文的舞台)       │
   │                                               │
   │    解析记录流 → profMap 按 (栈, tag) 去重累加    │
   │    build 遍历 → 栈转 Location / Function        │
   │    手工 protobuf 编码 → gzip → 一份 pprof 文件   │
   └───────────────────────────────────────────────┘
           │
           ▼
      cpu.pprof → go tool pprof → 火焰图
③ 那本账本在信号处理器里被写入,只写得进数字格子,既不能上锁、也不能构造 Go 结构体;所以跨过 ③→④ 边界的,只能是「一串 uint64 + 平行的标签指针」。本文只管框起来那一段:拿到账之后,怎么把它写成一份文件。
为什么这段读起来不直观 :因为它不是「一个算法」,而是三层翻译叠在一起,而且每层用的都是另一套语言。
| 层 | 手里是什么 | 要变成什么 | 对应源码 |
|---|---|---|---|
| 第一层 | 裸 uint64 记录流(runtime 的黑话) |
结构化样本(栈、标签、计数) | §4 addCPUData |
| 第二层 | PC 地址、内联展开帧 | Location / Function / Mapping 三张表 | §3、§6~§8 |
| 第三层 | 表里的字段 | protobuf 字节 + gzip 流 | §2、§10 |
再叠三个「环境限制」,代码就必然长得绕:
| 现实的麻烦 | 源码的对策 |
|---|---|
不能依赖 protoc 生成的 .pb.go(带 reflect / 初始化开销) |
手写只「写」不「读」的编码器(§10、难点 B) |
| 字符串重复率极高(函数名几万次) | 全走 string_table,字段里只存索引(§1、难点 A) |
| 样本流每秒上百条,不能每条都分配字符串 key | profMap 直接对 []uint64 做滚动哈希(§9、难点 H) |
| gzip 要流式写,不能把整个文件攒在内存 | flush 每 4KB 下刷一次、且只在消息边界刷(§2、难点 C) |
| 编译器内联把一帧展开成好几个伪 PC | pcDeck 状态机把它们折回去(§6、难点 E) |
一句话记住 :这里不关心「怎么抓样本」,只关心「抓完之后,怎么把一串数字整理、去重、翻译、装箱」。难的不是某一行位运算,是上游是 runtime 的黑话、下游是 proto 的字节规范,中间还得一边去重一边流式输出。
0.3 全局地图:一份 pprof 文件是怎么攒出来的
把整份源码当成一条装配线看就不乱了:
text
  profBuf.read  ──►  data []uint64 + tags
        │
        ▼
  ┌──────────────────────────────────────────────┐
  │  addCPUData(§4)                             │
  │   首记录解析周期 hz → period = 1e9 / hz        │
  │   逐条切出 count / stk / tag                   │
  │   溢出记录 → 归罪 lostProfileEvent             │
  │   b.m.lookup(stk, tag).count += count          │
  ├──────────────────────────────────────────────┤
  │  profMap(§9)按 (栈, tag) 去重累加            │
  │  all 链按插入序保存全部条目                     │
  ├──────────────────────────────────────────────┤
  │  build(§5)遍历 all 链                       │
  │    values[0]=count, values[1]=count×period    │
  │    appendLocsForStack:栈 → Location id 列表   │
  │      ├─ allFrames(§3)符号化展开              │
  │      ├─ pcDeck.tryAdd(§6)折叠内联            │
  │      └─ emitLocation(§7)写 Location/Function │
  │    pbSample → 写一条 Sample                    │
  │  写 Mapping / StringTable / 头部字段            │
  ├──────────────────────────────────────────────┤
  │  protobuf(§10)字节缓冲 + flush(§2)         │
  │    varint / length / packed / 三次 copy        │
  └──────────────────────────────────────────────┘
        │
        ▼
  gzip.Writer(BestSpeed)→ io.Writer → cpu.pprof
一句话读图 :左边进的是「一串数字」,右边出的是「一份压缩文件」;中间那个大方框里,上半段在去重、下半段在编码 ,build 是上下两半的分界线。读源码容易晕,很大程度是因为它按文件从上往下讲(先讲字段常量、再讲小工具、最后才讲编码器和 profMap),而人脑是按数据流动理解的------所以 §11 会先带你把一条记录跑完全程,再回头拆零件。
0.4 黑话速查表(读不下去时先翻这里)
用法:遇到不认识的词,先查「通俗解释」那一列,能继续读就不必深究;想追根问底再按第三列跳。
| 黑话 | 通俗解释 | 本文位置 |
|---|---|---|
| Profile | 一份剖析档案的最外层消息,pprof 工具读的就是它 | §1 |
| gzip(protobuf(Profile)) | 文件最外层封装:先编码成字节,再整体压缩 | §1、§5 |
| 五张表 | sample_type / sample / mapping / location / function,档案的五张主表 | §1 |
| string_table | 字符串字典:所有名字只登记一次,别处只写页码 | §1 |
| ValueType | 列定义:一列数据叫什么、单位是什么 | §1、§2 |
| Location.line\[\] | 一个栈帧里的「内联链」:一串函数 + 行号 | §1、§7 |
| sample.location_id | 数据行只存 Location 的编号,不重复存栈 | §1 |
| protobuf wire format | 字节层面的编码规矩:字段号 + 类型 + 值怎么摆 | §10 |
| varint / LEB128 | 变长整数:小数字占 1 字节,大数字才多占 | §10 |
| field number / tag | 字段编号,proto schema 里写死的 1、2、3...... | §1、§10 |
| wire_type | 这个字段的值怎么摆:0=单个数、2=带长度的一段 | §10 |
| packed 编码 | 一串数字打包成「一个 key + 总长度 + 连续值」 | §10 |
| tag 常量表 | 把 proto 字段号手抄成 Go 常量(70~129 行) | §1 |
| profileBuilder | 抄账员本人:持有全部中间状态的那一个大结构 | §1 |
| start / end | 构建开始与结束时间 → time_nanos / duration_nanos | §1、§5 |
| havePeriod / period | CPU 专属:采样周期(纳秒),由首记录的 hz 换算 | §1、§4 |
| stringIndex | 「字典登记员」:查不到就追加,返回页码 | §2 |
| stringMap | 名字 → 页码的反查表,避免重复登记 | §1、§2 |
| flush / dataFlush=4096 | 缓冲满 4KB 就往 gzip 里灌一批 | §2 |
| nest | 当前套了几层消息;不为 0 时禁止刷盘 | §2、§10 |
| pb* 三明治 | startMessage → 写字段 → endMessage 的固定写法 | §2 |
| startMessage / endMessage | 子消息开写 / 收尾回填长度前缀 | §10 |
| 三次 copy 杂技 | 长度前缀先追加到尾部,再整体搬移回头部 | §10 |
| tmp 16byte | 搬移时暂存 key + 长度的小草稿纸 | §10 |
| int64Opt / uint64Opt | 值为 0 就干脆不写这个字段(省字节) | §2、§10 |
| allFrames | 把一个 PC 展开成若干 frame(含内联链) | §3 |
| runtime.CallersFrames | runtime 提供的 PC → 函数 / 文件 / 行号翻译器 | §3 |
| locInfo | PC → Location 的缓存条目,命中就免符号化 | §3、§7 |
| firstPCFrames | 缓存里叶 PC 的展开结果,喂给 deck 复用 | §3、§6 |
| pcDeck | 把内联展开的多个伪 PC 折回一个 Location 的状态机 | §6 |
| NOP 伪 PC | 编译器为每层内联留的空指令地址,混在栈里 | §6 |
| tryAdd 三判据 | Func / Entry / Name 三条启发式,判断能否合并 | §6 |
| emitLocation | 把 deck 里攒好的内容写成一个 Location 消息 | §7 |
| newFuncs | 先攒着、Location 写完才补写的函数表新条目 | §7 |
| funcs | 函数全名 → Function.ID 的表 | §1、§7 |
| mapping / memMap | 加载进内存的模块(二进制 / 共享库)条目 | §1、§8 |
| parseProcSelfMaps | 读 /proc/self/maps,只挑可执行段 |
§8 |
| buildID | 二进制构建指纹,pprof 据此配对符号 | §1、§8 |
| fake mapping | 平台读不到 maps 时的兜底假条目,全收所有地址 | §8 |
| symbolizeFlag | 符号化结果标记:lookupTried / lookupFailed | §1、§3 |
| readMapping | 三种平台实现各自把模块表填进 b.mem | §8 |
| addCPUData | 消费记录流、解析并去重累加的入口 | §4 |
| 3+nuint64 记录 | 一条流水账:长度 / 时间 / 样本数 / 栈 | §4 |
| lostProfileEvent | 自递归伪函数,溢出丢的样本记在它名下 | §1、§4 |
| 溢出记录 | count==0 且栈长 1 的特殊记录,是丢件补报 | §4 |
| profMap | 按 (栈, tag) 去重累加的哈希表(map.go) | §9 |
| 滚动哈希 / 乘 41 | 逐 PC 左旋 8 位再加 41 倍,算出桶号 | §9 |
| move-to-front | 命中就把条目提到链头,热栈下次更快 | §9 |
| free / freeStk | 成批分配的条目池与栈池,避免每条都 new | §9 |
| gzip.BestSpeed | 压缩率换 CPU:剖析数据要写得快 | §3 |
| build | 遍历去重表、翻译栈、封包、收尾 gzip | §5 |
0.5 源码行号 ↔ 难点 ↔ 配图对照表
用法:读到某一节卡住,在这张表里找到它,先看「先看的白话」那一格,再回源码。「初读可跳过」打「可以」的,允许先糊弄过去,回头再补。
| 源码位置 | 在讲什么 | 先看的白话 | 配图 | 初读可跳过 |
|---|---|---|---|---|
| §1 · 20~129 行 | Profile 五张表、builder 字段、tag 常量表 | §1.1「档案柜」、难点 A / B | 图 10-1、图 10-2 | |
| §2 · 131~207 行 | stringIndex / flush / pb* 三明治 | §2.1「登记员与装箱工」、难点 C | --- | |
| §3 · 209~272 行 | allFrames 单地址展开、locInfo 缓存 | §3.1「单地址翻译器」 | --- | 可以 |
| §4 · 274~345 行 | addCPUData 首记录、主循环、溢出 | §4.1「拆包裹」、难点 D | --- | |
| §5 · 347~392 行 | build 遍历去重表、封包收尾 | §5.1「交账」 | --- | |
| §6 · 394~580 行 | appendLocsForStack、pcDeck 折叠 | §6.1「折叠机」、难点 E | 图 10-3 | |
| §7 · 582~657 行 | emitLocation 写 Location / Function | §7.1「定稿」、难点 F | --- | |
| §8 · 659~766 行 | mapping 与 parseProcSelfMaps | §8.1「查地图」、难点 G | --- | 可以 |
| §9 · map.go 全文 | profMap 去重哈希、池、MTF | §9.1「减压阀」、难点 H | --- | 可以 |
| §10 · protobuf.go 全文 | varint / packed / 三次 copy | §10.1「只带一把螺丝刀」、难点 I / J | 图 10-4 | |
| §11 · 串讲 | 一条 CPU 记录走完全程 | 全节 | 图 10-2 |
1 认识这份档案与攒档案的人:Profile 五张表 + profileBuilder(20~129 行)
1.1 先建画面:一个档案柜、一本字典
把一份 .pprof 想成一个档案柜:柜子里有五张主表------sample_type 是列定义、sample 是数据行、mapping 是加载进内存的模块、location 是栈帧、function 是函数。柜子旁边还单独立着一本字典 string_table:所有函数名、文件名、单位名先登记进字典,拿到一个页码,五张表里凡是碰到名字的地方,一律只写页码,不写字母。
这么摆是有代价的:读表的人得来回翻字典。但回报更大------一个跑了几秒的程序,main.worker 这个名字可能在栈里出现几万次,写进字典只要一次,页码走 varint 编码通常只占一两个字节。而抄账员 profileBuilder,就是那个一边翻字典、一边往五张表里填格子、最后把整个柜子压缩封箱的人。
1.2 Profile 消息的五张表
一份 .pprof 文件 = gzip(protobuf(Profile)) 。把最外层那层 gzip 撕掉,里面是一个 Profile 消息,结构如下:
scss
Profile
├── sample_type[]  ValueType{type,unit}        ← 列定义(如 samples/count + cpu/nanoseconds)
├── sample[]       Sample{location_id[], value[], label[]}   ← 数据行
├── mapping[]      Mapping{start,limit,offset,file,buildID}  ← 加载的模块(二进制/共享库)
├── location[]     Location{id, mapping_id, address, line[]} ← 栈帧(PC);line[] 是内联链!
├── function[]     Function{id, name, filename, start_line}
├── string_table[] string                      ★所有字符串先入表,字段里存索引
├── time_nanos / duration_nanos / period_type / period / default_sample_type
└── drop_frames / keep_frames / comment[]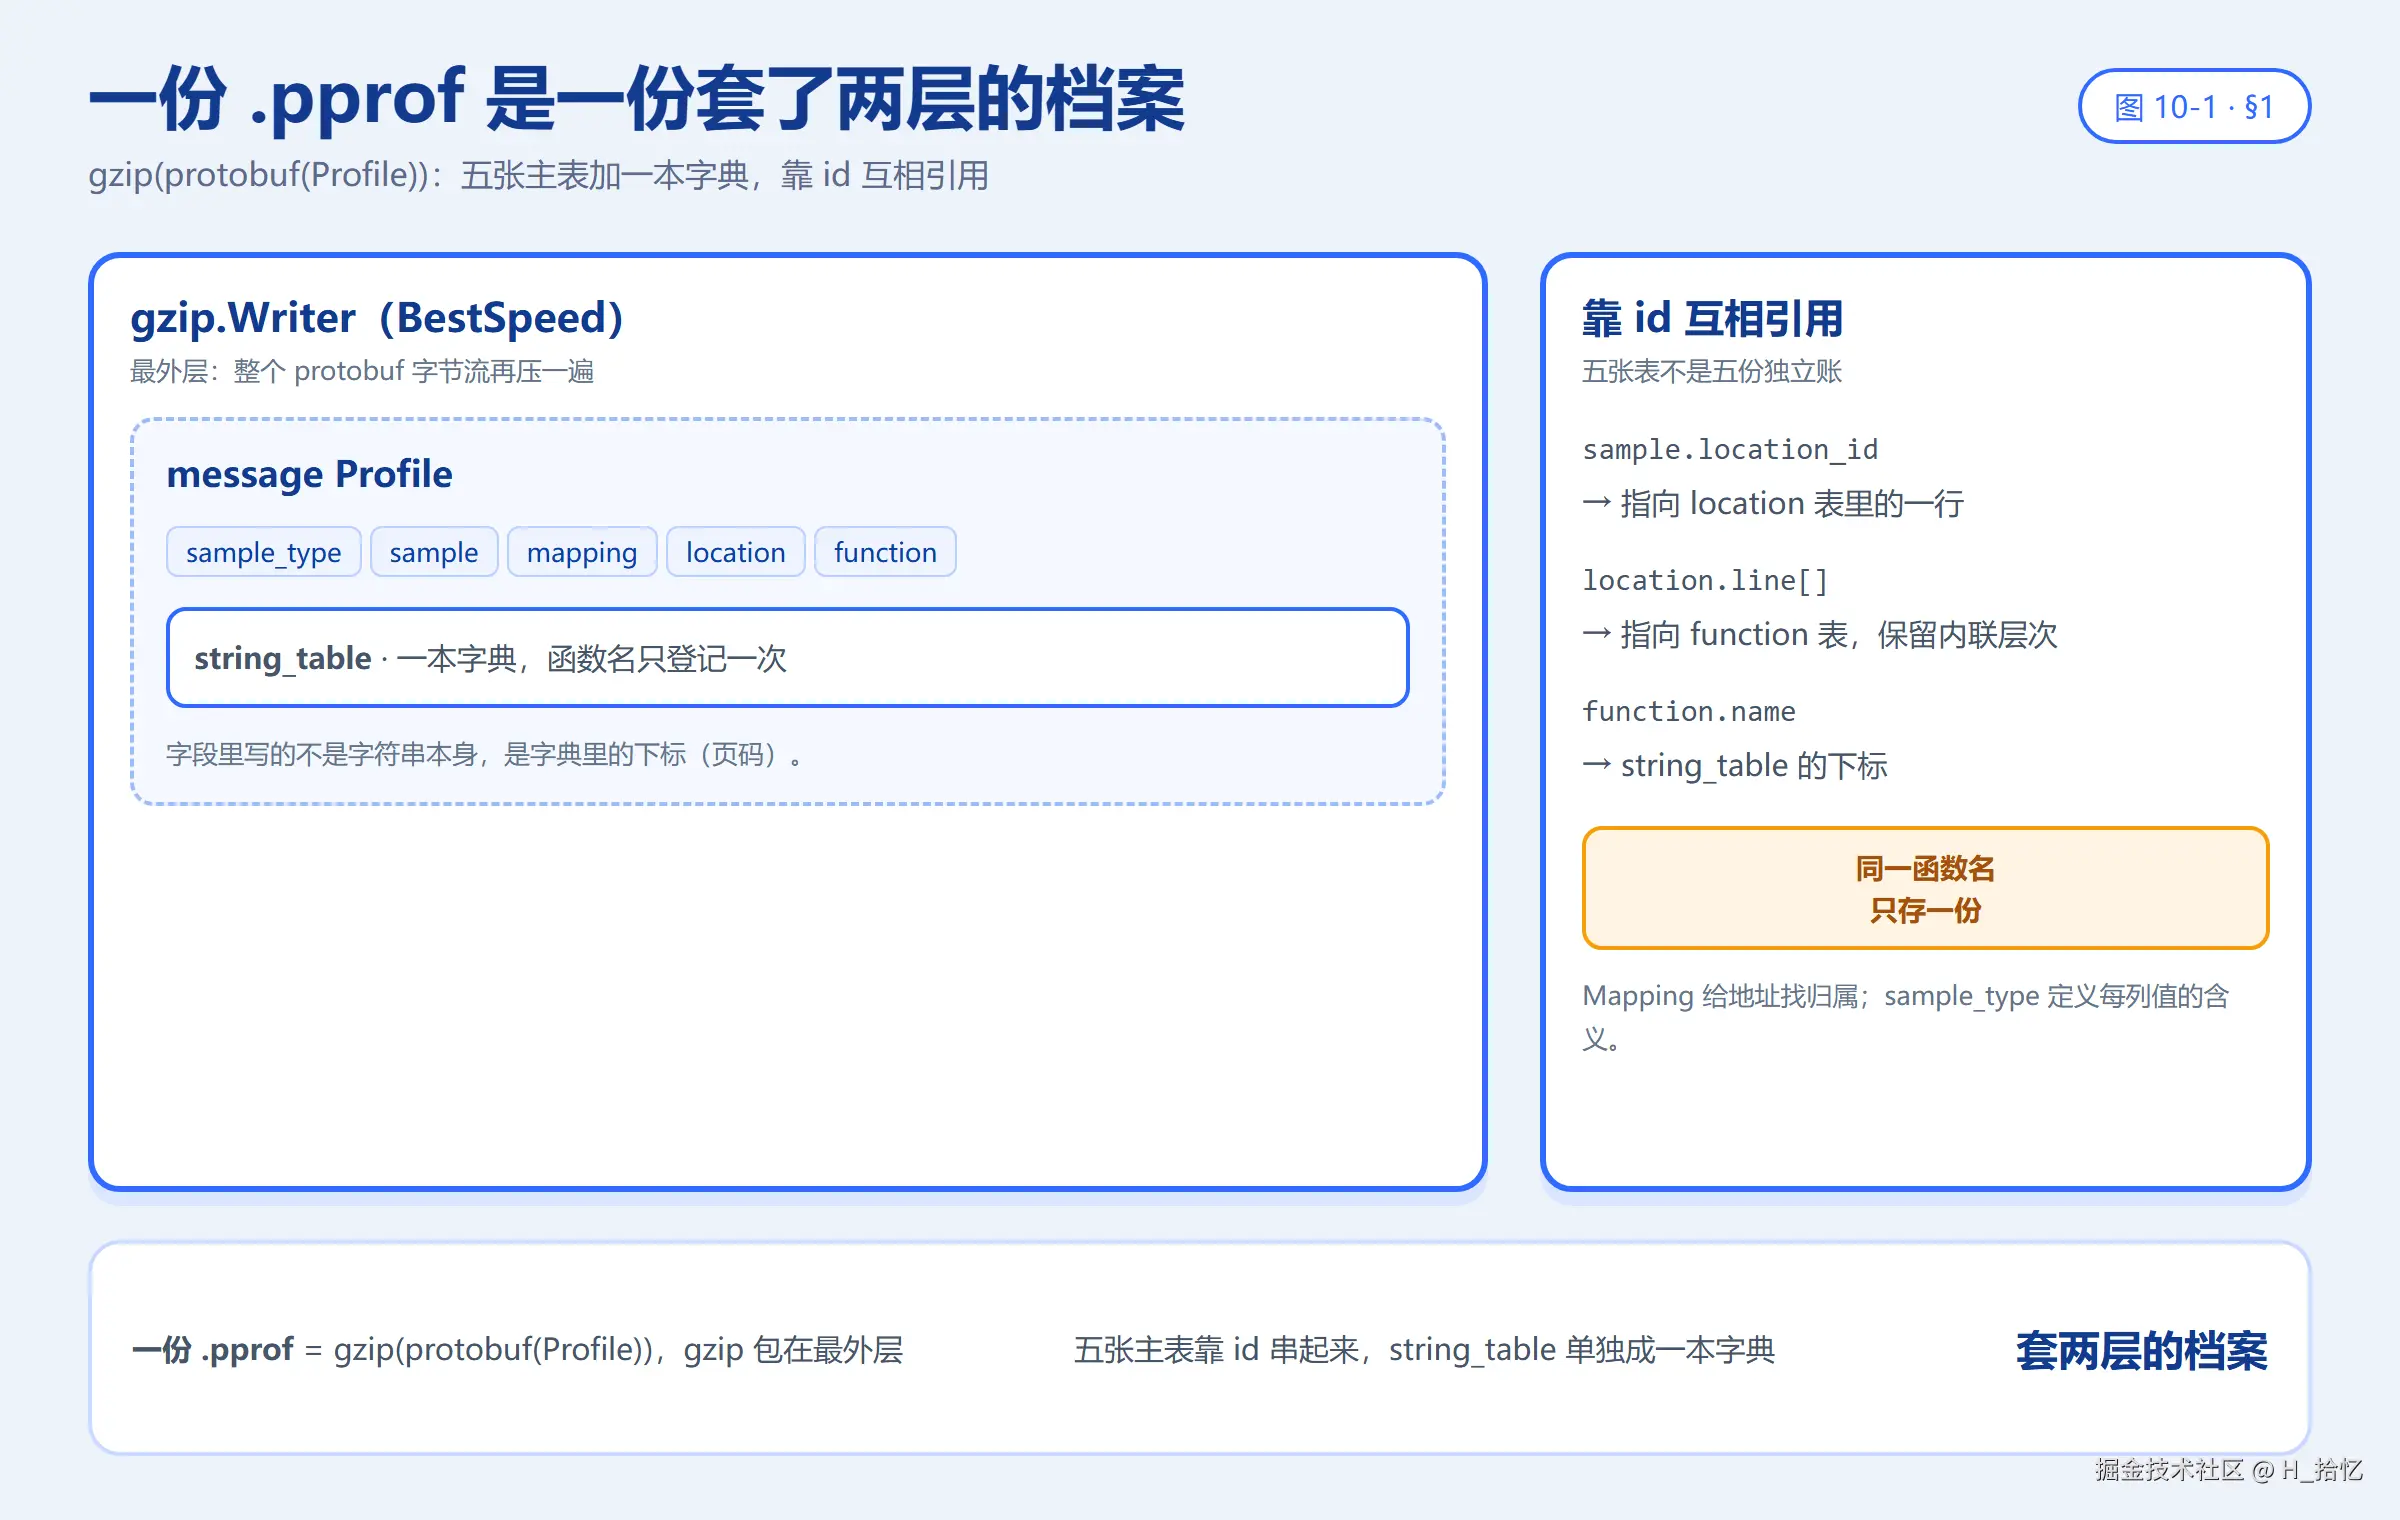
图 10-1 Profile 消息结构与 gzip 封包:一份 .pprof = gzip(protobuf(Profile)),五张主表加一本 string_table 字典,函数名只登记一次、字段里存页码索引。
看图时抓三处:五张主表里 sample / location / function 怎么靠 id 互相引用、string_table 为什么单独成表、gzip 为什么包在最外层;对应 §1.2、§5 与难点 A / B。
三个设计要点,后面每一节几乎都在给它们打地基:
- 字符串全走 string_table------重复的函数名 / 文件名只存一份,字段只存 int 索引(varint 压缩后极小);
- Location.line 是列表 ------一串「函数 + 行号」表示一条内联链(a 被 b 内联,一个 Location 表达多层调用);
- sample.location_id 引用 location 表------同一栈的样本在 sample 里只出现一次(生产端已去重),pprof 工具按 id 组装火焰图。
1.3 profileBuilder:抄账员身上挂了什么
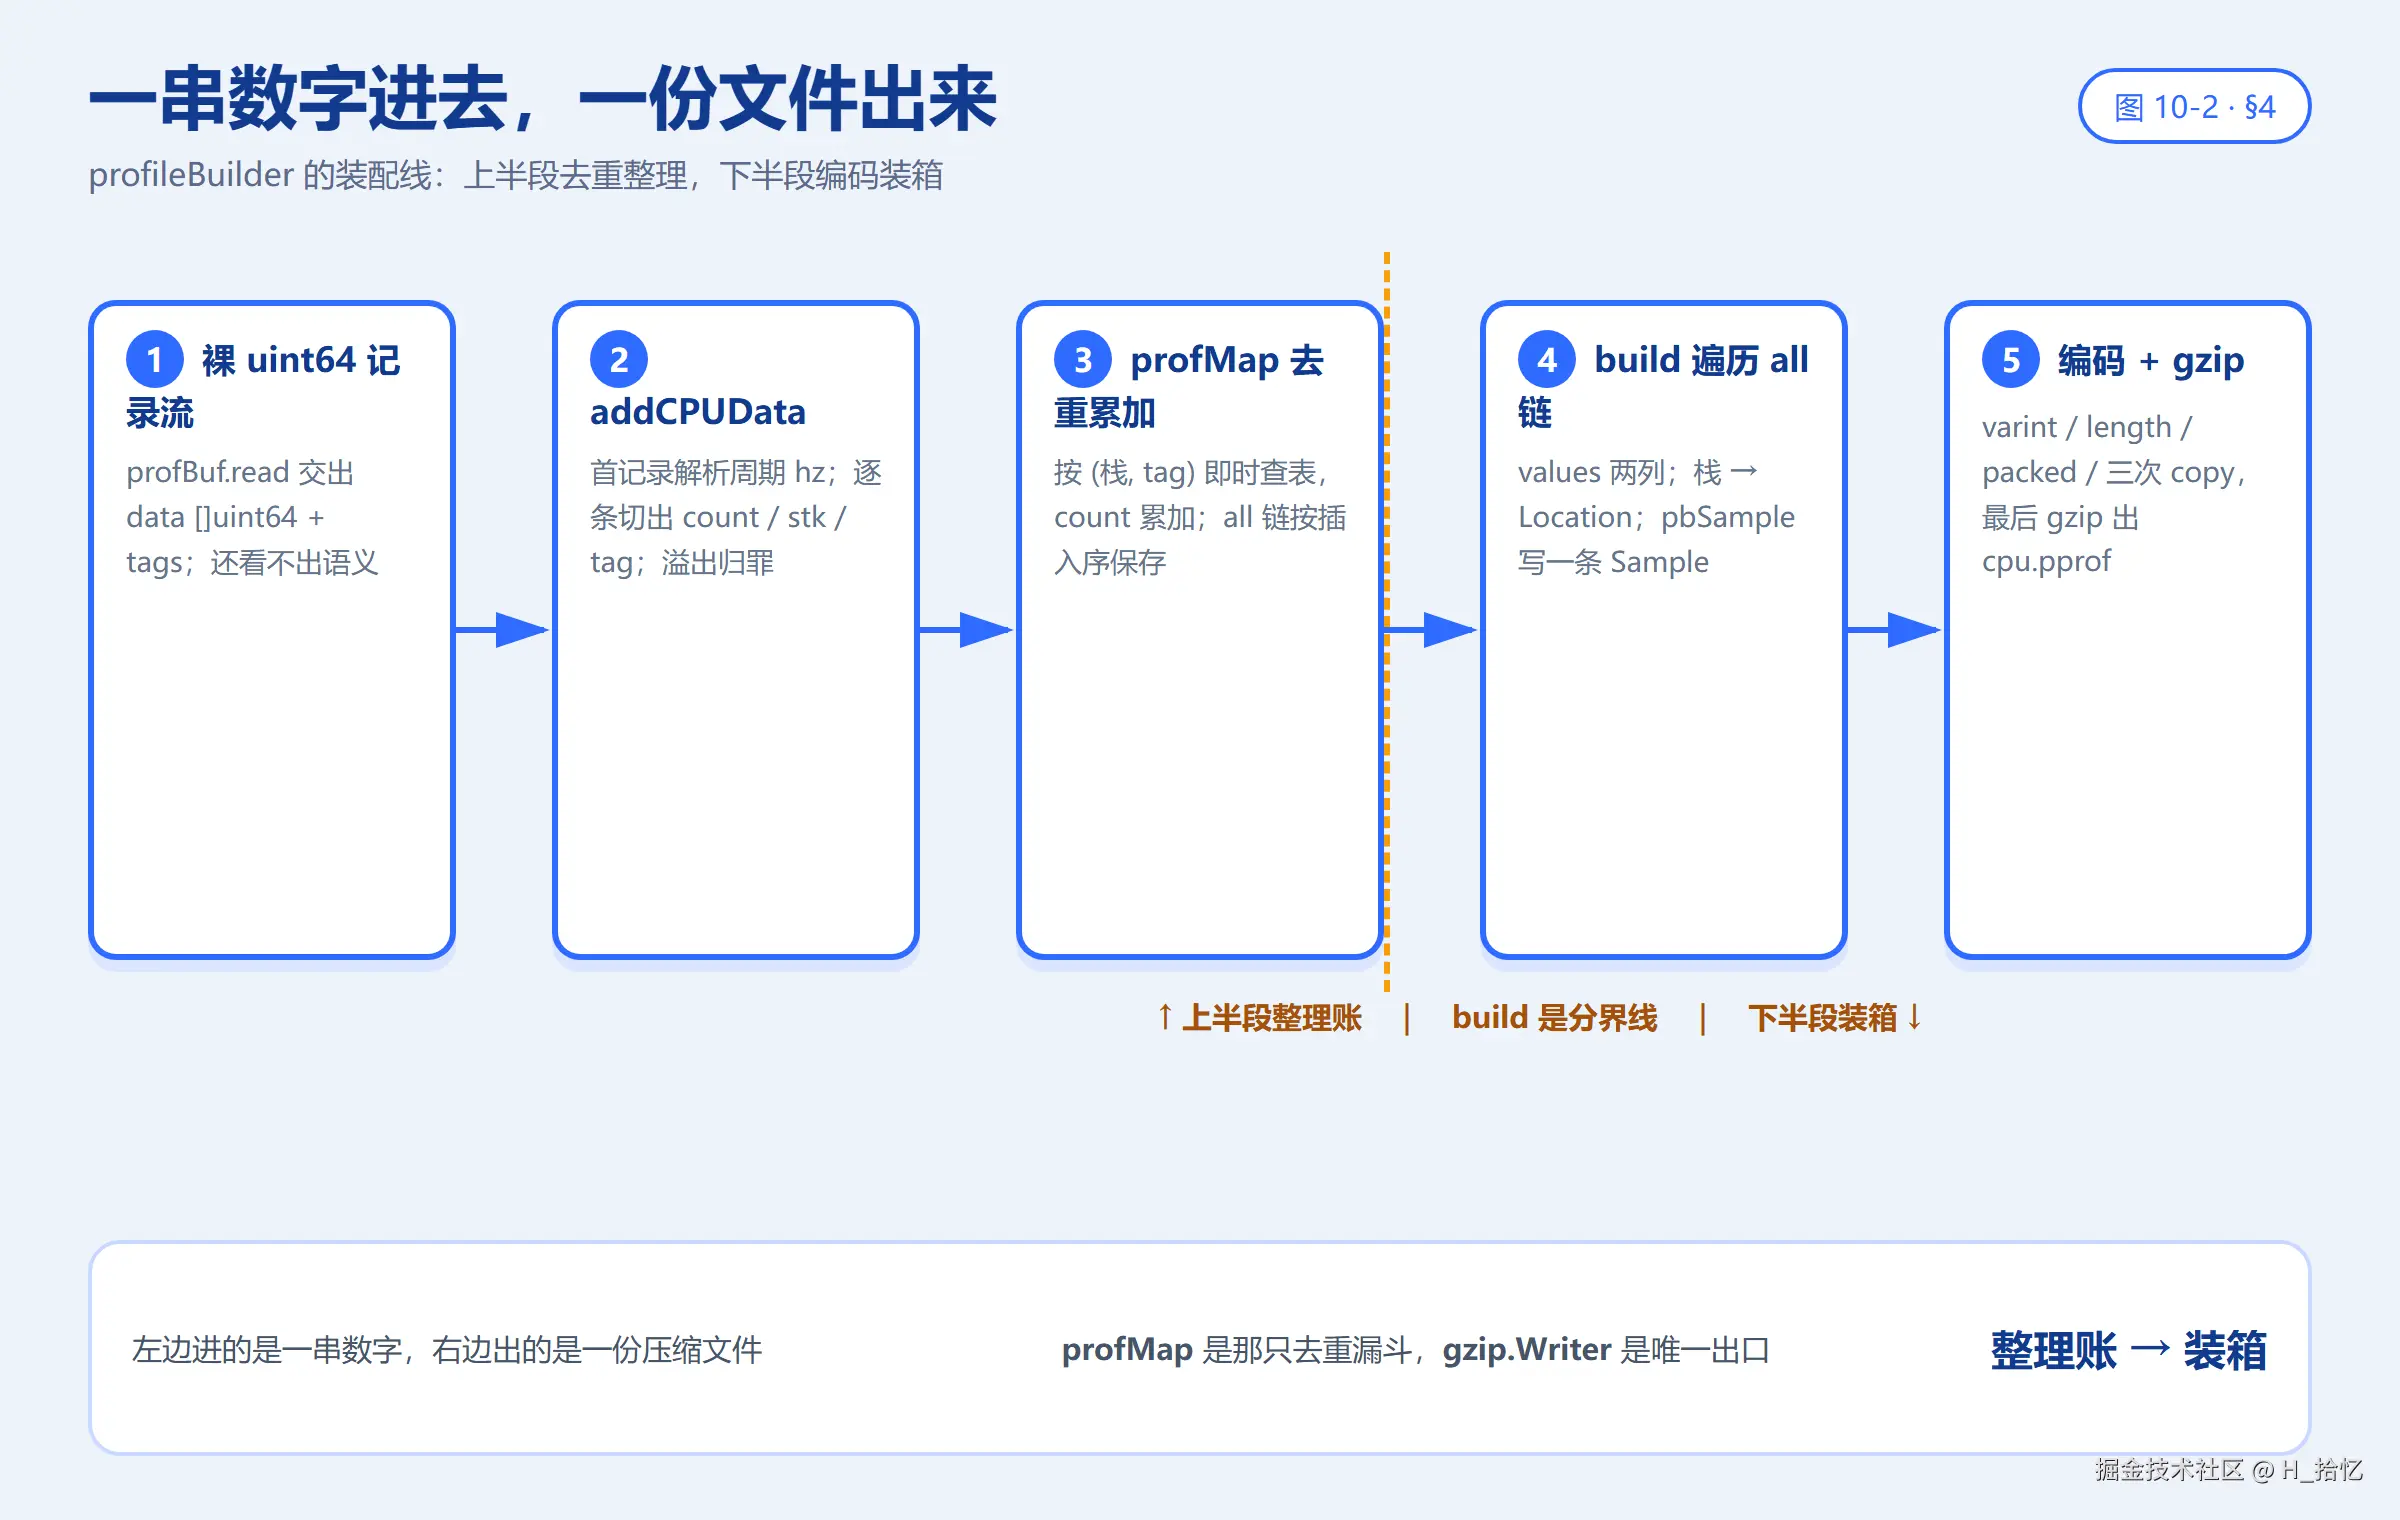
图 10-2 builder 攒文件流程:解析记录流 → profMap 按 (栈, tag) 去重累加 → build 遍历 → 栈转 Location → 手工编码 + gzip,前一半整理账、后一半装箱。
看图时抓三处:左边进的是裸 uint64 记录流、中间 profMap 是那只去重漏斗、右边 gzip.Writer 是唯一的出口;对应 §1.3、§4 与难点 A / B。
先看一个陪衬用的伪函数,再抄结构本身:
go
// lostProfileEvent is the function to which lost profiling
// events are attributed.
// (The name shows up in the pprof graphs.)
func lostProfileEvent() { lostProfileEvent() }   // ← 23:伪函数------溢出丢样本记在它名下
                                                  //     (自递归防编译器内联掉;pprof 图里能看到它)
                                                  // ← 24
// A profileBuilder writes a profile incrementally from a
// stream of profile samples delivered by the runtime.
type profileBuilder struct {
	start      time.Time              // ← 28:构建开始(→ time_nanos)
	end        time.Time              // ← 29:结束(→ duration_nanos)
	havePeriod bool                   // ← 30:是否已从数据头解析出周期(CPU 专属)
	period     int64                  // ← 31:采样周期(纳秒)
	m          profMap                // ← 32:样本去重表(map.go,见 §9)
	                                                  // ← 33
	// encoding state
	w         io.Writer              // ← 35:最终输出
	zw        *gzip.Writer           // ← 36:gzip 层
	pb        protobuf               // ← 37:字节缓冲(见 §10)
	strings   []string               // ← 38:string_table 累积
	stringMap map[string]int         // ← 39:字符串 → 索引
	locs      map[uintptr]locInfo    // ← 40:PC → Location 信息缓存(命中免符号化)
	funcs     map[string]int         // ← 41:函数全名 → Function.ID
	mem       []memMap               // ← 42:mapping 表
	deck      pcDeck                 // ← 43:内联折叠状态机(见 §6)
}                                               // ← 44
把这 16 个字段翻成「行李清单」,就是抄账员随身带的全部家当:
| 字段 | 通俗解释:装的是什么 |
|---|---|
start / end |
开工 / 收工时间,分别写进 time_nanos / duration_nanos |
havePeriod / period |
CPU 剖析专属:有没有解析出周期、周期多少纳秒 |
m |
样本去重表,§9 的主角 |
w |
最终输出目的地(文件 / HTTP 响应) |
zw |
gzip 压缩层,字节先过它 |
pb |
未压缩的字节缓冲,§10 的主角 |
strings / stringMap |
字符串字典与「名字 → 页码」反查表 |
locs |
PC → Location 缓存,命中免符号化 |
funcs |
函数全名 → Function.ID |
mem |
模块表,Location 要指明自己属于哪个模块 |
deck |
内联折叠状态机,一次只装一个 Location 的料 |
再往下是模块条目与符号化标记:
go
type memMap struct {                     // ← 46:一个内存映射条目
	// initialized as reading mapping
	start   uintptr   // ← 48:模块加载起始地址
	end     uintptr   // ← 49:结束地址
	offset  uint64    // ← 50:文件内偏移
	file    string    // ← 51:文件路径
	buildID string    // ← 52:构建指纹(pprof 据此配对符号服务器)
	                                                   // ← 53
	funcs symbolizeFlag  // ← 54:该 mapping 的符号化结果
	fake  bool           // ← 55:true=伪造的映射(/proc/self/maps 不可用时兜底)
}                                                       // ← 56
                                                        // ← 58~62:symbolizeFlag 注释------0/试过/试过失败
type symbolizeFlag uint8                                // ← 63
                                                        // ← 64
const (                                                 // ← 65
	lookupTried  symbolizeFlag = 1 << iota              // ← 66:1
	lookupFailed symbolizeFlag = 1 << iota              // ← 67:2
)                                                       // ← 68
这里有三张「只增不减」的表值得先记一笔,后面会反复用到:
| 表 | 键 → 值 | 谁往里写 | 为什么敢只增不减 |
|---|---|---|---|
strings + stringMap |
名字 → 页码 | stringIndex |
剖析时长有限,字典不会无限大 |
locs |
PC → locInfo |
emitLocation |
见过的地址缓存起来,下次直接命中 |
m(profMap) |
(栈, tag) → profMapEntry |
addCPUData |
只增不减,剖析时长有限,可接受 |
1.4 tag 常量表:把 schema 手抄成 Go
70~129 行是 proto 字段号常量表------与 pprof 格式约定的字段号一一对应,逐块列出(注释列即 proto 字段类型):
| 块 | 行号 | 字段(号 → 含义) |
|---|---|---|
| Profile | 72~85 | SampleType=1, Sample=2, Mapping=3, Location=4, Function=5, StringTable=6, DropFrames=7, KeepFrames=8, TimeNanos=9, DurationNanos=10, PeriodType=11, Period=12, Comment=13, DefaultSampleType=14 |
| ValueType | 88~89 | Type=1, Unit=2(都是 string_table 索引) |
| Sample | 92~94 | Location=1(repeated uint64), Value=2(repeated int64), Label=3 |
| Label | 97~99 | Key=1, Str=2, Num=3 |
| Mapping | 102~111 | ID=1, Start=2, Limit=3, Offset=4, Filename=5, BuildID=6, HasFunctions=7, HasFilenames=8, HasLineNumbers=9, HasInlineFrames=10 |
| Location | 114~117 | ID=1, MappingID=2, Address=3, Line=4 |
| Line | 120~121 | FunctionID=1, Line=2 |
| Function | 124~128 | ID=1, Name=2, SystemName=3, Filename=4, StartLine=5 |
不用背,只要知道它长这样:tagProfile_SampleType=1、tagSample_Location=1、tagLocation_Line=4、tagFunction_StartLine=5 这些常量,就是 proto schema 里写死的字段号,后面会被左移 3 位塞进每一个字节 key 里(§10、难点 I)。
手写字段号而不是用 .pb.go 生成代码------因为 runtime/pprof 不能依赖 protoc 生态,而且这个 encoder 只需要「写」一个方向。
1.5 难点 A|函数名只存一份,字段里为什么写的是页码
在纠结什么 :pbValueType、pbMapping、emitLocation 里到处是 b.stringIndex(...),为什么不直接把字符串写进字段?
通俗地说 :把它想成一本档案字典 。一个跑了几秒的程序,调用栈里 main.worker 可能出现几万次。要是每次都把这几个字母写进文件,既浪费字节,又让 pprof 工具没法按「同一个函数」聚合。做法是:所有字符串先登记进 strings 这张表,拿到一个页码(整数);后面所有字段只写页码。
stringIndex 就是这个登记员,逻辑只有三行(§2 的 130~141 行):
| 情况 | 动作 |
|---|---|
stringMap[s] 查到了 |
直接返回那个页码 |
| 没查到 | id = len(b.strings) → append 进表 → 记进 stringMap → 返回 |
newProfileBuilder 里 strings: []string{""}、stringMap: map[string]int{"": 0} 不是多余:proto 惯例要求 0 号恒为空串 ,所以字典从第 1 页才开始放真名字。还有个连锁好处:页码是整数,走 varint 编码后通常只占 1~2 字节;而字符串本身几十字节。int64Opt 遇到 0 号(空串)干脆整个字段都不写。
最小例子 :假设字典是 ["", "samples", "count", "main.worker"]。写两列 ValueType 时,"samples" 返回 1、"count" 返回 2;后面再遇到 "main.worker",返回 3。整个文件里 main.worker 这十个字母只出现在最后那张字典表里一次。
一句话记住 :字典登记一次、全场只写页码;string_table 就是这份档案的「名词表」。
对应源码行 :§1.2 三个设计要点里的第 1 条「字符串全走 string_table」;§2 的 id = len(b.strings) 那一行。
1.6 难点 B|手写 protobuf 编码为什么不直接用现成的库
在纠结什么 :Go 生态有现成的 protobuf 库和 protoc 生成的 .pb.go,为什么 proto.go 偏要自己手写编码器、连字段号都抄成常量?
通俗地说:三个理由,一个比一个实际:
| 理由 | 通俗解释 |
|---|---|
| 依赖方向 | runtime/pprof 是标准库最里层之一,不能反过来依赖 protoc 生成链 / 带 reflect 的运行时;§1.4 末尾那句注释直说「不能依赖 protoc 生态」 |
| 只需要「写」 | 生产端只负责把字节写出去,解析是 go tool pprof 的事;一个方向的活儿,没必要背整套生成代码 |
| 开销 | 生成代码带初始化、reflect、描述符,对一个「每 100ms 被叫醒一次」的后台泵来说都是白付的成本 |
所以这个编码器小得离谱:protobuf 结构只有 data []byte、tmp [16]byte、nest int 三个字段;能力也砍到只剩「写 varint / 写长度定界 / 写字符串 / 写 bool / 嵌套消息」,连「读」都没有(§10)。
最小例子(示意,不能直接编译;真实定义见 §10):
go
type protobuf struct {
	data []byte
	tmp  [16]byte
	nest int
}
三个字段就撑起了整份文件的字节产出,没有 descriptor、没有 message 结构体、没有反射。
一句话记住 :不是造轮子,是环境只准带一把螺丝刀------只写、只依赖最底层、只付必要开销。
对应源码行:§1.4 结尾「手写字段号而不是用 .pb.go 生成代码」那句注释;§10 开头「protoc 生成的代码要带 reflect/初始化开销,这里手写一个只写的最小实现」。
2 编码小工具:stringIndex / flush / pb*(131~207 行)
2.1 先建画面:登记员与装箱工
这一节是抄账员手边最常用的一组小工具,可以想成两个人加一套固定动作:
- 登记员
stringIndex:手上抱着strings字典和stringMap反查表,谁报一个名字,他查一下,有就回页码,没有就追加一页再回页码。 - 装箱工
flush:面前是pb这个未压缩的字节筐,攒到 4KB 就往gzip.Writer里倒一批;但他有个死规矩------只在一件货完整封好之后才倒,绝不在半件货的中间下刀。 pb*四个封装:是四种货(列定义、样本、标签、行、模块)各自的「三明治」打包法:起一个口、填字段、封口。
2.2 源码逐行:stringIndex 与 flush
go
// stringIndex adds s to the string table if not already present
// and returns the index of s in the string table.
func (b *profileBuilder) stringIndex(s string) int64 {
	id, ok := b.stringMap[s]        // ← 134:查表
	if !ok {                        // ← 135:新字符串
		id = len(b.strings)     // ← 136:索引 = 当前表长
		b.strings = append(b.strings, s)  // ← 137:入表
		b.stringMap[s] = id     // ← 138:反查表
	}                                // ← 139
	return int64(id)                 // ← 140
}                                    // ← 141
                                     // ← 142
func (b *profileBuilder) flush() {   // ← 143:增量下刷------防止 pb 无限膨胀
	const dataFlush = 4096       // ← 144:阈值 4KB
	if b.pb.nest == 0 && len(b.pb.data) > dataFlush {  // ← 145:nest=0 保证不在消息中间切断!
		b.zw.Write(b.pb.data)    // ← 146:写进 gzip(消息边界对齐的字节流,gzip 可流式)
		b.pb.data = b.pb.data[:0]  // ← 147:复用底层数组
	}                                // ← 148
}                                    // ← 149
flush 里那个 b.pb.nest == 0 看着像多余的保险,其实是整份文件不被写坏的闸门------难点 C 专门拆它。dataFlush = 4096 与 b.pb.data = b.pb.data[:0] 是一对:前者定阈值,后者复用底层数组,避免每次刷盘都重新分配。
2.3 源码逐行:四个 pb* 三明治
四个 pb* 封装(151~207 行)都是「startMessage → 字段 → endMessage」三明治,逐行:
go
// pbValueType encodes a ValueType message to b.pb.
func (b *profileBuilder) pbValueType(tag int, typ, unit string) {
	start := b.pb.startMessage()                          // ← 153:记长度前缀占位点
	b.pb.int64(tagValueType_Type, b.stringIndex(typ))     // ← 154:type 字段(字符串索引)
	b.pb.int64(tagValueType_Unit, b.stringIndex(unit))    // ← 155:unit 同上
	b.pb.endMessage(tag, start)                           // ← 156:回填长度前缀,挂到 tag 下
}                                                         // ← 157
                                                          // ← 159
// pbSample encodes a Sample message to b.pb.
func (b *profileBuilder) pbSample(values []int64, locs []uint64, labels func()) {
	start := b.pb.startMessage()                      // ← 161
	b.pb.int64s(tagSample_Value, values)              // ← 162:值列表(packed 编码)
	b.pb.uint64s(tagSample_Location, locs)            // ← 163:location id 列表(叶→根)
	if labels != nil {                                // ← 164:labels 延迟回调(用到时才编)
		labels()                                  // ← 165
	}                                                 // ← 166
	b.pb.endMessage(tagProfile_Sample, start)         // ← 167
	b.flush()                                         // ← 168:每样本刷一次(样本量大)
}                                                     // ← 169
                                                      // ← 171
// pbLabel encodes a Label message to b.pb.
func (b *profileBuilder) pbLabel(tag int, key, str string, num int64) {
	start := b.pb.startMessage()                  // ← 173
	b.pb.int64Opt(tagLabel_Key, b.stringIndex(key))   // ← 174:Opt=零值省略
	b.pb.int64Opt(tagLabel_Str, b.stringIndex(str))  // ← 175:字符串 label
	b.pb.int64Opt(tagLabel_Num, num)                 // ← 176:数值 label(heap 的 "bytes")
	b.pb.endMessage(tag, start)                      // ← 177
}                                                     // ← 178
                                                      // ← 180
// pbLine encodes a Line message to b.pb.
func (b *profileBuilder) pbLine(tag int, funcID uint64, line int64) {  // ← 181
	start := b.pb.startMessage()                    // ← 182
	b.pb.uint64Opt(tagLine_FunctionID, funcID)      // ← 183
	b.pb.int64Opt(tagLine_Line, line)               // ← 184
	b.pb.endMessage(tag, start)                     // ← 185
}                                                   // ← 186
                                                    // ← 188
// pbMapping encodes a Mapping message to b.pb.
func (b *profileBuilder) pbMapping(tag int, id, base, limit, offset uint64, file, buildID string, hasFuncs bool) {
	start := b.pb.startMessage()                        // ← 190
	b.pb.uint64Opt(tagMapping_ID, id)                   // ← 191
	b.pb.uint64Opt(tagMapping_Start, base)              // ← 192
	b.pb.uint64Opt(tagMapping_Limit, limit)             // ← 193
	b.pb.uint64Opt(tagMapping_Offset, offset)           // ← 194
	b.pb.int64Opt(tagMapping_Filename, b.stringIndex(file))    // ← 195
	b.pb.int64Opt(tagMapping_BuildID, b.stringIndex(buildID))  // ← 196
	// TODO: we set HasFunctions if all symbols from samples were symbolized ...(197~202:TODO------
	//     HasInlineFrames/HasLineNumbers 尚未区分设置)
	if hasFuncs {                                       // ← 203
		b.pb.bool(tagMapping_HasFunctions, true)    // ← 204:告诉 pprof"这份 mapping 自带符号"
	}                                                   // ← 205
	b.pb.endMessage(tag, start)                         // ← 206
}                                                       // ← 207
四个封装里藏着三处值得停一下的设计:
pbValueType的b.stringIndex(typ)说明列定义的「列名 / 单位」也是字典里的页码,不是裸字符串;pbSample的labels func()是延迟回调 ------标签用到时才编,且它和b.flush()一起保证了「一条样本写完就刷一次」;pbMapping里那段 TODO 老实承认HasInlineFrames/HasLineNumbers还没细分设置,只按hasFuncs写了HasFunctions。
startMessage / endMessage 的实体在 §10,这里先记住它们是一对:startMessage() 记下内容起点,endMessage(tag, start) 回填长度前缀并挂到 tag 下。
2.4 难点 C|缓冲刷盘为什么非要等 nest == 0
在纠结什么 :flush 的条件是 b.pb.nest == 0 && len(b.pb.data) > dataFlush,那个 nest 看着像多余的保险。
通俗地说 :dataFlush = 4096,意思很直白------字节缓冲攒到 4KB 就往 gzip 里灌一批,别让它无限膨胀。但灌的时机有讲究 :gzip 是流式的,字节可以分批写,可 protobuf 的一个消息不能被劈成两半。
nest 就是「现在套在第几层消息里」。startMessage() 进去时 nest++,endMessage() 出来时 nest--(§10)。只要 nest != 0,说明某个 Sample / Location / Function 正写到一半,前缀还没回填,这时候把 data 切走,等于把半句话发给了对方。
所以规矩是:只在「消息边界对齐」的地方刷盘 。pbSample 每写完一条样本就 flush() 一次,正是因为它刚 endMessage 出来,nest 回到 0;而 emitLocation 结尾也有一次 flush()(§7)。
违反了会怎样 :b.pb.data = b.pb.data[:0] 会复用底层数组,半截消息被送进 gzip 后,后续 endMessage 的三次 copy 会在一个已经被清空的缓冲上算 n1/n2/n3,字节彻底错乱------pprof 工具解析时直接报坏文件。
最小例子 :把 if b.pb.nest == 0 改成无条件刷,然后在 pbSample 的 endMessage 之前刚好攒够 4KB,就会把「Sample 内容已写、key+len 还没回填」的字节送出去。
一句话记住 :缓冲可以分批刷,消息不能半截刷 ;nest 就是那道「现在能不能切」的闸门。
对应源码行 :§2.2 的 142 行那个条件;§10 的 startMessage 里 b.nest++ 与 endMessage 里 b.nest--。
3 allFrames 与 locInfo:把 PC 翻成函数、并缓存下来(209~272 行)
3.1 先建画面:一台单地址翻译器
栈里是一串 PC 地址,pprof 文件里要的是「函数 + 文件 + 行号」。中间需要一台翻译器,而 allFrames 就是这台机器------但要特别注意:它一次只翻译一个地址,不是把整条栈丢进去。
为什么不整栈翻译?因为缓存的粒度是「地址」而不是「栈」:同一个 PC 会在成千上万条栈里反复出现,按地址缓存,第二次起就不用再问 runtime 了。locInfo 就是这台翻译器的缓存条目:记下这个 PC 定稿成了哪个 Location ID、覆盖了哪几个连续 PC、叶 PC 展开成了哪些 frame。
newProfileBuilder 则是一次性把抄账员的行李备齐:gzip 层、字典第 0 页的空串、三张空表,以及立刻去读一张「模块地图」。
3.2 源码逐行:allFrames
go
func allFrames(addr uintptr) ([]runtime.Frame, symbolizeFlag) {
	// Expand this one address using CallersFrames so we can cache
	// each expansion. ...(209~213:单地址展开------按地址缓存,别整栈展开)
	frames := runtime.CallersFrames([]uintptr{addr})  // ← 214:单元素切片!
	frame, more := frames.Next()                      // ← 215
	if frame.Function == "runtime.goexit" {
		// Short-circuit if we see runtime.goexit ...(216~218:goexit 无信息------直接空)
		return nil, 0                                 // ← 219
	}                                                  // ← 220
	                                                   // ← 221
	symbolizeResult := lookupTried                     // ← 222:默认"试过"
	if frame.PC == 0 || frame.Function == "" || frame.File == "" || frame.Line == 0 {
		symbolizeResult |= lookupFailed                // ← 224:任一字段缺失 → 失败位
	}                                                  // ← 225
	                                                   // ← 226
	if frame.PC == 0 {
		// If we failed to resolve the frame, at least make up
		// a reasonable call PC. This mostly happens in tests.
		frame.PC = addr - 1                            // ← 230:造个合理的 call PC(addr-1)
	}                                                  // ← 231
	ret := []runtime.Frame{frame}                      // ← 232
	for frame.Function != "runtime.goexit" && more {   // ← 233:一个 addr 可能展开出多个 frame(内联链)!
		frame, more = frames.Next()                    // ← 234
		ret = append(ret, frame)                       // ← 235
	}                                                  // ← 236
	return ret, symbolizeResult                        // ← 237
}                                                      // ← 238
三处最要紧:
runtime.CallersFrames([]uintptr{addr})传的是单元素切片,这正是「按地址缓存」的落点;frame.PC = addr - 1是在符号化失败时造一个合理的 call PC(主要发生在测试里),不至于让整个 Location 缺地址;for frame.Function != "runtime.goexit" && more这个循环说明一个 addr 可能展开出多个 frame ------这就是内联链,也是 §6pcDeck要处理的原料。
symbolizeResult 默认置 lookupTried,只要 PC / 函数 / 文件 / 行号任一缺失就或上 lookupFailed。这个标记会一路传到 emitLocation,最后决定 mapping 能不能声明「自带符号」(§7、§8)。
3.3 源码逐行:locInfo 与 newProfileBuilder
go
type locInfo struct {                     // ← 240:PC → Location 缓存条目
	// location id assigned by the profileBuilder
	id uint64                            // ← 242:已分配的 Location ID
	                                       // ← 244~246:pcs 注释------含 traceback 返回的内联伪 PC
	pcs []uintptr                         // ← 247:这个 Location 覆盖的连续 PC 段(栈匹配用)
	                                       // ← 249~251:firstPC* 注释
	firstPCFrames          []runtime.Frame  // ← 252:叶 PC 的展开结果(缓存)
	firstPCSymbolizeResult symbolizeFlag    // ← 253:其符号化结果
}                                          // ← 254
                                           // ← 255~258:构造器文档
func newProfileBuilder(w io.Writer) *profileBuilder {
	zw, _ := gzip.NewWriterLevel(w, gzip.BestSpeed)  // ← 260:★BestSpeed------压缩率换 CPU(剖析数据要快)
	b := &profileBuilder{
		w:         w,                              // ← 262
		zw:        zw,                             // ← 263
		start:     time.Now(),                     // ← 264:起始时间
		strings:   []string{""},                   // ← 265:string_table[0] 恒为空串(proto 惯例)
		stringMap: map[string]int{"": 0},           // ← 266
		locs:      map[uintptr]locInfo{},           // ← 267
		funcs:     map[string]int{},                // ← 268
	}                                              // ← 269
	b.readMapping()                                // ← 270:立刻读 /proc/self/maps(或平台等价)
	return b                                       // ← 271
}                                                  // ← 272
locInfo 里 pcs 那句「覆盖的连续 PC 段」先记牢:§6 的 appendLocsForStack 命中缓存时,会用 stk = stk[len(l.pcs):] 把整段一次性跳过。firstPCFrames / firstPCSymbolizeResult 则是「叶 PC 的展开结果」,缓存命中时直接喂给 deck 复用,省一次符号化。
3.4 本节拆解:两处容易被忽略的设计
为什么 gzip 用 BestSpeed 而不是默认级别? 剖析数据是在程序运行时后台写出的,每 100ms 被叫醒一次,压缩率换 CPU 是划算的:文件大一点无所谓,别拖慢被剖析的程序。这一行是 §1.3 那个「环境限制」表的直接落地。
为什么strings初始就要放一个空串? proto 惯例要求string_table[0]恒为空串,字典从第 1 页开始放真名字;对应地stringMap也预置了"": 0。这条不变量列在 §12 第 2 条,违反它工具解析会错位。
readMapping()为什么在构造器里就调? 因为模块表是全局背景信息,与具体样本无关,开工时一次读好即可;三种平台怎么读、读不到怎么兜底,是 §8 与难点 G 的内容。
本节没有独立编号的难点,但它给后面三处埋了线:allFrames 展开出的多个 frame 是难点 E(§6)的原料,locInfo 里那些切片为什么要拷贝是难点 F(§7)的关键,symbolizeResult 怎么汇总到 mapping 是难点 G(§8)的伏笔。
4 addCPUData:把 runtime 记录流切回语义(274~345 行)
4.1 先建画面:拆一个不透明的包裹
上游交来的 data 是 [3+n]uint64 记录流,tags 与之平行------一条记录配一个标签指针。这里就是消费端。
addCPUData 干的活像拆包裹:包裹上没有字段名、没有括号、没有逗号,只有一格一格的约定。第一格说「我这条一共占几格」,第二格是时间戳(明确忽略),第三格是这条记录代表几个样本,后面是一摞 PC。校验完,游标按第一格直接跳到下一条,不需要任何分隔符。整个函数只做两件事:把数字切回语义 ,然后交给去重表累加。
4.2 源码逐行:addCPUData
go
// addCPUData adds the CPU profiling data to the profile. ...(275~277:
//     契约------data 必须是整条记录;len(tags)==记录数)
func (b *profileBuilder) addCPUData(data []uint64, tags []unsafe.Pointer) error {
	if !b.havePeriod {
		// first record is period                       // ← 279:首条记录是元数据
		if len(data) < 3 {
			return fmt.Errorf("truncated profile")  // ← 282:连头都凑不齐
		}                                            // ← 283
		if data[0] != 3 || data[2] == 0 {            // ← 284:长度≠3 或 hz=0
			return fmt.Errorf("malformed profile")  // ← 285
		}                                            // ← 286
		// data[2] is sampling rate in Hz. Convert to sampling
		// period in nanoseconds.
		b.period = 1e9 / int64(data[2])              // ← 289:100Hz → 10,000,000ns(采集器写入的 hz 元记录!)
		b.havePeriod = true                          // ← 290
		data = data[3:]                              // ← 291:消费掉头记录
		// Consume tag slot. Note that there isn't a meaningful tag
		// value for this record.
		tags = tags[1:]                              // ← 294:tag 同步消费
	}                                                    // ← 295
	                                                     // ← 296~311:大注释------记录格式与溢出约定:
	//   data[0]=3+n, data[1]=时间戳(忽略), data[2]=count, data[3:]=栈
	//   count==0 且栈长 1 → 溢出记录(栈[0]=丢失样本数)
	//   同栈样本多 → 立即用 b.m(profMap)去重
	for len(data) > 0 {                                 // ← 312:主循环
		if len(data) < 3 || data[0] > uint64(len(data)) {  // ← 313:声称长度超出剩余
			return fmt.Errorf("truncated profile")  // ← 314
		}                                                // ← 315
		if data[0] < 3 || tags != nil && len(tags) < 1 {  // ← 316
			return fmt.Errorf("malformed profile")       // ← 317
		}                                                 // ← 318
		if len(tags) < 1 {                                // ← 319
			return fmt.Errorf("mismatched profile records and tags")  // ← 320
		}                                                 // ← 321
		count := data[2]                                  // ← 322:本记录的样本数
		stk := data[3:data[0]]                            // ← 323:栈切片
		data = data[data[0]:]                             // ← 324:游标前进
		tag := tags[0]                                    // ← 325:对应 tag
		tags = tags[1:]                                   // ← 326
	                                                      // ← 327
		if count == 0 && len(stk) == 1 {                  // ← 328:溢出记录(缓冲写满时合成的丢件补报)
			// overflow record
			count = uint64(stk[0])                    // ← 330:栈[0] 是丢失数
			stk = []uint64{                           // ← 331:伪栈------归罪 lostProfileEvent
				// gentraceback guarantees that PCs in the
				// stack can be unconditionally decremented and
				// still be valid, so we must do the same.
				uint64(abi.FuncPCABIInternal(lostProfileEvent) + 1),  // ← 335:+1 保持 return-PC 语义
			}                                         // ← 336
		}                                                 // ← 337
		b.m.lookup(stk, tag).count += int64(count)        // ← 338:★去重累加(profMap,见 §9)
	}                                                     // ← 339
	                                                      // ← 340
	if len(tags) != 0 {                                   // ← 341:数据与 tag 数不符
		return fmt.Errorf("mismatched profile records and tags")  // ← 342
	}                                                     // ← 343
	return nil                                            // ← 344
}                                                        // ← 345
把这条函数读薄,只剩三个动作:
| 步 | 代码 | 发生了什么 |
|---|---|---|
| 1 | !b.havePeriod 分支 |
首记录是元数据 :校验 data[0]==3 且 data[2]!=0,算 b.period = 1e9 / int64(data[2]),然后 data = data[3:]、tags = tags[1:] 消费掉 |
| 2 | for len(data) > 0 主循环 |
切出 count := data[2]、stk := data[3:data[0]],游标 data = data[data[0]:] 前进,同步取 tag |
| 3 | b.m.lookup(stk, tag).count += int64(count) |
查去重表、命中就累加、没命中就新建------整趟最核心的一句 |
溢出记录那段也值得单看:当 count==0 && len(stk)==1,说明这是一条「丢了 N 条样本」的补报,于是把 count 改成 stk[0](丢失数),把栈换成 lostProfileEvent 的伪 PC(+1 保持 return-PC 语义),让火焰图里能看见「丢了多少」。
一条具体记录长什么样(大注释给了格式):
| 位置 | 值 | 含义 |
|---|---|---|
data[0] |
3+n |
这条记录一共占几格 |
data[1] |
时间戳 | 原注释明确写着「忽略」 |
data[2] |
count |
这条记录代表几个样本 |
data[3:data[0]] |
栈 | 一串 PC |
4.3 难点 D|三层翻译:为什么输入是裸 uint64,不是现成的结构
在纠结什么 :addCPUData 开头一堆 if len(data) < 3、data[0] > uint64(len(data))、len(tags) < 1 的校验,像在拆一个不透明的包裹。为什么上游不直接给结构体?
通俗地说 :因为上游是那本不能上锁、不能分配内存的环形账本 。信号处理器往里写的时候,能写的只有「数字格子」,不可能构造 Go 结构体、更不可能塞字符串。所以跨过 ③→④ 边界的,只能是「一串 uint64 + 平行的标签指针」。本层第一件事就是按约定把数字重新切回语义。
那个约定是双方早就说好的暗号:
| 暗号 | 含义 |
|---|---|
| 第一格 = 整条长度 | 自带步长,读的时候直接跳这么多格 |
data[0] 必须 ≥ 3 |
长度字 + 时间 + 抬头,最少三格 |
count==0 且栈长 1 |
这不是普通样本,是「丢了 N 条」的补报 |
tags 与记录一一对应 |
一条记录配一个标签指针 |
最小例子 :一条 [5, 100, 1, 0xaa, 0xbb] 的读法------第一格说「我占 5 格」,第二格时间 100 忽略,第三格说「1 个样本」,后面 0xaa / 0xbb 是两层栈。校验完,游标直接 data = data[data[0]:] 跳到下一条,不需要任何分隔符。
一句话记住 :上游不是不肯给结构,是给不了;本层第一层工作就是按暗号把数字切回语义。
对应源码行 :§4.2 那段「data[0]=3+n, data[1]=时间戳(忽略), data[2]=count, data[3:]=栈」的注释,以及 count==0 && len(stk)==1 那个分支。
5 build:遍历去重表、封包、收尾 gzip(347~392 行)
5.1 先建画面:交账与装箱
addCPUData 是「来一条账、记一笔」,build 是「记完了,交账」:
- 先盖章------写起始时间、两列定义、时长、周期;
- 再按插入序 把去重表里的每一条样本取出来,把栈翻译成一串 Location 编号,写成一条
Sample; - 最后把
Mapping表、整本string_table、剩余字节一次写完,关掉 gzip 流。
它是整条流水线的分界线:上半段(解析 + 去重)到此为止,下半段(翻译 + 编码)从这里开始。注意 for e := b.m.all; e != nil; e = e.nextAll 走的是 all 全量链而不是哈希桶------因为输出要的是插入序,不是哈希序。
5.2 源码逐行:build
go
// build completes and returns the constructed profile.
func (b *profileBuilder) build() {                      // ← 348:profileWriter 的 eof 之后 / 各 write* 的收尾
	b.end = time.Now()                              // ← 349:结束时间
	                                                   // ← 350
	b.pb.int64Opt(tagProfile_TimeNanos, b.start.UnixNano())  // ← 351:采集起始(epoch ns)
	if b.havePeriod { // must be CPU profile          // ← 352:CPU 专属头部
		b.pbValueType(tagProfile_SampleType, "samples", "count")     // ← 353:列① 样本数
		b.pbValueType(tagProfile_SampleType, "cpu", "nanoseconds")   // ← 354:列② CPU 时间
		b.pb.int64Opt(tagProfile_DurationNanos, b.end.Sub(b.start).Nanoseconds())  // ← 355:时长
		b.pbValueType(tagProfile_PeriodType, "cpu", "nanoseconds")   // ← 356:周期单位
		b.pb.int64Opt(tagProfile_Period, b.period)                   // ← 357:周期(样本数×周期≈时长)
	}                                                   // ← 358
	                                                    // ← 359
	values := []int64{0, 0}                            // ← 360:两值样本缓冲
	var locs []uint64                                  // ← 361
	                                                    // ← 362
	for e := b.m.all; e != nil; e = e.nextAll {        // ← 363:遍历去重后的样本(插入序)
		values[0] = e.count                            // ← 364:列① 样本计数
		values[1] = e.count * b.period                 // ← 365:列② 样本×周期 = CPU 纳秒
	                                                    // ← 366
		var labels func()                              // ← 367:tag(pprof labels)→ sample.label
		if e.tag != nil {                              // ← 368
			labels = func() {                          // ← 369
				for _, lbl := range (*labelMap)(e.tag).list {  // ← 370:g.labels 就是 labelMap(采样时抄下的标签指针)
					b.pbLabel(tagSample_Label, lbl.key, lbl.value, 0)  // ← 371
				}                                      // ← 372
			}                                          // ← 373
		}                                              // ← 374
	                                                    // ← 375
		locs = b.appendLocsForStack(locs[:0], e.stk)   // ← 376:★栈 → Location id 列表(见 §6)
	                                                    // ← 377
		b.pbSample(values, locs, labels)               // ← 378:输出样本
	}                                                      // ← 379
	                                                       // ← 380
	for i, m := range b.mem {                              // ← 381:mapping 表
		hasFunctions := m.funcs == lookupTried // lookupTried but not lookupFailed  // ← 382:全部成功才声明有符号
		b.pbMapping(tagProfile_Mapping, uint64(i+1), uint64(m.start), uint64(m.end), m.offset, m.file, m.buildID, hasFunctions)  // ← 383
	}                                                      // ← 384
	                                                       // ← 385~387:两个 TODO(DropFrames/KeepFrames 未实现)
	b.pb.strings(tagProfile_StringTable, b.strings)        // ← 389:字符串表
	b.zw.Write(b.pb.data)                                  // ← 390:刷最后一批字节
	b.zw.Close()                                           // ← 391:结束 gzip 流(写 footer)
}                                                         // ← 392
labels 又是一处延迟回调:只有 e.tag != nil 才构造闭包,闭包遍历 (*labelMap)(e.tag).list 逐条 pbLabel。标签本来就贴在样本上(采样时抄下的 g.labels 指针),这里只是把它翻译成 proto 的 Label 消息。
5.3 本节拆解:两列值、两处时间、三条收尾
两列值不是一回事 :
values[0] = e.count是样本计数,values[1] = e.count * b.period是样本数乘周期算出来的估计 CPU 纳秒,不是实测值。§13 第 5 条专门澄清这个误解。
两处时间也不是一回事 :tagProfile_TimeNanos写的是b.start.UnixNano()(epoch 起始),tagProfile_DurationNanos写的是b.end.Sub(b.start)(真实墙钟时长);而记录流里那个data[1]时间戳被明确忽略。文件里的时间全部来自build自己的时钟。
三条收尾一个都不能少 :b.pb.strings(...)把整本字典写进string_table;b.zw.Write(b.pb.data)刷掉最后一批字节(flush有 4KB 阈值,尾巴未必够阈值);b.zw.Close()写 gzip footer------少了它工具读不出文件。这三条列在 §12 第 10 条。
hasFunctions := m.funcs == lookupTried 这句也顺手记一下:只有该 mapping 上所有符号化都「试过且没失败」,才敢向 pprof 声明「自带符号」;symbolizeResult 是怎么一层层汇总上来的,见 §7 与 §8。
6 appendLocsForStack 与 pcDeck:把摊平的内联折回去(394~580 行)
6.1 先建画面:一台折叠机
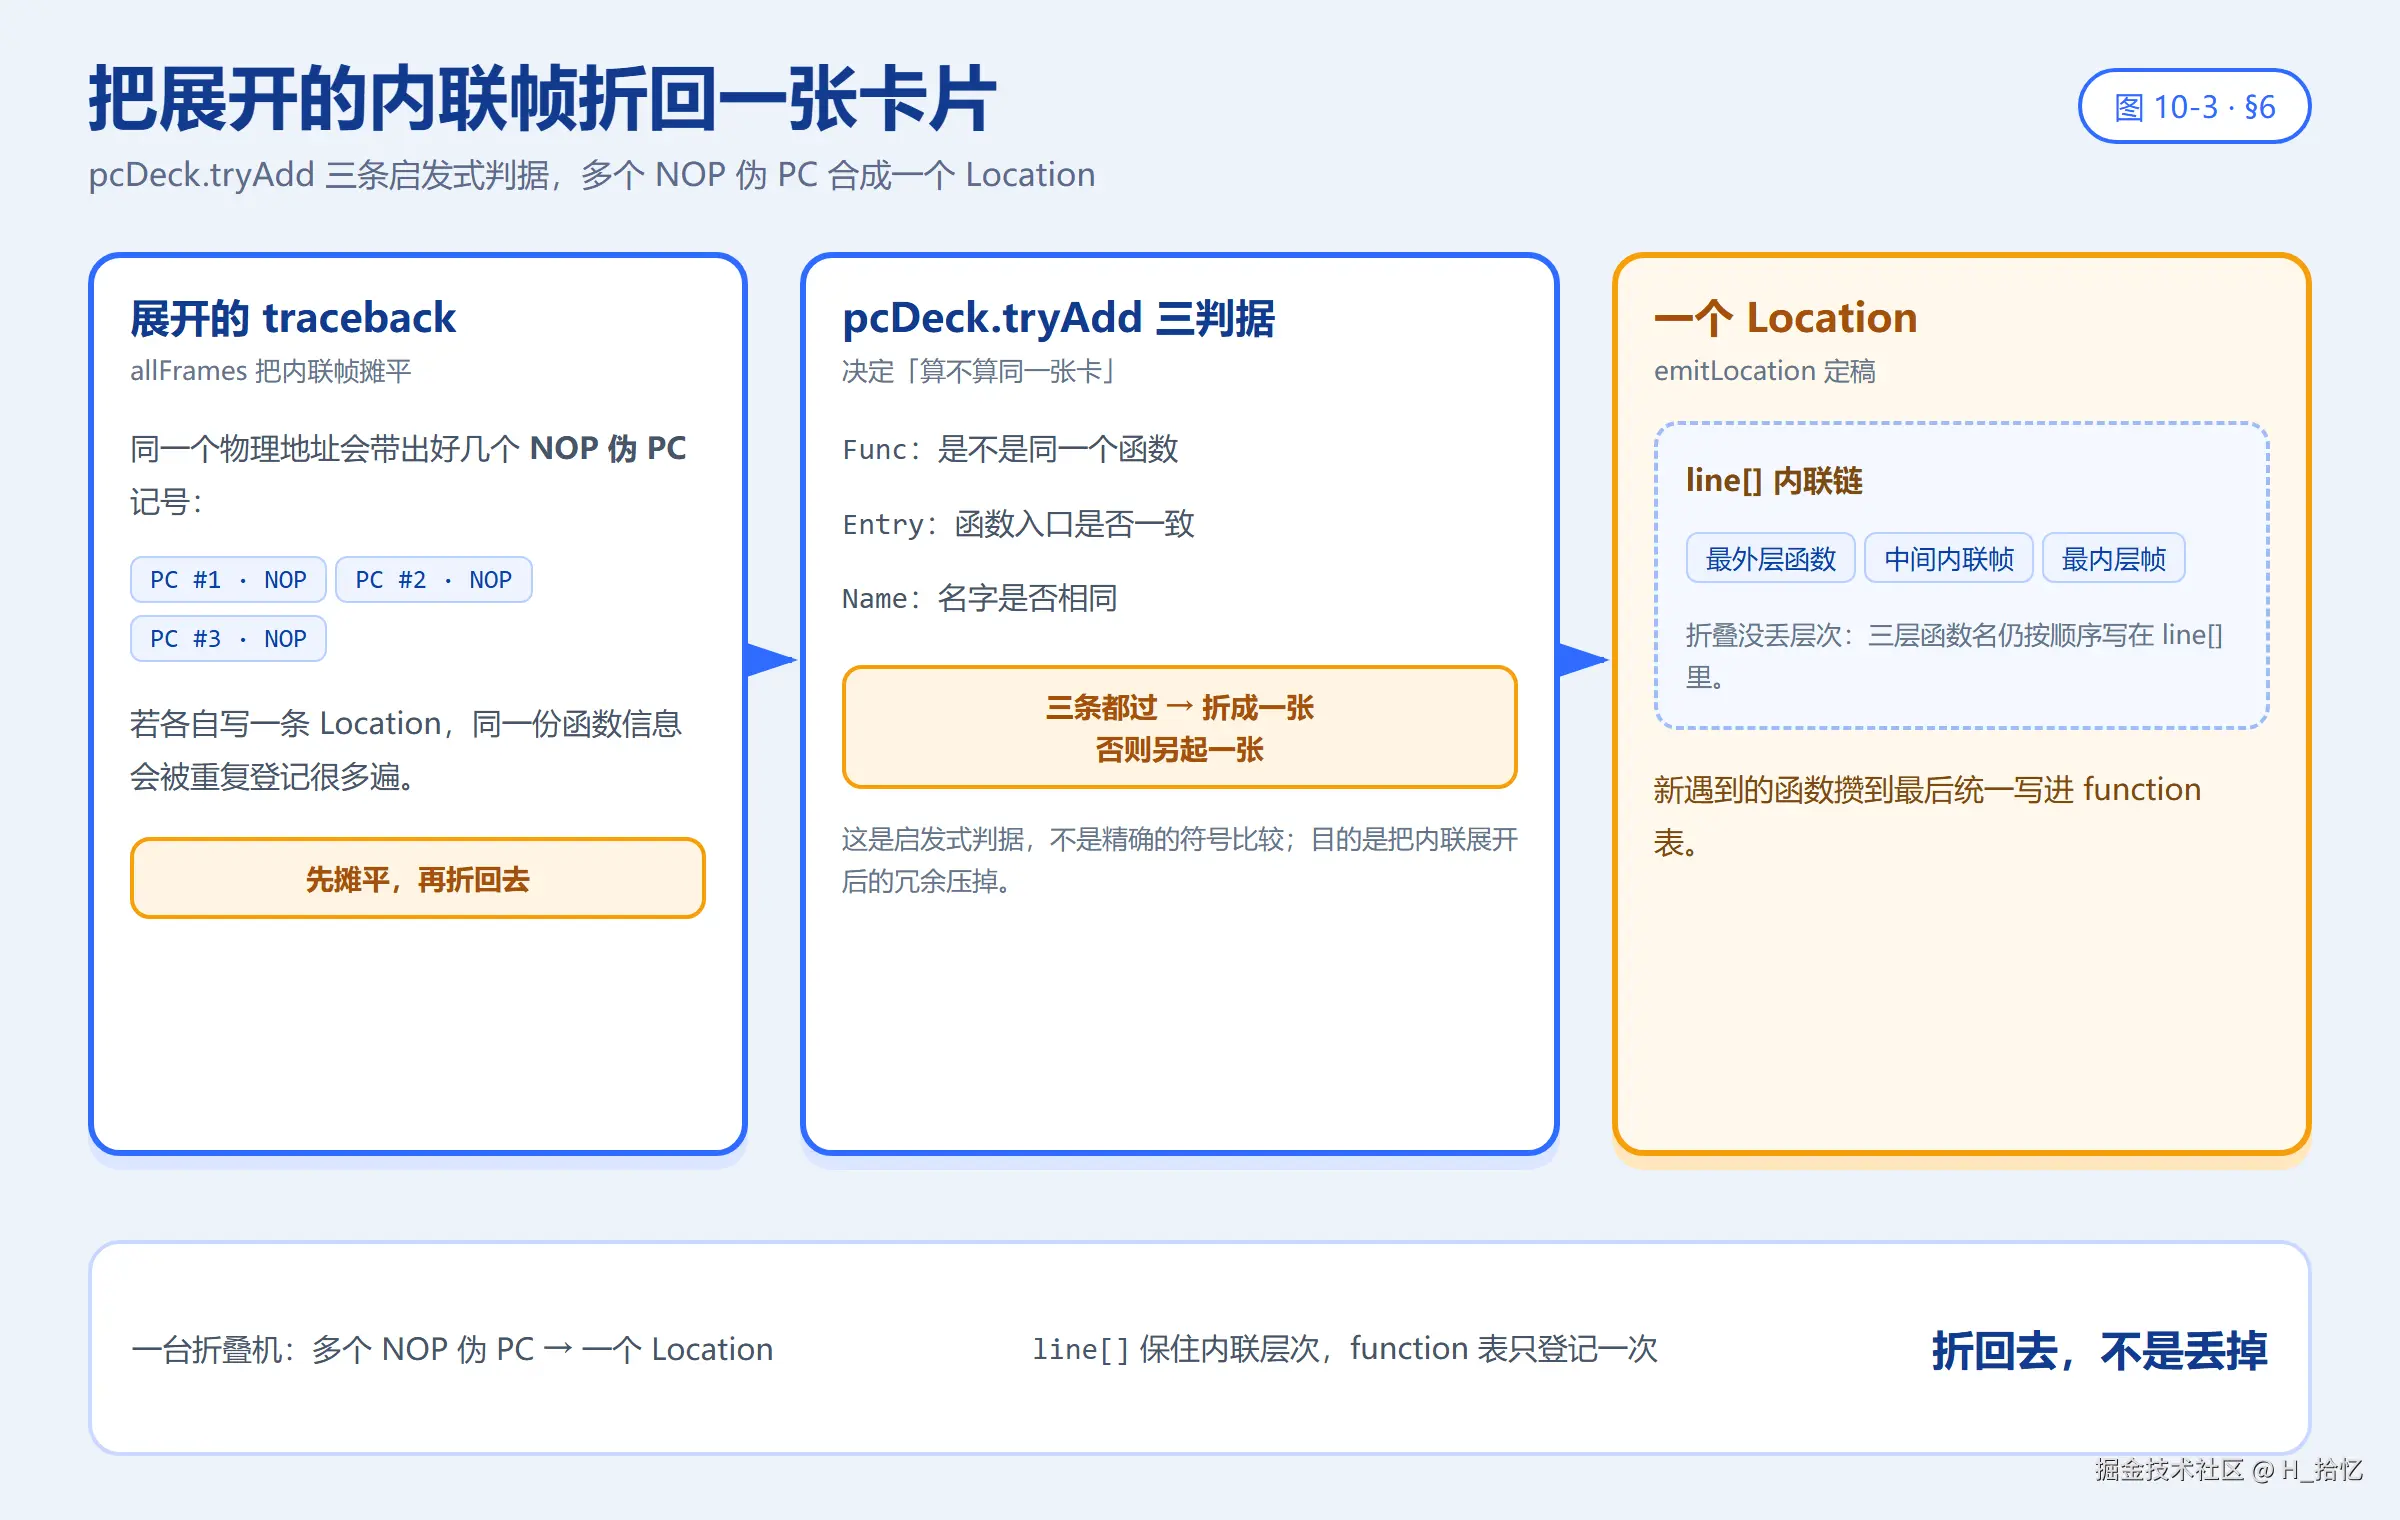
图 10-3 pcDeck / location 去重:traceback 展开出的多个 NOP 伪 PC,经三条启发式判据合成一个 Location,内含 line\[\] 内联链。
看图时抓三处:同一物理地址带出的三个 NOP 记号、tryAdd 的 Func / Entry / Name 三判据、折成一张卡片后背面写着的 line\[\] 三层函数名;对应 §6.2、§7.2 与难点 E / F。
问题 :runtime 的 traceback 已把内联展开 成独立帧------同一个物理地址 0x4553ee 会带出 a←b←main 三个 frame;而 proto 的规范是「一个 Location,内含 line[] 内联链」。两边对不上,pcDeck 就是把展开的帧折叠回去的状态机。
486~505 行的注释是不可多得的教学材料,原文复述:编译器为每层内联在外层函数里放一个 NOP (0x4553ec / 0x4553ed);traceback 把这些 NOP 地址当「伪 PC」混进栈里。信号恰好停在 MOVQ 上时,栈看起来是「0x4553ee 调用 0x4553ed 调用 0x4553ec」------其实是同一个物理位置的三个记号 。pcDeck 按叶→根顺序 tryAdd,把三者合成「地址 0x4553ee、line[]=[a,b,main] 的单个 Location」。
把它想成一台折叠机:牌堆 deck 一次只装一个 Location 的料,tryAdd 每来一个 PC 就问「能不能跟上一张叠在一起」;能就继续攒,不能就 emitLocation() 把这一堆定稿、再开一堆。
6.2 源码逐行:appendLocsForStack
go
// appendLocsForStack appends the location IDs for the given stack trace ...(394~402:
//     输入是 return PC 或内联标记 PC;可能返回空(全是 goexit);会向 b.pb 输出------不能在消息编码中途调)
func (b *profileBuilder) appendLocsForStack(locs []uint64, stk []uintptr) (newLocs []uint64) {
	b.deck.reset()                                    // ← 404:折叠状态机复位
	                                                   // ← 405
	// The last frame might be truncated. Recover lost inline frames.
	origStk := stk                                    // ← 407:留原始栈(panic 信息用)
	stk = runtime_expandFinalInlineFrame(stk)         // ← 408:末帧若是被截断的内联链------补全(runtime 侧 linkname)
	                                                   // ← 409
	for len(stk) > 0 {                                // ← 410:主循环:叶→根逐 PC
		addr := stk[0]                                // ← 411
		if l, ok := b.locs[addr]; ok {                // ← 412:缓存命中!
			// ...(413~423:NOP 伪 PC 注释------命中缓存的 PC 可能是内联中间层,
			//     必须先试 deck 能否继续折叠,再决定是否当作独立 Location)
			if len(b.deck.pcs) > 0 {              // ← 424:deck 有未刷的内容
				if added := b.deck.tryAdd(addr, l.firstPCFrames, l.firstPCSymbolizeResult); added {  // ← 425:先当内联中间层试
					stk = stk[1:]             // ← 426:成功------是同一内联链的一部分
					continue                 // ← 427
				}                             // ← 428
			}                                     // ← 429
			                                    // ← 430
			// first record the location if there is any pending accumulated info.
			if id := b.emitLocation(); id > 0 {  // ← 432:deck 不再能吸收 → 刷掉(独立 Location)
				locs = append(locs, id)      // ← 433
			}                                     // ← 434
			                                    // ← 435
			// then, record the cached location.
			locs = append(locs, l.id)            // ← 437:缓存里的 Location 入列
			                                    // ← 438
			// Skip the matching pcs. ...(439~443:跳过该 Location 覆盖的整段 PC;
			//     expandFinalInlineFrame 已保证栈足够长)
			if len(l.pcs) > len(stk) {           // ← 444:覆盖段比剩余栈还长------数据不一致
				panic(fmt.Sprintf("stack too short to match cached location; stk = %#x, l.pcs = %#x, original stk = %#x", stk, l.pcs, origStk))  // ← 445
			}                                     // ← 446
			stk = stk[len(l.pcs):]                // ← 447:整段跳过
			continue                              // ← 448
		}                                             // ← 449
		                                              // ← 450
		frames, symbolizeResult := allFrames(addr)    // ← 451:缓存未命中------符号化展开
		if len(frames) == 0 { // runtime.goexit.       // ← 452
			if id := b.emitLocation(); id > 0 {   // ← 453:先刷 deck
				locs = append(locs, id)       // ← 454
			}                                     // ← 455
			stk = stk[1:]                         // ← 456:丢弃 goexit
			continue                              // ← 457
		}                                             // ← 458
		                                              // ← 459
		if added := b.deck.tryAdd(addr, frames, symbolizeResult); added {  // ← 460:试着折叠
			stk = stk[1:]                         // ← 461:成功
			continue                              // ← 462
		}                                             // ← 463
		// add failed because this addr is not inlined with the
		// existing PCs in the deck. Flush the deck and retry handling
		// this pc.
		if id := b.emitLocation(); id > 0 {           // ← 467:失败------deck 是完整内联链,先刷
			locs = append(locs, id)               // ← 468
		}                                             // ← 469
		                                              // ← 470
		// check cache again - previous emitLocation added a new entry
		if l, ok := b.locs[addr]; ok {                // ← 472:刚才 emitLocation 刚缓存了它!
			locs = append(locs, l.id)             // ← 473
			stk = stk[len(l.pcs):] // skip the matching pcs.  // ← 474
		} else {                                      // ← 475
			b.deck.tryAdd(addr, frames, symbolizeResult) // must succeed.  // ← 476:空 deck 必成功
			stk = stk[1:]                         // ← 477
		}                                             // ← 478
	}                                                     // ← 479
	if id := b.emitLocation(); id > 0 { // emit remaining location.  // ← 480:收尾刷最后的 deck
		locs = append(locs, id)                       // ← 481
	}                                                     // ← 482
	return locs                                           // ← 483
}                                                         // ← 484
主循环有四条路,看着绕,其实只是「缓存命中 / 未命中」×「deck 能不能吸收」的组合:
| 情形 | 动作 |
|---|---|
| 缓存命中,deck 还能折叠(412~428 行) | tryAdd(addr, l.firstPCFrames, ...) 成功 → 当作同一内联链的中间层,继续 |
| 缓存命中,deck 折不动了(432~448 行) | 先 emitLocation() 刷掉 deck,再把缓存里的 l.id 入列,stk = stk[len(l.pcs):] 整段跳过 |
| 缓存未命中,符号化为空(452~457 行) | 是 runtime.goexit,先刷 deck 再丢弃 |
缓存未命中,tryAdd 失败(467~477 行) |
deck 是完整内联链,先刷;emitLocation 顺手缓存了当前 addr,于是再查一次缓存,命中就整段跳过,否则用空 deck 重试(必成功) |
最容易看漏的一步 :缓存命中时源码不直接采用
l.id,而是先让 deck 试着继续折叠------因为命中的 PC 有可能正是内联链的中间层。折不动了才定稿、再把缓存里的l.id入列。
6.3 源码逐行:pcDeck 与 reset
go
type pcDeck struct {              // ← 528(507~527 行注释:启发式三判据------见下)
	pcs             []uintptr  // ← 529:deck 里的原始 PC
	frames          []runtime.Frame  // ← 530:它们展开的 frame(可能多个/PC)
	symbolizeResult symbolizeFlag    // ← 531:聚合的符号化结果
	                                                   // ← 532
	firstPCFrames int                  // ← 535:首个(叶)PC 的 frame 数
	firstPCSymbolizeResult symbolizeFlag  // ← 538:其符号化结果(缓存命中时喂给 deck 用)
}                                                       // ← 539
                                                        // ← 540
func (d *pcDeck) reset() {                              // ← 541
	d.pcs = d.pcs[:0]                                // ← 542:长度清零,容量保留
	d.frames = d.frames[:0]                          // ← 543
	d.symbolizeResult = 0                            // ← 544
	d.firstPCFrames = 0                              // ← 545
	d.firstPCSymbolizeResult = 0                     // ← 546
}                                                       // ← 547
reset 里全是 d.xxx = d.xxx[:0]------长度清零、容量保留,下次 append 直接复用底层数组。这正是 §7 里缓存必须拷贝切片的原因:deck 会被复用,谁引用它的切片,谁的内容就会被下一轮覆写。
507~527 行注释给出的内联判定三判据(都不完美,合起来够用):
Frame.Func == nil(内联帧没有独立 Func;非 Go 函数也这样);Frame.Entry与入口函数帧相同(递归调用也这样);Frame.Name与入口函数名不同(内联函数不能直接递归)。
6.4 源码逐行:tryAdd 与三条判据
go
func (d *pcDeck) tryAdd(pc uintptr, frames []runtime.Frame, symbolizeResult symbolizeFlag) (success bool) {
	if existing := len(d.frames); existing > 0 {       // ← 553:deck 非空才判相容性
		// 'd.frames' are all expanded from one 'pc' ...(554~555)
		newFrame := frames[0]                       // ← 556:新 PC 的首个 frame
		last := d.frames[existing-1]                // ← 557:deck 尾 frame(入口函数)
		if last.Func != nil { // the last frame can't be inlined. Flush.  // ← 558:判据①
			return false                       // ← 559
		}                                           // ← 560
		if last.Entry == 0 || newFrame.Entry == 0 { // Possibly not a Go function. Don't try to merge.  // ← 561:判据②前置
			return false                       // ← 562
		}                                           // ← 563
		                                            // ← 564
		if last.Entry != newFrame.Entry { // newFrame is for a different function.  // ← 565:判据②
			return false                       // ← 566
		}                                           // ← 567
		if runtime_FrameSymbolName(&last) == runtime_FrameSymbolName(&newFrame) { // maybe recursion.  // ← 568:判据③
			return false                       // ← 569
		}                                           // ← 570
	}                                                   // ← 571
	d.pcs = append(d.pcs, pc)                           // ← 572:入 deck
	d.frames = append(d.frames, frames...)              // ← 573
	d.symbolizeResult |= symbolizeResult                // ← 574:聚合
	if len(d.pcs) == 1 {                                // ← 575:首个 PC
		d.firstPCFrames = len(d.frames)             // ← 576:记录其 frame 数
		d.firstPCSymbolizeResult = symbolizeResult  // ← 577
	}                                                   // ← 578
	return true                                         // ← 579
}                                                      // ← 580
代码里是「反过来判」的:四个 return false 分别对应三条判据(判据②拆成「Entry 为 0」的前置检查和「Entry 不等」两步):
| 判据 | 代码 | 排除什么 | ||
|---|---|---|---|---|
| ① | last.Func != nil → false |
非内联帧 / 非 Go 函数 | ||
| ② 前置 | `last.Entry == 0 | newFrame.Entry == 0` → false | 可能不是 Go 函数,别硬合 | |
| ② | last.Entry != newFrame.Entry → false |
不同函数 | ||
| ③ | 两个 runtime_FrameSymbolName 相等 → false |
递归(注释写着 maybe recursion) |
全都通过,才 append 进 deck,并聚合 symbolizeResult;首个 PC 额外记下 firstPCFrames / firstPCSymbolizeResult,供缓存命中时复用。
6.5 难点 E|pcDeck:把展开的内联帧折回一个 Location
在纠结什么 :runtime 的 traceback 已经把内联展开 成了独立帧,可 proto 规范要求「一个 Location,里面用 line[] 装内联链」。两边对不上,pcDeck 就是来翻译的。
通俗地说 :想象编译器把 a 内联进 b、b 内联进 main。物理上只有一个地址,但为了在栈里保留层级,编译器会在外层函数里放几个 NOP 空指令 当「伪 PC」。486~505 行的注释复述了这个场景:信号恰好停在 MOVQ 上时,栈看起来像「0x4553ee 调用 0x4553ed 调用 0x4553ec」,其实是同一个物理位置的三个记号。
pcDeck 是个「暂存的牌堆」:按叶 → 根 的顺序对逐个 PC 调 tryAdd,能合并就继续攒,不能合并就 emitLocation() 把当前这堆定稿成一个 Location,再开一堆。
最小例子 :栈里连着三个伪 PC,tryAdd 全返回 true,deck 里攒下它们展开出的 a / b / main 三个 frame;emitLocation 定稿时,地址取叶 PC,而 line[] 按顺序写三层------一个 Location 表达了三层调用 。反过来,若中间夹了一个真正不同的函数,tryAdd 返回 false,deck 先刷出上一个 Location,再为这个新 PC 开一堆。
还有一层缓存要留意:appendLocsForStack 先查 b.locs[addr],命中说明这个 PC 以前定稿过。但源码不直接采用,而是先让 deck 试着继续折叠 (b.deck.tryAdd(addr, l.firstPCFrames, ...))------因为缓存命中的 PC 有可能正是内联链的中间层。折不动了才 emitLocation 刷掉、再把缓存里的 l.id 入列,并 stk = stk[len(l.pcs):] 整段跳过。
三条判据是启发式不是铁律:源码注释明说「都不完美,合起来够用」,单条都有反例(比如递归也会让 Entry 相同)。这一点列在 §13 第 8 条。
一句话记住 :traceback 把内联摊平 ,proto 要叠起来 ;pcDeck 就是那台折叠机,三条启发式是它的手感。
对应源码行 :§6.1 的 NOP 伪 PC 教学注释、§6.3 的三判据、§6.4 tryAdd 里四个 return false。
7 emitLocation:把 deck 定稿成 Location 与 Function(582~657 行)
7.1 先建画面:定稿台
pcDeck 攒够了一个 Location 的料,emitLocation 负责把它写到 proto 里,像一张定稿台:
- 取叶 PC 当 Location 地址,分配一个新 ID,顺手把「这个 PC 覆盖哪几个 PC」记进
locs缓存; - 开一个
Location子消息,逐 frame 写line[]; - 找一下这个地址属于哪个 mapping,把符号化结果汇总上去;
- 收尾
Location,再把本轮新发现的函数补写成独立的 Function 消息; - 刷一次盘,deck 复位。
第 4 步那个「补写」是最反直觉的一处------明明在遍历 frame 时就发现了新函数,为什么不立刻写?难点 F 专门拆它。
7.2 源码逐行:emitLocation
go
// emitLocation emits the new location and function information recorded in the deck
// and returns the location ID encoded in the profile protobuf. ...(583~585:
//     会向 b.pb 输出;调用后 deck 复位)
func (b *profileBuilder) emitLocation() uint64 {
	if len(b.deck.pcs) == 0 {              // ← 587:空 deck
		return 0                       // ← 588
	}                                          // ← 589
	defer b.deck.reset()                       // ← 590:无论如何最后复位
	                                                   // ← 591
	addr := b.deck.pcs[0]                            // ← 592:Location 地址 = 叶 PC
	firstFrame := b.deck.frames[0]                   // ← 593
	                                                   // ← 594~597:Location 消息中途不能写 Function------先攒后写
	type newFunc struct {                            // ← 598:待写函数的局部结构
		id         uint64                        // ← 599
		name, file string                        // ← 600
		startLine  int64                         // ← 601
	}                                                   // ← 602
	newFuncs := make([]newFunc, 0, 8)                   // ← 603
	                                                   // ← 604
	id := uint64(len(b.locs)) + 1                      // ← 605:新 Location ID(自增)
	b.locs[addr] = locInfo{                            // ← 606:入缓存
		id:                     id,                // ← 607
		pcs:                    append([]uintptr{}, b.deck.pcs...),  // ← 608:★拷贝!deck 的切片要复用
		firstPCSymbolizeResult: b.deck.firstPCSymbolizeResult,       // ← 609
		firstPCFrames:          append([]runtime.Frame{}, b.deck.frames[:b.deck.firstPCFrames]...),  // ← 610:同上
	}                                                   // ← 611
	                                                   // ← 612
	start := b.pb.startMessage()                       // ← 613:Location 消息开写
	b.pb.uint64Opt(tagLocation_ID, id)                 // ← 614
	b.pb.uint64Opt(tagLocation_Address, uint64(firstFrame.PC))  // ← 615
	for _, frame := range b.deck.frames {              // ← 616:内联链逐层
		// Write out each line in frame expansion.
		funcName := runtime_FrameSymbolName(&frame)// ← 618:符号名(runtime 链接名,如 main.glob..1)
		funcID := uint64(b.funcs[funcName])        // ← 619:函数表查 ID
		if funcID == 0 {                           // ← 620:新函数
			funcID = uint64(len(b.funcs)) + 1  // ← 621:分配 ID
			b.funcs[funcName] = int(funcID)    // ← 622:入表
			newFuncs = append(newFuncs, newFunc{  // ← 623:攒着,Location 写完再写
				id:        funcID,           // ← 624
				name:      funcName,         // ← 625
				file:      frame.File,       // ← 626
				startLine: int64(runtime_FrameStartLine(&frame)),  // ← 627:函数声明行
			})                                // ← 628
		}                                           // ← 629
		b.pbLine(tagLocation_Line, funcID, int64(frame.Line))  // ← 630:line[] 一层
	}                                                   // ← 631
	for i := range b.mem {                              // ← 632:找 addr 属于哪个 mapping
		if b.mem[i].start <= addr && addr < b.mem[i].end || b.mem[i].fake {  // ← 633:区间判定;fake 兜底全收
			b.pb.uint64Opt(tagLocation_MappingID, uint64(i+1))  // ← 634
			                                                   // ← 635
			m := b.mem[i]                                      // ← 636
			m.funcs |= b.deck.symbolizeResult                  // ← 637:聚合符号化结果(有失败则 mapping 不声明有符号)
			b.mem[i] = m                                       // ← 638
			break                                              // ← 639:只属一个 mapping
		}                                                           // ← 640
	}                                                               // ← 641
	b.pb.endMessage(tagProfile_Location, start)                     // ← 642:Location 收尾
	                                                                // ← 643
	// Write out functions we found during frame expansion.
	for _, fn := range newFuncs {                                  // ← 645:补写新函数
		start := b.pb.startMessage()                           // ← 646
		b.pb.uint64Opt(tagFunction_ID, fn.id)                  // ← 647
		b.pb.int64Opt(tagFunction_Name, b.stringIndex(fn.name))          // ← 648
		b.pb.int64Opt(tagFunction_SystemName, b.stringIndex(fn.name))    // ← 649:SystemName 同名(Go 无 C++ 那样的 demangle 区别)
		b.pb.int64Opt(tagFunction_Filename, b.stringIndex(fn.file))      // ← 650
		b.pb.int64Opt(tagFunction_StartLine, fn.startLine)     // ← 651
		b.pb.endMessage(tagProfile_Function, start)             // ← 652
	}                                                               // ← 653
	                                                                // ← 654
	b.flush()                                                       // ← 655
	return id                                                       // ← 656
}                                                                   // ← 657
几个数字与细节对得上前面所有铺垫:
id := uint64(len(b.locs)) + 1------ Location ID 从 1 自增,与sample.location_id引用的正是这套编号;funcID == 0判定「新函数」,ID 同样从 1 开始,b.funcs是「函数全名 → ID」表;runtime_FrameSymbolName(&frame)取的是 runtime 链接名(如main.glob..1),SystemName也写同名------Go 没有 C++ 那样的 demangle 区别;b.mem[i].start <= addr && addr < b.mem[i].end || b.mem[i].fake------ 区间判定;fake兜底条目全收所有地址(§8、难点 G);m.funcs |= b.deck.symbolizeResult把这一轮的符号化结果汇总到 mapping,正是 §5 那个hasFunctions判据的数据来源。
7.3 难点 F|emitLocation:为什么新函数要攒到最后才写
在纠结什么 :emitLocation 里明明在遍历 deck.frames 时就已经发现了新函数(funcID == 0),为什么不立刻写 Function 消息,非要塞进 newFuncs 等 Location 写完再补?
通俗地说 :因为消息不能套消息 。回忆难点 J(§10):startMessage() 到 endMessage() 之间是一个子消息的「内容区」,长度前缀要等收尾时才回填。Location 消息从 start := b.pb.startMessage() 开始,到 b.pb.endMessage(tagProfile_Location, start) 结束;如果中间插进去一个完整的 Function 消息,它就会被算进 Location 的内容长度里------pprof 工具解析时会把它当成 Location 的字段,整个结构错位。
所以源码分两段:
| 阶段 | 干什么 |
|---|---|
| Location 内容区里 | 逐 frame 写 pbLine(line[] 一层),新函数只记进 newFuncs 小本本 |
endMessage 之后 |
再为 newFuncs 里的每一项补写独立的 Function 消息 |
还有两处「拷贝」特别容易被忽略:b.locs[addr] = locInfo{...} 时,pcs 和 firstPCFrames 都用 append([]T{}, ...) 拷贝了一份 。因为 defer b.deck.reset() 马上会把 deck 的切片长度清零、下次复用底层数组;不拷贝,缓存里存的就是会被覆写的同一块内存。§13 第 7 条就是这条。
最小例子 :newFuncs := make([]newFunc, 0, 8) 预留 8 个位置,遍历 frame 时遇到没见过的 funcName 就分配 funcID = len(b.funcs)+1、记进 b.funcs 和 newFuncs;等 Location 一 endMessage,再循环 newFuncs 逐个 startMessage → 五个字段 → endMessage。newFuncs 就是那张「先别写、等会儿补」的便签。
一句话记住 :子消息的内容区里不能再开子消息,所以新函数先记账、后补写;deck 要复用,缓存就得拷贝。
对应源码行 :§7.2 的 594~597 行「Location 消息中途不能写 Function------先攒后写」注释、608 / 610 行两次 append 拷贝、645~653 行补写循环。
8 mapping 与 parseProcSelfMaps:给每个地址找归属(659~766 行)
8.1 先建画面:给地址查一张地图
Location 光有地址还不够,pprof 工具得知道这个地址落在哪个二进制 / 共享库里,才能去配符号、算偏移。所以抄账员开工时(newProfileBuilder 里那句 b.readMapping(),§3)就读了一张模块地图:进程把哪些文件映射到了哪些地址区间。
Linux 上这张地图就是 /proc/self/maps。但它列出的是进程所有 内存映射------堆、栈、数据段、共享库、匿名映射......而 pprof 只关心「代码可能落在哪 」,也就是可执行段。所以解析器的主旋律是一串 continue:一行行扫过去,只把带 x 权限、有文件名、inode 正常的行留下,算上 buildID,回调上交。
8.2 源码逐行:parseProcSelfMaps
659~660 两个字节常量;662~751 行是 Linux /proc/self/maps 解析器:
go
var space = []byte(" ")      // ← 659
var newline = []byte("\n")   // ← 660
                             // ← 661
// parseProcSelfMaps ...(662~682:函数签名 + 真实 maps 样例注释,十八行长样例原样贴在源码里当文档)
func parseProcSelfMaps(data []byte, addMapping func(lo, hi, offset uint64, file, buildID string)) {
	var line []byte                                  // ← 684:当前行游标
	// next removes and returns the next field in the line. ...(685~686)
	next := func() []byte {                          // ← 687:按空格切字段
		var f []byte                             // ← 688
		f, line, _ = bytes.Cut(line, space)      // ← 689
		line = bytes.TrimLeft(line, " ")         // ← 690:吃掉多余空格
		return f                                 // ← 691
	}                                                  // ← 692
	                                                   // ← 693
	for len(data) > 0 {                               // ← 694:逐行
		line, data, _ = bytes.Cut(data, newline)  // ← 695
		addr := next()                             // ← 696:字段① lo-hi
		loStr, hiStr, ok := strings.Cut(string(addr), "-")  // ← 697
		if !ok {
			continue                         // ← 699:格式异常行跳过
		}                                          // ← 700
		lo, err := strconv.ParseUint(loStr, 16, 64)  // ← 701:十六进制地址
		if err != nil {
			continue                          // ← 703
		}                                          // ← 704
		hi, err := strconv.ParseUint(hiStr, 16, 64)  // ← 705
		if err != nil {
			continue                          // ← 707
		}                                          // ← 708
		perm := next()                             // ← 709:字段② 权限
		if len(perm) < 4 || perm[2] != 'x' {       // ← 710:第 3 位是 x?
			// Only interested in executable mappings.  // ← 711:只要可执行段(代码在里面)
			continue                          // ← 712
		}                                          // ← 713
		offset, err := strconv.ParseUint(string(next()), 16, 64)  // ← 714:字段③ 文件偏移
		if err != nil {
			continue                          // ← 716
		}                                          // ← 717
		next()          // dev                     // ← 718:字段④ 设备号------丢弃
		inode := next() // inode                    // ← 719:字段⑤ inode(后面要判 0)
		if line == nil {                            // ← 720:行尾无文件名
			continue                          // ← 721
		}                                          // ← 722
		file := string(line)                        // ← 723:剩余部分=路径(可含空格,故不逐字段切)
	                                                   // ← 724
		// Trim deleted file marker.
		deletedStr := " (deleted)"                   // ← 726:已删除文件后缀
		deletedLen := len(deletedStr)                // ← 727
		if len(file) >= deletedLen && file[len(file)-deletedLen:] == deletedStr {
			file = file[:len(file)-deletedLen]   // ← 729:去掉(符号仍可用)
		}                                              // ← 730
	                                                   // ← 731
		if len(inode) == 1 && inode[0] == '0' && file == "" {  // ← 732:inode 0 且无名
			// Huge-page text mappings ...(733~736:大页文本映射的碎片段;
			//     [vdso]/[vsyscall] 也是 inode 0 但有名------放行)
			continue                          // ← 737
		}                                          // ← 738
	                                                   // ← 739~746:TODO------pprof 的 remapMappingIDs 有个
	//     /anon_hugepage 调整,Go 侧决定先不做,看看会坏什么
		buildID, _ := elfBuildID(file)             // ← 748:ELF build-id(elf.go)
		addMapping(lo, hi, offset, file, buildID)  // ← 749:回调上交
	}                                                  // ← 750
}                                                     // ← 751
next() 只切固定几个字段,末尾直接 string(line) 当路径------因为路径本身可能带空格,所以不能按空格逐字段切 。这一点解释了为什么代码不把整行 Split 成数组。
8.3 源码逐行:addMapping 与 addMappingEntry
go
func (b *profileBuilder) addMapping(lo, hi, offset uint64, file, buildID string) {
	b.addMappingEntry(lo, hi, offset, file, buildID, false)  // ← 754:非伪造
}                                                             // ← 755
                                                              // ← 756
func (b *profileBuilder) addMappingEntry(lo, hi, offset uint64, file, buildID string, fake bool) {
	b.mem = append(b.mem, memMap{                          // ← 758:追加进 mapping 表
		start:   uintptr(lo),                          // ← 759
		end:     uintptr(hi),                          // ← 760
		offset:  offset,                               // ← 761
		file:    file,                                 // ← 762
		buildID: buildID,                              // ← 763
		fake:    fake,                                 // ← 764
	})                                                        // ← 765
}                                                             // ← 766(文件完)
addMapping 只是 addMappingEntry(..., false) 的一层薄封装;fake 参数留给平台兜底用。b.mem 里的顺序就是 §5 build 写 Mapping 表时的顺序,tagMapping_ID 取 i+1。
readMapping 的三种平台实现(概述,各自 30~78 行):
| 文件 | 平台 | 做法 |
|---|---|---|
proto_other.go(30 行) |
Linux/BSD | os.ReadFile("/proc/self/maps") → parseProcSelfMaps;失败则加 fake mapping |
proto_windows.go(78 行) |
Windows | 遍历模块句柄(Module32Next)取每个 DLL 的基址 / 大小 / 路径;peBuildID(pe.go)从 PE 头算 buildID |
proto_darwin.go(36 行) |
macOS | _dyld_image_count / _dyld_get_image_... API + machoBuildID;另有 vminfo_darwin.go 提供内存信息 |
三者填的都是同一张 b.mem,对上层完全透明。
8.4 难点 G|mapping:为什么只留可执行段
在纠结什么 :parseProcSelfMaps 逐行读 /proc/self/maps,中间一串 continue 跳过,最后才 elfBuildID(file) + addMapping(...)。它到底在挑什么?
通俗地说 :/proc/self/maps 列出的是进程所有 内存映射:堆、栈、数据段、共享库、匿名映射......而 pprof 只关心「代码可能落在哪 」,也就是可执行段。所以 perm := next() 之后那句 perm[2] != 'x' 就是筛子:权限字段第 3 位不是 x 的行,一律跳过。
其余几个 continue 也各有理由:
| 跳过条件 | 通俗解释 |
|---|---|
地址切不出 lo-hi / ParseUint 失败 |
这行不是合法地址范围,别脏了表 |
line == nil(行尾没文件名) |
匿名映射,没有可配对的文件 |
inode==0 且 file=="" |
大页文本映射的碎片段;但 [vdso] / [vsyscall] 也是 inode 0,有名就放行 |
权限位不是 x |
不是代码段,PC 不会落在这里 |
还有两个细节:文件名后缀 " (deleted)" 要去掉(文件被删了符号仍可用);剩下的整段 line 当路径,因为路径可能带空格,不能逐字段切。
那 fake 是干嘛的 :三种平台实现里,proto_other.go(Linux/BSD)读 /proc/self/maps 失败时会加一个 fake mapping。§7 的 emitLocation 找归属时那句 || b.mem[i].fake 就是让这个假条目「全收」所有地址,保证没有真实模块表时文件仍能生成。
最小例子 :一行 7f...-7f... r-xp 00001000 08:01 12345 /usr/bin/myapp,权限位有 x、有文件名、inode 非 0 → 留下,算出 lo/hi/offset,取 buildID,调 addMapping。隔壁一行 rw-p 的数据段 → 直接跳过。
一句话记住 :PC 只可能落在可执行段 ,所以 maps 里只挑带 x 的行;读不到就造个 fake 全收兜底。
对应源码行 :§8.2 的 709~713 行 perm[2] != 'x'、732~737 行 inode 判定、726~730 行 (deleted) 处理;§8.3 末尾三平台对照表。
9 map.go 的 profMap:按 (栈, tag) 即时去重
9.1 先建画面:整条流水线的减压阀
§4 那句 b.m.lookup(stk, tag).count += int64(count) 是整条流水线最关键的一句------没有它,每秒上百条样本会原样写进文件,文件瞬间爆炸。profMap 就是那只减压阀:同一个「栈 + 标签」只留一条,再来只把计数加上去。
它的实现看着比普通 map 复杂得多:拉链、全量链、空闲池、cap 钉死、move-to-front。但拆开看,每一处都是在回答同一个现实问题------样本流每秒上百条,绝大多数是重复的栈,既不能每条都新建条目,也不能每条都把栈序列化成字符串当 key。
9.2 源码逐行:profMap 结构
go
// (map.go) A profMap is a map from (stack, tag) to mapEntry.
// It grows without bound, but that's assumed to be OK.   // ← 10~11:只增不减(剖析时长有限,可接受)
type profMap struct {             // ← 12
	hash    map[uintptr]*profMapEntry  // ← 13:桶号 → 条目拉链(Go 原生 map 只当"数组"用)
	all     *profMapEntry             // ← 14:全量链头(build 按插入序遍历)
	last    *profMapEntry             // ← 15:全量链尾(O(1) 追加)
	free    []profMapEntry            // ← 16:条目空闲池(成批分配)
	freeStk []uintptr                 // ← 17:栈 PC 空闲池(大块切着用)
}                                    // ← 18
                                     // ← 19~20
type profMapEntry struct {           // ← 21
	nextHash *profMapEntry // next in hash list  // ← 22
	nextAll  *profMapEntry // next in list of all entries  // ← 23
	stk      []uintptr     // ← 24:栈(拷贝)
	tag      unsafe.Pointer// ← 25:标签(g.labels 指针,可为 nil)
	count    int64         // ← 26:累计样本数
}                                    // ← 27
hash 是「桶号 → 拉链」,all / last 是另一条按插入序串起来的全量链。为什么两条链都要?因为 §5 的 build 要 for e := b.m.all; e != nil; e = e.nextAll 按插入序 遍历,而哈希桶里是乱序的。free / freeStk 则是成批分配的对象池,避免每条样本都 new。
9.3 源码逐行:lookup
go
func (m *profMap) lookup(stk []uint64, tag unsafe.Pointer) *profMapEntry {
	// Compute hash of (stk, tag).
	h := uintptr(0)                                   // ← 30
	for _, x := range stk {                           // ← 31:滚动哈希:每步左旋 8 位再加 41 倍 PC
		h = h<<8 | (h >> (8 * (unsafe.Sizeof(h) - 1)))  // ← 32:rotate-left 8(位宽感知,32/64 位都对)
		h += uintptr(x) * 41                           // ← 33:乘 41------经典字符串哈希乘数
	}                                                     // ← 34
	h = h<<8 | (h >> (8 * (unsafe.Sizeof(h) - 1)))        // ← 35:tag 也滚进去
	h += uintptr(tag) * 41                                // ← 36
	                                                      // ← 37
	// Find entry if present.
	var last *profMapEntry                                // ← 39
Search:                                                  // ← 40:带标签循环(Go 的 goto 标签用于"退一层继续")
	for e := m.hash[h]; e != nil; last, e = e, e.nextHash {  // ← 41:拉链查找
		if len(e.stk) != len(stk) || e.tag != tag {   // ← 42:快筛
			continue                              // ← 43
		}                                             // ← 44
		for j := range stk {                           // ← 45:逐 PC 慢比
			if e.stk[j] != uintptr(stk[j]) {       // ← 46
				continue Search                    // ← 47:不匹配------回到外层拉链下一个
			}                                         // ← 48
		}                                             // ← 49
		// Move to front.
		if last != nil {                              // ← 51:命中且非链头
			last.nextHash = e.nextHash            // ← 52:摘下
			e.nextHash = m.hash[h]                 // ← 53:接到链头
			m.hash[h] = e                          // ← 54:MTF 启发式------热栈查找更快
		}                                             // ← 55
		return e                                       // ← 56
	}                                                     // ← 57
	                                                      // ← 58
	// Add new entry.
	if len(m.free) < 1 {                                  // ← 60:空闲池空了
		m.free = make([]profMapEntry, 128)            // ← 61:一次造 128 个
	}                                                     // ← 62
	e := &m.free[0]                                       // ← 63:取一个
	m.free = m.free[1:]                                   // ← 64:池游标前移
	e.nextHash = m.hash[h]                                // ← 65:接拉链
	e.tag = tag                                           // ← 66
	                                                      // ← 67
	if len(m.freeStk) < len(stk) {                       // ← 68:栈池不够长
		m.freeStk = make([]uintptr, 1024)             // ← 69:大块 1024
	}                                                     // ← 70
	// Limit cap to prevent append from clobbering freeStk.  // ← 71:cap 钉死------防止日后 append 越界写坏池
	e.stk = m.freeStk[:len(stk):len(stk)]                 // ← 72:从池里切一段
	m.freeStk = m.freeStk[len(stk):]                      // ← 73
	                                                      // ← 74
	for j := range stk {                                  // ← 75:拷贝栈
		e.stk[j] = uintptr(stk[j])                    // ← 76
	}                                                     // ← 77
	if m.hash == nil {                                    // ← 78:懒建 map
		m.hash = make(map[uintptr]*profMapEntry)      // ← 79
	}                                                     // ← 80
	m.hash[h] = e                                         // ← 81:挂桶
	if m.all == nil {                                     // ← 82:全量链为空
		m.all = e                                         // ← 83
		m.last = e                                        // ← 84
	} else {                                              // ← 85
		m.last.nextAll = e                                // ← 86:尾插(保插入序)
		m.last = e                                        // ← 87
	}                                                     // ← 88
	return e                                              // ← 89
}                                                        // ← 90(文件完)
四个设计逐个对号:
| 设计 | 代码 | 为什么 |
|---|---|---|
| 滚动哈希 | 30~36 行 h<<8 + uintptr(x)*41 |
直接对 []uint64 逐格算桶号,不用先把栈变成字符串 |
| 拉链 | hash[h] + nextHash |
哈希碰撞了就挂成一串,Go 原生 map 只当「桶数组」用 |
| 全量链 | all / last + nextAll |
另存一条插入序链,供 build 遍历 |
| 空闲池 | free(128)/ freeStk(1024) |
成批分配,避免每条样本都 new |
Search: 标签是 Go 里少见的写法:continue Search 从内层「逐 PC 慢比」直接退回外层拉链的下一个条目,比层层 break 干净。
为什么不直接用
map[string]*entry(栈序列化成 key)?------样本流里每秒百条都要走查;这里避免了每次的字符串序列化分配,且 MTF 让热栈停在链头。这是「runtime 品味」的典型样本。
9.4 难点 H|profMap:按 (栈, tag) 即时去重,为什么不用 mapstring
在纠结什么 :b.m.lookup(stk, tag).count += ... 这一行是整条流水线的「减压阀」,可 profMap 的实现看着比普通 map 复杂得多:拉链、全量链、空闲池、cap 钉死、move-to-front。
通俗地说 :先看它要解决的现实------每秒上百条样本流过来,绝大多数是重复的栈 。要是每条都新建条目,文件会爆炸;要是每条都把栈序列化成字符串当 key,光分配就够呛。所以源码直接对 []uint64 做滚动哈希,一个字符串都不造。
move-to-front :命中且不在链头时,把条目摘下来插到链头(51~54 行)。热栈(反复出现的那个)永远排第一,下次一眼就命中------少数栈反复出现的负载形态收益最大。
cap 钉死 :e.stk = m.freeStk[:len(stk):len(stk)] 那个三索引切片,把容量也钉成 len(stk)。因为 freeStk 是从大池子里切出来的,万一以后有人对 e.stk 做 append,不钉死就会越过边界写进池子里别人的栈,把整张表污染。
最小例子(示意,真实哈希见 §9.3):
go
for _, x := range stk {
	h = h<<8 | (h >> (8 * (unsafe.Sizeof(h) - 1)))
	h += uintptr(x) * 41
}
每读一格,左旋 8 位再加 41 倍,标签指针最后也滚进去------于是「同栈 + 同标签」必然落在同一个桶。
一句话记住 :不把栈变成字符串 ,直接对数字算哈希;热栈提到链头,栈池 cap 钉死防越界。
对应源码行 :§9.3 的 30~36 行滚动哈希、51~54 行 move-to-front、60~73 行空闲池与 cap 限制;§9.3 结尾那句「为什么不直接用 mapstring」。
10 protobuf.go:手写的 wire-format 编码器(1~141 行)
10.1 先建画面:只带一把螺丝刀的字节工
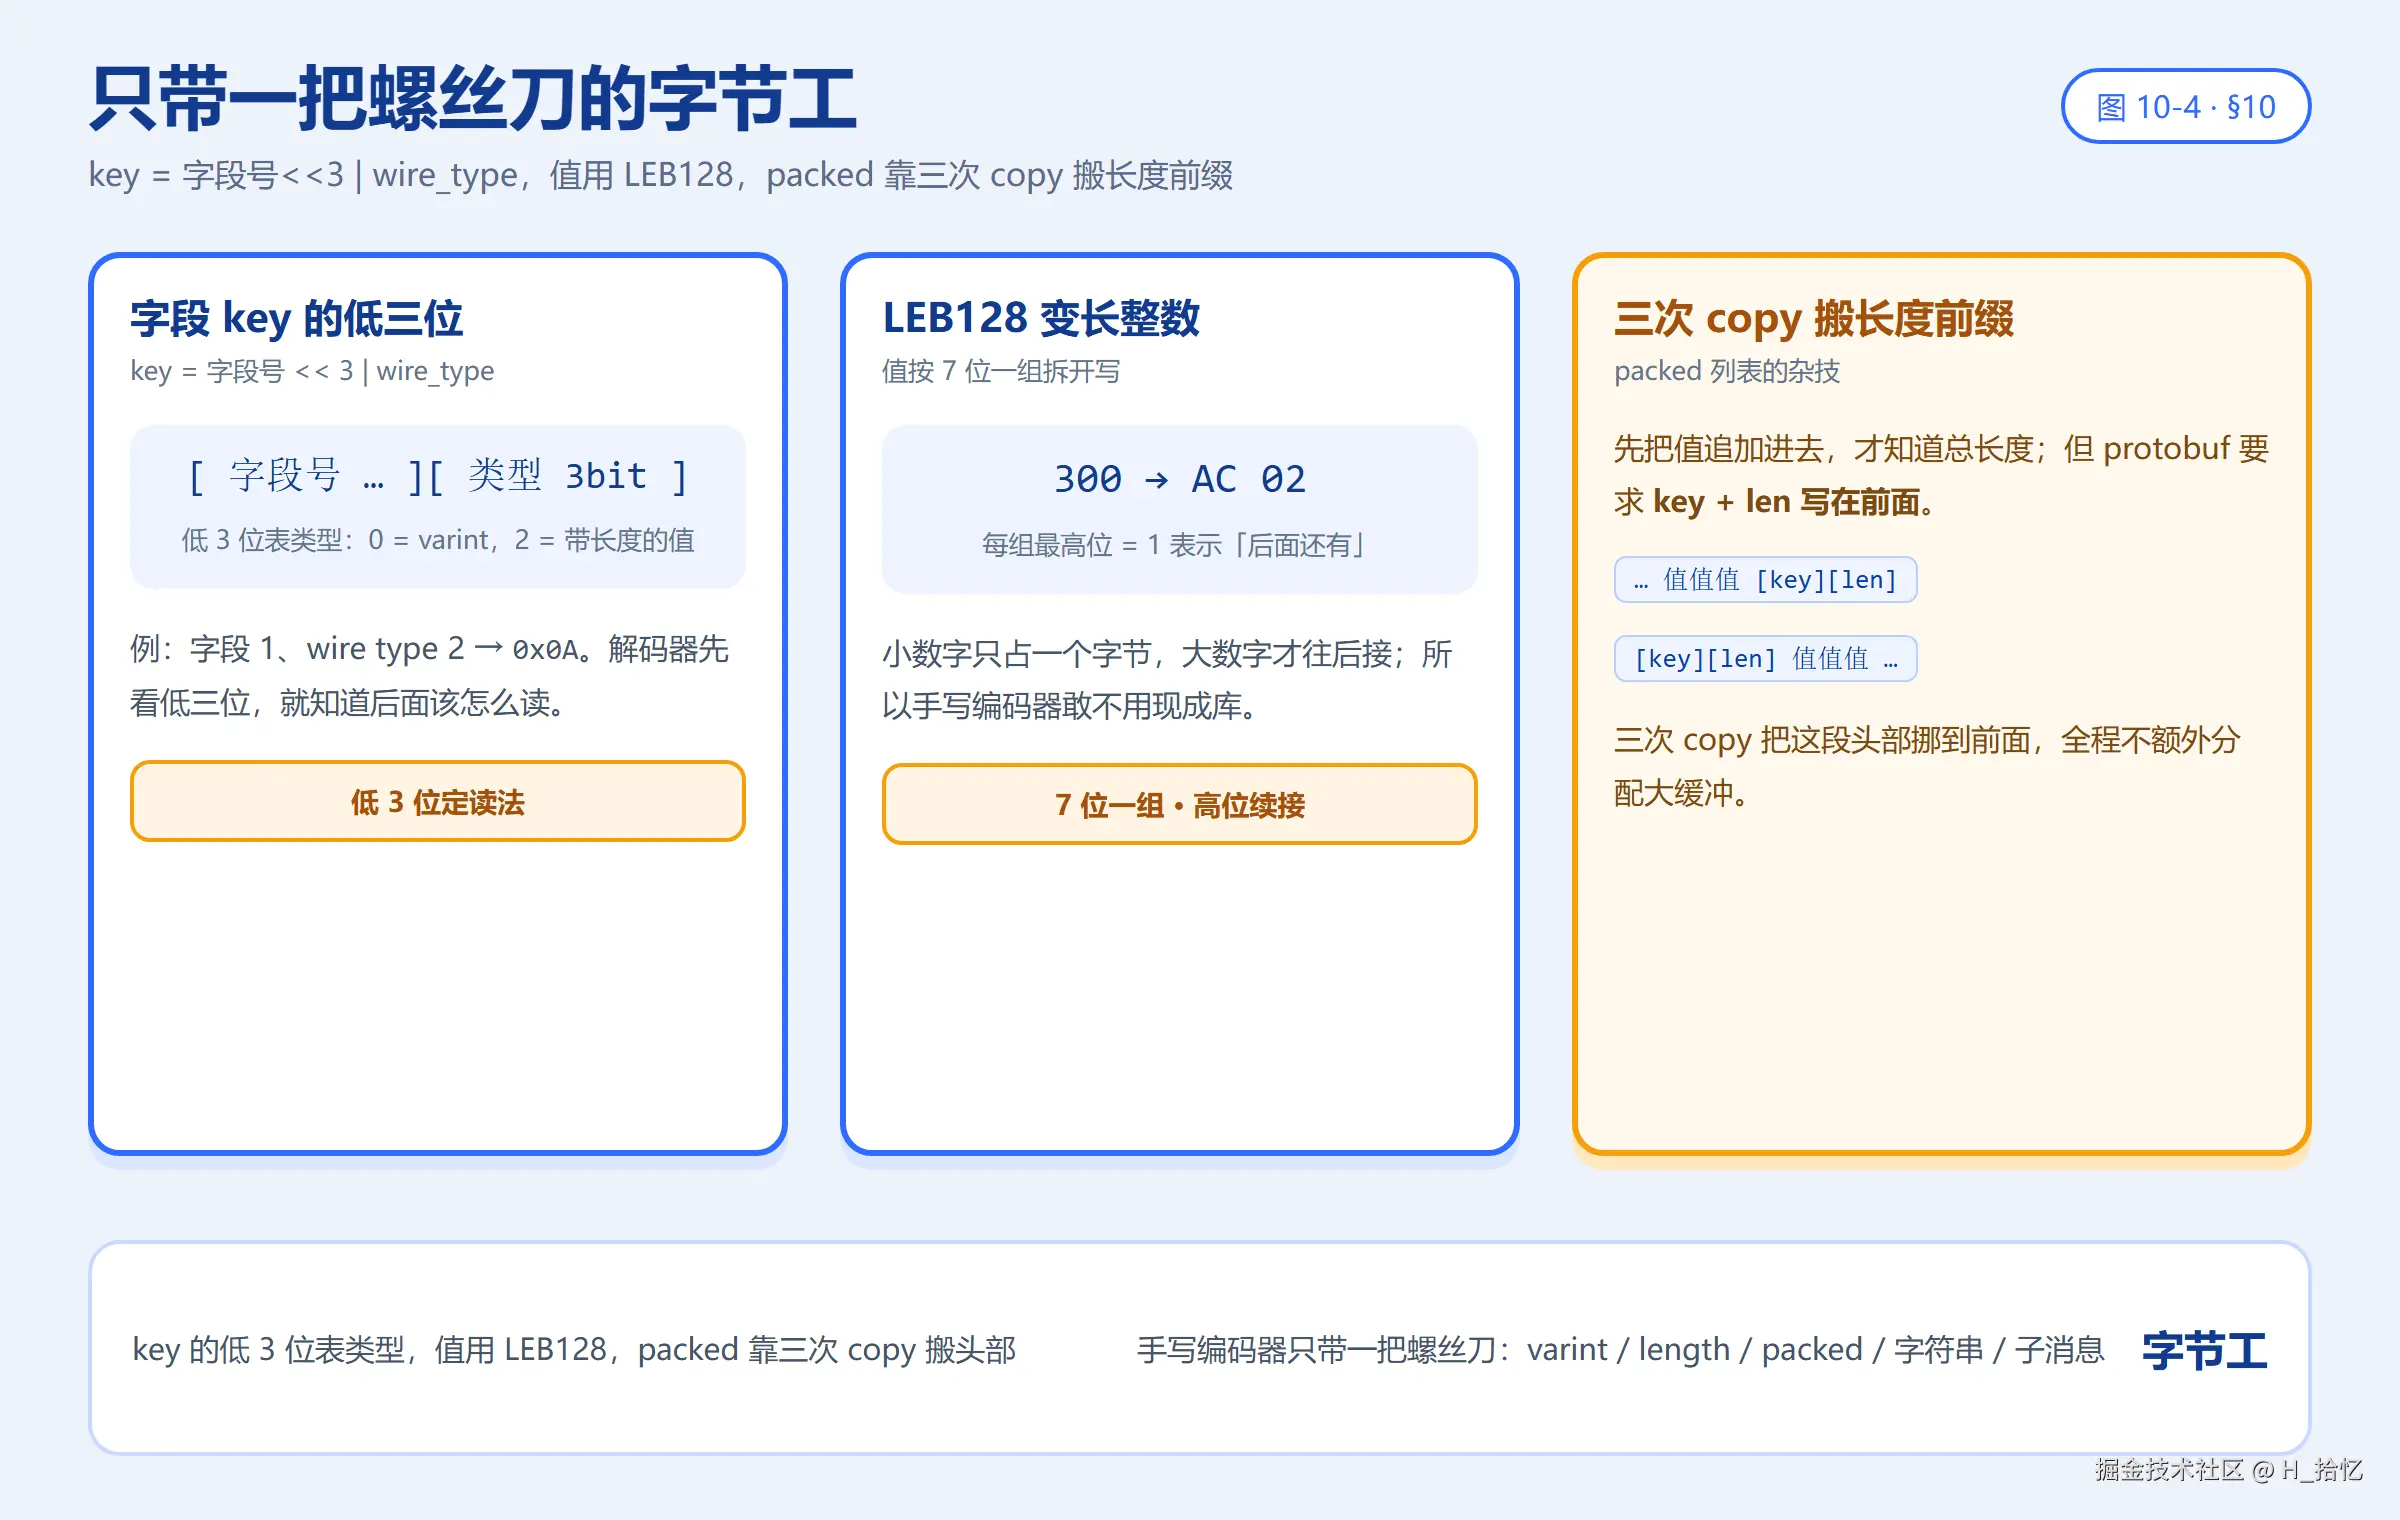
图 10-4 varint 与 wire-format:字段 key = 字段号左移 3 位按位或 wire_type,值用 LEB128 变长整数,packed 列表靠三次 copy 把长度前缀搬到头部。
看图时抓三处:key 里低 3 位表类型、varint 按 7 位一组用最高位标记续接、三次 copy 把 key+len 从尾部挪到头部;对应 §10.2、§10.4 与难点 I / J。
protoc 生成的代码要带 reflect / 初始化开销,这里手写一个只写的最小实现。整个编码器只有三件工具:一根 data []byte 缓冲、一张 tmp [16]byte 草稿纸、一个 nest int 嵌套深度计数。它能做的只有「写」:写 varint、写长度定界、写字符串、写 bool、开 / 关子消息------连「读」都没有。
它面对的核心麻烦只有一个:长度前缀必须在内容前面,可长度只有把内容写完才知道。这一节的「三次 copy 杂技」就是为它准备的。
10.2 源码逐行:varint / length / uint64
go
// (protobuf.go) A protobuf is a simple protocol buffer encoder.
type protobuf struct {
	data []byte        // ← 9:输出缓冲
	tmp  [16]byte      // ← 10:endMessage 的前插 scratch(三次 copy 杂技用)
	nest  int          // ← 11:嵌套深度(flush 判"消息边界"用)
}                     // ← 12
                      // ← 13
func (b *protobuf) varint(x uint64) {     // ← 14:LEB128 变长整数------proto 的地基
	for x >= 128 {                     // ← 15:还有高位
		b.data = append(b.data, byte(x)|0x80)  // ← 16:低 7 位 + 继续位
		x >>= 7                         // ← 17
	}                                  // ← 18
	b.data = append(b.data, byte(x))   // ← 19:最后一字节无继续位
}                                      // ← 20
                                       // ← 21
func (b *protobuf) length(tag int, len int) {  // ← 22:长度定界符(tag,wire_type=2)+长度
	b.varint(uint64(tag)<<3 | 2)           // ← 23:字段号<<3 | wire_type
	b.varint(uint64(len))                  // ← 24
}                                          // ← 25
                                           // ← 26
func (b *protobuf) uint64(tag int, x uint64) {  // ← 27:单 varint 字段(wire_type=0)
	// append varint to b.data
	b.varint(uint64(tag)<<3 | 0)             // ← 29:key
	b.varint(x)                              // ← 30:value
} // ← 31三行「按位或」是同一个动作:uint64(tag)<<3 | 0 是「单个数」字段的 key,uint64(tag)<<3 | 2 是「带长度的一段」的 key,byte(x)|0x80 是 varint 的继续位。低 3 位放类型,高位放字段号------难点 I 专门拆这套布局。
10.3 源码逐行:packed 编码与三次 copy
packed 编码的三次 copy 杂技(33~51 行)------proto 规范:repeated 数值 >2 个元素时用「一个 key + 连续 varint + 总长度前缀」。问题是长度前缀在写完数据后才知道,而前缀必须在前面:
go
func (b *protobuf) uint64s(tag int, x []uint64) {
	if len(x) > 2 {                          // ← 34:>2 个才值得 packed(阈值来自 proto 惯例)
		// Use packed encoding
		n1 := len(b.data)                // ← 36:数据区起点
		for _, u := range x {            // ← 37:先把裸 varint 全写进去(此时还没 key!)
			b.varint(u)              // ← 38
		}                                // ← 39
		n2 := len(b.data)                // ← 40:数据区终点
		b.length(tag, n2-n1)             // ← 41:★把 key+长度**追加**在数据后面!
		n3 := len(b.data)                // ← 42:现在的终点
		copy(b.tmp[:], b.data[n2:n3])    // ← 43:① 把 key+len 暂存 tmp
		copy(b.data[n1+(n3-n2):], b.data[n1:n2])  // ← 44:② 数据整体后移,前面腾出 key+len 的空位
		copy(b.data[n1:], b.tmp[:n3-n2])  // ← 45:③ key+len 就位
		return                           // ← 46
	}                                        // ← 47
	for _, u := range x {                    // ← 48:≤2 个:普通逐字段编码
		b.uint64(tag, u)                 // ← 49
	}                                        // ← 50
}                                            // ← 51
len(x) > 2 才走 packed------元素太少时,省下的 key 字节还不够抵长度前缀的开销,直接逐字段写更划算。
10.4 源码逐行:Opt 变体、字符串与子消息收尾
go
func (b *protobuf) uint64Opt(tag int, x uint64) {   // ← 53:Opt 变体------零值不编码(proto 惯例,省字节)
	if x == 0 {
		return                                   // ← 55
	}                                               // ← 56
	b.uint64(tag, x)                               // ← 57
}                                                   // ← 58
                                                    // ← 59~70:int64/int64Opt(60~63:负数走补码 uint64,64/69 同构略)
func (b *protobuf) int64s(tag int, x []int64) {     // ← 72:int64 版 packed(73~89 与 uint64s 逐行同构)
	...                                              // ← 74~85(三次 copy 同上)
}                                                   // ← 90
                                                    // ← 91
func (b *protobuf) string(tag int, x string) {      // ← 92:字符串字段(wire_type=2)
	b.length(tag, len(x))                       // ← 93:key+len
	b.data = append(b.data, x...)               // ← 94:原始字节
}                                                   // ← 95
                                                    // ← 96
func (b *protobuf) strings(tag int, x []string) {   // ← 97:repeated string(无 packed------string 不是定长)
	for _, s := range x {                       // ← 98
		b.string(tag, s)                    // ← 99
	}                                           // ← 100
}                                                   // ← 101
                                                    // ← 102~108:stringOpt(空串跳过)/
                                                    // ← 110~116:bool(1/0)/
                                                    // ← 118~123:boolOpt(false 跳过)
Opt 系列(零值不编码)是 proto 惯例:值为 0 / 空串 / false 时整个字段都不写,省字节。strings 没有 packed------字符串不是定长数值,没法打包成连续 varint。
go
type msgOffset int                       // ← 125:startMessage 的返回(占位位置)

func (b *protobuf) startMessage() msgOffset {  // ← 127:进入子消息
	b.nest++                                // ← 128:深度 +1(flush 据此拒绝切断)
	return msgOffset(len(b.data))          // ← 129:记下消息内容起点
}                                           // ← 130
                                            // ← 131
func (b *protobuf) endMessage(tag int, start msgOffset) {  // ← 132:子消息收尾------同款三次 copy!
	n1 := int(start)                    // ← 133:内容起点
	n2 := len(b.data)                   // ← 134:内容终点
	b.length(tag, n2-n1)                // ← 135:key+len 先追加到尾部
	n3 := len(b.data)                   // ← 136
	copy(b.tmp[:], b.data[n2:n3])       // ← 137:① 暂存
	copy(b.data[n1+(n3-n2):], b.data[n1:n2])  // ← 138:② 内容后移
	copy(b.data[n1:], b.tmp[:n3-n2])    // ← 139:③ 就位
	b.nest--                            // ← 140:深度 -1
}                                       // ← 141(文件完)
startMessage / endMessage 正是 §2 那些 pb* 三明治的两端:nest++ / nest-- 就是难点 C 里那道「现在能不能刷盘」的闸门,而 endMessage 用的是与 uint64s 完全同款 的三次 copy,只是 n1 换成 startMessage() 记下的内容起点。
为什么不用「预留长度位 + 回填」? varint 长度本身不定长(1~10 字节),预留多了浪费、预留少了放不下;尾部追加 + 整体搬移一次到位,代码只有三行。tmp [16]byte 恰好 ≥ 最大 key(2B)+ 最大 len(10B)。
10.5 难点 I|varint / field number 怎么读
在纠结什么 :b.varint(uint64(tag)<<3 | 2) 这一行,凭什么就能让 pprof 工具认出「这是个字段」?
通俗地说:protobuf 的字节里没有字段名、没有括号、没有逗号,全是数字。规矩只有两条:
- 每个字段先写一个 key :
key = 字段号 << 3 按位或 wire_type。低 3 位说「值怎么摆」,高位说「这是第几号字段」。 - wire_type 只有两种在这里用得上 :
0表示「后面跟着一个 varint 数」;2表示「后面跟着长度 + 一段字节」。
于是 tag<<3 按位或 0 就是「单个数」字段,tag<<3 按位或 2 就是「长度定界」字段。§1.4 那张常量表里的 tagProfile_Sample=2、tagSample_Value=2,说的就是字段号,会被左移 3 位塞进 key。
varint 怎么读:把一个整数按 7 位一组拆开,每组前面加一位「还有没有下一组」的标记。
| 规则 | 通俗解释 |
|---|---|
x >= 128 时 |
取低 7 位,加上 0x80 的继续位,写出去;x >>= 7 继续 |
x < 128 时 |
写最后一个字节,不带继续位 |
| 解码 | 读到最高位是 0 的字节就停,把各段 7 位拼回去 |
所以小数字(0~127)只占 1 字节,这正是难点 A 里「页码比字符串便宜」的底层原因。
最小例子 :字段号 9(tagProfile_TimeNanos)、wire_type 0 的 key 是 9<<3 = 72;值 300 的 varint 是两字节(因为 300 超过 127)。整条字段就是「72,300 的两字节」共 3 字节,没有字段名、没有等号。图 10-4 画的「key + len + 数据」就是这套布局。
一句话记住:字节里没有名字,只有「编号 + 类型」的 key;varint 让小数字只占一格。
对应源码行 :§10.2 varint 的 for x >= 128 循环、length 与 uint64 各一行;§1.4 字段号常量表。
10.6 难点 J|三次 copy 杂技:长度前缀为什么先追加到尾部
在纠结什么:嵌套消息和 packed 列表都要「key + 长度 + 内容」,可长度只有把内容写完才知道。为什么源码不「先留几个空字节,写完回填」,非要尾部追加再搬三次?
通俗地说 :因为长度本身是 varint,不定长。§10.4 结尾那句给了答案:长度可能是 1~10 字节,预留多了浪费、预留少了放不下。
于是源码反过来做:先把内容裸写进去,再把「key + 长度」追加到尾部 (这时长度终于知道了),然后三次 copy 把这段前缀挪到内容前面:
| 步 | 代码做什么 | 通俗解释 |
|---|---|---|
| ① | copy(b.tmp[:], b.data[n2:n3]) |
把刚追加的 key+len 暂存到 16 字节草稿纸 |
| ② | copy(b.data[n1+(n3-n2):], b.data[n1:n2]) |
把内容整体往后挪,前面空出前缀的位置 |
| ③ | copy(b.data[n1:], b.tmp[:n3-n2]) |
把前缀从草稿纸贴到空出来的位置 |
tmp [16]byte 为什么是 16?源码给了算式:足够放下「最大 key(2 字节)+ 最大 varint 长度(10 字节)」。
最小例子 :uint64s 里 len(x) > 2 才走 packed------先把三个裸 varint 写进 data(n1 到 n2),再 b.length(tag, n2-n1) 追加 key + 长度(n2 到 n3),三次 copy 之后,data[n1:] 变成「key | 长度 | 值1 | 值2 | 值3」。若只有 2 个或更少元素,源码直接逐字段写,不折腾。
endMessage 用的是完全同款 三次 copy,只是 n1 换成 startMessage() 记下的消息内容起点------所以 pbValueType、pbSample、pbLine 那些「三明治」全靠它收尾。
一句话记住 :长度事后才知道、又不定长,那就先写后面、再整体搬家,三行 copy 一次到位。
对应源码行 :§10.3 的 33~51 行 uint64s 三行 copy、§10.4 的 132~140 行 endMessage;§10.4 结尾「为什么不用预留长度位 + 回填」那段。
11 串起来:一条 CPU 记录走完全程
前十节是按源码文件顺序拆的零件。这一节只做一件事:跟着一条最普通的记录 从进 addCPUData 到出 cpu.pprof,把 §0.3 那张地图真正跑一遍。
开场 :newProfileBuilder 已经建好(strings 里只有空串、zw 是 gzip.BestSpeed、readMapping 已填好 mem)。
| 步 | 真实函数 / 字段 | 发生了什么 | 源码 |
|---|---|---|---|
| 1 | addCPUData 首记录 |
havePeriod 为假 → 检查 data[0]==3 且 data[2]!=0,算出 b.period = 1e9 / int64(data[2]);data = data[3:]、tags = tags[1:] 把头记录消费掉 |
§4 |
| 2 | 主循环 for len(data) > 0 |
count := data[2]、stk := data[3:data[0]]、data = data[data[0]:]、tag := tags[0]、tags = tags[1:] |
§4 |
| 3 | 溢出判定 | 若 count==0 && len(stk)==1,把 count 改成 stk[0](丢失数),栈换成 lostProfileEvent 的伪 PC |
§4 |
| 4 | b.m.lookup(stk, tag).count += int64(count) |
同一个栈 + 同一个标签,只把计数加上去,不新增条目 | §4、§9 |
| 5 | build:b.end = time.Now() |
写 time_nanos,CPU 专属再写两列 ValueType、时长、周期类型、周期 |
§5 |
| 6 | for e := b.m.all; e != nil; e = e.nextAll |
按插入序遍历去重表 | §5 |
| 7 | values[0]=e.count、values[1]=e.count*b.period |
列①样本数、列②样本数乘周期 = CPU 纳秒 | §5 |
| 8 | locs = b.appendLocsForStack(locs[:0], e.stk) |
栈 → 一串 Location 编号(内部调 allFrames、pcDeck.tryAdd、emitLocation) |
§3、§6、§7 |
| 9 | b.pbSample(values, locs, labels) |
写一条 Sample,且每样本 flush 一次 |
§2 |
| 10 | emitLocation → stringIndex |
遇到新函数名 / 文件名,先登记进 strings,字段里写页码 |
§2、§7 |
| 11 | 收尾 | 写 Mapping 表、写 tagProfile_StringTable、zw.Write(b.pb.data)、zw.Close() |
§5 |
一条具体记录长什么样(§4.2 的大注释给了格式):
| 位置 | 值 | 含义 |
|---|---|---|
data[0] |
3+n |
这条记录一共占几格 |
data[1] |
时间戳 | 原注释明确写着「忽略」 |
data[2] |
count |
这条记录代表几个样本 |
data[3:data[0]] |
栈 | 一串 PC |
整趟最核心的一句话 :输入是「一串数字」,输出是「一份档案」;中间那步
b.m.lookup(...).count += ...就是把成千上万条流水账压成几百行样本的唯一动作。没有它,文件会爆炸。
把三行 minimal 版摆在一起看,全部魔法都在第三行:
go
count := data[2]
stk := data[3:data[0]]
b.m.lookup(stk, tags[0]).count += int64(count)
第一行取样本数、第二行切出栈、第三行查表、命中就累加、没命中就新建。后面所有 Location / Function / Mapping / string_table / gzip,都只是把这张去重表里的内容翻译并装箱。
12 一页纸速查:不变量
这里把散在各节的「必须成立」翻成「通俗解释 / 谁保证 / 坏了会怎样」。读不下去时回来问一句「这句在守哪条?」,通常就通了。
| # | 通俗解释 | 谁保证 | 坏了会怎样 |
|---|---|---|---|
| 1 | 所有字符串先登记字典,字段只写页码 | stringIndex + strings / stringMap |
文件膨胀、同一函数无法聚合 |
| 2 | 0 号页码恒为空串 | newProfileBuilder 的 strings: []string{""} |
违反 proto 惯例,工具解析错位 |
| 3 | 同栈 + 同 tag 只累加计数,不新增条目 | profMap.lookup |
去重失效,文件爆炸 |
| 4 | 缓冲只在消息边界刷盘 | flush 的 nest == 0 |
半截消息进 gzip,文件损坏 |
| 5 | 长度前缀事后才知道,用三次 copy 搬到头部 | endMessage / uint64s |
预留位数不对,字节错位 |
| 6 | 子消息内容区里不能再开子消息 | emitLocation 的 newFuncs 延后补写 |
Function 被当成 Location 字段 |
| 7 | deck 会复用底层数组,缓存必须拷贝 | emitLocation 里两次 append([]T{}, ...) |
缓存里的 PC 被下次写入覆写 |
| 8 | 一个 Location 表达一整条内联链 | pcDeck 三判据 + line[] |
内联层级丢失,火焰图对不上 |
| 9 | 每条样本都要收尾再刷 | pbSample 末尾 b.flush() |
大剖析把 pb.data 攒爆内存 |
| 10 | 文件 = gzip(protobuf),收尾要 Close |
build 的 zw.Write + zw.Close() |
gzip 缺 footer,工具读不出 |
这十条是整篇源码的验收标准。每一个看着绕的位运算 / 拷贝 / 状态机,最后都能归到其中一条上。
13 最容易读错的 9 件事
这些是读这份源码时最高频的误解,逐条回看对应节即可澄清。
1|「addCPUData 第一条记录是样本」 不是。首记录是元数据 :data[0] 必须等于 3、data[2] 是采样率 hz,源码算 b.period = 1e9 / int64(data[2])(100Hz → 10,000,000 纳秒),然后 data = data[3:]、tags = tags[1:] 把它消费掉。这段只在 !b.havePeriod 时执行一次(§4、难点 D)。
2|「addCPUData 的时间戳会写进文件」 不会。§4.2 注释明写「data[1] = 时间戳(忽略)」。文件里的时间来自 build 的 b.start / b.end,不是记录流里的那个数字(§5)。
3|「溢出记录是某种特殊通道 / 特殊字段」 不是。它就是一条普通记录,靠 count==0 && len(stk)==1 这个内容指纹 认出来,然后把栈换成 lostProfileEvent 的伪 PC(+1 保持 return-PC 语义)。「丢了多少」最终会出现在火焰图里(§4)。
4|「flush 只是省内存,随便什么时候刷都行」 差得远。nest == 0 是硬约束,保证「消息边界对齐」。在 startMessage / endMessage 之间刷,会把没回填前缀的半截消息送进 gzip(§2、难点 C)。
5|「values[1] 是实测出来的 CPU 时间」 不是实测。build 里直接 values[1] = e.count * b.period,是样本数乘周期 算出来的估计 CPU 纳秒;duration_nanos 才是 b.end.Sub(b.start) 的真实墙钟时长。两者口径不同,请留意区分(§5)。
6|「这个 encoder 既写又读,能直接把 pprof 文件解析回来」 不能。生产端只实现「写」:varint / length / 字符串 / bool / 嵌套消息,连「读」都没有;解析是 pprof 工具那一侧的事。这也是它敢只留三个字段的原因(§1、§10、难点 B)。
7|「b.locs 缓存里存的切片可以直接引用 deck 的」 不行。emitLocation 里 pcs 和 firstPCFrames 都 append([]T{}, ...) 拷贝过,因为 defer b.deck.reset() 之后 deck 的底层数组会被复用;直接引用等于埋一颗定时炸弹(§7、难点 F)。
8|「pcDeck 三判据是精确规则」 不是。§6.3 明说「都不完美,合起来够用」,是启发式 :Func==nil、Entry 相同、Name 不同三条分别排除非内联、不同函数、递归,单条都有反例(§6、难点 E)。
9|「parseProcSelfMaps 把 maps 每一行都收进表」 只收可执行段。perm[2] != 'x' 跳过、inode==0 且无名跳过、(deleted) 后缀去掉;[vdso] 这类 inode 0 但有名的反而放行(§8、难点 G)。
14 五分钟复述卡
能把下面 8 句连着讲给别人听(哪怕讲得磕巴),这套机制就算立住了。
- 流水线上 ④ 抄账员拿到的是一串裸 uint64,不是结构体------因为 ③ 账本在信号处理器里,只写得进数字。
addCPUData先按暗号切记录:第一格长度、第二格时间(忽略)、第三格样本数、后面是栈;首记录是周期元数据,100Hz 换成 10,000,000 纳秒。- 所有名字先登记
string_table,字段里只写页码;stringIndex就是那个查不到就追加的登记员。 - 同栈 + 同标签靠
profMap.lookup(...).count += ...即时累加,不新增条目,这是文件不爆炸的关键。 build遍历去重表,把每个栈交给appendLocsForStack;pcDeck用三条启发式把内联摊开的伪 PC 折回一个 Location ,line[]里装内联链。- 编码器是手写的 141 行:不能依赖 protoc,只「写」不「读」;字段 key 是「编号左移 3 位按位或类型」,值用 varint。
- 长度前缀事后才知道又不定长,所以尾部追加 + 三次 copy 搬到头部;
flush等nest == 0才敢刷,消息不能半截进 gzip。 - 最后写 Mapping 表与
string_table,zw.Write收尾、zw.Close()补 gzip footer------一份cpu.pprof就交出去了。
讲不出第 2 句 → 回难点 D;第 4 句 → §9、难点 H;第 5 句 → §6、难点 E;第 6 / 7 句 → §10、难点 B / I / J。
写到这儿,再把开头那个问题答一遍:那份 cpu.pprof 不是「一次性打印」出来的,而是抄账员 profileBuilder 把一串裸 uint64 按暗号切开,用 profMap 把重复的栈压成一行行计数,再用 allFrames / pcDeck / emitLocation 把每个 PC 翻成带 line[] 的 Location,最后用一百多行手写的 varint 编码器把五张表灌进 gzip、关掉流补上 footer 才交出去的。函数名之所以在火焰图里只出现一次,是因为它早就登记进字典,表里只留了页码;长度前缀之所以看着别扭地先写到尾部,是因为它不定长,只能在内容写完那一刻才知道自己该占几格。
输入是一串数字,输出是一份档案,中间全靠去重、折叠和三次 copy------把这三件事记住,那些看似绕的结构,就都能解释成「好像也只能这么写」。