JS 逆向 / 开源工具解析
伪造一份"浏览器身份证":sdenv 是怎么骗过环境检测的
832 Star 的开源项目,把 jsdom 改成了一个"骗得过盘问"的浏览器。拆开它的 21 个补丁,看反爬与补环境这场身份攻防。
免责声明(务必先读)
本文仅作技术研究与原理学习,介绍的是一个开源工具的设计思路。sdenv 官方仓库明确声明:项目仅供学习、研究与技术交流,不得用于商业或违法用途;使用者须遵守当地法律法规、尊重目标网站服务条款与隐私政策、遵守 robots.txt、不对任何服务器造成负担、不采集受版权保护或个人隐私的数据。
绕过网站反爬机制可能违反《计算机信息系统安全保护条例》《网络安全法》及目标网站服务条款。本文不提供任何针对具体网站的攻击步骤,也不鼓励对任何真实站点发起请求。是否使用、如何使用,请自行评估法律与合规风险,后果自负。
一、先说人话:补环境到底在补什么
做过 JS 逆向的人都知道一个痛:从网站扒下来一段混淆 JS,扔进 Node 里 eval,它立刻就报错------
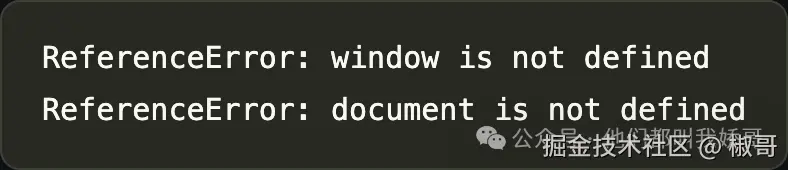
好,你造个假的 window = {}。它又问你要 document.cookie、要 navigator.userAgent、要 screen.width。你好不容易补齐,它开始反向审问你:
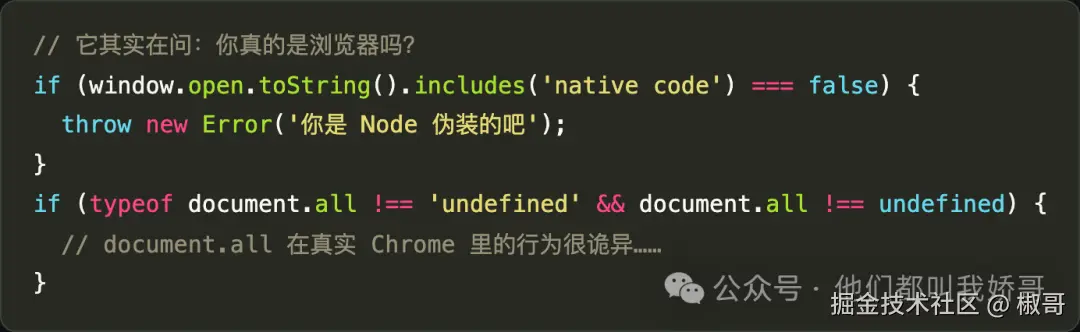
这就是补环境的本质战场 :不是"让代码跑起来",而是让代码在跑的过程中,找不到任何自己是假的证据。
反爬脚本会检查函数是不是原生的(toString() 里有没有 native code)、检查对象属性描述符、检查 document.all 这种浏览器里行为怪异的历史遗留物、检查各种 API 的参数个数和返回值。你补得再全,只要有一个细节露馅,它就把你标记为机器人,返回 412 或者直接封 IP。
sdenv 就是专门干这件事的框架,而且它是冲着最难缠的那类对手去的------VMP 防护。
二、sdenv 是谁:一个 832 Star 的"站在巨人肩膀上"的项目
先看基本盘(数据来自 2026-11-19 拉取的 GitHub 仓库):
| 项目 | 值 |
| 仓库 | pysunday/sdenv |
| Star / Fork | 832 / 261 |
| 语言 / 协议 | JavaScript / BSD-3-Clause |
| 创建时间 | 2024-03-10 |
| 最新版本 | 1.1.3(2025-12-16) |
| 核心依赖 | sdenv-jsdom、sdenv-extend、node-gyp 原生插件 |
项目描述写得很直白:
补环境框架 sdenv,针对 VMP 防护效果显著,理论通杀,配合同作者的纯算法逆向项目(rs-reverse)更好学习原理。
"站在巨人的肩膀上"这句 README 原话不是客套------它的思路确实是自己不造轮子:
-
DOM 仿真交给 jsdom
:jsdom 是 Node 生态里最成熟的 DOM 实现,能真实模拟浏览器 DOM 行为。sdenv fork 了一个专属版本 sdenv-jsdom,专门改掉了目标防护用来识别 jsdom 的那些特征。
-
浏览器特有 API 交给 sdenv-extend
:把 Node 端和浏览器端共用的环境补丁提取出来,做成一个扩展包。
-
jsdom 无法纯 JS 模拟的部分,用 C++ 原生插件补
:最典型的就是
document.all------ 这个诡异对象的行为必须用原生代码才能模拟到位,所以仓库里有个binding.gyp,安装时要跑node-gyp rebuild编译。
一句话概括它的定位:不是从零造一个浏览器,而是把 jsdom 改造成一个"骗得过环境检测"的浏览器。
三、原理拆解:三层结构 + 一个核心 API
3.1 整体架构
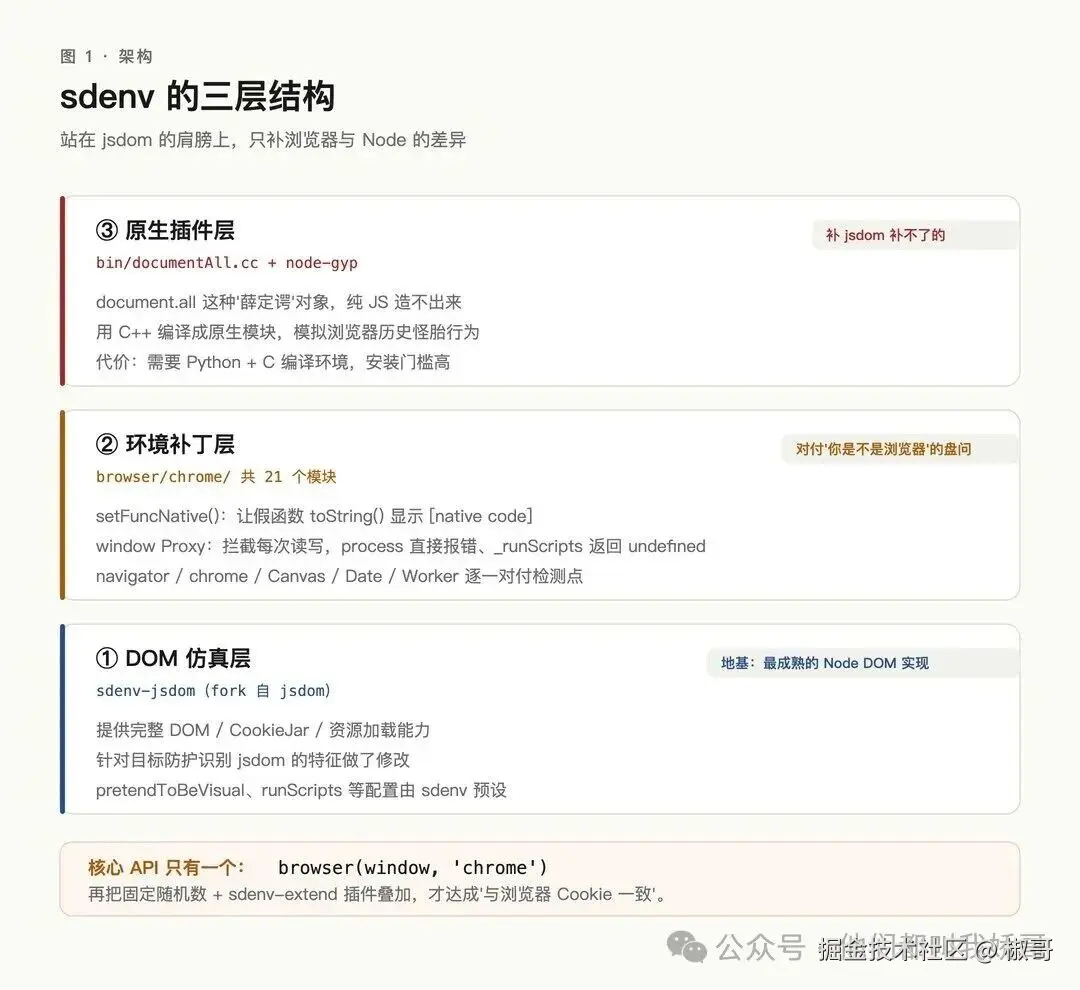
sdenv 的设计出奇简单。README 里说:核心 API 只有一个,就是 browser() 。
它的工作流程是这样的:
-
jsdomFromText()或
jsdomFromUrl()创建一个 jsdom 实例 -
在 jsdom 的
beforeParse钩子里调用browser(window, 'chrome') -
browser()往这个 window 对象上注入 21 个模块的环境补丁
-
得到的是一个"看起来像 Chrome"的 window,目标站点的混淆代码在里面愉快地运行
-
代码执行完,Cookie 写进了
cookieJar,导出即可用
3.2 核心 API:browser(window, type)
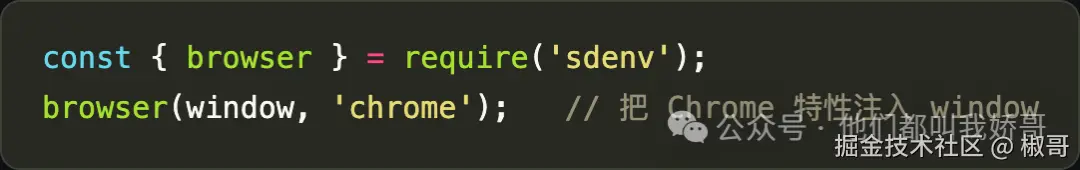
目前只支持 Chrome (Firefox / Safari 都是 N)。注入的内容在 browser/chrome/index.js 里一览无余------21 个模块依次加载:
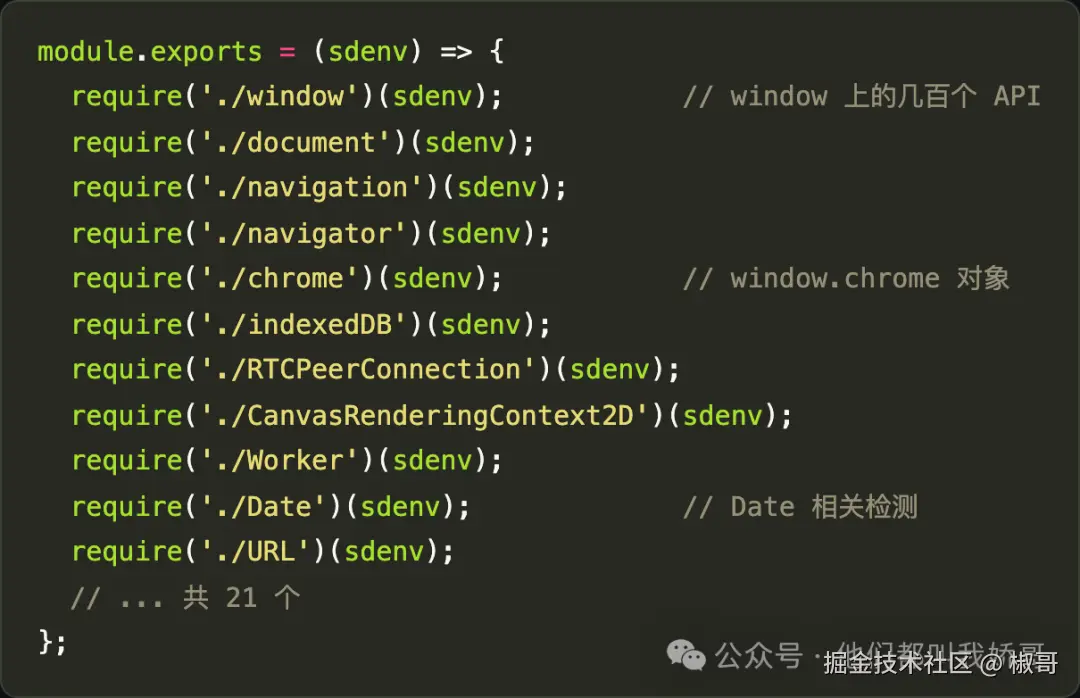
这 21 个模块不是随便堆的------每一个都对应一类反爬检测点 。navigator 对应指纹检测,chrome 对应 window.chrome 存在性检测(Headless 浏览器常在这里露馅),CanvasRenderingContext2D 对应 Canvas 指纹。
3.3 关键手法一:让假函数看起来"原生"
反爬脚本最爱用的一招是 Function.prototype.toString.call(func)------真浏览器的原生函数会返回 function atob() { [native code] },而你手写的假函数会返回完整的函数体,当场露馅。
sdenv 的解法是 setFuncNative()。看 window.js 里的实际调用:
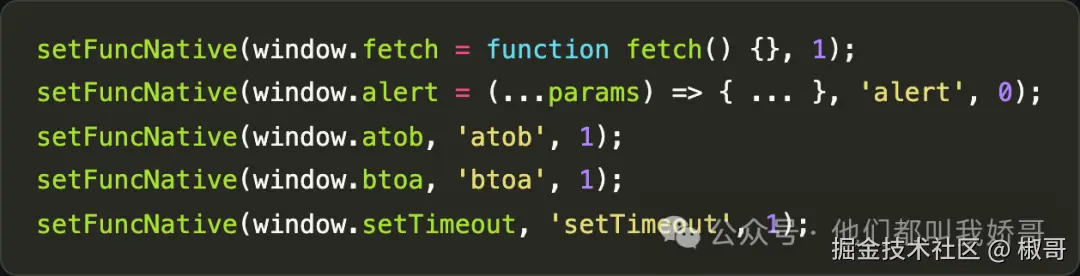
第二个参数是函数期望的参数个数 ------因为有些检测会检查 func.length。第三个参数在某些地方是函数名覆盖。经过这个处理,toString() 返回的就是 [native code],length 也对齐了。
3.4 关键手法二:window 代理,拦截每一次读写
更狠的检测不是看你"有没有"某个属性,而是监视你访问属性的行为。sdenv 提供了一个 window Proxy 配置:
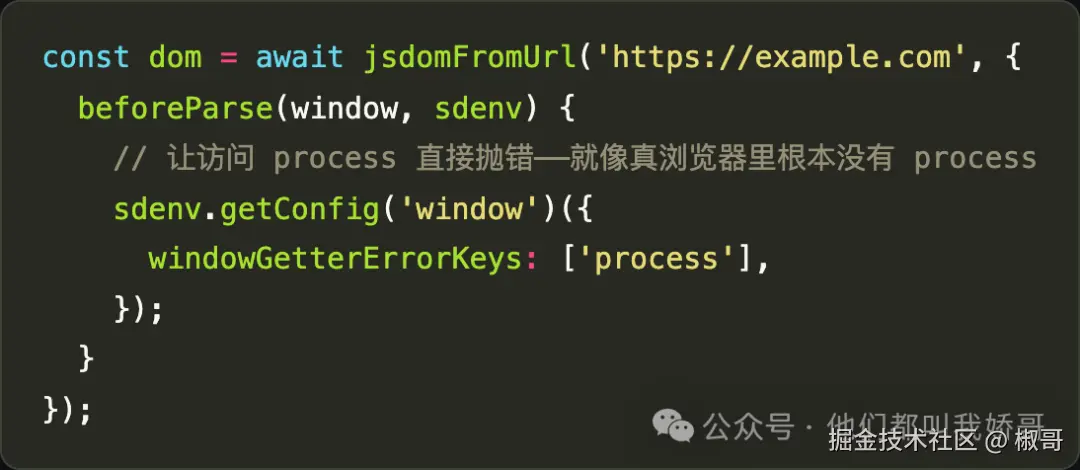
它能做四件事:
| 配置项 | 作用 | 典型场景 |
windowGetterErrorKeys |
取这些属性时报错 | 检测 process |
windowGetterUndefinedKeys |
取这些属性时返回 undefined | 检测 _runScripts |
log |
打印所有 get/set 操作 | 调试"它到底在读什么" |
parse |
改写任意属性的返回值 | 精确控值 |
其中 log 是逆向调试的神器------你可以看到混淆代码每一秒都在窥探 window 的哪些角落,然后针对性地补。这就是"补环境"这个行当的日常:跑一次,看日志,发现一个检测点,补上,再跑,再补。
3.5 关键手法三:原生插件补 document.all
document.all 是 IE 留下的历史怪胎:typeof document.all === 'undefined' 但 document.all !== undefined,用纯 JS 根本造不出这种"薛定谔的存在"。这类防护拿它当试金石。
sdenv 的解法是写 C++ 插件(bin/documentAll.cc + binding.gyp),安装时用 node-gyp 编译成原生模块。这也是它安装门槛高的根源:需要 Python + C 编译环境(Windows 要装 Visual Studio 并勾选"使用 C++ 的桌面开发",macOS 要 XCode)。
3.6 关键手法四:随机数固定
README 里有个容易被忽略的前提:作者是在"固定随机数 + 添加 sdenv-extend 部分插件"后,才达到 VMP 在 sdenv 里生成的 Cookie 与浏览器一致。
为什么?因为反爬脚本会故意用 Math.random() 生成一堆随机数,然后把结果混进 Cookie 做校验。真实浏览器里这些随机数无法预测------但只要你固定了种子,两边跑出同样的随机序列,就能得到同样的 Cookie。
这也是为什么 sdenv 的 Cookie 一致性是有条件的:它复现的不是"随机",而是"确定性" 。一旦目标站点换了算法、换了随机源,或者引入了真正依赖硬件熵的逻辑,这套前提就不成立了。
四、jsdom 是地基,sdenv 是整套伪装
第三章讲了 sdenv 的三层结构,其中第一层用的是"fork 版 jsdom"。这就引出一个最容易混淆的问题:sdenv 和 jsdom 到底什么关系?
一句话:jsdom 是通用 DOM 仿真库,sdenv 是专门骗过反爬检测的补环境框架------它把 jsdom 当地基,在上面盖了两层。
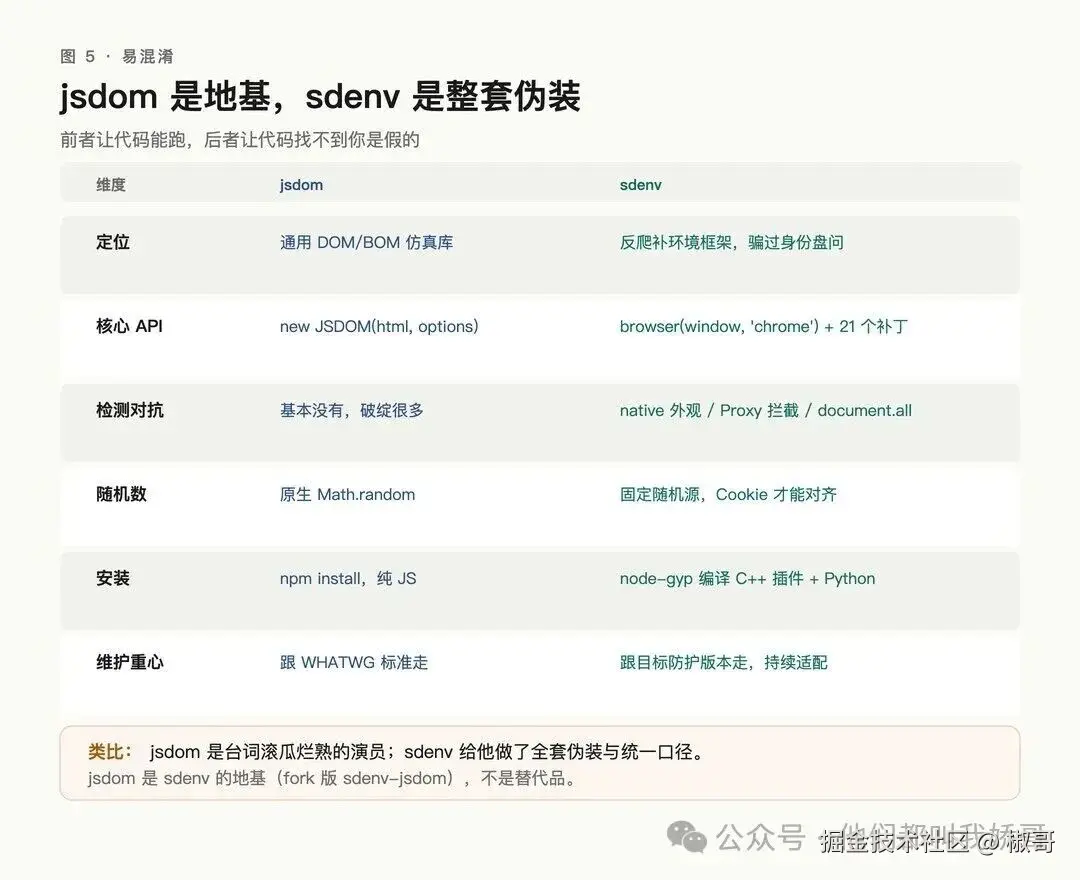
4.1 核心区别
| 维度 | jsdom | sdenv |
| 定位 | 通用 DOM/BOM 仿真(测试、SSR、爬虫) | 反爬对抗,不让代码发现自己在假环境里 |
| 核心 API | new JSDOM(html, options) |
browser(window, 'chrome') + 21 个补丁 |
| 检测对抗 | 基本没有,破绽很多 | native 外观 / Proxy 拦截 / document.all |
| 随机数 | 原生 Math.random |
固定随机源,Cookie 才能对齐 |
| 安装 | npm install,纯 JS |
node-gyp 编译 C++ 插件 + Python |
| 维护重心 | 跟 WHATWG 标准走 | 跟目标防护版本走,持续适配 |
4.2 目标不同,"够用"的标准就完全不同
jsdom 的标准是:DOM API 符合规范、测试能跑通。
sdenv 的标准是:混淆 JS 对你进行十几轮身份盘问时,找不到任何你是假的证据。
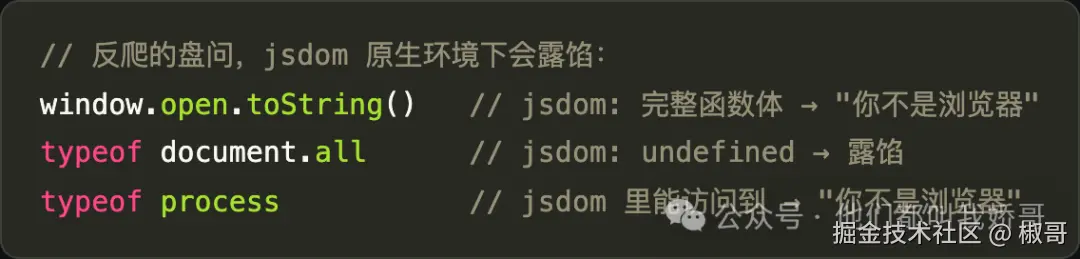
sdenv 逐条应对:setFuncNative() 让 toString() 返回 [native code],C++ 插件造出行为诡异的 document.all,window Proxy 让访问 process 直接抛错。
4.3 sdenv 不是 jsdom 的替代品,是使用者
它的三层结构里,第一层就是 fork 的 jsdom(sdenv-jsdom),改的是"目标防护用来识别 jsdom 的那些特征";第二层是 21 个环境补丁;第三层是 C++ 原生插件。jsdom 只是地基,上面两层才是 sdenv 的全部价值。
而"随机数固定"这件事,jsdom 里完全没有概念------原生 Math.random 就是随机。sdenv 把随机源固定住,让两边跑出同样的序列,才能得到一致的 Cookie。这既是它的独门绝技,也是它的脆弱点:对手一旦换随机源,这招就失效。
4.4 什么时候用哪个
| 场景 | 选择 |
| 单元测试、前端测试、SSR | jsdom(轻量、标准、够用) |
| 只是执行一段不设防的 JS | jsdom |
| 目标站点有 VMP / 环境检测 | sdenv(合规风险自担) |
| 想学习反爬检测原理 | 读 sdenv 的 21 个补丁模块,比读 jsdom 有价值 |
一个形象的类比:jsdom 像台词滚瓜烂熟的演员,sdenv 给这个演员做了全套伪装------伪造声纹(native code)、伪造证件(document.all)、统一幕僚口径(Proxy 拦截),连随机行为都提前编排好(固定随机数)。
五、怎么用:四条路,从简单到硬核
sdenv 提供四种使用方式,按上手难度排:
① npx(最省事,零安装)
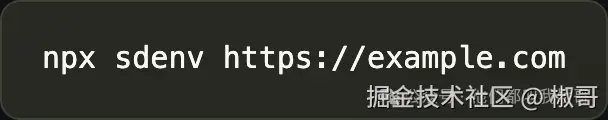
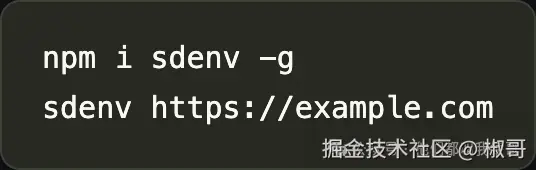
② 全局安装
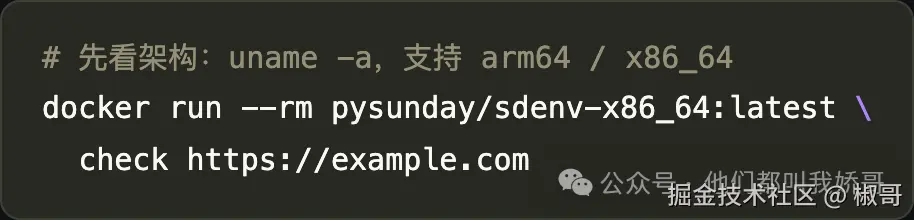
③ Docker(环境隔离,跨平台最稳)
④ npm 包(集成进自己的项目)
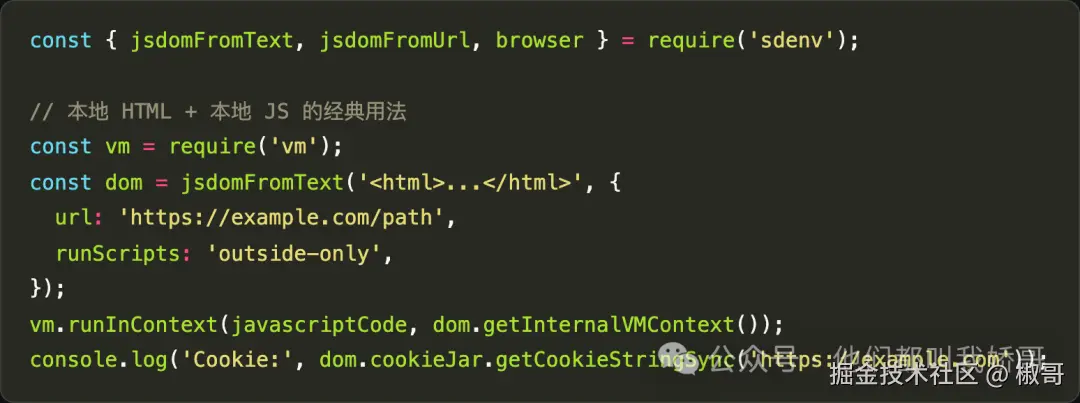
Node 版本是个坑:README 给了实测矩阵------v20.19.5 支持、v21.7.3 不支持、v22.21.1 支持、v23.11.1 支持、v24.12.0 支持、v25.2.1 支持。注意 v21.7.3 明确不支持,别踩。
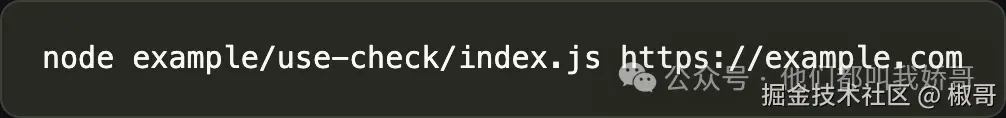
还有一个官方自检命令可以判断某网站适不适用:
六、风险清单:五条,包括最容易被忽视的合规问题
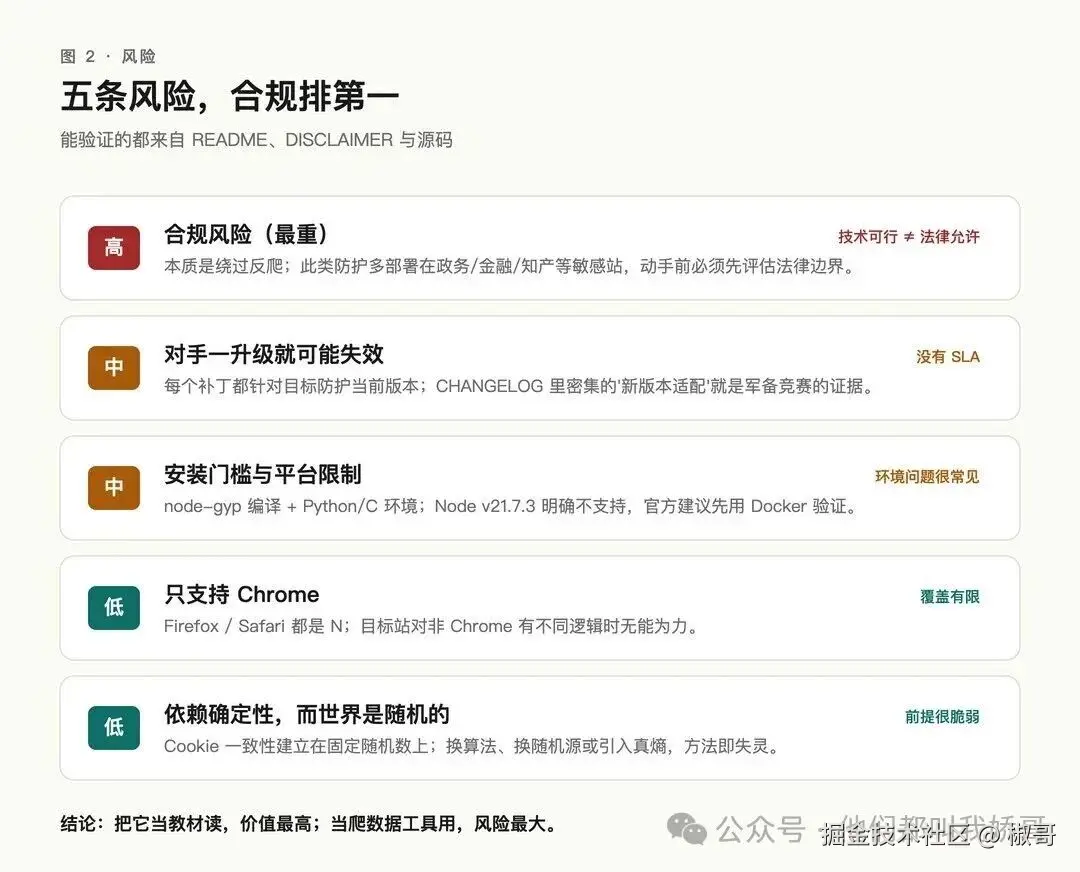
① 合规风险(最重)
这是本文开篇就加免责声明的原因。sdenv 的能力本质是绕过网站反爬机制,而这类 VMP 防护通常部署在政务、金融、知识产权等敏感站点。
对这类站点发起自动化请求,可能触及:
- 目标网站的《服务条款》与
robots.txt - 《网络安全法》《数据安全法》《计算机信息系统安全保护条例》
- 若涉及个人信息,还有《个人信息保护法》
技术可行 ≠ 法律允许。 这条风险不是"注意一下"级别的,是"动手之前必须先想清楚"级别的。
② 对手一升级就可能失效
README 自己说得很诚实:
该项目的开发基于 VMP 防护网站,不能保证在其它反爬虫产品上稳定使用。
它依赖的每一个"识别特征"------函数 native、document.all、随机数固定------都是针对目标防护当前版本 的。对方一升级,这些特征变了,补丁就从"隐形斗篷"变成"显眼标签"。CHANGELOG 里 2025 年密集的"新版本适配"提交就是明证:这是一场需要持续跟进的军备竞赛。
③ 安装门槛与平台限制
node-gyp 编译 + Python/C 环境 + 21 个环境模块,让它比普通 npm 包难装得多。Node 版本还有明确的"雷区"。官方甚至建议:"如不确定是否本地问题,可以先以 docker 方式运行验证"------这话翻译过来就是"环境问题很常见"。
④ 只支持 Chrome
Firefox / Safari 都是 N。目标站点如果针对非 Chrome 做了不同逻辑,sdenv 无能为力。
⑤ 它需要"确定性",而真实世界是随机的
前面说过,Cookie 一致性建立在固定随机数这个前提上。但很多现代反爬会引入设备指纹、时间熵、服务端下发的随机挑战。一旦随机源不在你能控制的范围内,这套方法就失灵了。
七、JVM 生态有没有类似的库
写到这里,一个很自然的问题浮出来:如果技术栈是 Java,有没有 sdenv 的对应物?
先给结论:没有一个开箱即用的"JVM 版 sdenv" 。有的是拆开后的零件,而且缺的那块恰好是最难的。
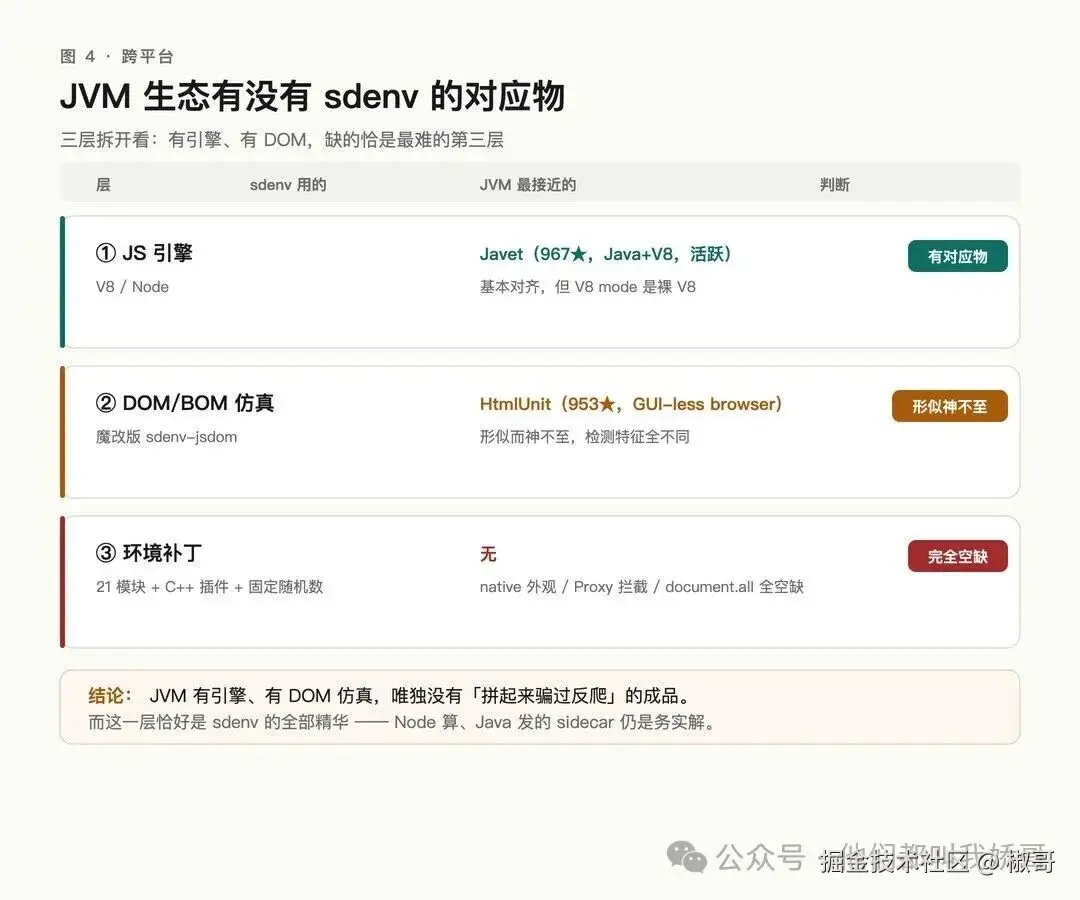
6.1 把 sdenv 拆成三层,逐层找对应
| sdenv 的层 | 它用的东西 | JVM 里最接近的对应物 | 差距 |
| ① JS 引擎 | V8 / Node | Javet(967★,Java+V8,仍在活跃维护) | 引擎层基本对齐 |
| ② DOM/BOM 仿真 | 魔改版 sdenv-jsdom | HtmlUnit(953★,GUI-less browser) | 形似而神不至 |
| ③ 环境补丁 | 21 个模块 + C++ 插件 + 固定随机数 | 无 | 完全空缺 |
第三层才是 sdenv 的真正价值------setFuncNative() 造 [native code]、window Proxy 拦截窥探、C++ 补 document.all、固定随机数对齐 Cookie。这一层在 JVM 里没有任何现成实现。
6.2 三个容易被误解的点
① Javet 的起点比 Node 更低,不是平移。
这点最常被想当然。Node = V8 + 内置 API,sdenv 是站在 Node 肩膀上补"浏览器和 Node 的差异"。而 Javet 的 V8 mode 是裸 V8 ------连 setTimeout 都没有(所以作者才另写了 Javenode,专门在 V8 mode 里补 Node API,但 2025 年初后就没怎么动)。
也就是说,在 JVM 上你要先补 Node,再补浏览器,比 Node 上多补一整层。
② HtmlUnit 看着像 jsdom,其实不是一条赛道。
它内置 JS 引擎,能做 DOM、表单、点击,但定位是网页测试框架 ,不是反爬对抗。更关键的是:这类防护针对 jsdom 的检测特征,是基于 jsdom 特有行为写的;你换成 HtmlUnit,检测特征完全不同------等于换了一套对手,从零开始对抗。
③ Nashorn 直接出局,GraalJS 只解决引擎层。
Nashorn 在 JDK 11 标记废弃、JDK 15 移除(JEP 372)。GraalJS 能用,Polyglot API 执行 JS 很舒服,但它同样不提供 DOM/BOM,补环境还是全靠自己写。
6.3 所以 Java 团队该怎么办
如果要在纯 JVM 里复刻,只有两条路:
-
自己造轮子
:Javet(V8 mode)+ 自己写 DOM + 自己写 21 类环境补丁 + C++ 补
document.all。工作量约等于重新实现一遍 sdenv,而且没有社区帮你跟进对手的版本升级。 -
进程隔离,但仍让 Node 管算
:把补环境的部分留在 Node 侧,Java 只保留 HTTP 客户端------Node 负责算出 Cookie 和签名,Java 负责发业务请求。职责切分干净,还能复用 Node 侧整个生态。
这第二条路,恰恰是我更推荐的方案。为了"纯 Java"把问题复杂化,通常不划算。
八、适合谁,不适合谁
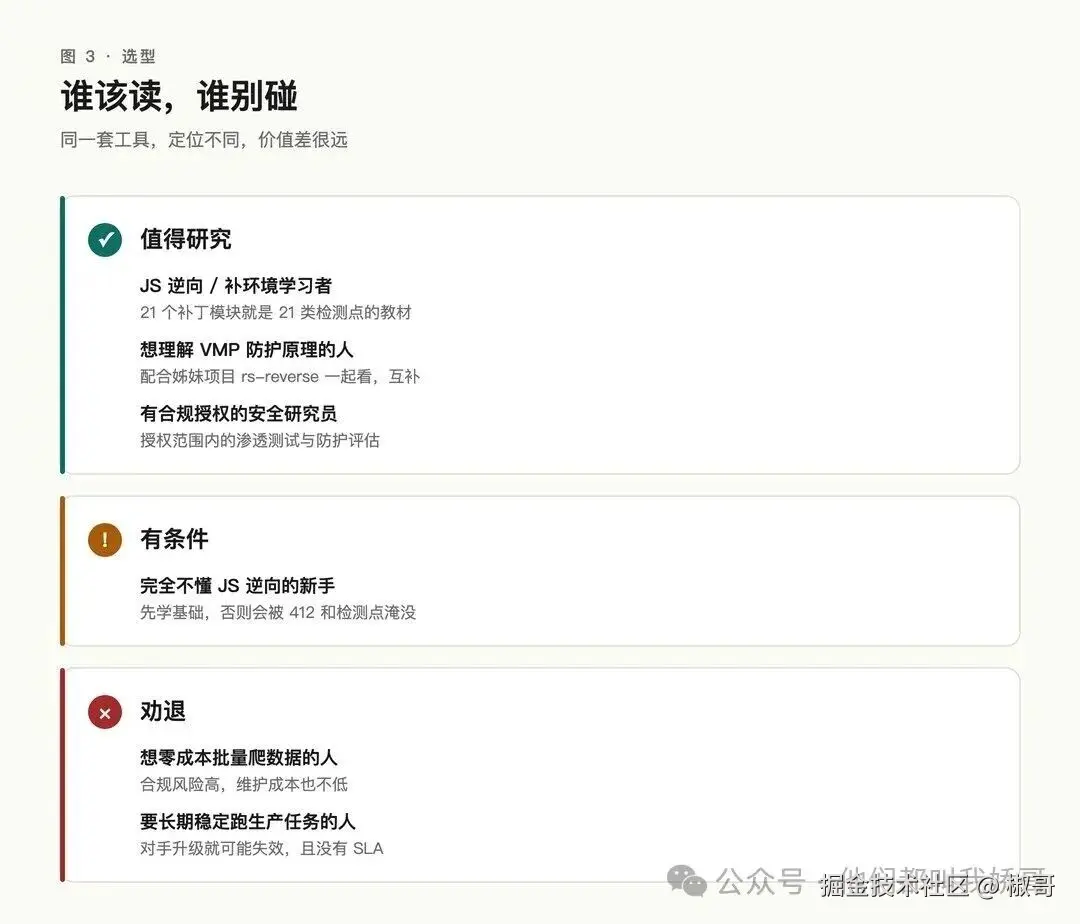
| 你是什么人 | 建议 | 理由 |
| JS 逆向 / 补环境学习者 | 很值得研究 | 源码是高质量的补环境教材,21 个模块就是 21 类检测点 |
| 想理解 VMP 防护原理的人 | 配合 rs-reverse 一起看 | 同作者的姊妹项目做纯算法逆向,两者互补 |
| 有合规授权的安全研究员 | 可以用 | 授权范围内的渗透测试、防护评估 |
| 想零成本批量爬数据的人 | 劝退 | 合规风险高,且维护成本不低 |
| 完全不懂 JS 逆向的新手 | 先学基础 | 直接上手会被 412 和检测点淹死 |
| 要长期稳定跑生产任务 | 慎重 | 对手升级就可能失效,没有 SLA |
九、写在最后:它真正的价值,是让你看见"检测"本身
把 sdenv 拆开看,最有意思的不是"过防护"这个结果,而是它暴露了一个事实:
现代反爬和补环境,本质是一场关于"身份证据"的攻防。
网站不停地问:"你是浏览器吗?"------toString() 是不是 native?document.all 是不是那个怪东西?window.chrome 在不在?随机数能不能复现?
补环境框架则不停地伪造证据:setFuncNative 造 native 外观、C++ 插件造 document.all、Proxy 拦截每一次窥探、固定随机数造确定性。
sdenv 把这场攻防完整地摊在了源码里。哪怕你永远不去过任何一个真实站点,读它的 21 个补丁模块,也能让你明白反爬工程师在想什么------这或许才是它对普通开发者最大的价值。
技术本身无罪,但能力越大,边界越要清楚。研究原理可以,越界使用不行。