纯文字的 X1 共 10 页、137,782 字节。丢给 macOS 预览的「减小文件大小」滤镜出来是 142,400 字节,反而大了 3.4%(实测)。同一个滤镜碰上一份重复资源很多的文件还能大出 68.6%。原因这次没查。到底是工具不给力,还是文件本身没什么可省?这次把 qpdf 12.4.0 跟结构有关的四个开关拆开,一次只开一个。机器是一台 Apple 芯片 Mac。每种操作只跑一次。下面的百分比都是这次实测,只对这几份文件成立。
样本一共五份。X1 是 10 页纯文字。T1 是两页 A4 文字材料,第 1 页有一张照片。T2 是把 T1 按 300 DPI 渲染成整页图片的扫描型。X2 是一份 8 页的图文报告。D1 是一份构造样本:同一张 800×600 的 JPEG 和同一份字体子集各存 5 份。它专门用来看重复资源,数字不代表日常文件。X2 这份图文样本是 NASA/JPL《Mars Exploration Rover》NASA Facts(2004),维基共享资源,公有领域。第 1 页那张照片来自 Wikimedia Commons,按 CC0 使用。其余样本都是自制的虚构内容。
开开关之前先看什么都不加的 qpdf in.pdf out.pdf。后面每个开关都叠在这次重写上。X1 小了 0.29%。X2 小了 0.03%。T2 几乎没动。T1 却大了 0.07%。D1 大了 1.03%,多出 7,783 字节(实测)。我猜是 qpdf 按自己的习惯把对象和交叉引用表重排了一遍。原文件写得紧的话,重排反而多出一点。这一行先记住。下面有两个开关的结果跟它一模一样。
对象流是唯一明显的单项
五份样本逐项对照,每个开关单独开一次。表里全是实测数,百分比都是跟原文件比。
| 操作(qpdf 12.4.0,实测) | X1 纯文字 | T1 文字+照片 | T2 扫描型 | X2 图文报告 | D1 构造样本 |
|---|---|---|---|---|---|
| 原文件(字节) | 137,782 | 2,312,093 | 2,357,639 | 1,497,423 | 756,741 |
| 默认重写 | −0.29% | +0.07% | −0.00% | −0.03% | +1.03% |
只开 --object-streams=generate |
−4.15% | −0.74% | −0.02% | −0.25% | −16.26% |
只开 --recompress-flate --compression-level=9 |
−1.11% | +0.07% | −0.00% | −0.11% | +0.99% |
只开 --remove-unreferenced-resources=yes |
−0.29% | +0.07% | −0.00% | −0.03% | +1.03% |
只开 --decode-level=specialized |
−0.29% | +0.07% | −0.00% | −0.03% | +1.03% |
| 对象流加 Flate 九级叠加 | −4.97% | −0.75% | −0.02% | −0.33% | −16.31% |
X1 那条命令原样贴在这里。text.pdf 就是 X1,文件名换成了占位名。
scss
$ qpdf --object-streams=generate text.pdf text-os.pdf && wc -c text.pdf text-os.pdf
  137782 text.pdf
  132065 text-os.pdf
  269847 total
按规范的说法,对象流是把页面字典、字体描述、宽度数组这些不是流的小对象装进一个流里统一压缩。交叉引用表也换成一条压过的流。纯文字的 X1 里这类小对象多。单开就省了 5,717 字节。T1 和 X2 的大头是图片,只动了零点几个百分点。扫描型 T2 几乎全是图片字节,只省 0.02%。D1 的 −16.26% 是构造出来的。它的 5 份重复字体带着没压缩的宽度数组。打进对象流以后字体相关字节从 266,381 降到 134,332(实测)。这个数不能拿去当平均水平。
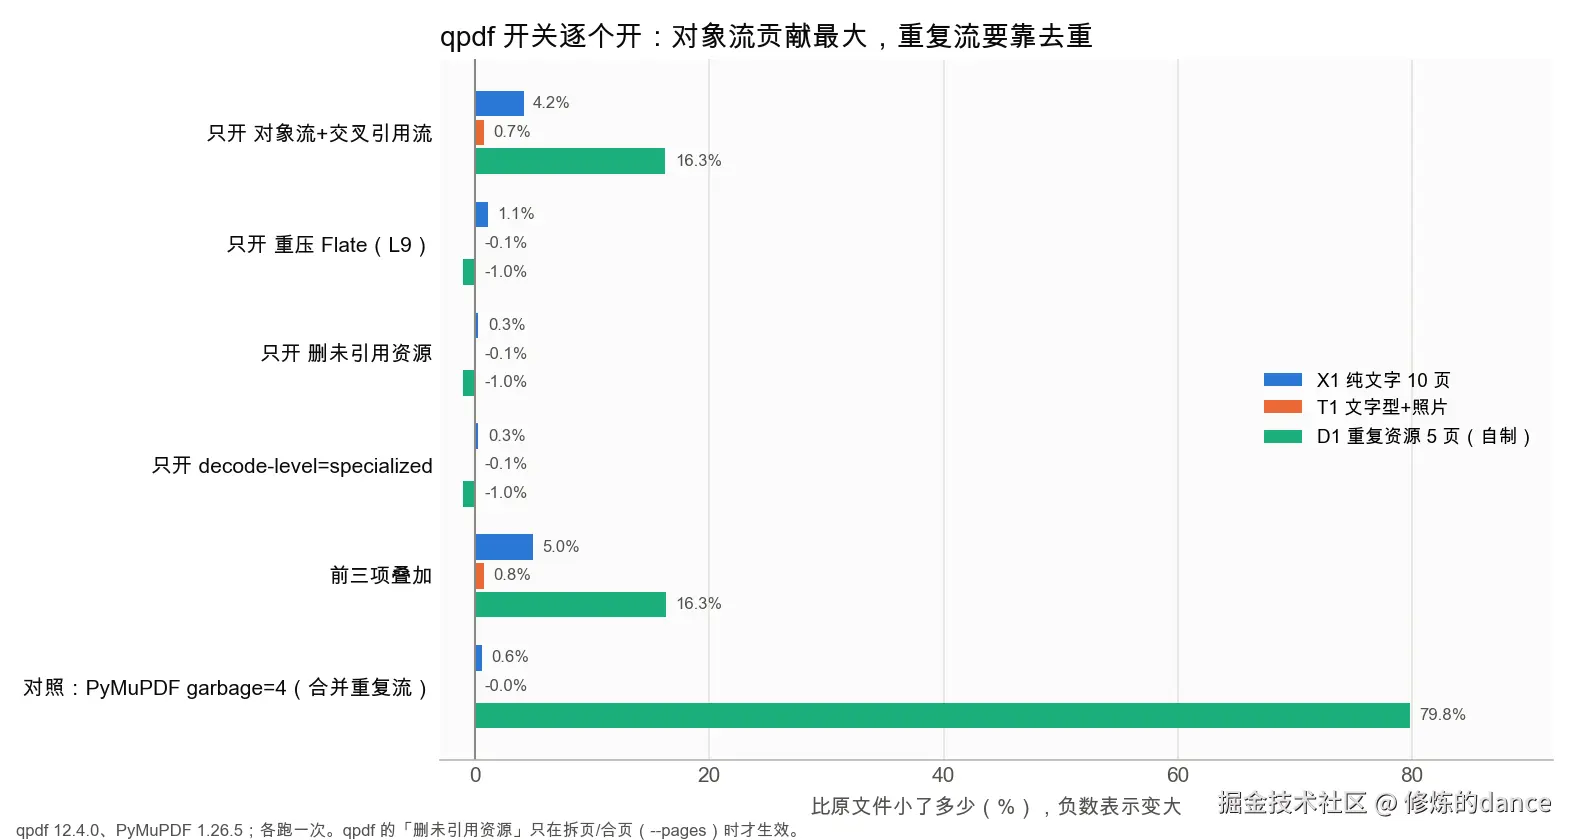
这张图先看最上面一组。只开对象流时蓝条 X1 是 4.2%,绿条 D1 是 16.3%。往下三组的条都很短。D1 的绿条还往左伸到了 −1.0%。最底下一组是 PyMuPDF 的对照,D1 那条一直拉到 79.8%。图上的 4.2% 就是表里的 4.15%,只是少留了一位小数。
Flate 九级重压只多挤出 1%
--recompress-flate --compression-level=9 会把已经用 Flate 压过的流解开再按 9 级压一遍。单开它 X1 小了 1.11%,X2 小了 0.11%。T1 和 D1 跟默认重写差不多。比原文件还是大 0.07% 和 0.99%(实测)。跟对象流叠在一起后 X1 是 130,933 字节,一共 −4.97%。比单开对象流多省 1,132 字节,就这么多。
再拿一个反证兜底:用 --compress-streams=n --decode-level=generalized 把所有流解开再存。X1 胀到 309,649 字节,足有原来的 2.25 倍。D1 是原来的 3.12 倍(实测)。现成的 PDF 生成时就已经压过一遍。结构优化能拿到的只是「压得不够狠」和「存重复了」这两块。
删未引用资源不带 pages 一个也没删
--remove-unreferenced-resources=yes 是四个开关里名字最像能瘦身的。单开以后五份文件的体积跟默认重写完全一样(实测)。qpdf 帮助里写着这项清理只在拆页、合页时生效。也就是命令带了 --pages 的时候。另有一份两页的构造样本,两页共用的资源里放了一个没用到的字体和一张没用到的图。带上 --pages . -- 以后 7,700 字节降到 1,148 字节(实测)。--decode-level=specialized 单开的结果也跟默认重写一模一样。我猜它只管解码到哪一层,不改压缩方式(推断,这次没核实)。
重复资源要靠合并重复流
D1 把 qpdf 上面几项全叠上是 633,342 字节。5 份图片一份都没合并(实测)。qpdf 有没有别的选项能合并重复流这次没测。只能说试过的这几个做不到。
对照组是 PyMuPDF 1.26.5 的 save()。garbage=3 只合并重复的非流对象,D1 小了 13.69%。garbage=4 连重复的流也合并掉,756,741 降到 152,455,也就是 −79.85%。再加上 deflate 和对象流是 135,184 字节(实测)。同样的 garbage 档位放到四份常规样本上体积几乎没变。能让结构优化上两位数的只有重复资源特别多的文件。
纯文字 PDF 八成以上是字体
按对象在文件里的起止位置切开统计。X1 的 137,782 字节里字体占 88.14%。内容流占 9.16%。页面与结构对象加上交叉引用表一共不到 3%(实测)。四份常规样本里结构这一块只占 0.04%~2.70%。结构优化的天花板就在这儿。X1 这份纯文字样本压到 −5% 左右就到顶了。
平时在浏览器里压 PDF 我用的是图映 ImgIng imging.cn/ ,它有一档「无损结构」只做结构优化不碰图片。这次 X1 走这一档是 137,782 → 131,156 字节,−4.81%。和 qpdf 叠加后的 −4.97% 在一个量级。扫描型 T2 只少了 676 字节(实测)。从这次结果看它没做字体子集化,所以纯文字文件它也压不下去多少。里面具体怎么打包对象我从外面看不出来。
手上有一份压不动的 PDF 可以先跑一遍 qpdf --object-streams=generate,再用 wc -c 比前后大小。省不到 5% 的话结构上就没什么油水了。想再小只能从字体子集化或图片下手。要是一下省到两位数,照 D1 的情况推断,多半是文件里存了重复的图或字体。这时换一个能合并重复流的工具再过一遍更划算。