2026-10-08·记忆系统·Actor 边界
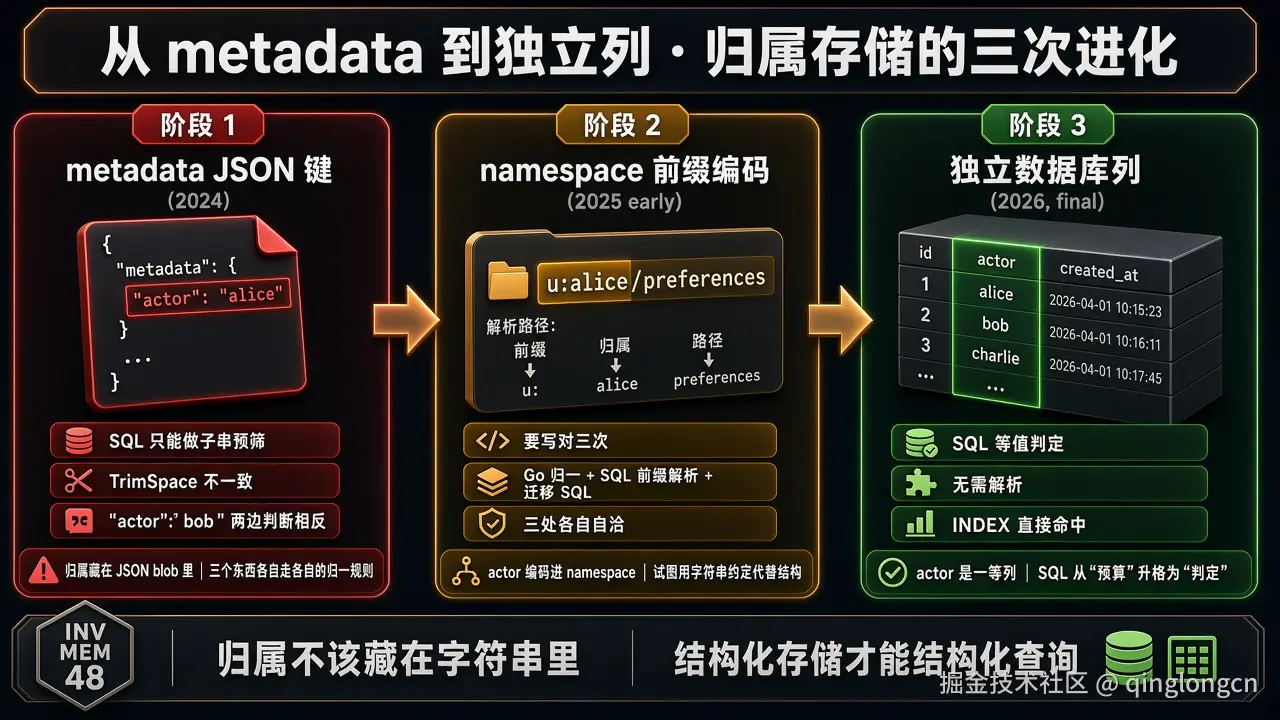
引擎的 actor 归属经历了三个阶段:metadata JSON 键 → namespace 前缀编码 → 独立数据库列。每个阶段看起来都是"正确的修法",但每个阶段都引入了新的一类 bug。这是一个关于"用什么数据结构表达归属"的工程故事。
一、阶段 1:metadata JSON 键
最初的设计很自然------归属信息放在 metadata 里:
bash
{
    "content": "我喜欢简洁风格",
    "scope": "global",
    "metadata": {
        "actor": "alice",
        "source": "conversation"
    }
}看起来合理:metadata 是扩展字段,actor 是可选的归属标签,不需要就不填。
这个设计同时出了三个问题
问题 1:SQL 只能子串匹配
bash
-- metadata 是 TEXT 列,存 JSON 字符串
-- 查询 actor = "alice" 只能这样写:
WHERE metadata LIKE '%"actor":"alice"%'
这不是精确匹配------如果有人的 actor 叫 "alice2",LIKE '%alice%' 会把它也捞上来。而且 JSON 键的顺序不确定,"actor":"alice" 和 "source":"conversation","actor":"alice" 在 LIKE 表达式里是不同的模式。
问题 2:Go 侧 TrimSpace 和 SQL 侧 LIKE 不一致
bash
// Go 侧判断
func ActorVisible(entry, actor string) bool {
    entryActor := strings.TrimSpace(entry.Metadata["actor"])
    return entryActor == "" || entryActor == actor
}
如果 metadata 里存的是 "actor": " bob "(带空格),SQL 的 LIKE '%"actor":"bob"%' 匹配失败(不带空格),但 Go 的 TrimSpace 之后判断通过。同一条数据,SQL 层说"不是 bob 的",Go 层说"是 bob 的"。
问题 3:actor 同时承担三个语义
metadata["actor"] 这个键同时被用作:
- JSON 子串------SQL 预筛的匹配目标
- 命名空间前缀 ------
UserNS("alice")="u:alice",用来把 actor 编码进 namespace - 去重键组成部分 ------
(scope, namespace, actor, key)构成唯一行标识
这三者的归一规则不同:SQL 做子串匹配(不 trim),Go 做等值比较(trim),namespace 构造函数做前缀拼接(不 trim 也不转义)。一个字段三种解读,每种解读各自自洽,合在一起产出矛盾的结果。
二、阶段 2:namespace 前缀编码
第一次修法是把 actor 编码进 namespace:
bash
// UserNS("alice") = "u:alice"
// 存储时:scope=global, namespace="u:alice"
// 读取时:namespace 以 "u:" 开头 → 属于某个 actor看起来更好:actor 从一个不确定的 JSON 键变成了 namespace 的结构化部分,SQL 可以做前缀匹配。
这个设计又出了两个新问题
问题 1:需要两个逐字符一致的编码器
bash
// Go 侧编码
func UserNS(actor string) string {
    return "u:" + actor
}

// 迁移 SQL 编码
UPDATE memories SET namespace = 'u:' || metadata_actor WHERE ...
Go 的 UserNS("alice") 和 SQL 的 'u:' || 'alice' 必须产出完全相同的字符串。如果 Go 侧做了 trim 而 SQL 没做(或反过来),迁移会产出第二个键槽 而不是修复第一个------"u:alice" 和 "u: alice" 是两个不同的 namespace。
问题 2:namespace 不再只表示"话题"了
原本 namespace 的语义是"这条记忆关于什么话题"------"code-style"、"review-process"。现在它同时承载了"这条记忆属于谁"。于是 AgentNS("legal-agent") 下面可能有 "u:alice" 和 "u:bob" 两个子 namespace,但也可能有 "shared" 这个无主的共享通道。
namespace 的空间从"话题"膨胀成了"话题 × 归属"的笛卡尔积。 查询变得复杂:要找 Alice 的 L4 记忆,需要先构造 "u:alice" 前缀再和 AgentNS 组合。
三、阶段 3:独立数据库列(最终方案)
第二次修法彻底换了方向------actor 从 metadata/namespace 里取出来,变成 memories 表的一个独立列:
bash
ALTER TABLE memories ADD COLUMN actor TEXT NOT NULL DEFAULT '';actor 列的语义极其清晰:
- 空字符串 = 无主(L1 环境信息、L2 团队共识)
- 非空字符串 = 属于该 actor(L3 个人偏好、L4 角色记忆)
bash
-- 精确匹配,不是子串
WHERE actor = 'alice'

-- 层判定可以直接在 SQL 里做
WHERE scope = 'global' AND actor = ''      -- L2 共识
WHERE scope = 'global' AND actor = 'alice' -- L3 关于我
伴随的三个清理
UserNS前缀构造函数删除 :namespace 退回"话题"的单一语义,"u:alice"这种编码不再存在MigrationRules和migrateScope删除:不再需要在读取时做 namespace→actor 的解码- 存量数据回填 :
ddlMemoriesV7把 metadata 里的 actor 值提取到独立列,剥掉 namespace 的u:前缀
为什么这次是对的
| 维度 | metadata 键 | namespace 前缀 | 独立列 |
|---|---|---|---|
| SQL 精度 | 子串匹配 | 前缀匹配 | 等值匹配 |
| 层判定参与 | 不参与(需要应用层推导) | 部分参与(看前缀) | 直接参与(scope + actor = 层) |
| 编码器数量 | 1(但 SQL 侧另写) | 2(Go + SQL 各一个) | 0(裸字符串) |
| namespace 语义 | 纯话题 | 话题 + 归属(污染) | 纯话题(恢复) |
| 零值含义 | "没填"(歧义) | 不适用 | "无主"(明确) |
四、行业对比:归属存在哪里
| 方案 | 归属在哪里 | 强度 | 类似 引擎 哪个阶段 |
|---|---|---|---|
| Mem0 | scope 参数(user_id/agent_id) | 参数传递 | 阶段 2(调用方给的) |
| LangGraph | namespace 路径("users/alice/memories") | 路径编码 | 阶段 2 |
| AWS AgentCore | 复合 actorId + IAM policy | IAM enforce | 阶段 2.5(平台级) |
| MUXI | PostgreSQL RLS + user_id 列 | 数据库 enforce | 阶段 3(独立列 + 数据库级) |
| Oracle AI Memory | tenant_id 列 + RLS | 数据库 enforce | 阶段 3 |
| Agentium | scope 枚举 + userId 列 | 应用层 enforce | 阶段 3 |
| Letta | Agent 级 Core Memory + Shared Block | 物理分离 | 接近 Cell 级 |
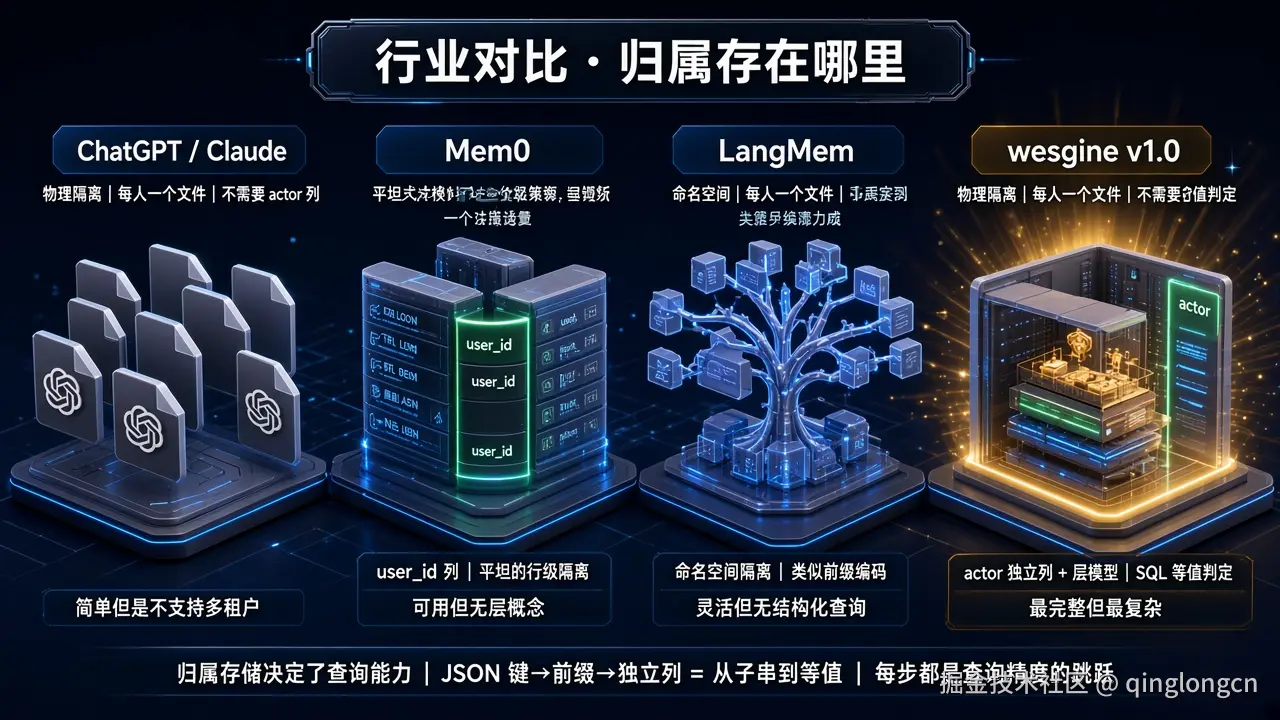
行业趋势 :2026 年新发布的方案(MUXI、Oracle、Agentium)都选择了独立列------不是因为 namespace 路径不能做隔离,而是因为它不能参与 SQL 的精确判定 。当你需要在 WHERE 子句和 LIMIT 之前做归属过滤时(而不是取回一堆数据后在应用层过滤),独立列是唯一选择。
五、两个执行点、一条规则
actor 列解决了"存在哪"的问题。但"谁来检查"同样关键。
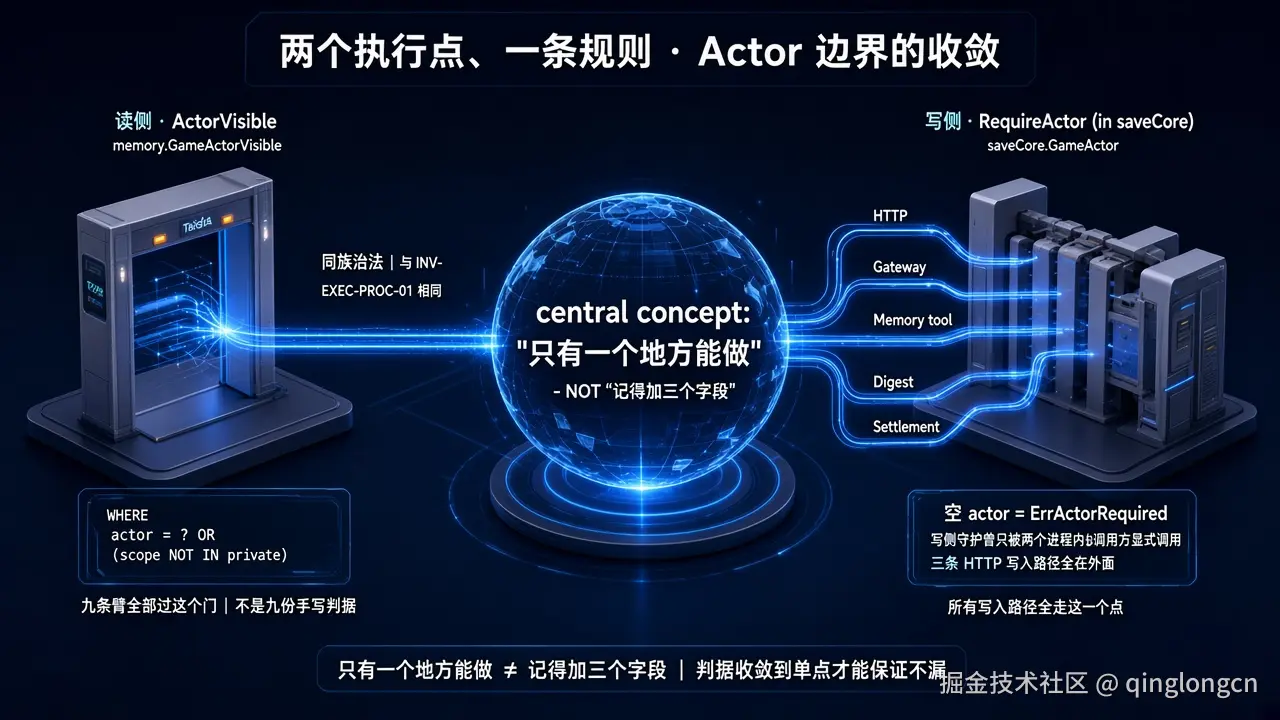
引擎 把 actor 边界的全部判据收敛到两个执行点:
bash
读侧 → ActorVisible(entry, actor)   唯一判据
写侧 → RequireActor(scope, actor)    在 saveCore 内,唯一执行点
为什么是"一个函数"而不是"每个查询加 WHERE"?
因为 ActorVisible 的判据不是简单的等值比较。它是一个按 scope 分支的三臂判据:
| Scope | 无 actor | 有 actor 但不匹配 |
|---|---|---|
| 共享域(system/global) | 可见 | 不可见 |
| 共享通道(agent + shared/kb:/c:) | 可见 | 可见(标签只是署名) |
| 私有域(agent 其余) | 不可见 | 不可见 |
关键行:私有域的无主条目 fail-closed。 读侧无法区分"故意共享"和"忘了打标签"------共享有唯一的三个通道,剩下的无主只能是数据错误。宁可召回不到,不能发给别人。
如果每个查询路径各自实现这个三臂判据,就会像之前五个消费方各自推导层归属一样------最终只有一份是对的。
六、写侧的单点守卫
读侧 fail-closed 解决了"泄漏",但没解决"污染"------一条无主的私有域条目虽然谁都读不到,但它占着存储空间和 GC 预算。
更重要的是:如果某条写入路径不检查 actor,写出的无主条目在当时三处 fail-open 的读侧路径上是可见的------于是写入 bug 和读取 bug 相互依赖,单独修其中一侧不会暴露问题。
RequireActor 在 saveCore 内执行------所有写入路径(SDK / HTTP / 工具 / flush / Settlement / 迁移)都经过 Save → saveCore,所以只要 saveCore 检查了,就没有路径能绕过。
它曾经只被两个进程内调用方显式调用 :memory 工具和行为 flush。三条 HTTP 写入路径和 saveCore 自己都不调------新增第四条路径漏调时编译器不报错,测试不失败,只会安静写出无主条目。
修法和 子进程单点生成规则(子进程生成单点)一致:"只有一个地方能 spawn",不是"记得加三个字段"。
七、给其他 Agent 系统的建议
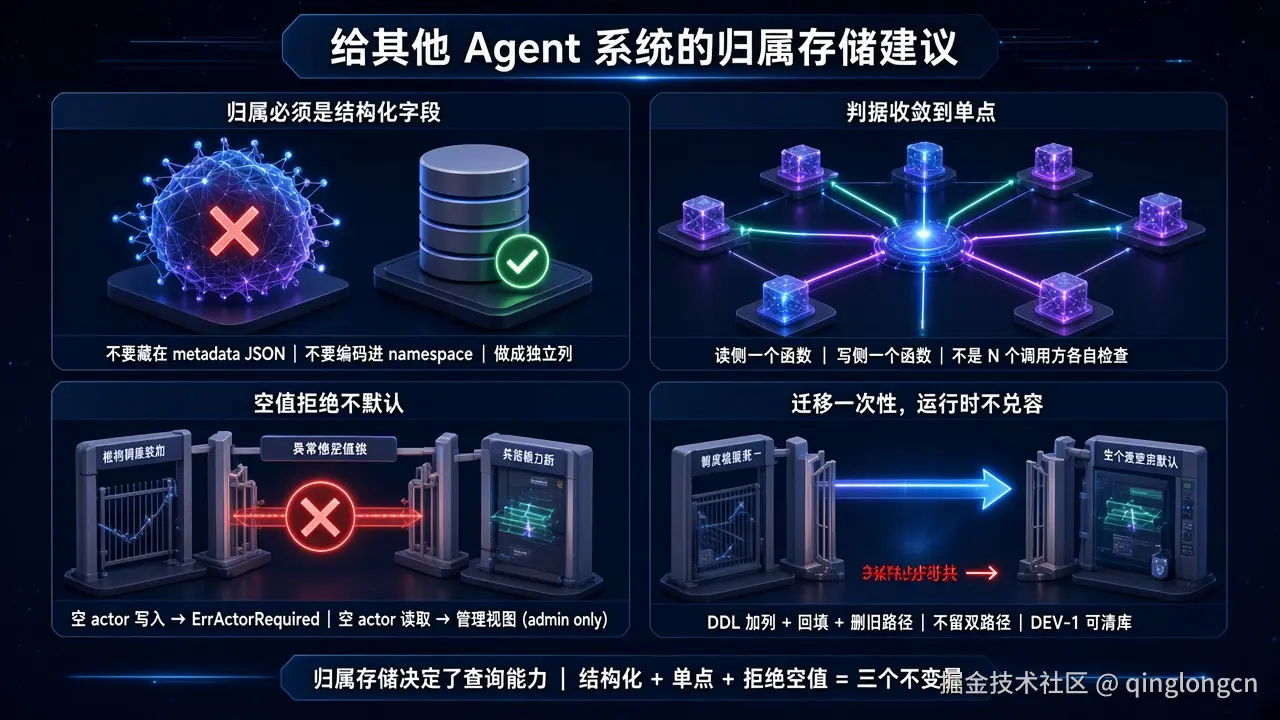
建议 1:归属从第一天就做成独立列
不要从 metadata JSON 键开始------它看起来灵活,实际上会在 SQL 精度、namespace 污染、多编码器三个方向同时出问题。2026 年的所有新发布方案都选了独立列,这不是巧合。
建议 2:读侧的默认是"不可见",不是"可见"
ActorVisible 对私有域无主条目 fail-closed。这比 fail-open 安全得多------fail-open 意味着一条数据错误(忘了写 actor)变成一次隐私泄漏。
建议 3:写侧检查放在最深处
RequireActor 放在 saveCore(所有写入路径的汇聚点),不放在各个调用方。这不是代码风格偏好------放在调用方的检查,新增一条路径时编译器不会提醒你忘了。
八、常见误区
误区 1:"Metadata JSON 键够灵活------以后加字段不用改 schema"
❌ 灵活性的代价是 SQL 无法精确判定。WHERE metadata LIKE '%"actor":"bob"%' 对 " bob " 和 "bob2" 给出错误结果。列的 schema 变更(ALTER TABLE ADD COLUMN)的成本远低于 N 个判据各自做子串匹配的 bug 排查成本。
误区 2:"namespace 前缀编码(u:alice)是好的中间方案"
❌ 它需要两个编码器(Go 和 SQL 各一个)逐字符一致,不一致时产出第二个键槽而非修复第一个。而且它把 namespace 从"话题分区"污染为"话题×归属"的笛卡尔积------查询复杂度翻倍。
误区 3:"提成独立列后就不需要 ActorVisible 了------直接 WHERE actor = ? "
❌ ActorVisible 不是简单的等值比较------它是按 scope 分支的三臂判据(共享域放行无主行、私有域拒绝无主行、共享通道只看署名)。WHERE actor = ? 会在私有域放行无主行------方向反了。
参考
- 引擎 actor 提列:从 metadata 到独立列、RequireActor 单点、ActorVisible 单点
- 反模式组 S #310-#323(20 条 Actor 边界反模式)