作者:来自 Elastic Sa Zhang, Zac Li, Gregory Chase
上手体验 Elasticsearch:深入探索 Elasticsearch 实验室代码仓库 中的示例笔记本,开始 免费云试用,或者 立即在本地计算机上(local machine now) 试用 Elastic。
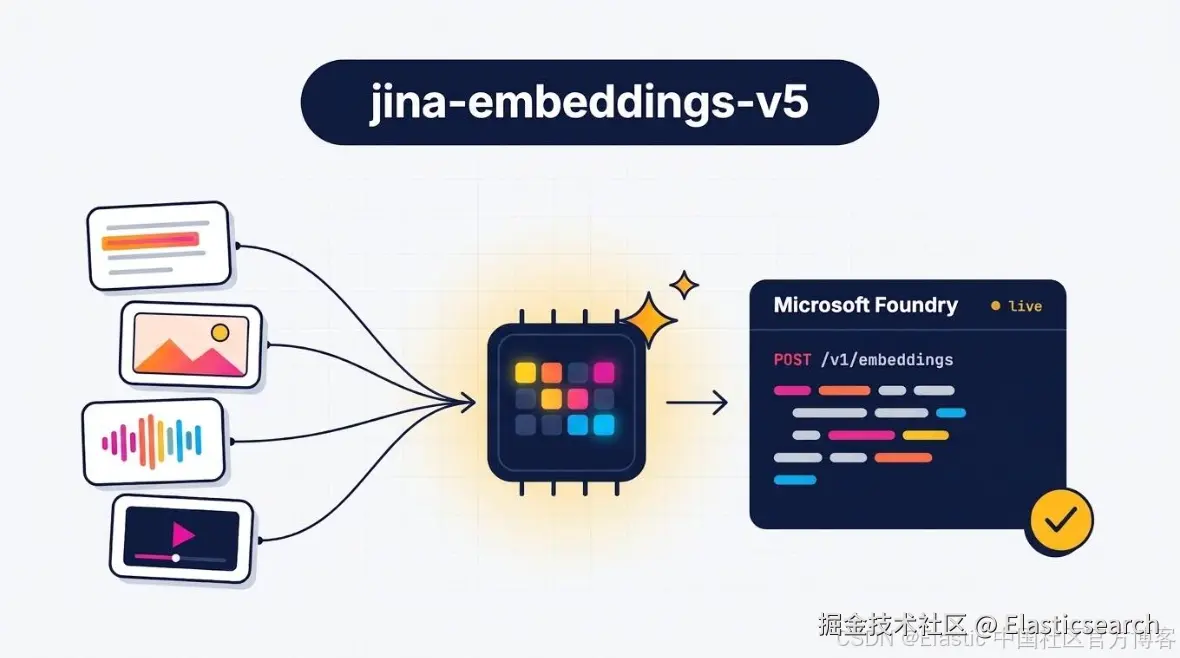
一次查询可以在同一组结果中返回一段视频和一段文字。Jina 嵌入(Embeddings) v5 现已上线 Microsoft Foundry 模型目录,包含四款模型,参数量从 2.39 亿到 17.4 亿不等。文本模型(text models) 支持 100 多种语言,全模态模型(omni models) 则将文本、图像、PDF 文件、音频和视频映射到同一个向量空间。
你可以在自己的 Azure 订阅中将这些模型部署为专用终结点,按计算小时付费。模型和你的数据都保留在你的租户中。小型模型在大规模图像嵌入基准测试(MIEB)中得分为 58.00,在大规模 多语言 文本嵌入基准测试(MMTEB)中得分为 67.00。微型模型的文本得分低约 1.5 分,索引速度则是小型模型的 3.4 倍。Jina AI 隶属于 Elastic,因此生成的向量可以直接写入 Elasticsearch。
Jina Embeddings v5 模型系列包含哪些模型
Jina AI 提供为特定任务设计的小型模型,能够在整个搜索和检索过程中保留语义,以较低的成本达到前沿水平的准确率。Jina 模型的规模仅为同类模型的一小部分,却在基准测试中位居榜首或名列前茅。在 Foundry 中,Jina Embeddings v5 模型能以更低的计算成本提供高度相关的 语义搜索(semantic search) 结果。完整结果请参阅 文本(text) 和 全模态(omni) 技术报告。
Jina Embeddings v5 系列包含两类模型,每类均提供两种参数规模:
- 文本模型(Text models,jina-embeddings-v5-text-small、jina-embeddings-v5-text-nano)。 提供用于检索、匹配、聚类和分类的多语言文本嵌入。
- 全模态模型(Omni models,jina-embeddings-v5-omni-small、jina-embeddings-v5-omni-nano)。 新增对图像、音频和视频的支持,将它们映射到同一个向量空间,从而通过一次查询实现统一的跨模态搜索。
Jina Embeddings v5 文本模型体积小,能在 100 多种语言中实现较高的准确率。全模态模型将所有模态嵌入同一个向量空间,因此一次查询就能从所有受支持的媒体类型和语言中返回高度相关的结果。
小型与微型模型的准确率和速度对比
如果准确率是你最看重的指标,请选择小型模型。它们的 上下文窗口 更大,最多可容纳 32,000 个词元(tokens),参数也更多,有助于最大限度地提高所嵌入和检索内容的相关性。
如果速度和吞吐量更重要,请选择微型模型。以下基准测试结果展示了这种取舍。
在 多模态 应用中,v5-omni-small 在大规模图像嵌入基准测试(MIEB)中得分为 58.00,在大规模多模态嵌入基准测试的视频子集(MMEB-Video)中得分为 41.20。v5-omni-nano 的对应得分分别为 47.87 和 26.87。
两款模型在文本和音频上的表现相近。在大规模多语言文本嵌入基准测试(MMTEB)中,小型模型得分为 67.00,微型模型得分为 65.5。在大规模音频嵌入基准测试(MAEB)中,两款模型的得分均为 49.69。吞吐量基准测试显示,微型模型处理文本的速度是小型模型的 3.4 倍,处理图像和视频的速度是 2.2 倍,处理音频的速度是 1.5 倍。
| 模型(Model) | 输入(Input) | 参数量(Parameters) | 输入词元长度(Input token length) | 俄罗斯套娃式嵌入维度(Matryoshka dimensions) | 最适合的场景(Best for) |
|---|---|---|---|---|---|
jina-embeddings-v5-text-small |
文本 | 6.77 亿 | 32,000 | 1024--32 | 以较小的模型体积实现最高的语义搜索准确率 |
jina-embeddings-v5-text-nano |
文本 | 2.39 亿 | 8,000 | 768--32 | 模型体积极小,文档索引和检索速度最高可达小型模型的 3.4 倍 |
jina-embeddings-v5-omni-small |
文本、图像、PDF 文件、音频、视频 | 约 17.4 亿 | 32,000 | 1024--32 | 在涵盖文本、图像、视频和音频的语义搜索中实现最高准确率 |
jina-embeddings-v5-omni-nano |
文本、图像、PDF 文件、音频、视频 | 约 10.4 亿 | 8,000 | 768--32 | 多模态内容的索引和检索速度是小型模型的 1.5--3.4 倍 |
| [表 1. jina-embeddings-v5 系列各模型之间的差异。] |
如何在 Microsoft Foundry 中部署 Jina Embeddings v5
在托管计算资源上预配 Jina Embeddings v5 终结点
- 登录你的 Azure 账户。
- 打开 Microsoft Foundry 模型目录,找到 Jina Embeddings v5。
- 选择要用的模型版本,并将其部署到托管计算资源上。选择受支持的 GPU 规格(SKU)。模型卡中列出的规格为 A10。确保你的 Azure 订阅拥有该规格所需的配额,然后设置实例数量。每个实例都运行一份模型副本。流量较大时,可以增加实例数量。
- 选择 部署(Deploy)。
- 终结点将在 15 至 20 分钟内完成预配。
调用你的 Jina Embeddings v5 终结点
在 模型和终结点(Models + endpoints) 中打开你的部署,复制 目标 URI(Target URI) 和 密钥(key) 。直接使用界面上显示的 URI,它已经以 /v1/embeddings 结尾。请求正文采用 Jina Embeddings API 的格式:
vbnet
`

1.  curl "$TARGET_URI" \
2.    -H "Authorization: Bearer $ENDPOINT_KEY" \
3.    -H "Content-Type: application/json" \
4.    -d '{
5.      "model": "jina-embeddings-v5-text-small",
6.      "task": "retrieval.passage",
7.      "input": ["Invoices are due 30 days after delivery."]
8.    }'

`AI代码解释
调用时:
- 建立索引时,将
task设置为retrieval.passage。搜索时,将其设置为retrieval.query。 - 使用全模态模型时,将以 Base64 编码的媒体与文本放在同一个列表中传入,例如
{"image": "<经 Base64 编码的图像>"}。 - 从模型目录部署的终结点会阻止出站访问,因此不支持媒体 URL。
然后将向量存入 Elasticsearch 或其他向量存储系统。
Microsoft Foundry 模型目录中的 Jina Embeddings v5
点击下方链接,了解 Microsoft Foundry 模型目录中的 Jina 模型。每款模型都有独立的目录页面,其中包含模型卡、支持的 GPU 规格(SKU)和定价信息:
- 文本小型模型(jina-embeddings-v5-text-small)
- 文本微型模型(Jina-embeddings-v5-text-nano)
- 全模态小型模型(jina-embeddings-v5-omni-small)
- 全模态微型模型(jina-embeddings-v5-omni-nano)
Jina Embeddings v5 模型卡和技术报告
- Hugging Face 上的模型卡:文本小型模型(text-small)、文本微型模型(text-nano)、全模态小型模型(omni-small)、全模态微型模型(omni-nano)
- Jina 全模态模型技术报告(Jina omni technical report)
- Jina 文本模型技术报告(Jina text technical report)
原文:Jina Embeddings v5 multimodal search in Microsoft Foundry | Elasticsearch Labs