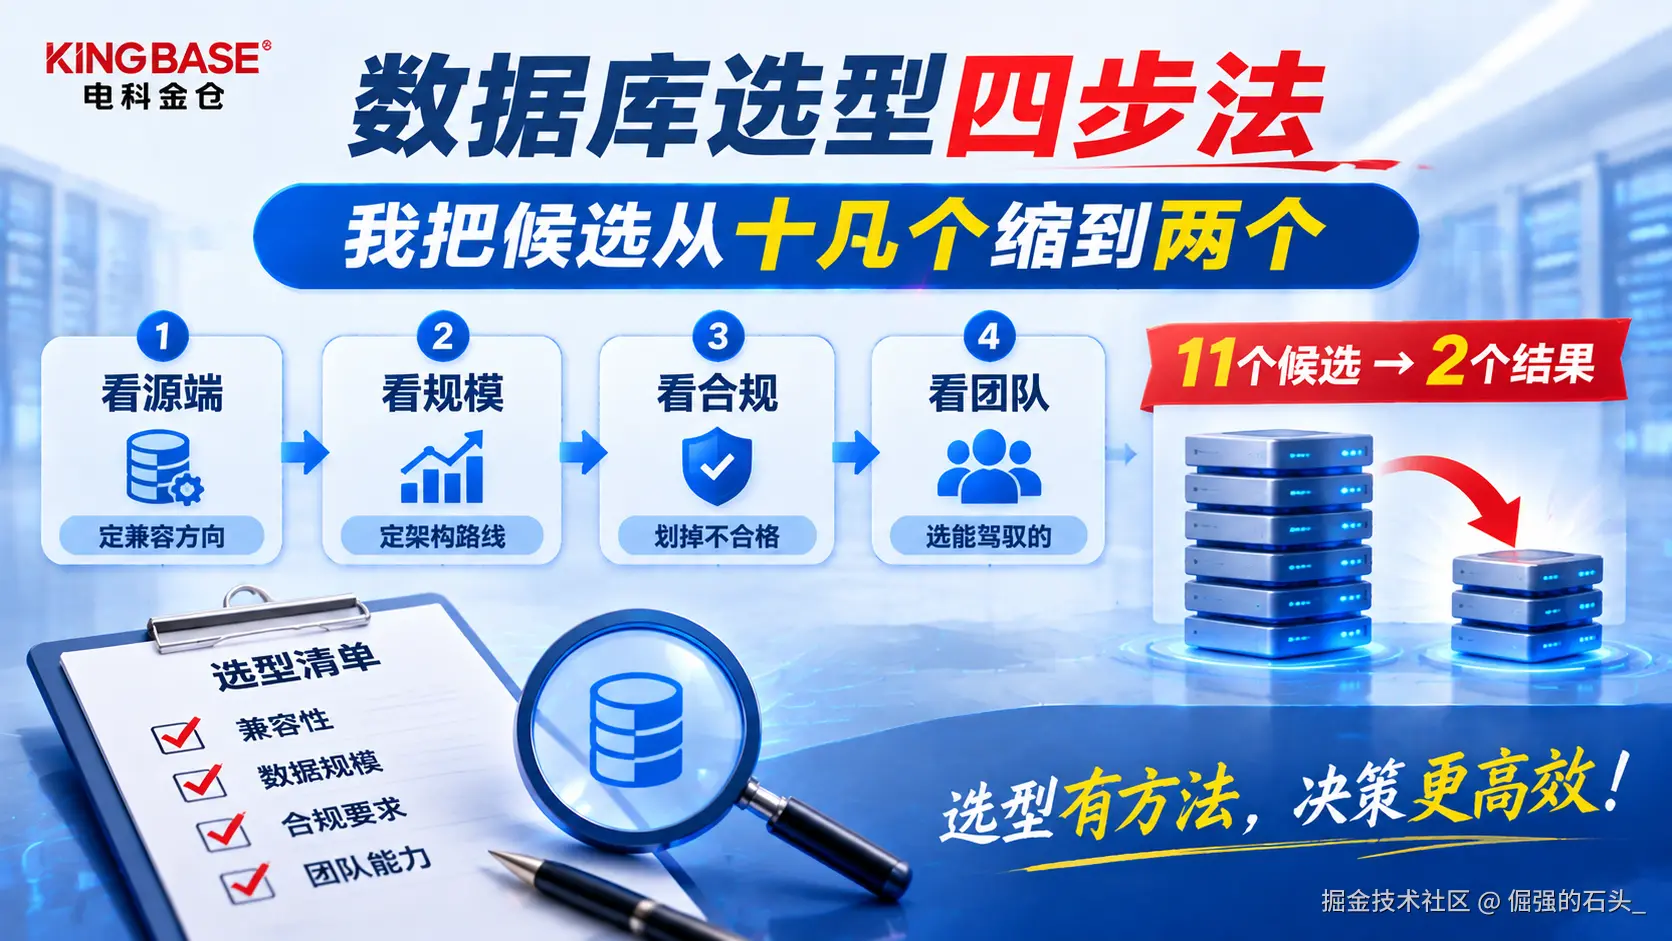
去年年底,公司让我牵头做核心系统的数据库选型,方向是换成国产库。接手的时候,候选清单上有十一个产品,材料堆了半人高。团队里有人提议拉个对比表,把功能、跑分、兼容率一项一项比。我们照这个思路干了半个月,结论越比越乱。每个产品都有一堆优点,谁也说服不了谁。
后来我把方法换了。先看自己,再看产品。 约束条件没对齐之前,比产品是浪费时间的。四步走完,十一个候选缩到了两个。这篇把这套方法完整写下来。
@toc
第一步:看源端,定兼容方向
选型的第一件事,是把现在这套系统的家底盘清楚。源库是什么,决定了你要往哪个方向验兼容。
我们的源端比较杂。核心在 Oracle 上,外围有几个 MySQL 的库,还有一套老系统在 SQL Server 上。三个源端,三种验法。这一步花了一周,把老系统的家底盘了个底朝天。盘的时候有个发现值得说。不少兼容问题藏在"谁都不常用"的边角代码里。越久没人动过的模块,越要过一遍。
Oracle 源,重点验的不只是 SQL 语法。真正的深水区是这些:
- PL/SQL 对象:存储过程、函数、包、触发器、自定义类型。其中"包"是最容易翻车的地方。很多国产库支持存储过程,但包的支持不完整。我们有四十多个业务包,这块必须逐个过。
- Oracle 特有语法:ROWNUM、CONNECT BY、MERGE INTO、DECODE、NVL 这些,业务代码里到处都是。
- 系统包:DBMS_JOB、DBMS_OUTPUT、DBMS_LOB 这类,业务代码用得飞起。缺一个都是麻烦。
- 数据类型细节:NUMBER 的精度映射、VARCHAR2 按字节还是按字符算长度、DATE 和 TIMESTAMP 的行为差异。
这一轮盘下来,我们的结论是,Oracle 兼容能力是第一筛选条件。公开资料里的口径,金仓数据库 KingbaseES(下文简称 KES)对 PL/SQL 包、自治事务、游标循环这些特性支持得比较完整。实际迁移项目里,超过 95% 的存储过程少量调整就能直接跑。方向对了,具体数字还是要自己在 POC 里验。
MySQL 源,重点看协议兼容。能不能只换 JDBC 驱动就完成迁移、Binlog 格式 CDC 工具认不认、MyBatis 生成的 SQL 有没有方言问题。
SQL Server 源,看 T-SQL 语法和系统函数的兼容面,还有 SSIS、SSRS 这些周边工具的替代方案。
这一步盘下来的重点,归置成了一张图: 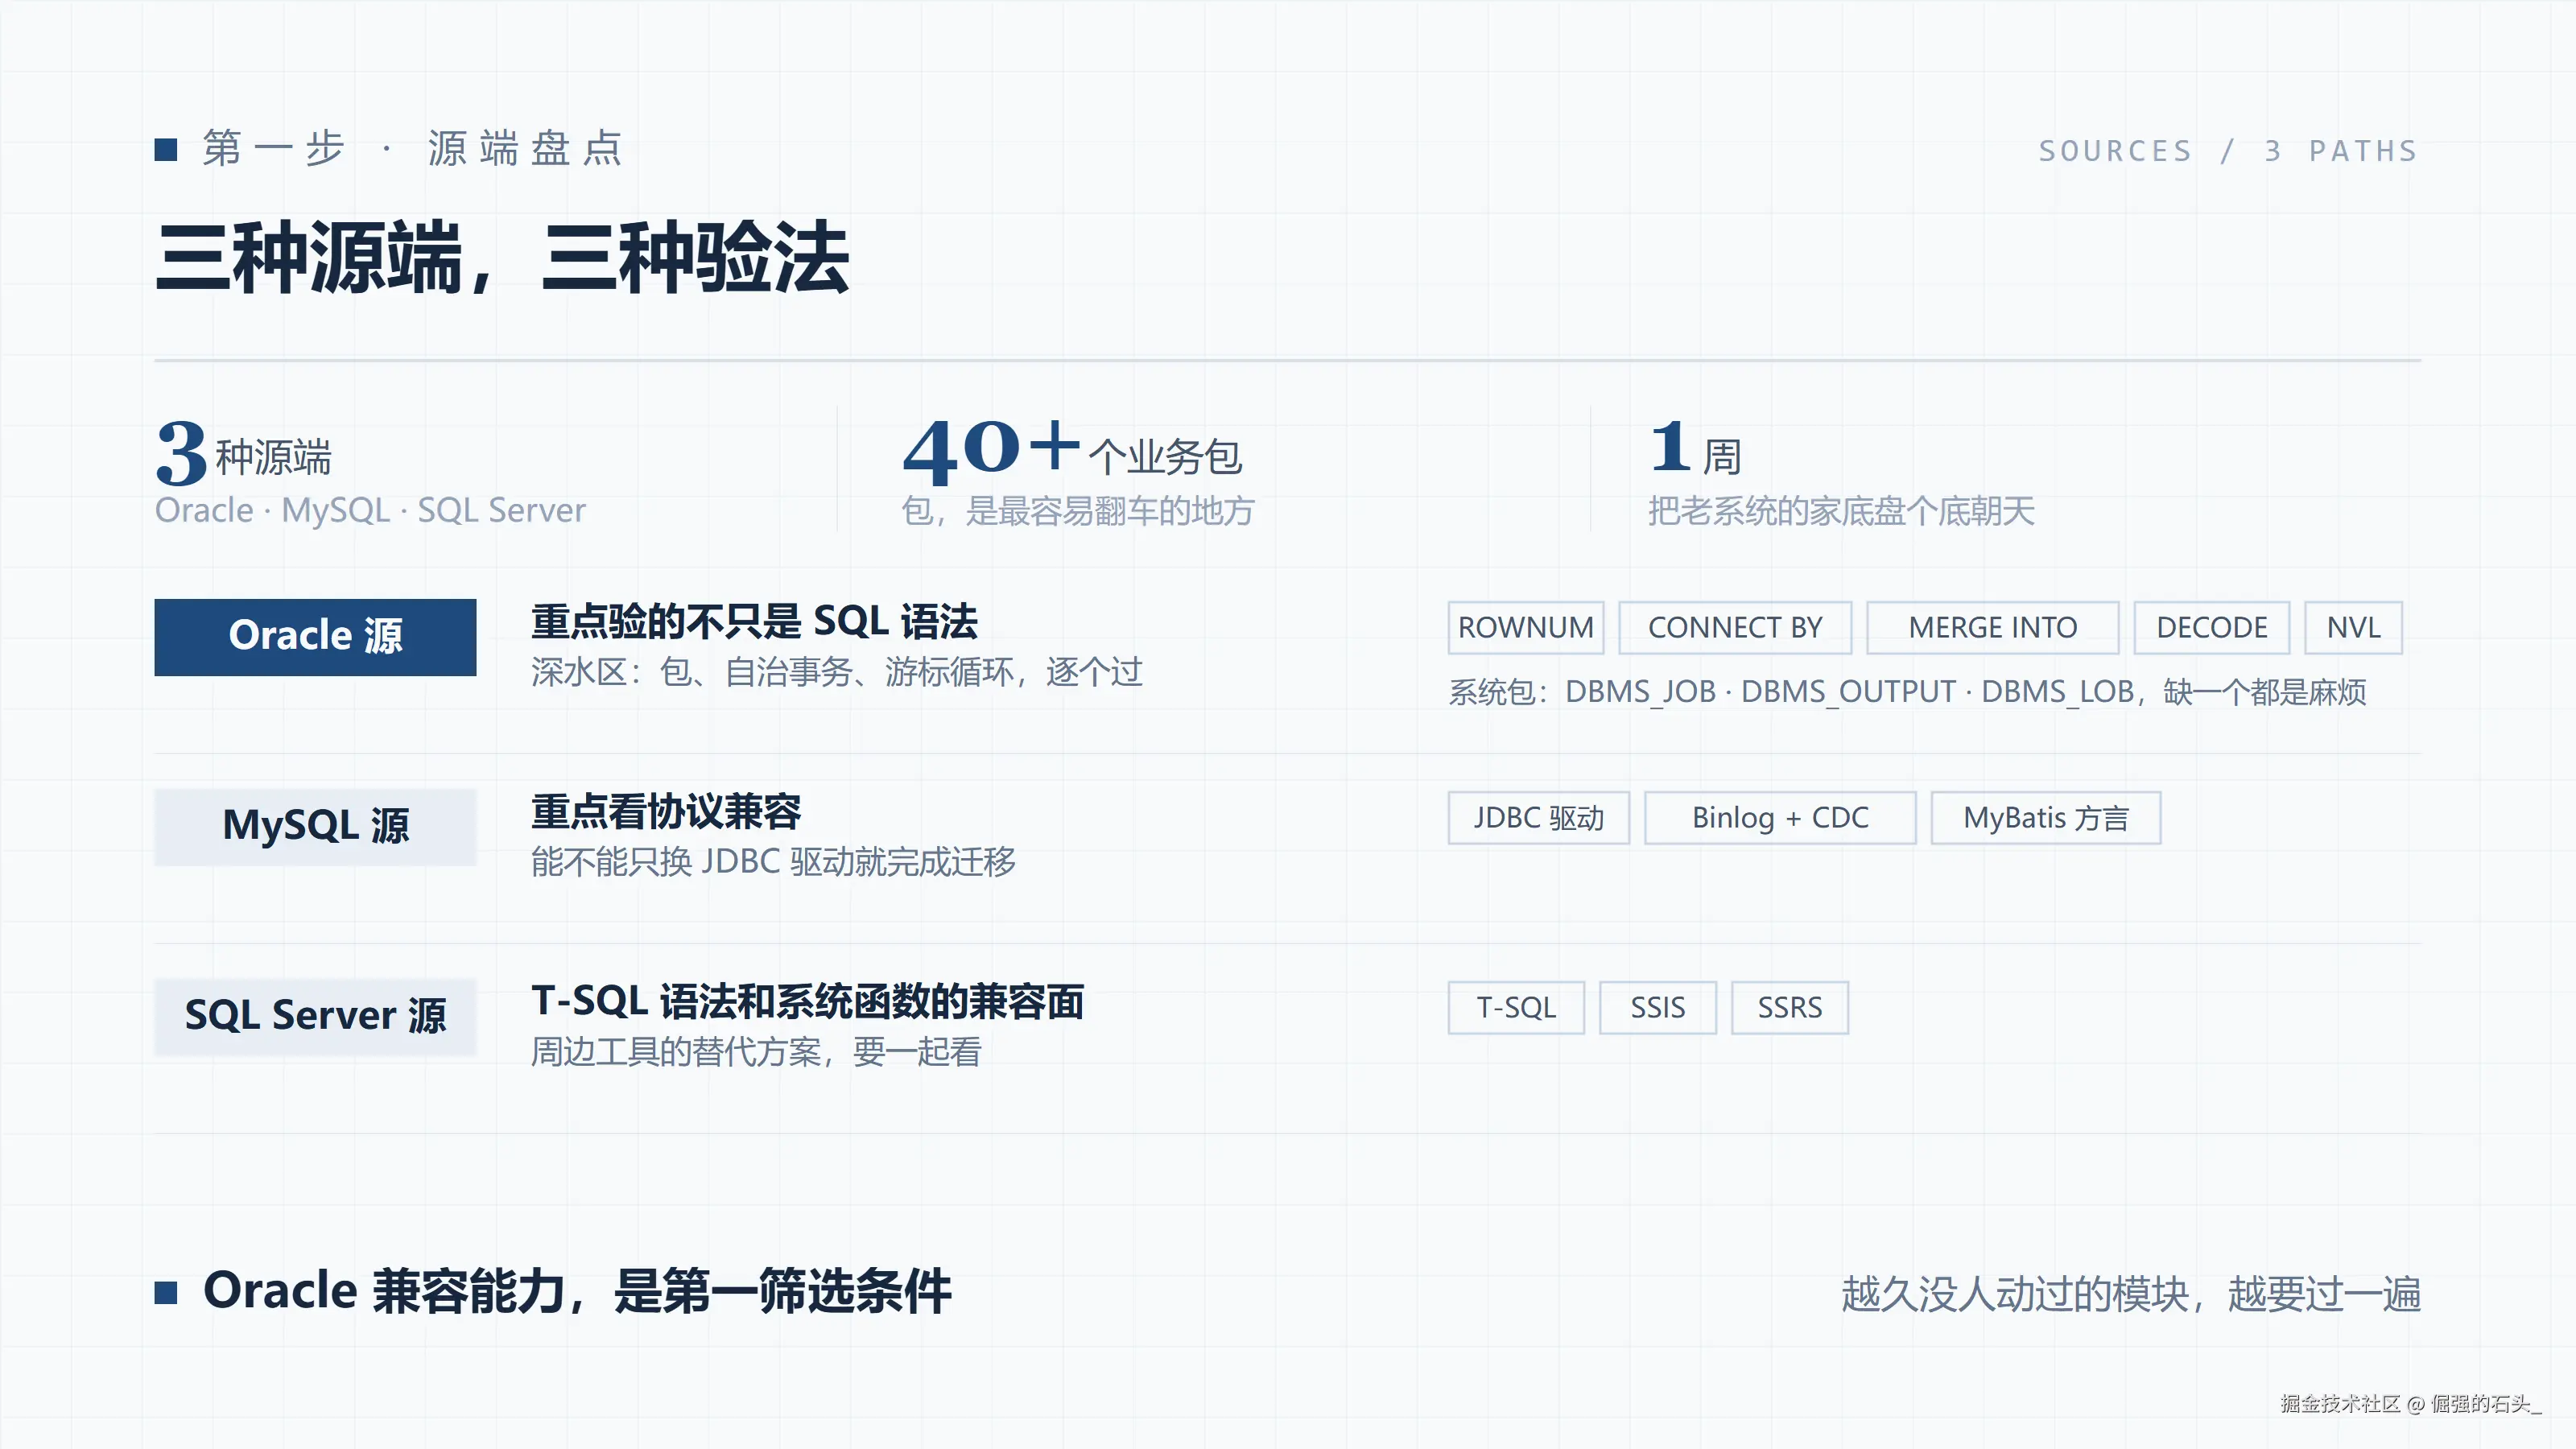
第二步:看规模,定架构路线
兼容方向定了,第二步是给自己的数据量和并发"验明正身"。别小题大做,也别硬扛。
业界的经验口径是,单表千万行以内、总量 10TB 以下、日均查询万级以内,集中式通常足够,而且运维成本最低。我们核心库的实际数据是 3.2TB、峰值并发不到四千。无论怎么算,都够不到分布式的起点。
顺手把"什么时候该考虑分布式"的信号也记下来,免得两年后忘了看。写入瓶颈真实出现、单表超过一亿行导致 DDL 和备份窗口扛不住、明确的在线扩容需求、RPO=0 加秒级切换的高可用硬要求。四个信号一个都没有,就安心用集中式。
补充一个行业口径的数字,防止有人拿"大势"来劝你。有行业分析把 2026 年新上系统的分布式采用率统计在 71% 左右。但这个数字的口径要拆开看。新增场景里大量是物联网采集、日志、边缘节点这类天生适合分布式的写入型业务,把比例拉高了。核心交易库的集中式存量,比这个数字给人的直觉要大得多。别人上分布式有别人的理由。你的理由,要从自己的四个信号里找。
还有一个新变量要提一下,多模。我们公司除了关系数据,还有文档类的客服记录和 AI 团队要的向量检索。是给这些需求各配一套专用库,还是找一个关系、文档、时序、向量都能装的产品?金仓 KES V9 这类融合型多模架构,给的是后一种选项。五种数据模型一套内核,集中式、分布式、共享存储一条产品线全覆盖。对我们这种运维编制紧张的小团队,少一套组件就是少一份排班压力。
集中式、分布式之外,云原生和融合多模这两条路线也常被人摆上桌。一张对比表,四条路线的边界一目了然: 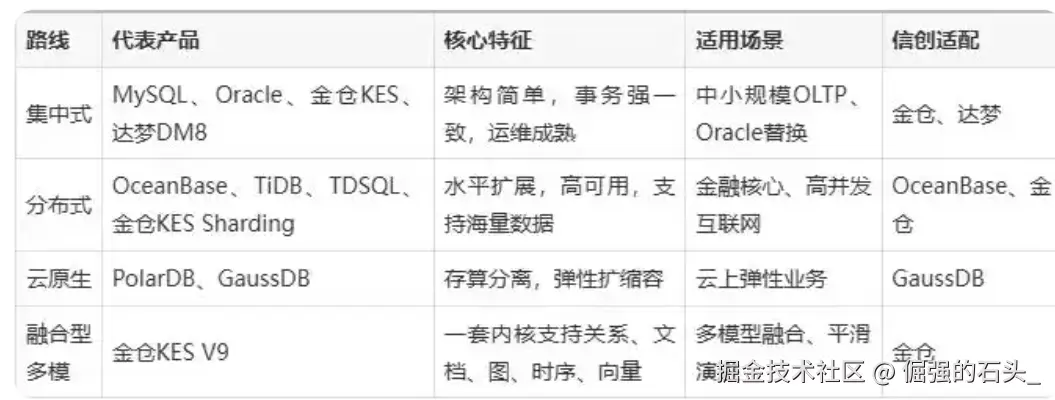
顺手把第二步的判断依据画成了自检清单。一边是我们自己的数,一边是那四条信号: 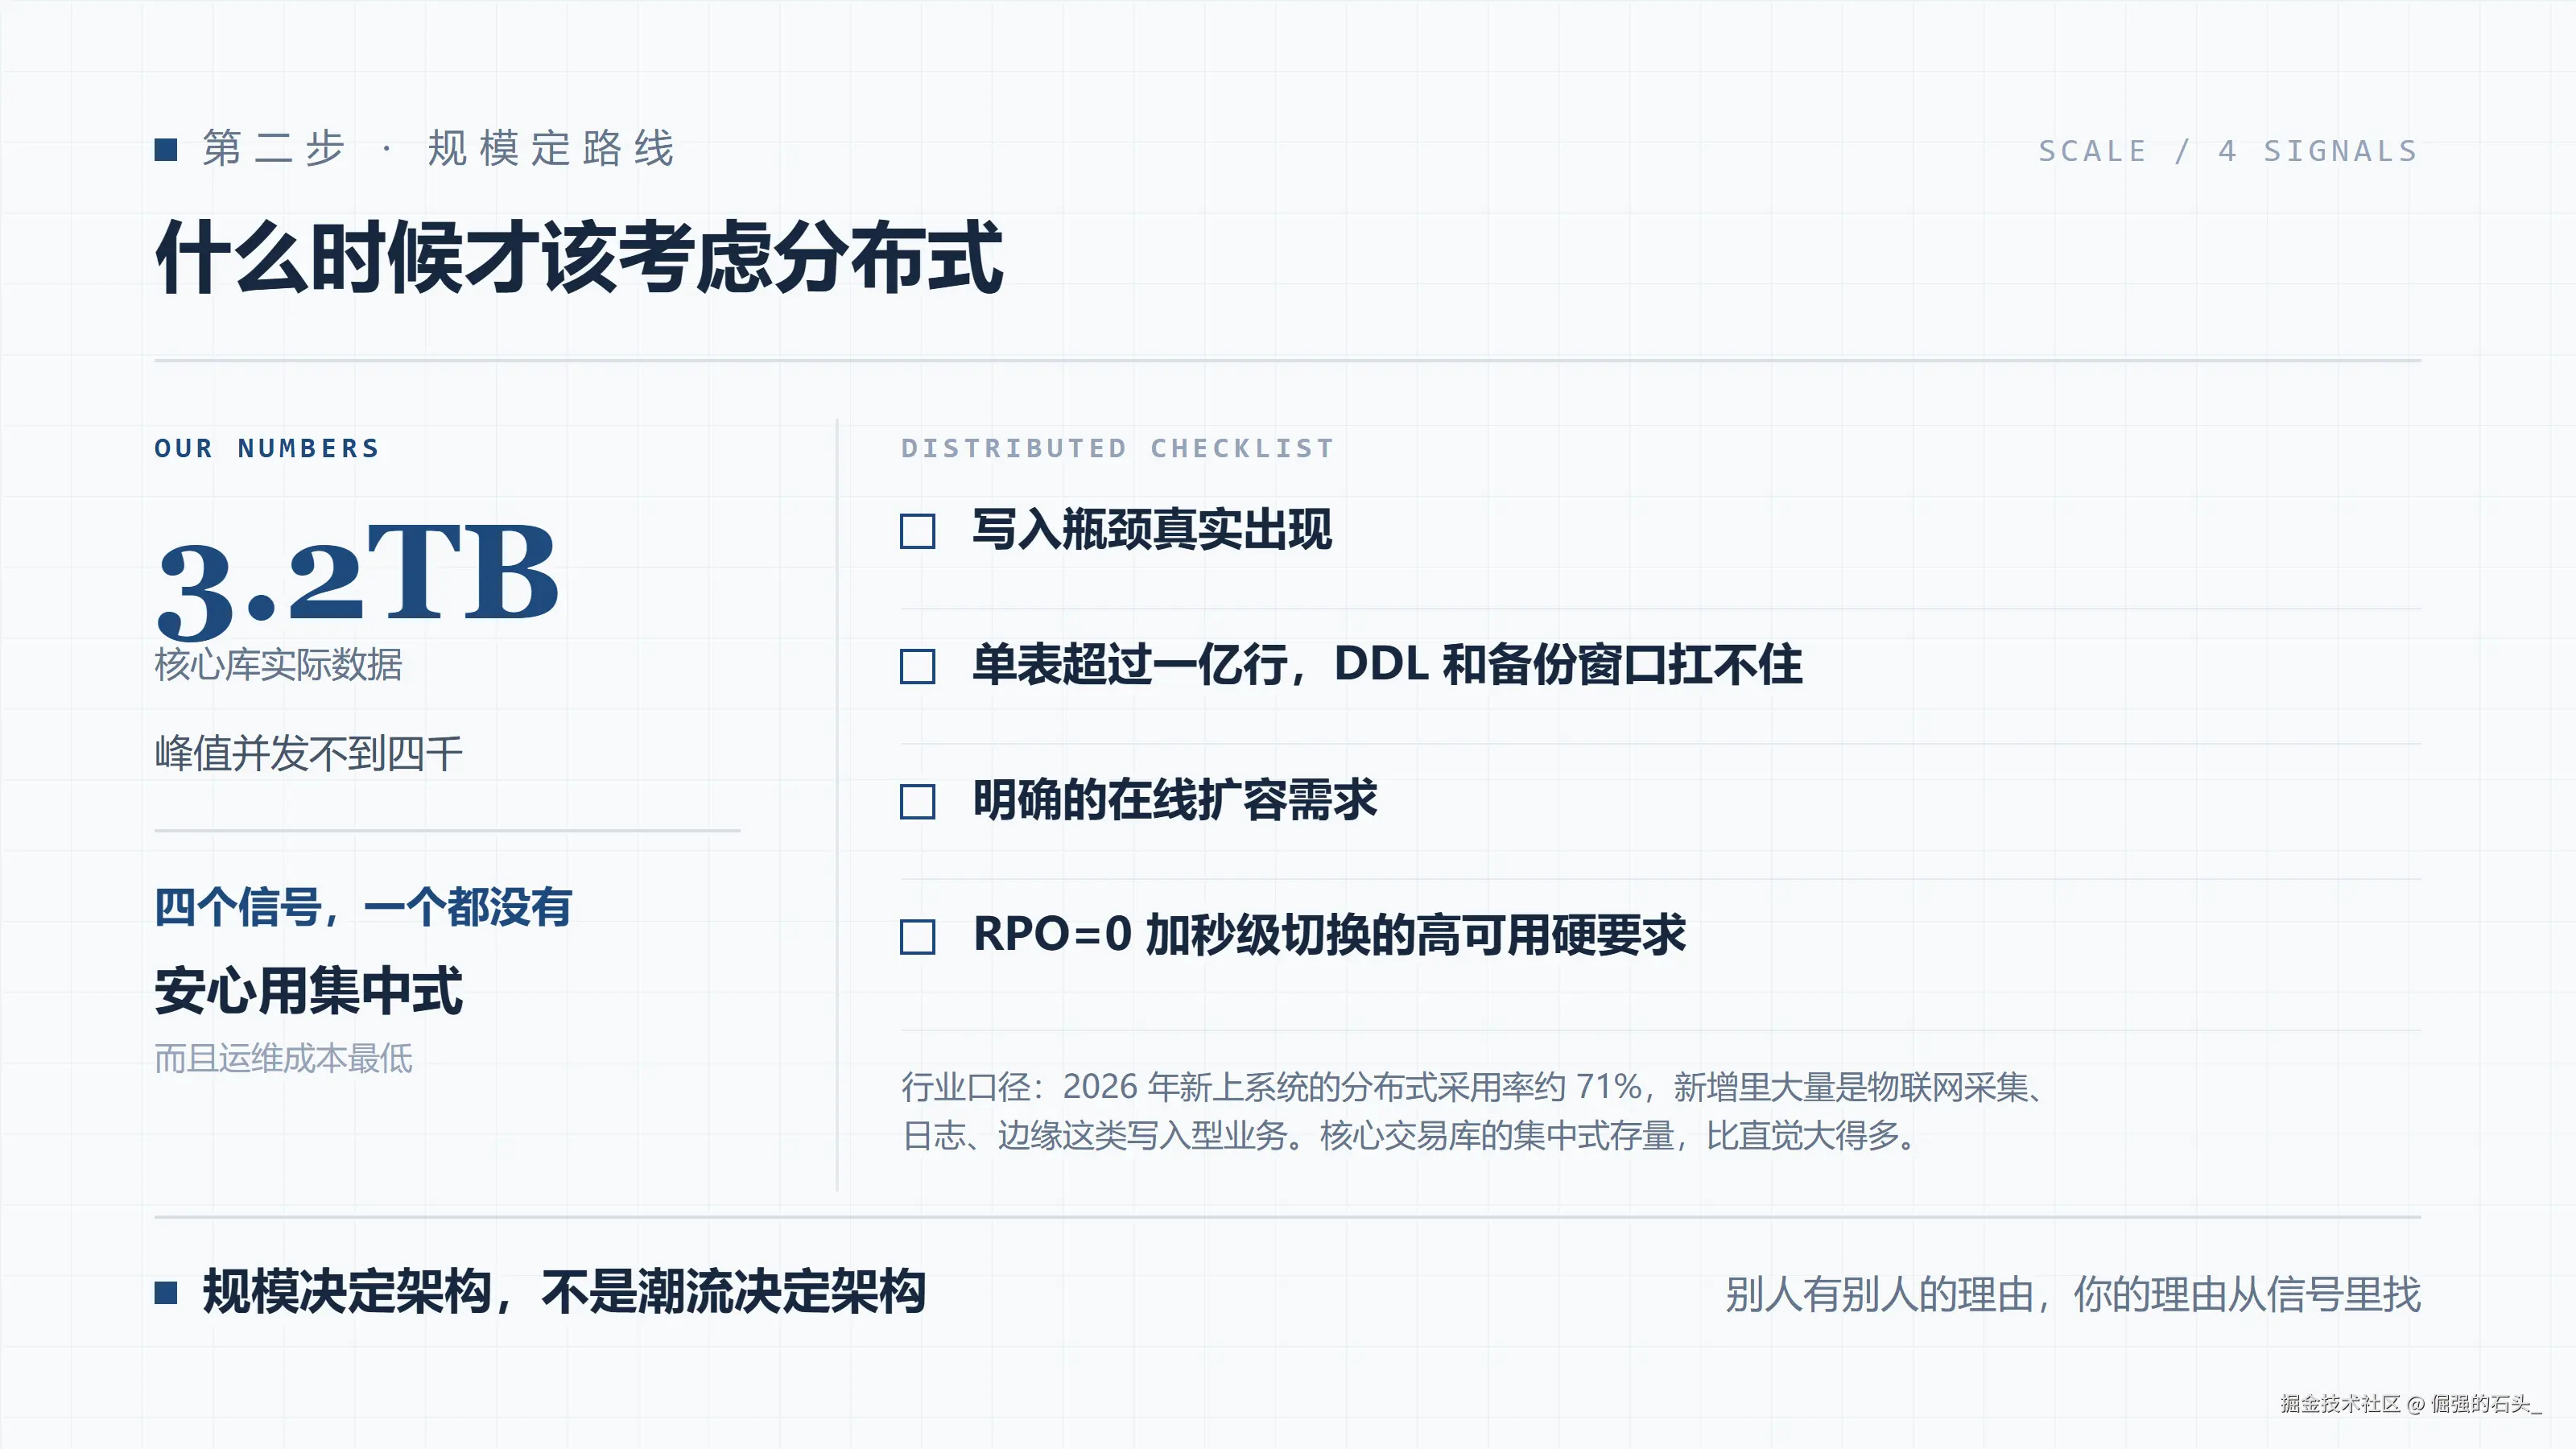
第三步:看合规,把不合格的划掉
这一步最有筛选效率,也最容易被技术出身的人忽略。
我们的下游客户里政企不少。信创是硬门槛,不是加分项。要核对的清单:安全可靠测评,2026 年 5 月第四期名单发布后,入围产品 23 款,II 级认证从 1 款涨到 6 款;国密算法认证,SM2/SM3/SM4;等保级别;国产 CPU 适配,鲲鹏、飞腾、海光、龙芯;国产操作系统适配,麒麟、统信 UOS。
这一轮下来,清单从十一个划到五个。说实话,前五步比任何功能对比表都管用。不合规的产品,功能再好也进不了标书。
第四步:看团队,别选驾驭不了的
最后一步,诚实地评估自己人。
我们的现实是,两个 DBA,没有分布式运维经验,晚上值班就这两个人。这意味着什么?意味着功能最全、架构最复杂的产品,对我们反而是负资产。运维工具链的完善程度、故障切换的自动化水平、备份恢复的操作难度,这些在我们这里的权重比性能跑分高。
这一步具体看哪几项?我后来逐项核过一遍,清单也抄在这里: 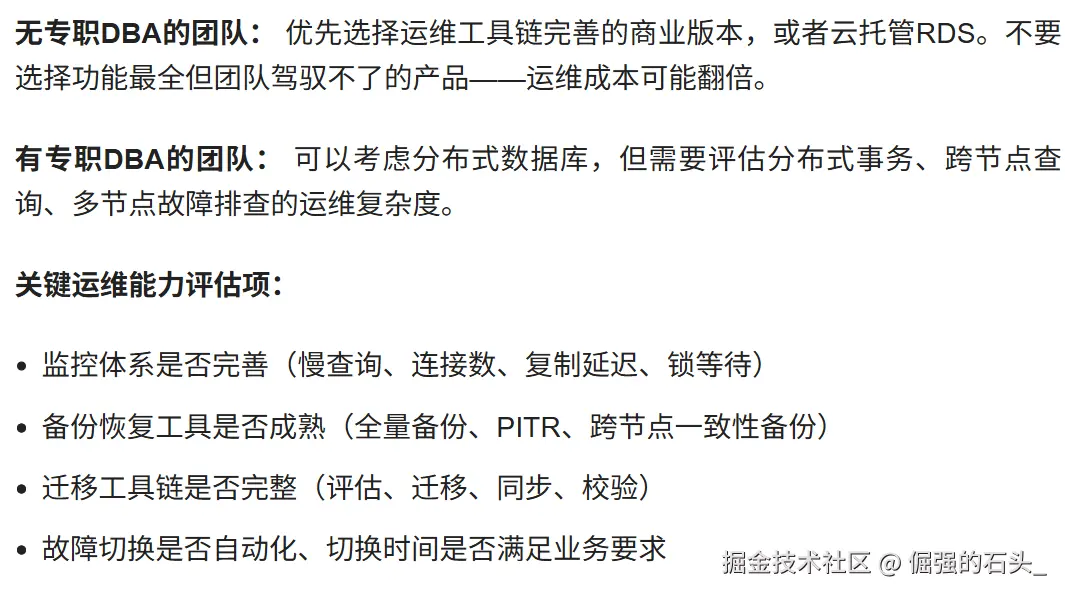
两个 DBA 的团队,选产品要看三样。监控体系能不能一键看慢查询和复制延迟。PITR 是不是按几个按钮就能做。故障切换要不要人肉跑脚本。这些能力,金仓的工具链覆盖得比较全。这也是它最终留在候选里的原因之一。
这一步还有个隐性好处。把团队能力摆上台面之后,跟厂商的谈判姿态都变了。销售再讲分布式多模多活的高阶能力,我们就一句"先演示你们的监控和一键切换"。话锋立刻从 PPT 回到我们真正会用到的功能上。知道自己的边界,谈判就不容易被带节奏。
POC:最后的验尸官
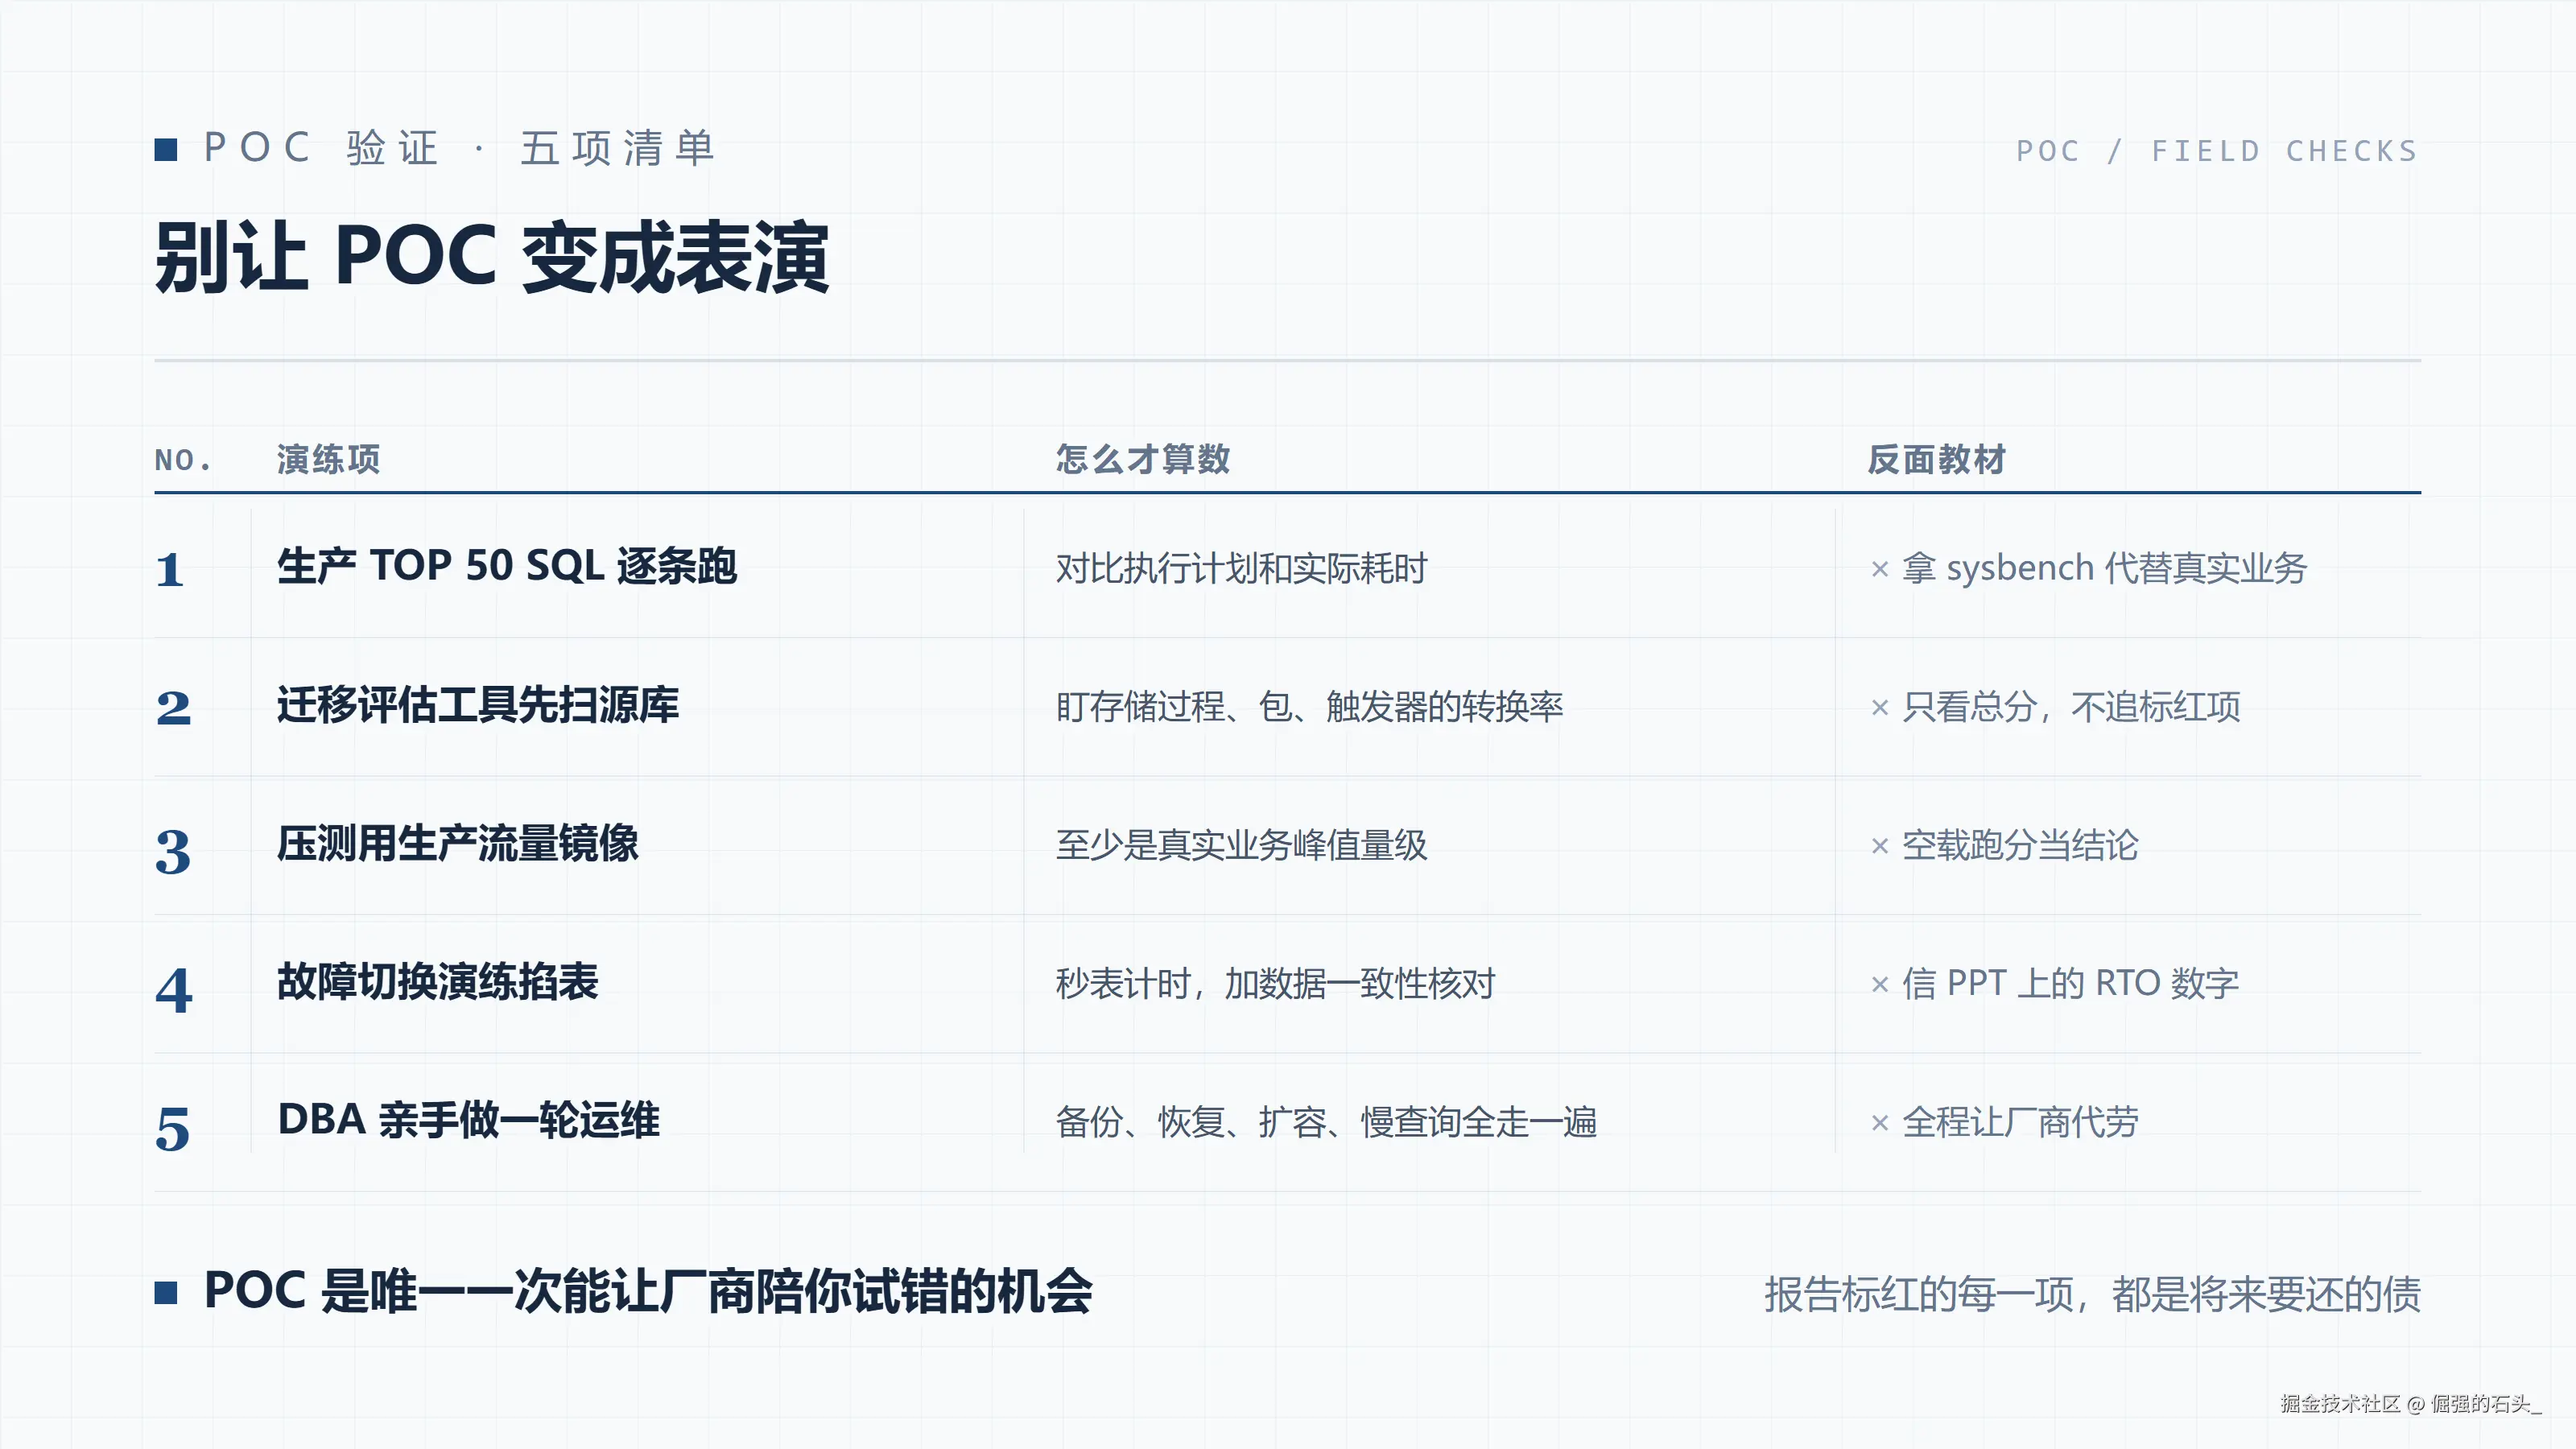
四步走完,候选剩两个。这时候千万别直接拍板。POC 必须做,而且要用对方法。我们踩过的坑提前说了:
- 别用 sysbench 代替真实业务 SQL。 拿生产 TOP 50 的 SQL 逐条跑,对比执行计划和实际耗时。这才是真考验。
- 迁移评估工具先跑一遍源库,生成兼容性报告。重点看存储过程、包、触发器的自动转换率。报告标红的每一项,都是将来要还的债。
- 压测用生产流量镜像,至少是真实业务峰值量级。空载跑分没有意义,要看带负载时的表现。
- 故障切换演练:模拟主节点宕机,掐表看切换时间和数据一致性。别信 PPT 上的 RTO 数字。
- 让 DBA 亲手做一轮运维操作:备份、恢复、扩容、慢查询排查。边做边记录哪里卡手。POC 是唯一一次能让厂商陪你试错的机会。
两个可对照的参考案例
四步法说起来抽象。正好有两个公开项目的数字,拿来当参照物再合适不过。口径都是公开资料,抄录如下。
一个集中式的例子。某省级电网的测控类业务,覆盖 26 个省、70 多万个传感器,存量数据 30TB。整套系统在国产库上连续运行了 14 年,可用性做到了 5 个 9。你看,30TB 的规模,没有上分布式,靠集中式跑了 14 年。这就是"10TB 以下集中式足够"这个口径的另一面。超一点,集中式也远没有到天花板。
一个分布式的例子。某船舶行业的监管平台,十几万艘船、20 万台终端往上报数据。日峰值写入 3000 万条,存量 300 亿条。5 个节点的分布式集群,每天新写入 1.5 亿条,查询响应毫秒级。这种写入吞吐和总量,才是分布式真正的主场。
光看文字不直观。我把两个案例的数字抄成了一张对照表:
| 对照项 | 省级电网 · 测控业务 | 船舶行业 · 监管平台 |
|---|---|---|
| 覆盖规模 | 26 个省、70 多万个传感器 | 十几万艘船、20 万台终端 |
| 数据量 | 存量 30TB | 存量 300 亿条,日峰值写入 3000 万条 |
| 架构 | 集中式,连续运行 14 年 | 5 节点分布式集群,每天新写入 1.5 亿条 |
| 跑出来的成绩 | 可用性 5 个 9 | 查询响应毫秒级 |
| 它说明的事 | 30TB 出头,集中式远没到天花板 | 这种吞吐才是分布式的主场 |
也就是说,判断标准不是"分布式新不新",是你的规模落在哪一边。
两个案例摆在一起,第二步想传达的东西就直观了。**规模决定架构,不是潮流决定架构。**我们的 3.2TB 夹在这两个案例中间,位置站在哪一边,一目了然。
结果与复盘
最后中标的是金仓数据库 KingbaseES,四步全过。Oracle 兼容的深度,让我们四十多个包里大部分能自动转换。集中式架构,两个 DBA 驾驭得住。信创清单全绿。POC 里 TOP 50 SQL 的兼容表现也最稳。签约那天,距离立项正好三个月。 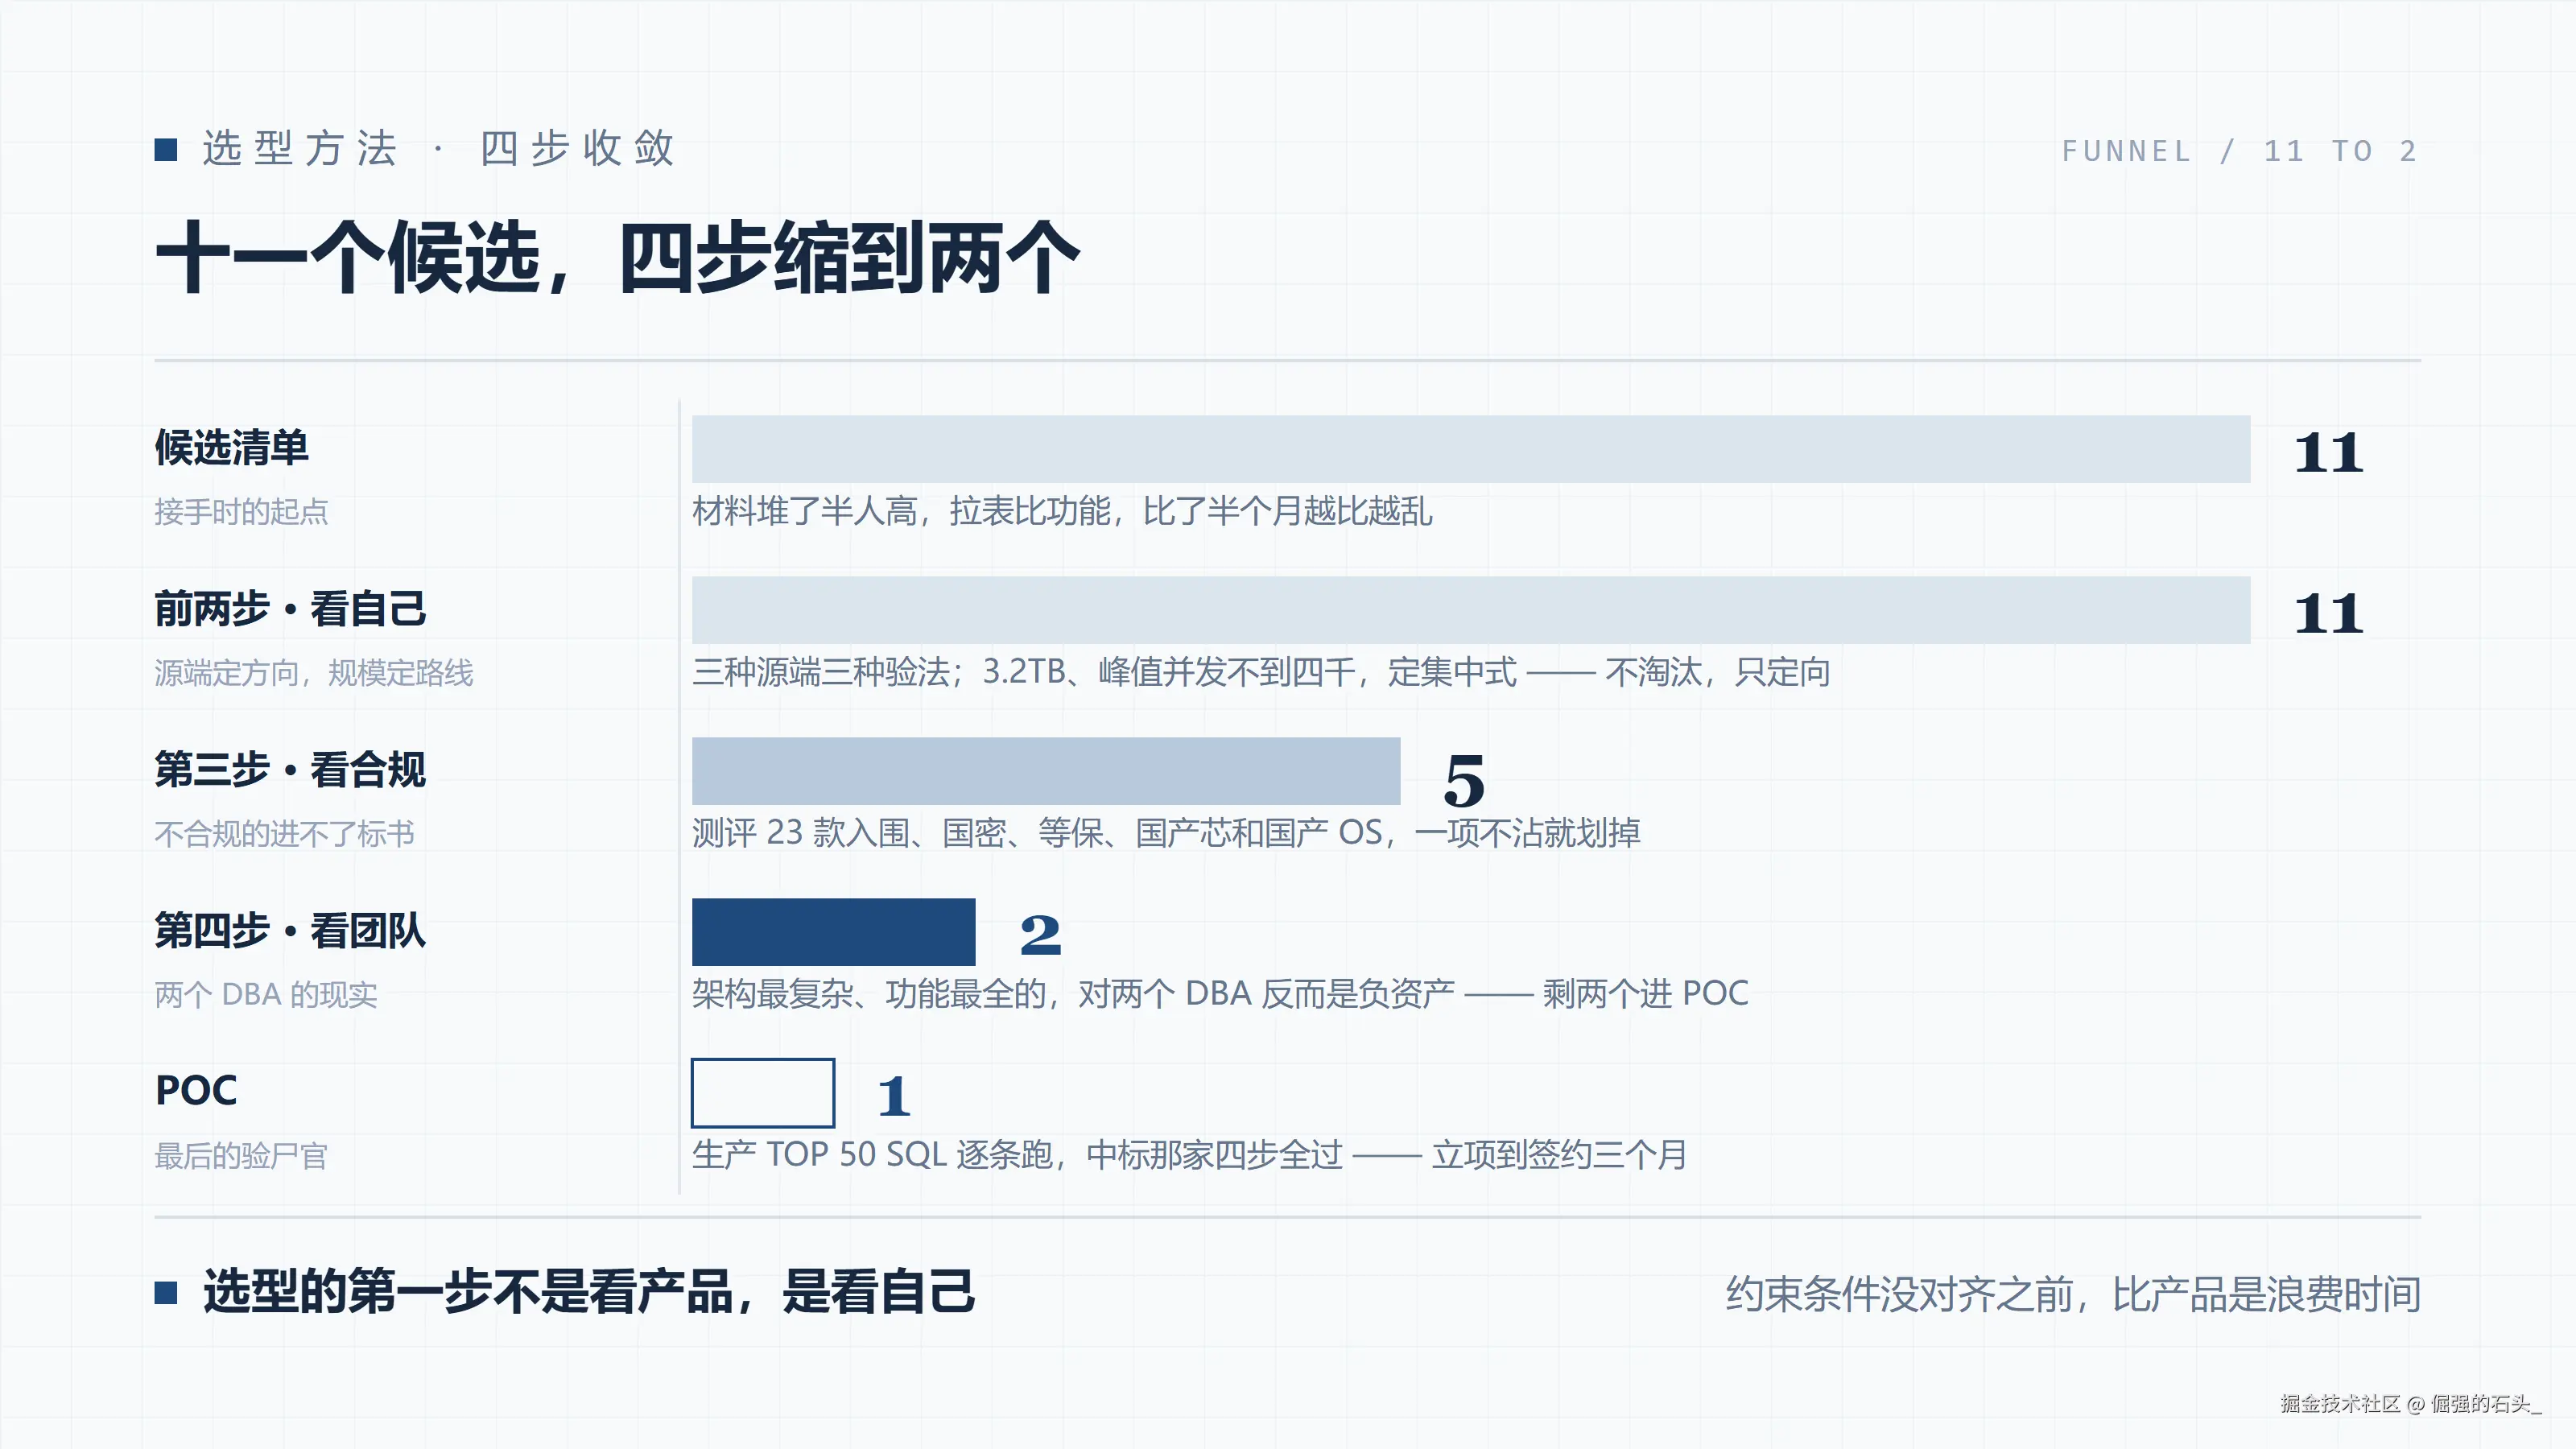
回头看那半个月"拉表比功能"的弯路,问题不在勤奋,在顺序。选型的第一步不是看产品,是看自己。 源端类型决定兼容方向。数据规模决定架构路线。合规门槛划掉不合格的。团队能力决定最终谁能落地。四步走完,你会发现真正需要认真比较的,从来只有两三个。