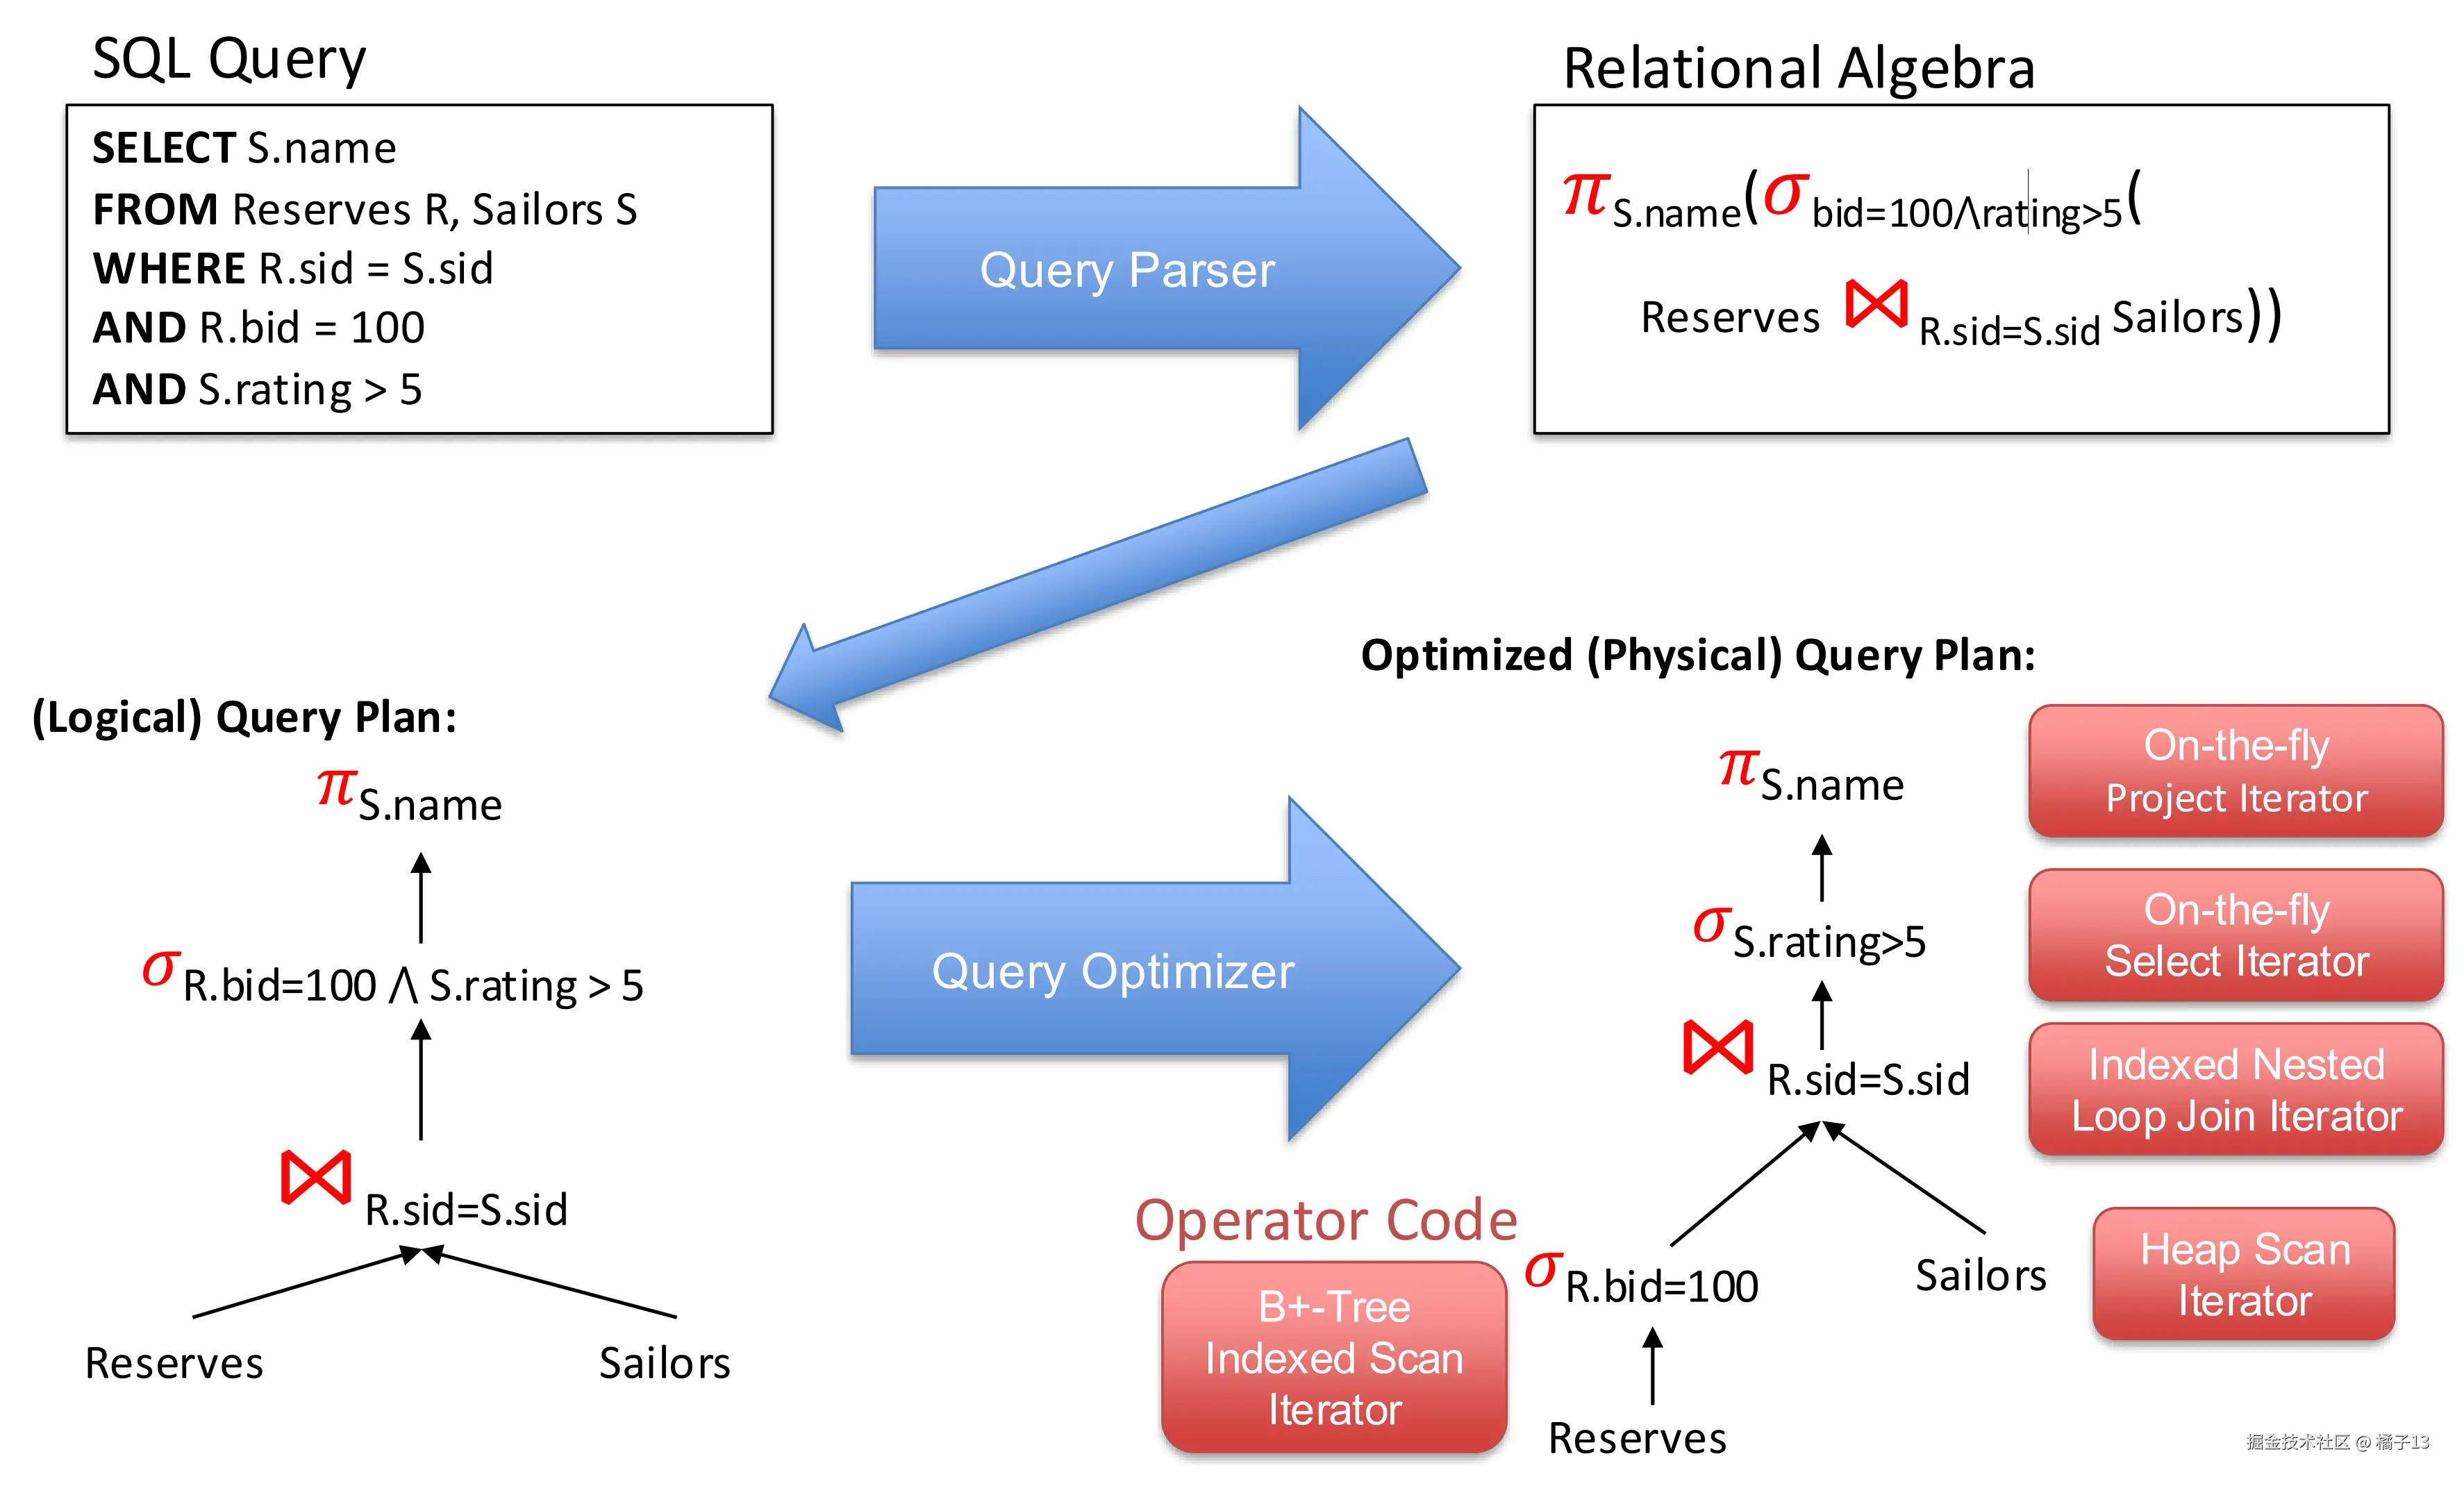
 上图分为如下流程
bash
① SQL 语句
      ↓ Query Parser(语法分析器)
② 关系代数表达式
      ↓ (画成树)
③ 逻辑计划树 (Logical Plan)
      ↓ Query Optimizer(优化器)
④ 物理计划树 (Physical Plan)
      ↓
⑤ 算子代码 (Iterator:open/next/close)| 算子 | 目 | 基本/复合 | 作用 | SQL 对应 |
|---|---|---|---|---|
| π 投影 | 单目 | 基本 | 竖着切列(并去重) | SELECT(要去重得 DISTINCT) |
| σ 选择 | 单目 | 基本 | 横着切行 | WHERE |
| ρ 重命名 | 单目 | 基本 | 改列名/表名 | AS |
| ∪ 并 | 双目 | 基本 | r1 或 r2 | UNION |
| − 差 | 双目 | 基本 | 在 r1 不在 r2 | EXCEPT |
| × 笛卡尔积 | 双目 | 基本 | 两表两两配对 | FROM A, B(无条件) |
| ∩ 交集 | 双目 | 复合 | 同时在 r1 和 r2 | INTERSECT |
| ⋈_θ θ连接 | 双目 | 复合 | × + 条件 | FROM A,B WHERE A.x=B.y |
| ⋈ 自然连接 | 双目 | 复合 | 同名属性等值 + 去重列 | NATURAL JOIN |
注意 π 和 σ 的区别:
- π 竖着切(砍列)
- σ 横着切(砍行)
注意三点
- ∪ 和 − 要求"并相容" 两边的表必须列数相同、对应列类型相同。否则不合法(上一页 p9 的 "typed" 就靠这个静态检查)。
- × 没有条件,所以要配 σ × 单独用几乎没意义,它总是和 σ 一起出现,然后被写成 ⋈。
- 自然连接 ⋈ 按"所有同名属性"等值 两张表只要有同名列,就自动按它等值。如果不想按某个同名列连,就必须用 ⋈_θ 显式写条件。
关系代数操作
复合运算符 join
连接属于复合运算符(和交运算类似),它并不是一种全新的基本操作,而是由笛卡尔积和选择组合出来的"语法糖"。
通用形式:
σθ(R×S)
含义是:先用笛卡尔积把 R 和 S 两两配对,再用选择条件 θ 筛出满足连接条件的行。所以 θ 连接的本质就是"先乘后选"。
常见连接类型的层级关系如下:
- θ 连接 ( R⋈θS):按照逻辑表达式 θ 做连接,是最一般的形式。
- 等值连接 (Equi-Join):θ 条件全部由相等判断(合取等式)构成的 θ 连接,即 θ 只包含 = 且用 ∧ 连接。
- 自然连接 ( R⋈S):在所有同名匹配列上做等值连接,并去掉重复列,是等值连接的特例。
逻辑层(RA 语义):这个连接"是什么意思"
bash
三者是逐层特化的关系:θ 连接 ⊇ 等值连接 ⊇ 自然连接。
⋈_θ   θ 连接(最一般)          例:R ⋈_{R.sid=S.sid ∧ R.bid>100} S
 │
 └─ ⋈_equi  等值连接(θ 只含 "列 = 列" 且用 AND 连)
     │                          例:R ⋈_{R.sid=S.sid ∧ R.x=S.y} S
     └─ ⋈  自然连接(等值 + 只挑"同名属性")
                                例:R ⋈ S(自动按同名 sid 等值)
θ 连接(Theta Join,⋈_θ):最一般的连接
R⋈θS=σθ(R×S) 注意: θ是一个条件
等值连接(Equi-Join,⋈_equi):条件只能是相等
R⋈R.sid=S.sidS=σR.sid=S.sid(R×S)
其中 ⋈R.sid=S.sid 里的条件就是 θ,只是这里的 θ 恰好是"等值"判断。
自然连接(Natural Join,⋈):等值连接的特例
它是等值连接的一种特殊形式:对所有同名字段做相等匹配,并且会把重复的字段通过投影剔除掉。
R⋈S=πunique fld.(σeq. matching fld.(R×S))
计算过程分三步:
- 笛卡尔积 :先计算 R×S,把两张表两两配对。
- 选择(Select) :只留"同名列相等"的行,即 σeq. matching fld.。
- 投影(Project) :去掉重复的列,只保留全部不重复的字段,即 πunique fld.。
两者区别:θ 连接和自然连接的条件来源不同:θ 连接的条件由你书写,自然连接的条件由数据库根据"有没有同名列"自动确定。
物理层(执行算法):这个连接"怎么算出来"
代价记号(Cost notation)
- R:存储关系 R 所占的页数(pages)
- pR:关系 R 每页存放的记录数(records per page)
- ∣R∣:关系 R 的基数,即记录总数(cardinality)
有如下公式: ∣R∣=pR×R
简单嵌套循环连接(Simple Nested Loops Join,SNLJ)
最朴素的连接实现:对 R 的每条记录,都完整扫描一遍 S,逐对判断连接条件 θ。
适用情况:任何逻辑连接类型的 θ 连接(含 <、≠、OR),这种执行算法作为兜底策略。
text
Join(R, S):
    foreach record r in R do
        foreach record s in S do
            if θ(r, s) then
add <r, s> to result- 时间复杂度 : ∣R∣×∣S∣ 次记录比较
- I/O 代价 : R+∣R∣×S 次页读取(外层每读一条记录,内层都要重扫一遍 S) SNLJ 代价 = 外表页数 + 外表记录数 × 内表页数
- 特点:实现最简单,但代价最高,通常只作为其他算法的对照基准
索引嵌套循环连接(Index Nested Loops Join,INLJ)
在 SNLJ 的基础上做优化:内层不再全表扫描 S,而是利用 S 连接列上的索引,直接定位到匹配的记录。
适用情况:等值连接和自然连接
text
Join(R, S):
    foreach tuple r in R do
        foreach tuple s in S where r_i == s_j do   ← 只取匹配的那些(走索引)
            add <r, s> to result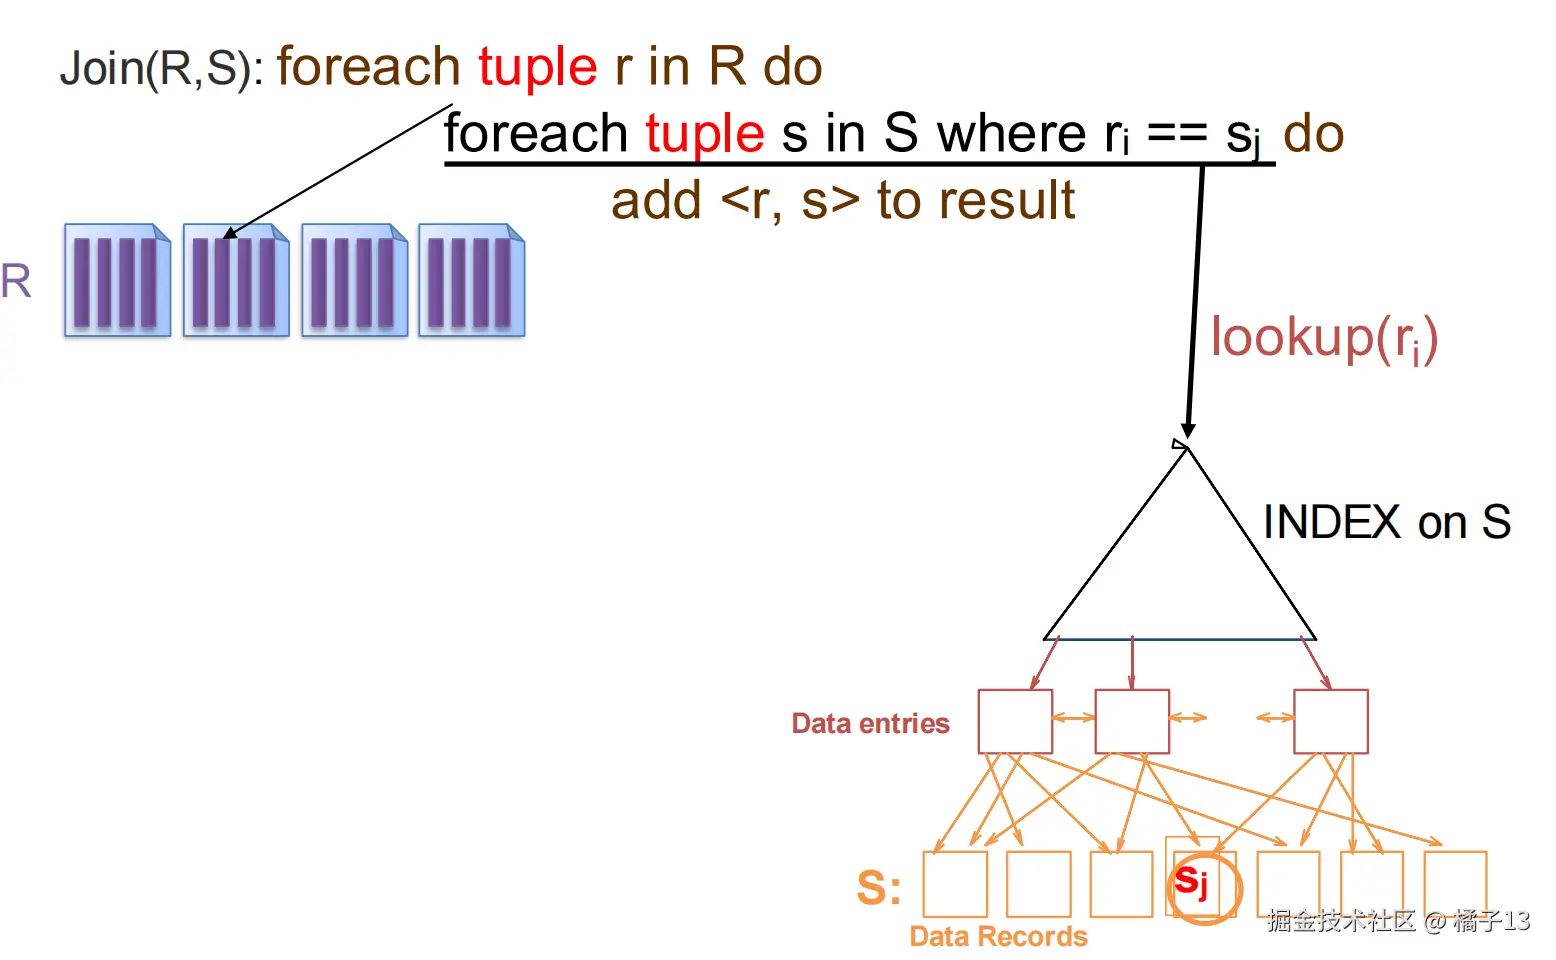
- 时间复杂度 : ∣R∣×log∣S∣(每次索引查找为对数级)
- I/O 代价 : R+∣R∣×cost to find matching S tuples 次页读取
- cost to find matching S tuples = 索引下降(search) + 回表(retrieval)
- 特点:内表连接列有索引时效率显著优于 SNLJ,是实际数据库中最常用的连接算法之一
| 情形 | 代价 | 数值 |
|---|---|---|
| Alt.1(by value)(树里直接有整条记录) | 只需 search = 从根走到叶 | 2--4 I/O |
| Alt.2(by reference) | ① search:lookup RID | 2--4 I/O |
| ② retrieval:拿 RID 回堆文件取记录 | 聚簇:匹配元组占几页就几 I/O(per page) 非聚簇:每条匹配 1 I/O(per tuple) |
⇒ 因此"Clustered 按页算 / Unclustered 按条算"这行是全部代价差异的来源: 一条 r 匹配 k 条 s:聚簇花 ⌈k/p_S⌉ 页,非聚簇花 k 页。
举例 : 数据:外层 R( R=1000, pR=100, ∣R∣=100,000)、内层 S( S=500, pS=80, ∣S∣=40,000),可用的索引高度为 4 层。
| 方案 | 公式 | 假设每个 key 的匹配数 k | 代价 |
|---|---|---|---|
| 无索引(SNLJ) | R+∥R∥×S | --- | 1000+100,000×500=50,001,000 |
| 非聚簇索引(k=1) | R+∥R∥×(4+k) | k=1 | 1000+100,000×5=501,000 |
| 聚簇索引(k=1) | R+∥R∥×(4+⌈k/pS⌉) | k=1 | 1000+100,000×5=501,000 |
| 非聚簇索引(k=10) | 每条匹配需 1 页,因此为 4+10 | k=10 | 1000+100,000×14=1,401,000 |
| 聚簇索引(k=10) | ⌈10/80⌉=1,因此为 4+1 | k=10 | 1000+100,000×5=501,000 |
| 非聚簇索引(k=1000,重复键很多) | 4+1000 | k=1000 | 1000+100,000×1004=100,401,000,比全扫还差! |
排序归并连接(Sort-merge join)
适用情况:适用于等值连接和自然连接
- Two stages:分为两个阶段:
- Sort tuples in R and S by join key 按照连接键,对 R、S 的元组分别排序
- all tuples with same key in consecutive order 相同键值的所有元组会连续排列在一起
- input might already be sorted ... why? 输入有可能本身已经有序......(思考:为什么这很重要?)
- Merge scan the sorted partitions and emit tuples that match 对两个有序分区进行归并扫描,输出匹配的元组
- Sort tuples in R and S by join key 按照连接键,对 R、S 的元组分别排序
bash
while (还没结束) {
    while (r < s)  advance r          // ① 追赶:R 落后就往前进
    while (r > s)  advance s          //     S 落后也往前进
    // 此时 r == s
    mark s                            // ② 记住 S 在这个 key 组的起点
    while (r == s) {                  // ③ 外层:R 里所有同 key 的记录
        while (r == s) {              // ④ 内层:S 里所有同 key 的记录
            yield <r, s>              //    输出一对
            advance s                 //    S 前进
        }
        reset s to mark               // ⑤ S 回到组开头(给 R 的下一条重新配)
        advance r                     //    R 前进
    }
}IO代价: Sort R + Sort S + (R+S) 代价 = 排序 R 的开销 + 排序 S 的开销 + 归并扫描阶段读 R、S 的开销
但是最坏情况下,最后这一项代价可能变成 (R\timesS)(这种情况非常少见!)
问:什么是最坏情况?
✅ 标准答案:重复键极多。同一个连接键在 R 和 S 里都有大量元组,归并时需要嵌套遍历所有匹配元组,退化成笛卡尔积级别的扫描。
第二个结论:两趟排序的缓冲条件 B>max(R,S)
这个结论和外部排序的「两趟上限」是同一回事,下面把推导一步步写清楚。
第一步:pass0 造 run。 用 B 个缓冲页做初始归并段(run),每个 run 最多装 B 页,所以 N 页数据能造出
⌈N/B⌉ 个 run
第二步:一次归并最多并几个 run。 归并时要用 1 个缓冲页做输出,剩下的 B−1 页各对应一个输入 run,因此一次归并最多合并 B−1 个 run。
第三步:两趟排完的条件。 两趟排序 = pass0 造 run + pass1 一次归并全部 run,所以要求 run 的个数不超过一次能并的上限:
⌈N/B⌉≤B−1
去掉上取整(放大成更严格的条件):
N≤B(B−1)
第四步:解出 B。 当 B 较大时 B(B−1)≈B2,于是
B≈N (精确做法:试算 B(B−1)≥N)
第五步:套到连接上。 排序归并连接要对 R 和 S 各排一次,两张表都要能两趟排完,取两者中较大的页数作为约束:
B>max(R,S)
只要满足这个条件, R 和 S 都能在两趟内排好,排序归并连接的总代价就稳定在 3(R+S) 量级,而不会退化。
朴素内存哈希连接(Naïve in-memory hash join)
适用情况:适用于等值连接和自然连接
算法思路
- 选较小的表 R 作为构建表(build relation),大表 S 作为探测表(probe relation),判 R < 0.7×(B−2),满足才走 naïve hash,否则换 Grace。
- Build 阶段:逐页读 R(R 次页读),把全部 R 读入内存,在 join key 上构建哈希表,每个 entry 存 (key, 整条记录)(不是索引与记录分离!),插表是内存操作。
- Probe 阶段:S 逐页流式读(S 次页读),每条算 h(key) 定位桶 → 桶内真比较 key → 相等则拼接(看规则,可能去掉重复列)输出;冲突靠 key 比较排除,重复 key 会输出多行。
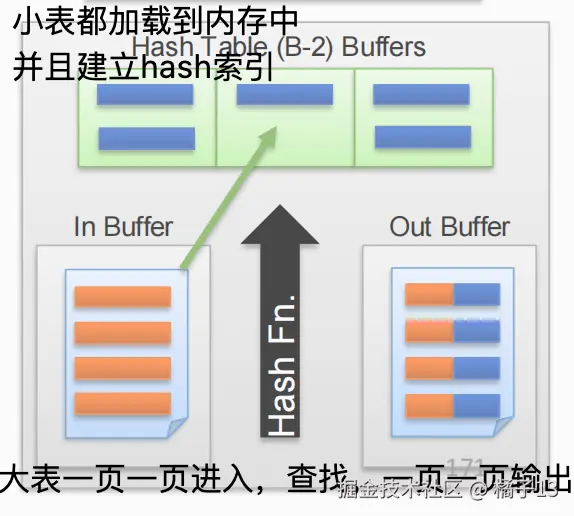 内存约束公式
R<(B−2)×hash_fill
| 记号 | 含义 |
|---|---|
| B | 内存总缓冲块数量 |
| B−2 | 预留 2 个块:一个作输入缓冲区(In Buffer)、一个作输出缓冲区(Out Buffer),剩下的块用来存哈希表 |
| hash_fill | 哈希表装填因子(hash fill factor,哈希表块的有效利用率, <1,通常取0.7) |
| R | 存放关系 R 需要的块数 |
含义 : R 所占块数必须小于哈希表可用空间上限,才能全部装入内存,从而执行这个朴素版本。
IO代价: R + S
Grace Hash Join
适用情况:适用于等值连接和自然连接
算法过程 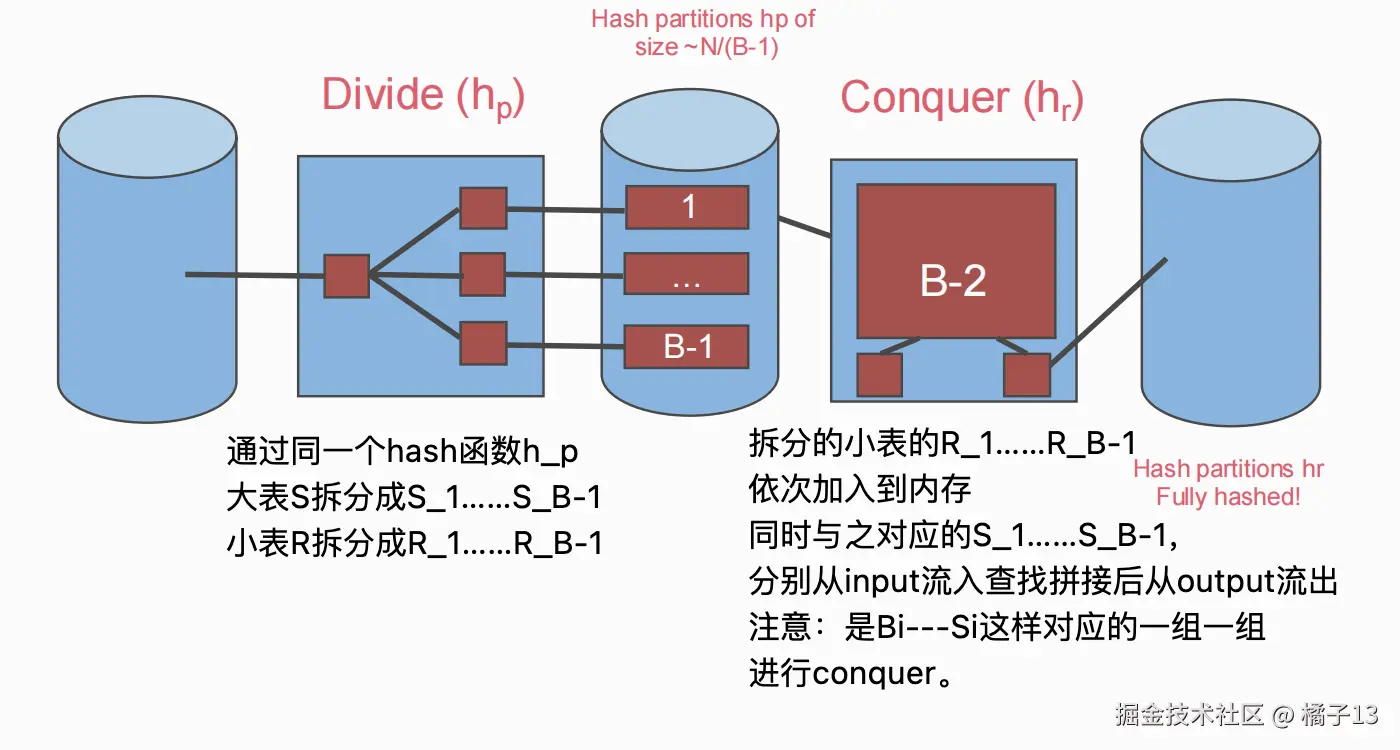
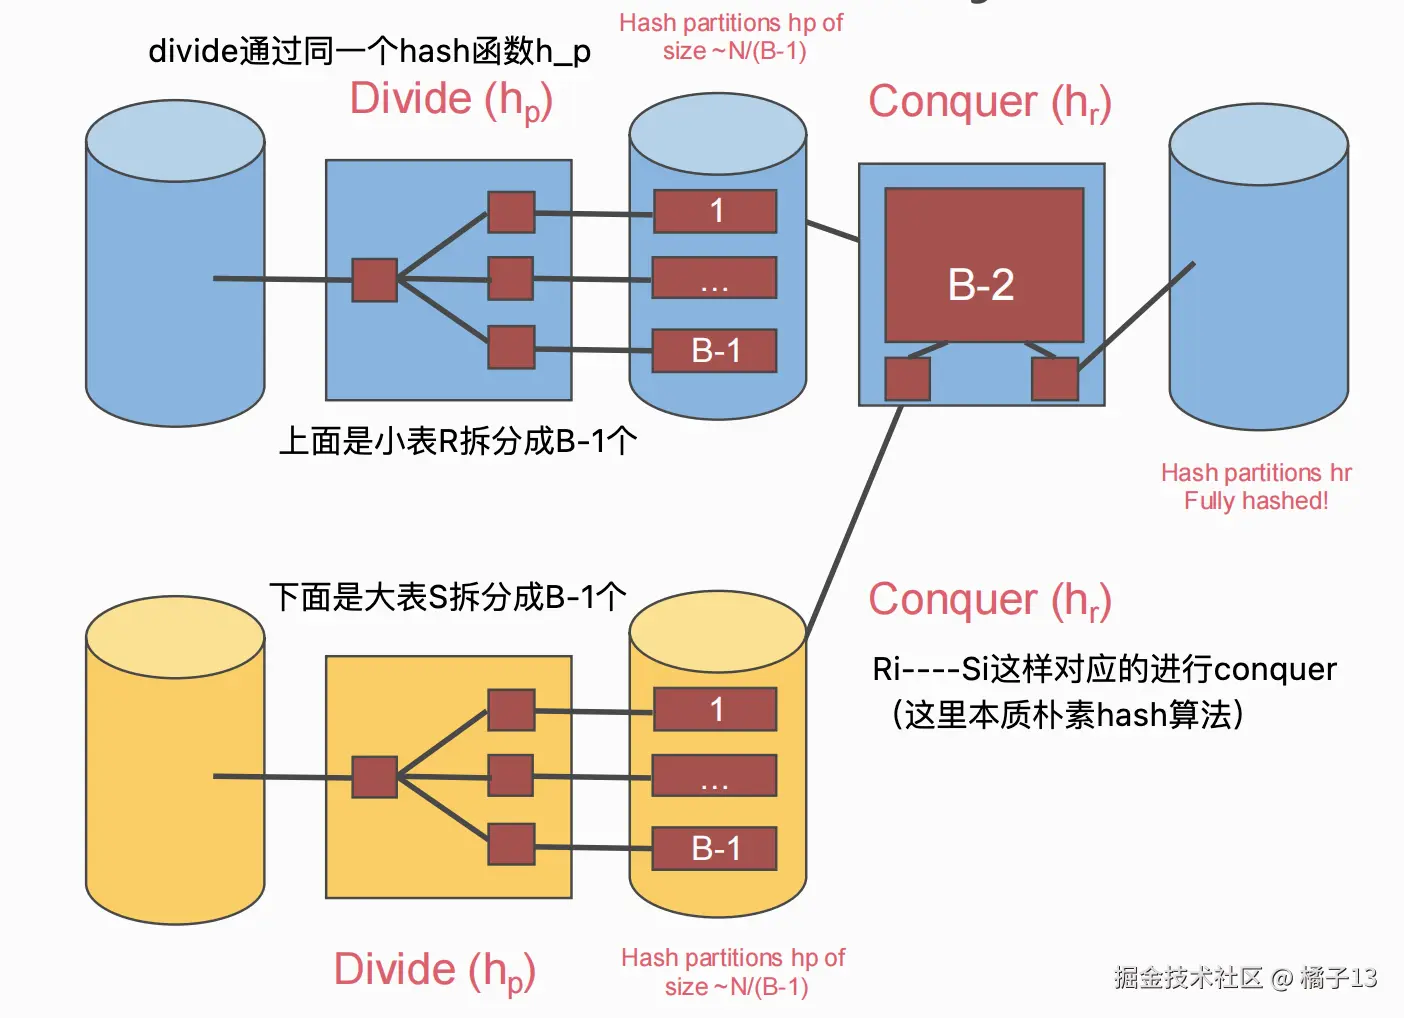
- Partition 划分阶段(Divide)
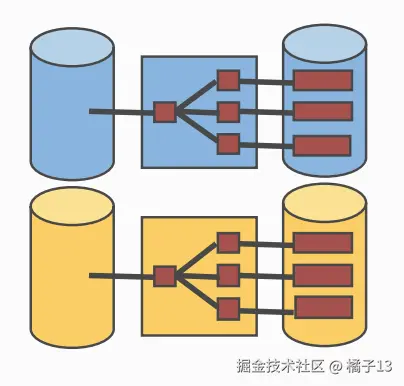
按照连接键,对关系 R、S 的元组做哈希分区
- 同一个连接键对应的所有元组,一定会分到同一个分区
bash
用同一个哈希函数 h_p,把 R 和 S 各自按 join key 分到 B−1 个磁盘分区:

  for each page of R:  逐条算 h_p(key) mod (B−1) → 追加到对应分区输出缓冲 → 满则 flush
  for each page of S:  同上

结果:R₁...R_{B−1},S₁...S_{B−1}(成对的分区)
保证:同一个 key 的记录,一定落在同一对分区(R_i 和 S_i)里
为什么是 B−1 :分区阶段 1 帧装输入页,剩下 B−1 帧各挂一个分区当输出缓冲。 为什么必须用同一个 h_p 切两张表:否则同 key 会落到 R_i 和 S_j(i≠j),就 join 不起来了。
- Build & Probe 构建 + 探测阶段(Conquer)
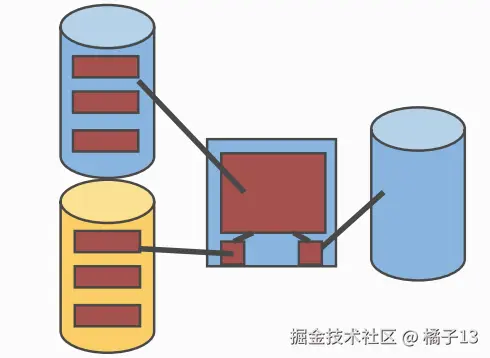
对每一个分区,单独执行哈希表构建与探测(就是前面朴素内存哈希连接的算法)
- 假设:较小表的单个分区可以装入内存
- 如果某个分区还是太大,放不下内存:递归分区(换正交哈希函数继续拆分)
bash
for i = 1 .. B−1:                     ← 一次只处理一对分区
    读 R_i 进内存,用 h_r 建哈希表       ← 和 naïve hash 完全一样
    扫 S_i,逐条 probe                   ← 命中就拼接输出
    释放,处理下一对
伪代码
bash
// ========== 阶段1:Divide 划分阶段:对 R、S 分别哈希分区,写入磁盘 ==========
For Cur in {R, S}:                // 依次处理关系R、关系S
    For page in Cur:              // 遍历当前关系的每一个磁盘页
        Read page into input buffer   // 将磁盘页读入内存输入缓冲区
        For tup on page:              // 遍历页中每一条元组
            // 按连接键hash_p计算桶号,放入对应桶的输出缓冲区
            Place tup in output buf[ hash_p(tup.joinkey) ]
            If output buf full then flush to disk partition
    // 当前关系全部扫描完成,把缓冲区里残留数据刷盘
    Flush output bufs to disk partitions


// ========== 阶段2:Conquer 求解阶段:逐个分区执行朴素哈希连接 ==========
For i in [0..(B-1)):              // 遍历每一对编号相同的分区 (R_i, S_i)
    // Build 构建:读取R的第i分区,在内存建哈希表
    For page in R_i:
        For tup on page:
            // 使用 hash_r 在内存哈希表中插入这条元组
            Build tup in memory hash_r(tup.joinkey)

    // Probe 探测:读取S的第i分区,去哈希表匹配
    For page in S_i:
        For tup on page:
            Read page into input buffer
            // 用连接键探测内存哈希表,查找匹配元组
            Probe memory hash_r(tup.joinkey) for matches
            Send all matches to output buffer
            Flush output buffer if full
IO 代价 2-pass hash
bash
分区(Divide)  :读 [R]+[S] → 写 [R]+[S]   = 2([R]+[S])
建表+探测(Conquer):再读 [R]+[S]          = 1([R]+[S])
────────────────────────────────────────────────
总计 = 3([R]+[S])
若发生递归:每多一层,多付一趟 2(R+S) (读+写整个文件),所以递归版代价 = 2(R+S) × 层数
内存要求
在 R 上构建哈希表,假设分区均匀分布。
划分阶段(Divide) :把 R 切分成 B−1 个分区,每个分区大小约为
B−1R
匹配阶段(Conquer) :要求 R 的单个分区页数小于 B−2,即
B−1R<B−2
两边同乘 B−1,得到
R<(B−1)(B−2)
当 B 较大时 (B−1)(B−2)≈B2,近似写成
R<B2
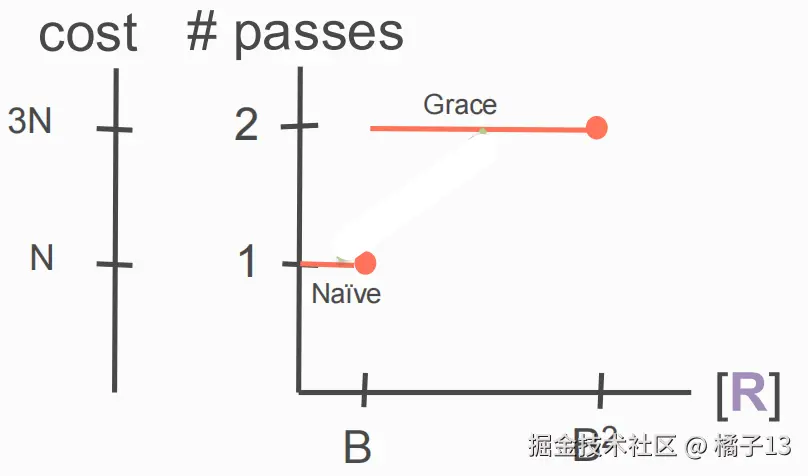
| R 的范围 | 算法 | 趟数 | 代价 |
|---|---|---|---|
| R<B | Naïve(整表进内存) | 1 | R+S |
| B<R<B2 | Grace | 2 | 3(R+S) |
| R>B2 | Grace 递归 / 换 SMJ | ≥3 | 更贵 |
bash
这个连接是什么语义?
│
├─ θ 里含 <、>、≠、OR ......(非等值)
│     └── 只能:SNLJ / PNLJ / BNLJ
│
└─ 等值(equi / natural)
      └── 候选:SNLJ、INLJ、Sort-Merge、Hash
                  ↑
            优化器按代价四选一
                  │
                  ├─ 小表装得进内存       ──→ In-memory hash   (最便宜)
                  ├─ 有聚簇索引          ──→ INLJ
                  ├─ 两侧已排序/结果要排序 ──→ Sort-Merge
                  └─ 都不行             ──→ SNLJ(兜底)

Q1 谓词是等值吗?
   └ 否 → SNLJ(唯一能吃任意 θ 的)
Q2 内表有可用索引吗(且够有选择性)?
   └ 是 → INLJ(聚簇 1/页、非聚簇 1/条)
Q3 小表能装进内存吗?
   ├ [小表] < 0.7·(B−2)     → Naïve hash   [R]+[S]
   ├ [小表] < (B−1)(B−2)≈B² → Grace hash   3([R]+[S])
   └ 再大 → 递归分区 / Sort-Merge
附加:结果需要 ORDER BY / 输入已有序 → Sort-Merge 加分
各连接算法对比总表
| 算法 | ① 适用情况 | ② 算法流程 | ③ I/O 代价 |
|---|---|---|---|
| SNLJ 嵌套循环 | 任意连接的谓词 θ(含 <、≠) 没有索引 内存可任意小 | 遍历外层的每一条记录 → 完整扫描一遍内表 → 比较外层和内层的每一条记录 | R+∥R∥×S 页级: R+R×S 块级: R+⌈R/(B−2)⌉×S |
| INLJ 索引嵌套循环 | 等值连接(索引也支持范围查询) 内表在 join key 上有索引 | 遍历外层的每一条记录 → 用索引查到 RID(2--4 页) → 按 RID 回表读取记录 | R+∥R∥×(h+retr) retr:聚簇 ⌈k/p⌉、非聚簇 k Alt.1(叶存整行)则没有回表 |
| Naïve hash 内存哈希 | 等值连接 小表 <(B−2)⋅f, f≈0.7 | ① Build:把小表全部读进内存,建立哈希表 ② Probe:扫描大表,用同一个哈希函数找桶 | R+S |
| Grace hash | 等值连接 小表 <(B−1)(B−2)≈B2 | ① Divide:用 hp 把两张表各分到 B−1 个磁盘分区 ② Conquer:对每个分区,用 hr 在内存中 build 表并 probe | 3(R+S) = 分区 2N + 匹配 1N,其中 N=R+S |
| Sort-Merge | 等值连接 输入已经(或能够)有序,或者需要输出有序 不怕 skew | ① 把两张表按 join key 排序 ② 用双指针做归并 ③ 遇到 key 相等时,输出组与组的配对 | sort(R)+sort(S)+R+S =5(R+S)(排序各两趟) 最坏 R×S(重复键让整组装不进内存) |