一个 1572 行的函数,让 AI 按开源工具 rulemason 的清理流程拆成了 150 行,测试全绿。但测试绿了,只说明写过的用例没坏。这篇讲我们又做了哪四件事,才敢说「行为一点没变」。
先看结果
项目里有一个后台任务函数,负责调用上游服务、处理限流和重试、写入结果、发通知。全部写在一个函数里,1572 行。谁要改它,得先在 1500 多行里找到自己要改的那几行。
这次由 AI 编码助手(Claude Code)动手,按 rulemason 的存量清理流程走,人负责确认计划和验收。rulemason 是一个开源项目:给 AI 编码工具定一套写代码的规矩,再加上每次改动都要过的检查点。它在这次整理里管了哪些事,第五节单独说。结果:
| 改前 | 改后 | |
|---|---|---|
| 主函数行数 | 1572 | 150 |
| 主函数复杂度 | 143 | 7 |
| 全量测试 | 6471 通过 | 每一步都是 6471 通过、0 失败 |
「复杂度」是什么,下一节说。
一、函数多长算长?数行数不如数岔路口
网上流传一张表:少于 30 行理想,80 到 150 行偏长,超过 200 行要重构,1500 行以上是「屎山」。好记,但只看长度。
读代码真正累的,是要同时记住多少种情况。圈复杂度 数的就是这个:函数里有多少个岔路口(if、循环、except......)。一个 500 行、从头走到尾的函数,复杂度是 1;一个 20 行但处处是判断的函数,可能超过 10。Python 的 lint 工具 Ruff 用规则 C901 来查,默认上限是 10,这个数来自提出圈复杂度的 McCabe 当年的建议。
我们拿同一批 11 个函数,用两把尺子各量一遍:
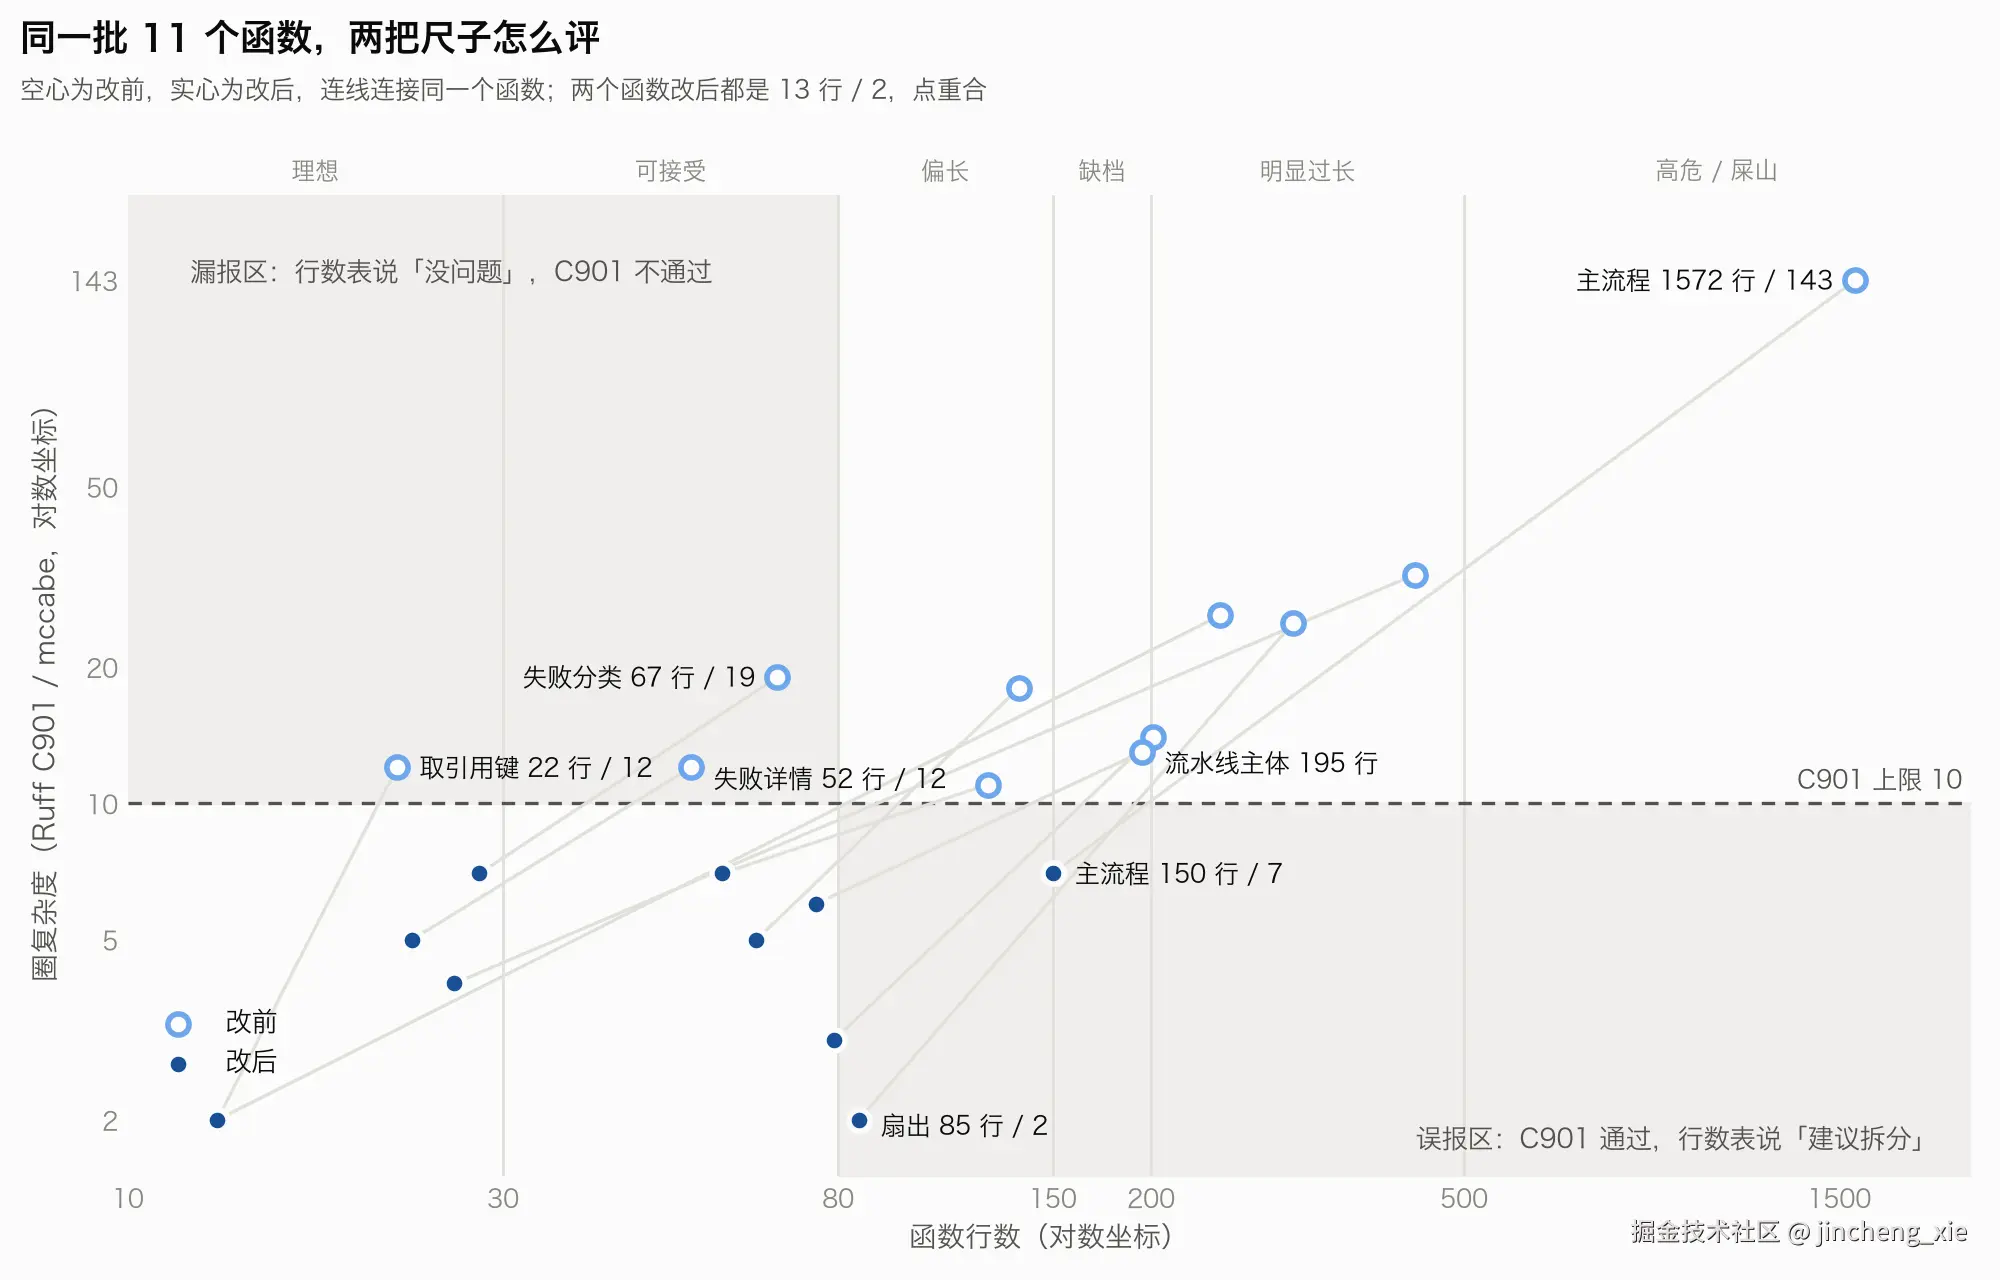
两把尺子在两头是一致的,1572 行谁看都知道要拆。分歧在中间:
- 该拆的没报:一个 22 行的函数有 12 个岔路口,行数表说它「非常理想」。
- 不该拆的报了:一个改后 85 行、只有 2 个岔路口的函数,行数表还说「建议拆分」。
所以这次的目标只看复杂度:每个函数拆到 10 以内。行数不当目标,事先就说好不承诺减行。
二、怎么拆:分 4 步,每步都能回退
一口气改 1572 行,出了问题不知道是哪里引起的。我们分成 4 步,每一步都是一个能单独提交、单独回退的状态:
改前       143
第 1 步     80   拆出「写结果」和「收尾」
第 2 步     68   拆出「前置检查」和「没有可用线路」
第 3 步      7   拆出最难的「线路重试循环」
第 4 步          处理同一文件里另外 3 个超标函数
拆完以后,主函数读起来像一份目录(示意,已脱敏并简化):
python
async def run_job(...):
    job = prepare_job(...)                      # 前置检查
    if (done := await already_finished(job)):   # 已经做完就直接返回
        return done

    state = await run_route_loop(job)           # 按顺序试各条上游线路
    if state.finished:
        return state.result

    outcome = state.outcome()
    finalized = await finalize(job, outcome)    # 写结果、结算、审计
    await notify(job, finalized)                # 推送与告警
    return summary(job, outcome)
拆的过程中顺手收拾了几处典型问题:
- 同一段「排队重试」的代码复制了 4 份,其中一份就有 50 多行,收成了一个函数。
- 循环里定义了 4 个闭包,它们引用循环变量,读的人得自己确认会不会读到下一轮的值,改成了一个带状态的小类。
- 90 多行「有值才拷贝」的
if,改成了按键列表拷贝。这里有个坑:原代码里「不为 None 才拷」和「为真才拷」两种判断混着用,合成一种就会改变空字符串和 0 的处理,所以拆成了两个函数。
三、测试全绿之后,又做的四件事
为什么测试绿了还不够?两个原因:
- 测试只管写过用例的那些路径,1572 行里有大量岔路没人写过用例。
- Python 测试常按名字替换依赖(打桩)。重构时把代码搬到别处,桩就替换不到了,测试照样能过,实际跑的已经是别的东西。
所以我们又做了四件事。它们有一个共同的规矩:每种检查写好后,先故意把代码改坏一处,确认检查会报错,再改回来。 发现不了错误的检查,跑再多遍也没用。这条写在 rulemason 清理流程的原则里。
第一件:录像对比
改前、改后各跑一遍相关的 554 个测试,把每个测试发出的每一条 SQL、打出的每一行日志都记下来,逐条比对。就像给程序录两段像,一帧一帧对。
结果:535 个完全一致,14 个改前就不稳定(比如输出里有 AI 随机生成的文案),另有 4 个不一致。
这 4 个多发了一次数据库查询,查到的数据完全一样。原因是:这几个测试共用一个数据库连接,改前大函数一直攥着某条记录,它留在缓存里,再读时不用查库;拆成小函数后,这条记录随函数返回被释放,再读就要重新查。我们临时把记录留住再跑一遍,差异消失,原因就确认了。线上每次都新建连接,本来就会查库,所以没有差别。
这种差异测试抓不到,因为结果一模一样。
第二件:新旧两版做同一套题
把改前的代码留一份,和新代码放在一起。数据库、队列、上游服务这些外部依赖,全部换成会记账的替身。再随机生成大量场景(上游成功、失败、限流、超时......),让新旧两版各做一遍,要求返回值、调用了哪些依赖、抛了什么异常、最后写进数据库的内容,全都一样。
主函数做了 12000 道题,全部一致。
这里也踩过一个坑:裁判自己漏看了。对比脚本的日志级别设错了,INFO 级别的日志根本没记下来,也就没参与比较。发现后修好重跑,结论没变,但证据到这时才完整。检查工具本身也要检查。
第三件:确认题目真的考到了新代码
12000 道题全对,前提是题目真的走到了新代码。统计下来,新增和改动的 814 行全部被执行到了。
第四件:故意埋雷
执行到,不等于检查到。最后一步是故意往代码里埋雷:改一个常量、换一个边界、少调一次依赖......每埋一个,就让上面的「新旧对题」重跑一遍,看它能不能发现。
一共埋了 63 个,最终全部被发现。前几轮有漏网的,说明随机题目没出到那条路,补了题目才全部抓住。没有这一步,「12000 道全对」也可能只是题太简单。
yaml
测试全绿          6471 个,每步都过          底线
录像对比          554 个测试逐条比           对外发出的东西一样
新旧对题          12000 道全部一致          各种情况下结果一样
覆盖自检          814 行全部走到            题目考到了新代码
故意埋雷          63 个全部被发现          检查本身抓得住错
四、代价和没做到的
- 文件变长了 31%(3400 行到 4453 行)。拆函数不会减少岔路口的总数,只是把它们分到 84 个小函数里;函数签名和说明也要占行。这是事先就说好的。
- 主函数停在 150 行。复杂度已经是 7,剩下的主要是参数和日志。再拆只会把一串参数原样往下传,读起来更累。
- 新旧对题用的是替身,不碰真实数据库。第一件里那种「多查一次库」的差别,它看不到,要靠录像对比兜底。
五、rulemason 在这里管了什么
这个函数能被发现、被排上日程、按上面的方式拆完,每一步都有 rulemason 的一份:
yaml
接入        装上 lint 规则:复杂度上限 10
  |         老代码先登记成「接入前遗留」,不至于一接入就全红
  v
诊断        /rulemason cleanup:全仓 60 个模块按问题多少排队
  |         点名「这个函数复杂度 143,需分批拆」
  v
列计划      复杂度目标、分几步、不承诺减行,等人确认才动手
  |
  v
动手        AI 按清理流程的七条原则做
  |
  v
收尾 跑 ruff 和全量测试;清干净的文件从「遗留」清单里删掉- 定上限:接入时,rulemason 给项目装上共享的 ruff 规则,复杂度上限 10。这个函数当时被登记成「接入前遗留」:日常开发不被它卡住,但也不会被忘掉。这次拆完,这个文件的复杂度和闭包两条豁免已经删掉。
- 排队 :
/rulemason cleanup先只诊断不改代码,把全仓模块按问题多少排好队,这个函数所在的模块排第 6。 - 定计划:进入模块后先列计划、等人确认。计划要写明复杂度目标(这次选了「给上限留余量」,新函数不超过 8)、分几步做,并且复杂度和行数分开预估、不承诺减行。第一节里「只看复杂度」「不承诺减行」就是从这里来的。
- 定规矩:清理流程开头有七条原则,本文用到的有:等价的证据要独立于测试通过,对跑测试先见过它失败;被测试按名字依赖的东西不动;指标是手段;改前改后用同一条命令对比;行为差异逐项披露。
- 收尾:改完自动跑 ruff 和全量测试;不替你提交,改动留在工作区由人检查。
也要说清楚 rulemason 没做的:录像对比、新旧对题、故意埋雷这几套脚本,是 AI 按「证据独立于测试」这条原则当场写的,rulemason 目前不自带这些工具。反过来,这个项目前几个模块清理时记下的约 40 条反馈,已经写回了 rulemason 的清理流程,上面那七条原则就是这么来的。
想在自己的项目里试:
bash
uv tool install rulemason    # 装一次
rulemason init               # 在项目根目录运行,勾选你用的 AI 工具
然后在 AI 工具里运行 /rulemason 补全项目信息,再用 /rulemason cleanup 做全仓诊断。支持 Claude Code、Cursor、Codex、OpenCode。
六、可以带走的三条经验
- 测试全绿是底线,不是证明。 要说行为没变,再拿几份不依赖现有测试的证据,并且先证明每份证据抓得住错。
- 先定量什么,再动手。 这次量岔路口,不量行数;改前改后用同一条命令量,数字才可比。
- 让 AI 分步做,每步留证据。 每一步都能单独回退;AI 中途被打断时,靠事先存下的改前证据接着做,不用重来。
项目地址:github.com/rulemason/rulemason。欢迎试用和提 issue。