效果展示
前言
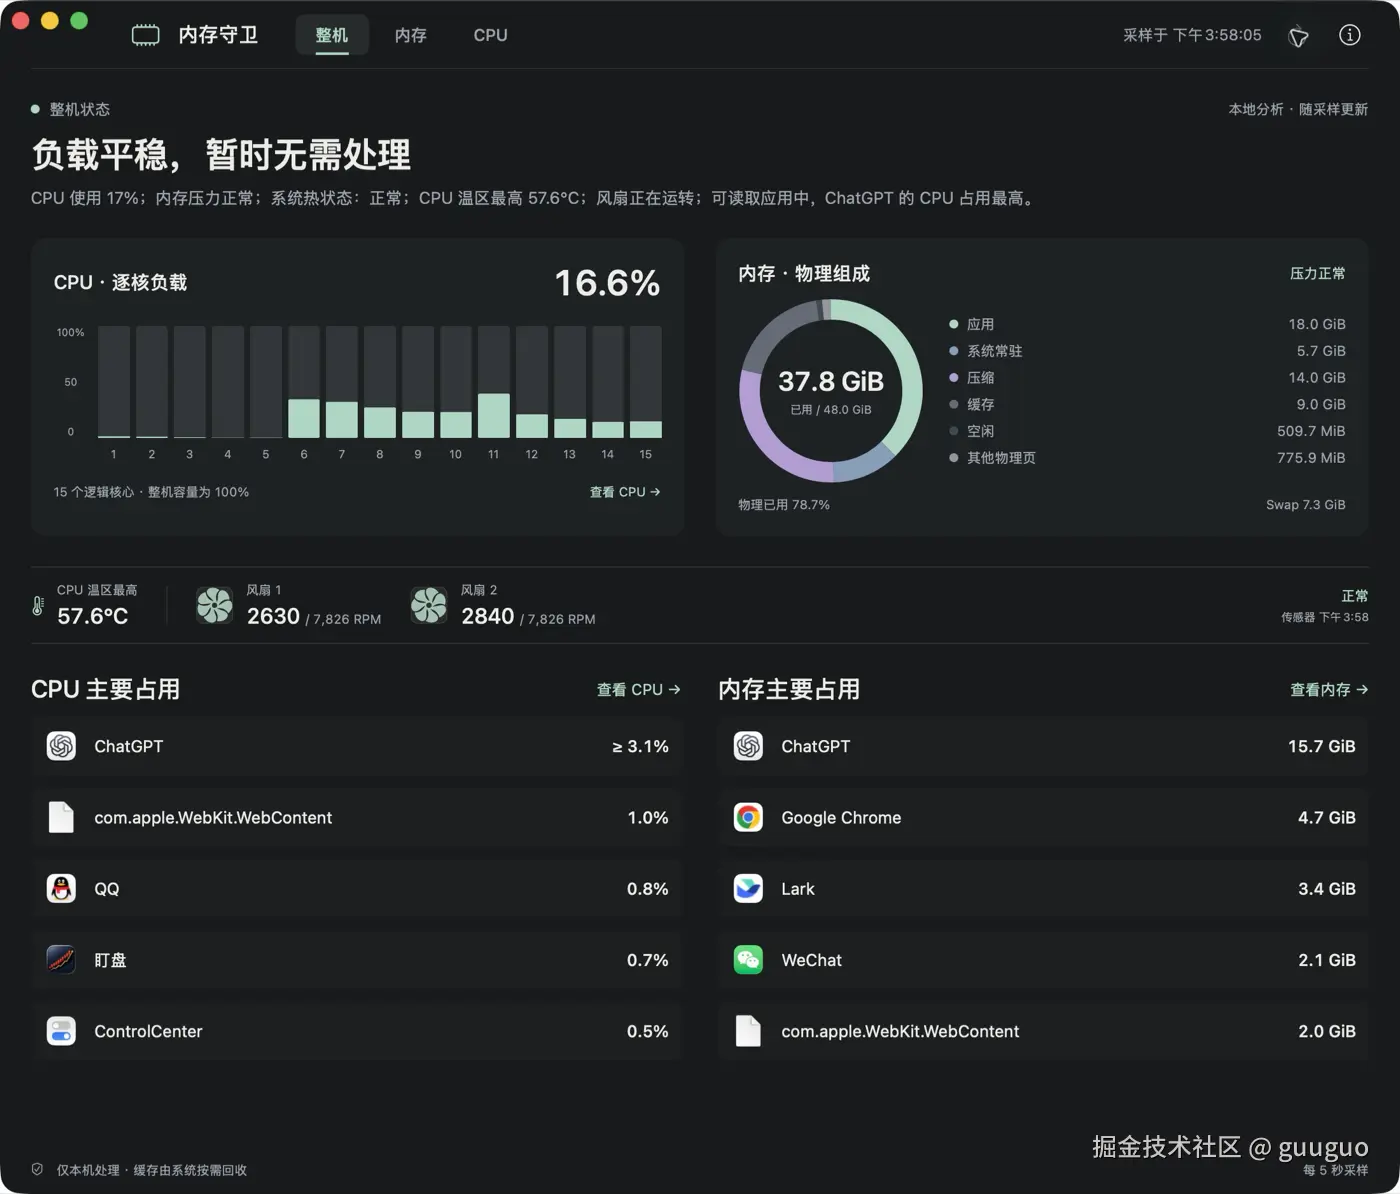
最近在 48 GiB 内存的 Mac 上开着 Codex、ChatGPT 和几个终端会话跑代码,物理内存经常莫名顶到 35 GiB 以上。
打开系统自带的活动监视器一看,列表里全是黑盒的 node 进程,加起来差不多 6 GiB。
可活动监视器只给你显示一个孤零零的名字叫 node,你根本看不出它属于哪个项目、是什么 MCP 服务、或者是不是哪个已经关掉的会话留下的。
不敢随便杀,重开客户端又怕把正在跑的上下文搞断。
于是顺手在自己日常用的原生 SwiftUI 监控工具 MemoryGuardian(内存守卫)里,把 AI / MCP / Node 深度归因 和 保守安全回收 这套逻辑补齐了,顺便清理掉历史旧代码,直接开源出来。
一、把吃掉 6G 内存的 MCP 直接揪出来
工具写好之后对着本机一扫,以前黑盒的 node 进程一下全显形了。
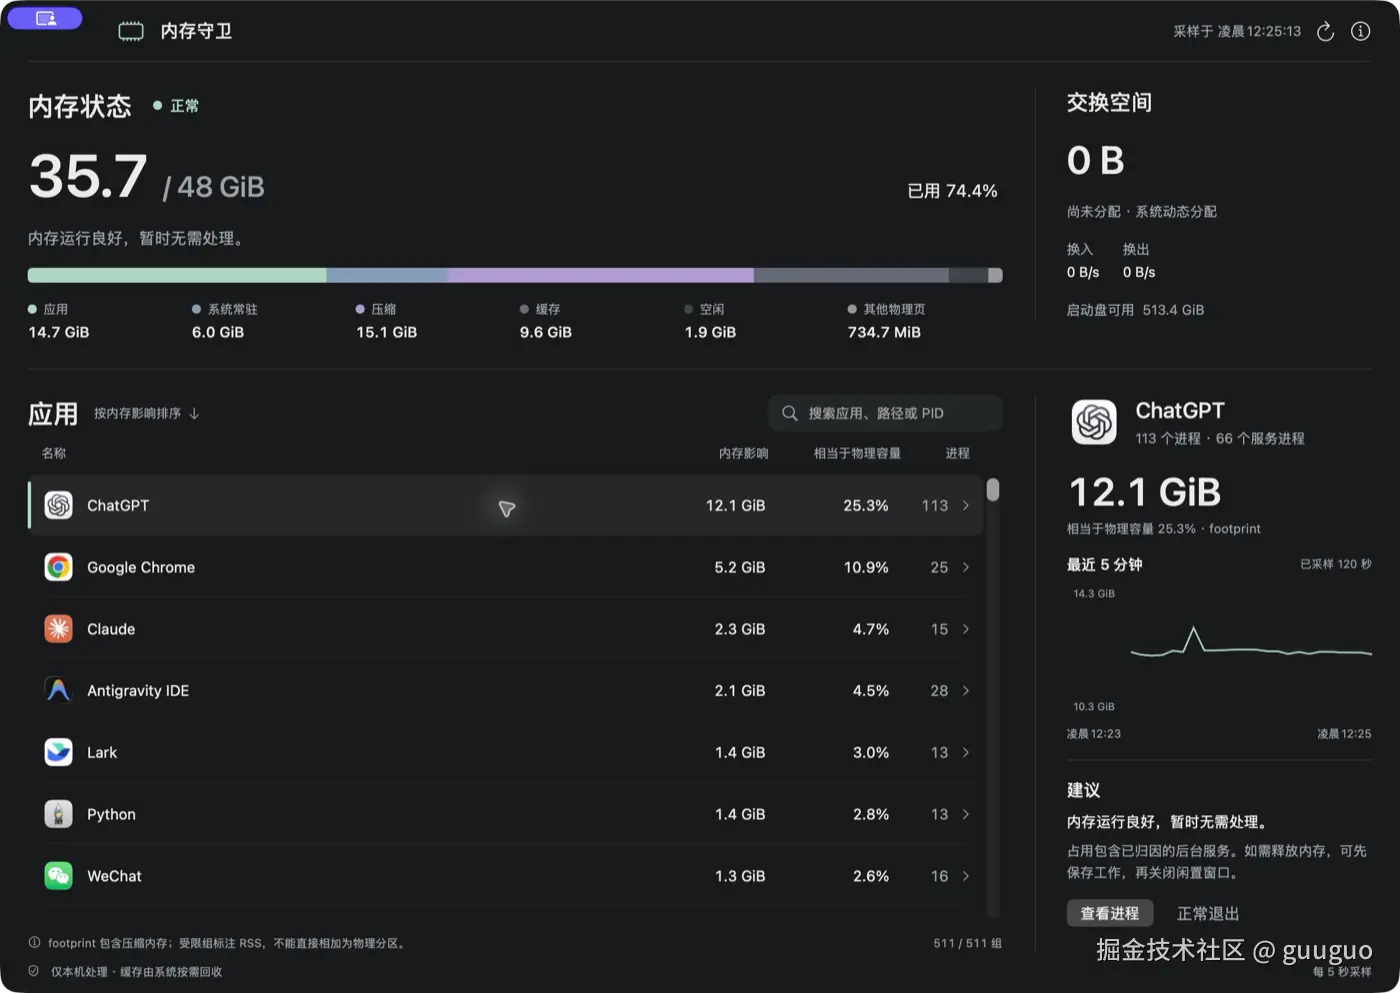
在一次实测快照里,ChatGPT / Codex 下面挂了 113 个进程、总占用 12.1 GiB,其中有 66 个是外部服务进程。
点开服务归因列表,排在最前面的三个大户直接被揪了出来:
wigolo(本地网页检索 MCP 服务):16 个进程,一共占了 6.1 GiB ,启动链是node ← codex,入口指向~/.npm/_npx/.../node_modules/wigolo/dist/index.jsshadcn:16 个进程,占了 1.1 GiB@agentmemory/mcp:16 个进程,占了 513.4 MiB
仔细看数量就能发现问题根源:我当时开了 8 个会话,每个会话都用 npm exec 拉起了一对壳进程加子进程,直接把这批 MCP 服务完整复制了 8 份常驻在后台。
抓包的时候还发现一个特别反直觉的坑。
那 16 个 wigolo 进程里,吃内存最狠的两个用普通 ps 看常驻内存(RSS)分别只有 73.9 MiB 和 71.1 MiB,看起来人畜无害。
但通过 macOS 内核 proc_pid_rusage 读取真实内存影响(ri_phys_footprint)之后,这两个进程的实际占用高达 2.9 GiB 和 2.0 GiB。
原因很简单,大部分匿名内存已经被系统压进内存压缩器里了,如果只按 RSS 排序,真正的内存大户直接隐身。
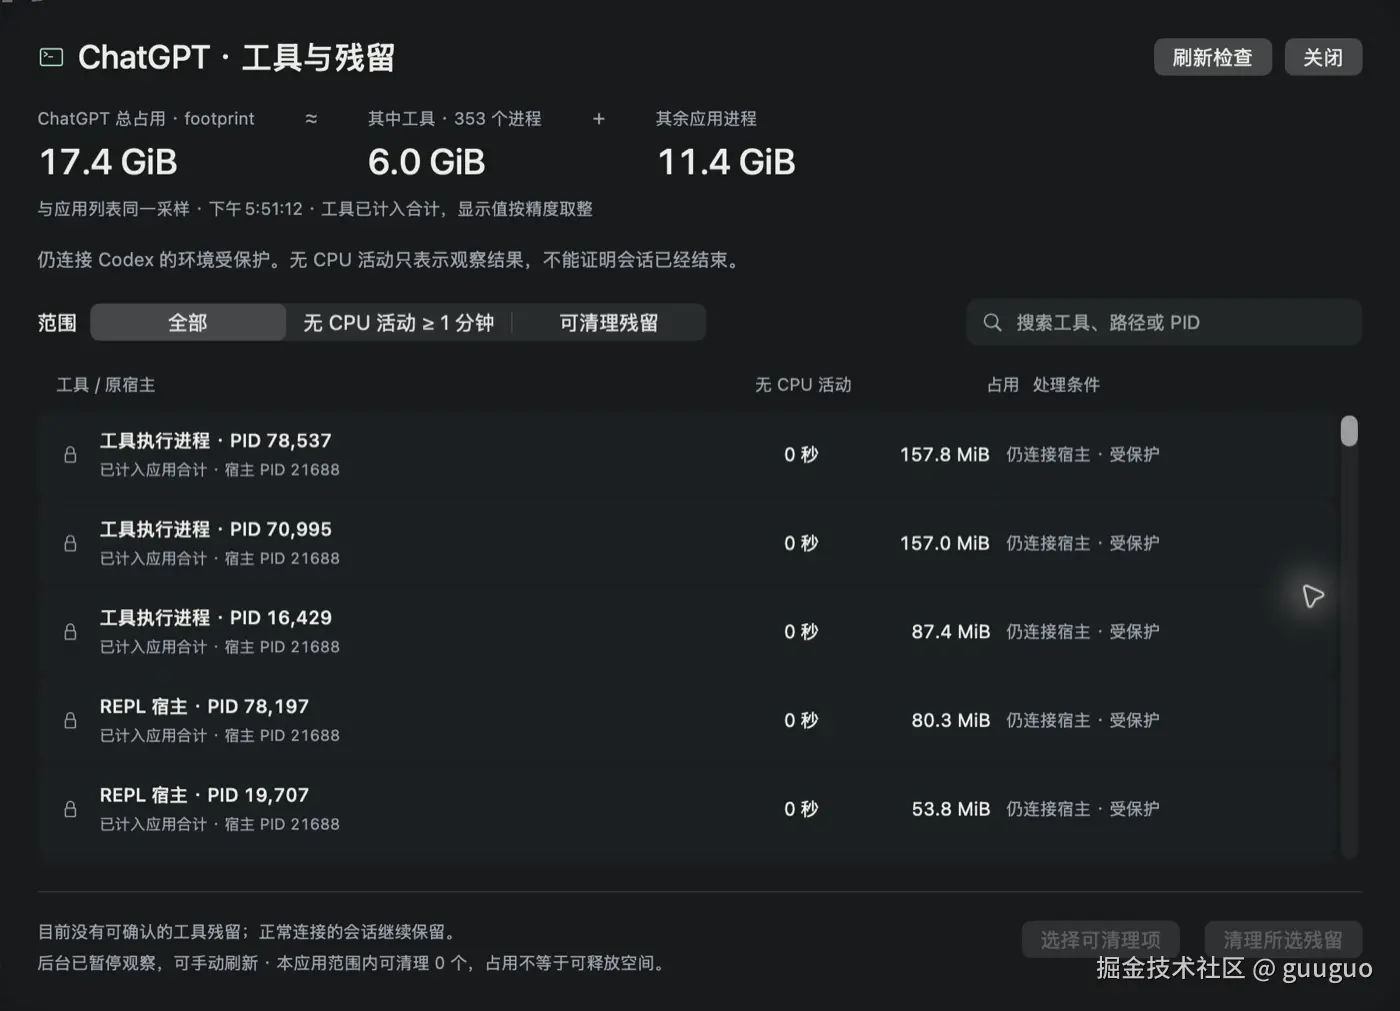
后来到另一个高峰时段,整棵 ChatGPT 进程树甚至涨到了 403 个进程、17.4 GiB,其中 353 个都是工具和执行进程,占了 6.0 GiB;拆开工具范围统计,单单 REPL 宿主 就有 213 个(约 2.41 GiB)、Codex 应用工具 70 个(约 2.05 GiB)、浏览器工具 71 个(约 1.10 GiB)。
把这本账算清楚之后,后面就知道该动谁、不该动谁了。
二、深度归因是怎么做的
为了把这些进程无侵入地揪出来,主要做了三件事。
1. 用 footprint 替代 RSS,绝不混合口径
在采样阶段直接通过 Darwin 的 proc_pid_rusage(pid, RUSAGE_INFO_V0, ...) 取每个进程的 ri_phys_footprint:
swift
var usage = rusage_info_v0()
let readable = withUnsafeMutablePointer(to: &usage) { pointer in
    pointer.withMemoryRebound(to: rusage_info_t?.self, capacity: 1) {
        proc_pid_rusage(pid, RUSAGE_INFO_V0, $0) == 0
    }
}
这里有一个很关键的口径边界:普通用户权限能完整读到当前用户进程的 footprint,但读其他系统用户进程会受权限限制。
如果一个应用分组里只要有一个进程读不到 footprint,整组就退回统一用 RSS 求和,并在界面单独标注,绝不把 footprint 和 RSS 硬加在一起糊弄用户。
2. 用 KERN_PROCARGS2 无侵入还原服务名,不碰环境变量
很多人图省事会直接调 ps -axo args 去正则匹配命令行,这样做既慢、遇到带空格路径会劈叉,还容易把进程里的敏感环境变量一起捞出来。
我直接读取 macOS 内核的 CTL_KERN / KERN_PROCARGS2 字节块,它的布局固定是 argc、可执行文件路径、零填充、连续的 argv 字符串、最后才是环境变量。
解析时只数够 argc 个参数就停下,环境变量一个字节都不碰,UI 和日志里也只保留识别出来的包名和入口文件路径:
swift
static func arguments(from data: Data) -> [String] {
    guard data.count >= MemoryLayout<Int32>.size else { return [] }
    let count = data.withUnsafeBytes { $0.loadUnaligned(as: Int32.self) }
    guard count > 0 else { return [] }
    let bytes = [UInt8](data)
    var index = MemoryLayout<Int32>.size
    // 内核布局:argc、可执行路径、零填充、argv、环境变量;读满 argc 即止,不碰环境变量。
    while index < bytes.count && bytes[index] != 0 { index += 1 }
    while index < bytes.count && bytes[index] == 0 { index += 1 }
    var values: [String] = []
    for _ in 0..<Int(count) {
        guard index < bytes.count else { break }
        let start = index
        while index < bytes.count && bytes[index] != 0 { index += 1 }
        values.append(String(decoding: bytes[start..<index], as: UTF8.self))
        index += 1
    }
    return values
}
拿到干净的参数数组后,再顺手处理几类 Node 常见变体:
npm exec会把argv[0]重写成npm exec @scope/pkg@version,直接提取包名,去掉版本号后缀- 遇到
/node_modules/.bin/软链接,用destinationOfSymbolicLink还原到真实包目录再归类 - 如果入口是相对路径(例如
scripts/server.mjs),再用proc_pidinfo(..., PROC_PIDVNODEPATHINFO, ...)拿到进程当前工作目录拼成完整路径
3. 单次快照父链追溯,每个 PID 只记一次
拿到所有进程和 Node 服务名后,在同一次快照里沿着 parentPid 往上追溯:
swift
while parentPID > 1, let parent = byPID[parentPID], visited.insert(parentPID).inserted {
    row.parentChain.append("\(parent.name) (PID \(parent.pid))")
    let key = appGroupName(for: parent)
    if key.hasSuffix(".app") { owners[row.pid] = key; break }
    parentPID = parent.parentPid
}
if owners[row.pid] == nil, let service = row.service { owners[row.pid] = service.identity }
只要父链上能追到 .app 宿主(比如 ChatGPT.app 或 Codex.app),就把这个服务进程折叠进宿主的内存总量里,同时记录启动链。
没有应用祖先的独立服务(比如你自己终端拉起来的本地服务),就按识别到的包名或项目目录拆开展示;如果连入口也确认不了,宁可老老实实标成 node · 来源未确认,绝不按 node 安装目录瞎猜归属。
算应用详情页时,严格从同一份快照拆分 应用总占用 ≈ 工具进程 + 其余应用进程,确保列表和详情数字能严丝合缝对上。
三、为什么不能"CPU 为 0 就直接杀"
一开始我也想偷懒,觉得哪个后台 MCP 或 Node 进程连续 60 秒 CPU 增量为 0,直接弹窗一键干掉不就完事了。
实际拿离线的 codex app-server --stdio 挂一个自建 MCP 测试进程做了一次对照实验,结果立刻被打脸。
当 MCP 宿主进程还在和主会话保持连接时,即使它平时 CPU 占用完全为 0,只要你从外部把它杀掉,下一次工具调用会直接返回错误:
tool call failed: Transport closed
必须重新执行 config/mcpServer/reload 才能恢复连接。
这说明了一件事:"CPU 不动"只能代表此刻没在算东西,不能证明连接没用了。
所以我在安全回收这块定了两条保守策略,不做自动后台强杀。
1. 孤立残留清理:5 道硬门禁
只有明确确认是"已经脱离原宿主的孤立残留",才允许用户勾选清理。必须同时满足:
- 本次监控运行期间已经亲眼观测到它的原宿主(
owner)是谁,启动前就存在的野进程不乱动 - 原宿主进程现在已经退出,并且该残留的
ppid已经被launchd(PID 1)接管 - 该进程自身没有正在运行的子进程
- 在连续不中断的采样下,累计 CPU 时间至少 60 秒没有任何增长
- 点下清理按钮的那一刻,再向内核重新核对一遍 UID、
startTimeTicks(防止 PID 复用误杀)、命令行路径和子进程状态,任何一项变了就跳过,而且只发SIGTERM,绝不升级SIGKILL
2. 闲置执行内核重置:放过宿主,只清 worker
对于还在连接中的 Codex 工具,后来通过拆进程树发现,真正吃内存且保存大量临时上下文的,往往是挂在 REPL 宿主 下面的配对执行进程(trusted-worker.js 和带 --working-dir 的 kernel.js)。
同样用离线 codex app-server 做了验证:只给这两个执行进程发 SIGTERM、保住上层 REPL 宿主和 MCP 传输通道,下一次在同一会话里继续调工具,底层会自动重新初始化内核并返回 isError: false,对话记录和连接全都不受影响。
当然,这步依然坚持先让用户看清工作目录和占用大小、确认没有在途长任务后再手动点重置,并在弹层里坦白提示:重置会清空临时 JS 变量和本地浏览器或文档句柄。
至于平时常驻本身的开销,软件也做了节能分级:窗口在前台可见时 5 秒采一次,切到后台、被遮挡或关掉主窗口后,自动停掉进程枚举和传感器扫描,只在菜单栏每 30 秒刷新一次系统摘要,机器休眠直接暂停。现在它在我本机连续挂了三天多,内存稳在 60 MiB 左右,平时 CPU 几乎是 0%。
四、开源获取与当前边界
项目全部用原生技术实现(macOS 端使用 macOS 14+ / Swift 6,另附 C# / WPF 写的 Windows 原生预览版),完整的构建测试与打包说明都放在了 MemoryGuardian GitHub 仓库 里。
目前 Windows 预览版实现了类似的内存概览和 WMI Node 服务归因,但还没在 Windows 实机走完完整验收,传感和重置面板也暂时只在 macOS 版里有。
另外老实交代几个目前的限制:
- 打包脚本默认用本地 ad-hoc 签名,没有花钱买 Apple Developer 公证,自己编译跑或者分发给朋友时首次打开需要去系统设置里放行。
- 服务归因目前主要针对 Node / npm / npx 和 Codex 工具链做了深挖,Bun、Deno 和 Python 还没泛化进去。
- 只读 SMC 温度和双风扇上限读取按苹果 M1 到 M5 及部分 Intel 做了键位映射,遇到未收录芯片可能会显示读取失败。
最后
这个小工具最初只是为了解决我自己 48G Mac 莫名变慢的问题,现在已经每天常驻在我的菜单栏里了。
平时我自己重度用 AI 写代码,踩到顺手能治的痛点就会做个小工具出来,陆续写过几个都放在了个人主页 hub.guuguo.top 上。
如果你平时也同时开着 Codex、Claude Code 或一堆 MCP 工具,主页里还有我做的另外几个相关小工具可以顺带看看,比如手机远程盯着电脑多 Agent 跑代码的 Agent Control、不破坏原版签名的 Antigravity 多语言启动器,以及精简版的菜单栏整理工具 MenuBarTidy。
所有源码和后续折腾记录都在:
- 本项目仓库:MemoryGuardian
- 个人工具矩阵主页:hub.guuguo.top
- GitHub 主页:@guuguo
- 掘金主页:guuguo 的技术文章
自己每天都在用,顺手把旧包袱清掉开源出来,希望能帮到同样被黑盒 node 进程困扰的同学~