原文:mp.weixin.qq.com/s/mBj5qXdm3...(2025年12月12日)
过去一年,我们每个人都在为AI的聪明程度惊叹。但热潮过后,一个更现实的问题摆在了所有公司面前:AI虽强,但它不懂我的业务。
它就像一个刚毕业的天才实习生,博古通今,知识渊博,但对你公司的产品文档、销售黑话、内部流程一无所知。你让他写一封营销邮件,他旁征博引,就是说不到点子上。你问他上个季度的销售数据分析,他只能抱歉地说:"我的知识截止到2023年。"
我们正处在一个尴尬的岔路口:一边是通用AI的强大能力,另一边是企业个性化知识的巨大鸿沟。 怎么把我们海量的内部文档、SOP、聊天记录,变成AI能理解、会使用的"独家记忆"?这,才是AI下半场竞争的关键。
今天,我们就用"老司机"的视角,把这个过程用大白话给你讲透。这背后没有魔法,只有一个极其精巧的逻辑,我称之为:为你的AI,打造一个超级智能的"专属图书馆"。
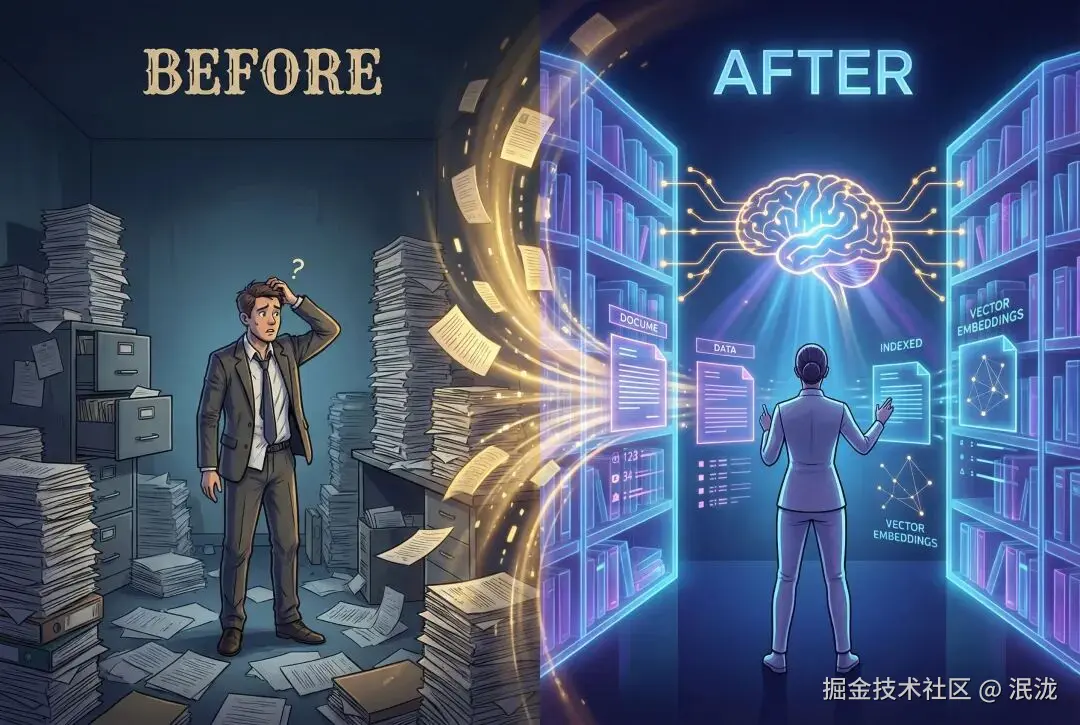
AI图书馆概念总览图
核心概念拆解:三步建成"AI图书馆"
忘掉那些复杂的代码和技术术语,我们想象一下你是个图书管理员,任务是整理公司成吨的资料,好让一位超级聪明的"外聘专家"(也就是LLM)能随时查阅并给出建议。
你会怎么做?
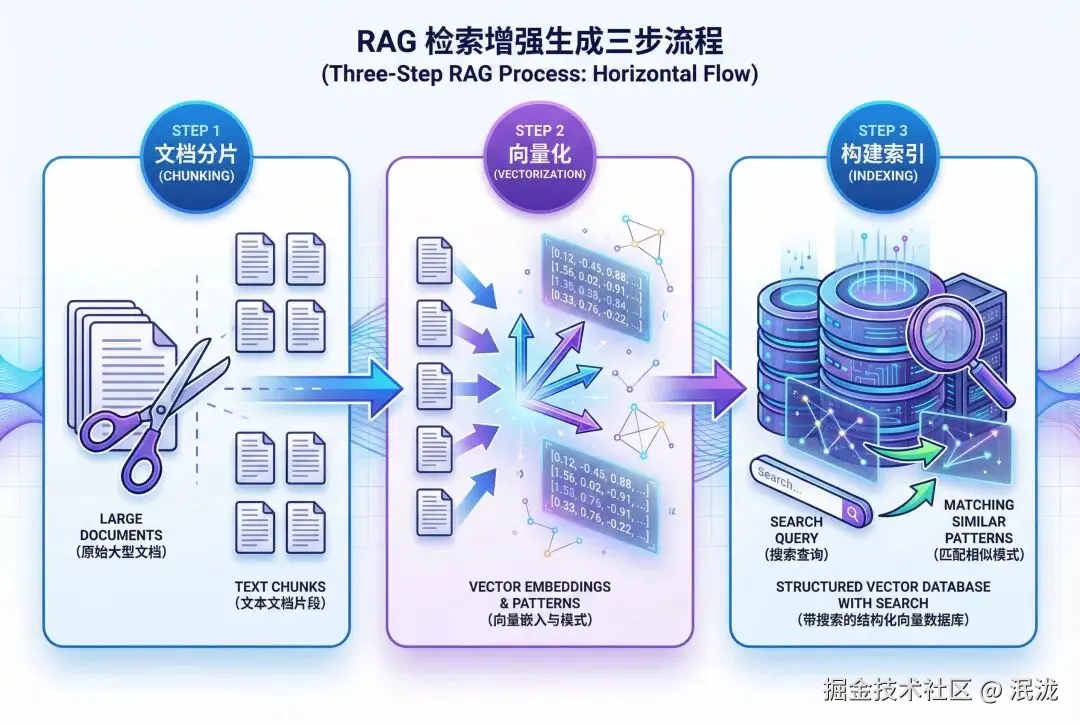
RAG三步流程可视化
第一步:整理书页(文档分片 Chunking)
你面前堆着山一样的文件:几百页的PDF、超长的Word文档、各种博客文章。你总不能把一本500页的书直接丢给专家,告诉他"你自己看吧"。他一次性也消化不了这么多信息(AI的"上下文窗口"是有限的)。
最聪明的做法是,把厚书拆成一页一页的关键内容。
在AI的世界里,这就叫"文档分片"(Chunking)。我们把一篇长长的文档,切成一个个逻辑连贯、大小适中的段落。为了不让语义在切分处断裂,我们还耍了个小聪明:每个新片段的开头,会包含上一个片段结尾的一小部分内容(Overlap),就像翻书时,眼睛会自然地关联上下文一样。
逻辑流程:
[一篇万字长文] -> 智能切割 -> [片段1, 片段2, 片段3, ..., 片段N]
这一步的目标很简单:把"大而全"的原材料变成"小而精"的知识单元,让AI能一口一口地"吃"。
第二步:撰写"思想钢印"(向量化 Vectorization)
现在我们有了一堆"知识页面",但怎么让专家快速找到他想要的?靠"关键词"吗?太Low了。如果用户问"公司食堂哪家强?",关键词搜索"食堂"可能会错过一篇写着"内部饭堂体验极佳"的帖子。
我们需要更高级的玩法。想象你有一种"魔法墨水",能把每一页纸的核心思想、所有隐含的情感和逻辑,都"翻译"成一个独一无二的"味道",或者说,一个**"思想钢印"**。
在AI的世界,这个过程叫"向量化"(Vectorization)。我们使用一个叫"Embedding模型"的工具(比如OpenAI的text-embedding-ada-002),它会阅读每个文本片段,然后输出一长串数字(比如一个1536维的向量)。
这串数字,就是那页纸的"思想钢印"。它不是简单的编码,而是对文本语义的数学表达。 思想上越接近的两段话,它们的"思想钢印"(向量)在数学空间里的距离就越近。
比如,"今天天气真不错"和"阳光明媚,惠风和畅"的"思想钢印",味道就会非常相似。
第三步:打造"智能目录"(构建索引 Indexing)
我们有了成千上万个带着"思想钢印"的知识页面。最后一步,就是把它们存放到一个地方,以便快速查找。
这个存放地,不是普通的书架,而是一个超级智能的"卡片目录" 。它不按标题、不按页码,而是按"思想钢印"的味道来组织。
这个"智能目录"在技术上被称为"向量数据库"(Vector Database),比如Chroma、Pinecone等。
当你把所有页面的"思想钢印"都存进去后,这个图书馆就建成了。
当用户提出一个问题(比如"介绍一下我们的新产品'追光者'有哪些优势?"),整个系统会这样运作:
- 先把问题也用"魔法墨水"生成一个"思想钢印"。
- 拿着这个问题的"思想钢印",去"智能目录"里寻找味道最相近的那几个知识页面。
- 把这几个最相关的页面(也就是原始文本片段)交给"外聘专家"(LLM)。
- 最后对专家说:"请根据这几份材料,回答用户关于'追光者'产品优势的问题。"
看到没?专家不再是凭空想象,而是基于你提供的、最相关的内部资料来回答。回答的准确性和可靠性,瞬间拉满。
价值升维:这不止是技术,这是企业的新"蒸汽机"
如果说过去的关键词搜索是"刀耕火种",那这套"建图书馆"的方法论,就是知识管理领域的"蒸汽机"。
它的商业价值,远超你想象:
- 极致的降本增效 :想象一下,新员工入职,直接跟AI对话就能完成90%的培训;客服面对复杂问题,AI能秒级检索所有历史案例给出最佳答案;法务在几秒内就能审阅完上百份合同的风险点。所有依赖"找信息、学知识"的工作,都将被彻底重塑。
- 激活沉睡的数据资产:公司里那些陈年的报告、无人问津的Wiki、散落在各处的会议纪要,瞬间从"数字垃圾"变成了"可对话的黄金"。它们不再是静静躺在硬盘里的文件,而是企业鲜活的、可随时调用的"集体记忆"。
- 革命性的决策支持 :老板不再需要等下属整理几天的报告。他可以直接问:"对比过去三个季度,我们A产品的用户流失原因主要有哪些变化?" AI会整合所有相关数据,给出提炼后的洞察。决策,将变得前所未有的敏捷和数据驱动。
这套方法,正在让AI从一个"花哨的玩具",真正变成深入业务骨髓的"生产力工具"。它构建的不是一个简单的问答机器人,而是一个懂你业务、为你思考、永不疲倦的"企业大脑"。
总结与展望
我们今天聊的,本质上是一种思维方式的转变:从"人找信息"到"信息找人"的终极进化。
通过"分片、向量化、索引"这简单的三步,我们就为AI装上了一双能看透我们私有知识的"眼睛",和一个能精准调取记忆的"大脑"。这让AI真正成为了我们自己的AI。
所以,别再纠结于如何选择模型了。真正的战场已经转移。
未来,一家公司的核心竞争力,可能不只在于它拥有多少数据,更在于它能以多快的速度、多深的精度,将这些数据转化为可执行的洞察。而这一切,就从为你的知识库,装上一个"AI大脑"开始。
你的公司,开始建自己的"AI图书馆"了吗?欢迎在评论区分享你的看法。