开场:模型会背诗,但它不知道娃的课本
陪娃复习古诗,最常见的问法是
你:我们二年级那首放风筝的诗,怎么背? AI:放风筝的诗啊,《风筝》清孔尚任 结伴儿童裤褶红,手提线索骂天公。人人夸你春来早,欠我风筝五丈风。
可是二年级风筝的诗是《村居》,模型其实"背得出"《村居》,问题不在会不会背,在于它不知道你家娃这册课本里有什么。训练数据里没有"你家娃二年级下第 1 课学的哪首诗"这种信息,于是它只好拿训练记忆里"和风筝沾点边"的东西来凑,答案不准确。
更麻烦的是反面:你问一首课本外的诗,它多半也会热情地背一段,错没错你都得自己去核对。
这一篇就干一件事:给"字问先生"配一本古诗书。娃问到古诗,它先翻自己的书,翻到了照书上的讲、顺带说出处(哪首、谁写的、哪一课学的);翻不到就老实说"我的古诗书里还没有这首"。
这就是 RAG------Retrieval(先检索)+ Augmented(把检索结果拼进 prompt)+ Generation(再生成)。三个字母各管一段,串起来解决"模型不知道私有数据"的问题。
本文源码:github.com/tongli99/zi... ,对应 tag
v0.2------clone 后git checkout v0.2,或直接浏览 v0.2 快照。
一、先看全貌:RAG 有两条路,一条写、一条读
RAG拆开有两条独立的路:
css
1.写路径:
本篇例子:系统启动时,写入。
古诗库 data/poems.json
   │ PoemIngestor:每首诗 → embedding 模型 → 向量
   ▼
向量库 InMemoryEmbeddingStore(JVM 内存)
   (条目文本 + 结构化出处 metadata + 向量,一一对应)

2.读路径:
每次对话都跑
娃问问题 → embedding 模型 → 问题向量
   │ 和库里每个条目向量算相似度,取最相近的几首
   ▼
RetrievalAugmentor:把查到的诗拼进这条用户消息
   │ [system 人设] + [Redis 里的历史] + [问题 + 查到的诗]
   ▼
大模型生成回答(全诗 + 出处,不瞎编)
注意两条路需共用同一个 embedding 模型------这是铁律:向量只有同一个模型算出来才落在同一个空间里,夹角才有可比性;若两条路各用一个模型,等于拿两把刻度不同的尺子量远近。
下面按"RAG 原理(分块、检索、注入、防幻觉)→ LangChain4j 组件 → 关键代码 → 一次问答全程"的顺序学习。
二、RAG 原理(上):分块与检索
先看语料怎么切块存进去(写路径的原理),再看检索为什么能把对的块搜出来(读路径第一步)。
2.1 分块:粒度跟着"要回显的单位"走
RAG 的语料不能整坨入库,得先切块(chunking),块的大小直接影响检索命中。切法没有标准答案,只有一条原则:粒度跟着"你要回显的单位"走。
古诗的单位自然是"一首":一首绝句二十八个字,整首才有完整语义,拆成单句会"命中了一句、丢了题目和出处";我们要回显的恰恰是"哪首诗"这个整体信息,块和诗一一对应,命中一块就是命中整首。反过来,语料换成"一整篇课文"就必须拆块------不拆则检索粒度太粗、上下文塞不下。
没有天然边界的语料(长文档、网页)怎么办?生产上的通用套路是**"结构优先、大小兜底":先按文档的天然结构切------Markdown 按标题层级、代码按函数;结构块还超大就递归降级(段落 → 句子 → 字符),钳住最大长度,并留一段重叠(overlap)给下一块,防止答案正好骑在切口上。经验起点是 每块 256~512 token、重叠 10%**,之后配一组"问题 → 应命中文档"的验证用例,拿命中数调参,不拍脑袋。LangChain4j 里对应的是 DocumentSplitters.recursive(...),挂 EmbeddingStoreIngestor 流水线用。至于语义切分、给每块补上下文再嵌入、父子块这些进阶玩法------等语料大了、检索开始不准了再上。
2.2 关键词检索为什么失败
拿例子看:娃问"那首放风筝的",要找的是《村居》,原文是"儿童散学归来早,忙趁东风放纸鸢"。"风筝"两个字,题目、原文、课序里都没有,所以整库搜不到。
2.3 向量:把语义变成可以算的距离
embedding 模型做的事:把任意一段文本映射成一个高维向量。它见过海量语料,学会了"语义相近的文本,向量也相近"------"放风筝那首"和"忙趁东风放纸鸢"一个字都不共享,但都常出现在"风筝、纸鸢、春天、儿童"的语境里,所以它们的向量夹角小。
相似度用余弦相似度衡量(两个向量夹角的 cos 值,越大越近)。LangChain4j 对外报的 score 是归一化到 0~1 的相关度。检索 = 把问题向量和库里每个条目向量都算一遍,按分数取前 K 个。
所以 RAG 检索是:不问"字面像不像",只问"意思近不近"。
2.4 项目中裸检索接口
项目中,GET /api/poems/search 是专门写的观察窗口------只走向量检索、不调 chat 模型,把命中的诗和匹配分数原样吐出来:
sql
GET /api/poems/search?question=那首放风筝的

data: [
  { "title": "村居", "author": "高鼎", "dynasty": "清",
    "lesson": "二年级下·第1课", "score": 0.6x, ... },
  { "title": "咏柳", ..., "score": 0.4x },
  ...
](分数以你跑出来的为准。)《村居》稳居第一,第二名的差距肉眼可见------这就是"向量相近"的具象化。排查 RAG 问题的第一站永远是这里:没答对,先看检索回了什么,再决定去改检索还是去改 prompt。
三、RAG 原理(下):注入与防幻觉
资料搜出来了,原理还剩两件事:查到的东西怎么交给模型(注入),模型怎么管住不瞎编(防幻觉)。
3.1 注入:查到的资料拼进"这条"用户消息
检索命中的 top-K 资料怎么交给模型?答案是拼进当条用户消息------人设和历史照旧在外面:
那首放风筝的诗,背给我听听?

下面是从古诗书里查到的资料,回答古诗问题以查到的诗为准:
《村居》(清·高鼎,二年级下·第1课)
草长莺飞二月天,拂堤杨柳醉春烟。儿童散学归来早,忙趁东风放纸鸢。
《咏柳》(唐·贺知章,二年级下·第1课)
碧玉妆成一树高......
这就是 RAG 里 A(Augmented)的本义:不改模型、不改人设,只给"当前这条问题"增补它需要的资料。资料贴着问题走,模型一眼对上"问的是哪段、该用哪段答"。
3.2 防幻觉:RAG 只保证"看得见",不保证"只按它说"
RAG 只保证"模型看得见查到的诗",不保证"它只按查到的诗说话"。防幻觉采用:prompt 立规矩,产品给证据。
prompt 立规矩------人设文件(system-prompt.txt)里新增的一段:
diff
怎么聊古诗:
- 消息里带着"从古诗书里查到的资料"时,回答古诗问题以查到的诗为准,讲完自然带上出处:诗题、作者、哪一课学的
- 古诗书里没有的诗,老实说"我的古诗书里还没有这首哦",不凭自己的记忆背,更不编
- 查到的资料和孩子的问题无关时,就当没看见,正常陪聊前两行就是规矩:以查到的诗为准 ------带着检索资料时以查到的为准,讲完自然带出处(诗题、作者、哪一课学的);没有就说没有------库里没有的,老实说"我的古诗书里还没有这首哦",不凭自己的记忆背、更不编。第三行"无关当没看见"先不过多讲述,以后版本继续学习。
产品给证据:出处回显 。聊天里讲完自然带上"出处"来收尾。让回答可核对。
这套做法留下两个已知缺口:
- 约束是软的:规矩写在 prompt 里,模型绝大多数时候听话,但没有硬保证。"拒答"要做成硬路径(检索不到就不放行)才算数;
- 检索没有判断力:每条消息都查一次库,娃打个招呼"你好"也照样检索 3 首诗拼进去,全靠第三行"当没看见"兜底------多数时候无害,但白花一次检索。
"拒答硬路径 "和"该查才查",这两个判断力,留给下一版本 v0.3 继续学习。
四、LangChain4j 怎么实现 RAG
原理清楚了,看 LangChain4j 怎么落地。框架把 RAG 拆成几个组件,和原理一一对应:
| RAG 环节 | LangChain4j 组件 | 本项目落地 |
|---|---|---|
| 检索条目 | TextSegment |
一首诗一块,出处用 metadata带出 |
| 向量化 | EmbeddingModel |
OpenAiEmbeddingModel(通义端点) |
| 向量存储 | EmbeddingStore |
InMemoryEmbeddingStore(JVM 内存) |
| 检索 | ContentRetriever |
EmbeddingStoreContentRetriever(top-K) |
| 注入 | RetrievalAugmentor + ContentInjector |
DefaultRetrievalAugmentor + 中文模板 |
组件之间只认接口不认实现,所以每一格都能单独换:换 embedding 提供方,动 EmbeddingModel 一个 bean;向量库搬家,动 EmbeddingStore 一个 bean。
4.1 RAG 组件的两种用法:让框架自动做,或自己写
第一种,把 RetrievalAugmentor 挂到 AiServices 上。挂上之后,每收到一条用户消息,框架自动完成"向量化 → 检索 → 把资料拼进消息",再交给 chat 模型。Companion 接口和 ChatController 一行都不用改------检索是框架在代理那一层(companion.chat(...))自动插进去的,接口和控制器只负责把问题丢给 companion,看不见、也不用管 RAG 发生在哪一步。聊天主链路用的就是这种。
第二种,自己在代码里调 embeddingModel.embed() 和 embeddingStore.search(),结果想怎么用就怎么用。/api/poems/search 用的就是这种:命中了哪几首、分数多少,直接返回给前端,不调 chat 模型。
| 用法 | 适合 | 本项目落点 |
|---|---|---|
| 挂到 AiServices,框架自动做 | 正常聊天,每问都要带资料 | 聊天主链路 |
| 自己调 embed、search | 调试观察、结果直接给前端、不需要生成 | /api/poems/search |
4.2 向量库怎么选:内存库什么时候够
本篇选 InMemoryEmbeddingStore,看着像玩具,其实是量力而行的选择。什么时候需要独立向量库(Qdrant、Milvus、pgvector......),看四个信号:
| 信号 | 内存库的表现 | 独立向量库 |
|---|---|---|
| 语料上万条 | 检索是精确扫描:每个候选向量都算一遍相似度,没有索引,量大会慢 | HNSW 近似最近邻索引,量大数据也能毫秒级 |
| 重启不想重嵌 | 进程一死向量全没,重启全量重新嵌入(重花 embedding 的钱) | 向量落盘,重启即加载 |
| 多实例部署 | 库在各自 JVM 里,各查各的、互不可见 | 独立进程,多实例共享一份库 |
| 按条件过滤检索 | 不支持 | metadata 过滤("只查二年级上"这类) |
对号入座:本篇 8 首诗、单机跑、不需要过滤,四个信号一个都不占,内存库就够了,也不用多装一个软件。哪天信号凑齐要搬家,替换点就是 EmbeddingStore 这一个接口,下一小篇就干这个:把向量库搬进 Qdrant,检索和对话代码一行不动。
五、关键代码
把项目的关键代码按数据流串起来:poems.json → 条目 → 向量 → 库 → 检索 → 注入 → 回答。
5.1 语料与条目
语料是 data/poems.json,人工录入。每首诗造成一个 TextSegment,text 和 metadata 各放各的:
java
// PoemService:造检索条目
TextSegment.from(
        "《村居》(清·高鼎,二年级下·第1课)\n草长莺飞二月天......",  // text
        Metadata.from(Map.of("title", ..., "author", ..., "dynasty", ...,
                             "lesson", ..., "content", ...)))          // metadata
text 里除了诗的原文,还拼了题目、作者、朝代、课序。为什么?"二年级"三个字只在课序里、不在诗的原文里,而向量化只算 text,不写进 text 的词永远搜不到 ------出处不拼进去,"二年级那首"这种问法就匹配不到。metadata 那份不参与向量化,是给程序用的,/api/poems/search 回显的出处就是它。
5.2 装配(RagConfig):模型、库、检索器、增强器四个 bean
embedding 模型用通义千问(text-embedding-v3)。为什么要换一家?DeepSeek 只有 chat 接口,没有 embedding 接口------换一家,key 也得一家一组环境变量(chat 三个、embedding 三个),互不干扰。
java
// RagConfig:和 chat 模型并排的第二组模型装配
OpenAiEmbeddingModel.builder()
        .baseUrl("https://dashscope.aliyuncs.com/compatible-mode/v1")  // DashScope 兼容端点
        .apiKey(...)                                                   // AI_EMBEDDING_API_KEY
        .modelName("text-embedding-v3")                                // 向量模型名称
        .build();
向量库一行 new InMemoryEmbeddingStore<>()------它只存向量,什么都不会算。检索器是读路径的执行者,要干两件事:先把问题向量化(用 embedding 模型),再拿向量去库里搜(用向量库),所以它得同时挂上库和模型;maxResults(3) 限定 top-K,只取最相近的 3 首:
java
EmbeddingStoreContentRetriever.builder()
        .embeddingStore(embeddingStore)    // 去哪个库捞
        .embeddingModel(embeddingModel)    // 用哪个模型把问题向量化
        .maxResults(3)                     // top-K
.build();增强器把检索器包起来,并指定注入模板。默认模板是英文,这里换成中文;{{userMessage}}(娃的原话)和 {{contents}}(检索到的诗)两个占位符都要保留:
java
DefaultRetrievalAugmentor.builder()
        .contentRetriever(contentRetriever)
        .contentInjector(DefaultContentInjector.builder()
                .promptTemplate(PromptTemplate.from("""
                        {{userMessage}}

                        下面是从古诗书里查到的资料,回答古诗问题以查到的诗为准:
                        {{contents}}"""))
                .build())
        .build();
5.3 写路径:开机入库
启动时 PoemIngestor(ApplicationRunner)把 5.1 造好的条目全量入库:
java
List<TextSegment> segments = poemService.toSegments();       // 8 首诗,一首一个条目
List<Embedding> embeddings = embeddingModel.embedAll(segments).content();  // 一次批量调向量模型
embeddingStore.addAll(embeddings, segments);                 // 向量 + 条目成对入库
log.info("古诗存入内存向量库完成:{} 首(重启自动重建)", segments.size());
三行就是写路径的全部:条目 → 向量 → 入库。
顺带一提:LangChain4j 还有更粗粒度的 EmbeddingStoreIngestor(管"文档→分块→向量化→入库"整条流水线),但它吃的是 Document。我们的语料是一首首现成的整诗,三行手动入库,先从简单入门。
5.4 读路径:聊天挂一行,裸检索三行
聊天主链路就是 4.1 的第一种用法:项目v0.1版本 装配 Companion 时挂过 chatModel、chatMemoryProvider,现在v0.2版只是在 builder 上多挂一行:
java
AiServices.builder(Companion.class)
        .chatModel(chatModel)
        .streamingChatModel(streamingChatModel)
        .chatMemoryProvider(chatMemoryProvider)
        .systemMessageProvider(memoryId -> systemPrompt)
        .retrievalAugmentor(retrievalAugmentor)   // ← v0.2 新增,就这一行
        .build();
挂上之后,每条用户消息都自动先走"向量化 → 检索 → 注入",拼出来就是 3.1 那段的样子。Companion 接口一行没改,同步和流式都自动带上了 RAG。
/api/poems/search(2.4 的观察窗口)是第二种用法,自己调 embed 和 search,不经过 chat 模型。背后是 PoemService.search() 的三行:
java
Embedding queryEmbedding = embeddingModel.embed(question).content();   // 问题向量化
EmbeddingSearchResult<TextSegment> result = embeddingStore.search(EmbeddingSearchRequest.builder()    // 去库里捞 top3
        .queryEmbedding(queryEmbedding)
        .maxResults(3)
        .build());
六、一次 RAG 问答全过程
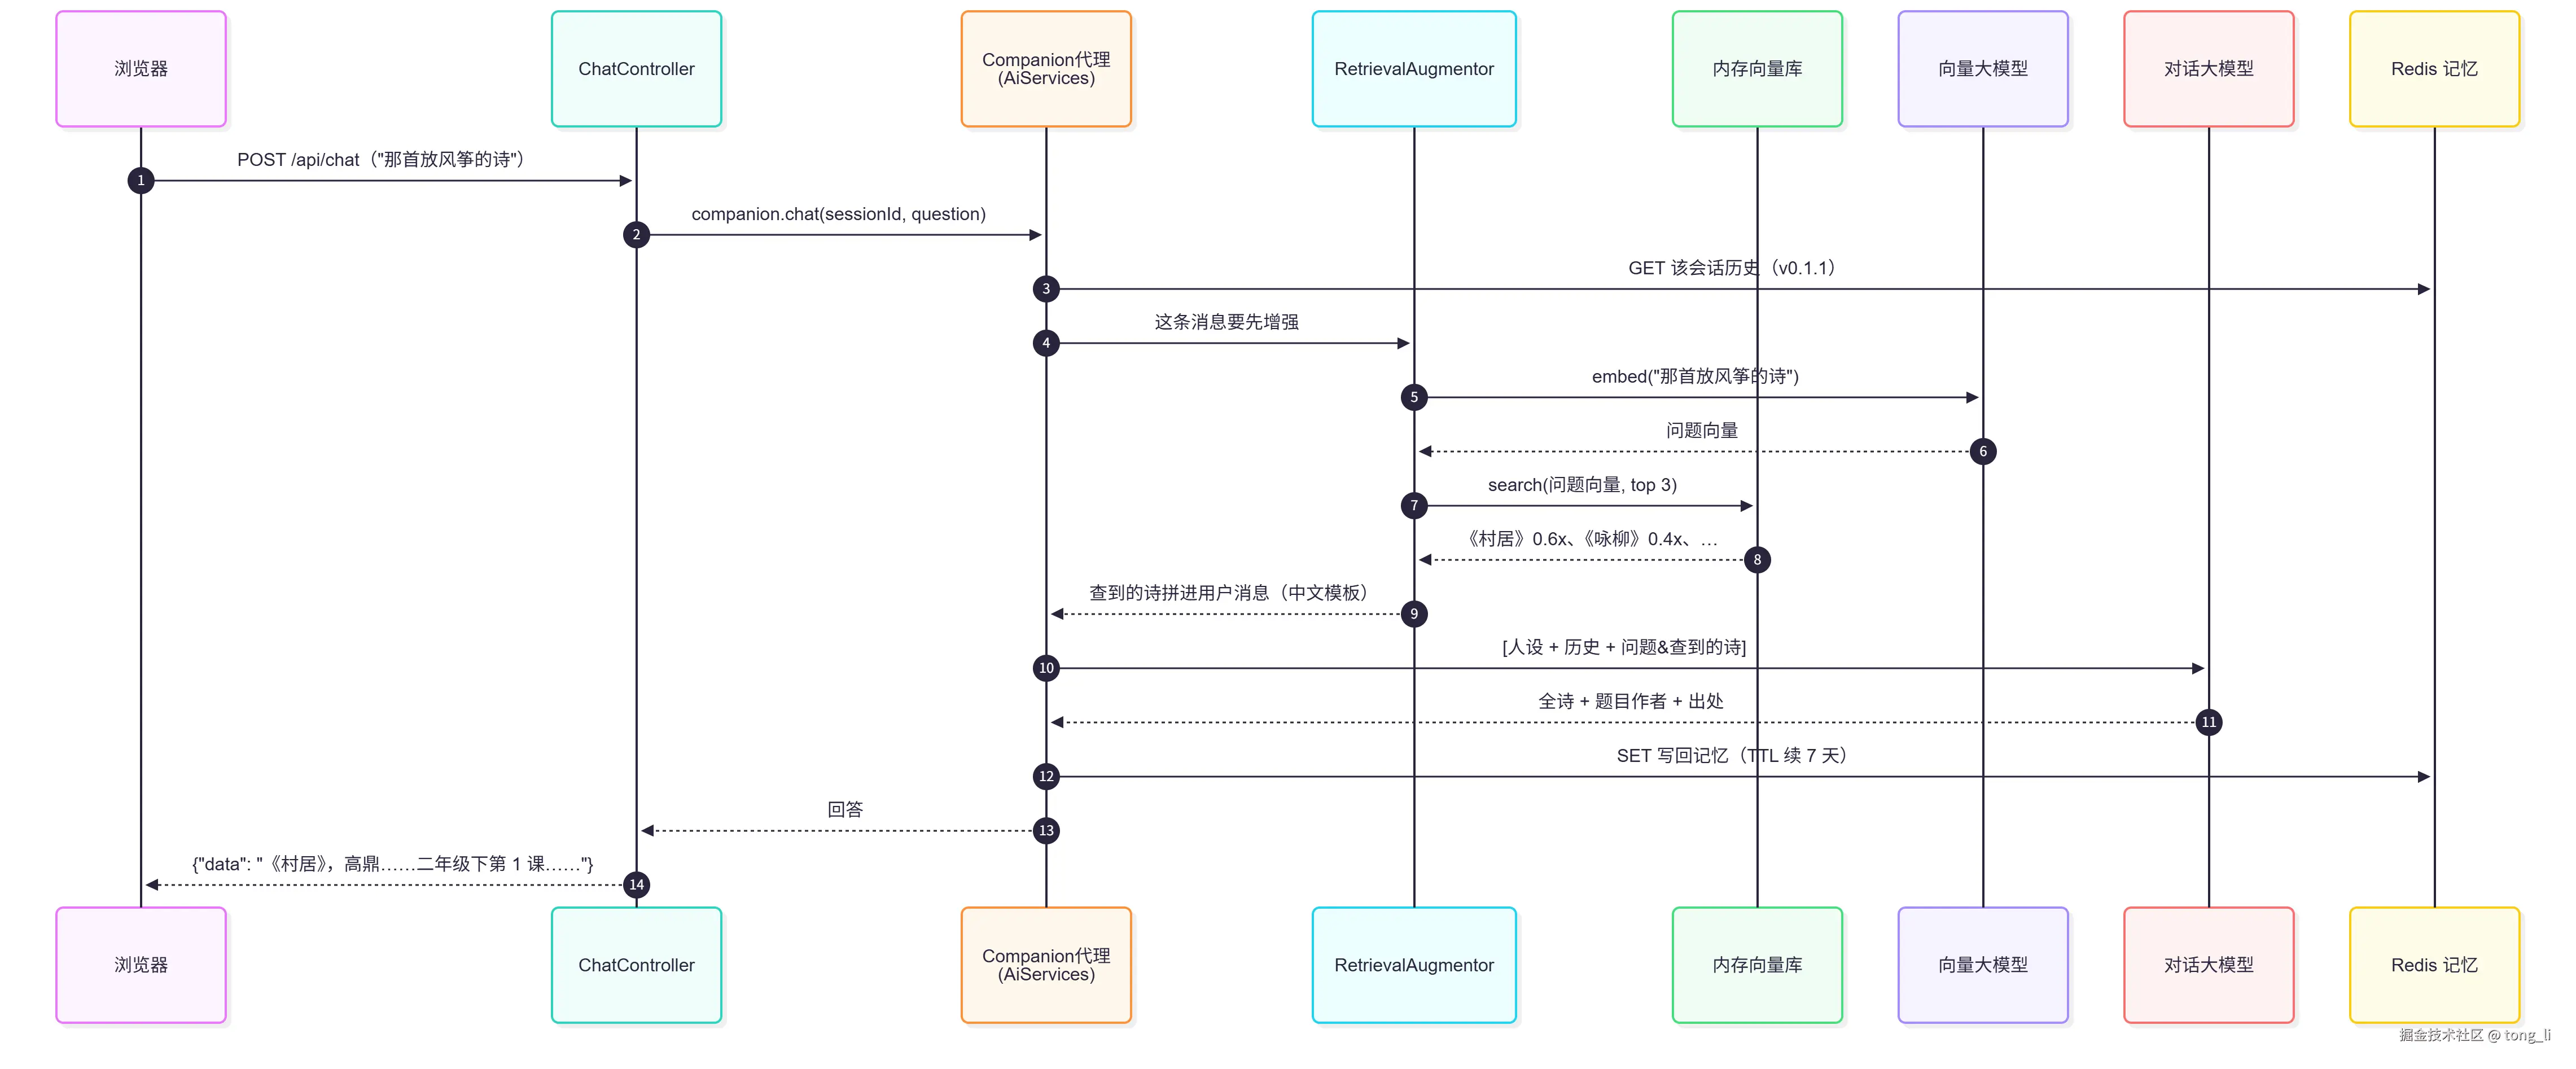
对照 v0.1 的序列图看,新增的只有第 4~9 步(先检索再生成);记忆(第 3、12 步)和人设(第 10 步拼进 system)原样运转------RAG 是往原来的链路里插了一节,不是重造一条。
七、怎么跑 + 怎么验证
bash
# 1. 两把 key:chat 一家、embedding 一家(都是 OpenAI 兼容协议)
export AI_CHAT_BASE_URL=https://api.deepseek.com/v1
export AI_CHAT_API_KEY=sk-xxx
export AI_CHAT_MODEL=deepseek-v4-pro
export AI_EMBEDDING_BASE_URL=https://dashscope.aliyuncs.com/compatible-mode/v1
export AI_EMBEDDING_API_KEY=sk-xxx
export AI_EMBEDDING_MODEL=text-embedding-v3

# 2. 起 Redis(记忆照旧;v0.2 无新增外部依赖,向量库在 JVM 内存)
docker compose up -d

# 3. 启动:看到"古诗存入内存向量库完成:8 首"即写路径 OK
mvn spring-boot:run验证五步(http/poems.http 里备好了请求模板,question 换成自己的问题即可,逐条 Send Request):
GET /api/poems:看语料,8 首诗、五个字段;GET /api/poems/search?question=那首放风筝的:《村居》应排第一,看清分数长什么样;POST /api/chat问"那首放风筝的诗,背给我听听":全诗 + 出处;POST /api/chat问"帮我背一下《将进酒》":应老实说没有;- 问一句无关的"我今天有点累":正常陪聊,没硬扯古诗。
想改语料:直接编辑 data/poems.json(对着自家娃的课本录),重启即生效。