前言
不知道你有没有遇到过这种情况:花了大半天把一份 PDF 喂给 RAG 系统,结果检索出来的片段全是断句的表格、错位的标题,大模型拿着这些碎片化的内容,一本正经地给你编答案。
你以为是 Embedding 模型不行,换了;
以为是切片大小不对,调了;
以为是向量库检索策略有问题,也改了。
折腾一圈下来,效果还是那个鬼样子。
问题不在检索层,在更前面。
你喂进去的"原料",从 PDF 变成文本的那一刻,结构就已经丢了。
而 Docling,就是专门来解决这件事的。
IBM 研究院出品,2025 年 3 月捐给 Linux 基金会,2026 年 8 月成为 LF AI & Data 基金会的 Graduated 项目。
GitHub 星标超过 7 万,社区贡献者里超过 68% 的 PR 来自核心团队之外。
今天这篇文章就专门跟大家一起聊聊Docling,希望对你会有所帮助。
更多项目实战在Java突击队网:susan.net.cn/project
一、Docling 在解决什么问题?
有些小伙伴可能会说:"PDF 解析工具不是很多吗?PyMuPDF、pdfplumber 不都能用?"
能。
但它们解决的是"把字抠出来"的问题。
Docling 解决的是"把结构留下来"的问题。
PDF 本质上是一堆"画在页面上的指令"。
它告诉你"在坐标 (x, y) 画一段文字",但不告诉你"这段文字是标题还是正文"、"这个表格有几行几列"、"这两栏应该先读左边还是先读右边"。
传统工具把字抠出来之后,结构就丢了。
你拿到的是"一堆文字",不是"一份文档"。
Docling 做的事情,是用 AI 模型把 PDF 的视觉信息"还原"成逻辑结构。 它识别标题、段落、表格、图片、公式、代码块,然后按人类阅读的顺序重新组织,输出一个带层级、带位置信息、带表格结构 的 DoclingDocument 对象。
一句话说清:Docling 把"能读出来"升级成了"能按结构用"。
二、一张图看懂 Docling 的整体链路
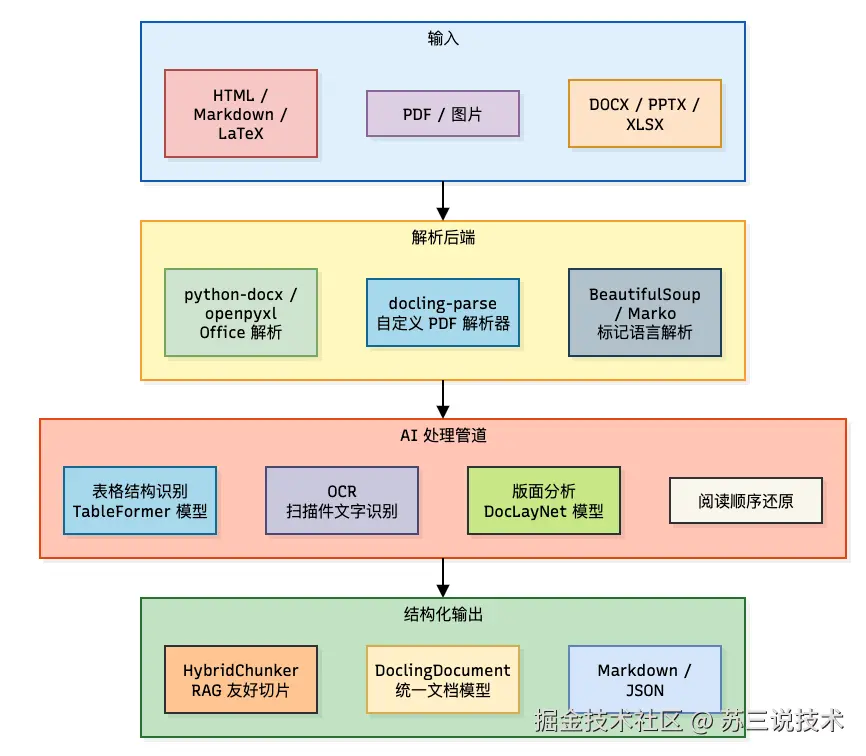
Docling 的架构是模块化的,每一层职责清晰:
解析后端 :针对不同格式用不同的解析器。PDF 用的是自研的 docling-parse,基于 qpdf 构建,解决了 PyMuPDF 的许可证限制和 pypdfium 的质量问题。
AI 处理管道 :StandardPdfPipeline 会并行跑 OCR、版面分析、表格结构识别。版面分析用的是 DocLayNet 模型,表格识别用的是 TableFormer。
统一文档模型 :所有格式最终都变成一个 DoclingDocument,带层级、带位置、带表格结构。你可以无损导出 JSON,也可以导出 Markdown 或 HTML。
三、底层原理
这一节讲的是 Docling 最核心的三件事。我尽量用图把每个环节的"输入"和"输出"讲清楚。
3.1 版面分析:先搞清楚"什么东西在哪"
传统工具拿到 PDF,直接开始抠字。Docling 拿到 PDF,第一件事是把每一页渲染成图片,然后跑版面分析模型。
这一步的目标不是"认出字",是"认出元素"。
DocLayNet 模型会识别出这一页上的每个元素属于哪种类型------标题、段落、表格、图片、公式、代码块------以及它在页面上的坐标位置。
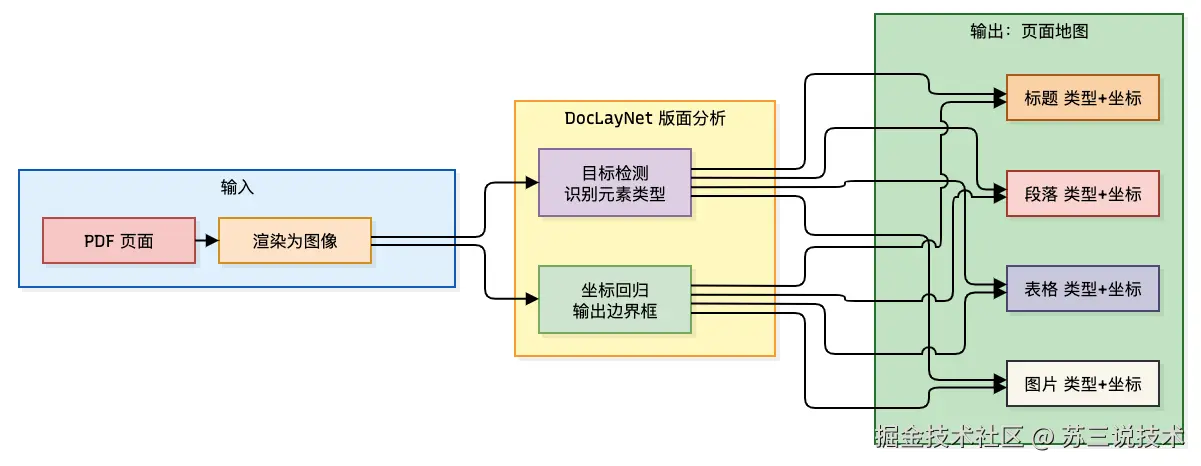
这一步的价值在于:后面所有的处理,都是基于"元素"而不是"文本流"。
它知道"这是一个表格",所以会用表格识别模型;它知道"这是一个标题",所以会保留层级。
3.2 阅读顺序还原:多栏排版不再错乱
版面分析告诉你"什么东西在哪",阅读顺序还原告诉你"先读什么、后读什么"。
双栏论文的阅读顺序是"左栏从上到下,再右栏从上到下"。
但 PDF 里没有"栏"这个概念,只有坐标。如果按坐标从上到下、从左到右硬排,左栏底部和右栏顶部会被拼在一起,上下文直接断裂。
Docling 的阅读顺序模型根据元素的位置和类型,推断出人类会怎么读这一页。
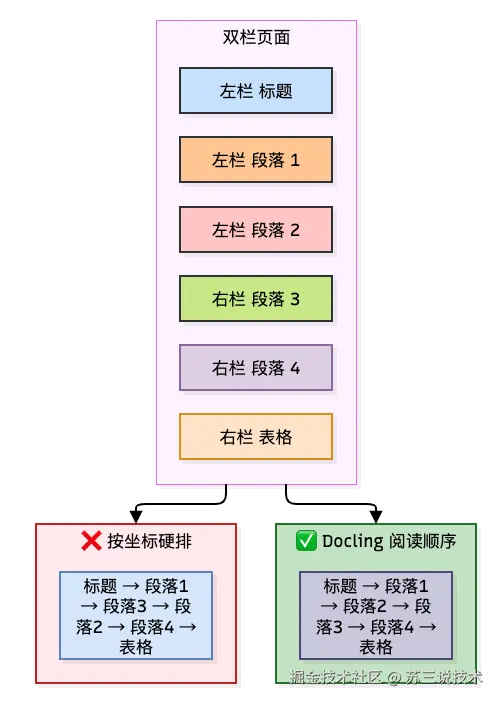
左边是"按坐标硬排"的结果:段落1 后面直接跟了段落3,上下文断了。
右边是 Docling 还原的顺序:左栏读完了才读右栏,逻辑是连贯的。
3.3 表格结构识别:TableFormer 把"一堆数字"变回"一张表"
这是 Docling 最被低估的能力。
传统工具提取表格,要么把表格拆成散落的文本块,要么用简单的行列切分,遇到合并单元格就崩。你拿到的是"一堆数字",不是"一张有结构的表"。
TableFormer 模型会预测表格的行列结构 ,包括合并单元格、多级表头、单元格内嵌列表。它输出的不是文本,是带行列关系的结构化表格。
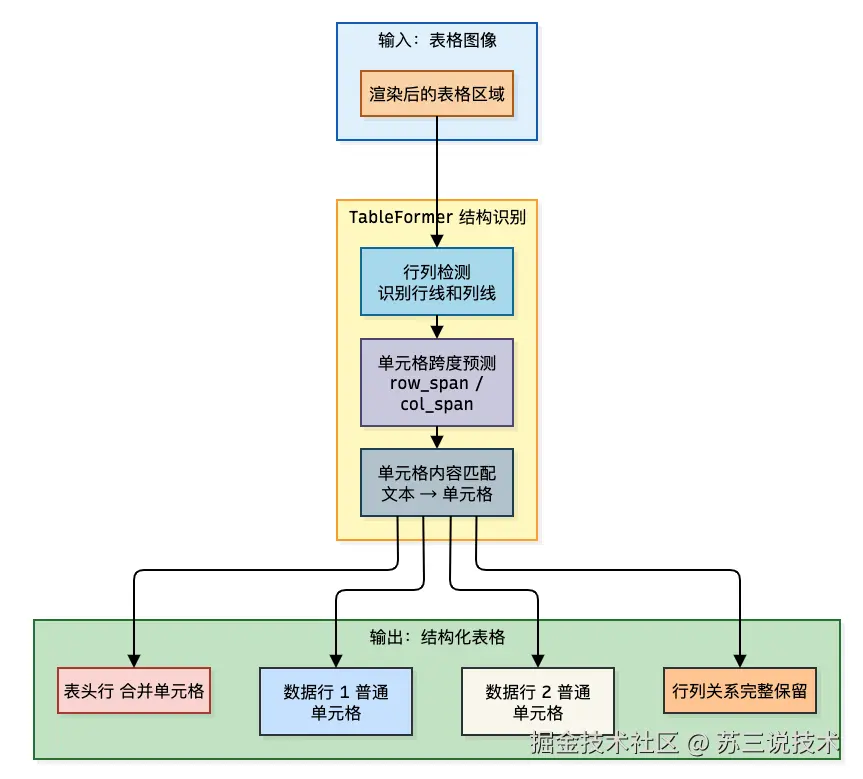
这意味着什么?
RAG 系统检索到这张表时,大模型能看懂"这个数字属于哪个指标、哪一列"。
而不是拿到一堆散落的数字,自己猜。
四、代码实战:从 PDF 到 RAG 就绪的切片
4.1 安装
bash
pip install doclingPython 3.10 及以上。
macOS、Linux、Windows 都支持。
4.2 基础转换:PDF 转 Markdown
bash
from docling.document_converter import DocumentConverter

source = "your_document.pdf"
converter = DocumentConverter()
result = converter.convert(source)

print(result.document.export_to_markdown())
4.3 处理扫描件:开启 OCR
bash
from docling.document_converter import DocumentConverter, PdfFormatOption
from docling.datamodel.pipeline_options import PdfPipelineOptions
from docling.datamodel.base_models import InputFormat

pipeline_options = PdfPipelineOptions()
pipeline_options.do_ocr = True
pipeline_options.do_table_structure = True

converter = DocumentConverter(
    format_options={
        InputFormat.PDF: PdfFormatOption(pipeline_options=pipeline_options)
    }
)
doc = converter.convert("scanned_invoice.pdf").document
print(doc.export_to_markdown())
4.4 RAG 切片:HybridChunker 把结构"喂"给向量库
这是 Docling 跟 RAG 结合最关键的一步。
普通的字符切片会切断句子、拆散表格。HybridChunker 会按照文档的结构来切------标题下的段落不会被拆开,表格不会被切成两半。它还会用 tokenizer 感知的方式,确保切片大小适合你的 Embedding 模型。
bash
from docling.document_converter import DocumentConverter
from docling.chunking import HybridChunker

converter = DocumentConverter()
doc = converter.convert("employee_handbook.pdf").document

chunker = HybridChunker()
chunks = list(chunker.chunk(dl_doc=doc))

for chunk in chunks[:3]:
    # contextualize() 会把章节标题等元数据拼回切片文本
    print(chunker.contextualize(chunk))
    print("---")
contextualize() 的价值 :一个关于"离职政策"的切片,原本可能只有"离职需提前30天通知"这一句话。contextualize() 会把"员工手册 > 人事制度 > 离职管理"这个层级拼进去。Embedding 模型拿到的是带上下文的文本,检索准确率自然更高。
五、优缺点
优点
1. 结构化输出,RAG 友好
输出的是带层级、带表格结构、带位置信息的 DoclingDocument,不是"一堆文字"。配合 HybridChunker,切片质量远超字符切片。
2. 表格识别能力强
TableFormer 模型能还原行列结构、合并单元格、多级表头。TEDS 评分在 0.877 到 0.911 之间。
3. 完全本地运行
模型下载到本地,推理在本地跑。数据敏感、离线内网的场景也能用。
4. 多格式统一
PDF、DOCX、PPTX、XLSX、HTML、Markdown、图片、音频,全部走同一个 DoclingDocument 模型。
5. 生态集成成熟
原生支持 LangChain、LlamaIndex,有 MCP Server,Java 也有 docling-java 封装。
6. 开源治理可靠
Linux 基金会 Graduated 项目,贡献者来自 109 个组织,社区活跃度高。
缺点
1. 不是最快的
CPU 上处理一份复杂 PDF 大约 9 到 10 秒。Marker 或 PyMuPDF4LLM 在简单 PDF 上更快。
2. 复杂表格仍有上限
嵌套极深的表格,Reducto 这类商业方案声称准确率高约 20%。
3. Python 生态,Java 需要绕道
Docling 本身是 Python 包。Java 项目需要通过 docling-serve 的 REST API 或 docling-java 封装来调用,多一层网络开销。
4. 部分高级功能默认关闭
公式转 LaTeX、代码块识别、图片描述这些能力,默认是关的,需要手动开。
六、适用场景
| 场景 | 推荐程度 | 理由 |
|---|---|---|
| RAG 知识库文档预处理 | ✅✅✅ 强烈推荐 | 结构化输出 + HybridChunker,切片质量高 |
| 需要保留表格结构 | ✅✅✅ 强烈推荐 | TableFormer 还原行列和合并单元格 |
| 数据敏感、不能上云 | ✅✅✅ 强烈推荐 | 完全本地运行,离线可用 |
| 技术文档/学术论文解析 | ✅✅✅ 强烈推荐 | 版面分析和阅读顺序还原能力强 |
| 追求极致解析速度 | ⚠️ 需评估 | CPU 上比 Marker 慢 |
| 极复杂嵌套表格 | ⚠️ 需评估 | 商业方案仍有优势 |
| 纯 Java 技术栈 | ⚠️ 需评估 | 需要通过 REST API 调用 |
七、写在最后
回到最初的问题:为什么越来越多人用 Docling?
因为它把 PDF 解析这件事,从"抠字"升级成了"还原结构"。
一份 PDF 的价值不在于"有多少字",在于"字和字之间是什么关系"。标题属于哪个章节、表格里的数字对应哪个指标、这段代码属于哪个函数------这些关系,传统工具丢掉了,Docling 留下来了。
留下来的结构,直接决定了 RAG 系统的上限。
一份被拆散的表格,Embedding 模型再强也检索不准;一份保留结构的表格,检索出来的片段大模型直接能用。
当然,Docling 不是最快的,复杂表格也不是 100% 准确。
但对于"我要把 PDF 变成 RAG 能用的数据"这个需求来说,Docling 是目前开源方案里结构保留最完整、生态集成最成熟的选择之一。
参考资源:
- GitHub :github.com/docling-pro...