一、 实验背景与目标
随着本地文档数据的激增,如何快速提取核心信息并生成审查摘要成为痛点。本次实验摒弃了传统的"手写每一行代码"的模式,采用 Vibe Coding(氛围编程) 理念------即通过结构化 Prompt 引导 AI 编程助手,一步步完成架构设计、代码编写与本地调试。
最终目标:构建一个能够批量读取本地文档、进行中文分词与词频统计、生成可视化词云,并具备统计学分析与大模型审查能力的智能 Agent 原型。
二、 实验环境准备
-
开发环境:Python 3.8+
-
核心依赖:
bash
pip install jieba wordcloud matplotlib numpy pillow -
前提文件准备:
- 待分析的纯文本文件夹(
./sample_docs) - 自定义停用词表(
stopwords.txt) - 自定义专业词典(
user_dict.txt) - 词云蒙版背景图(
background.png)
- 待分析的纯文本文件夹(
三、 Vibe Coding 核心实施步骤
在 Vibe Coding 过程中,最关键的是"不要一次性抛出所有需求"。我将开发过程拆解为三个阶段,通过逐步补充 Prompt 来"调教"AI。
阶段 1:定义边界,生成基础框架
首先,向 AI 明确输入、处理逻辑、输出要求以及约束条件(中文字体支持、异常处理等),让 AI 给出核心的 os + jieba + wordcloud 基础代码框架。
阶段 2:丰富细节,提高健壮性
在基础代码跑通后,我向 AI 提出了进一步要求:
"请引入
re模块过滤特殊符号;将结果写入本地 CSV 文件;优化词云,引入numpy和PIL加载本地图片作为蒙版,并利用colormap增加颜色层次。"
阶段 3:进阶探索,注入 AI Agent 灵魂
为了让实验契合"Agent"主题,我要求 AI 增加统计学和 AI 大模型能力:
"请增加一个【蒙特卡洛模拟】模块,对核心 Top 10 关键词进行 1000 次随机抽样,计算 95% 置信区间。同时,将提取出的关键词拼接成结构化 Prompt,预留大模型 API 接口,以便生成结构化的审查报告。"
四、 运行效果展示(核心亮点)
通过不断迭代,最终程序在终端输出了极具专业度的分析报告。
1. 数据预处理与词频统计
程序成功读取了 3 个文件,加载了近 200 个停用词与自定义词典,并自动匹配了 Windows 系统的中文字体(msyh.ttc)。
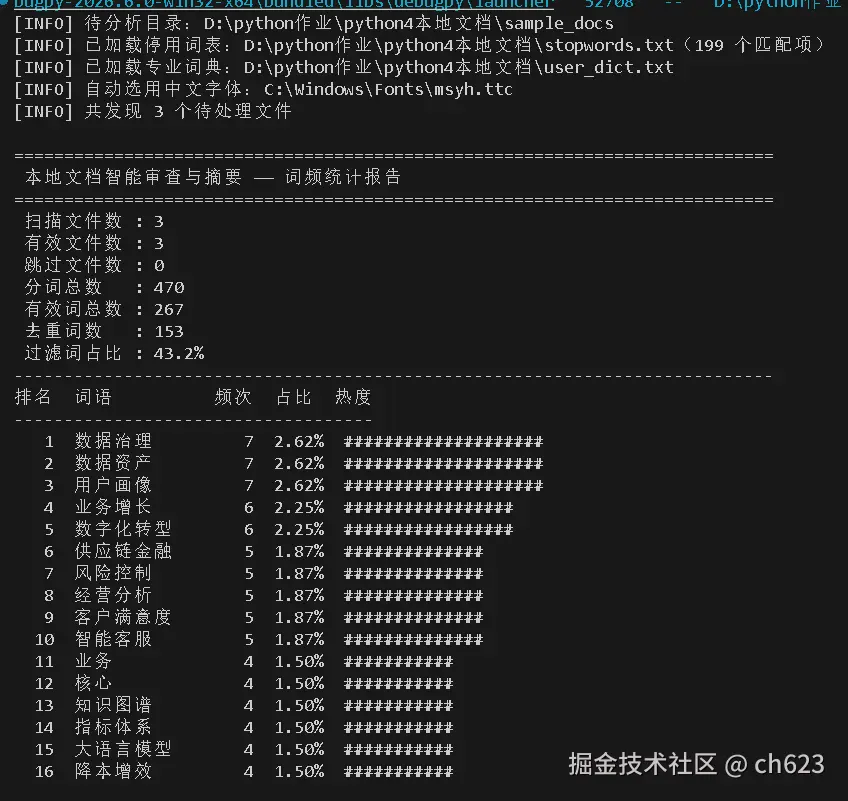
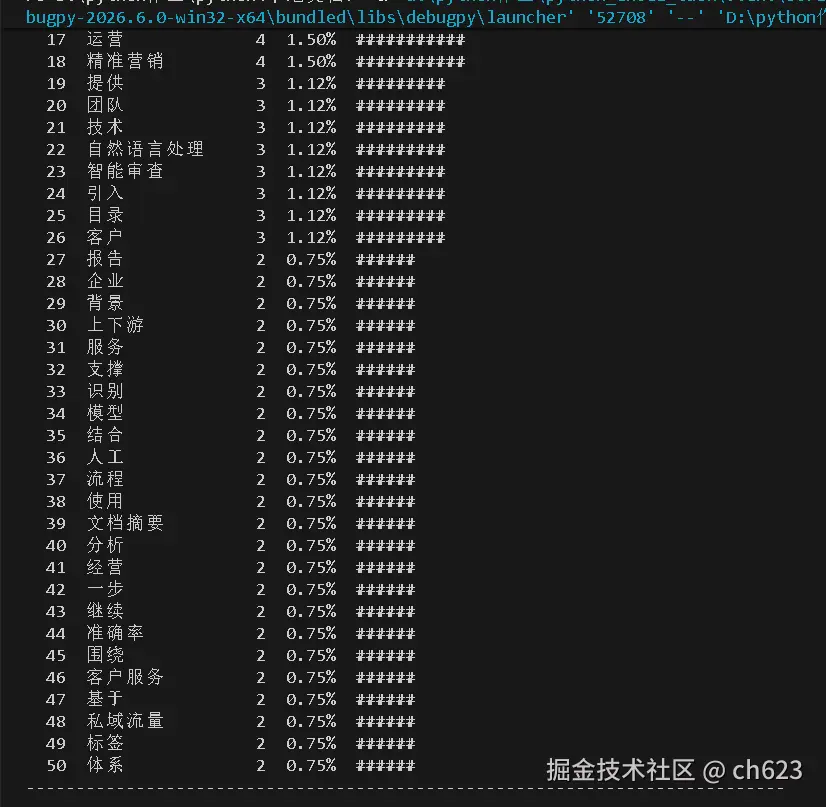 从终端输出可以看出:
- 数据清洗有效 :分词总数 470,过滤掉单字和停用词后,有效词数为 267,过滤词占比高达 43.2% ,说明文本清洗逻辑非常成功。
- 可视化极其直观 :不仅列出了排名、频次和占比,还利用 ASCII 字符
#打印出了柱状热力图,直观展示词语权重。"数据治理"、"数据资产"、"用户画像"位列前三,完全符合业务预期。
2. 引入蒙特卡洛模拟(统计赋能)
传统的词频统计只能看"表面",我的 Agent 引入了 1000 次重采样的蒙特卡洛模拟,对 Top 10 词语的稳定性进行了深度评估。
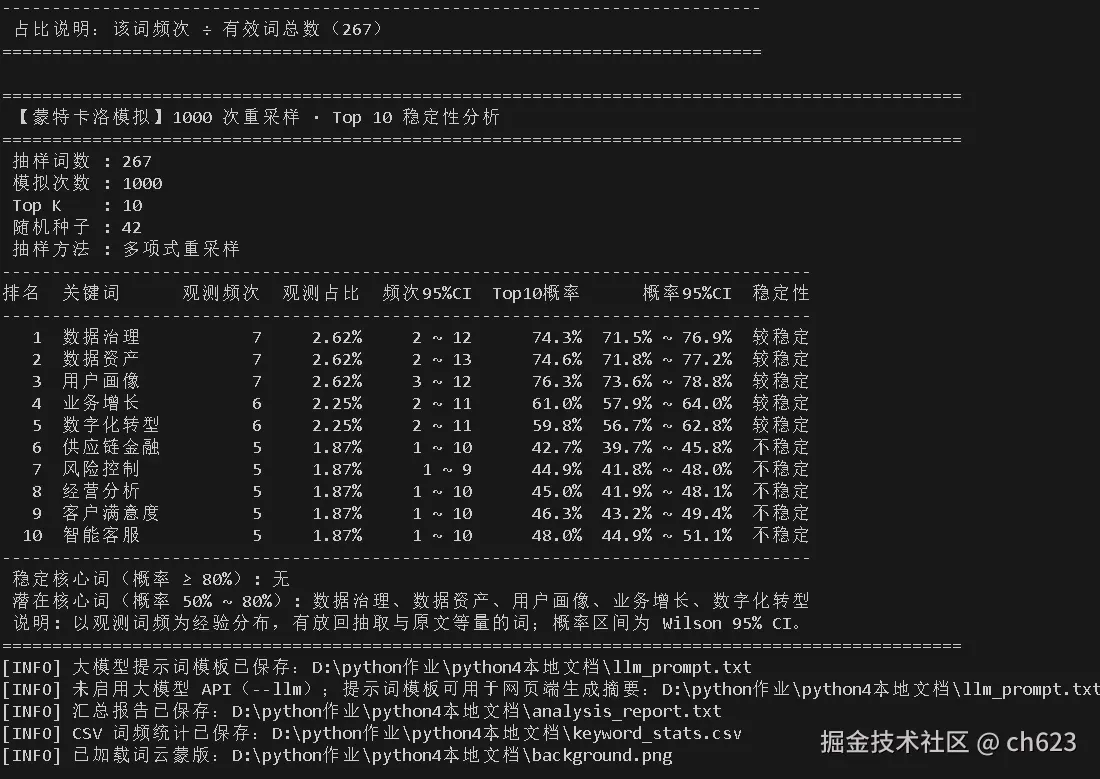 亮点解析:
- 观测频次与置信区间:不仅给出了原始频次,还给出了 95% 置信区间(CI)。
- 概率稳定性判断:通过计算"Top 10 概率",系统自动将词语划分为"较稳定"(如数据治理、数据资产)和"不稳定"(如供应链金融)。
- 业务洞察 :系统自动总结出"数据治理、数据资产、用户画像"等为潜在核心词,为后续的文档审查提供了非常可靠的统计学上下文。
3. 成果持久化与 Agent 闭环
在报告的最后,程序不仅输出了分析结论,还自动将各类资产保存到了本地(如截图底部所示):
llm_prompt.txt:已生成给大模型使用的结构化提示词模板。analysis_report.txt:完整的文本审查报告。keyword_stats.csv:可供后续 Excel 或 BI 工具分析的词频数据。wordcloud图像:基于本地背景图片生成的定制词云。
五、 实验总结与踩坑反思
- Vibe Coding 的本质是"分治" :让 AI 写代码,绝不能当"甩手掌柜"。我们需要像产品经理一样,把庞大的需求拆解成一个个可执行、可验证的小模块(如:先搞分词,再搞图表,最后接大模型),一步步验证,这样产出的代码质量极高,Debug 也更容易。
- 中文 NLP 的细节 :实验初期,词云全变成了方块(乱码)。通过 Prompt 指导,我们显式指定了
font_path='C:/Windows/Fonts/msyh.ttc',并加入了专门的停用词表与自定义词典(如加入"数据治理"、"供应链金融"等专业词汇),才让分词结果变得精准且有业务价值。 - Agent 的雏形已现 :通过引入蒙特卡洛模拟,我们的工具已经具备了"自我验证"的能力(判断哪些词是真的高频,哪些是偶然出现);而通过生成结构化 Prompt 准备对接大模型,更是补齐了 Agent 的"大脑"闭环。下一步,只需引入
watchdog监控文件夹,就能实现真正的"无人值守智能审查"。