文章目录
HDFS回收站
- HDFS会为每个用户创建一个回收站目录:/user/用户名/.Trash/
- 回收站中的数据都会有一个默认的保存周期,过期未恢复则会被HDFS自动彻底删除
- 默认情况下HDFS回收站功能是不开启的,需要修改core-site.xml中的fs.trash.interval属性
shell
# 停止所有服务
[root@hadoop01 hadoop-3.2.0]# sbin/stop-all.sh
Stopping namenodes on [hadoop01]
Last login: Tue Mar  5 14:00:05 CST 2024 on pts/0
Stopping datanodes
Stopping secondary namenodes [hadoop01]
Last login: Tue Mar  5 16:07:06 CST 2024 on pts/0
Stopping nodemanagers
Last login: Tue Mar  5 16:07:10 CST 2024 on pts/0
Stopping resourcemanager
Last login: Tue Mar  5 16:07:14 CST 2024 on pts/0
You have new mail in /var/spool/mail/root
[root@hadoop01 hadoop-3.2.0]# jps
8875 Jps


# 修改core-site.xml
[root@hadoop01 hadoop-3.2.0]# vim etc/hadoop/core-site.xml

        <property>
            <name>fs.trash.interval</name>
            <!--单位分钟-->
            <value>1440</value>
      </property>


# 同步到其它两台从节点
[root@hadoop01 hadoop-3.2.0]# scp -rq etc/hadoop/core-site.xml hadoop03:/home/soft/hadoop-3.2.0/etc/hadoop/
[root@hadoop01 hadoop-3.2.0]# [root@hadoop01 hadoop-3.2.0]# scp -rq etc/hadoop/core-site.xml hadoop02:/home/soft/hadoop-3.2.0/etc/hadoop/

# 重启
[root@hadoop01 hadoop-3.2.0]# sbin/start-all.sh
Starting namenodes on [hadoop01]
Last login: Tue Mar  5 16:07:17 CST 2024 on pts/0
Starting datanodes
Last login: Tue Mar  5 16:14:28 CST 2024 on pts/0
Starting secondary namenodes [hadoop01]
Last login: Tue Mar  5 16:14:31 CST 2024 on pts/0
Starting resourcemanager
Last login: Tue Mar  5 16:14:36 CST 2024 on pts/0
Starting nodemanagers
Last login: Tue Mar  5 16:14:43 CST 2024 on pts/0
# 查看进程
[root@hadoop01 hadoop-3.2.0]# jps
9393 SecondaryNameNode
9636 ResourceManager
9958 Jps
9128 NameNode
You have new mail in /var/spool/mail/root
# 查看文件
[root@hadoop01 hadoop-3.2.0]# hdfs dfs -ls /
Found 3 items
-rw-r--r--   2 root    supergroup      22125 2024-03-05 12:59 /NOTICE.txt
-rw-r--r--   2 root    supergroup       1361 2024-03-05 13:00 /README.txt
-rw-r--r--   3 1111612 supergroup       7877 2024-03-05 14:01 /test.md
# 删除文件  提示信息:将README文件移动到了root/.Trash/Current/
[root@hadoop01 hadoop-3.2.0]# hdfs dfs -rm /README.txt
2024-03-05 16:15:44,889 INFO fs.TrashPolicyDefault: Moved: 'hdfs://hadoop01:9000/README.txt' to trash at: hdfs://hadoop01:9000/user/root/.Trash/Current/README.txt


# 如果文件过大超出回收站的容量,可以用下面的命令解决,跳过回收站直接永久性删除
[root@hadoop01 hadoop-3.2.0]# hdfs dfs -rm -skipTrash /test.md
Deleted /test.md
HDFS的安全模式
- 集群在刚启动的时候HDFS进入安全模式,此时无法执行写操作
- 查看安全模式:hdfs dfsadmin -safemode get
- 离开安全模式:hdfs dfsadmin -safemode leave
shell
查看安全模式
[root@hadoop01 hadoop-3.2.0]# hdfs dfsadmin -safemode get
Safe mode is OFF
定时上传数据至HDFS
- 获取日志文件的名称
- 在HDFS上面使用日期创建目录
- 将日志文件上传到创建的HDFS目录中
- 考虑脚本重跑补数据的情况
- 配置crontab任务
上传脚本
shell
#!/bin/bash
# 获取昨天的日期
yestoday=$1
if [ "$yestoday" = "" ]
then
	yestoday=`date +%Y_%m_%d --date="1 days ago"`
fi
# 拼接日志文件路径信息
logPath=/home/log/access_${yestoday}.log
hdfsPath=/log/${yestoday//_/}
#在HDFS上面创建目录
hdfs dfs -mkdir -p ${hdfsPath}
#数据上传
hdfs dfs -put ${logPath} ${hdfsPath}
执行脚本
shell
# 执行脚本跑昨天的数据
[root@hadoop01 shell]# sh -x uploadLogData.sh
+ yestoday=
+ '[' '' = '' ']'
++ date +%Y_%m_%d '--date=1 days ago'
+ yestoday=2024_03_05
+ logPath=/home/log/access_2024_03_05.log
+ hdfsPath=/log/20240305
+ hdfs dfs -mkdir -p /log/20240305
+ hdfs dfs -put /home/log/access_2024_03_05.log /log/20240305


# 执行脚本跑指定日期的数据
[root@hadoop01 shell]# sh -x uploadLogData.sh 2024_01_05
+ yestoday=2024_01_05
+ '[' 2024_01_05 = '' ']'
+ logPath=/home/log/access_2024_01_05.log
+ hdfsPath=/log/20240105
+ hdfs dfs -mkdir -p /log/20240105
+ hdfs dfs -put /home/log/access_2024_01_05.log /log/20240105

查看
[root@hadoop01 shell]# hdfs dfs -ls /log/20240305
Found 1 items
-rw-r--r--   2 root supergroup         21 2024-03-06 09:40 /log/20240305/access_2024_03_05.log

[root@hadoop01 shell]# hdfs dfs -ls /log/20240105
Found 1 items
-rw-r--r--   2 root supergroup         21 2024-03-06 09:45 /log/20240105/access_2024_01_05.log
配置crontab任务
shell
# 定时上传数据 上传日志放在uploadData.log里面
[root@hadoop01 shell]# vim /etc/crontab
0 1 * * * root sh /home/shell/uploadLogData.sh >> /home/shell/uploadData.log
HDFS的高可用和高扩展
针对我们目前这个一主两从的集群,前面做过分析
- 高可用(HA):NameNode主要负责接收用户的操作请求,所有的读写请求都会经过它,存在单点故障,对于这个情况而言需要部署多节点NameNode,但是只有一个NameNode是Active状态,其它的是StandBy状态;ActiveNameNode负责所有的客户端操作,StandByNameNode用来同步Ann的状态消息,以提供快速故障恢复能力;启动HA的时候不能启动SecondaryNameNode。

- 高扩展:HDFS适合存储大文件,原因在于NameNode存储的文件的索引(元数据信息),文件实际存储在DataNode上,所以不管是大文件还是小文件,在NameNode上所在的索引内存是一定的;如果NameNode内存不够用,官方提供了Federation机制

HDFS写数据过程源码剖析
RPC原理分析
- 一种通过网络从远程计算机程序上请求服务,而不需要了解底层网络技术的协议
- 采用client/server模式,请求程序就是一个client,服务提供的程序就是一个server
- Hadoop的整个体系结构就是构建在RPC之上的,客户端和NameNode通信、DataNode和NameNode之间的通信都是通过RPC协议来实现
这个调用过程是跨主机,跨进程的
RPC接口分析
- ClientProtocol:HDFS客户端(FileSystem)与NameNode通信的接口
- DatanodeProtocal:DataNode和NameNode通信的接口,通过心跳机制,DataNode定时上报自己当前节点的状态信息
- NamenodeProtocol:SecondaryNameNode与NameNode通信的接口,负责合并事务日志信息
案例分析
java
# server
public static void main(String[] args) throws IOException {
        Configuration conf = new Configuration();
        // 创建RPC server构建器
        RPC.Builder builder = new RPC.Builder(conf);
        builder.setBindAddress("127.0.0.1")
                .setPort(8099)
                .setProtocol(MyProtocol.class)
                .setInstance(new MyProtocolImpl());


        RPC.Server server = builder.build();
        server.start();
        System.out.println("server started");
    }
java
# client
public static void main(String[] args) throws IOException {
        InetSocketAddress addr = new InetSocketAddress("127.0.0.1", 8099);
        Configuration con = new Configuration();
        // 获取RPC代理
        MyProtocol proxy = RPC.getProxy(MyProtocol.class, MyProtocol.versionID, addr, con);
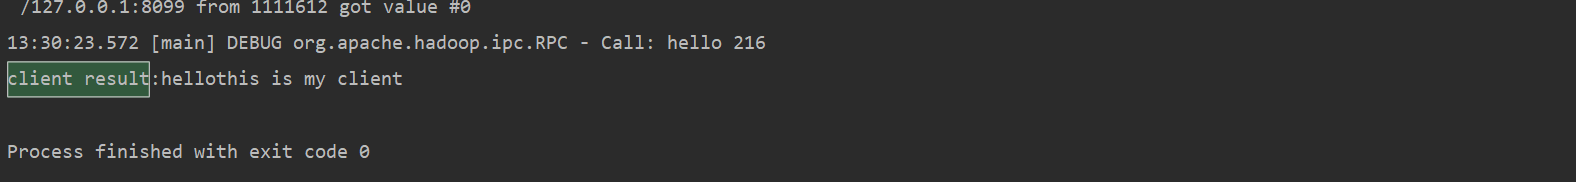
        String result = proxy.hello("this is my client");
        System.out.println("client result:" + result);
    }
java
/**
 * 自定义RPC接口
 */
public interface MyProtocol extends VersionedProtocol {

    long versionID = 123456;

    String hello(String name);


}
java
public class MyProtocolImpl implements MyProtocol {
    @Override
    public String hello(String name) {
        System.out.println("我被调用了...");
        return "hello" + name;
    }

    /**
     * 获取接口版本号
     * @param s
     * @param l
     * @return
     * @throws IOException
     */
    @Override
    public long getProtocolVersion(String s, long l) throws IOException {
        return versionID;
    }

    @Override
    public ProtocolSignature getProtocolSignature(String s, long l, int i) throws IOException {
        return new ProtocolSignature();
    }
}
IOException {
return versionID;
}
@Override
public ProtocolSignature getProtocolSignature(String s, long l, int i) throws IOException {
    return new ProtocolSignature();
}
}