正则表达式
- 在处理字符串时,需要查找符合某些复杂规则的字符串,正则表达式就是用于描述这些规则的工具
一、正则表达式语法
-
行定位符:用来描述字符串的边界 -->用来匹配一整行
符号 匹配位置 ^ 行的开始 $ 行的结尾 ^tm: 可以匹配行tm equal Tomorrow Moontm$:可以匹配行Tomorrow moon tm
-
**元字符:**用来匹配的字符标记
代码 说明 . 匹配除换行外的任意字符 \w 匹配字母、数字、下划线、汉字 \s 匹配任意空白符 \d 匹配数字 \b 匹配单词的开始、结束 \bmr\w*\b:匹配一个以mr为开头的单词,比如:mrsoft、mr123456
-
**重复:**用来匹配特定数量的元字符,称作限定符
限定符 说明 举例 ? 匹配前面的字符一次、零次 colou?r --> 匹配color、colour + 匹配前面的字符一次、多次 go+gle --> 匹配范围gogle ~ go...gle * 匹配前面的字符零次、多次 go*gle --> 匹配范围ggle ~ go...gle {n} 匹配前面的字符n次 go{2}gle --> 匹配google {n,} 匹配前面的字符至少n次 go{2,}gle --> 匹配范围 google ~ goo...gle {n, m} 匹配前面的字符n, m次 employe{0,2} --> 匹配employ, employe, employee -
**字符类:**用来匹配没有预定义元字符的字符集合,使用
[]列举出来即可[aeiou]:匹配任何一个英文元音字母[,?!]:匹配三个符号中的其中一个[0-9]: 匹配一个数字[a-z0-9A-Z]:匹配数字或字母[^a-zA-Z]: 匹配一个不是字母的字符, ^放在括号里面表示排除的意思[\u4e00-\u9fa5]: 匹配一个汉字
这种字符类的匹配方式,是可以同重复限定符配合使用的
-
选择字符:匹配包含条件选择逻辑的字符
-
身份证号:可能为15为全数字、18位全数字、17为数字加x或X
re(^\d{15}$)|(^\d{18}$)|(^\d{17}(x|X)$)上述使用
|来表示选择性匹配,使用^ $限定开头和结尾
-
-
**转义字符:**匹配特殊的元字符,主要是针对
. * ? \ ( ) { }-
IP地址:格式通常为xxx.xxx.xxx.xxx
re[1-9]{1,3}\.[0-9]{1,3}\.[0-9]{1,3}\.[0-9]{1,3}上述使用
\.来匹配IP地址中的.
-
-
**小括号:**改变功能字符的限定范围
-
(thir | four)th: 匹配 thirth、fourth -
(\.[1-9]{1,3}){3}:匹配(\.[1-9]{1,3})三次
二、python中的正则表达式
**说明:**python在使用正则表达式时,是将其作为模式字符串使用的,简而言之就是匹配模式是字符串类型,这就导致部分元字符,如\b 会被python解读为python语言的转义字符,故而要使用\\b表示正则模式字符串,为了比较出现大量的特殊字符、反斜杠,常采用原生字符串 r'\b'
-
**匹配字符串:**re模块提供
match() search() findall()方法进行字符串匹配-
使用
match()方法匹配字符串:re.match(pattern, string, [flags])从string起始处开始匹配,匹配成功返回Match对象,否则返回Nonepythonimport re pattern = r'mr_\w+' # 匹配一个mr_开头的字符串 string = 'MR_SHOP' flag = re.I # 不区分大小写 match = re.match(pattern, string, flag) # 输出: <re.Match object; span=(0, 7), match='MR_SHOP'> string = 'aaaMR_shop' print(re.match(pattern, string, flag)) # 输出: None通过返回的Match对象可以查看相关数据
pythonmatch.start() # 匹配值的起始位置 match.end() # 匹配值的结束位置 match.span() # 匹配位置的元组 match.string # 进行匹配的字符串 match.group() # 匹配得到的结果 -
使用
search(pattern, string)方法匹配字符串 :该方法用于在整个字符串中搜索第一个匹配值,并返回Match对象,其余与match()方法相同 -
**使用
findall(pattern, string)方法匹配字符串:**该方法由于在整个字符串中搜索所有符合正则表达式的字符串,并以列表形式返回匹配结果,而不是Match对象。 -
**替换字符串:**re模块提供
sub()方法实现字符串的替换,re.sub(pattern, repl, string, count, flags)表示按着pattern对string进行匹配,并替换成repl字符串。 -
count: 可选参数-->替换的最大次数,默认为0表示全部替换
-
flags:可选参数 --> 用于控制匹配方式,如是否区分大小写等(flag=re.I表示不区分大小写)
-
-
**分割字符串:**re模块提供
split()方法实现字符串的分割,re.split(pattern, string, [maxsplit], [flags])表示按着pattern对string进行分割,返回分割后的列表- maxsplit: 可选参数 --> 最大查分次数,默认全拆
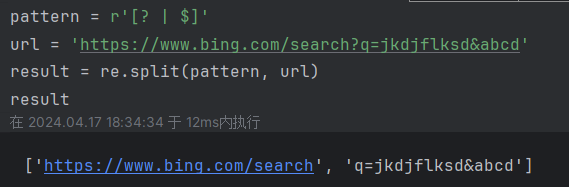
上述代码展示了,对网址按
? $进行分割的实现以及具体的结果
三、实战中的相关问题
1. 对txt的每行进行匹配时,输出匹配结果时报错
-
由于进行匹配时往往会出现匹配失败返回的match为None的情况,就会对Match对象的属性输出报错,比如下述代码,如果没有匹配到那么match就会是None,代码就会报错
pythonmatch = re.match(pattern, string, flag) print(match.group()) -
正确的做法是加一个检测机制,如下所示,这样就保证了只有正确匹配到时才会输出
pythonmatch = re.match(pattern, string, flag) if match: print(match.group()) -
正确的做法是加一个检测机制,如下所示,这样就保证了只有正确匹配到时才会输出
pythonmatch = re.match(pattern, string, flag) if match: print(match.group())