如果对htmlunit还不了解的话可以参考Java:爬虫htmlunit-CSDN博客
了解了htmlunit之后,我们再来学习如何在页面中抓取我们想要的数据,我们在学习初期可以找一些结构比较清晰的网站来做测试爬取,首先我们随意找个网站如下:

当我们打开网站F12,进入开发者模式,我们在学习之前我们需要知道我们要爬取什么数据,了解数据和页面的结构。就拿这个网站来说我们如果要爬取它的数据,首先需要获取他们的类别,在获取类别下的数据。那我们在点击类别的时候,需要分析下地址有没有变化,如果变化了,我们需要拿到指定类别的地址,然后和域名拼接成完整地址抓取其类目下的数据。
为什么要拼接呢?因为在网站类目使用的跳转,会自动加上站点地址;我们在爬取的时候是没有该网站域名的。
这个列子非常简单,我们直接要获取它的类别跳转的地址,再根据爬取的地址爬取其详情数据;
分析下来我们只要抓取该页面的a标签即可。这个在 htmlunit 中提供了 HtmlAnchor直接可以获取所有的a标签,代码如下:
/**
 * <b>Function: </b> todo
 *
 * @program: 根据页面信息获取子页面信息
 * @Package: com.kingbal.king.dmp
 * @author: dingcho
 * @date: 2024/06/13
 * @version: 1.0
 * @Copyright: 2024 www.kingbal.com Inc. All rights reserved.
 */
@Slf4j
public class BaseTest {

	public static void main(String[] args) throws Exception {
		HtmlPage page = SpiderUtils.crawlPageWithoutAnalyseJs("https://www.yiyiwiy.com/");
		//System.err.println(page);
		List<HtmlAnchor> htmlAnchorList = page.getAnchors();
		log.info("htmlAnchorList.size() >>" + htmlAnchorList.size());
		log.info("********************");
		htmlAnchorList.forEach(f -> {
			if(f.getHrefAttribute().contains("vodtypehtml")){
				log.info(f.getHrefAttribute());
			}
		});
		log.info("********************");
	}

}
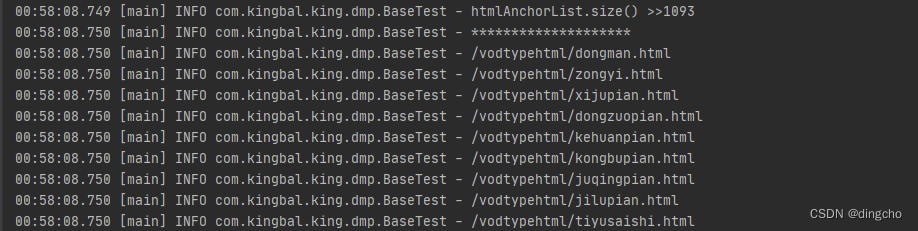
我们抓取的是所有页面的a标签,所以我们需要过滤掉我们不需要的地址:
if(f.getHrefAttribute().contains("vodtypehtml")){
	log.info(f.getHrefAttribute());
}
然后执行代码,就可以获取到对应数据